首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

深度解读 OpenYurt :边缘自治能力设计解析

作者 | 新胜 阿里云技术专家 导读:OpenYurt 开源两周以来,以非侵入式的架构设计融合云原生和边缘计算两大领域,引起了不少行业内同学的关注。阿里云推出开源项目 OpenYurt,一方面是把阿里云在云原生边缘计算领域的经验回馈给开源社区,另一方面也希望加速云计算向边缘延伸的进程,并和社区共同探讨未来云原生边缘计算架构的统一标准。为了更好地向社区和用户介绍 OpenYurt,我们特地推出【深度解读OpenYurt】系列文章,本文为系列文章的第二篇,详细介绍了 OpenYurt 的边缘自治能力的设计细节。 系列文章推荐: OpenYurt 开箱测评 | 一键让原生 K8s 集群具备边缘计算能力 OpenYurt介绍 5 月 29 号 OpenYurt 正式开源了。OpenYurt 作为公共云服务 ACK@Edge 的核心框架,已经应用于

优秀的个人博客,低调大师

快速解析物联网应用服务设备

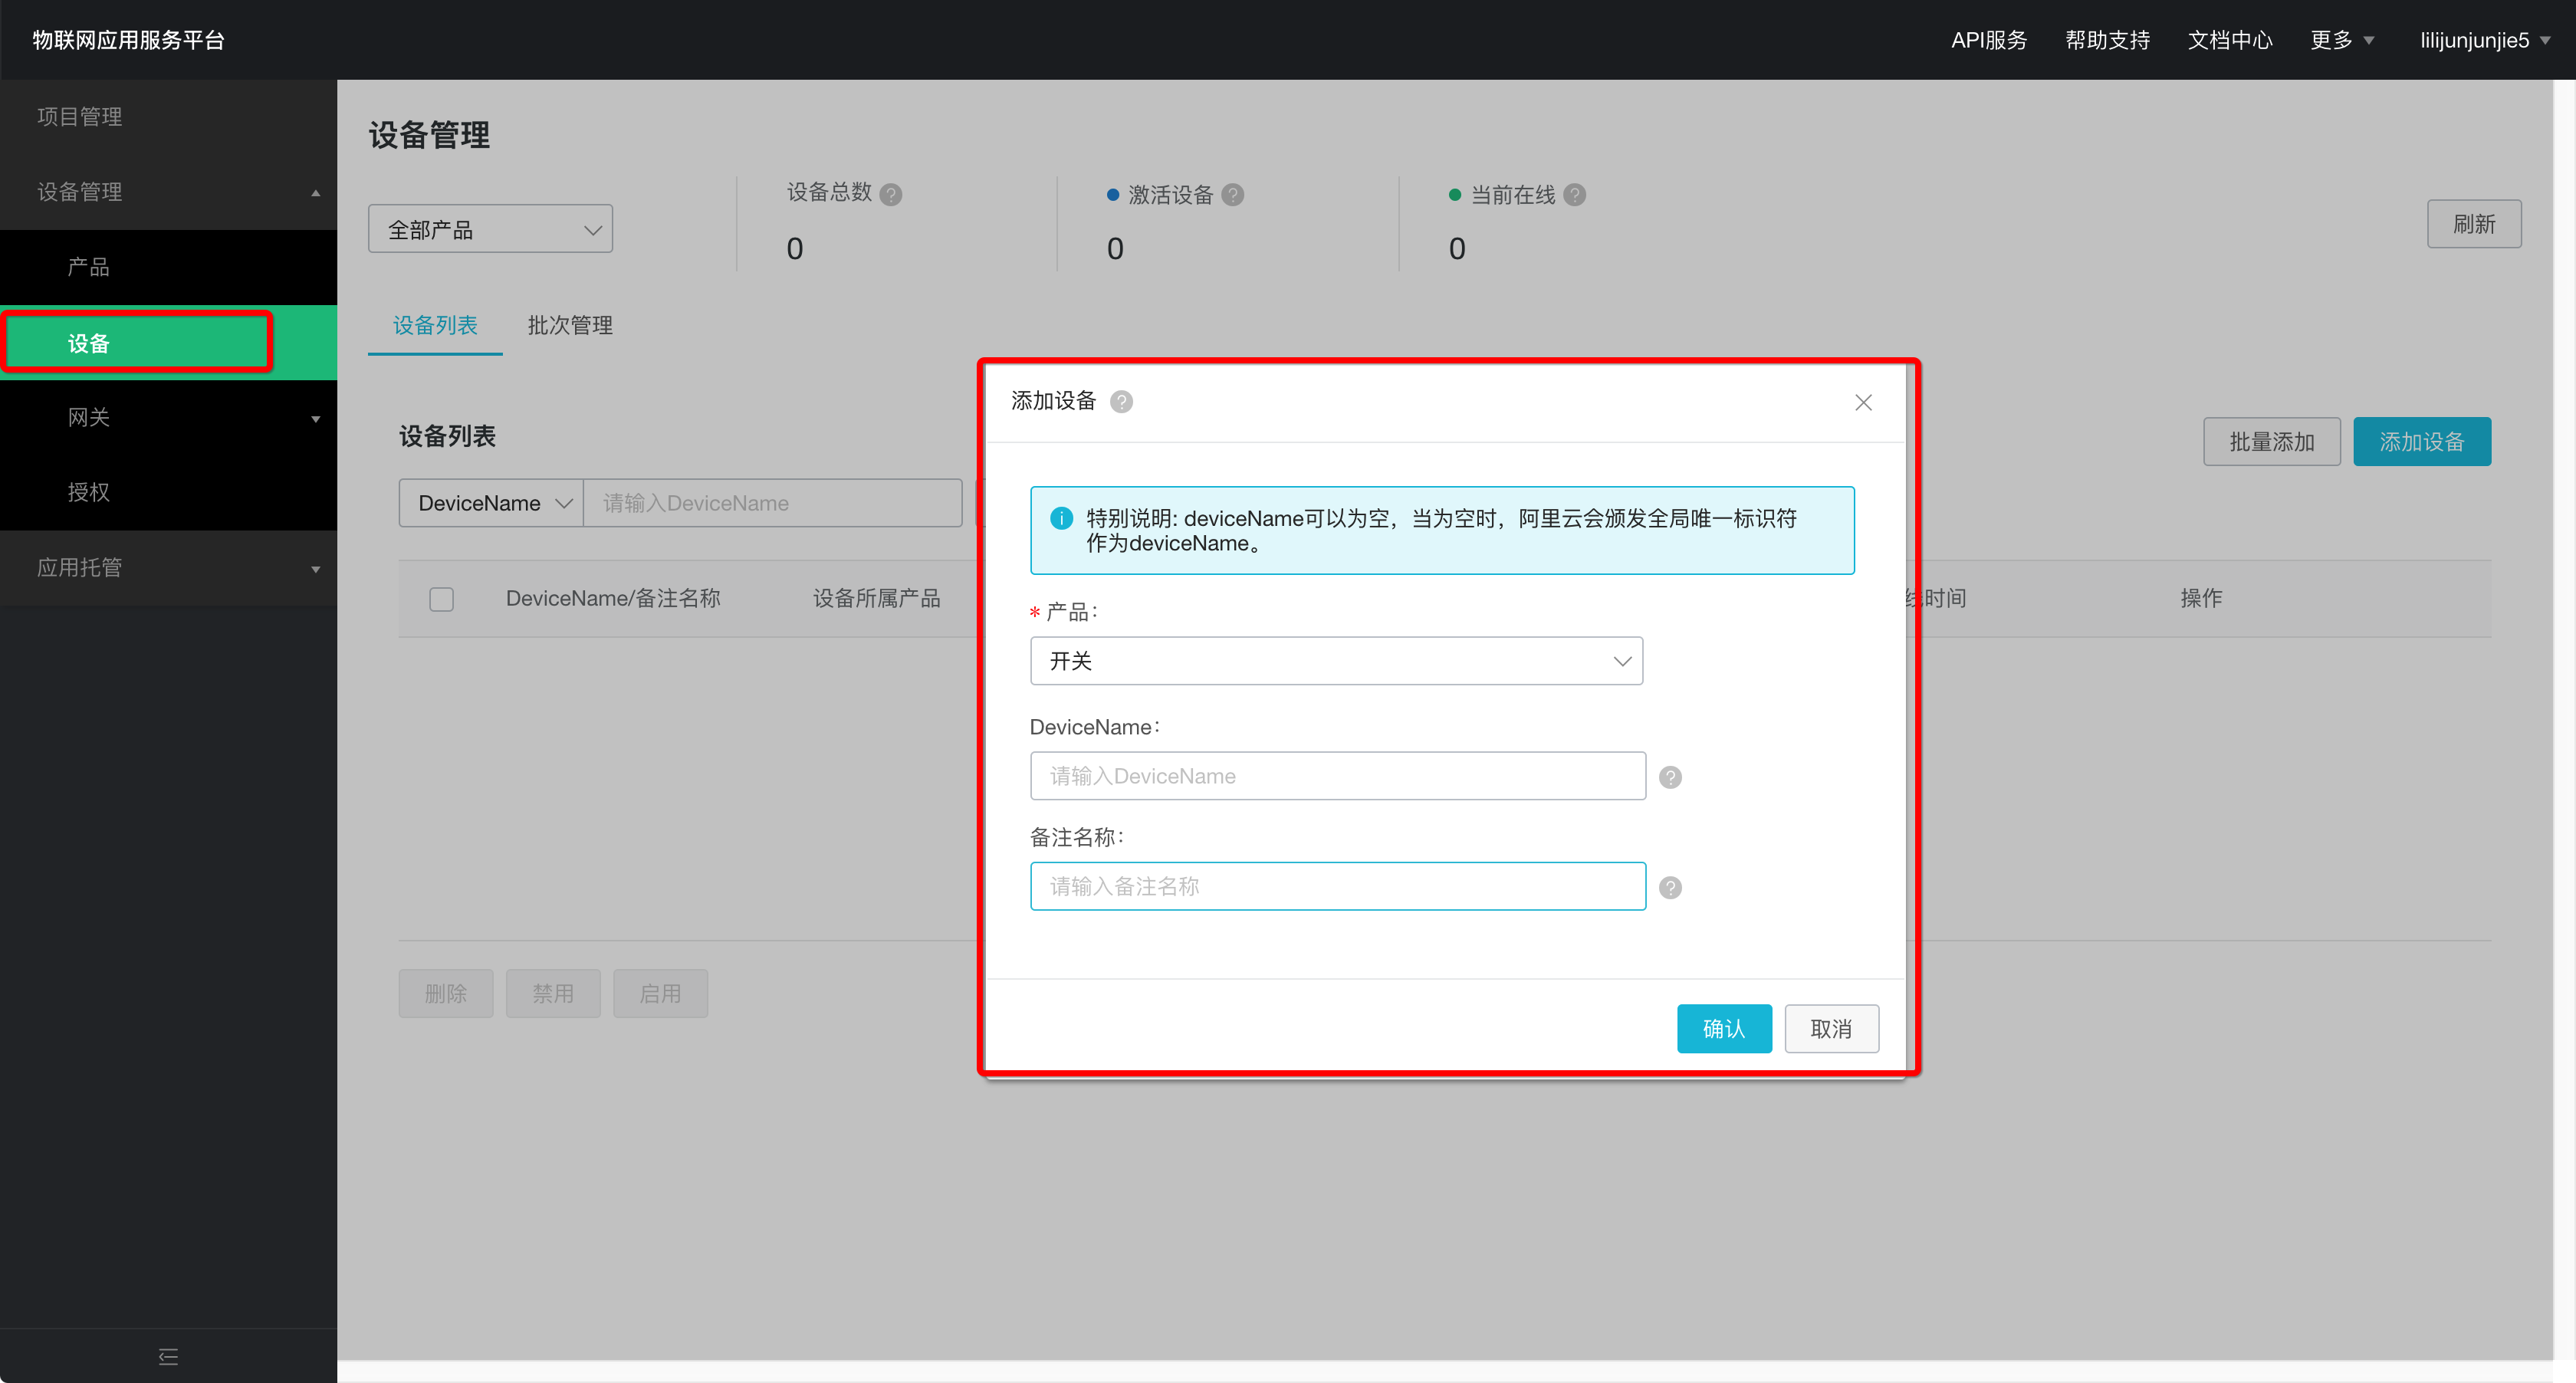
云栖号快速入门:【点击查看更多云产品快速入门】不知道怎么入门?这里分分钟解决新手入门等基础问题,可快速完成产品配置操作! 产品指某一类设备,创建完产品后,需要为设备创建身份。您可以创建单个设备,也可以批量创建设备。本文为您讲述单个设备的创建。 操作步骤 1.登录应用服务平台控制台。2.左侧导航栏选择设备管理 > 设备,再页面右侧添加设备。3.在添加设备对话框中,输入设备信息,单击确认。 执行结果 设备创建成功后,将自动弹出查看设备证书弹框。您可以查看、复制设备证书信息。设备证书由设备 ProductKey、DeviceName、和 DeviceSecret组成,是设备与物联网平台进行通信的重要身份认证,建议您妥善保管。 之后,您也可以在设备列表中,单击设备对应的查看按钮,进入设备详情页设备信息页签下,查看设备信息。 下一步 请参见设备端开发文档开发设备端SDK。 本文来自 阿里云文档中心 物联网应用服务 设备 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK

优秀的个人博客,低调大师

分析kubernetes中的事件机制-源码解析

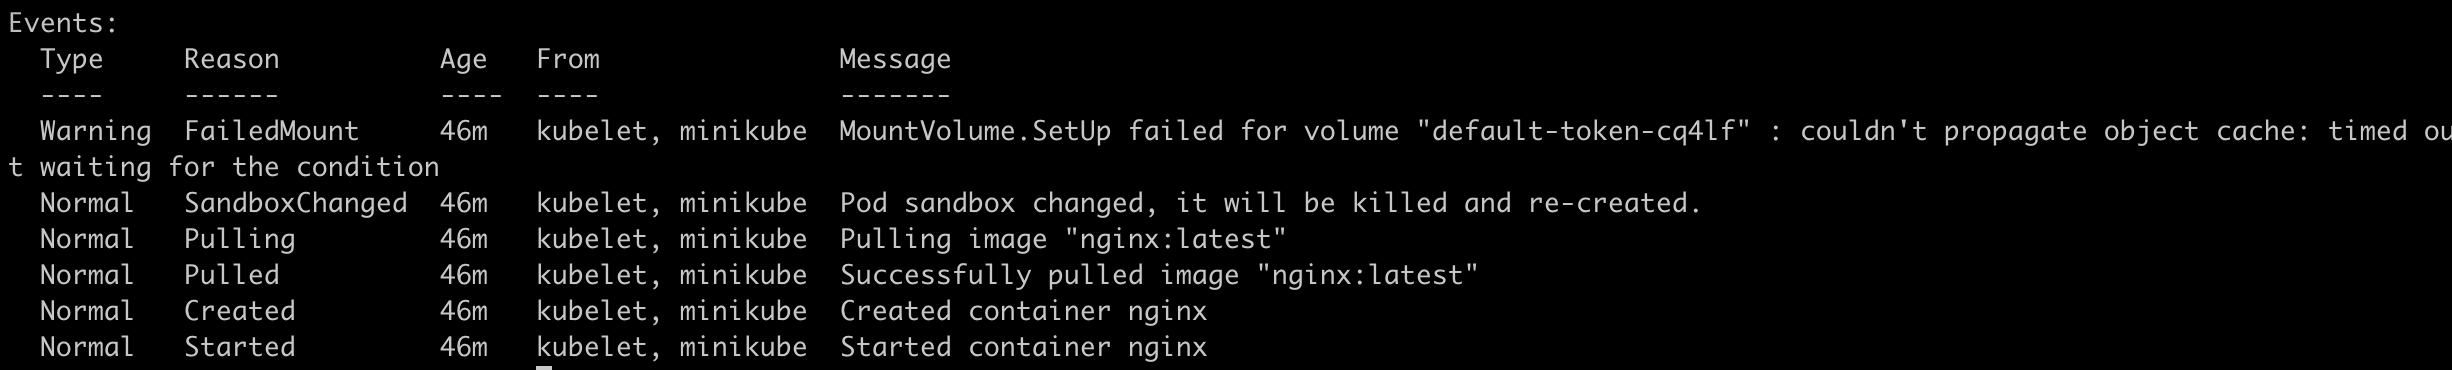
我们通过 kubectl describe [资源] 命令,可以在看到Event输出,并且经常依赖event进行问题定位,从event中可以分析整个POD的运行轨迹,为服务的客观测性提供数据来源,由此可见,event在Kubernetes中起着举足轻重的作用。 event并不只是kubelet中都有的,关于event的操作被封装在client-go/tools/record包,我们完全可以在写入自定义的event。 现在让我们来一步步揭开event的面纱。 Event定义 其实event也是一个资源对象,并且通过apiserver将event存储在etcd中,所以我们也可以通过 kubectl get event 命令查看对应的event对象。 以下是一个event的yaml文件: apiVersion: v1 count: 1 eventTime: null firstTimestamp: "2020-03-02T13:08:22Z" involvedObject: apiVersion: v1 kind: Pod name: example-foo-d75d8587c-xsf64 namespace: default resourceVersion: "429837" uid: ce611c62-6c1a-4bd8-9029-136a1adf7de4 kind: Event lastTimestamp: "2020-03-02T13:08:22Z" message: Pod sandbox changed, it will be killed and re-created. metadata: creationTimestamp: "2020-03-02T13:08:30Z" name: example-foo-d75d8587c-xsf64.15f87ea1df862b64 namespace: default resourceVersion: "479466" selfLink: /api/v1/namespaces/default/events/example-foo-d75d8587c-xsf64.15f87ea1df862b64 uid: 9fe6f72a-341d-4c49-960b-e185982d331a reason: SandboxChanged reportingComponent: "" reportingInstance: "" source: component: kubelet host: minikube type: Normal 主要字段说明:** involvedObject: 触发event的资源类型 lastTimestamp:最后一次触发的时间 message:事件说明 metadata :event的元信息,name,namespace等 reason:event的原因 source:上报事件的来源,比如kubelet中的某个节点 type:事件类型,Normal或Warning event字段定义可以看这里:types.go#L5078 接下来我们来看看,整个event是如何下入的。 写入事件 1、这里以kubelet为例,看看是如何进行事件写入的 2、文中代码以Kubernetes 1.17.3为例进行分析 先以一幅图来看下整个的处理流程 创建操作事件的客户端:kubelet/app/server.go#L461 // makeEventRecorder sets up kubeDeps.Recorder if it's nil. It's a no-op otherwise. func makeEventRecorder(kubeDeps *kubelet.Dependencies, nodeName types.NodeName) { if kubeDeps.Recorder != nil { return } //事件广播 eventBroadcaster := record.NewBroadcaster() //创建EventRecorder kubeDeps.Recorder = eventBroadcaster.NewRecorder(legacyscheme.Scheme, v1.EventSource{Component: componentKubelet, Host: string(nodeName)}) //发送event至log输出 eventBroadcaster.StartLogging(klog.V(3).Infof) if kubeDeps.EventClient != nil { klog.V(4).Infof("Sending events to api server.") //发送event至apiserver eventBroadcaster.StartRecordingToSink(&v1core.EventSinkImpl{Interface: kubeDeps.EventClient.Events("")}) } else { klog.Warning("No api server defined - no events will be sent to API server.") } } 通过 makeEventRecorder 创建了 EventRecorder 实例,这是一个事件广播器,通过它提供了StartLogging和StartRecordingToSink两个事件处理函数,分别将event发送给log和apiserver。NewRecorder创建了 EventRecorder 的实例,它提供了 Event ,Eventf 等方法供事件记录。 EventBroadcaster 我们来看下EventBroadcaster接口定义:event.go#L113 // EventBroadcaster knows how to receive events and send them to any EventSink, watcher, or log. type EventBroadcaster interface { // StartEventWatcher(eventHandler func(*v1.Event)) watch.Interface StartRecordingToSink(sink EventSink) watch.Interface StartLogging(logf func(format string, args ...interface{})) watch.Interface NewRecorder(scheme *runtime.Scheme, source v1.EventSource) EventRecorder Shutdown() } 具体实现是通过 eventBroadcasterImpl struct来实现了各个方法。 其中StartLogging 和 StartRecordingToSink 其实就是完成了对事件的消费,EventRecorder实现对事件的写入,中间通过channel实现了生产者消费者模型。 EventRecorder 我们先来看下EventRecorder 接口定义:event.go#L88,提供了一下4个方法 // EventRecorder knows how to record events on behalf of an EventSource. type EventRecorder interface { // Event constructs an event from the given information and puts it in the queue for sending. // 'object' is the object this event is about. Event will make a reference-- or you may also // pass a reference to the object directly. // 'type' of this event, and can be one of Normal, Warning. New types could be added in future // 'reason' is the reason this event is generated. 'reason' should be short and unique; it // should be in UpperCamelCase format (starting with a capital letter). "reason" will be used // to automate handling of events, so imagine people writing switch statements to handle them. // You want to make that easy. // 'message' is intended to be human readable. // // The resulting event will be created in the same namespace as the reference object. Event(object runtime.Object, eventtype, reason, message string) // Eventf is just like Event, but with Sprintf for the message field. Eventf(object runtime.Object, eventtype, reason, messageFmt string, args ...interface{}) // PastEventf is just like Eventf, but with an option to specify the event's 'timestamp' field. PastEventf(object runtime.Object, timestamp metav1.Time, eventtype, reason, messageFmt string, args ...interface{}) // AnnotatedEventf is just like eventf, but with annotations attached AnnotatedEventf(object runtime.Object, annotations map[string]string, eventtype, reason, messageFmt string, args ...interface{}) } 主要参数说明: object 对应event资源定义中的 involvedObject eventtype 对应event资源定义中的type,可选Normal,Warning. reason :事件原因 message :事件消息 我们来看下当我们调用 Event(object runtime.Object, eventtype, reason, message string) 的整个过程。发现最终都调用到了 generateEvent 方法:event.go#L316 func (recorder *recorderImpl) generateEvent(object runtime.Object, annotations map[string]string, timestamp metav1.Time, eventtype, reason, message string) { ..... event := recorder.makeEvent(ref, annotations, eventtype, reason, message) event.Source = recorder.source go func() { // NOTE: events should be a non-blocking operation defer utilruntime.HandleCrash() recorder.Action(watch.Added, event) }() } 最终事件在一个 goroutine 中通过调用 recorder.Action 进入处理,这里保证了每次调用event方法都是非阻塞的。其中 makeEvent 的作用主要是构造了一个event对象,事件name根据InvolvedObject中的name加上时间戳生成: 注意看:对于一些非namespace资源产生的event,event的namespace是default func (recorder *recorderImpl) makeEvent(ref *v1.ObjectReference, annotations map[string]string, eventtype, reason, message string) *v1.Event { t := metav1.Time{Time: recorder.clock.Now()} namespace := ref.Namespace if namespace == "" { namespace = metav1.NamespaceDefault } return &v1.Event{ ObjectMeta: metav1.ObjectMeta{ Name: fmt.Sprintf("%v.%x", ref.Name, t.UnixNano()), Namespace: namespace, Annotations: annotations, }, InvolvedObject: *ref, Reason: reason, Message: message, FirstTimestamp: t, LastTimestamp: t, Count: 1, Type: eventtype, } } 进一步跟踪Action方法,apimachinery/blob/master/pkg/watch/mux.go#L188:23 // Action distributes the given event among all watchers. func (m *Broadcaster) Action(action EventType, obj runtime.Object) { m.incoming <- Event{action, obj} } 将event写入到了一个channel里面。注意:这个Action方式是apimachinery包中的方法,因为实现的sturt recorderImpl将 *watch.Broadcaster 作为一个匿名struct,并且在 NewRecorder 进行 Broadcaster 赋值,这个Broadcaster其实就是 eventBroadcasterImpl 中的Broadcaster。 到此,基本清楚了event最终被写入到了 Broadcaster 中的 incoming channel中,下面看下是怎么进行消费的。 消费事件 在 makeEventRecorder 调用的 StartLogging 和 StartRecordingToSink 其实就是完成了对事件的消费。 StartLogging直接将event输出到日志 StartRecordingToSink将事件写入到apiserver 两个方法内部都调用了 StartEventWatcher 方法,并且传入一个 eventHandler 方法对event进行处理 func (e *eventBroadcasterImpl) StartEventWatcher(eventHandler func(*v1.Event)) watch.Interface { watcher := e.Watch() go func() { defer utilruntime.HandleCrash() for watchEvent := range watcher.ResultChan() { event, ok := watchEvent.Object.(*v1.Event) if !ok { // This is all local, so there's no reason this should // ever happen. continue } eventHandler(event) } }() return watcher } 其中 watcher.ResultChan 方法就拿到了事件,这里是在一个goroutine中通过func (m *Broadcaster) loop() ==>func (m *Broadcaster) distribute(event Event) 方法调用将event又写入了broadcasterWatcher.result 主要看下 StartRecordingToSink 提供的的eventHandler, recordToSink 方法: func recordToSink(sink EventSink, event *v1.Event, eventCorrelator *EventCorrelator, sleepDuration time.Duration) { // Make a copy before modification, because there could be multiple listeners. // Events are safe to copy like this. eventCopy := *event event = &eventCopy result, err := eventCorrelator.EventCorrelate(event) if err != nil { utilruntime.HandleError(err) } if result.Skip { return } tries := 0 for { if recordEvent(sink, result.Event, result.Patch, result.Event.Count > 1, eventCorrelator) { break } tries++ if tries >= maxTriesPerEvent { klog.Errorf("Unable to write event '%#v' (retry limit exceeded!)", event) break } // Randomize the first sleep so that various clients won't all be // synced up if the master goes down. // 第一次重试增加随机性,防止 apiserver 重启的时候所有的事件都在同一时间发送事件 if tries == 1 { time.Sleep(time.Duration(float64(sleepDuration) * rand.Float64())) } else { time.Sleep(sleepDuration) } } } 其中event被经过了一个 eventCorrelator.EventCorrelate(event) 方法做预处理,主要是聚合相同的事件(避免产生的事件过多,增加 etcd 和 apiserver 的压力,也会导致查看 pod 事件很不清晰) 下面一个for循环就是在进行重试,最大重试次数是12次,调用 recordEvent 方法才真正将event写入到了apiserver。 事件处理 我们来看下EventCorrelate方法: // EventCorrelate filters, aggregates, counts, and de-duplicates all incoming events func (c *EventCorrelator) EventCorrelate(newEvent *v1.Event) (*EventCorrelateResult, error) { if newEvent == nil { return nil, fmt.Errorf("event is nil") } aggregateEvent, ckey := c.aggregator.EventAggregate(newEvent) observedEvent, patch, err := c.logger.eventObserve(aggregateEvent, ckey) if c.filterFunc(observedEvent) { return &EventCorrelateResult{Skip: true}, nil } return &EventCorrelateResult{Event: observedEvent, Patch: patch}, err } 分别调用了 aggregator.EventAggregate , logger.eventObserve , filterFunc 三个方法,分别作用是: aggregator.EventAggregate:聚合event,如果在最近 10 分钟出现过 10 个相似的事件(除了 message 和时间戳之外其他关键字段都相同的事件),aggregator 会把它们的 message 设置为 (combined from similar events)+event.Message logger.eventObserve:它会把相同的事件以及包含 aggregator 被聚合了的相似的事件,通过增加 Count 字段来记录事件发生了多少次。 filterFunc: 这里实现了一个基于令牌桶的限流算法,如果超过设定的速率则丢弃,保证了apiserver的安全。 我们主要来看下aggregator.EventAggregate方法: func (e *EventAggregator) EventAggregate(newEvent *v1.Event) (*v1.Event, string) { now := metav1.NewTime(e.clock.Now()) var record aggregateRecord // eventKey is the full cache key for this event //eventKey 是将除了时间戳外所有字段结合在一起 eventKey := getEventKey(newEvent) // aggregateKey is for the aggregate event, if one is needed. //aggregateKey 是除了message和时间戳外的字段结合在一起,localKey 是message aggregateKey, localKey := e.keyFunc(newEvent) // Do we have a record of similar events in our cache? e.Lock() defer e.Unlock() //从cache中根据aggregateKey查询是否存在,如果是相同或者相类似的事件会被放入cache中 value, found := e.cache.Get(aggregateKey) if found { record = value.(aggregateRecord) } //判断上次事件产生的时间是否超过10分钟,如何操作则重新生成一个localKeys集合(集合中存放message) maxInterval := time.Duration(e.maxIntervalInSeconds) * time.Second interval := now.Time.Sub(record.lastTimestamp.Time) if interval > maxInterval { record = aggregateRecord{localKeys: sets.NewString()} } // Write the new event into the aggregation record and put it on the cache //将locakKey也就是message放入集合中,如果message相同就是覆盖了 record.localKeys.Insert(localKey) record.lastTimestamp = now e.cache.Add(aggregateKey, record) // If we are not yet over the threshold for unique events, don't correlate them //判断localKeys集合中存放的类似事件是否超过10个, if uint(record.localKeys.Len()) < e.maxEvents { return newEvent, eventKey } // do not grow our local key set any larger than max record.localKeys.PopAny() // create a new aggregate event, and return the aggregateKey as the cache key // (so that it can be overwritten.) eventCopy := &v1.Event{ ObjectMeta: metav1.ObjectMeta{ Name: fmt.Sprintf("%v.%x", newEvent.InvolvedObject.Name, now.UnixNano()), Namespace: newEvent.Namespace, }, Count: 1, FirstTimestamp: now, InvolvedObject: newEvent.InvolvedObject, LastTimestamp: now, //这里会对message加个前缀:(combined from similar events): Message: e.messageFunc(newEvent), Type: newEvent.Type, Reason: newEvent.Reason, Source: newEvent.Source, } return eventCopy, aggregateKey } aggregator.EventAggregate方法中其实就是判断了通过cache和localKeys判断事件是否相似,如果最近 10 分钟出现过 10 个相似的事件就合并并加上前缀,后续通过logger.eventObserve方法进行count累加,如果message也相同,肯定就是直接count++。 总结 好了,event处理的整个流程基本就是这样,我们可以概括一下,可以结合文中的图对比一起看下: 创建 EventRecorder 对象,通过其提供的 Event 等方法,创建好event对象 将创建出来的对象发送给 EventBroadcaster 中的channel中 EventBroadcaster 通过后台运行的goroutine,从管道中取出事件,并广播给提前注册好的handler处理 当输出log的handler收到事件就直接打印事件 当 EventSink handler收到处理事件就通过预处理之后将事件发送给apiserver 其中预处理包含三个动作,1、限流 2、聚合 3、计数 apiserver收到事件处理之后就存储在etcd中 回顾event的整个流程,可以看到event并不是保证100%事件写入(从预处理的过程来看),这样做是为了后端服务etcd的可用性,因为event事件在整个集群中产生是非常频繁的,尤其在服务不稳定的时候,而相比Deployment,Pod等其他资源,又没那么的重要。所以这里做了个取舍。 参考文档: https://cizixs.com/2017/06/22/kubelet-source-code-analysis-part4-event/ 关注公众号,获取最新文章推送

优秀的个人博客,低调大师

java线程池使用(二)------部分源码解析

前一篇博客介绍了构造参数分别是什么意思现在介绍java线程池源码1 init线程池初始化,代码比较简单 public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) { if (corePoolSize < 0 || //核心线程数校验 maximumPoolSize <= 0 || //非核心线程数校验 maximumPoolSize < corePoolSize || keepAliveTime < 0) throw new IllegalArgumentException(); if (workQueue == null || threadFactory == null || handler == null) //必传参数校验 throw new NullPointerException(); this.acc = System.getSecurityManager() == null ? null : AccessController.getContext(); this.corePoolSize = corePoolSize; this.maximumPoolSize = maximumPoolSize; this.workQueue = workQueue; this.keepAliveTime = unit.toNanos(keepAliveTime); this.threadFactory = threadFactory; this.handler = handler; } 2 线程池核心类Worker 线城池中,使用Worker来保证线程池线程的活跃,保证在没有任务执行时,也能保证线程资源不被释放掉woker类实现了runable接口,本身就是一个线程 private final class Worker extends AbstractQueuedSynchronizer implements Runnable { private static final long serialVersionUID = 6138294804551838833L; //worker运行的线程,是线程池中实际的线程,通过ThreadFactory生成 final Thread thread; //线程池新增线程时的默认任务,可以为空 Runnable firstTask; //已经执行过的线程任务数 volatile long completedTasks; Worker(Runnable firstTask) { setState(-1); // inhibit interrupts until runWorker this.firstTask = firstTask; this.thread = getThreadFactory().newThread(this); } //将执行方法委托给ThreadPoolExecuter public void run() { runWorker(this); } // Lock methods // // The value 0 represents the unlocked state. // The value 1 represents the locked state. protected boolean isHeldExclusively() { return getState() != 0; } protected boolean tryAcquire(int unused) { if (compareAndSetState(0, 1)) { setExclusiveOwnerThread(Thread.currentThread()); return true; } return false; } protected boolean tryRelease(int unused) { setExclusiveOwnerThread(null); setState(0); return true; } public void lock() { acquire(1); } public boolean tryLock() { return tryAcquire(1); } public void unlock() { release(1); } public boolean isLocked() { return isHeldExclusively(); } void interruptIfStarted() { Thread t; if (getState() >= 0 && (t = thread) != null && !t.isInterrupted()) { try { t.interrupt(); } catch (SecurityException ignore) { } } } } 3 线程池新增任务 下面看源码核心方法1 ThreadPoolExecuter.execute() public void execute(Runnable command) { if (command == null) throw new NullPointerException(); int c = ctl.get(); //判断当前线程数量和最大核心线程数 if (workerCountOf(c) < corePoolSize) {//线程数<最大核心线程数 if (addWorker(command, true))//尝试创建新的worker,如果创建成功则直接返回 return; c = ctl.get();//获取最新的的数量 } if (isRunning(c) && workQueue.offer(command)) {//1 检查线程池状态 //2当前线程数>=最大核心线程数。 //3尝试将新增的线程放入blockingqueue int recheck = ctl.get(); //对线程池状态进行二次校验,防止其他线程在offer期间对线程池状态进行了修改 if (! isRunning(recheck) && remove(command)) //二次校验,失败后将新增线程从blockingqueue移除 //二次校验成功则不移除,利用java&&的特性 reject(command); //校验失败进入过载策略 else if (workerCountOf(recheck) == 0) //二次校验成功,判断当前线程池线程数量是否归零, //如果归零,则创建新的空worker,由worker去进行处理queue //中的任务 addWorker(null, false); } else if (!addWorker(command, false))//如果queue.offer返回false,证明queue已经满了, // 尝试创建非核心线程 reject(command); //创建失败则证明已经到达最大线程数,进去过载策略 } 2 核心方法二 ThreadPoolExecuter.addWorker() private boolean addWorker(Runnable firstTask, boolean core) { retry: for (;;) { int c = ctl.get(); int rs = runStateOf(c);//获取当前线程池状态 // Check if queue empty only if necessary. if (rs >= SHUTDOWN && ! (rs == SHUTDOWN && firstTask == null && ! workQueue.isEmpty())) return false; for (;;) { int wc = workerCountOf(c); if (wc >= CAPACITY || wc >= (core ? corePoolSize : maximumPoolSize)) return false; if (compareAndIncrementWorkerCount(c)) break retry; c = ctl.get(); // Re-read ctl if (runStateOf(c) != rs) continue retry; // else CAS failed due to workerCount change; retry inner loop } } boolean workerStarted = false; boolean workerAdded = false; Worker w = null; try { w = new Worker(firstTask); final Thread t = w.thread; if (t != null) { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { // Recheck while holding lock. // Back out on ThreadFactory failure or if // shut down before lock acquired. int rs = runStateOf(ctl.get()); if (rs < SHUTDOWN || (rs == SHUTDOWN && firstTask == null)) { if (t.isAlive()) // precheck that t is startable throw new IllegalThreadStateException(); workers.add(w); int s = workers.size(); if (s > largestPoolSize) largestPoolSize = s; workerAdded = true; } } finally { mainLock.unlock(); } if (workerAdded) { t.start(); workerStarted = true; } } } finally { if (! workerStarted) addWorkerFailed(w); } return workerStarted; }

优秀的个人博客,低调大师

云计算解析:告诉你如何选择云

随着云计算技术的快速发展和普及,越来越多的机构通过采用云服务的方式来搭建网站及服务器。 为了方便不同需求的用户,很多云计算服务商都会提供很多形式的云服务,这里面比较常见的就是公有云、私有云以及混合云,品牌有腾讯云、阿里云等,还有些服务商会提供社群云(社区云)等。那么这些云计算的形式有什么区别呢?用户又该如何选择呢? 1、公有云 公有云是为广大用户、个人或企业提供的云基础设施。公有云就是第三方的公有云供应商为用户提供可通过互联网访问的虚拟环境中的服务器空间。用户可以通过购买云服务器、数据存储和其他与云相关的服务等公有云服务来访问这些服务器。 在公有云中,所有硬件、软件和其他支持性基础结构均为云提供商所拥有和管理。 在公有云中,你与其他组织或云“租户”共享相同的硬件、存储和网络设备。你可以使用 Web 浏览器访问服务和管理帐户。公有云部署通常用于提供基于 Web 的电子邮件、网上办公应用、存储以及测试和开发环境。 公有云非常适合计算能力需求有波动的企业或专门面向公众的应用程序。 公有云优势: 成本更低 — 无需购买硬件或软件,仅对使用的服务付费。 无需维护 — 维护由服务提供商提供。 近乎无限制的缩放性 — 提供按需资源,可满足业务需求。 高可靠性 — 具备众多服务器,确保免受故障影响。 由于担心公有云的安全性、私密性等问题。于是就有了私有云。 2、私有云 私有云是云计算的另一种形式。它为一个企业或组织提供专用的云环境。私有云可以由企业或组织内部的IT团队在该组织的防火墙后面进行内部操作,因此组织可以更好地控制其计算资源。私有云主要由企业使用,因此它也被视为一种企业云。 私有云可在物理上位于组织的现场数据中心,也可由第三方服务提供商托管。在私有云中,服务和基础结构始终在私有网络上进行维护,硬件和软件专供组织使用。 私有云可使组织更加方便地自定义资源,从而满足特定的 IT 需求。 私有云的使用对象通常为政府机构、金融机构以及其他具备业务关键性运营且希望对环境拥有更大控制权的中型到大型组织。 私有云优势: 灵活性更高 — 组织可自定义云环境以满足特定业务需求。 安全性更高 — 资源不与其他组织共享,从而可实现更高控制性和安全性级别。 缩放性更高 — 私有云仍然具有公有云的缩放性和效率。 但是私有云的费用相对较高, 并且维护成本也不低。结合了公有云和私有云的优势推出了混合云。 3、混合云 混合云是一种云计算模型,它通过安全连接(如VPN连接或租用线路)组合一个或多个公有云和私有云环境,从而允许在不同云环境之间共享数据和应用程序。当在私有云上运行的应用程序遇到使用高峰时,它们可以自动“突发”到公有云环境以获得额外的按需容量。这被称为“云爆发”。由于额外的需求将在公有云上,无需担心提前配置硬件以满足高峰需求。连接公有云和私有云有两种方法:VPN和点对点专用连接。 混合云通常被认为是“两全其它将本地基私有云与公有云相结合,组织可利用这两者的优势。在混合云中,数据和应用程序可在私有云和公有云之间移动,从而可提供更大灵活性和更多部署选项。 混合云优势: 控制性 — 组织可针对敏感资产维持私有基础结构。 灵活性 — 需要时可利用公有云中的其他资源。 成本效益 — 具备扩展至公有云的能力,因此可仅在需要时支付额外的计算能力。 容易轻松 — 无需费时费力即可转换至云,因为可根据时间按工作负荷逐步迁移。 混合云整合了公有云和公有云的优势。它提供高可扩展性,几乎无限的存储空间,灵活的支付模式,并且与公有云一样具有成本效益。混合云也非常安全;它为您提供了更多的灵活性和对云资源的控制。 4、社群云 社群云,也称社区云,是由几个组织共享的云端基础设施,它们支持特定的社群,有共同的关切事项,例如使命任务、安全需求、策略与法规遵循考量等。管理者可能是组织本身,也能是第三方;管理位置可能在组织内部,也可能在组织外部。 社群云在模式和机制、可靠性、安全、组织管理等方面面临挑战,有待进一步解决。社群云与私有云、公有云相比模式上复杂一些,由多个组织共同构建和共享云设施。 5、总结 公有云、私有云、混合云以及社群云的主要区别就是使用的人群和使用的方式不一样: 公有云由公众开放使用 私有云由单一组织独占使用 混合云则是前述的两种以上模式的混合 社群云是由一个特定社区独占使用,该社区由具有共同关切 (如使命、安全要求、政策等) 的多个组织组成 使用场景区别: 公有云部署通常用于提供基于 Web 的电子邮件、网上办公应用、存储以及测试和开发环境。 私有云的使用对象通常为政府机构、金融机构以及其他具备业务关键性运营且希望对环境拥有更大控制权的中型到大型组织。 混合云的使用对象通常由大流量的互联网业务,同时部分业务有合规需求或者需要充分利用现有IT资产的企业或组织 社群云的使用对象通常是多个有密切关系的组织一起联合使用。 在选择的时候,应该根据实际情况,选择最适合自己的云服务。

优秀的个人博客,低调大师

Dubbo源码解析实战 - 负载均衡算法LoadBalance

1 简介 本篇尽量用一些简单的数学式子和流程图和大家一起梳理一下这些集群容错算法. 2 灵魂拷问 谈谈dubbo中的负载均衡算法及特点 最小活跃数算法中是如何统计这个活跃数的 简单谈谈你对一致性哈希算法的认识 3 接口的继承体系 4 RandomLoadBalance(随机) 随机,按权重设置随机概率在一个截面上碰撞的概率高,但调用量越大分布越均匀,而且按概率使用权重后也比较均匀,有利于动态调整提供者权重。 默认策略,但是这个随机和我们理解上的随机还是不一样的,因为他还有个概念叫weight(权重),就是用来控制这个随机的概率的,我们来看代码实现. package org.apache.dubbo.rpc.cluster.loadbalance; import org.apache.dubbo.common.URL; import org.apac

优秀的个人博客,低调大师

JVM常见面试题解析

总结了JVM一些经典面试题,分享出我自己的解题思路,希望对大家有帮助,有哪里你觉得不正确的话,欢迎指出,后续有空会更新。 1.什么情况下会发生栈内存溢出。思路:描述栈定义,再描述为什么会溢出,再说明一下相关配置参数,OK的话可以给面试官手写是一个栈溢出的demo。 我的答案: 栈是线程私有的,他的生命周期与线程相同,每个方法在执行的时候都会创建一个栈帧,用来存储局部变量表,操作数栈,动态链接,方法出口等信息。 局部变量表又包含基本数据类型,对象引用类型如果线程请求的栈深度大于虚拟机所允许的最大深度,将抛出StackOverflowError异常,方法递归调用产生这种结果。如果Java虚拟机栈可以动态扩展,并且扩展的动作已经尝试过,但是无法申请到足够的内存去完成扩展,或者在新建立线程的时候没有足够的内存去创建对应的虚拟机栈,那么Java虚拟机将抛出一个OutOfMemory 异常。 (线程启动过多)参数 -Xss 去调整JVM栈的大小2.详解JVM内存模型思路:给面试官画一下JVM内存模型图,并描述每个模块的定义,作用,以及可能会存在的问题,如栈溢出等。 我的答案: JVM内存结构 程序计数器: 当前线程所执行的字节码的行号指示器,用于记录正在执行的虚拟机字节指令地址,线程私有。 Java虚拟栈: 存放基本数据类型、对象的引用、方法出口等,线程私有。 Native方法栈: 和虚拟栈相似,只不过它服务于Native方法,线程私有。 Java堆: java内存最大的一块,所有对象实例、数组都存放在java堆,GC回收的地方,线程共享。 方法区: 存放已被加载的类信息、常量、静态变量、即时编译器编译后的代码数据等。 (即永久带),回收目标主要是常量池的回收和类型的卸载,各线程共享 3.JVM内存为什么要分成新生代,老年代,持久代。 新生代中为什么要分为Eden和Survivor。思路: 先讲一下JAVA堆,新生代的划分,再谈谈它们之间的转化,相互之间一些参数的配置(如: –XX:NewRatio,–XX:SurvivorRatio等),再解释为什么要这样划分,最好加一点自己的理解。 我的答案: 1)共享内存区划分共享内存区 = 持久带 + 堆持久带 = 方法区 + 其他Java堆 = 老年代 + 新生代新生代 = Eden + S0 + S12)一些参数的配置默认的,新生代 ( Young ) 与老年代 ( Old ) 的比例的值为 1:2 ,可以通过参数 –XX:NewRatio 配置。默认的,Edem : from : to = 8 : 1 : 1 ( 可以通过参数 –XX:SurvivorRatio 来设定)Survivor区中的对象被复制次数为15(对应虚拟机参数 -XX:+MaxTenuringThreshold)3)为什么要分为Eden和Survivor?为什么要设置两个Survivor区?如果没有Survivor,Eden区每进行一次Minor GC,存活的对象就会被送到老年代。 老年代很快被填满,触发Major GC.老年代的内存空间远大于新生代,进行一次Full GC消耗的时间比Minor GC长得多,所以需要分为Eden和Survivor。Survivor的存在意义,就是减少被送到老年代的对象,进而减少Full GC的发生,Survivor的预筛选保证,只有经历16次Minor GC还能在新生代中存活的对象,才会被送到老年代。设置两个Survivor区最大的好处就是解决了碎片化,刚刚新建的对象在Eden中,经历一次Minor GC,Eden中的存活对象就会被移动到第一块survivor space S0,Eden被清空; 等Eden区再满了,就再触发一次Minor GC,Eden和S0中的存活对象又会被复制送入第二块survivor space S1(这个过程非常重要,因为这种复制算法保证了S1中来自S0和Eden两部分的存活对象占用连续的内存空间,避免了碎片化的发生) JVM中一次完整的GC流程是怎样的,对象如何晋升到老年代思路:先描述一下Java堆内存划分,再解释Minor GC,Major GC,full GC,描述它们之间转化流程。 我的答案: Java堆 = 老年代 + 新生代新生代 = Eden + S0 + S1当 Eden 区的空间满了, Java虚拟机会触发一次 Minor GC,以收集新生代的垃圾,存活下来的对象,则会转移到 Survivor区。大对象(需要大量连续内存空间的Java对象,如那种很长的字符串) 直接进入老年态 ;如果对象在Eden出生,并经过第一次Minor GC后仍然存活,并且被Survivor容纳的话,年龄设为1,每熬过一次Minor GC,年龄+1, 若年龄超过一定限制(15),则被晋升到老年态 。即 长期存活的对象进入老年态 。老年代满了而 无法容纳更多的对象 ,Minor GC 之后通常就会进行Full GC,Full GC 清理整个内存堆 – 包括年轻代和年老代 。Major GC 发生在老年代的GC , 清理老年区 ,经常会伴随至少一次Minor GC, 比Minor GC慢10倍以上 。5.你知道哪几种垃圾收集器,各自的优缺点,重点讲下cms和G1,包括原理,流程,优缺点。思路:一定要记住典型的垃圾收集器,尤其cms和G1,它们的原理与区别,涉及的垃圾回收算法。 我的答案: 1)几种垃圾收集器:Serial收集器:单线程的收集器,收集垃圾时,必须stop the world,使用复制算法。ParNew收集器:Serial收集器的多线程版本,也需要stop the world,复制算法。Parallel Scavenge收集器: 新生代收集器,复制算法的收集器,并发的多线程收集器,目标是达到一个可控的吞吐量。 如果虚拟机总共运行100分钟,其中垃圾花掉1分钟,吞吐量就是99%。Serial Old收集器:是Serial收集器的老年代版本,单线程收集器,使用标记整理算法。Parallel Old收集器:是Parallel Scavenge收集器的老年代版本,使用多线程,标记-整理算法。CMS(Concurrent Mark Sweep) 收集器:是一种以获得最短回收停顿时间为目标的收集器, 标记清除算法,运作过程:初始标记,并发标记,重新标记,并发清除 ,收集结束会产生大量空间碎片。G1收集器: 标记整理算法实现, 运作流程主要包括以下:初始标记,并发标记,最终标记,筛选标记 。 不会产生空间碎片,可以精确地控制停顿。2)CMS收集器和G1收集器的区别:CMS收集器是老年代的收集器,可以配合新生代的Serial和ParNew收集器一起使用;G1收集器收集范围是老年代和新生代,不需要结合其他收集器使用;CMS收集器以最小的停顿时间为目标的收集器;G1收集器可预测垃圾回收的停顿时间CMS收集器是使用“标记-清除”算法进行的垃圾回收,容易产生内存碎片G1收集器使用的是“标记-整理”算法,进行了空间整合,降低了内存空间碎片。6.简单说说你了解的类加载器,可以打破双亲委派么,怎么打破。思路:先说明一下什么是类加载器,可以给面试官画个图,再说一下类加载器存在的意义,说一下双亲委派模型,最后阐述怎么打破双亲委派模型。 我的答案: 1) 什么是类加载器?类加载器就是根据指定全限定名称将class文件加载到JVM内存,转为Class对象。 启动类加载器(Bootstrap ClassLoader): 由C++语言实现(针对HotSpot),负责将存放在lib目录或-Xbootclasspath参数指定的路径中的类库加载到内存中。其他类加载器: 由Java语言实现,继承自抽象类ClassLoader。 如:扩展类加载器(Extension ClassLoader): 负责加载libext目录或java.ext.dirs系统变量指定的路径中的所有类库。应用程序类加载器(Application ClassLoader)。 负责加载用户类路径(classpath)上的指定类库,我们可以直接使用这个类加载器。 一般情况,如果我们没有自定义类加载器默认就是用这个加载器。2)双亲委派模型双亲委派模型工作过程是: 如果一个类加载器收到类加载的请求,它首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器完成。 每个类加载器都是如此,只有当父加载器在自己的搜索范围内找不到指定的类时(即ClassNotFoundException),子加载器才会尝试自己去加载。 双亲委派模型图: 3)为什么需要双亲委派模型?在这里,先想一下,如果没有双亲委派,那么用户是不是可以 自己定义一个java.lang.Object的同名类 , java.lang.String的同名类 ,并把它放到ClassPath中,那么 类之间的比较结果及类的唯一性将无法保证 ,因此,为什么需要双亲委派模型? 防止内存中出现多份同样的字节码 4)怎么打破双亲委派模型?打破双亲委派机制则不仅 要继承ClassLoader 类,还要 重写loadClass和findClass 方法。 7.怎么打出线程栈信息。思路:可以说一下jps,top ,jstack这几个命令,再配合一次排查线上问题进行解答。 我的答案: 输入jps,获得进程号。top -Hp pid 获取本进程中所有线程的CPU耗时性能jstack pid命令查看当前java进程的堆栈状态或者 jstack -l > /tmp/output.txt 把堆栈信息打到一个txt文件。可以使用fastthread 堆栈定位,http://fastthread.io/需要java学习路线图的私信笔者“java”领取哦!另外喜欢这篇文章的可以给笔者点个赞同,关注一下,每天都会分享Java相关文章!还有不定时的福利赠送,包括整理的学习资料,面试题,源码等~~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册