首页 文章 精选 留言 我的

精选列表

搜索[博客搭建],共10000篇文章
优秀的个人博客,低调大师

【博客大赛】基于百度飞桨paddlepaddle的疫情可视化实战

百度paddlepaddle安装及疫情可视化实战 1. paddle安装可以参考官方文档 地址链接: https://www.paddlepaddle.org.cn/install/quick选择合适自己的方式进行安装 2. 疫情数据可视化 思路:通过爬虫得到数据并且通过pyecharts进行可视化 爬取丁香园公开的统计数据 上网的全过程: 普通用户打开浏览器 --> 往目标站点发送请求 --> 接收响应数据 --> 渲染到页面上。 爬虫程序模拟浏览器 --> 往目标站点发送请求 --> 接收响应数据 --> 提取有用的数据 --> 保存到本地/数据库。 爬虫的过程: 1.发送请求(requests模块) 2.获取响应数据(服务器返回) 3.解析并提取数据(re正则) 4.保存数据 我们用到了:request模块: requests是python实现的简单易用的HTTP库,官网地址:http://cn.python-requests.org/zh_CN/latest/ re模块: re模块是python用于匹配字符串的模块,该模块中提供的很多功能是基于正则表达式实现的, import json import re import requests import datetime today = datetime.date.today().strftime('%Y%m%d') #20200315 def crawl_dxy_data(): """ 爬取丁香园实时统计数据,保存到data目录下,以当前日期作为文件名,存JSON文件 """ response = requests.get('https://ncov.dxy.cn/ncovh5/view/pneumonia') #request.get()用于请求目标网站 print(response.status_code) # 打印状态码 try: url_text = response.content.decode() #更推荐使用response.content.deocde()的方式获取响应的html页面 #print(url_text) url_content = re.search(r'window.getAreaStat = (.*?)}]}catch', #re.search():扫描字符串以查找正则表达式模式产生匹配项的第一个位置 ,然后返回相应的match对象。 url_text, re.S) #在字符串a中,包含换行符\n,在这种情况下:如果不使用re.S参数,则只在每一行内进行匹配,如果一行没有,就换下一行重新开始; #而使用re.S参数以后,正则表达式会将这个字符串作为一个整体,在整体中进行匹配。 texts = url_content.group() #获取匹配正则表达式的整体结果 content = texts.replace('window.getAreaStat = ', '').replace('}catch', '') #去除多余的字符 json_data = json.loads(content) with open('data/' + today + '.json', 'w', encoding='UTF-8') as f: json.dump(json_data, f, ensure_ascii=False) except: print('<Response [%s]>' % response.status_code) def crawl_statistics_data(): """ 获取各个省份历史统计数据,保存到data目录下,存JSON文件 """ with open('data/'+ today + '.json', 'r', encoding='UTF-8') as file: json_array = json.loads(file.read()) statistics_data = {} for province in json_array: response = requests.get(province['statisticsData']) try: statistics_data[province['provinceShortName']] = json.loads(response.content.decode())['data'] except: print('<Response [%s]> for url: [%s]' % (response.status_code, province['statisticsData'])) with open("data/statistics_data.json", "w", encoding='UTF-8') as f: json.dump(statistics_data, f, ensure_ascii=False) if __name__ == '__main__': crawl_dxy_data() crawl_statistics_data() 运行以上代码,我们需要在代码同目录下创建data文件夹运行成功后,在data文件夹下能够得到两个文件分别是:statistics_data.json和一个今天日期的json 安装第三方库pyecharts Echarts 是一个由百度开源的数据可视化工具,凭借着良好的交互性,精巧的图表设计,得到了众多开发者的认可。而 Python 是一门富有表达力的语言,很适合用于数据处理。当数据分析遇上数据可视化时,pyecharts 诞生了。pyecharts api可以参考:https://pyecharts.org/#/zh-cn/chart_api 使用 options 配置项,在 pyecharts 中,一切皆 Options。 主要分为全局配置组件和系列配置组件。 (1)系列配置项 set_series_opts(),可配置图元样式、文字样式、标签样式、点线样式等; (2)全局配置项 set_global_opts(),可配置标题、动画、坐标轴、图例等; pyecharts非常好用!!!我们通过pip安装 pip install -i https://pypi.tuna.tsinghua.edu.cn/simple pyecharts 如果下载时出现断线和速度过慢的问题导致下载失败,可以尝试使用其他国内源当出现Successfully installed pyecharts-1.7.1 simplejson-3.17.0时我们就安装成功了 数据可视化地图 全国地图 import json import datetime from pyecharts.charts import Map from pyecharts import options as opts # 读原始数据文件 today = datetime.date.today().strftime('%Y%m%d') #20200315 datafile = 'data/'+ today + '.json' with open(datafile, 'r', encoding='UTF-8') as file: json_array = json.loads(file.read()) # 分析全国实时确诊数据:'confirmedCount'字段 china_data = [] for province in json_array: china_data.append((province['provinceShortName'], province['confirmedCount'])) china_data = sorted(china_data, key=lambda x: x[1], reverse=True) #reverse=True,表示降序,反之升序 print(china_data) # 全国疫情地图 # 自定义的每一段的范围,以及每一段的特别的样式。 pieces = [ {'min': 10000, 'color': '#540d0d'}, {'max': 9999, 'min': 1000, 'color': '#9c1414'}, {'max': 999, 'min': 500, 'color': '#d92727'}, {'max': 499, 'min': 100, 'color': '#ed3232'}, {'max': 99, 'min': 10, 'color': '#f27777'}, {'max': 9, 'min': 1, 'color': '#f7adad'}, {'max': 0, 'color': '#f7e4e4'}, ] labels = [data[0] for data in china_data] counts = [data[1] for data in china_data] m = Map() m.add("累计确诊", [list(z) for z in zip(labels, counts)], 'china') #系列配置项,可配置图元样式、文字样式、标签样式、点线样式等 m.set_series_opts(label_opts=opts.LabelOpts(font_size=12), is_show=False) #全局配置项,可配置标题、动画、坐标轴、图例等 m.set_global_opts(title_opts=opts.TitleOpts(title='全国实时确诊数据', subtitle='数据来源:丁香园'), legend_opts=opts.LegendOpts(is_show=False), visualmap_opts=opts.VisualMapOpts(pieces=pieces, is_piecewise=True, #是否为分段型 is_show=True)) #是否显示视觉映射配置 #render()会生成本地 HTML 文件,默认会在当前目录生成 render.html 文件,也可以传入路径参数,如 m.render("mycharts.html") m.render(path='./data/数据.html') 这里代码都有完善的注释,就不拆解来讲了 ### 数据可视化湖北省地图 ```python import json import datetime from pyecharts.charts import Map from pyecharts import options as opts # 读原始数据文件 today = datetime.date.today().strftime('%Y%m%d') #20200315 datafile = 'data/'+ today + '.json' with open(datafile, 'r', encoding='UTF-8') as file: json_array = json.loads(file.read()) # 分析湖北省实时确诊数据 # 读入规范化的城市名称,用于规范化丁香园数据中的城市简称 with open('/home/aistudio/data/data24815/pycharts_city.txt', 'r', encoding='UTF-8') as f: defined_cities = [line.strip() for line in f.readlines()] def format_city_name(name, defined_cities): for defined_city in defined_cities: if len((set(defined_city) & set(name))) == len(name): name = defined_city if name.endswith('市') or name.endswith('区') or name.endswith('县') or name.endswith('自治州'): return name return name + '市' return None province_name = '湖北' for province in json_array: if province['provinceName'] == province_name or province['provinceShortName'] == province_name: json_array_province = province['cities'] hubei_data = [(format_city_name(city['cityName'], defined_cities), city['confirmedCount']) for city in json_array_province] hubei_data = sorted(hubei_data, key=lambda x: x[1], reverse=True) print(hubei_data) labels = [data[0] for data in hubei_data] counts = [data[1] for data in hubei_data] pieces = [ {'min': 10000, 'color': '#540d0d'}, {'max': 9999, 'min': 1000, 'color': '#9c1414'}, {'max': 999, 'min': 500, 'color': '#d92727'}, {'max': 499, 'min': 100, 'color': '#ed3232'}, {'max': 99, 'min': 10, 'color': '#f27777'}, {'max': 9, 'min': 1, 'color': '#f7adad'}, {'max': 0, 'color': '#f7e4e4'}, ] m = Map() m.add("累计确诊", [list(z) for z in zip(labels, counts)], '湖北') m.set_series_opts(label_opts=opts.LabelOpts(font_size=12), is_show=False) m.set_global_opts(title_opts=opts.TitleOpts(title='湖北省实时确诊数据', subtitle='数据来源:丁香园'), legend_opts=opts.LegendOpts(is_show=False), visualmap_opts=opts.VisualMapOpts(pieces=pieces, is_piecewise=True, is_show=True)) m.render(path='./data/湖北省数据.html') 增长趋势 on from pyecharts.charts import Line from pyecharts import options as opts # 读原始数据文件 datafile = 'data/statistics_data.json' with open(datafile, 'r', encoding='UTF-8') as file: json_dict = json.loads(file.read()) # 分析各省份2月1日至今的新增确诊数据:'confirmedIncr' statistics__data = {} for province in json_dict: statistics__data[province] = [] for da in json_dict[province]: if da['dateId'] >= 20200201: statistics__data[province].append(da['confirmedIncr']) # 获取日期列表 dateId = [str(da['dateId'])[4:6] + '-' + str(da['dateId'])[6:8] for da in json_dict['湖北'] if da['dateId'] >= 20200201] # 全国新增趋势 all_statis = np.array([0] * len(dateId)) for province in statistics__data: all_statis = all_statis + np.array(statistics__data[province]) all_statis = all_statis.tolist() # 湖北新增趋势 hubei_statis = statistics__data['湖北'] # 湖北以外的新增趋势 other_statis = [all_statis[i] - hubei_statis[i] for i in range(len(dateId))] line = Line() line.add_xaxis(dateId) line.add_yaxis("全国新增确诊病例", #图例 all_statis, #数据 is_smooth=True, #是否平滑曲线 linestyle_opts=opts.LineStyleOpts(width=4, color='#B44038'),#线样式配置项 itemstyle_opts=opts.ItemStyleOpts(color='#B44038', #图元样式配置项 border_color="#B44038", #颜色 border_width=10)) #图元的大小 line.add_yaxis("湖北新增确诊病例", hubei_statis, is_smooth=True, linestyle_opts=opts.LineStyleOpts(width=2, color='#4E87ED'), label_opts=opts.LabelOpts(position='bottom'), #标签在折线的底部 itemstyle_opts=opts.ItemStyleOpts(color='#4E87ED', border_color="#4E87ED", border_width=3)) line.add_yaxis("其他省份新增病例", other_statis, is_smooth=True, linestyle_opts=opts.LineStyleOpts(width=2, color='#F1A846'), label_opts=opts.LabelOpts(position='bottom'), #标签在折线的底部 itemstyle_opts=opts.ItemStyleOpts(color='#F1A846', border_color="#F1A846", border_width=3)) line.set_global_opts(title_opts=opts.TitleOpts(title="新增确诊病例", subtitle='数据来源:丁香园'), yaxis_opts=opts.AxisOpts(max_=16000, min_=1, type_="log", #坐标轴配置项 splitline_opts=opts.SplitLineOpts(is_show=True),#分割线配置项 axisline_opts=opts.AxisLineOpts(is_show=True)))#坐标轴刻度线配置项 line.render(path='./data/趋势图.html') 需要自己完成的饼状图 import json import datetime from pyecharts.charts import Map, Pie from pyecharts import options as opts # 读原始数据文件 today = datetime.date.today().strftime('%Y%m%d') #20200315 datafile = 'data/'+ today + '.json' with open(datafile, 'r', encoding='UTF-8') as file: json_array = json.loads(file.read()) # 分析全国实时确诊数据:'confirmedCount'字段 china_data = [] for province in json_array: china_data.append((province['provinceShortName'], province['confirmedCount'])) china_data = sorted(china_data, key=lambda x: x[1], reverse=True) #reverse=True,表示降序,反之升序 print(china_data) labels = [data[0] for data in china_data] counts = [data[1] for data in china_data] m = Pie(init_opts=opts.InitOpts(height='900px')) m.add("累计确诊", [list(z) for z in zip(labels, counts)], center=["50%", "60%"], radius=['0%', '40%']) #,)center=[100,50] m.set_series_opts(label_opts=opts.LabelOpts(formatter="{b}: {c}", font_size=12), is_show=False) #全局配置项,可配置标题、动画、坐标轴、图例等 m.set_global_opts(title_opts=opts.TitleOpts(title='全国实时确诊数据', subtitle='数据来源:丁香园'), legend_opts=opts.LegendOpts(is_show=False, type_="scroll", pos_left="80%", orient="vertical"), ) #render()会生成本地 HTML 文件,默认会在当前目录生成 render.html 文件,也可以传入路径参数,如 m.render("mycharts.html") m.render(path='./data/饼状图.html') over!!!

优秀的个人博客,低调大师

【博客大赛】【实战】k8s中长连接服务负载不均衡问题分析

一、概述 本文针对我们生产上出现的流量不均的问题,深层次地分析问题产生原因,对其中的一些机制做一些介绍。 k8s是一个特别复杂的系统,而网络相关的问题是其中最复杂的问题,要通过一两篇文章介绍清楚是很难的。这个流量不均的问题出现的原因并不复杂,就是因为kube-proxy使用了iptables做负载均衡,而它是以概率的方式转发,使用长连接且连接数较少时,偏差会比较大。虽然原因不复杂,但是我们希望能把这其中的整个流程和原理梳理清楚,在介绍过程中,同时介绍一些底层的东西,但是不会太深入。 二、背景介绍 本章主要介绍一些相关的背景,包括出问题的系统,生产上的现象等。 2.1 生产问题描述 出问题的系统是一个以Dubbo服务为基础的应用,日交易量近2000万,在生产上部署到了k8s集群中,发现集群里的Pod流量不均衡,而且差异很大,甚至有时候到了9比1的流量比,有的pod日交易量接近千万,有的还不到一百万,由于交易本身比较快,未造成严重后果。 在默认情况下,Dubbo的消费者会与每一个生产者建立一个长连接,之后的请求都通过这个长连接发送,底层基于Netty实现IO多路复用,即使单个连接也能实现高效传输。消费者在客户端实现负载均衡,轮询向每个连接发送请求,出现流量不均,应该就是KubeProxy做了二次负载均衡导致。 2.2 Dubbo协议适配容器的问题与解决办法 默认情况下,Dubbo服务的提供者把本机地址发布到zk上,消费者通过订阅zk,获取提供者的地址信息,在客户端进行负载均衡,调用提供者。 但是,当服务提供者在容器内的时候,它发布的地址是POD的地址,除非消费者也在k8s中,否则没法访问这个地址。在我们将传统应用向云上迁移时,不可避免的会有云外的应用访问云上的应用,所以这个问题必须要解决。 新版的Dubbo里提供了四个配置用来指定要发布的地址和端口,可以从环境变量或者properties里取。因为我们用的Dubbo版本较老,没实现这个功能,所以自己添加了这个功能。 DUBBO_IP_TO_REGISTRY: 要发布到注册中心上的地址 DUBBO_PORT_TO_REGISTRY: 要发布到注册中心上的端口 DUBBO_IP_TO_BIND: 要绑定的服务地址(监听的地址) DUBBO_PORT_TO_BIND: 要绑定的服务端口 通过在Deployment的yaml文件中指定前面两个环境变量,即可让Dubbo发布指定的地址和端口。 env: - name: DUBBO_IP_TO_REGISTRY valueFrom: fieldRef: fieldPath: status.hostIP - name: DUBBO_PORT_TO_REGISTRY value: "30001" status.hostIP是k8s提供的一个机制,可以在pod启动的时候把宿主机的IP拿到并传到pod的环境变量里,对于端口的话,就需要指定一个,这里我们用的就是Service的NodePort。 Pod的IP和端口,最终是需要映射到宿主机的IP和一个端口,所以我们使用这种机制,对IP和端口进行替换就行了。这样有一个问题就是,如果有些宿主机上面不止一个Pod,就会发布同样的地址和端口,但是这样对于Dubbo来说是没问题的,相当于这个宿主机的流量有多份,比如下面我发布的一个示例。 到此,我们已经基本上解决了Dubbo应用上云的问题,接下来介绍上云后遇到的问题与分析。 三、流量不均问题分析与验证 本章将会详细分析流量是如何在k8s流转的,太底层的简单介绍。 3.1 流量是如何流转的 要分析流量不均的问题,就需要知道流量是怎么走的。 在k8s中,网络问题是一个最复杂的问题,但是不是每个人都需要完整掌握这些内容,对于大部分开发人员来说,需要知道基本原理。 3.1.1 k8s网络模型-解决集群内部的互联互通 k8s的网络联通方式有很多种,但是都有一个规范,需要满足如下条件: 集群中所有Pod都有一个唯一的IP,都可以与所有其他Pod通信,而无需使用网络地址转换(NAT)。 所有Node都可以在没有NAT的情况下与所有Pod通信。 Pod看到自己的IP就是其他人看到的IP。 图片说明: 一个k8s集群,下面个Node,上面是Node上起的Pod 对于k8s集群,Node是物理节点,它们在一个可以互相访问的网络。真正对外提供服务的单元,是Pod,其实也可以把它们看作一些小虚拟机,每个Pod都有自己的IP,一般跟Node不处于一个网段。 基于前述的网络模型,对于上图中的一个集群,Node对Pod是包含的关系,每个Pod都运行在一个Node上,但是,在网络上,它们可以看作是不通的实体,有唯一的IP,而且这个网络中的实体都可以互相通信,而不必经过NAT。 以上我们说的是集群内部,当一个Pod要访问外部的IP地址的时候,一般是要经过NAT的。 图片说明:Pod访问外部,要经过SNAT,把源地址替换成Node的地址 要实现上述规范,有多种方式,比如通过配置复杂的路由信息,通过Overlay网络等,不同的公司和组织对网络解决方案的需求不一样,所以Kubernetes没有把方案固化在系统中,而是通过接口的形式,让使用者自己去选择实现方式,这个接口就是CNI(Container Network Interface)。 图片说明:kubelet创建Pod时会调用具体的CNI插件 每个Node上面都有一个kubelet进程,用于接收Api Server的指令,创建Pod,这时候它会根据安装的CNI的插件去给容器创建网络,同样,k8s对于容器的创建,也是基于插件的,叫CRI(Container Runtime Interface),虽然我们主要有docker,但是还有rkt等其它实现。 一般要实现CNI,有以下几种方式,比较常用的比如flannel,此处不再详细介绍底层原理。 3.1.2 KubeProxy-解决外部访问内部POD 先说明一下,此处说KubeProxy解决了外部访问内部Pod,并不确切,只是为了与上面集群内部互联互通对应。KubeProxy是K8s里一个非常重要的组件,虽然解决外部访问内部的Pod并不完全靠它,但是它在每种方式里都起了很大作用。 k8s对外提供服务,靠的是Service,Service是k8s里最核心的概念,它把符合某一些特征的Pod组合起来,通过负载均衡的方式对外服务。 比如我们定义下面一个nginx的Service,会把存在标签app:nginx的pod选出来,作为一个服务对外提供。Service不关系Pod是怎么创建的,这些Pod有可能是单独创建的,有可能是Deployment,StatefulSet,DaemonSet等,Service只关心Pod是否有这个标签。 其中targetPort是Pod暴漏的端口,port是给ClusterIP暴漏的端口,nodePort是主机上暴漏的端口。 apiVersion: v1 kind: Service metadata: name: nginx-service spec: type: NodePort selector: app: nginx ports: - protocol: TCP port: 8080 targetPort: 80 nodePort: 30008 创建后,有一个Service, k8s@kube-master1:~$ kubectl get service NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 530d nginx-service NodePort 10.100.33.163 <none> 8080:30008/TCP 12m 它有4个Pod k8s@kube-master1:~$ kubectl get pod -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES nginx-deployment-85ff79dd56-26w6p 1/1 Running 0 8m15s 10.244.3.33 node3 <none> <none> nginx-deployment-85ff79dd56-dbv58 1/1 Running 0 8m15s 10.244.1.47 node1 <none> <none> nginx-deployment-85ff79dd56-gtr7x 1/1 Running 0 8m15s 10.244.2.29 node2 <none> <none> nginx-deployment-85ff79dd56-jn6q2 1/1 Running 0 8m15s 10.244.2.30 node2 <none> <none> 接下来,我们以这个Service来为例介绍后面的内容,这个集群是我在本地打的一个集群,3个Node的地址分别是192.168.174.51/52/53。 k8s@kube-master1:~$ kubectl get node NAME STATUS ROLES AGE VERSION kube-master1 Ready master 532d v1.16.2 node1 Ready <none> 532d v1.16.2 node2 Ready <none> 532d v1.16.2 node3 Ready <none> 532d v1.16.2 每个Node上面,有一个KubeProxy,负责对一个Service的多个Pod做转发和负载均衡,保存着每个服务对应的Pod以及它的TargetPort,称为EndPoint,这个信息是随着Service中的Pod变化而动态变化的,所有信息保存到集中的etcd中。 KubeProxy根据这些信息进行负载均衡。 即使有的Node上没有服务对应的Pod,它的Kube-Proxy也能实现这个服务的跨Node的转发 因此,要访问一个Service,其实就是访问KubeProxy,它会将请求转发到该Service下的所有pod,而且不只是本机的Pod,整个集群中的Pod都可以转发,前面的网络模型介绍过了,Node跟所有的Pod都是相通的。 那么怎么访问KubeProxy呢? 有如下几种方式 3.2.2.1 ClusterIP ClusterIP是专门让集群内部访问Service的方法,因为每个服务都能通过Node本机的Kube-Proxy访问,所以其它Pod调用本机的Kube-Proxy即可。 但是,假设我们写了一个应用,部署到k8s上,要调用一个集群内的Service,对于开发人员来说,“配置为本机地址”, 这个是不好配置的,所以,k8s就发明了ClusterIP这个概念,它是一个虚拟的IP,通过这个IP就可以访问Service,这个IP是不存在的,ping不通,但是可以telnet(不通的模式不一样,有的模式能ping通)。 它的实现原理是什么呢?通过iptables的转发规则,将这个IP对应的端口的请求,转发到本机的Kube-Proxy即可(注:这个例子是iptables转发的)。 -A KUBE-SERVICES -d 10.100.33.163/32 -p tcp -m comment --comment "default/nginx-service: cluster IP" -m tcp --dport 8080 -j KUBE-SVC-GKN7Y2BSGW4NJTYL 看这个iptables规则,就是把目标地址10.100.33.163,端口为8080的tcp请求,转发到KUBE-SVC-GKN7Y2BSGW4NJTYL这个规则上,这个规则就是kube-proxy的一种实现,是专门转发到这个服务的。 所以,集群内任意一个Node或者Pod使用ClusterIP访问这个服务的时候,直接被转发到了本机的Kube-Proxy,进而实现了负载均衡。 3.1.2.2 NodePort ClusterIP解决了内部访问的问题,那外部访问呢?大部分网络模型实现,Pod的地址对外是不可见的,所以外部是没法直接调用Pod的IP和端口的,那就只能通过开放Node的端口来实现对内的访问,也就是NodePort。 对于一个服务,如果要使用NodePort方式访问,那么它需要占一个端口,所有Node上的端口都被这个服务占用,比如前面的nginx服务,使用了30008端口,用任意一个Node的地址加上这个30008端口,就可以访问这个Service。 KubeProxy会监听这个端口,并且将这个端口对应的请求转发到后面的Pod上。 注:此处的“监听”,或者“listen”,并不合适,只是看上去像监听,就拿我创建的这个服务为例,它其实是跟前面ClusterIP是一样的,有条iptables规则,可以看到标红的,是把NodePort和ClusterIP都转发到同一个规则上,也就是kube-proxy上,下面会详细介绍。 这时候KubeProxy保存的信息包含了NodePort的信息。 使用这种方式会有以下两个问题: 调用者不能访问固定IP,需要自己做负载均衡 只能使用 30000-32767这些端口,端口有限且管理麻烦(可以修改端口范围) 那就又衍生出两种模式,Loadbalancer和Ingress,因为这两种方式与KubeProxy关系不大,不再赘述,简述原理。 Loadbalancer模式 Loadbalancer模式虽然k8s提供了接口,但是没提供实现,因为需要外部的负载均衡,一般在公有云上会提供Loadbalancer,在私有云上,我们也可以自己实现Loadbalancer模式,比如前面挂载一个F5。 Ingress模式 端口有限,且不好管理,能不能扩展一下呢?可以通过域名的方式区分不同的服务,而不是端口,比如mb.cmbc.com.cn:8080转发到mb-service,per.cmbc.com.cn:8080转发到per-service,nginx是有这个能力根据域名转发到不通的服务上的,我们可以依赖nginx实现这个功能。虽然我创建的这个服务是nginx的,但是Ingress是在我们的服务之上又部署了一层nginx(除了nginx,还可通过其它方式实现)。 本质上,Ingress就是基于NodePort做的一个nginx的Service,但是这一层nginx是由k8s管理的,它能动态修改nginx的配置。 比如我们新建了一个Service,它对应两个Pod如上图所示,端口是28080,要通过Ingress的方式对外开放,域名是mb.cmbc.com.cn,这时候会创建nginx的pod,它的配置文件被写成了下面的样子。 upstream mbservice { server 172.16.1.4:28080; server 172.16.1.5:28080; } server { listen 80; server_name mb.cmbc.com.cn; location / { #root html; #index index.html index.htm; proxy_pass http://mbservice; proxy_connect_timeout 2s; } 这个配置文件随着Pod的变化,能动态更新并加载。 这样相当于对外就是一个nginx服务,它在做内部服务的转发,我们还可以加一个perservice在这个nginx上,这样的话其实只占用一个端口就行,但是必须用域名访问。Ingress还解决了一个会话保持的问题,因为KubeProxy只能使用ip-hash做会话保持,而nginx可以基于cookie做会话保持。 现在已经解决了访问服务的问题,接下来看Kube-Proxy如何做服务的转发和负载均衡。 3.1.3 KubeProxy的实现 KubeProxy并不一定是一个实际存在的实体,它也可能是一组规则,KubeProxy有三种实现:userspace, iptables和ipvs,接下来分别介绍。 3.1.3.1 userspace userspace,名字就能看出来,是用户空间的实现,它是真正的要起一个进程,监听端口,并且在这个进程内做路由转发和负载均衡,原理上很简单,但是它的效率太低,早已经被k8s抛弃了。 使用userspace模式,在最好的情况下,用户进程读到网络数据,什么也不操作,直接转发,也需要两次数据复制,只要用户空间的进程稍微操作下,就需要更多的内存复制,性能太差。图片说明:假设用户进程完全不操作,基本上不太可能 既然有了userspace模式,也就有kernelspace模式,它能减少内存复制,大大提高效率。 图片说明: 使用基于内核的转发,效率会提高很多 内核模式的转发就是iptables和ipvs。 3.1.3.2 iptables和ipvs 这俩其实都是依赖的一个共同的Linux内核模块:Netfilter。Netfilter是Linux 2.4.x引入的一个子系统,它作为一个通用的、抽象的框架,提供一整套的hook函数的管理机制,使得诸如数据包过滤、网络地址转换(NAT)和基于协议类型的连接跟踪成为了可能。Netfilter的架构就是在整个网络流程的若干位置放置了一些检测点(HOOK),而在每个检测点上登记了一些处理函数进行处理。图片说明:Netfilter的Hook点 在一个网络包进入Linux网卡后,有可能经过这上面五个Hook点,我们可以自己写Hook函数,注册到任意一个点上,而iptables和ipvs都是在这个基础上实现的。 iptables是把一些特定规则以“链”的形式挂载到每个Hook点,这些链的规则是固定的,而是是比较通用的,可以通过iptables命令在用户层动态的增删,这些链必须串行的执行。执行到某条规则,如果不匹配,则继续执行下一条,如果匹配,根据规则,可能继续向下执行,也可能跳到某条规则上,也可能下面的规则都跳过。 相比于iptables,ipvs更聚焦,它是专门做负载均衡的,其实ipvs就是著名的LVS(Linux Virtual Server)的底层实现,它仅在部分hook点增加了自己的处理函数,对报文做一些转换与处理,可以通过ipvsadm命令在用户层进行修改。 它们俩依赖的都是同一个内核功能,而且也能实现一些相同的功能,但是差别很是挺大的: 1.iptables更通用,主要是应用在防火墙上,也能应用于路由转发等功能,ipvs更聚焦,它只能做负载均衡,不能实现其它的例如防火墙上。 2.iptables在处理规则时,是按“链”逐条匹配,如果规则过多,性能会变差,它匹配规则的复杂度是O(n),而ipvs处理规则时,在专门的模块内处理,查找规则的复杂度是O(1) 3.iptables虽然可以实现负载均衡,但是它的策略比较简单,只能以概率转发,而ipvs可以实现多种策略。 3.1.3.2.1 使用iptables实现Kube-Proxy转发 我们以前面的服务为例,说明iptables如何实现转发。 用iptables-save命令,可以查看当前所有的iptables规则,涉及到k8s的比较多,基本在每个链上都有,包括一些SNAT的,就是Pod访问外部的地址的时候,需要做一下NAT转换,我们只看涉及到Service负载均衡的。 首先,PREROUTING和OUTPUT都加了一个KUBE-SERVICES规则,也就是进来的包和出去的包都要都走一下KUBE-SERVICES规则 -A PREROUTING -m comment --comment "kubernetes service portals" -j KUBE-SERVICES -A OUTPUT -m comment --comment "kubernetes service portals" -j KUBE-SERVICES 然后是目标地址是10.100.33.163.32并且目标端口是8080的,也就是这个服务的ClusterIP,走到KUBE-SVC-GKN7Y2BSGW4NJTYL规则,这个规则其实就是Kube-Proxy。 -A KUBE-SERVICES -d 10.100.33.163/32 -p tcp -m comment --comment "default/nginx-service: cluster IP" -m tcp --dport 8080 -j KUBE-SVC-GKN7Y2BSGW4NJTYL 然后在KUBE-SERVICES下,还有个NodePort的规则,NodePort规则里有个针对30008的端口,也转发到KUBE-SVC-GKN7Y2BSGW4NJTYL -A KUBE-SERVICES -m comment --comment "kubernetes service nodeports; NOTE: this must be the last rule in this chain" -m addrtype --dst-type LOCAL -j KUBE-NODEPORTS -A KUBE-NODEPORTS -p tcp -m comment --comment "default/nginx-service:" -m tcp --dport 30008 -j KUBE-SVC-GKN7Y2BSGW4NJTYL 综上,不管是ClusterIP,还是NodePort,都走到了同一个规则上。 然后我们来看最重要的KUBE-SVC-GKN7Y2BSGW4NJTYL,它以不同的概率走到了不同的规则,这些规则最终走到了Pod里,这就是负载均衡策略。 -A KUBE-SVC-GKN7Y2BSGW4NJTYL -m statistic --mode random --probability 0.25000000000 -j KUBE-SEP-TAGWFRUUPZNGX64Q -A KUBE-SVC-GKN7Y2BSGW4NJTYL -m statistic --mode random --probability 0.33332999982 -j KUBE-SEP-EB5WVJVEKQXCINKS -A KUBE-SVC-GKN7Y2BSGW4NJTYL -m statistic --mode random --probability 0.50000000000 -j KUBE-SEP-IBEEHXV54CXNZAW6 -A KUBE-SVC-GKN7Y2BSGW4NJTYL -j KUBE-SEP-7U2SPH2FG4WIXRDV -A KUBE-SEP-EB5WVJVEKQXCINKS -p tcp -m tcp -j DNAT --to-destination 10.244.2.29:80 -A KUBE-SEP-TAGWFRUUPZNGX64Q -p tcp -m tcp -j DNAT --to-destination 10.244.1.47:80 -A KUBE-SEP-IBEEHXV54CXNZAW6 -p tcp -m tcp -j DNAT --to-destination 10.244.2.30:80 -A KUBE-SEP-7U2SPH2FG4WIXRDV -p tcp -m tcp -j DNAT --to-destination 10.244.3.33:80 如果我们把这个负载均衡用图画出来,就比较好看了。 因为这个链是串行的,所以每条链上被选中的概率不一样,但是最终,每个Pod被选中的概率是一样的。 3.1.3.2.2 使用ipvs进行转发 可以使用ipvsadm在用户空间查看和操作ipvs规则。把k8s的proxy模式改成ipvs后,重启了nginx服务,Pod的IP已经变了,Service的不会变。 k8s@kube-master1:~$ kubectl get service NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 531d nginx-service NodePort 10.100.33.163 <none> 8080:30008/TCP 45h k8s@kube-master1:~$ kubectl get pod -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES nginx-deployment-85ff79dd56-cznpb 1/1 Running 0 24m 10.244.2.36 node2 <none> <none> nginx-deployment-85ff79dd56-kj8bv 1/1 Running 0 24m 10.244.3.39 node3 <none> <none> nginx-deployment-85ff79dd56-mljg8 1/1 Running 0 24m 10.244.1.51 node1 <none> <none> nginx-deployment-85ff79dd56-t2cgj 1/1 Running 0 24m 10.244.3.38 node3 <none> <none> 由于ipvs的hook是在INPUT那,所以必须让流量走到INPUT链,需要把ClusterIP绑定到一个本地网络设备上,也就是下面的kube-ipvs0,多个服务的话就会绑定多个,每个Node都有一个这个设备,这个IP称为VIP(Virtual IP,此处不再详细介绍): k8s@node1:~$ ip a | grep ipvs 4: kube-ipvs0: <BROADCAST,NOARP> mtu 1500 qdisc noop state DOWN group default inet 10.96.0.10/32 brd 10.96.0.10 scope global kube-ipvs0 inet 10.96.0.1/32 brd 10.96.0.1 scope global kube-ipvs0 inet 10.100.33.163/32 brd 10.100.33.163 scope global kube-ipvs0 ------- k8s@node2:~$ ip a | grep ipvs 4: kube-ipvs0: <BROADCAST,NOARP> mtu 1500 qdisc noop state DOWN group default inet 10.96.0.10/32 brd 10.96.0.10 scope global kube-ipvs0 inet 10.96.0.1/32 brd 10.96.0.1 scope global kube-ipvs0 inet 10.100.33.163/32 brd 10.100.33.163 scope global kube-ipvs0 只要走到了INPUT上,就能走到ipvs的负载均衡模块,我们用ipvsadm查看转发规则。 k8s@node1:~$ sudo ipvsadm -Ln IP Virtual Server version 1.2.1 (size=4096) Prot LocalAddress:Port Scheduler Flags -> RemoteAddress:Port Forward Weight ActiveConn InActConn ...省略... TCP 192.168.174.51:30008 rr -> 10.244.1.51:80 Masq 1 0 0 -> 10.244.2.36:80 Masq 1 0 0 -> 10.244.3.38:80 Masq 1 0 0 -> 10.244.3.39:80 Masq 1 0 0 ...省略... TCP 10.100.33.163:8080 rr -> 10.244.1.51:80 Masq 1 0 0 -> 10.244.2.36:80 Masq 1 0 0 -> 10.244.3.38:80 Masq 1 0 0 -> 10.244.3.39:80 Masq 1 0 0 ...省略... 可以看到,到ClusterIP:Port和NodePort的流量,都被以rr(round robin)的策略转发到4个pod上。 ipvs也需要跟iptables结合使用,还有一些SNAT等规则,此处不再详细介绍,但是介绍一个概念ipset。我们会看到有这样一条规则: -A KUBE-NODE-PORT -p tcp -m comment --comment "Kubernetes nodeport TCP port for masquerade purpose" -m set --match-set KUBE-NODE-PORT-TCP dst -j KUBE-MARK-MASQ 这条规则是用来将所有的NodePort的流量做SNAT的,但是不需要每个NodePort加一条规则,而是用了一个match-set,就是包含在某个集合内的流量都要走这个规则,这个集合就是ipset。 k8s@node1:~$ sudo ipset list KUBE-NODE-PORT-TCP Name: KUBE-NODE-PORT-TCP Type: bitmap:port Revision: 3 Header: range 0-65535 Size in memory: 8264 References: 1 Number of entries: 1 Members: 30008 这个set是bitmap,效率很高,用来匹配数据包复杂度是O(1)。 再看另一个ipset,这个是ClusterIP的set,使用hash实现的,效率也特别高。 Name: KUBE-CLUSTER-IP Type: hash:ip,port Revision: 5 Header: family inet hashsize 1024 maxelem 65536 Size in memory: 408 References: 2 Number of entries: 5 Members: 10.96.0.1,tcp:443 10.96.0.10,tcp:9153 10.100.33.163,tcp:8080 10.96.0.10,udp:53 10.96.0.10,tcp:53 通过使用ipset的方式,使得iptables的规则数不会随着节点数量增长,能够支持超大规模的集群。 3.2 问题复现与解决 因为Dubbo配置比较复杂,还需要制作镜像,写服务端代码和客户端代码,比较麻烦,所以使用Redis模拟Dubbo的行为,效果是一样的。 Dubbo的服务提供者会主动发布地址到zk上,基于前面的方案,提供者会把Node的地址和NodePort发布出来,Dubbo消费者会在客户端侧做负载均衡,同时,进入kube-proxy后,会再次负载均衡。 这样就会出现一个问题,客户端访问了192.168.174.51,有可能最终在192.168.174.52上执行,这样对于客户端遍历所有服务端的一些操作,就无法进行了。 Dubbo默认的是消费者与每个服务提供者建立一个长连接,然后再客户端对这些长连接使用轮询的策略做负载均衡。我们可以用Redis模拟这个行为,把zk上的地址写死,使用jedis与每个地址建立长连接,然后轮询调用,看看每个pod的流量。 创建一个Redis服务 k8s@kube-master1:~$ kubectl get service NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 531d redis-service NodePort 10.104.6.137 <none> 6379:30001/TCP 24m 它有3个Pod,分别在集群的3个节点上 k8s@kube-master1:~$ kubectl get pod -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES redis-deployment-8687bfc768-5795b 1/1 Running 1 13m 10.244.2.40 node2 <none> <none> redis-deployment-8687bfc768-srps9 1/1 Running 1 13m 10.244.1.54 node1 <none> <none> redis-deployment-8687bfc768-xl2zm 1/1 Running 1 13m 10.244.3.42 node3 <none> <none> 进入到每个实例,分别设置key为pod的值为1,2,3,比如下面先连到第一个pod上设置,依次对3个pod做设置。 k8s@kube-master1:~$ kubectl exec -it redis-deployment-8687bfc768-7lzpl /bin/bash root@redis-deployment-8687bfc768-7lzpl:/data# redis-cli 127.0.0.1:6379> set pod 1 OK 127.0.0.1:6379> get pod "1" 我们让客户端都去get('pod'),根据取到的值的分布,就能知道流量的分布。 我们用jedis模拟一下Dubbo的访问过程,看看流量分配的情况 import java.util.Map; import java.util.concurrent.ConcurrentHashMap; import java.util.concurrent.atomic.AtomicLong; import redis.clients.jedis.Jedis; public class ABC { public static void main(String[] args) throws InterruptedException { /**模拟dubbo发布在zk的地址**/ String[] addrs = {"192.168.174.51","192.168.174.52","192.168.174.53"}; /**模拟6个消费者**/ Thread[] threads = new Thread[6]; /**3个计数器,统计3个Pod的访问次数**/ final Map<String,AtomicLong> map = new ConcurrentHashMap<String,AtomicLong>(); map.put("1", new AtomicLong(0)); map.put("2", new AtomicLong(0)); map.put("3", new AtomicLong(0)); for(int i = 0; i < 6; i++) { threads[i] = new Thread(new Runnable() { @Override public void run() { //每个消费者分别与3个提供者建立单个长连接,与Dubbo一样 Jedis[] jedis = new Jedis[3]; for(int j = 0; j < 3; j++) { jedis[j] = new Jedis(addrs[j], 30001,5000,5000); try { Thread.sleep(100); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } //模拟Dubbo的轮询负载均衡策略 for(int k = 0; k < 300; k++) { String pod = jedis[k%3].get("pod"); map.get(pod).getAndIncrement(); } }}); threads[i].start(); } Thread.sleep(5000); System.out.println(map); } } 多次运行,流量都是不平均的。 如果我们把消费者改成100个,看上去比例还好点 但也是不平均的。 现在我们改成ipvs模式,重启一下。 k8s@kube-master1:~$ kubectl get pod -o wide NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES redis-deployment-8687bfc768-5795b 1/1 Running 0 6m1s 10.244.2.39 node2 <none> <none> redis-deployment-8687bfc768-srps9 1/1 Running 0 6m1s 10.244.1.53 node1 <none> <none> redis-deployment-8687bfc768-xl2zm 1/1 Running 0 6m1s 10.244.3.41 node3 <none> <none> 前面的代码,反复执行,结果都是一样的。 根据这个,我们可以确定,使用iptables的时候,由于在负载均衡的时候使用概率,短链接的时候,交易量大了,能实现负载均衡。但是在长连接的时候,在建立连接的时候是以概率建立的,而一旦建立,之后的请求都会走这个连接,所以如果连接数不多,那么各个Pod的连接数可能差异很大。 四、总结 在传统的架构中,网络关系是很清晰的,或者直连,或者中间有F5或者Nginx等做一次负载均衡,但是上了k8s之后,底层的网络转发是特别复杂的,对于开发者来说,这是透明的,但是出了问题,很多时候,需要了解底层的东西。 在我们传统应用向云上迁移时,由于多年的持续开发,不仅是软件内部架构,以及与外部的交互关系,都比较复杂,在上云的过程中,需要十分谨慎,先用一些比较简单的模块充分验证,摸索经验,再逐步把核心应用迁移到云上。

优秀的个人博客,低调大师

[雪峰磁针石博客]大数据Hadoop工具python教程2-python访问HDFS

https://pypi.org/project/hdfs3 已经不维护PyArrowhttps://pypi.org/project/hdfs/https://pypi.org/project/snakebite/ python2中比较好,对python3支持不好。 hdfs和PyArrow比较常用,这里以hdfs为例: 快速入门 from hdfs import InsecureClient client = InsecureClient('http://localhost:50070', user='hduser_') fs_folders_list = client.list("/") print(fs_folders_list) with client.read('/user/hduser/input.txt', enco

优秀的个人博客,低调大师

[雪峰磁针石博客]python经典面试题:列表和元组有什么异同?

python测试开发项目实战-目录 python工具书籍下载-持续更新 python 3.7极速入门教程 - 目录 列表和元组是Python中最常用的两种数据结构,字典是第三种。 相同点: 都是序列 都可以存储任何数据类型 可以通过索引访问 语法差异 使用方括号[]创建列表,而使用括号()创建元组。 请看以下示例: >>> l = ["https://china-testing.github.io/", "https://www.oscobo.com/"] >>> t = ("https://china-testing.github.io/", "https://www.oscobo.com/") >>> print(l) ['https://china-testing.github.io/', 'https://www.oscobo.com/'] >>> print(t) ('https://china-testing.github.io/', 'https://www.oscobo.com/') >>> print(type(l)) <class 'list'> >>> print(type(t)) <class 'tuple'> 是否可变 列表是可变的,而元组是不可变的,这标志着两者之间的关键差异。 我们可以修改列表的值,但是不修改元组的值。 由于列表是可变的,我们不能将列表用作字典中的key。 但可以使用元组作为字典key。 >>> l[1] = "https://www.jianshu.com/u/69f40328d4f0" >>> l ['https://china-testing.github.io/', 'https://www.jianshu.com/u/69f40328d4f0'] >>> t[1] = "https://www.jianshu.com/u/69f40328d4f0" Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: 'tuple' object does not support item assignment 重用与拷贝 元组无法复制。 原因是元组是不可变的。 如果运行tuple(tuple_name)将返回自己。 >>> copy_t = tuple(t) >>> print(t is copy_t) True >>> copy_l = list(l) >>> print(l is copy_l) False 参考资料 讨论 项目实战讨论QQ群630011153 144081101 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 python工具书籍下载-持续更新 大小差异 Python将低开销的较大的块分配给元组,因为它们是不可变的。 对于列表则分配小内存块。 与列表相比,元组的内存更小。 当你拥有大量元素时,元组比列表快。列表的长度是可变的。 >>> l = ["https://china-testing.github.io/", "https://www.oscobo.com/"] >>> t = ("https://china-testing.github.io/", "https://www.oscobo.com/") >>> print(l.__sizeof__()) 56 >>> print(t.__sizeof__()) 40 同构与异构 习惯上元组多用于用于存储异构元素,异构元素即不同数据类型的元素,比如(ip,port)。 另一方面,列表用于存储异构元素,这些元素属于相同类型的元素,比如[int1,in2,in3]。

优秀的个人博客,低调大师

[雪峰磁针石博客]python数据结构基础工具书籍下载-持续更新

算法图解 - 2017.pdf 本书示例丰富,图文并茂,以让人容易理解的方式阐释了算法,旨在帮助程序员在日常项目中更好地发挥算法的能量。书中的前三章将帮助你打下基础,带你学习二分查找、大O表示法、两种基本的数据结构以及递归等。余下的篇幅将主要介绍应用广泛的算法,具体内容包括:面对具体问题时的解决技巧,比如,何时采用贪婪算法或动态规划;散列表的应用;图算法;Kzui近邻算法。 数据结构与算法__Python语言描述-2015.pdf 本书基于Python语言介绍了数据结构与算法的基本知识,主要内容包括抽象数据类型和Python面向对象程序设计、线性表、字符串、栈和队列、二叉树和树、集合、排序以及算法的基本知识。本书延续问题求解的思路,从解决问题的目标来组织教学内容,注重理论与实践的并用。 Python算法教程 - 2016.pdf Python是一种面向对象、解释型计算机程序设计语言,其应用领域非常广泛,包括数据分析、自然语言处理、机器学习、科学计算以及推荐系统构建等。 本书用Python语言来讲解算法的分析和设计。本书主要关注经典的算法,但同时会为读者理解基本算法问题和解决问题打下很好的基础。全书共11章。分别介绍了树、图、计数问题、归纳递归、遍历、分解合并、贪心算法、复杂依赖、Dijkstra算法、匹配切割问题以及困难问题及其稀释等内容。本书在每一章结束的时候均有练习题和参考资料,这为读者的自我检查以及进一步学习提供了较多的便利。在全书的结尾,给出了练习题的提示,方便读者进行查漏补缺。 本书概念和知识点讲解清晰,语言简洁。本书适合对Python算法感兴趣的初中级用户阅读和自学,也适合高等院校的计算机系学生作为参考教材来阅读。 参考资料 讨论qq群144081101 591302926 567351477 钉钉免费群21745728 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 Python Data Structures and Algorithms - 2017.pdf Python Algorithms, 2nd Edition 2014.pdf Problem Solving with Algorithms and Data Structures Release 3.0 - 2013.pdf Problem Solving in Data Structures and Algorithms Using Python - 2016.pdf Practical Programming An Introduction to Computer Science Using Python (Pragmatic Programmers) 2009.pdf grokking algorithms - 2016.pdf Fundamentals of Python From First Programs Through Data Structures - 2010.pdf Fundamentals of Python - Data Structures - 2014.pdf Data Structures and Algorithms with Python(Springer,2015).pdf Data Structures and Algorithms Using Python - 2011.pdf Data Structures and Algorithms in Python - 2013.pdf Data Structures And Algorithmic Thinking With Python - 2016.pdf https://github.com/prakhar1989/Algorithms https://github.com/PacktPublishing/Python-Data-Structures-and-Algorithms

优秀的个人博客,低调大师

[雪峰磁针石博客]自动化测试框架pytest教程1-快速入门

第1章 快速入门 什么是pytest? pytest是强大的Python测试工具,它可以用于所有类型和级别的软件测试。 Pytest可以被开发团队,QA团队,独立测试小组,实践TDD的个人和开放源代码项目。实际上,整个互联网上的项目都是从unittest或者nose转向pytest,包括Mozilla和Dropbox。为什么?因为pytest提供强大的功能,如'断言'重写,第三方插件模型,强大但简单的fixture模型。 pytest是软件测试框架,这意味着pytest是命令行工具。它会自动找到你写的测试,运行测试并报告结果。可编写插件或安装第三方来扩展插件。它可以用来测试Python发行版。它很容易与其他工具对接,如持续集成和网页自动化。 Pytest脱颖而出的原因: 简单 易读 用assert来测试失败,而不是self.assertEqua

优秀的个人博客,低调大师

[雪峰磁针石博客]python工具库介绍-dubbo:通过telnet接口访问dubbo服务

## 简介 dubbo服务发布之后,我们可以利用telnet命令进行调试、管理。更多资料参见 [Telnet命令参考手册](http://alibaba.github.io/dubbo-doc-static/Telnet+Command+Reference-zh-showComments=true&showCommentArea=true.htm) telnet 调用示例: ```python $ telnet 172.17.103.110 9097 Trying 172.17.103.110... Connected to 172.17.103.110. Escape character is '^]'. dubbo>ls com.oppo.sso.service.onekey.IOnekeyRegister register dubbo>invoke com.oppo.sso.service.onekey.IOnekeyRegister.register({"applicationKey":"mac","imei":"","mobile":"13244448888","createIP":"127.0.0.1","createBy":"172.17.0.1"}) {"configCountry":null,"userIdLong":0,"appPackage":null,"appVersion":null,"accountName":null,"romVersion":null,"resultCode":3001,"thirdStatus":null,"registerType":0,"sendChannel":null,"operator":null,"manufacturer":null,"password":null,"osVersion":null,"lock":false,"model":null,"visitorLocked":false,"OK":false,"brand":null,"email":null,"createIP":null,"deny":false,"encryptEmail":null,"sessionKey":null,"thirdId":null,"passwordOriginal":null,"mobile":null,"applicationKey":null,"thirdpartyOk":false,"userAgent":null,"userName":null,"resultDesc":"应用不存在","userId":0,"encryptMobile":null,"emailStatus":null,"createBy":null,"freePwd":false,"changeTimes":0,"createTime":null,"mobileStatus":null,"oldLock":false,"codeTimeout":null,"lastUpdate":null,"imei":null,"sessionTimeout":0,"sdkVersion":null,"networkID":0,"status":null} elapsed: 98 ms. dubbo> ``` ## Python实现 源码: ```python """ Name: dubbo.py Tesed in python3.5 """ import json import telnetlib import socket class Dubbo(telnetlib.Telnet): prompt = 'dubbo>' coding = 'utf-8' def __init__(self, host=None, port=0, timeout=socket._GLOBAL_DEFAULT_TIMEOUT): super().__init__(host, port) self.write(b'\n') def command(self, flag, str_=""): data = self.read_until(flag.encode()) self.write(str_.encode() + b"\n") return data def invoke(self, service_name, method_name, arg): command_str = "invoke {0}.{1}({2})".format( service_name, method_name, json.dumps(arg)) self.command(Dubbo.prompt, command_str) data = self.command(Dubbo.prompt, "") data = json.loads(data.decode(Dubbo.coding, errors='ignore').split('\n')[0].strip()) return data if __name__ == '__main__': conn = Dubbo('172.17.103.110', 9097) json_data = { "applicationKey":"mac", "imei":"", "mobile":"13244448888", "createIP":"127.0.0.1", "createBy":"172.17.0.1" } result = conn.invoke( "com.oppo.sso.service.onekey.IOnekeyRegister", "register", json_data ) print(result) ``` 执行结果: ```python # python3 dubbo.py {'manufacturer': None, 'applicationKey': None, 'OK': False, 'codeTimeout': None, 'password': None, 'encryptEmail': None, 'passwordOriginal': None, 'thirdId': None, 'emailStatus': None, 'freePwd': False, 'sessionTimeout': 0, 'createTime': None, 'osVersion': None, 'lastUpdate': None, 'email': None, 'sdkVersion': None, 'registerType': 0, 'sendChannel': None, 'visitorLocked': False, 'createIP': None, 'thirdStatus': None, 'encryptMobile': None, 'networkID': 0, 'resultCode': 3001, 'brand': None, 'changeTimes': 0, 'userAgent': None, 'imei': None, 'operator': None, 'romVersion': None, 'model': None, 'lock': False, 'sessionKey': None, 'configCountry': None, 'deny': False, 'userIdLong': 0, 'resultDesc': '应用不存在', 'status': None, 'createBy': None, 'thirdpartyOk': False, 'appPackage': None, 'appVersion': None, 'accountName': None, 'userId': 0, 'oldLock': False, 'userName': None, 'mobile': None, 'mobileStatus': None} ``` 更复杂的例子。 源码: ```python import json import telnetlib import socket class Dubbo(telnetlib.Telnet): prompt = 'dubbo>' coding = 'gbk' def __init__(self, host=None, port=0, timeout=socket._GLOBAL_DEFAULT_TIMEOUT): super().__init__(host, port) self.write(b'\n') def command(self, flag, str_=""): data = self.read_until(flag.encode()) self.write(str_.encode() + b"\n") return data def invoke(self, service_name, method_name, arg): command_str = "invoke {0}.{1}({2})".format( service_name, method_name, json.dumps(arg)) self.command(Dubbo.prompt, command_str) data = self.command(Dubbo.prompt, "") data = json.loads(data.decode(Dubbo.coding, errors='ignore').split('\n')[0].strip()) return data if __name__ == '__main__': conn = Dubbo('183.131.22.99', 21881) content = { "sign": "FKeKnMEPybHujjBTzz11BrulB5av7pLhJpk=", "partnerOrder": "0511e0d38f334319a96920fa02be02a7", "productDesc": "hello", "paySuccessTime": "2016-08-25 18:33:04", "price": "1", "count": "1", "attach": "from_pay_demo", "date": "20160825", } content_json = json.dumps(content).replace('"', '\\"') json_data = { "requestId": "0511e0d38f334319a96920fa02be02a7", "reqUrl": 'http://www.oppo.com', "httpReqType": "POST", "headerMap": None, "reqContent": content_json, "appId": "10001", "productName": "test", "timeStamp": "1472121184957", "partnerId": "2031", "signType": "MD5", "sign": "23B621FBBF887373C65E553C2222258F", "successResult": "OK", } result = conn.invoke( "com.oppo.pay.notify.api.facade.NotifyApplyService", "httpNotify", json_data ) print(result) ``` 执行结果: ```python $ python3 dubbo.py {'resMsg': 'ǩ', 'data': None, 'errorDetail': 'sign check fail!', 'resCode': '100003', 'success': False} ``` ## 待改进 * 进行多个项目的实验,增加异常处理 ## 参考资料 - [本文最新版本地址](https://china-testing.github.io/python3_lib_dubbo.html) - [本文涉及的python测试开发库](https://github.com/china-testing/python-api-tesing) 谢谢点赞! - [本文相关海量书籍下载](https://github.com/china-testing/python-api-tesing/blob/master/books.md) - [本文源码地址](https://github.com/china-testing/python-api-tesing/tree/master/python3_libraries/_dubbo)

优秀的个人博客,低调大师

[雪峰磁针石博客]python库介绍-argparse: 命令行选项及参数解析

快速入门 argparse是一个完整的参数处理库。参数可以根据add_argument()的action选项触发不同action。支持的action有存储参数(单个,或作为列表的一部分);存储常量的值(对布尔开关true/false有特殊处理)。默认动作是存储参数值。支持type(指定存储类型)和dest(指定存储变量)等参数。 然后使用函数parse_args()进行参数解析,这个函数的输入默认是sys.argv[1:],也可以使用其他字符串列表。选项使用GNU/POSIX语法处理,可以混合选项和参数值。parse_args的返回值是一个包含命令参数的Namespace。所有参数以属性的形式存在,比如args.myoption。 下面是一个简单的示例:argparse_short.py import argparse parser = argparse.ArgumentParser(description='Short sample app') parser.add_argument('-a', action="store_true", default=False) parser.add_argument('-b', action="store", dest="b") parser.add_argument('-c', action="store", dest="c", type=int) print(parser.parse_args(['-a', '-bval', '-c', '3'])) 执行结果: $ python3 argparse_short.py Namespace(a=True, b='val', c=3) 长参数argparse_long.py import argparse parser = argparse.ArgumentParser( description='Example with long option names', ) parser.add_argument('--noarg', action="store_true", default=False) parser.add_argument('--witharg', action="store", dest="witharg") parser.add_argument('--witharg2', action="store", dest="witharg2", type=int) print( parser.parse_args( ['--noarg', '--witharg', 'val', '--witharg2=3'] ) ) 执行结果 $ python3 argparse_long.py Namespace(noarg=True, witharg='val', witharg2=3) 混合可选和必选参数:argparse_arguments.py import argparse parser = argparse.ArgumentParser( description='Example with nonoptional arguments', ) parser.add_argument('count', action="store", type=int) parser.add_argument('units', action="store") print(parser.parse_args()) 执行结果 $ python3 argparse_arguments.py 3 inches Namespace(count=3, units='inches') $ python3 argparse_arguments.py some inches usage: argparse_arguments.py [-h] count units argparse_arguments.py: error: argument count: invalid int value: 'some' $ python3 argparse_arguments.py usage: argparse_arguments.py [-h] count units argparse_arguments.py: error: the following arguments are required: count, units 参数action有: store:默认action模式,存储值到指定变量。store_const:存储值在参数的const部分指定,多用于实现非布尔的命令行flag。store_true / store_false:布尔开关。可以2个参数对应一个变量。append:存储值到列表,该参数可以重复使用。append_const:存储值到列表,存储值在参数的const部分指定。version 输出版本信息然后退出。 下面是各种action的示例:argparse_action.py import argparse parser = argparse.ArgumentParser() parser.add_argument('-s', action='store', dest='simple_value', help='Store a simple value') parser.add_argument('-c', action='store_const', dest='constant_value', const='value-to-store', help='Store a constant value') parser.add_argument('-t', action='store_true', default=False, dest='boolean_t', help='Set a switch to true') parser.add_argument('-f', action='store_false', default=True, dest='boolean_f', help='Set a switch to false') parser.add_argument('-a', action='append', dest='collection', default=[], help='Add repeated values to a list') parser.add_argument('-A', action='append_const', dest='const_collection', const='value-1-to-append', default=[], help='Add different values to list') parser.add_argument('-B', action='append_const', dest='const_collection', const='value-2-to-append', help='Add different values to list') parser.add_argument('--version', action='version', version='%(prog)s 1.0') results = parser.parse_args() print('simple_value = {!r}'.format(results.simple_value)) print('constant_value = {!r}'.format(results.constant_value)) print('boolean_t = {!r}'.format(results.boolean_t)) print('boolean_f = {!r}'.format(results.boolean_f)) print('collection = {!r}'.format(results.collection)) print('const_collection = {!r}'.format(results.const_collection)) 执行结果如下,注意'simple_value'等被自动化转化为大写 $ python3 argparse_action.py -h usage: argparse_action.py [-h] [-s SIMPLE_VALUE] [-c] [-t] [-f] [-a COLLECTION] [-A] [-B] [--version] optional arguments: -h, --help show this help message and exit -s SIMPLE_VALUE Store a simple value -c Store a constant value -t Set a switch to true -f Set a switch to false -a COLLECTION Add repeated values to a list -A Add different values to list -B Add different values to list --version show program's version number and exit $ python3 argparse_action.py -s value simple_value = 'value' constant_value = None boolean_t = False boolean_f = True collection = [] const_collection = [] $ python3 argparse_action.py -c simple_value = None constant_value = 'value-to-store' boolean_t = False boolean_f = True collection = [] const_collection = [] $ python3 argparse_action.py -t simple_value = None constant_value = None boolean_t = True boolean_f = True collection = [] const_collection = [] $ python3 argparse_action.py -f simple_value = None constant_value = None boolean_t = False boolean_f = False collection = [] const_collection = [] $ python3 argparse_action.py -a one -a two -a three simple_value = None constant_value = None boolean_t = False boolean_f = True collection = ['one', 'two', 'three'] const_collection = [] $ python3 argparse_action.py -B -A simple_value = None constant_value = None boolean_t = False boolean_f = True collection = [] const_collection = ['value-2-to-append', 'value-1-to-append'] $ python3 argparse_action.py --version argparse_action.py 1.0 可选前缀 ArgumentParser函数中的选项prefix_chars可以指定前缀。默认使用UNIX风格,命令行使用‘-’作为前缀。可以使用windows的’/’或者其他符号。 argparse_prefix_chars.py import argparse parser = argparse.ArgumentParser( description='Change the option prefix characters', prefix_chars='-+/', ) parser.add_argument('-a', action="store_false", default=None, help='Turn A off', ) parser.add_argument('+a', action="store_true", default=None, help='Turn A on', ) parser.add_argument('//noarg', '++noarg', action="store_true", default=False) print(parser.parse_args()) 执行结果 $ python3 argparse_prefix_chars.py -h usage: argparse_prefix_chars.py [-h] [-a] [+a] [//noarg] Change the option prefix characters optional arguments: -h, --help show this help message and exit -a Turn A off +a Turn A on //noarg, ++noarg $ python3 argparse_prefix_chars.py +a Namespace(a=True, noarg=False) $ python3 argparse_prefix_chars.py -a Namespace(a=False, noarg=False) $ python3 argparse_prefix_chars.py //noarg Namespace(a=None, noarg=True) $ python3 argparse_prefix_chars.py ++noarg Namespace(a=None, noarg=True) $ python3 argparse_prefix_chars.py --noarg usage: argparse_prefix_chars.py [-h] [-a] [+a] [//noarg] argparse_prefix_chars.py: error: unrecognized arguments: --noarg 处理配置文件中的参数 argparse_with_shlex.py import argparse from configparser import ConfigParser import shlex parser = argparse.ArgumentParser(description='Short sample app') parser.add_argument('-a', action="store_true", default=False) parser.add_argument('-b', action="store", dest="b") parser.add_argument('-c', action="store", dest="c", type=int) config = ConfigParser() config.read('argparse_with_shlex.ini') config_value = config.get('cli', 'options') print('Config :', config_value) argument_list = shlex.split(config_value) print('Arg List:', argument_list) print('Results :', parser.parse_args(argument_list)) 其中argparse_with_shlex.ini文件的内容如下: [cli] options = -a -b 2 执行结果 $ python3 argparse_with_shlex.py Config : -a -b 2 Arg List: ['-a', '-b', '2'] Results : Namespace(a=True, b='2', c=None) 上面例子使用了ConfigParser来读取配置,再用shlex来切割参数。也可以通过fromfile_prefix_chars 告知argparse输入参数为文件。 argparse_fromfile_prefix_chars.py import argparse import shlex parser = argparse.ArgumentParser(description='Short sample app', fromfile_prefix_chars='@', ) parser.add_argument('-a', action="store_true", default=False) parser.add_argument('-b', action="store", dest="b") parser.add_argument('-c', action="store", dest="c", type=int) print(parser.parse_args(['@argparse_fromfile_prefix_chars.txt'])) argparse_fromfile_prefix_chars.txt -a -b 2 执行结果 $ python3 argparse_fromfile_prefix_chars.py Namespace(a=True, b='2', c=None) 帮助 自动生成 Argparse会自动生成的帮助和版本信息。ArgumentParser的add_help参数控制帮助的生成,默认是开启。 argparse_with_help.py import argparse parser = argparse.ArgumentParser(add_help=True) parser.add_argument('-a', action="store_true", default=False) parser.add_argument('-b', action="store", dest="b") parser.add_argument('-c', action="store", dest="c", type=int) print(parser.parse_args()) 下例就关闭帮助: argparse_without_help.py import argparse parser = argparse.ArgumentParser(add_help=False) parser.add_argument('-a', action="store_true", default=False) parser.add_argument('-b', action="store", dest="b") parser.add_argument('-c', action="store", dest="c", type=int) print(parser.parse_args()) 执行结果 $ python argparse_with_help.py -h usage: argparse_with_help.py [-h] [-a] [-b B] [-c C] optional arguments: -h, --help show this help message and exit -a -b B -c C $ python argparse_without_help.py -h usage: argparse_without_help.py [-a] [-b B] [-c C] argparse_without_help.py: error: unrecognized arguments: -h 自定义帮助 argparse_custom_help.py import argparse parser = argparse.ArgumentParser(add_help=True) parser.add_argument('-a', action="store_true", default=False) parser.add_argument('-b', action="store", dest="b") parser.add_argument('-c', action="store", dest="c", type=int) print('print_usage output:') parser.print_usage() print() print('print_help output:') parser.print_help() 执行结果 $ python3 argparse_custom_help.py print_usage output: usage: argparse_custom_help.py [-h] [-a] [-b B] [-c C] print_help output: usage: argparse_custom_help.py [-h] [-a] [-b B] [-c C] optional arguments: -h, --help show this help message and exit -a -b B -c C argparse_raw_description_help_formatter.py import argparse parser = argparse.ArgumentParser( add_help=True, formatter_class=argparse.RawDescriptionHelpFormatter, description=""" description not wrapped""", epilog=""" epilog not wrapped""", ) parser.add_argument( '-a', action="store_true", help="""argument help is wrapped """, ) parser.print_help() 执行结果 $ python3 argparse_raw_description_help_formatter.py usage: argparse_raw_description_help_formatter.py [-h] [-a] description not wrapped optional arguments: -h, --help show this help message and exit -a argument help is wrapped epilog not wrapped argparse_raw_text_help_formatter.py import argparse parser = argparse.ArgumentParser( add_help=True, formatter_class=argparse.RawTextHelpFormatter, description=""" description not wrapped""", epilog=""" epilog not wrapped""", ) parser.add_argument( '-a', action="store_true", help="""argument help is not wrapped """, ) parser.print_help() 执行结果 $ python3 argparse_raw_text_help_formatter.py usage: argparse_raw_text_help_formatter.py [-h] [-a] description not wrapped optional arguments: -h, --help show this help message and exit -a argument help is not wrapped epilog not wrapped argparse_metavar_type_help_formatter.py import argparse parser = argparse.ArgumentParser( add_help=True, formatter_class=argparse.MetavarTypeHelpFormatter, ) parser.add_argument('-i', type=int, dest='notshown1') parser.add_argument('-f', type=float, dest='notshown2') parser.print_help() 执行结果 $ python3 argparse_metavar_type_help_formatter.py usage: argparse_metavar_type_help_formatter.py [-h] [-i int] [-f float] optional arguments: -h, --help show this help message and exit -i int -f float 组织解析器 公共解析器:通过父子类来实现。 见argparse_parent_base.py: import argparse parser = argparse.ArgumentParser(add_help=False) parser.add_argument('--user', action="store") parser.add_argument('--password', action="store") argparse_uses_parent.py import argparse import argparse_parent_base parser = argparse.ArgumentParser( parents=[argparse_parent_base.parser], ) parser.add_argument('--local-arg', action="store_true", default=False) print(parser.parse_args()) 注意:父类关闭了help。子类却默认开启了help。执行结果: $ python3 argparse_uses_parent.py -h usage: argparse_uses_parent.py [-h] [--user USER] [--password PASSWORD] [--local-arg] optional arguments: -h, --help show this help message and exit --user USER --password PASSWORD --local-arg 参数冲突 argparse_conflict_handler_resolve.py import argparse parser = argparse.ArgumentParser(conflict_handler='resolve') parser.add_argument('-a', action="store") parser.add_argument('-b', action="store", help='Short alone') parser.add_argument('--long-b', '-b', action="store", help='Long and short together') print(parser.parse_args(['-h'])) 执行结果 $ python3 argparse_conflict_handler_resolve.py usage: argparse_conflict_handler_resolve.py [-h] [-a A] [--long-b LONG_B] optional arguments: -h, --help show this help message and exit -a A --long-b LONG_B, -b LONG_B Long and short together argparse_conflict_handler_resolve2.py、 import argparse parser = argparse.ArgumentParser(conflict_handler='resolve') parser.add_argument('-a', action="store") parser.add_argument('--long-b', '-b', action="store", help='Long and short together') parser.add_argument('-b', action="store", help='Short alone') print(parser.parse_args(['-h'])) 执行结果 $ python3 argparse_conflict_handler_resolve2.py usage: argparse_conflict_handler_resolve2.py [-h] [-a A] [--long-b LONG_B] [-b B] optional arguments: -h, --help show this help message and exit -a A --long-b LONG_B Long and short together -b B Short alone 参数分组 默认有可选参数和必选参数组。 argparse_default_grouping.py import argparse parser = argparse.ArgumentParser(description='Short sample app') parser.add_argument('--optional', action="store_true", default=False) parser.add_argument('positional', action="store") print(parser.parse_args()) 执行结果 $ python3 argparse_default_grouping.py -h usage: argparse_default_grouping.py [-h] [--optional] positional Short sample app positional arguments: positional optional arguments: -h, --help show this help message and exit --optional 前面的用户名和密码就可以分组: argparse_parent_with_group.py import argparse parser = argparse.ArgumentParser(add_help=False) group = parser.add_argument_group('authentication') group.add_argument('--user', action="store") group.add_argument('--password', action="store") argparse_uses_parent_with_group.py import argparse import argparse_parent_with_group parser = argparse.ArgumentParser( parents=[argparse_parent_with_group.parser], ) parser.add_argument('--local-arg', action="store_true", default=False) print(parser.parse_args()) 执行结果 $ python3 argparse_uses_parent_with_group.py -h usage: argparse_uses_parent_with_group.py [-h] [--user USER] [--password PASSWORD] [--local-arg] optional arguments: -h, --help show this help message and exit --local-arg authentication: --user USER --password PASSWORD 互斥选项 使用add_mutually_exclusive_group()可以添加互斥选项: argparse_mutually_exclusive.py import argparse parser = argparse.ArgumentParser() group = parser.add_mutually_exclusive_group() group.add_argument('-a', action='store_true') group.add_argument('-b', action='store_true') print(parser.parse_args()) 执行结果 $ python3 argparse_mutually_exclusive.py -h usage: argparse_mutually_exclusive.py [-h] [-a | -b] optional arguments: -h, --help show this help message and exit -a -b $ python3 argparse_mutually_exclusive.py -a Namespace(a=True, b=False) $ python3 argparse_mutually_exclusive.py -b Namespace(a=False, b=True) $ python3 argparse_mutually_exclusive.py -a -b usage: argparse_mutually_exclusive.py [-h] [-a | -b] argparse_mutually_exclusive.py: error: argument -b: not allowed with argument -a 嵌套解析 argparse_subparsers.py import argparse parser = argparse.ArgumentParser() subparsers = parser.add_subparsers(help='commands') # A list command list_parser = subparsers.add_parser( 'list', help='List contents') list_parser.add_argument( 'dirname', action='store', help='Directory to list') # A create command create_parser = subparsers.add_parser( 'create', help='Create a directory') create_parser.add_argument( 'dirname', action='store', help='New directory to create') create_parser.add_argument( '--read-only', default=False, action='store_true', help='Set permissions to prevent writing to the directory', ) # A delete command delete_parser = subparsers.add_parser( 'delete', help='Remove a directory') delete_parser.add_argument( 'dirname', action='store', help='The directory to remove') delete_parser.add_argument( '--recursive', '-r', default=False, action='store_true', help='Remove the contents of the directory, too', ) print(parser.parse_args()) 执行结果 $ python3 argparse_subparsers.py -h usage: argparse_subparsers.py [-h] {list,create,delete} ... positional arguments: {list,create,delete} commands list List contents create Create a directory delete Remove a directory optional arguments: -h, --help show this help message and exit $ python3 argparse_subparsers.py create -h usage: argparse_subparsers.py create [-h] [--read-only] dirname positional arguments: dirname New directory to create optional arguments: -h, --help show this help message and exit --read-only Set permissions to prevent writing to the directo ry $ python3 argparse_subparsers.py delete -r foo Namespace(dirname='foo', recursive=True) 高级参数处理 可变参数:数字N代表N的参数,?0或者1个参数。*0或者多个参数。+1或者多个参数。 argparse_nargs.py import argparse parser = argparse.ArgumentParser() parser.add_argument('--three', nargs=3) parser.add_argument('--optional', nargs='?') parser.add_argument('--all', nargs='*', dest='all') parser.add_argument('--one-or-more', nargs='+') print(parser.parse_args()) 执行结果 $ python3 argparse_nargs.py -h usage: argparse_nargs.py [-h] [--three THREE THREE THREE] [--optional [OPTIONAL]] [--all [ALL [ALL ...]]] [--one-or-more ONE_OR_MORE [ONE_OR_MORE ...]] optional arguments: -h, --help show this help message and exit --three THREE THREE THREE --optional [OPTIONAL] --all [ALL [ALL ...]] --one-or-more ONE_OR_MORE [ONE_OR_MORE ...] $ python3 argparse_nargs.py Namespace(all=None, one_or_more=None, optional=None, three=None) $ python3 argparse_nargs.py --three usage: argparse_nargs.py [-h] [--three THREE THREE THREE] [--optional [OPTIONAL]] [--all [ALL [ALL ...]]] [--one-or-more ONE_OR_MORE [ONE_OR_MORE ...]] argparse_nargs.py: error: argument --three: expected 3 argument(s) $ python3 argparse_nargs.py --three a b c Namespace(all=None, one_or_more=None, optional=None, three=['a', 'b', 'c']) $ python3 argparse_nargs.py --optional Namespace(all=None, one_or_more=None, optional=None, three=None) $ python3 argparse_nargs.py --optional with_value Namespace(all=None, one_or_more=None, optional='with_value', three=None) $ python3 argparse_nargs.py --all with multiple values Namespace(all=['with', 'multiple', 'values'], one_or_more=None, optional=None, three=None) $ python3 argparse_nargs.py --one-or-more with_value Namespace(all=None, one_or_more=['with_value'], optional=None, three=None) $ python3 argparse_nargs.py --one-or-more with multiple values Namespace(all=None, one_or_more=['with', 'multiple', 'values'], optional=None, three=None) $ python3 argparse_nargs.py --one-or-more usage: argparse_nargs.py [-h] [--three THREE THREE THREE] [--optional [OPTIONAL]] [--all [ALL [ALL ...]]] [--one-or-more ONE_OR_MORE [ONE_OR_MORE ...]] argparse_nargs.py: error: argument --one-or-more: expected at least one argument 参数类型 argparse_type.py import argparse parser = argparse.ArgumentParser() parser.add_argument('-i', type=int) parser.add_argument('-f', type=float) parser.add_argument('--file', type=open) try: print(parser.parse_args()) except IOError as msg: parser.error(str(msg)) 执行结果 $ python3 argparse_type.py -i 1 Namespace(f=None, file=None, i=1) $ python3 argparse_type.py -f 3.14 Namespace(f=3.14, file=None, i=None) $ python3 argparse_type.py --file argparse_type.py Namespace(f=None, file=<_io.TextIOWrapper name='argparse_type.py' mode='r' encoding='UTF-8'>, i=None) $ python3 argparse_type.py -i a usage: argparse_type.py [-h] [-i I] [-f F] [--file FILE] argparse_type.py: error: argument -i: invalid int value: 'a' $ python3 argparse_type.py -f 3.14.15 usage: argparse_type.py [-h] [-i I] [-f F] [--file FILE] argparse_type.py: error: argument -f: invalid float value: '3.14.15' $ python3 argparse_type.py --file does_not_exist.txt usage: argparse_type.py [-h] [-i I] [-f F] [--file FILE] argparse_type.py: error: [Errno 2] No such file or directory: 'does_not_exist.txt' Choices可以指定参数的选项: argparse_choices.py import argparse parser = argparse.ArgumentParser() parser.add_argument( '--mode', choices=('read-only', 'read-write'), ) print(parser.parse_args()) 执行结果 $ python3 argparse_choices.py -h usage: argparse_choices.py [-h] [--mode {read-only,read-write}] optional arguments: -h, --help show this help message and exit --mode {read-only,read-write} $ python3 argparse_choices.py --mode read-only Namespace(mode='read-only') $ python3 argparse_choices.py --mode invalid usage: argparse_choices.py [-h] [--mode {read-only,read-write}] argparse_choices.py: error: argument --mode: invalid choice: 'invalid' (choose from 'read-only', 'read-write') 文件参数 argparse_FileType.py import argparse parser = argparse.ArgumentParser() parser.add_argument('-i', metavar='in-file', type=argparse.FileType('rt')) parser.add_argument('-o', metavar='out-file', type=argparse.FileType('wt')) try: results = parser.parse_args() print('Input file:', results.i) print('Output file:', results.o) except IOError as msg: parser.error(str(msg)) 执行结果 $ python3 argparse_FileType.py -h usage: argparse_FileType.py [-h] [-i in-file] [-o out-file] optional arguments: -h, --help show this help message and exit -i in-file -o out-file $ python3 argparse_FileType.py -i argparse_FileType.py -o tmp_\ file.txt Input file: <_io.TextIOWrapper name='argparse_FileType.py' mode='rt' encoding='UTF-8'> Output file: <_io.TextIOWrapper name='tmp_file.txt' mode='wt' encoding='UTF-8'> $ python3 argparse_FileType.py -i no_such_file.txt usage: argparse_FileType.py [-h] [-i in-file] [-o out-file] argparse_FileType.py: error: argument -i: can't open 'no_such_file.txt': [Errno 2] No such file or directory: 'no_such_file.txt' 自定义action 自定义action是argparse.Action的子类可以处理add_argument中的参数定义相关的参数,并返回一个可调用对象。构造函数会处理参数定义,仅仅需要处理__call__函数。__call__函数中parser代表解释器,namespace用于返回解释结果,value为要处理的参数,option_string用于触发action(对可选参数,永远是None。 argparse_custom_action.py import argparse class CustomAction(argparse.Action): def __init__(self, option_strings, dest, nargs=None, const=None, default=None, type=None, choices=None, required=False, help=None, metavar=None): argparse.Action.__init__(self, option_strings=option_strings, dest=dest, nargs=nargs, const=const, default=default, type=type, choices=choices, required=required, help=help, metavar=metavar, ) print('Initializing CustomAction') for name, value in sorted(locals().items()): if name == 'self' or value is None: continue print(' {} = {!r}'.format(name, value)) print() return def __call__(self, parser, namespace, values, option_string=None): print('Processing CustomAction for {}'.format(self.dest)) print(' parser = {}'.format(id(parser))) print(' values = {!r}'.format(values)) print(' option_string = {!r}'.format(option_string)) # Do some arbitrary processing of the input values if isinstance(values, list): values = [v.upper() for v in values] else: values = values.upper() # Save the results in the namespace using the destination # variable given to our constructor. setattr(namespace, self.dest, values) print() parser = argparse.ArgumentParser() parser.add_argument('-a', action=CustomAction) parser.add_argument('-m', nargs='*', action=CustomAction) results = parser.parse_args(['-a', 'value', '-m', 'multivalue', 'second']) print(results) 执行结果 $ python3 argparse_custom_action.py Initializing CustomAction dest = 'a' option_strings = ['-a'] required = False Initializing CustomAction dest = 'm' nargs = '*' option_strings = ['-m'] required = False Processing CustomAction for a parser = 4315836992 values = 'value' option_string = '-a' Processing CustomAction for m parser = 4315836992 values = ['multivalue', 'second'] option_string = '-m' Namespace(a='VALUE', m=['MULTIVALUE', 'SECOND']) 参考资料 本文相关书籍下载 紧张整理更新中,讨论 钉钉免费群21745728 qq群144081101 567351477 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 英文参考

优秀的个人博客,低调大师

阿里云服务器怎么安装个人博客?安装wordpress程序,创建LAMP环境?

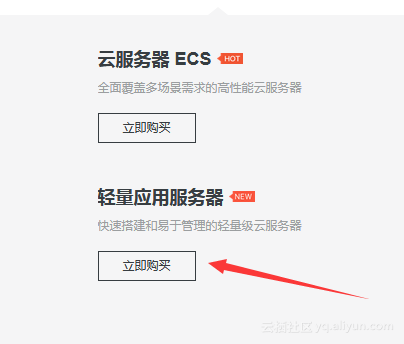
注册域名比较简单,这里就不讲了,直接到阿里云官网注册就行了。 最近阿里云推出了轻量应用型服务器,有一键配置功能,使用方便,1分钟就可以配置了。 注意,请先到阿里云官网 领取幸运券,除了价格上有很多优惠外,还可以参与抽奖。详见:https://promotion.aliyun.com/ntms/act/ambassador/sharetouser.html?userCode=2a7uv47d&utm_source=2a7uv47d 1、登录 阿里云官网,点击:轻量应用服务器,如下图: 2、根据需要选择配置,如下图:(再次提醒一下,购买前请先:领取阿里云幸运券,有很多优惠。)

优秀的个人博客,低调大师

基于minikube快速搭建单节点环境

一、说明 本文主要介绍在 Centos7 环境下基于 Minikube 来快速部署 Kubernetes 单节点集群环境,并在外部访问部署在 k8s 上的 dashboard 服务。 二、Minikube 介绍 Minikube 是一个基于go语言开发,易于在本地运行 Kubernetes 的工具,可在你的笔记本电脑上的虚拟机内轻松创建单机版 Kubernetes 集群,对硬件资源没有太高的要求,非常适合 测试 和 本地开发。 官方文档:https://minikube.sigs.k8s.io/docs/ 架构图: 运作原理: 从 Minikube 的架构中可以看出 master 节点与其它节点合为一体,而整体则通过宿主机上的 kubectl 进行管理,这样可以更加 节省资源。 简单来说就是,用户使用 Minikube CLI 管理虚拟机上的 Kubernetes 环境,比如:启动,停止,删除,获取状态等。一旦 Minikube 虚拟机启动,用户就可以使用熟悉的 Kubectl CLI 在 Kubernetes 集群上执行操作。 三、Minikube安装 3.1. 系统要求 CUP:2核以上 内存:2GB以上 硬盘:需要20G 网络:能连因特网(需要下载安装包), 容器:需要先安装Docker或其他容器。 3.2. 安装前准备 3.2.1. 安装 Docker 安装步骤参考:https://www.runoob.com/docker/centos-docker-install.html docker 的最低建议版本为 20.10.0 以上 配置阿里云加速器:https://cr.console.aliyun.com/cn-shenzhen 启动 docker: systemctl start docker systemctl enable docker.service 3.2.2. 创建新用户 操作 minikube 需要一个具有 root 权限的用户(非root) 需要将该用户添加进入 docker 用户组 添加该用户至 docker 用户组:sudo gpasswd -a 用户名 docker 更新 docker 用户组:newgrp docker 3.3. 部署 切换新创建的用户来操作 minikube,我这里创建的用户为 zlt su zlt 安装步骤参考:https://minikube.sigs.k8s.io/docs/start/ 3.3.1. 安装命令 执行以下2个命令,下载并安装 minikube 命令: curl -LO https://storage.googleapis.com/minikube/releases/latest/minikube-linux-amd64 sudo install minikube-linux-amd64 /usr/local/bin/minikube 执行命令 minikube version 查看版本号: 3.3.2. 启动集群 执行以下命令: minikube start --image-mirror-country='cn' --kubernetes-version=v1.23.8 image-mirror-country 为指定使用国内源 kubernetes-version 指定部署的版本(最新版兼容性坑比较多,所以选择低版本) 执行成功如下图所示: 3.3.3. 验证 执行命令 minikube status 查看状态,结果如下: [zlt@zlt opt]$ minikube status minikube type: Control Plane host: Running kubelet: Running apiserver: Running kubeconfig: Configured 3.3.4. 查看集群状态 可直接使用 minikube 自带的 kubectl 命令。 获取集群所有节点(机器): minikube kubectl get nodes 获取集群所有命名空间: minikube kubectl get namespaces 查看集群所有 Pod: minikube kubectl -- get pods -A 3.3.5. Minikube 常用命令 进入节点服务器: minikube ssh 执行节点服务器命令,例如查看节点 docker info: minikube ssh -- docker info 删除集群, 删除 ~/.minikube 目录缓存的文件: minikube delete 关闭集群: minikube stop 销毁集群: minikube stop && minikube delete 四、安装 kubectl 由于 minikube 内置的 kubectl 命令功能不全,所以最好独立安装一个 kubectl 用以下命令下载最新发行版: curl -LO "https://dl.k8s.io/release/$(curl -L -s https://dl.k8s.io/release/stable.txt)/bin/linux/amd64/kubectl" 安装 kubectl: sudo install -o root -g root -m 0755 kubectl /usr/local/bin/kubectl 查看版本的详细信息: kubectl version --client --output=yaml 五、安装 dashboard 执行以下命令,启动 dashboard 插件: minikube dashboard 集群外部想要直接访问 dashboard 还需要设置代理才能访问,执行以下命令: kubectl proxy --port=8001 --address='192.168.28.138' --accept-hosts='^.*' --port 需要暴露的端口号 --address 服务器外网IP(宿主机IP) --accept-hosts 外部访问服务器的IP(白名单) 这样就可以在浏览器上通过以下地址访问 Kubernetes Dashboard: http://192.168.28.138:8001/api/v1/namespaces/kubernetes-dashboard/services/http:kubernetes-dashboard:/proxy/ 扫码关注有惊喜!

优秀的个人博客,低调大师

PhotonServer(一)——服务器基础搭建

2 --> PhontonServer下载: https://www.photonengine.com/en-US/sdks#server-sdkserverserver 官方配置资料: https://doc.photonengine.com/en-us/server/current/getting-started/photon-server-in-5min 解除20人同时连接限制到100人同时连接: 下载后我们可以根据文档来进行Server的配置。刚下载并且解压下来后可以看到限制最大连接数为20人,那么这里我们可以升级到100人连接数的,首先注册并登录PhontonServer,然后再下面网址下载一个解除100人数限制的文件。https://dashboard.photonengine.com/en-US/selfhosted 下载后的文件,根据电脑系统,32位就放在PhotonServer解压下..\deploy\bin_Win32,如果是64位就放在PhotonServer解压下..\deploy\bin_Win64,我电脑是64,如下 然后我们启动PhotonControl.exe,这时候我们就可以看到最大连接数到了100人了。 创建自己的Server 我这里用的是VS 2017 完成后,要开始创建生成库,在PhotonServer解压下..\deploy中创建自己项目名称文件夹,在此文件夹中创建bin文件夹。 之后,开始开发服务器端,通过浏览,添加下载的PhotonServer中一下五个.dll文件 服务器代码: using Photon.SocketServer; using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.Threading.Tasks; namespace AR_RemoteServer { //所有的Server端 主类都要继承自applicationbase public class RemoteServer : ApplicationBase { //当一个客户端请求连接的时候,服务器端就会调用这个方法 //我们使用peerbase,表示和一个客户端的链接,然后photon就会把这些链接管理起来 protected override PeerBase CreatePeer(InitRequest initRequest) { return new ClientPeer(initRequest); } protected override void Setup() { } protected override void TearDown() { } } } using Photon.SocketServer; using PhotonHostRuntimeInterfaces; using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.Threading.Tasks; namespace AR_RemoteServer { //管理跟客户端的链接的 class ClientPeer : Photon.SocketServer.ClientPeer { public ClientPeer(InitRequest initRequest) : base(initRequest) { } //处理客户端断开连接的后续工作 protected override void OnDisconnect(DisconnectReason reasonCode, string reasonDetail) { } //处理客户端的请求 protected override void OnOperationRequest(OperationRequest operationRequest, SendParameters sendParameters) { } } } 至于服务端具体代码,后续我们在整合。 下面开始生成服务:配置好这些信息后,右击项目—>生成,生成后在之前设置的文件夹下就会出现.dll文件 开始配置刚才生成的Server: 首先,打开PhotonServer.config配置 开始配置我们的TCP,UDP配置。用VS打开它。可以看到LoadBalancing配置,可以根据这个写入字节的配置节点,这里我们直接复制一份出来,还是复制到PhotonServer.config下,修改一下节点就OK。 <ArRemote MaxMessageSize="512000" MaxQueuedDataPerPeer="512000" PerPeerMaxReliableDataInTransit="51200" PerPeerTransmitRateLimitKBSec="256" PerPeerTransmitRatePeriodMilliseconds="200" MinimumTimeout="5000" MaximumTimeout="30000" DirectDispatchToCLR="true" DisplayName="ArRemote"> <!-- 0.0.0.0 opens listeners on all available IPs. Machines with multiple IPs should define the correct one here. --> <!-- Port 5055 is Photon's default for UDP connections. --> <UDPListeners> <UDPListener IPAddress="0.0.0.0" Port="5055" OverrideApplication="AR_RemoteServer"> </UDPListener> </UDPListeners> <!-- 0.0.0.0 opens listeners on all available IPs. Machines with multiple IPs should define the correct one here. --> <TCPListeners> <!-- TCP listener for Game clients on Master application --> <TCPListener IPAddress="0.0.0.0" Port="4530" OverrideApplication="AR_RemoteServer" InactivityTimeout="10000"> </TCPListener> </TCPListeners> <!-- WebSocket (and Flash-Fallback) compatible listener --> <WebSocketListeners> <WebSocketListener IPAddress="0.0.0.0" Port="9090" DisableNagle="true" InactivityTimeout="10000" OverrideApplication="AR_RemoteServer"> </WebSocketListener> </WebSocketListeners> <!-- Defines the Photon Runtime Assembly to use. --> <Runtime Assembly="PhotonHostRuntime, Culture=neutral" Type="PhotonHostRuntime.PhotonDomainManager" UnhandledExceptionPolicy="TerminateProcess"> </Runtime> <!-- Defines which applications are loaded on start and which of them is used by default. Make sure the default application is defined. --> <!-- Application-folders must be located in the same folder as the bin_Win64 folders. The BaseDirectory must include a "bin" folder. --> <Applications Default="AR_RemoteServer"> <Application Name="AR_RemoteServer" BaseDirectory="AR_RemoteServer" Assembly="AR_RemoteServer" Type="AR_RemoteServer.RemoteServer"> </Application> </Applications> </ArRemote> 修改部分: Application标签中,添加 ForceAutoRestart="true"表示是“否自动重启”。 最后关闭重启下Photon,就可以看到ArRemote的Application 了,启动起来。 日志输出: 打开Open logs,会弹出 输出Server启动的一些信息,如果启动出错可以在这找错误信息。另一个CLR是提示License以及最大连接数,以及运行的Photon的应用的配置信息等,可以通过CLR看出哪些配置出错了,这个是Photon的两个日志输出. 出现上面的running就启动成功。 出现上面CServerice:OnException(),表示出现错误,看后面意思修改。 扩展自己Log输出: 上边已经引入log4net.dll文件,可以去log4net的官网找这个配置怎么写,也可以在我们下载的photon里面找这个配置文件。这里我在phonton文件下的目录里面找到了配置文件log4net.config,把配置文件log4net.config复制到我们项目里面的根目录下并且将它设置为始终复制,然后打开配置文件修改里面的配置。 下面我们开始创建一个Log对象,然后初始化。在RemoteServer这个类里面定义一个Log对象 //定义一个Log对象 public static readonly ILogger log = LogManager.GetCurrentClassLogger(); //调用 log.Info("连接"); 输出日志文件在下列路径可以找到,我定义的名字是AR.Server.log 最重要的一点:自定义的输出日志必须在Server启动时初始化它的位置等信息 protected override void Setup() { //日志的初始化(定义配置文件log4net位置) //Path.Combine 表示连接目录和文件名,可以屏蔽平台的差异 // Photon: ApplicationLogPath 就是配置文件里面路径定义的属性 //this.ApplicationPath 表示可以获取photon的根目录,就是Photon-OnPremise-Server-SDK_v5\deploy这个目录 //这一步是设置日志输出的文档文件的位置,这里我们把文档放在Photon-OnPremise-Server-SDK_v5\deploy\bin_Win64\log里面 log4net.GlobalContext.Properties["Photon:ApplicationLogPath"] = Path.Combine(Path.Combine(Path.Combine(this.ApplicationRootPath, "bin_win64")), "log"); //this.BinaryPath表示可以获取的部署目录就是目录Photon-OnPremise-Server-SDK_v5\deploy\AR_RemoteServer\bin FileInfo configFileInfo = new FileInfo(Path.Combine(this.BinaryPath, "log4net.config")); //如果这个配置文件存在 if (configFileInfo.Exists) { LogManager.SetLoggerFactory(Log4NetLoggerFactory.Instance);//设置photon使用哪个日志插件 //让log4net这个插件读取配置文件 XmlConfigurator.ConfigureAndWatch(configFileInfo); } //初始化 log.Info("Server启动!");//最后利用log对象就可以输出了 } 打开自定义日志,如下 这样整个服务就配置好了,至于服务编码后续再总结

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册