首页 文章 精选 留言 我的

精选列表

搜索[学习],共10000篇文章
优秀的个人博客,低调大师

Java 学习(21)--集合笔试题

集合笔试题 1.产生10个1-20之间的随机数,要求随机数不能重复(List 和 Set 分别实现) 分析:1.创建一个 ArrayList 对象 2.如果 ArrayList 对象长度小于 10 3.在循环中,创建一个 Random 对象,产生 1-20 之间的随机数 4. 通过 ArrayList 对象 d constains 方法判断,该随机数是否存在于集合中,不存在则加入,存在则放弃。 代码: 1.List package com.neuedu.collection; import java.util.ArrayList; import java.util.Random; public class Demo1 { public static void main(String[] args) { ArrayList<Integer> list = new ArrayList<>(); while(list.size() < 10){ Random random = new Random(); int nextInt = random.nextInt(20) + 1; if(!list.contains(nextInt)) { list.add(nextInt); } } System.out.println(list); } } 输出: 2.Set (无序【添加顺序和打印顺序不一致】、不重复) package com.neuedu.collection; import java.util.HashSet; import java.util.Set; public class Demo2 { public static void main(String[] args) { Set set = new HashSet<Integer>(); while(set.size() < 10) { int random = (int)(Math.random() * 20) + 1; set.add(random); } System.out.println(set); } } 输出: 拓展:当两个内容相同则输出一个,不同则都输出 hashcode: 根据一个对象,通过一定的算法,计算出一个 32位 的 2进制 表示的数据(不定长数据 转换 定长数据) Objecthashcode(默认的hashcode):根据对象在内存的地址来计算hashcode 值(基本都不相同) name 是string 类型,string 类型重写 hashcode ,当字符串内容相同则 hashcode 值相同(属性相关) set 结构: 竖:hashtable(hash 桶)里面的小格(hashcode),当hashcode 值相同时才会放到同一个小格里面; 横:LinkedList(链表),里面的小格(equal 后的值),若二者相同则表示在链表的同一格里面,重复的不在添加到小格中;如二者不同则不在同一格里面,将不同的放在后面的小格里面。 package com.neuedu.collection; import java.util.HashSet; import java.util.Set; public class SetDemo { public static void main(String[] args) { Set<Person> set = new HashSet<Person>(); Person p1 = new Person("林青霞", 50); Person p2 = new Person("林青霞", 40); set.add(p1); set.add(p2); System.out.println(set); } } class Person { private String name; private int age; public Person(String name, int age) { super(); this.name = name; this.age = age; } public String getName() { return name; } public void setName(String name) { this.name = name; } public int getAge() { return age; } public void setAge(int age) { this.age = age; } @Override public String toString() { return "Person [name=" + name + ", age=" + age + "]"; } @Override public int hashCode() { return name.hashCode() + age; } @Override public boolean equals(Object obj) { if(!(obj instanceof Person)){ return false; } Person person = (Person)obj; if(this.name.equals(person.name) && this.age == person.age) { return true; } return false; } } 输出: 2.键盘录入5个学生信息(姓名、语文成绩、数学成绩、英语成绩)按照总分从高到低的顺序(若总分相同,则按照语文、数学、英语的成绩进行倒序) 二叉树:24 18 30 16 20 28 35 中序遍历(详解) :左 中 右 16 18 20 24 28 30 35 package com.neuedu.collection; import java.util.Scanner; import java.util.Set; import java.util.TreeSet; public class Demo3 { public static void main(String[] args) { TreeSet<Student> treeSet = new TreeSet<>(); Scanner scanner = new Scanner(System.in); for(int i = 1; i <= 5; i++) { System.out.println("请输入第" + i + "个学生的信息"); System.out.println("姓名:"); String name = scanner.next(); System.out.println("语文 成绩:"); int chinese = scanner.nextInt(); System.out.println("数学成绩:"); int math = scanner.nextInt(); System.out.println("英语成绩:"); int english = scanner.nextInt(); Student student = new Student(name, chinese, math, english); treeSet.add(student); } System.out.println("学生成绩录入完毕"); System.out.println("按照分数排序后的结果是:"); System.out.println(treeSet); } } class Student implements Comparable<Student>{ private String name; private int chinese; private int math; private int english; public String getName() { return name; } public void setName(String name) { this.name = name; } public int getChinese() { return chinese; } public void setChinese(int chinese) { this.chinese = chinese; } public int getMath() { return math; } public void setMath(int math) { this.math = math; } public int getEnglish() { return english; } public void setEnglish(int english) { this.english = english; } public int getTotal() { return chinese + english + math; } @Override public String toString() { return "Student [name=" + name + ", chinese=" + chinese + ", math=" + math + ", english=" + english + "]"; } public Student(String name, int chinese, int math, int english) { super(); this.name = name; this.chinese = chinese; this.math = math; this.english = english; } @Override public int compareTo(Student o) { int temp = o.getTotal() - this.getTotal(); if(temp == 0) { temp = o.chinese - this.chinese; } if(temp == 0) { temp = o.math - this.math; } if(temp == 0) { temp = o.english - this.english; } /*temp = (temp != 0 ? temp : (o.chinese - this.chinese)); temp = (temp != 0 ? temp : (o.math - this.math)); temp = (temp != 0 ? temp : (o.english - this.english));*/ return temp; } } 输出:(只有2名学生) 3.“aababcabcdabcde”获取字符串中每个字母出现的次数,要求结果 a(5) b(4) c(3) 分析:1.将字符串转换成一个字符数组 2.对字符数组进行遍历,放到 Set 集合中 package com.neuedu.collection; import java.util.Map.Entry; import java.util.Scanner; import java.util.Set; import java.util.TreeMap; import java.util.TreeSet; import org.omg.CosNaming.NamingContextExtPackage.StringNameHelper; public class Demo4 { public static void main(String[] args) { Scanner scanner = new Scanner(System.in); System.out.println("请输入字符串"); String str = scanner.next(); TreeSet<Character> treeSet = new TreeSet<>(); for(int i = 0; i < str.length(); i++) { treeSet.add(str.charAt(i)); } System.out.println(treeSet); for(Character c : treeSet) { int count = 0; for(int i = 0; i < str.length(); i++) { if(str.charAt(i) == c) { count++; } } System.out.print(c+"(" + count + ") " ); } } } 输出: 方法二: package com.neuedu.collection; import java.util.Map.Entry; import java.util.Scanner; import java.util.Set; import java.util.TreeMap; import java.util.TreeSet; import org.omg.CosNaming.NamingContextExtPackage.StringNameHelper; public class Demo4 { public static void main(String[] args) { Scanner scanner = new Scanner(System.in); System.out.println("请输入字符串"); String str = scanner.next(); TreeMap<Character, Integer> map = new TreeMap<>(); //遍历字符串 for(int i = 0; i < str.length(); i++) { //获取每个字符 Character key = str.charAt(i); //判断map中是否包含该字符,如果不包含,value=1, if(!map.containsKey(key)) { map.put(key, 1); }else {//如果map中已经包含改字符,则取出原来的值+1 map.put(key, map.get(key) + 1); } } StringBuffer sb = new StringBuffer(); Set<Entry<Character, Integer>> entrySet = map.entrySet(); for(Entry<Character, Integer> entry : entrySet) { sb.append(entry.getKey()).append("(").append(entry.getValue()).append(") "); } System.out.println(sb.toString()); } 输出: 标准方法: //“aababcabcdabcde”获取字符串中每个字母出现的次数,要求结果 a(5) b(4) c package com.hd.file; import java.util.Set; import java.util.TreeMap; public class demo3 { public static void main(String[] args) { String str = "aababcabcdabcde"; TreeMap<Character,Integer> map = new TreeMap<Character,Integer>(); char[] chs = str.toCharArray(); for(Character ch:chs){ Integer value = map.get(ch); if(value==null){ map.put(ch, 1); }else{ value++; map.put(ch, value); } } Set<Character> set = map.keySet(); StringBuilder sb = new StringBuilder(); for(Character s:set){ Integer value = map.get(s); sb.append(s).append("(").append(value).append(")"); } System.out.println(sb.toString()); } } 输出: 4.模拟斗地主洗牌、发牌、看牌 方法一: 分析: 分析: * 1:创建一副牌 * 1.1 : 创建一个牌盒 * 1.2: 装牌 * 2:洗牌 * 3:发牌 * 4:看牌 package com.neuedu.collection; import java.util.ArrayList; import java.util.Collections; public class PokerDemo { public static void main(String[] args) { ArrayList<String> poker = new ArrayList<>(); String[] colors = {"","","",""}; String[] numbers = {"A","2","3","4","5","6","7","8","9","10","J","Q","K"}; for(String color : colors) { for(String number : numbers) { poker.add(color.concat(number)); } } poker.add("大王"); poker.add("小王"); //洗牌 Collections.shuffle(poker); //创建打牌的人 ArrayList<String> rulai = new ArrayList<>(); ArrayList<String> sunwukong = new ArrayList<>(); ArrayList<String> weiwei = new ArrayList<>(); ArrayList<String> dipai = new ArrayList<>(); //摸牌 for(int i = 0; i < poker.size(); i++) { if(i >= poker.size() - 3) { dipai.add(poker.get(i)); } if(i % 3 == 0) { rulai.add(poker.get(i)); } if(i % 3 == 1) { sunwukong.add(poker.get(i)); } if(i % 3 == 2) { weiwei.add(poker.get(i)); } } //看牌 lookPoker("A", rulai); lookPoker("B", sunwukong); lookPoker("C", weiwei); lookPoker("底牌", dipai); } public static void lookPoker(String name, ArrayList<String> pai) { System.out.println(name + "的牌是:"); for(String s : pai) { System.out.print(s + " "); } System.out.println(); } } 输出: 方法二: 思路: * 1:创建一个HashMap集合 * 2:创建一个ArrayList,用来存放牌的编号 * 3:创建花色数组和点数数组 * 4:从1编号开始向Hashmap中存放相应的编号和对应的牌,同时往ArrayList中存储编号 * 5:洗牌(洗的是编号) * 6:发牌(发牌发的也是编号,为了保证编号是排序的,应该创建一个TreeSet集合) * 7:看牌(遍历TreeSet,获取编号,然后从HashMap中找到对应的牌) package com.neuedu.collection; import java.util.ArrayList; import java.util.Collections; import java.util.HashMap; import java.util.List; import java.util.Map; import java.util.Set; import java.util.TreeSet; /** * 4: 模拟斗地主洗牌、发牌和看牌 * 思路: * 1:创建一个HashMap集合 * 2:创建一个ArrayList,用来存放牌的编号 * 3:创建花色数组和点数数组 * 4:从1编号开始向Hashmap中存放相应的编号和对应的牌,同时往ArrayList中存储编号 * 5:洗牌(洗的是编号) * 6:发牌(发牌发的也是编号,为了保证编号是排序的,应该创建一个TreeSet集合) * 7:看牌(遍历TreeSet,获取编号,然后从HashMap中找到对应的牌) * */ public class PokerDemo2 { public static void main(String[] args) { Map<Integer,String> poker = new HashMap<>(); List<Integer> num = new ArrayList<>(); String[] colors = {"","","",""}; String[] numbers = {"3","4","5","6","7","8","9","10","J","Q","K","A","2"}; int count = 1; for(String number : numbers) { for(String c : colors) { poker.put(count, c.concat(number)); num.add(count); count++; } } poker.put(count, "小王"); num.add(count); count++; poker.put(count, "大王"); num.add(count); //洗牌 Collections.shuffle(num); TreeSet<Integer> linQingXia = new TreeSet<>(); TreeSet<Integer> zhouRunFa = new TreeSet<>(); TreeSet<Integer> liuDeHua = new TreeSet<>(); TreeSet<Integer> diPai = new TreeSet<>(); for(int i = 0; i <num.size(); i++) { if(i >= num.size() - 3) { diPai.add(num.get(i)); continue; } if(i % 3 == 0) { linQingXia.add(num.get(i)); } if(i % 3 == 1) { zhouRunFa.add(num.get(i)); } if(i % 3 == 2) { liuDeHua.add(num.get(i)); } } //看牌 lookPoker("A", linQingXia, poker); lookPoker("B", zhouRunFa, poker); lookPoker("C", liuDeHua, poker); lookPoker("底牌", diPai, poker); } public static void lookPoker(String name,Set<Integer> set,Map<Integer, String> map) { System.out.println(name + "的牌是:"); for(Integer key : set) { System.out.print(map.get(key) + " "); } System.out.println(); } } 输出:

优秀的个人博客,低调大师

Java 学习(20)--异常 / IO 流

异常(Exception) (1)程序出现的不正常的情况。 (2)异常的体系 Throwable(接口,将异常类对象交给 JVM 来处理) |--Error 严重问题,我们不处理。(jvm 错误,程序无法处理) |--Exception异常 (程序可以处理的异常) |--RuntimeException (运行期异常,可以通过逻辑判断进行控制,不需要捕获 处理方法:1.try...catch 2.throws) |--其他(受查)异常 (继承自Exception,且不是RuntimeException,必须要捕获) (3)异常的处理: A:JVM 的默认处理 当系统发生运行异常时,Jvm 会创建一个异常类的对象;查看是否对这个异常进行捕获和处理,若没有,则把异常的名称 ,原因,位置等信息输出在控制台,但是程序不能继续执行了。 B:自己处理 a:try...catch...finally 自己编写处理代码 ,后面的程序可以继续执行 b:throws 把自己处理不了的,在方法上声明,告诉调用者,这里有问题 (4)面试题 A:编译期异常和运行期异常的区别 ? 编译期异常必须要处理的,否则编译不通过;运行期异常可以不处理,也可以处理 B:throw和 throws 的区别 throw:在方法体中,后面跟的是异常对象名 ,并且只能是一个 throw 抛出的是一个异常对象,说明这里肯定有一个异常产生了 throws:在方法声明后,后面跟的是异常的类名 , 可以是多个 ;throws 是声明方法有异常,是一种可能性,这个异常并不一定会产生, (5)finally A:finally用于释放资源,它的代码永远会执行。 特殊情况:在执行到 finally 之前jvm 退出了 B:面试题 a:final,finally,finalize 的 区 别 ? 详解 b: 如果在 catch里面有 return, 请问 finally还执行吗 ?如果执行 ,在 return前还是后 会/前(实际上在中间) C:异常处理的变形 try...catch...finally / try...catch... / try...catch...catch.../try...catch...catch...fianlly / try...finally (6)自定义异常 继承自 Exception 或者 RuntimeException, 只需要提供无参构造和一个带参构造即可 (7)异常的注意实现 A:父的方法有异常抛出 ,子的重写方法在抛出异常的时候必须要小于等于父的异常 B:父的方法没有异常抛出 ,子的重写方法不能有异常抛出 C:父的方法抛出多个异常 ,子的重写方法必须比父少或者小 IO 流 File 我们要想实现输入输出操作就必须要知道,java在硬盘上的表现形式,也就是说硬盘上面的文件和文件夹在java中有一个专门的 类来表示:File;IO流操作中大部分都是对文件的操作,所以 Java就提供了 File类供我们来操作文件 (java类:成员变量,成员方法,构造方法,成员代码块,成员内部类) 构造方法 A:File file =newFile("e:\\demo\\a.txt");// 根据一个路径得到 File对象 B:File file =newFile("e:\\demo","a.txt");// 根据一个目录和一个子文件 /目录得到File 对象 C:File file = new File("e:\\demo"); File file2 =newFile(file,"a.txt");// 根据一个父 File对象和一个子文件 /目录得到File对象 1.File(File parent, String child) :根据一个File对象和一个文件名创建File对象 2.File(String pathname):根据指定的路径创建File对象 3.File(String parent, String child) :根据一个路径字符串和一个文件名创建File对象 public class FileDemo1 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\a.txt"); //全路径 File file1 = new File("d:\\test", "a.txt"); //真正的路程 , 要创建的文件名 File file1 = new File("d:\\test"); File file2 = new File(file1,"a.txt"); //将路径封装到 file 对象里去; //封装好的对象 , 要创建的文件名 //以上三种方式实现的效果是一样的 System.out.println(file2); } } File 类的功能 A:创建功能 publicbooleancreateNewFile() :根据file对象的路径,创建一个硬盘中的文件或路径, 如果没有对应的路径,就会抛出异常 java.io.IOException; 如果该路径下没有对应文件,则创建成功,返回true; 如果该文件已经存在则创建失败,返回false publicbooleanmkdir(): 创建一个文件夹,创建成功返回true 如果没有对应的路径,则创建失败,返回false 如果该文件夹已经存在,则创建失败,返回false publicbooleanmkdirs() :创建文件夹,如果路径中的文件夹不存在,就一起创建出来 public class FileDemo2 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\a.txt"); System.out.println("createNewFile:" + file.createNewFile()); File file = new File("d:\\test\\demo"); System.out.println("mkdir:" + file.mkdir()); File file1 = new File("d:\\test\\aaa"); System.out.println("mkdir:" + file1.mkdir()); File file2 = new File("d:\\test\\aaa\\bbb"); System.out.println("mkdir:" + file2.mkdir()); File file3 = new File("d:\\test\\aaa\\bbb\\ccc"); System.out.println("mkdir:" + file3.mkdir()); File file = new File("d:\\test\\aaa\\bbb\\ccc"); System.out.println("mkdirs:" + file.mkdirs()); //说明骑白马的不一定是王子 File file = new File("D:\\test\\a.txt"); System.out.println("mkdir:" + file.mkdir()); } } B:删除功能 public boolean delete() :java删除不走回收站,所删除时一定要小心;如果删除时对应的路径名不存在, 则删除失败,返回false;删除此抽象路径名表示的文件或目录。如果此路径名表示一个目录,则该目录必须为空才能删除。 public class FileDemo3 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\aaa\\bbb"); System.out.println("delete:" + file.delete()); } } C:重命名功能 public boolean renameTo(File dest) :将File对象对应的路径名改为传入的file对象对应路径名, 如果重命名前后的两个文件不在同一个文件夹下,则该方法有剪切的效果 如果路径名相同,就是改名。 如果路径名不同,就是改名并剪切。 路径以盘符开始:绝对路径 c:\\a.txt 路径不以盘符开始:相对路径 a.txt public class FileDemo4 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\lihongxiao.txt"); File newFileName = new File("d:\\test\\demo\\weiwei.txt"); System.out.println("renameTo:" + file.renameTo(newFileName)); File file = new File("aaa.txt"); file.createNewFile(); //没有写盘符,叫做相对路径,会在项目的根路径下创建 File file = new File("aaa\\bbb\\ccc"); System.out.println("mkdirs:" + file.mkdirs()); // 相对路径 } } D:判断功能 publicbooleanisDirectory() :判断是否是文件夹 publicbooleanisFile() :判断是否是文件 publicbooleanexists(): 判 断 是 否 存 在 publicbooleancanRead(): 判 断 是 否 可 读 publicbooleancanWrite() :判断是否可写 publicbooleanisHidden() :判断是否隐藏 public class FileDemo5 { public static void main(String[] args) throws IOException { File file = new File("a.txt"); File file = new File("ccc"); System.out.println("是否文件夹:" + file.isDirectory()); File file = new File("aaa"); System.out.println("canRead:" + file.canRead()); System.out.println("canWrite:" + file.canWrite()); File file = new File("aaa"); System.out.println("canRead:" + file.canRead()); System.out.println("isHidden:" + file.isHidden()); } } E:获取功能 publicStringgetAbsolutePath() :获取文件的绝对路径 publicStringgetPath() :获取相对路径 publicStringgetName() :获取名称 publiclonglength() :获取长度。字节数 publiclonglastModified() :获取最后一次的修改时间,毫秒值 public class FileDemo6 { public static void main(String[] args) throws IOException { File file1 = new File("aaa\\bbb\\ccc"); file1.mkdirs(); File file = new File("aaa\\bbb\\ccc\\weiwei.txt"); file.createNewFile(); System.out.println("AbsolutePath:----" + file.getAbsolutePath()); System.out.println("path:----" + file.getPath()); System.out.println("fileName:-----" + file.getName()); System.out.println("length:---" + file.length()); Date date = new Date(file.lastModified()); DateFormat df = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); String format = df.format(date); System.out.println(format); } } F:高级获取功能 public String[] list() :获取指定目录下的所有文件或者文件夹的名称数组 public File[] listFiles() :获取指定目录下的所有文件或者文件夹的 File数组 public class FileDemo7 { public static void main(String[] args) throws IOException { File file = new File("d:\\"); for(String name : file.list()) { System.out.println(name); } File file = new File("d:\\"); for(File file1 : file.listFiles()) { System.out.println(file1.getName()+"----"+file1.getAbsolutePath()); } } } G:过滤器功能 案例: 判断D盘中是否存在后缀名为.png的文件 分析: 1:将D封装到一个File对象中 2:获取D盘下的所有的文件和文件夹 3: 从这些文件和文件夹中根据条件遍历查找满足条件的文件 public class FileDemo8 { public static void main(String[] args) throws IOException { File file = new File("D:\\"); File[] sonFiles = file.listFiles(); for(File file2 : sonFiles) { String filename = file2.getName(); if(filename.endsWith(".png") && file2.isFile()) { System.out.println(filename); } } } } 方法二:设置条件,查找满足条件的文件 public class FileDemo9 { public static class MyFilter implements FilenameFilter{ @Override public boolean accept(File dir, String name) { if(name.endsWith(".png")){ return true; } return false; } } public static void main(String[] args) throws IOException { File file = new File("D:\\"); MyFilter myFilter = new MyFilter(); String[] list = file.list(new FilenameFilter() { @Override public boolean accept(File dir, String name) { // TODO Auto-generated method stub return false; } }); for(String name : list) { System.out.println(name); } } } 总结:输出指定目录下指定后缀名的文件名称 a:先获取所有的,在遍历的时候判断,再输出 b: 先判断,再获取,最后直接遍历输出即可

优秀的个人博客,低调大师

Python | Python学习之深浅拷贝

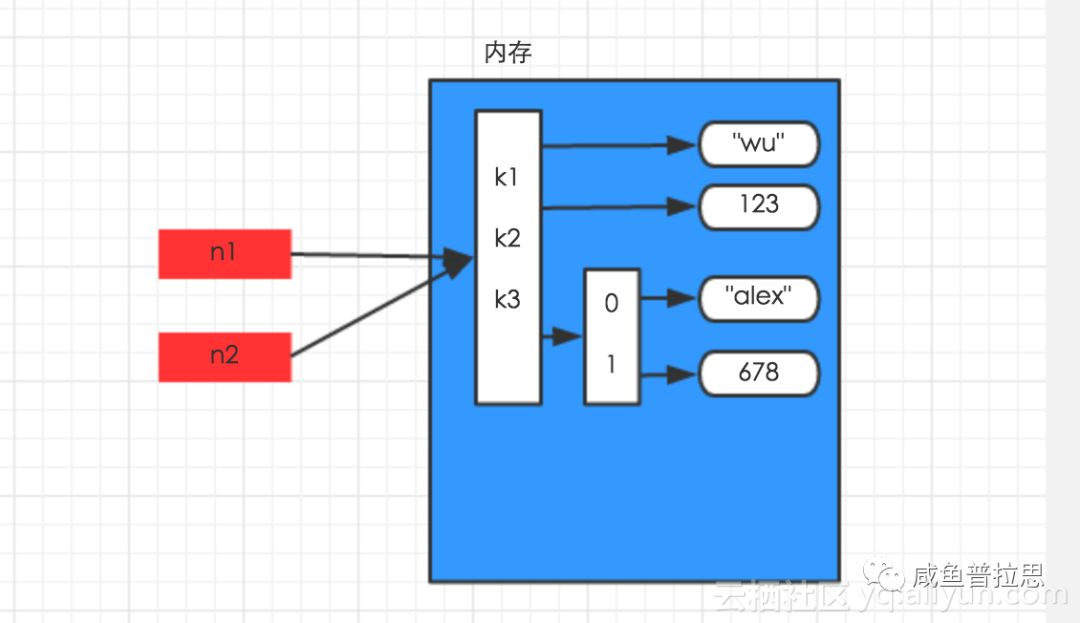
直接步入正题,聊一聊 Python 中的深浅拷贝 关于 is 和 == == 是 python 标准操作符中的比较操作符,用来比较判断两个对象的 value(值) 是否相等 。 # 例1.1 a = '2332424' b = '2332424' print(a == b) 输出: True [Finished in 0.1s] is 也被叫做同一性运算符,这个运算符比较判断的是对象间的唯一身份标识,也就是id是否相同。 # 例1.2 a = b = ['2343456'] c = ['2343456'] print(a == b, id(a), id(b)) print(a == c, id(a), id(c)) print(a is b, id(a), id(b)) print(a is c, id(a), id(c)) 输出: True 10715336 10715336 True 10715336 10717064 True 10715336 10715336 False 10715336 10717064 [Finished in 0.1s] 不同类型下, == 的结果都为True,但是 is 的结果则不一定 # 例1.3 # a 和 b 都为数值时 a = 1 b = 1 print(id(a)) print(id(b)) print(a == b) print(a is b) 1715077616 1715077616 True True [Finished in 0.1s] # a 和 b 都为字符串时 a = 'abcdefg' b = 'abcdefg' print(id(a)) print(id(b)) print(a == b) print(a is b) 11847696 11847696 True True [Finished in 0.1s] # a 和 b 都为列表时 a = ['12345678'] b = ['12345678'] print(id(a)) print(id(b)) print(a == b) print(a is b) 16941256 16942984 True False [Finished in 0.1s] # a 和 b 都是字典时 a = {'a':1,'b':2} b = {'a':1,'b':2} print(id(a)) print(id(b)) print(a == b) print(a is b) 10421192 10421256 True False [Finished in 0.1s] # a 和 b 都是元组时 a = (1,2,3) b = (1,2,3) print(id(a)) print(id(b)) print(a == b) print(a is b) 11960608 11960680 True False [Finished in 0.1s] # a 和 b 都为集合时 a = set([1,2,3]) b = set([1,2,3]) print(id(a)) print(id(b)) print(a == b) print(a is b) 16850504 16919464 True False [Finished in 0.1s] 只有数值型和字符串型的情况下,a is b才为True,当a和b是tuple,list,dict或set型时,a is b为False。 关于深浅拷贝 首先我们来看几个栗子: # 例2.1:赋值 a = [1,2,3] b = a a.append([4,5,6]) print(a) print(b) print(a is b) print(a == b) 输出: [1, 2, 3, [4, 5, 6]] [1, 2, 3, [4, 5, 6]] [Finished in 0.1s] True True 在例2.1中a的末尾新增了[4,5,6]之后,b的值也发生了变化,这是因为a把值赋值给b只是将创建的b对象指向了a对象指向的内存,这时的a和b指向的都是同一块内存空间(id),所以修改a后b的值也一起改变。 # 例2.2:赋值 a = [1,2,3] b = a a = [4,5,6] print(a) print(b) print(id(a)) print(id(b)) 输出: [4, 5, 6] [1, 2, 3] 10848136 10846408 [Finished in 0.1s] 在例2.2中先将a赋值给b,又将[4,5,6]赋值给a,这时已经给a创建了新的内存空间,所以打印a,b时a和b的值并不相同。 下面来看下深浅拷贝的不同之处: 首先字符串 、元组以及数值的深浅拷贝是没有差别的,如下例子所示: # 例3.1 # 字符串 import copy a = '1345' b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 17025040 17025040 17025040 [Finished in 0.1s] # 数值 import copy a = 1345 b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 9326480 9326480 9326480 [Finished in 0.1s] # 元组 import copy a = (1,2,3) b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 10715424 10715424 10715424 [Finished in 0.2s] 而对于字典、列表 进行浅拷贝和深拷贝时,其id是有变化的 # 列表 import copy a = [1,2,3] b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 17540104 17040264 17419656 [Finished in 0.1s] #字典 import copy a = {"a": "1", "b": 2, "c": ["c", 3]} b = copy.copy(a) c = copy.deepcopy(a) print(a, b, c) print(id(a), id(b), id(c)) a['c'] = '666' print(a, b, c) print(id(a), id(b), id(c)) 输出: {'b': 2, 'a': '1', 'c': ['c', 3]} {'b': 2, 'a': '1', 'c': ['c', 3]} {'b': 2, 'a': '1', 'c': ['c', 3]} 6882248 17105992 16886792 {'b': 2, 'a': '1', 'c': '666'} {'b': 2, 'a': '1', 'c': ['c', 3]} {'b': 2, 'a': '1', 'c': ['c', 3]} 6882248 17105992 16886792 [Finished in 0.1s] 浅拷贝 :不管多么复杂的数据结构,浅拷贝都只会copy一层,且当copy指向不可变类型时,copy不会执行copy操作。当copy指向可变类型时,copy会执行第一层拷贝,即拷贝浅层的指向。 深拷贝 :其实深拷贝就是在内存中重新开辟一块空间,不管数据结构多么复杂,只要遇到可能发生改变的数据类型,就重新开辟一块内存空间把内容复制下来,直到最后一层,不再有复杂的数据类型,就保持其原引用。这样,不管数据结构多么的复杂,数据之间的修改都不会相互影响,这就是深拷贝,也同样可以将深拷贝理解为真正意义上的复制,是两个操作独立的个体。 有关深浅拷贝相关的图片说明可以参照下面几个链接的内容,以加深理解: http://www.cnblogs.com/wupeiqi/articles/5453708.htmlhttp://www.runoob.com/w3cnote/python-understanding-dict-copy-shallow-or-deep.html也可参照下面的几张图片: 原文发布时间为:2018-07-10本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”。

优秀的个人博客,低调大师

机器学习实战之线性回归

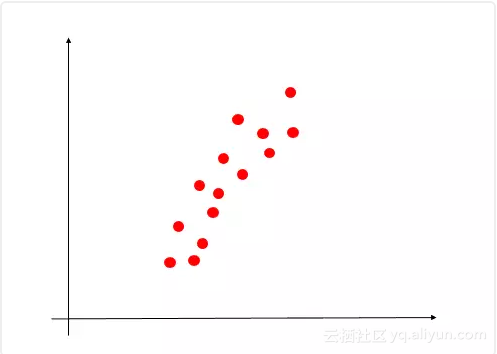
线性回归原理与推导 如图所示,这时一组二维的数据,我们先想想如何通过一条直线较好的拟合这些散点了?直白的说:尽量让拟合的直线穿过这些散点(这些点离拟合直线很近)。 目标函数 要使这些点离拟合直线很近,我们需要用数学公式来表示。首先,我们要求的直线公式为:Y = XTw。我们这里要求的就是这个w向量(类似于logistic回归)。误差最小,也就是预测值y和真实值的y的差值小,我们这里采用平方误差: 求解 我们所需要做的就是让这个平方误差最小即可,那就对w求导,最后w的计算公式为: 我们称这个方法为OLS,也就是“普通最小二乘法” 线性回归实践 数据情况 我们首先读入数据并用matplotlib库来显示这些数据。 def loadDataSet(filename): numFeat = len(open(filename).readline().

优秀的个人博客,低调大师

Python学习-基础知识-2

目录 Python基础知识2 一、二进制 二、文字编码-基础 为什么要有文字编码? 有哪些编码格式? 如何解决不同国家不兼容的编码格式? unicode编码格式的缺点 如何既能全球通用还可以规避unicode的缺点? python3的编码格式是什么样的? 三、浮点数 四、列表 如何理解列表? 列表的操作有哪些? 深浅复制问题 五、字符串 什么是字符串? 字符串的常用方法 使用r取消字符串转义 六、元组 元组和列表有什么区别? 七、哈希 八、字典 什么是字典? 字典常用操作 九、集合 什么是集合? 集合基本操作 集合分类计算 十、文件编码--进阶 十一、几个技术问题 if 条件语句判断 字典的两种循环方法对比 while...else... Python基础知识2 标签:python 目录: 一、二进制 计算机内部使用二进制表示数据。1位二进制可以代表2种状态,n位二进制可以表示2^n种状态,一般使用如下图示来计算一个字节的二进制和十进制互转: 128 64 32 16 8 4 2 1 256 1 1 1 1 1 1 1 1 78 0 1 0 0 1 1 1 0 33 0 0 1 0 0 0 0 1 6 0 0 0 0 0 1 1 0 二、文字编码-基础 为什么要有文字编码? 不论是文字、图片、视频还是其他类型的数据,在计算机内部都是以二进制的形式存储和表示。对于文字类型的数据,二进制需要通过文字编码表的映射关系,将二进制数据转换为对应的文字。文字编码表预先收录了字形和二进制数据的对应关系。但不同的国家因文字不同,所以产生了不同的编码表,编码表也叫作编码格式。 有哪些编码格式? 因不同国家的文字不同,各国都编写了适合本国语言的编码格式。如GBK是中国的编码格式,ASCII是美国的编码格式,SHIFT_JIS是日本的编码格式等等。不同的编码格式给出了不同的二进制和字形的对应关系标准,所以不同编码格式之间不能混用,否则会出现乱码。 如何解决不同国家不兼容的编码格式? 正因为编码格式互相不兼容,国际标准组织才出面编写了一个全球各国通用的unicode编码格式,此编码格式将全世界的语言都囊括进去,不论是哪一个国家,只要使用unicode进行编码,输出的文件都可以在全球通用,所以unicode也称为:万国码。(当然,读取的时候也要使用unicode编码进行读取) unicode编码格式的缺点 但是,unicode编码格式要求一个字符至少对应2个字节的二进制数据,这就导致对于编码长度小于2个字节的语言比如英文来说,存储空间加倍,不但影响存储,还影响传输效率。 如何既能全球通用还可以规避unicode的缺点? 此时UTF-8编码格式应运而生,UTF-8在unicode基础上,使用可变长编码的方法,使用1-4个字节来表示一个字符,优先使用1字节,不够的话再增加1字节,以此类推。通过变长的方式用于优化unicode在存储和传输时带来的资源浪费。 python3的编码格式是什么样的? 简单来说,python3在内存中操作字符串时的编码格式统一是unicode,而在读写文件时使用的编码格式默认是UTF-8。 三、浮点数 python中的浮点数包括:有限小数(如:1.2)和无限循环小数(如:1/3)。 python中的浮点数精度最长只有小数点后16位,可以使用decimal模块来提高精度。使用python3的/运算得到的结果就是浮点数。此外,浮点数还用于科学计数法,如1000000的科学计数法写法是:1.0E6。 当超出浮点数当前精度的时候会发生四舍五入的操作。 四、列表 如何理解列表? 列表可以简单的被理解成一个存储容器。此容器可以存放不同种类的对象,可以新增一个对象、删除一个对象、或者替换一个对象。列表类似于数组,只不过python的列表是动态的,不仅可以动态扩展和缩小长度,还可以存放不同的数据类型。列表使用如下方式声明: li = [0,1,2,3,4] 或者 li = list(range(5)) 列表的操作有哪些? 1. 查询 li[0]或者li[-1] # 通过下标索引对象值,不能超出下标范围 li.index('a') # 通过对象值查找对应下标,不存在的对象会导致此函数报错ValueError li.count('a') # 得到列表中'a'值出现的次数 2. 增加 li.append(20) # 在列表末尾追加元素 li.insert(0, 20) # 在列表下标0出插入20,这会导致元素右侧统一右移一个单位 3. 修改 li[0] = 20 # 直接修改第一个元素的值为20 li[:3] = [1,2,3] # 将列表前三个元素批量修改 4. 删除 li.remove(23) # 根据元素值删除元素,不存在会报错ValueError li.pop(0) # 根据元素下标删除元素,不给于参数则默认-1 del li[1] # 使用通用删除关键字del del li[1:5] # 使用del批量删除 5. 切片 li = [1,2,3,4,5] L = li[:3] # L的值是[1,2,3],切片含首不含尾 L = li[:] # 将li列表进行浅复制赋予L L = li[::-1] # 将li列表倒序后浅复制赋予L 6. 更新/扩展 list_a.extend(list_b) # 将b的值更新至a list_a = [1,2] list_b = [2,3] list_a.extend(list_b) # a的值是[1,2,3],b保持不变 7. 拼接 list_a = [1,2] list_b = [2,3] list_c = list_a + list_c # c的值是[1,2,3],a和b保持不变 8. 排序 li.sort() # 在原始列表上修改,排序默认方式是升序 li.reverse() # 让列表倒序 9. 循环 for i in li: print(i) 10. 清空/复制 li.clear() list_b = list_a.copy() # 等价于list_b = list_a[:] 深浅复制问题 因为列表是可变对象,即列表中的元素是可以改变的,所以在复制列表的时候,如果使用简单的复制(即浅复制),遇到嵌套的小列表时就会出现问题。为了规避可变对象在修改值时的安全问题,对于可变对象的复制,建议使用深复制。深复制的使用方式如下: import copy list1 = [1,2,3,[4,5],6] list2 = copy.deepcopy(list1) list1[-2][-1] = 'abc' print(list1) print(list2) 结果是: [1, 2, 3, [4, 'abc'], 6] [1, 2, 3, [4, 5], 6] 五、字符串 什么是字符串? 字符串就是一串字符序列,字符串在计算机中也是二进制数据,这些二进制数据通过编码格式显示成对应的字形,即字符串。字符串是不可变对象,一旦被创建就无法被修改。 字符串的常用方法 1.判断是否是数字字符串 str.isdigit() s = '123' s.isdigit() # 值是True s = '123b' s.isdigit() # 值是False 2. 替换字符 str2 = str1.replace(old, new) # 返回一个新字符串 s1 = 'aaahello,world' s2 = s1.replace('a', 'A') print(s1) print(s2) 结果: aaahello,world AAAhello,world 3. 定位字符 i = str.index(char) # 不存在会报错 i = str.find(char) # 不存在返回-1 s1 = 'aaahello world' print(s1.index('a')) print(s1.index('b')) print(s1.find('a')) print(s1.find('b')) 结果: 0 报错ValueError 0 -1 4. 字符计数 count = str.count(char) # 查找字符串中char字符的个数 s1 = 'aaahello world' print(s1.count('a')) 结果: 3 5. 处理首尾空格 str2 = str1.strip() # 返回新字符串,删除首尾空格 s1 = ' hello world' print(s1) print(s1.strip()) 结果: hello world hello world 6. 处理banner展示条 str2 = str1.center(len, char) # 使用char填充字符串长度到len s1 = 'student info' print(s1.center(20, '*')) print(s1.center(20, '-')) print(s1.center(20, '+')) 结果: ****student info**** ----student info---- ++++student info++++ 7. 分割字符串产生列表 list = str.split(char) # 根据char字符分割字符串成列表,默认cahr是空格 s1 = 'student!info!xiaoming' li = s1.split('!') print(type(li)) print(li) 结果: <class 'list'> ['student', 'info', 'xiaoming'] 8. 拼接字符串列表成更长字符串 str = char.join(list) # 根据char字符连接list里的所有字符串成为更长的字符串 li = ['student', 'info', 'xiaoming'] s1 = '+'.join(li) print(type(s1)) print(s1) 结果: <class 'str'> student+info+xiaoming 9. 字符串格式化输出 str2 = str1.format(*args, **kw) # 根据args和kw来对应赋值 result = 'name:{name}, age:{age}, a {0},a {1}'.format('apple', 'bananer', name='xiaoming', age=26) print(result) 结果: name:xiaoming, age:26, a apple,a bananer 10. 判断字符串开头和结尾 bool = str.startwith/endwith(char) # 判断是否以char开头或结尾 s1 = 'hello' s2 = 'world' print(s1.startswith('h')) print(s2.endswith('d')) 结果: True True 11. 改变字符串大小写 str2 = str1.upper/lower() # 设置大小写 s1 = 'hello world' print(s1.upper()) 结果: HELLO WORLD 使用r取消字符串转义 在字符串前面增加一个r可以取消此字符串在print过程中的转义功能,从而打印出字符串字面量。 s1 = '\ta\nbc' print(s1) s2 = r'\tabc\n' print(s2) 结果: a bc \tabc\n 六、元组 元组和列表有什么区别? 元组可以认为是只读列表,元组的操作大部分和列表一致,只不过一旦定义完毕之后就不能修改元组元素的值。 但是,如果元组元素是一个可变对象比如列表,则可以修改此列表中的值,这并不违反元组的规则因为列表自身这个容器的内存地址并没有变化。 tu = (1,2,[3,4]) # tu[0] = 10 # 这条语句会报错 tu[-1].append(5) print(tu) 结果是: (1, 2, [3, 4, 5]) 七、哈希 哈希函数用于将任意长度的输入通过算法计算得到固定长度的输出,这个输出也叫哈希值。 哈希算法是根据输入值的特征计算的,所以如果输入值不停变化,则输出也会不稳定,这就要求输入的是不可变对象。 因为哈希算法的原因,可能会出现不同的输入值有同样的输出值,这就发生了哈希冲突,所以想通过输出来反推唯一的输入是不合理的。 数据中保存的用户密码都是密文。 使用哈希的程序一定要有处理冲突的模块。 八、字典 什么是字典? 字典在某种角度上和列表很类似,都可以被认为是存储工具,保存各种数据类型对象。不过列表是通过下标索引,而字典是通过key来索引。另外,列表是有序的,而字典是无序的,因为字典的key涉及到哈希算法的计算。 数据类型 是否有序 索引值 作用 是否可变对象 使用方式 列表 有序 下标,从0开始 存储其他对象地址 是 li[0],li[-1] 字典 无序 key值,不可变对象 存储其他对象地址 是 dic[key] 字典常用操作 1. 增加 字典没有追加的函数,增加一个key-value的方式是直接: dic['name'] = 'xiaoming' 如果dic中已经存在'name'的key,则会使用'xiaoming'来覆盖原有的value 2. 修改 字典的修改直接是: dic['name'] = new_value 将新的值覆盖原有值 3. 查找 方法1:print(dic['name']) 如果dic没有'name'的key,则会报错 方法2:print(dic.get('name', 'not found!') 如果dic没有'name'的key,则会返回'not found!',默认第二参数是None,可以不填写 4. 删除 方法1:del dic['name'] 如果dic没有'name'的key,则会报错 方法2:dic.pop('name', 'not found!') 如果dic没有'name'的key,则会返回'not found!',第二参数没有默认值,必须手工输入否则会报错 5. 清空/复制 dic.clear() dic2 = dic1.copy() # 浅复制 6. 设置默认 dic.setdefault('name', 'xiaoming') 首先,dic会查找自身是否有'name',如果有返回原有value值。如果没有,就新增这个key-value并返回新value值。 7. 更新 dic1.update(dic2) 使用dic2来更新dic1,有则覆盖,无则新增。 dic1 = { 'a': 1, 'b': 2, 'x': 3,{'a': 1, 'b': 2, 'x': 100, 'y': 200} } dic2 = { 'b': 2, 'x': 100, 'y': 200, } dic1.update(dic2) print(dic1) 结果是: {'a': 1, 'b': 2, 'x': 100, 'y': 200 } 8. fromkeys 为一系列key设置统一的value值,并返回此字典。比如要为3个房地产楼盘设置统一价格: dic = dict.fromkeys(['万科', '阳光城', '融信'], 2000) print(dic) 结果是: {'万科': 2000, '阳光城': 2000, '融信': 2000} 9. 循环获取keys、values、items for key in dic.keys() for value in dic.values() for item in dic.items() 九、集合 什么是集合? 集合一般用于分类计算。集合中的元素都是唯一的,不会有重复。集合是无序的,集合是可变对象,但是集合内的元素必须是不可变对象。因为集合一般用于分类计算,是站在集合维度的,所以集合并不支持s[0]这种方式来访问元素。 集合基本操作 s = {1,2,3,4,5} print(s.pop()) # 随机删除一个元素 s.add(50) s.add(60) print(s) s.discard(100) # 删除元素,不存在不会报错 # s.remove(100) # 100不存在就会报错 s2 = {100,200,300} s.update(s2) # 两个集合合并,其实就是并集 print(s) s.clear() # 清空集合元素 print(s) 结果是: 1 {2, 3, 4, 5, 50, 60} {2, 3, 4, 5, 100, 200, 300, 50, 60} set() # 代表空集合 集合分类计算 s1 = {11,22,33} s2 = {22,33,44} print('交集是:', s1 & s2) # 交集是: {33, 22} print('s1 对于 s2 的差集是:', s1 - s2) # s1 对于 s2 的差集是: {11} print('s2 对于 s1 的差集是:', s2 - s1) # s2 对于 s1 的差集是: {44} print('并集是:', s1 | s2) # 并集是: {33, 11, 44, 22} print('对称差集是:', s1 ^ s2) # 对称差集是: {11, 44} print('s1是s2的超集吗?', s1.issuperset(s2), s1 > s2) # s1是s2的超集吗? False False print('s1是s2的子集吗?', s1.issubset(s2), s1 < s2) # s1是s2的子集吗? False False print('23在不在是s1中?', 23 in s1) # 23在不在是s1中? False print('s1 和 s2 是不是 不相交?', s1.isdisjoint(s2)) # s1 和 s2 是不是 不相交? False 十、文件编码--进阶 这里从:python3读取文件abc.txt,执行文件中的代码并在命令行展现内容的整个过程来理解各环节的编码问题。 文件准备 # abc.txt str1 = '中国' print(str1) 环境准备 python环境:python3.6.1 os环境:windows 10 abc.txt是使用pycharm编辑的,pycharm的编码设置为UTF-8 开始 我们登录windows操作系统,windows操作系统默认的编码格式是GBK,windows中有一个cmd命令行,此命令行的编码格式继承了操作系统的格式,也是GBK。 打开pycharm,默认pycharm在安装完毕后的编码格式是GBK,可以通过设置修改为UTF-8。 在pycharm中创建文件abc.txt,在此文件中写入: str1 = '中国' print(str1) 注意,此时abc.txt文件中的str1的编码格式是UTF-8,即编辑器pycharm是什么格式,则编写的文件就是什么编码格式。 使用Crtl+s保存此文件到硬盘。 单独在cmd中打开python解释器,进入交互环境,在交互环境中,我们可以输入: s1 = 'hello world' s2 = '你好 世界' 不论你输入的是什么字符串,不论是中文还是英文,此时在python3交互环境中的编码格式都是统一的unicode。 退出python3交互环境,在cmd命令中通过命令启动python3解释器执行abc.txt文件:python abc.txt 第7步其实有很多小环节: python3会使用默认的读写文件的编码格式对abc.txt文件进行解释。python3默认读写编码格式是UTF-8,而此文件恰好也是以UTF-8格式保存在硬盘上的,所以python3可以正确的对此文件进行编码。 python3通过UTF-8读写文件编码对此文件进行解释,将UTF-8的文件内容转换成unicode格式的字符串保留在内存中。 python3解释器执行unicode的保存在内存中的代码,设置一个str1变量,创建一个unicode格式的'中国' python3执行print函数,此时str1依然是unicode格式 print函数被执行,str1的'中国'会被打印到cmd中 cmd命令行接收到一个以unicode编码的字符串,虽然cmd默认是GBK编码,但是cmd可以认识GBK和unicode,所以可以根据unicode编码规则打印出此字符串的字形:'中国' 总之,有如下几个环节是需要编码的: python3解释器内部编码,也就是在内存中的编码格式,就是unicode python3解释器去读取文件时使用的编码格式,默认是UTF-8,会按照你在文件头部指定的# coding: xxx来设定,不设定的话就是UTF-8 文件自身也有一个编码格式,此编码格式来源于编辑此文件的编辑器 编辑器的编码格式继承了操作系统的编码格式,mac/Linux是UTF-8,windows是GBK,此外,cmd和shell也继承了操作系统的编码格式 十一、几个技术问题 if 条件语句判断 a = [1] if a: print('true') else: print('false') 这里的if条件是判断成立的,但是如下两者却是false: a == True a is True 为什么? 首先,a和True不能用is比较,因为是肯定不同的两个对象内存地址。也不能用==比较因为是不同的数据类型,值是肯定不同的。其次,if a这个语句等价于:if boo(a),bool(a)的结果是True,所以可以判断成立。 字典的两种循环方法对比 dic = { 'a': 1, 'b': 2, 'c': 3, } for key in dic.keys(): print(key, dic[key]) for key, value in dic.items(): print(key, value) 哪一种循环的性能更好? 尝试过两种办法: 两种循环各循环100次,计算运行时间,发现是下面那种时间短。 扩大dic的数据量到100万个项目,两种循环各执行1次,发现上面那种时间短。 目前还不知道确切分析的方法,后续补充。 while...else... 用处:需要判断while是否完全正常执行完毕时 i = 0 while i < 10: print(i) i += 1 else: print('循环正常执行完毕,没有被break或者return打断')
优秀的个人博客,低调大师

docker重点 学习以及指令资料

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80597552 --name 名称 -it -i 容器输入终端保持打开, -t开一个伪终端 ip ad li 查看网段 docker attach id 获取docker 有些容器进入不成功 后台运行 ctrl p + ctrl q 获取容器pid nsenter nsenter --target 4497 --mount --uts --ipc --net --pid root /usr/share/nginx/html 91 映像端口 80 容器被映像的端口 -h 指定主机名 -v 数据卷 docker run -it --name volume-test1 -h centos -v /datacentos docker inspect -f "{{.Volumes}}"volume-test1 docker日志如何存储 只读格式 useradd -s /sbin/nologin -M www 前台运行 docker commit -m "my nginx" c85374823499rainyday/my-ngnix:v1 #This is My first Dockerfile # Version 1.0 #Author : Rainyday From centos #MAINTAINER MAINTAINER Rainyday #ADD ADD pcre-8.42.tar.gz /usr/local/src ADD nginx-1.13.12.tar.gz /usr/local/src #RUN RUN yum install -y wget gcc gcc-c++ make openssl-devel RUN useradd -s /sbin/nologin -M www #WORKDIR WORKDIR /usr/local/src/nginx-1.13.12 RUN ./configure --prefix=/usr/local/nginx --user=www--with-http_ssl_module --with-http_stub_status_module--with-pcre=/usr/local/src/pcre-8.42 && make &&make install RUN echo "daemon off;" >>/usr/local/nginx/conf/nginx.conf ENV PATH /usr/local/nginx/sbin:$PATH EXPOSE 80 CMD ["nginx"] 资源限制 cgroup http://mirrors.aliyun.com/repo/ wget http://mirrors.aliyun.com/repo/epel-6.repo docker build -t stress . docker images docker run -it --rm -c 512 stress --cpu 1 指定cpu大小 docker run -it --rm stress --cpu 1 指定cpu docker run -it --rm --cpuset-cpus=0 stress --cpu 1 指定占用几个cpu docker exec id docker run -it --rm -m 128m stress --v m 1 --vm-bytes 120m --vm-hang 0 测压大于两倍关掉 cpu -c --cpu-set 内存 -m docker 网络模式 docker run -d -p 5001:5000 registry docker push localhost:5001/test/e:v1 docker tag d1fd7d86a825 47.106.154.105:5001/test/es:v1 echo '{"insecure-registries":["47.106.154.105:5001"] }' >/etc/docker/daemon.json docker pull 47.106.154.105:5001/test/e:v1 shipyard -H tcp:0.0.0.0:235 -H unix:///var:/run/docker.sock docker run -it -d --name shipyard-rethinkdb-data--entrypoint /bin/bash shipyard/rethinkdb -l

优秀的个人博客,低调大师

python学习-基础知识-1

1、计算机历史 计算机使用高低电压的两种状态来描述信息。计算机可以理解的只有二进制数据即010100011....,1个比特位可以表示的状态只有2种,n个比特位可以表示的状态有2的n次方种。 所以如果想要描述天气状态:天晴、下雨、刮风、下雪、霜冻,则需要使用3个比特位。 2、编程语言历史 计算机只能理解二进制数据,二进制数据中蕴含了很多指令、操作、数据,计算机通过cpu直接运行二进制代码执行不同的功能,二进制代码被称为机器语言。 但是机器语言(二进制代码)对于人类而言可读性太差、编写太困难,所以人类需要使用适合自身的语言来编程以操作计算机。 一开始,人类将机器语言中的代码进行分类、标记,把蕴含操作行为、蕴含数据的二进制代码使用英语单词标记,形成了汇编语言。汇编语言的模式是:操作行为+被操作数。 操作行为和被操作数都使用英语单词代替了一串010101的二进制代码,这样人类只需要编写汇编语言,再将汇编语言通过之前的映射关系转换成二进制即可。 通过汇编语言,人类即可以方便的编写代码,又可以通过转化得到对应的二进制代码让计算机运行。 但是,汇编语言依然可读性较差、编写也不是非常的方便,要实现一个简单的功能需要非常多的汇编代码,代码冗余性依然很高。 于是,人类模仿汇编和二进制的对应关系,将高级语言和汇编又对应起来,这时候人类就只需要编写高级语言,再通过编译器将高级语言转换成汇编语言或者直接转换成二进制代码。 高级语言的代码非常接近人类的英语,所以使用起来很方便。 因语法规则、语义的不同,高级语言分为很多种,如:python,java、c、c++、JavaScript,ruby等等。 3、编译型高级语言/解释性高级语言 高级语言接近人类英语,编写的代码可读性也很强,但是计算机是无法直接理解和执行源代码的,因为计算机只认识二进制代码,所以不论是哪一种高级语言,都需要将源代码转换成二进制代码后才能被计算机执行。 在转换过程中,有2种不同的情况: 1、编译型 编译型高级语言,在程序执行之前,需要提前将源代码通过编译器转换成目标文件(二进制代码),然后计算机直接执行目标文件。 优点:计算机执行效率高、速度快 缺点: 如果程序需要修改,必须修改源代码并再次编译,修改不方便 一旦编译完成,目标文件就只能在当前操作系统和cpu架构上运行,无法在其他平台使用,除非重新编译 举例:c、c++、c# 2、解释型 解释型高级语言,由解释器实时读取源代码并编译成二级制代码交由计算机执行。 优点: 程序的修改直接操作源文件即可,修改方便 只要计算机安装了对应平台的解释器,源代码就可以被执行,即一份源代码可以在不同平台运行,平台兼容性好 缺点: 因为需要实时编译,所以运行效率低、速度较慢 需要一个匹配版本和平台的解释器与源代码共同工作 举例:python、java、ruby 4、python版本 python有2个相互不兼容的大版本,版本2最高是2.7,版本3截止20180603最高是3.6.5。版本2官方宣布将会维护到2020年,建议现在选择版本3编码。 5、python解释器 解释器也是一种程序,功能是将python源代码翻译成机器语言。解释器可以使用多种语言编写,有如下几种: cpython,官方发布的解释器,使用c语言编写 ipython,在cpython基础上套了一个壳,提高用户交互性 pypy,据说使用jit技术动态实时编译使得代码运行速度更快,但是目前暂不成熟 jpython和icronpython,使用java和.net编写,一般不使用 6、python文件执行 两种方式执行python文件,一种是启动解释器并将python源文件作为参数,解释器读取文件中代码。一种是启动解释器,在交互环境编写代码执行。 7、变量 1、变量存在的原因 用于保存阶段性计算的结果,同时变量用于描述程序中的一些数据,良好的变量命名和使用会增加代码的可读性。 2、变量命名规范 变量名可以是数字、字母、下划线的任意组合,注意:不可使用除了下划线之外的特殊字符 变量名开头不能是数字 变量名不能和python预定义的关键字重名 注意:python竟然可以使用中文作为变量名! 3、变量定义语法 age = 26 定义一个变量,它的名字是age,此变量指向内存中的一个对象,此对象值是26 8、常量 常量的命名规范和变量一样,不过常量的命名约定俗成的是全大写。 常量用于保存基本不变的数据,python没有提供类似c语言的const关键字来强制规定常量的不可变性,所以python中的常量是约定俗成的不可变。 9、python安装 www.python.org官网下载最新版本3.6.5,根据电脑配置选择32或者64位,安装的时候选择add to path并自定义安装位置和其他高级选项,安装完成可以直接shell进入python解释器。 10、输入/输出 python中通过input函数提供shell输入,通过print函数提供shell打印。 input函数会阻塞程序执行直到获取shell输入值 11、注释 不论哪一种高级语言,我们在编码的时候都是将脑海中的思路、信息、步骤简化成实际的代码。将大脑中的信息转换成实际代码的时候,会有很大的信息量丢失,即代码所表达的信息量是很少的。 所以单独的代码无法还原编码时的全部信息量,此时我们就需要使用注释来弥补代码缺失的信息量。优秀的注释+代码可以提供很高的可读性,也方便后续代码使用和维护。 注释有几个需要遵守的规范: 1、注释的内容应该保持与代码的强一致性,注释应该精简、准确的表达代码的含义、编码背景等 2、可以使用中文或者英文 3、注意注释的使用量,在适当且必要的地方使用注释,如:重要流程节点、复杂代码块解释等 12、数据类型 计算机只认识二进制,对于计算机而言,数据没有类别,全部都是010101010... 但是对于人类而言,人类世界中的数据、信息是五花八门的,我们编码的过程其实就是在计算机世界中对现实世界进行建模的过程,所以我们需要对人类世界的数据划分类别。 基础的数据类型有:数字(整数+小数)、字符串、布尔值 我们使用int来表示整数类型、float表示小数类型 我们使用str表示字符串类型 我们使用bool表示布尔值类型 数字类型用于计算、字符串类型用于表示信息、布尔类型用于判断 13、字符串格式化输出 所谓格式化输出,其实就是在编码过程中定义展示模板,在模板中通过占位符代表后续有对应数据填充在此。 占位符: %d 整数类型 %f 小数类型 %s 字符串类型(%s是万能匹配,即任意数据类型都可以填充到%s占位符中) %r 原格式(将数据的原始格式存放到%r占位符中,如字符串的原格式就包含引号) 14、运算符 算数运算符 + - * / (注意,/ 除法运算符得到的商可以是小数,即5/2 = 2.5) // % (地板除得到的结果是商的整数部分,如5//2 = 2。取模得到的结果是未整除的结果,如5%2 = 1,对2取模可以判断奇偶。) ** (幂运算,5**2 = 25) 比较运算符 == > < >= <= != (==表示的是两边对象的值是否相等,python3中使用!=表示不等于,不再使用<>) 赋值运算符 = (赋值) += -= *= /= //= %= **= (在原有值的基础上做运算,并赋值给原有变量,如a = 5, a %= 2,此时a = 1) 逻辑运算符 and or no (逻辑判断会使用短路判断,所以:使用and的时候,概率小的放前面。使用or的时候,概率大的放前面。) 15、流程控制-分支 程序默认是自上而下没有分支的执行代码。很多时候我们需要通过判断程序运行中间的某一种状态、情况、值,来决策程序下一步该执行哪些代码。 通过分支提供多条执行路线,分支有双分支、多分支。 之所以可以划分多种分支是因为可能出现多种不同条件,而这些条件的概率和应该为1。 分支需要特别注意条件判断的逻辑性,多种条件只会执行其中一个条件,条件之间是相互对立的。 通过if elif elif else来提供多分支,通过条件的布尔值结果判断条件是否成立。 注意:条件判断应该把概率大的放在前面,概率小的放后面,对于无法明确具体判断条件的可以放在else统一匹配。另外,判断input的返回值的时候注意,input返回值一定是字符串。 16、流程控制-循环-while while关键字后面的语义是:判断条件是否成立?成立的话执行一次循环体然后再次判断条件是否成立。不成立的话跳过此循环体执行后续代码。 因为循环代码有导致死循环的风险,所以任何一个循环定义,都需要预先设计循环跳出条件。循环可以在循环体中通过break跳出,或者通过while条件判断不成立跳过。(当然,也可以在循环体中exit) 通过continue可以提前结束当前循环,直接开始下一次的循环while判断,注意:continue应用于跳过后续本应该执行的代码。 因为continue可以跳过后续本应该执行的代码,而后续执行代码中可能包含循环跳出的设置如:i += 1。所以continue的使用会有死循环风险,需要单独处理循环跳出问题。 17、while...else... 据说使用while后面的else,如果while正常执行完毕,则执行else。如果while没有正常执行完毕如被break打断,则不会执行else。可以使用else是否执行来判断循环是否正常执行完毕,我觉得这并不合理,考虑下述代码: 1 i = 11 2 while i < 10: 3 print('i is:', i) 4 i += 1 5 if i == 3: 6 break 7 else: 8 print('循环正常执行完毕') 9 10 # 循环没有正常执行完毕,实际上循环根本就没执行,else也被执行了。所以else被用于判断 11 # while是否正常执行我觉得并不合理。 18、while的使用 思考如下练习: # 使用while,完成以下图形的输出 # # * # * * # * * * # * * * * # * * * * * # * * * * # * * * # * * # * 1 star = 1 2 most_star = 5 3 while star <= most_star: 4 print(' *' * star) 5 if star == most_star: 6 while most_star > 0: 7 most_star -= 1 8 print(' *' * most_star) 9 break 10 star += 1 11 12 row = 1 13 most_row = 5 14 while row <= most_row: 15 print(' *' * row) 16 row += 1 17 row = most_row - 1 18 while row > 0: 19 print(' *' * row) 20 row -= 1 while循环只能打印一个方向,如果是两个相反的方向,需要两个while。两个while可以写成第二个while放在第一个while的末尾。

优秀的个人博客,低调大师

Java 学习(01)--DOS/环境/常量

1:计算机概述(了解) (1)计算机 (2)计算机硬件 (3)计算机软件 系统软件:window,linux,mac 应用软件:qq,yy,飞秋 (4)软件开发(理解) 软件:是由数据和指令组成的。(计算器) 开发:就是把软件做出来。 如何实现软件开发呢? 就是使用开发工具和计算机语言做出东西来 (5)语言 自然语言:人与人交流沟通的 计算机语言:人与计算机交流沟通的 C,C++,C#,Java (6)人机交换 图形界面:操作方便只管 DOS命令:需要记忆一些常见的命令 2:键盘功能键的认识和快捷键(掌握) (1)功能键的认识 tab shift ctrl alt windos 空格 上下左右 回车 截图 (2)快捷键 全选 Ctrl+A 复制 Ctrl+C 粘贴 Ctrl+V 剪切 Ctrl+X 撤销 Ctrl+Z 保存 Ctrl+S 3:常见的DOS命令(掌握) (1)常见的如下 盘符的切换 d:回车 目录的进入 cd javase cd javase\day01\code 目录的回退 cd.. cd\ 清屏 cls 退出 exit (2)其他的几个(了解) 创建目录 删除目录 创建文件 删除文件 显示目录下的内容 删除带内容的目录4:Java语言概述(了解) (1)Java语言的特点 有很多小特点,重点有两个开源,跨平台 (2)Java语言是跨平台的,请问是如何保证的呢?(理解) 针对不同的操作系统,提高不同的jvm来实现的。 (4)Java语言的平台 JavaSE JavaME--Android JavaEE 5:JDK,JRE,JVM的作用及关系(掌握) (1)作用 JVM:保证Java语言跨平台它是运行所有 Java 程序的抽象计算机 , 是 Java 语言的运行环境,它是 Java 最具吸 引力的特性之一, JVM 读取并处理编译过的与平台无关的字节码 (class) 文件。 Java 编译器针对 JVM 产生 class 文件,因此是独立于平台的。 Java 解释器负责将 JVM 的代码在特定的平台上运行。 Java 虚拟机是不跨平台的 JRE:Java程序的运行环境包括 Java 虚拟机 (JVM Java Virtual Machine) 和 Java 程序所需的核心类库等, 如果想要运行一个开发好的 Java 程序, 计算机中只需要安装 JRE 即可。 JDK:Java程序的开发环境 (jre、编译器)。 JDK 是提供给 Java 开发人员使 用的, 其中包含了 java 的开发工具,也包括了 JRE。 (2)关系 JDK:JRE+工具 JRE:JVM+类库 6:JDK的下载,安装,卸载(掌握) (1)下载到官网。 (2)安装 必须一步一步的安装,一般只要会点击下一步即可 注意:建议所有跟开发相关的软件都不要安装在有中文或者空格的目录下。 (3)卸载 a:控制面板 -- 添加删除程序 b:通过专业的软件卸载工具。(比如360的软件管家卸载) 7:第一个程序:HelloWorld案例(掌握) class HelloWorld { public static void main(String[] args) { System.out.println("HelloWorld"); } }(1)程序解释: A:Java程序的最基本单位是类,所以我们要定义一个类。 格式:class 类名 举例:class HelloWorld B:在类中写内容的时候,用大括号括起来。 C:Java程序要想执行,必须有main方法。 格式:public static void main(String[] args) D:要指向那些东西呢,也用大括号括起来。 E:你要做什么呢?今天我们仅仅做了一个简单的输出 格式:System.out.println("HelloWorld"); 注意:""里面的内容是可以改动的。 (2)Java程序的开发执行流程: A:编写java源程序(.java) B:通过javac命令编译生成.class文件 C:通过java命令运行.class文件 (要与 代码 中的类名相同) 8:常见的问题(掌握) (1)扩展名被隐藏 如何找到:查看--文件扩展名打上勾勾 (2)要求文件名称和类名一致。 实际上不这样做也是可以的。 但是,注意: javac后面跟的是文件名+扩展名 java后面跟的类名不带扩展名 (3)Java语言严格区分大小写,请注意。 (4)括号的配对问题。一般来说,括号都是成对出现的。 (6)遇到在类 HelloWorld 中找不到主方法,肯定是主方法的格式问题。 9:path环境变量(掌握) (1)path环境变量的作用 保证javac命令可以在任意目录下运行。 (2)path配置: 找到环境变量的位置,(我的电脑右击选属性--高级设置--环境变量)在系统变量里面 新建: 变量名:JAVA_HOME 变量值:D:\java\jdk8 修改: 变量名:Path 变量值:%JAVA_HOME%\bin 10:classpath环境变量(理解) (1)classpath环境变量的作用:保证class文件可以在任意目录下运行 (2)classpath环境变量的配置:找到环境变量的位置,在系统变量里面新建:变量名:classpath 变量值:d:\java教程\fy18\20180526\code\HelloWorld案例 (一般不用设置,文件较多时极难管理) 11:关键字(掌握) (1)被Java语言赋予特定含义的单词 (2)特点:全部小写。(3)注意事项:A:goto和const作为保留字存在。 B:类似于Notepad++这样的高级记事本会对关键字有特殊颜色标记 12:标识符(掌握) (1)就是给类,接口,方法,变量等起名字的字符序列 (2)组成规则: A:英文大小写字母 B:数字 C:$和_ (3)注意事项: A:不能以数字开头 B:不能是java中的关键字 C:区分大小写 13:注释(掌握) (1)就是对程序进行解释说明的文字 (2)分类: A:单行注释 // B:多行注释 /**/ C:文档注释(后面讲) /** */ (3)注释的作用 A:解释说明程序,提高了代码的阅读性。 B:可以帮助我们调试程序。 14:常量(掌握) (1)在程序执行的过程中,其值不发生改变的量(2)分类: A:字面值常量 B:自定义常量(后面讲)(3)字面值常量 A:字符串常量 "hello" B:整数常量 12,23 C:小数常量 12.345 D:字符常量 'a','A','0' E:布尔常量 true,false F:空常量 null (4) 在 Java 中针对整数常量提供了四种表现形式 A:二进制 由 0,1 组成。以 0b 开头。 B:八进制 由 0,1,...7 组成。以 0 开头。 C:十进制 由 0,1,...9 组成。整数默认是十进制。 D:十六进制 由 0,1,...9,a,b,c,d,e,f( 大小写均可 ) 组成。以 0x 开头。

优秀的个人博客,低调大师

day06_JDBC学习笔记

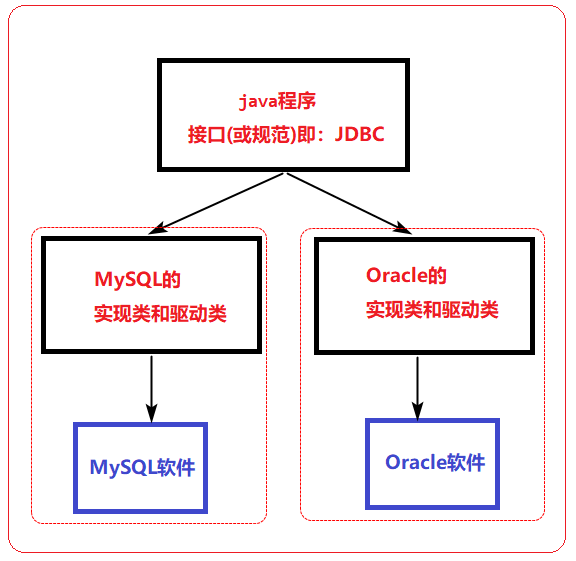
============================================================ 一、JDBC概述 为什么要使用JDBC? JDBC:JavaDataBaseConnectivity,是SUN公司提供的一套操作数据库的标准规范(技术)。 JDBC与数据库驱动的关系:接口与实现的关系。 JDBC规范(掌握四个核心对象): DriverManager类:用于注册驱动(创建连接对象)。java.sql.DriverManager; Connection接口:表示与数据库创建的连接 。java.sql.Connection; Statement接口:操作数据库sql语句的对象,并返回相应结果的对象。java.sql.Statement; preparedStatement接口:预编译对象,是Statement对象的子类。用于解决sql的注入问题。实际用的是这个类。java.sql.PreparedStatement; ResultSet接口:结果集或一张虚拟表(客户端存表数据的对象)。java.sql.ResultSet; 开发一个JDBC程序的准备工作: >JDBC规范在哪里: JDK中: java.sql.*; // jdk自身带的包 javax.sql.*; // 扩展包(企业级开发) >数据库厂商提供的驱动:jar文件(也即具体的实现) *.jar ============================================================ 二、开发一个JDBC程序(重要) 使用JDBC技术,通过java代码实现查询数据库中的数据并显示在java的控制台中。 1、先创建数据库表,并向表中添加测试数据。 create database day06; use day06; create table users ( id int primary key auto_increment, name varchar(40), password varchar(40), email varchar(60), birthday date ) character set utf8 collate utf8_general_ci; insert into users(name, password, email, birthday) values('zs', '123456', 'zs@sina.com', '1980-12-04'); insert into users(name, password, email, birthday) values('lisi', '123456', 'lisi@sina.com', '1981-12-04'); insert into users(name, password, email, birthday) values('wangwu', '123456', 'wangwu@sina.com', '1979-12-04'); 2、创建Java Project项目,添加数据库驱动(xxx.jar)。 3、实现JDBC操作。 ============================================================ 三、JDBC常用的类和接口详解 1、java.sql.Drivermanager类:注册驱动、建立连接 a、注册驱动 DriverManager.deregisterDriver(newcom.mysql.jdbc.Driver());// 不建议使用 原因有2个: >导致驱动被注册2次。 >强烈依赖数据库的驱动jar包 (若把奶瓶的BuildPath给Remove掉,代码就会报错,就能看到效果) 解决办法: Class.forName("com.mysql.jdbc.Driver");// 把奶瓶的BuildPath给Remove掉,代码也不会报错了 用到反射机制的知识:靠类的全路径来加载,解耦合了,不依赖数据库的驱动jar包了,以后会把上面的字符串放在配置文件里,更灵活了,便于后期维护。 b、与数据库建立连接 DriverManager类的静态方法: public staticConnectiongetConnection(Stringurl,Stringuser,Stringpassword) 试图建立到给定数据库URL的连接 DriverManager.getConnection("jdbc:mysql://localhost:3306/day06","root","root"); URL:是SUN公司与数据库厂商之间的一种协议。 jdbc:mysql://localhost:3306/day06 协议子协议 IP 数据库端口号数据库名称 mysql:jdbc:mysql://localhost:3306/day14或者 jdbc:mysql:///day14(默认连接本机的数据库) oracle:jdbc:oracle:thin:@localhost:1521:sid 瘦客户端,比如:玩页游协议 子协议子子协议 IP 数据库端口号数据库名称 oracle:jdbc:oracle:thick:@localhost:1521:sid 胖客户端,比如:LOL、魔兽世界(需要下载软件) 与数据库建立连接的方式 第一种: //publicstaticConnectiongetConnection(Stringurl,Stringuser,Stringpassword) Connectionconn=DriverManager.getConnection("jdbc:mysql://localhost:3306/day06","root","root"); 第二种: //publicstaticConnectiongetConnection(Stringurl,Propertiesinfo) Propertiesinfo=newProperties();//要参考数据库文档 info.setProperty("user","root"); info.setProperty("password","root"); Connectionconn=DriverManager.getConnection("jdbc:mysql://localhost:3306/day06",info); 第三种: //publicstaticConnectiongetConnection(Stringurl) Connectionconn=DriverManager.getConnection("jdbc:mysql://localhost:3306/day06?user=root&password=root"); //模拟表单form提交的两种方式:GET和POST 实际开发常用第一种。 扩展内容:演示3个案例的话需要写3个main方法,所以有了快速测试的方法 ==> junit技术 packagecom.itheima.junitdemo; publicclassCalc{ publicintadd(inta,intb){ returna+b; } publicdoublediv(doublea,intb){ returna/b; } } ------------------------------------------- packagecom.itheima.junitdemo; importorg.junit.Assert; importorg.junit.Test; //注:测试的方法有要求:不能有返回值,不能有参数。 publicclassTestCalc{ @Test publicvoidtest1(){ Calcc=newCalc(); Assert.assertEquals(8,c.add(3,5));//assert断言 } @Test publicvoidtest2(){ Calcc=newCalc(); Assert.assertEquals(3,c.div(10,3),0.4); } } ----------------------------------------------------------------------------- 2、java.sql.Connection接口:一个连接(与数据库连接的一座桥梁) 该接口的实现在数据库驱动jar包中。所有与数据库交互都是基于连接对象的。 //创建执行sql语句的对象Satement(接口) //Connection(接口)的方法:StatementcreateStatement() Statementstmt=conn.createStatement(); ----------------------------------------------------------------------------- 3、java.sql.Statement接口:操作sql语句,并返回相应结果的对象(小货车) 该接口的实现在数据库驱动jar包中。用于执行静态 SQL 语句并返回它所生成结果的对象。 //执行sql语句,该语句返回单个ResultSet结果集对象。 //Statement(接口)的方法:ResultSetexecuteQuery(Stringsql) //注意;该方法只能执行select语句。 ResultSetrs=stmt.executeQuery("select*fromusers"); //Statement(接口)的方法:int executeUpdate(Stringsql) //根据执行的DML(insertupdatedelete)语句,返回受影响的行数。 // 服务器端叫法:insert、delete、update、select(增删改查) // 客户端的叫法:create、read、update、delete(CRUD)(增删改查) inti=stmt.executeUpdate("INSERTINTOusersVALUES(4,'tom','123','tom@163.com','2015-09-28')"); inti=stmt.executeUpdate("UPDATEusersSETNAME='jerry',PASSWORD='333',email='jerry@163.com'WHEREid=4"); inti=stmt.executeUpdate("DELETEFROMusersWHEREid=4"); //Statement(接口)的方法:booleanexecute(Stringsql) // 这个方法很奇葩!!! //此方法可以执行任意sql语句。返回boolean值,表示是否返回ResultSet结果集。 //仅当执行select语句,且有返回结果时返回true,其它语句都返回false。 ----------------------------------------------------------------------------- 4、java.sql.ResultSet接口:结果集(客户端存表数据的对象) a、封装结果集 提供一个游标,默认游标指向结果集第一行之前(即表头)。 调用一次booleannext(),游标向下移动一行。 提供一些getXxx()方法。 ------------------------------------------- 将结果集中的数据封装到javaBean类中,javaBean就是一普通java类,该类中只有private类型的成员变量、无参构造方法和getter/setter方法。 java的数据类型与数据库中的类型的关系: JAVA DB byte tityint 1字节 short smallint 2字节 intint 4字节 long bigint 8字节 float float doubledouble String char 或者 varchar Datedate ------------------------------------------- ResultSet结果集封装数据的方法: ObjectgetObject(intcolumnIndex) 根据序号取值,索引从1开始 ObjectgetObject(StringColomnName) 根据列名取值 booleannext() 将光标从当前位置向下移动一行 intgetInt(intcolIndex) 以int 形式获取ResultSet结果集当前行指定列号值 intgetInt(StringcolLabel) 以int 形式获取ResultSet结果集当前行指定列名值 floatgetFloat(intcolIndex) 以float 形式获取ResultSet结果集当前行指定列号值 floatgetFloat(StringcolLabel) 以float形式获取ResultSet结果集当前行指定列名值 StringgetString(intcolIndex) 以String形式获取ResultSet结果集当前行指定列号值 StringgetString(StringcolLabel) 以String 形式获取ResultSet结果集当前行指定列名值 DategetDate(intcolumnIndex) 以Date形式获取ResultSet结果集当前行指定列号值 DategetDate(StringcolumnName) 以Date形式获取ResultSet结果集当前行指定列名 voidclose() 关闭ResultSet对象 ------------------------------------------- 1 package com.itheima.entitydemo; 2 3 import java.util.Date; 4 5 /* 6 * 一般实体类的类名和数据库的表名一致。(注意:若数据库的表名单词带s的,则实体类名就去掉s) 7 * 实体类的成员变量名和数据库表中的列名一致。(这是一个约定,网站开发的时候会提到) 8 */ 9 public class User { 10 private int id; 11 private String name; 12 private String password; 13 private String email; 14 private Date birthday; 15 16 public int getId() { 17 return id; 18 } 19 20 public void setId(int id) { 21 this.id = id; 22 } 23 24 public String getName() { 25 return name; 26 } 27 28 public void setName(String name) { 29 this.name = name; 30 } 31 32 public String getPassword() { 33 return password; 34 } 35 36 public void setPassword(String password) { 37 this.password = password; 38 } 39 40 public String getEmail() { 41 return email; 42 } 43 44 public void setEmail(String email) { 45 this.email = email; 46 } 47 48 public Date getBirthday() { 49 return birthday; 50 } 51 52 public void setBirthday(Date birthday) { 53 this.birthday = birthday; 54 } 55 56 @Override 57 public String toString() { 58 return "User [id=" + id + ", name=" + name + ", password=" + password + ", email=" + email + ", birthday=" 59 + birthday + "]"; 60 } 61 62 } User.java 1 package com.itheima.entitydemo; 2 3 import java.sql.Connection; 4 import java.sql.DriverManager; 5 import java.sql.ResultSet; 6 import java.sql.Statement; 7 import java.util.ArrayList; 8 import java.util.List; 9 10 import org.junit.Test; 11 12 /* 13 * 服务器端叫法:insert、delete、update、select (增删改查) 14 * 客户端的叫法:create、read、update、delete (CRUD)(增删改查) 15 */ 16 public class TestCRUD { 17 18 @Test 19 public void testSelect() throws Exception { 20 // 加载驱动 21 Class.forName("com.mysql.jdbc.Driver"); 22 23 // 获取连接对象Connection(注意:能用接口的就不用实现类,多态=>对象上传=>向上转型=>里氏替换,利于后期代码扩展) 24 Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/day06", "root", "root"); 25 26 // 获取执行sql语句的对象Statement 27 Statement stmt = conn.createStatement(); 28 29 // 执行sql的查询语句,并返回结果 30 ResultSet rs = stmt.executeQuery("select * from users"); 31 32 // 把取到的数据装到集合中 33 List<User> list = new ArrayList<User>(); 34 35 // 处理结果 36 User u = null; 37 while (rs.next()) { 38 u = new User(); 39 u.setId(rs.getInt("id")); 40 u.setName(rs.getString("name")); 41 u.setPassword(rs.getString("password")); 42 u.setEmail(rs.getString("email")); 43 u.setBirthday(rs.getDate("birthday")); 44 list.add(u); // 把对象添加到集合中去 45 } 46 47 // 遍历集合(增强for) 48 for (User user : list) { 49 System.out.println(user); 50 } 51 52 // 关闭资源 53 rs.close(); 54 stmt.close(); 55 conn.close(); 56 } 57 58 @Test 59 public void testInsert() throws Exception { 60 // 加载驱动 61 Class.forName("com.mysql.jdbc.Driver"); 62 63 // 获取连接对象Connection(注意;能用接口的就不用实现类,多态=>对象上传=>向上转型=>里氏替换,利于后期代码扩展) 64 Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/day06", "root", "root"); 65 66 // 获取执行sql语句的对象Statement 67 Statement stmt = conn.createStatement(); 68 69 // 执行sql的插入语句,并返回结果 70 int i = stmt.executeUpdate("INSERT INTO users VALUES (4, 'tom', '123','tom@163.com', '2015-09-28')"); 71 72 // 处理返回的结果 73 if (i > 0) { 74 System.out.println("success"); 75 } 76 77 // 关闭资源 78 stmt.close(); 79 conn.close(); 80 } 81 82 @Test 83 public void testUpdate() throws Exception { 84 // 加载驱动 85 Class.forName("com.mysql.jdbc.Driver"); 86 87 // 获取连接对象Connection(注意;能用接口的就不用实现类,多态=>对象上传=>向上转型=>里氏替换,利于后期代码扩展) 88 Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/day06", "root", "root"); 89 90 // 获取执行sql语句的对象Statement 91 Statement stmt = conn.createStatement(); 92 93 // 执行sql的更新语句,并返回结果 94 int i = stmt.executeUpdate("UPDATE users SET NAME = 'jerry', PASSWORD = '333', email = 'jerry@163.com' WHERE id = 4"); 95 96 // 处理返回的结果 97 if (i > 0) { 98 System.out.println("success"); 99 } 100 101 // 关闭资源 102 stmt.close(); 103 conn.close(); 104 } 105 106 @Test 107 public void testDelete() throws Exception { 108 // 加载驱动 109 Class.forName("com.mysql.jdbc.Driver"); 110 111 // 获取连接对象Connection(注意;能用接口的就不用实现类,多态=>对象上传=>向上转型=>里氏替换,利于后期代码扩展) 112 Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/day06", "root", "root"); 113 114 // 获取执行sql语句的对象Statement 115 Statement stmt = conn.createStatement(); 116 117 // 执行sql的删除语句,并返回结果 118 int i = stmt.executeUpdate("DELETE FROM users WHERE id = 4"); 119 120 // 处理返回的结果 121 if (i > 0) { 122 System.out.println("success"); 123 } 124 125 // 关闭资源 126 stmt.close(); 127 conn.close(); 128 } 129 130 } TestCRUD.java b、可移动游标的方法(现在很少用了,只有next()还常用) ResultSet结果集的方法: booleannext() 将光标从当前位置向前移一行 booleanprevious() 将光标移动到此ResultSet对象的上一行 booleanabsolute(introw) 参数是当前行的索引,从1开始,根据行的索引定位移动的指定索引行 voidafterLast() 将光标移动到末尾,正好位于最后一行之后 voidbeforeFirst() 将光标移动到开头,正好位于第一行之前(即表头) ----------------------------------------------------------------------------- 5、释放资源 资源有限,要正确关闭。 原则:在使用对象之前,先判断对象是否为空。 把某一部分代码加上try...catch...的快捷键:Alt+Shift+Z 1 package com.itheima.jdbcdemo; 2 3 import java.sql.Connection; 4 import java.sql.DriverManager; 5 import java.sql.ResultSet; 6 import java.sql.SQLException; 7 import java.sql.Statement; 8 9 /* 10 * 使用JDBC技术,通过java代码实现查询数据库中的数据并显示在java的控制台中。 11 * 12 * 演示正确释放资源。 13 * 14 * 把某一部分代码加上try...catch...的快捷键:Alt + Shift + Z 15 */ 16 public class Demo4 { 17 18 public static void main(String[] args) { 19 // 获取连接对象Connection 20 Connection conn = null; 21 // 获取执行sql语句的对象Statement 22 Statement stmt = null; 23 // 执行sql查询语句,并返回结果 24 ResultSet rs = null; 25 try { 26 // 加载驱动 27 Class.forName("com.mysql.jdbc.Driver"); 28 conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/day06", "root", "root"); 29 stmt = conn.createStatement(); 30 rs = stmt.executeQuery("select * from users"); 31 // 处理返回的结果 32 while (rs.next()) { 33 // 根据列名取值,顺序自己定,更灵活 34 System.out.println(rs.getObject("id")); 35 System.out.println(rs.getObject("name")); 36 System.out.println(rs.getObject("password")); 37 System.out.println(rs.getObject("email")); 38 System.out.println(rs.getObject("birthday")); 39 } 40 } catch (Exception e) { 41 e.printStackTrace(); 42 } finally { 43 // 关闭资源 44 if (rs != null) { 45 try { 46 rs.close(); 47 } catch (SQLException e) { 48 e.printStackTrace(); 49 } 50 } 51 if (stmt != null) { 52 try { 53 stmt.close(); 54 } catch (SQLException e) { 55 e.printStackTrace(); 56 } 57 } 58 if (conn != null) { 59 try { 60 conn.close(); 61 } catch (SQLException e) { 62 e.printStackTrace(); 63 } 64 } 65 } 66 } 67 } 演示正确释放资源 ============================================================ 四、使用JDBC实现CRUD操作 注意: *一般实体类的类名和数据库的表名一致。(注意:若数据库的表名单词带s的,则实体类名就去掉s) *实体类的成员变量名和数据库表中的列名一致。(这是一个约定,网站开发的时候会提到) 后续演示代码的实体类的类名为User。 其实名字可以随意起的,但是一般要求我们做到见名知意。 ============================================================ 五、实现一个用户登录的功能 ============================================================ 六、解决SQL注入问题:preparedStatement(预编译语句) preparedStatement(接口):预编译对象,是Statement(接口)对象的子类。 特点:(安全高效,防止恶义SQL语法) 1、性能要高;PreparedStatement实例包含已编译的SQL语句,所以其执行速度要快于Statement对象。 2、会把sql语句先编译。 3、sql语句中的参数会发生变化,过滤掉用户输入的关键字。 package com.itheima.service; import java.sql.Connection; import java.sql.PreparedStatement; import java.sql.ResultSet; import com.itheima.entity.User; import com.itheima.util.DBUtils; public class DoLogin { /** * 根据姓名和密码查询用户信息 * @param name * @param password * @return User */ public User findUser(String name, String password) { Connection conn = null; // Statement stmt = null; PreparedStatement stmt = null; ResultSet rs = null; User u = null; try { conn = DBUtils.getConnection(); // stmt = conn.createStatement(); // String sql = "select * from users where name = '" + name + "' and password = '" + password + "'"; // rs = stmt.executeQuery(sql); String sql = "select * from users where name = ? and password = ?"; stmt = conn.prepareStatement(sql); stmt.setString(1, name); // 给?赋值 stmt.setString(2, password); // 给?赋值 rs = stmt.executeQuery(); if (rs.next()) { u = new User(); u.setId(rs.getInt("id")); u.setName(rs.getString("name")); u.setPassword(rs.getString("password")); u.setEmail(rs.getString("email")); u.setBirthday(rs.getDate("birthday")); } } catch (Exception e) { e.printStackTrace(); } finally { DBUtils.closeAll(rs, stmt, conn); } return u; } } ============================================================我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

Java学习笔记--泛型(巨细)

泛型: 泛型在java基础中属于重要的一部分,掌握泛型是必要的。接下来以我的理解来解释一下 背景:编译器是先通过检查代码中泛型的类型 再进行类型擦除 再进行编译的 什么是泛型, 什么时候需要泛型, 泛型怎么用, 泛型注意的问题。 目前我接触的泛型应用就是集合使用泛型达到 一个集合里面只有一种类型的数据 泛型的好处: 1. 将运行时的异常提前至了编译时。 2. 避免了无谓的强制类型转换 。 泛型在集合中的常见应用: ArrayList<String> list = new ArrayList<String>(); true 推荐使用。 ArrayList<Object> list = new ArrayList<String>(); false ArrayList<String> list = new ArrayList<Object>(); false //以下两种写法主要是为了兼顾新老系统的兼用性问题。 * ArrayList<String> list = new ArrayList(); true ArrayList list = new ArrayList<String>(); true 注意: 泛型没有多态的概念,左右两边的数据 类型必须 要一致,或者只是写一边的泛型类型。 推荐使用: 两边都写泛型。 具体集合是上面类型的 是看左边的泛型是什么 举个常见的例子: 集合: ArrayList list = new ArrayList(); list.add("11"); list.add(3); 这个时候ArrayList集合中存储了多种类型,是不是看起来很不顺眼,日常应用中 我们想要的结果是 一个集合里面存储的类型是同一个。 如: ArrayList<String> list = new ArrayList<String>(); list.add("11"); list.add(3); //这个时候 集合list只能存放String类型的数据 //如果存储了其他的如 Integer类型之类的就会报错,是在编译前检查 泛型方法 public <T> T showKeyName(T a){//<T>是声明泛型方法 return a; } 泛型类: 自定义泛型: 自定义泛型就是一个数据类型的占位符或者是一个数据类型的变量。 class Point< T>{ // 此处可以随便写标识符号,T是type的简称 一般都是T private T var ; // var的类型由T指定,即:由外部指定 public T getVar(){ // 返回值的类型由外部决定 return var ; } public void setVar(T var){ // 设置的类型也由外部决定 this.var = var ; } }; 注意:在方法上自定义泛型,这个自定义泛型的具体数据类型 是在调用该方法的时候传入实参时确定具体的数据类型的。 泛型类还可以同时定义多个泛型 栗子: class Point< K,V>{ // 不一样的泛型 private K var ; // var的类型由K指定 private V time ; //time的类型由V指定 } }; 泛型类中要注意一: 静态方法无法访问类上定义的泛型 如果静态方法要使用泛型的话,必须将静态方法也定义成泛型方法 (原因我也不知道) 声明泛型一定要写在static后,返回值类型之前 class MyMessage<T>{ public T qu(T a) { System.out.println("qu"); return a; } public static <t> t ha(t a){ //静态函数需要重新泛型 System.out.println("ha"); return a; } } class new1{ public static void main(String[] args) { System.out.println(MyMessage.ha("aaa")); } } 注意 如果是调用静态的泛型函数时不能MyMessage<String>.ha("aaa") 传入具体泛型 泛型类中要注意二: 泛型类与泛型方法共存: public class Test1<T>{ public void testMethod(T t){ System.out.println(t.getClass().getName()); } public <T> T testMethod1(T t){ return t; } } 上面代码中,Test1<T> 是泛型类,testMethod 是泛型类中的普通方法, 而testMethod1是一个泛型方法。而泛型类中的类型参数与泛型方法中的类型参数 是没有相应的联系的,泛型方法始终以自己定义的类型参数为准。 意思就是调用testMethod1 结果是里面里面的那个决定的 而不是外面的那个类 如果在一个泛型类中存在泛型方法,那么两者的类型参数最好不要同名。 泛型方法与可变参数 再看一个泛型方法和可变参数的例子: public <T> void printMsg( T... args){ for(T t : args){ System.out.println(t); } } 泛型父类子类继承: class Son1 extends MyMessage<String>{ //指的是父类里面T是用String来代替了 //如果有重写的话 那么重写的父类类型是String public String ha(String a) { return a; } } class Son2<T> extends MyMessage<T>{ public T xx(T a) { return a; } } 泛型接口: class person<T>{ public T a(T az) { System.out.println("futher"); return az; } } class son extends person<Integer>{ @Override public Integer a(Integer az) { System.out.println("son"); return az; } } 注意:不能对确切的泛型类型使用instanceof操作。如下面的操作是非法的,编译时会出错。 List<String> aList=new ArrayList<String>(); aList instanceof List<String>//编译错误 泛型有个叫泛型擦除的 意思就是说 虽然有不同的泛型 但是在编译后计算机只看到Object类型的 举个栗子: List<String> aList1=new ArrayList<String>(); List<Integer> aList2=new ArrayList<Integer>(); 编译后就变成 List aList1=new ArrayList(); List aList2=new ArrayList(); //在编译生成的字节码中不包含泛型中的类型参数,类型参数会在编译时去掉。 //例如:List<String> 和 List<Integer> 在编译后都变成 List。 泛型通配符 先来看一个问题: public void showKeyValue1(Generic<Number> obj){ Log.d("泛型测试","key value is " + obj.getKey()); } Generic<Integer> gInteger = new Generic<Integer>(); Generic<Number> gNumber = new Generic<Number>(); showKeyValue(gInteger); // showKeyValue这个方法编译器会为我们报错: 我们来解决一下为什么会报错 问: 首先有个疑惑 不是有泛型擦除吗?为什么Generic<Integer>传递给 Generic<Number>的参数会报错 编译后不是变成Generic类型传递给Generic吗? 答:类型检查是在编译前判断的 所以是先判断类型 然后再泛型擦除 先来看一个问题: public void showKeyValue1(Generic<Number> obj){ Log.d("泛型测试","key value is " + obj.getKey()); } Generic<Integer> gInteger = new Generic<Integer>(); Generic<Number> gNumber = new Generic<Number>(); showKeyValue(gInteger); // showKeyValue这个方法编译器会为我们报错: 我们来解决一下为什么会报错 问: 首先有个疑惑 不是有泛型擦除吗?为什么Generic<Integer>传递给 Generic<Number>的参数会报错 编译后不是变成Generic类型传递给Generic吗? 答:类型检查是在编译前判断的 所以是先判断类型 然后再泛型擦除 问:Integer不是继承Number吗 为什么还无法传递? 答:相同参数类型的泛型类的继承关系取决于泛型类自身的继承结构。 List<Integer>和List<Number>是不同的对象 没有继承关系 前提泛型类自身一定要有继承关系 而泛型继承没有一点卵用 泛型一定要相同才行 (如果有通配符那么两个维度的继承同时满足也可以) 例如 List<String> 是 Collection<String> 的子类 List<Integer> 不是 Collection<Number> 的子类 栗子: 传入的参数是List<Integer> 形参1.public static String print(List<Integer> a) 可以通过 形参2.public static String print(List<Number> a) 不能通过 两个维度没有继承关系 形参3.public static<T> String print(List<T> a) 可以通过 形参4.public static String print(List<?> a) 可以通过 public static void zz(Collection<Integer> a) 可以通过 因为存在继承 public static void zz(Collection<Number> a) 不可以 传入参数List<String> 形参1 public static void xx(List<?> a)可以 形参2 public static void xx(List<? extends Number> a) 不可以 因为限制了范围 当类型声明中使用通配符 ? 时, 其子类型可以在两个维度上扩展。 例如 Collection<Number> 在维度1上扩展:List<? extends Number> 在维度2上扩展:Collection<Integer> 两个维度上同时扩展:List<Integer> 意思就是 Collection<Number>可以接收List<Integer> 总结: 引入泛型之后的类型系统增加了两个维度:一个是类型参数自身的继承体系结构, 另外一个是泛型类或接口自身的继承体系结构。第一个指的是对于 List<String> 和List<Object>这样的情况,类型参数String是继承自Object的。 而第二种指的是 List接口继承自Collection接口。 对于这个类型系统,有如下的一些规则: 相同类型参数的泛型类的关系取决于泛型类自身的继承体系结构。 即List<String>是Collection<String> 的子类型, List<String>可以替换Collection<String>。 这种情况也适用于带有上下界的类型声明。 当泛型类的类型声明中使用了通配符的时候,其子类型可以在两个维度上分别展开 如对Collection<? extends Number>来说, 其子类型可以在Collection这个维度上展开, 即List<? extends Number>和Set<? extends Number>等; 也可以在Number这个层次上展开,即Collection<Double>和 Collection<Integer>等。如此循环下去,ArrayList<Long>和 如果泛型类中包含多个类型参数,则对于每个类型参数分别应用上面的规则。 通配符写法: public static void zz(List<?> a) 通配符是实参而且还是根实参 不是形参 所以可接受任何泛型对象 还可以定义上边界和下边界: 上边界: public static void zz(List<? extends Number> a){ // 只能接收Number及其Number的子类 } 下边界: public static void zz(List<? super Integer > a){ // 只能接收Integer及其Integer的父类 } 如果类型的变量有限定那么原始类型就用第一个边界的类型变量代替 上界通配符后不能往集合添加元素 取出的元素也是上界父元素 add受限制 下届通配符 可以添加元素 必须是子类或者本身 取出的元素类型都是Object get受限制 获取数据用extend通配符 添加数据用super通配符 两个都想就不别用通配符 只有super有权限添加 其他的只能查看 提一下: Java泛型无法向上转型 class Info< T>{ private T var ; // 定义泛型变量 public void setVar(T var){ this.var = var ; } public T getVar(){ return this.var ; } public String toString(){ // 直接打印 return this.var.toString() ; } }; public class GenericsDemo23{ public static void main(String args[]){ Info< String> i1 = new Info< String>() ; // 泛型类型为String Info< Object> i2 = null ; i2 = i1 ; //这句会出错 incompatible types 因为两者不是一个对象 } }; 还有: 泛型的类型参数不能用在Java异常处理的catch语句中。因为异常处理是由JVM在运行时刻来进行的。由于类型信息被擦除,JVM是无法区分两个异常类型MyException;和MyException的。对于JVM来说,它们都是 MyException类型的。也就无法执行与异常对应的catch语句。 重点:在泛型中不能使用基本数据类型,如果需要使用基本数据类型,那么就使用基本数据类型对应的包装类型。 桥方法: 看看下面这个类SonPair class SonPair extends Pair<String>{ public void setFirst(String fir){....} } 很明显,程序员的本意是想在SonPair类中覆盖父类Pair的setFirst(T fir)这个方法。但事实上,SonPair中的setFirst(String fir)方法根本没有覆盖住Pair中的这个方法。 原因很简单,Pair在编译阶段已经被类型擦除为Pair了,它的setFirst方法变成了setFirst(Object fir)。 那么SonPair中setFirst(String)当然无法覆盖住父类的setFirst(Object)了。 这对于多态来说确实是个不小的麻烦,我们看看编译器是如何解决这个问题的。 编译器 会自动在 SonPair中生成一个桥方法(bridge method ) : public void setFirst(Object fir) { setFirst((String) fir) } 这样,SonPair的桥方法确实能够覆盖泛型父类的setFirst(Object) 了。而且桥方法内部其实调用的是子类字节setFirst(String)方法。对于多态来说就没问题了。 1.2)问题还没有完,多态中的方法覆盖是可以了,但是桥方法却带来了一个疑问: 现在,假设 我们还想在 SonPair 中覆盖getFirst()方法呢? class SonPair extends Pair<String> { public String getFirst(){....} } 由于需要桥方法来覆盖父类中的getFirst,编译器会自动在SonPair中生成一个 public Object getFirst()桥方法。 (干货——引入了桥方法,该方法是编译器生成的,不是程序员码出来的) 但是,疑问来了,SonPair中出现了两个方法签名一样的方法(只是返回类型不同): ①String getFirst() // 自己定义的方法 ②Object getFirst() // 编译器生成的桥方法 难道,编译器允许出现方法签名相同的多个方法存在于一个类中吗?事实上有一个知识点可能大家都不知道: ① 方法签名 确实只有方法名+参数列表 。这毫无疑问! ② 我们绝对不能编写出方法签名一样的多个方法 。如果这样写程序,编译器是不会放过的。这也毫无疑问! ③ 最重要的一点是: JVM会用参数类型和返回类型来确定一个方法。 一旦编译器通某种方式自己编译出方法签名一样的两个方法 (只能编译器自己来创造这种奇迹,我们程序员却不能人为的编写这种代码)。JVM还是能够分清楚这些方法的,前提是需要返回类型不一样。 结论: 在编译阶段,所有泛型类的类型参数都会被Object或者它们的限定边界来替换。(类型擦除) 在继承泛型类型的时候,桥方法的合成是为了避免类型变量擦除所带来的多态灾难。 最后提一下泛型数组 : List<String>[] ls = new ArrayList<String>[10]; 而使用通配符创建泛型数组是可以的,如下面这个例子: List<?>[] ls = new ArrayList<?>[10]; 泛型数组在java中是不支持的 因为泛型擦除的原因 如果创建了泛型数组 Object[] aa=new ArrayList[]; 加入可以创建 aa[0]=new ArrayList(); 编译器被骗 那么就是不安全的 还有协变……不是很了解

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册