首页 文章 精选 留言 我的

精选列表

搜索[鸿蒙实践],共10000篇文章
优秀的个人博客,低调大师

Vite + React 组件开发实践

简介:毫不夸张的说,Vite 给前端带来的绝对是一次革命性的变化。或者也可以说是 Vite 背后整合的 esbuild 、 Browser es modules、HMR、Pre-Bundling 等这些社区中关于 JS 编译发展的先进工具和思路,在 Vite 这样的整合推动下,给前端开发带来了革命性变化。 作者 | 风水 来源 | 阿里技术公众号 去年发表的《一个好的组件应该是什么样的?》 一文介绍了借助 TypeScript AST 语法树解析,对 React 组件 Props 类型定义及注释提取,自动生成组件对应 截图、用法、参数说明、README、Demo 等。在社区中取得了比较好的反响,同时应用在团队中也取得了较为不错的结果,现在内部组件系统中已经累计使用该方案沉淀 1000+ 的 React 组件。 之前我们是借助了 webpack + TypeScript 做了一套用于开发 React 组件的脚手架套件,当开发者要组件开发时,即可直接使用脚手架初始化对应项目结构进行开发。 虽然主路径上确实解决了组件开发中所遇到的组件无图无真相、组件参数文档缺失、组件用法文档缺失、组件 Demo 缺失、组件无法索引、组件产物不规范等内部组件管理和沉淀上的问题,但 Webpack 的方案始终还是会让组件开发多一层编译,当一个组件库沉淀超过 300+ 时,引入依赖不断增长,还是会带来组件编译上的负荷导致开发者开发体验下降。 一 Vite 带来的曙光 Vite 给前端带来的绝对是一次革命性的变化,这么说毫不夸张。 或许应该说是 Vite 背后整合的 esbuild 、 Browser es modules、HMR、Pre-Bundling 等这些社区中关于 JS 编译发展的先进工具和思路,在 Vite 这样的整合推动下,给前端开发带来了革命性变化。 我很早就说过,任何一个框架或者库的出现最有价值的一定不是它的代码本身,而是这些代码背后所带来的新思路、新启发。所以我在写文章的时候,也很注重能把我思考最后执行的整个过程讲清楚。 Vite 为什么快,主要是 esbuild 进行 pre-bundles dependencies + 浏览器 native ESM 动态编译,这里我不做过多赘述,详细参考:Vite: The Problems 在这个思路的背景下,回到我们组件开发的场景再看会发现以下几个问题高度吻合: 组件库开发,实际上不需要编译全部组件。 组件开发,编译预览页面主要给开发者使用,浏览器兼容可控。 HMR(热更新)能力在 Vite 加持下更加显得立竿见影,是以往组件开发和调试花费时间最多的地方。 Vite 中一切源码模块动态编译,也就是 TypeScript 类型定义和 JS 注释也可以做到动态编译,大大缩小编译范围。 那么,以往像 StoryBook 和之前我们用于提取 tsx 组件类型定义的思路将可以做一个比较大的改变。 之前为了获取组件入参的类型数据会在 Wwebpack 层面做插件用于动态分析 export 的 tsx 组件,在该组件下动态加入一段 __docgenInfo 的静态属性变量,将从 AST 分析得到的类型数据和注释信息注入进组件 JS Bundle,从而进一步处理为动态参数设置: TypeScript 对组件 Props 的定义 分析注入到 JS Bundle 中的内容 分析转换后实现的参数交互设置 所以对于组件来说,实际上获取这一份类型定义的元数据对于组件本身来说是冗余的,不论这个组件中的这部分元数据有没有被用到,都会在 Webpack 编译过程中解析提取并注入到组件 Bundle 中,这显然是很低效的。 在 Vite 的思路中,完全可以在使用到组件元数据时,再获取其元数据信息,比如加载一个 React 组件为: import ReactComponent from './component1.tsx' 那么加载其元数据即: import ComponentTypeInfo from './component1.tsx.type.json'; // or const ComponentTypeInfoPromise = import('./component1.tsx.type.json'); 通过 Vite 中 Rollup 的插件能力加载 .type.json 文件类型,从而做到对应组件元数据的解析。同时借助 Rollup 本身对于编译依赖收集和 HMR 的能力,做到组件类型变化的热更新。 二 设计思路 以上是看到 Vite 的模块加载思路,得到的一些灵感和启发,从而做出的一个初步设想。 但如果真的要做这样一个基于 Vite 的 React 、 Rax 组件开发套件,除了组件入参元数据的获取以外,当然还有其他需要解决的问题,首当其冲的就是对于 .md 的文件解析。 1 组件 Usage 参照 dumi 及 Icework 所提供的组件开发思路,组件 Usage 完全可以以 Markdown 写文档的形式写到任何一个 .md 文件中,由编译器动态解析其中关于 jsx、tsx、css、scss、less 的代码区块,并且把它当做一段可执行的 script 编译后,运行在页面中。 这样既是在写文档,又可以运行调试组件不同入参下组件表现情况,组件有多少中Case,可以写在不同的区块中交由用户自己选择查看,这个设计思路真是让人拍案叫绝! 最后,如果能结合上述提到 Vite 的 esbuild 动态加载和 HMR 能力,那么整个组件开发体验将会再一次得到质的飞跃。 所以针对 Markdown 文件需要做一个 Vite 插件来执行对 .md 的文件解析和加载,预期要实现的能力如下: import { content, modules } from "./component1/README.md"; // content README.md 的原文内容 // modules 通过解析获得的`jsx`,`tsx`,`css`,`scss`,`less` 运行模块 预期设想效果,请点击放大查看: 2 组件 Runtime 一个常规的组件库目录应该是什么样的?不论是在一个单独的组件仓库,还是在一个已有的业务项目中,其实组件的目录结构大同小异,大致如下: components ├── component1 │ ├── README.md │ ├── index.scss │ └── index.tsx ├── component2 │ ├── README.md │ ├── index.scss │ └── index.tsx 在我们的设想中你可以在任意一个项目中启动组件开发模式,在运行 vite-comp 之后就可以看到一个专门针对组件开发的界面,在上面已经帮你解析并渲染出来了在 README.md 中编写的组件 Usage,以及在 index.tsx 定义的 interface,只需要访问不同的文件路径,即可查看对应组件的表现形态。 同时,最后可以帮你可以将这个界面上的全部内容编译打包,截图发布到 NPM 上,别人看到这个组件将会清晰看到其组件入参,用法,截图等,甚至可以打开 Demo 地址,修改组件参数来查看组件不同状态下的表现形态。 如果要实现这样的效果,则需要一套组件运行的 Runtime 进行支持,这样才可以协调 React 组件、README.md、TypeScript 类型定义串联成我们所需要的组件调试+文档一体的组件开发页面。 在这样的 Runtime 中,同样需要借助 Vite 的模块解析能力,将其 URL 为*//(README|*).html 的请求,转换为一段可访问的组件 Runtime Html 返回给浏览器,从而让浏览器运行真正的组件开发页面。 http://localhost:7000/components/component1/README.html -> /components/component1/README.html -> /components/component1/README.md -> Runtime Html 3 组件 Props Interface 正如我上述内容中讲到的,如果利用 Vite 添加一个对 tsx 的组件 props interface 类型解析的能力,也可以做成独立插件用于解析 .tsx.type.json 结尾的文件类型,通过 import 这种类型的文件,从而让编译器动态解析其 tsx 文件中所定义的 TypeScript 类型,并作为模块返回给前端消费。 其加载过程就可以当做是一个虚拟的模块,可以理解为你可以通过直接 import 一个虚拟的文件地址,获取到对应的 React 组件元信息: // React Component import Component from './component1.tsx'; // React Component Props Interface import ComponentTypeInfo from './component1.tsx.type.json'; // or const ComponentTypeInfoPromise = import('./component1.tsx.type.json'); 由于这种解析能力并不是借助于 esbuild 进行,所以在转换性能上无法和组件主流程编译同步进行。 在请求到该文件类型时,需要考虑在 Vite 的 Serve 模式下,新开线程进行这部分内容编译,由于整个过程是异步行为,不会影响组件主流程渲染进度。当请求返回响应后,再用于渲染组件 Props 定义及侧边栏面板部分。 在热更新过程中,同样需要考虑到 tsx 文件修改范围是否涉及到 TypeScript 类型的更改,如果发现修改导致类型变化时,再触发 HMR 事件进行模块更新。 三 组件 Build 以上都是在讨论组件在 Vite 的 Serve 态(也就是开发态)下的情况,我们上文中大量借助 Vite 利用浏览器 es module 的加载能力,从而做的一些开发态的动态加载能力的扩展。 但是 Vite 在组件最终 Build 过程中是没有 Server 服务启动,当然也不会有浏览器动态加载,所以为了让别人也可以看到我们开发的组件,能够体验我们开发时调试组件的样子,就需要考虑为该组件编译产出一份可以被浏览器运行的 html。 所以在 Vite 插件开发过程中,是需要考虑在 Build 状态下的编译路径的,如果是在 Build 状态下,Vite 将使用 Rollup 的编译能力,那么就需要考虑手动提供所有组件的 rollup.input(entries)。 在插件编写过程中,一定需要遵循 Rollup 所提供的插件加载生命周期,才能保证 Build 过程和 Serve 过程的模块加载逻辑和编译逻辑保持一致。 我一开始在实现的过程中,就是没有了解透彻 Vite 和 Rollup 的关系,在模块解析过程中依赖了大量 Vite 的 Server 提供的服务端中间件能力。导致在考虑到 Build 态时,才意识到其中的问题,最后几乎重新写了之前的加载逻辑。 四 总结 我姑且把这个方案(套件)称之为 vite-comp,其大致的构成就是由 Vite + 3 Vite Pugins 构成,每个插件相互不耦合,相互职责也不相同,也就是说你可以拿到任意一个 Vite 插件去做别的用途,后续会考虑单独开源,分别是: Markdown,用于解析 .md 文件,加载后可获取原文及 jsx、tsx 等可运行区块。 TypeScript Interface,用于解析 .tsx 文件中对于 export 组件的 props 类型定义。 Vite Comp Runtime,用于运行组件开发态,编译最终组件文档。 结合 Vite,已经实现了 Vite 模式下的 React、Rax 组件开发,它相比于之前使用 Webpack 做的组件开发,已经体现出了以下几个大优势: 无惧大型组件库,即使有 2000 个组件在同一个项目中,启动依旧是 <1000ms。 高效的组件元数据加载流,项目一切依赖编译按需进行。 毫秒级热更新响应,借助 esbuild 几乎是按下保存的一瞬间,就可以看到改动效果。 预览体验: 启动 Markdown 组件文档毫秒级响应 TypeScript 类型识别 Vite 现在还是只是刚刚起步,这种全新的编译模式,已经给我带来了非常多的开发态收益,结合 Vite 的玩法未来一定还会层出不穷,比如 Midway + lambda + Vite 的前端一体化方案也是看得让人拍案叫绝,在这个欣欣向荣的前端大时代,相信不同前端产物都会和 Vite 结合出下一段传奇故事。 我是一个热爱生活的前端工程师!Yooh! 相关链接 https://vitejs.dev/guide/why.html#the-problems https://d.umijs.org/ https://ice.work/ 前端开发技术图谱 6 大知识点,14 个课程,680 个课时,将前端开发知识和实战经验融入图谱,包含 HTML 、CSS、JavaScript 、jQuery 、Vue 、React 、Angular 、NodeJS 等前端开发必备技能,帮你迅速提升。 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Pgbouncer最佳实践:系列三

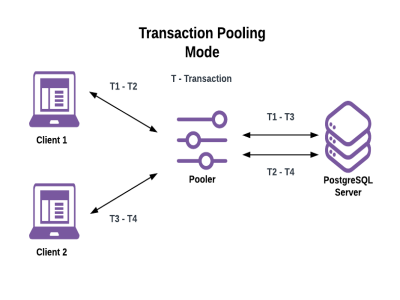
作者:王志斌,曾获得中国PostgreSQL数据库管理工程师(PGCE),是PostgreSQL官方认证讲师,盘古云课堂特邀金牌讲师。 PgBouncer具有三种可用的池模式:事务池,会话池和语句池: 事务连接池 数据库客户端很少在不间断的情况下执行连续的事务。而是通常在事务之间执行非数据库工作。这意味着服务器连接在等待新工作到达时会花费大量时间空闲。 事务池模式试图减少服务器连接的空闲时间,如下所示: 池程序在开始事务时将服务器连接分配给客户端。 客户端的事务完成后,池程序将释放连接分配。 注意事项: 如果客户端运行多个事务,则每个事务可以在不同的服务器连接上执行。 单个服务器连接可以在其生命周期内运行由不同客户端发出的事务。 图 6 事务连接池 与服务器所允许的连接相比,允许活动客户端的数量要多得多。尽管取决于给定的工作负载,但经常会看到10倍或更多的活动客户端连接与服务器连接比率。 这确实带来了一个重要的警告:客户端不再期望对数据库会话状态所做的更改在同一客户端进行的连续事务中继续存在,因为这些事务可能在不同的服务器连接上运行。此外,如果客户端进行会话状态更改,它们可能并且很可能会影响其他客户端。 以下是一些使用上面的事务池示例: 如果客户端1在T1中的第一个服务器连接上将会话设置为只读,而客户端2的T3是写事务,则T3将失败,因为它在现在的只读服务器连接上运行。 如果客户端1运行PREPARE a1 AS ...在T1上运行EXECUTE a1 ...,在T2上,则T2将失败,因为预编译语句对于运行T1的服务器连接是本地的。 如果客户端2在T3中创建了一个临时表并尝试在T4中使用它,则T4将失败,因为该临时表对于运行T3的服务器连接是本地的。 有关使用事务池时不支持的会话状态功能和操作的完整列表,请参见PgBouncer的列表 会话连接池 分配给客户端的服务器连接在客户端连接的整个生命周期内持续。这看起来好像根本不使用连接池一样,但是有一个重要的区别:当分配的客户端断开连接时,服务器连接不会被破坏。当客户端断开连接时,池管理器将: 清除客户端所做的任何会话状态更改。 将服务器连接返回到池中,以供其他客户端使用。 图 7 会话连接池 语句连接池 在此,服务器连接分配仅在单个语句的持续时间内持续。这具有与事务池模式相同的会话状态限制,同时还破坏了事务语义。 图 8 语句连接池 这使得所有客户端连接的行为就像在“自动提交”模式下一样。如果客户端尝试开始多语句事务,则合并程序将返回错误。尽管这是 表 3 连接池模式对比 从上述对比情况来看,在连接池的选择上,需要依据业务环境特点来进行选择,默认情况下推荐使用事务连接池,它兼顾了执行事务的特性,尤其多语句的支持,并且不会像会话连接池那样,尝尝处于等待状态。当然事务模式并不支持预编译语句。而根据具体业务场景的特殊需要,有些时候需要客户端与服务器端保持连接,或者支持预编译语句,这样只能选择会话池模式。还有一些特例情况,某些业务场景只是单语句执行,那么语句池模式可能更适合。因此对比这三种模式,可以发现从对客户端操作的支持程度来讲,会话池支持度最高,其次是事务池,最后是语句池模式。但是从支持的连接数来讲,可能刚好是相反的顺序。 表 4 SQL特性对照表 上表为会话连接池和事务连接池的SQL特性对比情况,可以通过对比具体业务场景与SQL特性的符合度,来对连接池模式进行选型。 下面列举了一些示例场景: 有些只运行快速查询,因此在没有事务的情况下可以共享一个会话来处理上百个并发查询。 一些角色成员对于会话级并发是安全的,并且总是使用事务。因此,他们可以安全地共享数百个并发事务的多个会话。 有些角色过于复杂,无法与其他人共享会话。因此,您对它们使用会话池模式可以避免当所有“插槽”都已占用时连接错误。 不要使用它代替HAProxy或其他负载均衡器。尽管pgbouncer具有一些可配置的功能来解决负载均衡器要解决的问题,例如dns_max_ttl,并且可以为其设置DNS配置,但是大多数产品环境都使用HAProxy或其他用于HA的负载均衡器。这是因为HAProxy确实擅长以循环方式在服务器之间实现负载平衡,而不是pgbouncer。尽管pgbouncer对于postgres连接池更好,但最好使用一个小型守护程序来完美地执行一项任务,而不是使用较大的守护程序来完成两项任务,那样效果更糟。 在对于连接数的建议值来讲,上文也给出了一个大致的结果,就是一般情况下设置为CPU核数的3-4倍左右,当然这个不是绝对值,应该是在与业务场景类似的硬件环境中充分进行测试后,才能够得出具体的数值。 还有一点需要注意的是连接Pgbouncer的连接方式,网络连接和unix socket连接方式,较网络连接,unix socket方式可能更加节省网络通信的开销,因此如果pgbouncer和数据库在一台机器部署,可以优选该方式;如果处于不同服务器上,则选择网络连接。 了解更多PostgreSQL热点资讯、新闻动态、精彩活动,请访问中国PostgreSQL官方网站 解决更多PostgreSQL相关知识、技术、工作问题,请访问中国PostgreSQL官方问答社区 下载更多PostgreSQL相关资料、工具、插件问题,请访问中国PostgreSQL官方下载网站

优秀的个人博客,低调大师

Phoenix索引构建最佳实践

用户福利 阿里云发布业界首款云原生多模数据库Lindorm,新用户可享9.9元/3个月优惠,技术交流钉钉群:35977898,更多内容请参考链接 背景 Phoenix的索引构建有两类方法: 同步构建,直接通过sqlline.py create index构建 在云HBase Phoenix 5.x之后,同步构建可以通过轻客户端或重客户端来构建。 异步构建,先create index ... async, 然后通过MR提交build索引job。 因此我们有三种方式构建索引:轻客户端、重客户端、MR异步构建,我们依次介绍下各种方案的优缺点、适用场景和使用方法。 同步构建-轻客户端 适用与数据量比较小,一般构建耗时在10分钟以内。使用方式: 直接使用轻客户端, sqlline-thin.py , create index 即可。 如果数据量较大,我们很可能会遇到索引build超时,我们释放调整Phoenix hbase.rpc.timeout、hbase.client.scanner.timeout.period、phoenix.query.timeoutMs 配置,重启Queryserver生效。 优点: 简单,不占用客户端资源,整个build过程是在服务端完成的。 缺点: 调整参数需要重启queryserver生效,重启过程会导致线上服务临时中断 调整参数会对线上服务造成影响如果有异常SQL导致的大请求会导致服务端负载高,调整了RPC超时时间, 一旦遇到这种请求,无法及时中断,可能对线上业务产生的影响。 无法控制并发,可能因为索引构建打爆服务器 同步构建-重客户端 重客户端适用于中小规模的数据构建,一般索引构建时间在10小时以内。 使用方式: 下载重客户端工具 部署在用户VPC下,机器配置大于等于4c8g;重客户端构建索引的过程中流量会经过这个节点,如果需要更快的索引构建,可以升级节点配置。 调整配置 bin/hbase-site.xml后,使用bin/sqline.py 集群地址 hbase.zookeeper.quorumzk 连接地址,注意使用VPC链接地址。 并发数 phoenix.query.threadPoolSize并发数,越大对目标集群读写压力,可以从1开始逐步增加 超时配置 phoenix.query.keepAliveMs hbase.rpc.timeout hbase.client.scanner.timeout.period phoenix.query.timeoutMs超时时间单位是ms, 可以按需调整。 for ex: <property> <name>hbase.zookeeper.quorum</name> <value>master1-1,master2-1,master3-1:2181</value> </property> <property> <name>phoenix.query.threadPoolSize</name> <value>1</value> </property> <property> <name>phoenix.query.keepAliveMs</name> <value>60000000</value> </property> <property> <name>hbase.rpc.timeout</name> <value>60000000</value> </property> <property> <name>hbase.client.scanner.timeout.period</name> <value>60000000</value> </property> <property> <name>phoenix.query.timeoutMs</name> <value>60000000</value> </property> 优点: 灵活,并发、超时时间可以按需调整,无需重启Phoenix集群,对线上服务影响小 缺点: 需要单独build索引的资源机器 受制于build索引机器的单机性能,扩展性差。 异步构建-MR MR索引构建适用于超大规模数据的情况。 使用方式: 异步索引构建方案 创建异步索引 CREATE INDEX async_index ON my_schema.my_table (v) ASYNC 提交MR JOB build 索引 hadoop --config /mr-phoenix-conf jar \ /mr-phoenix-conf/ali-phoenix-5.2.4.1-HBase-2.x-client.jar \ org.apache.phoenix.mapreduce.index.IndexTool \ --data-table {DATA_TABLE_XXXX} \ --index-table {INDEX_XXX} \ --output-path hdfs://hbase-cluster/ASYNC_INDEX_TMP ps: ali-phoenix-client获取,先下载重客户端包,解压后,取ali-phoenix-xxxx-HBase-2.x-client.jar 索引Build MR环境准备 自建Hadoop或者购买EMR Hadoop集群 在MR环境中创建mr-phoenix-conf目录 配置云HBASE的zk到hbase-site.xml,并此配置文件添加到mr-phoenix-conf目录 云HBase的zk地址可以从控制台获取。 拷贝以下hadoop配置文件到mr-phoenix-conf目录下,包括: core-site.xml、mapred-site.xml、yarn-site.xml、hdfs-site.xml 修改hdfs-site.xml(mr-phoenix-conf目录下) 增加hbase hdfs访问能力。 云HBase HDFS开端口和NN地址获取,找@云HBase答疑协助。 修改dfs.nameservices 增加hbase-cluster 增加hbase-cluster hdfs相关配置 EMR集群打通HBase集群参考配置 <property> <name>dfs.nameservices</name> <value>emr-cluster,hbase-cluster</value> </property> <property> <name>dfs.client.failover.proxy.provider.hbase-cluster</name> <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value> </property> <property> <name>dfs.ha.automatic-failover.enabled.hbase-cluster</name> <value>true</value> </property> <property> <name>dfs.ha.namenodes.hbase-cluster</name> <value>nn1,nn2</value> </property> <property> <name>dfs.namenode.rpc-address.hbase-cluster.nn1</name> <value>${nn1-host}:8020</value> </property> <property> <name>dfs.namenode.rpc-address.hbase-cluster.nn2</name> <value>${nn2-host}:8020</value> </property> 优点: 可以对任意规模数据进行索引构建, 扩展性强 缺点: 需要准备单独build资源 相对复杂 总结 适用数据量 优点 缺点 轻客户端 0~10GB 简单,无需额外资源 配置参数调整会影响线上服务 重客户端 10GB-512GB 可以灵活配置并发、超时参数,无需重启Phoenix集群 需要单独的构建索引的机器,受制于单机性能 MR异步构建 512GB~TB级 适用于任意规模索引构建,扩展性强 额外MR资源、MR集群配置复杂 一般少量数据直接用轻客户端来做索引构建,对于中小规模的数据推荐用重客户端来构建索引,而大规模数据则推荐用MR进行索引构建。 参考文档: Phoenix 二级索引:http://phoenix.apache.org/secondary_indexing.html AliPhoenix重客户端下载地址:https://hbase-opt.oss-cn-hangzhou.aliyuncs.com/ali-phoenix-5.2.4.1-HBase-2.x-all.tar.gz

优秀的个人博客,低调大师

中原银行 Arthas 实践之路

作者 | 于爽 中原银行系统研发工程师,目前在技术平台室中间件小组从事分布式缓存、消息队列等相关工作。 【Arthas 官方社区正在举行征文活动,参加即有奖品拿哦~点击投稿】 Arthas 是一款 Java应用开源诊断工具,由于其强大的问题排查及诊断能力,自其开源以来广受开发者的关注和使用,多次登顶 GitHub Trending,并得到国内多家技术媒体的推荐分享。 一. 定制化功能改造 Arthas 可以通过简单的命令交互模式,接入运行的 JVM,快速定位和诊断线上程序运行问题。在不重启服务的情况下,实时、动态的修改相关 code,并实时生效。具体工作原理如下: 1. 连接JVM:通过attach机制,通过attach pid连接正在运行的JVM; 2. 查看及修改JVM字节码:通过instrument技术对运行中的JVM附加或修改字节

优秀的个人博客,低调大师

云迁移的优秀实践

云迁移是将数据和应用程序从现场IT基础设施迁移到云平台的过程,仍然是许多企业的首要任务。事实上根据研究和预测,到2020年,全球将有83%的企业工作负载在云平台中,而AWS和Microsoft Azure等公共云平台将继续主导市场。随着移动设备的广泛采用和采用灵活的工作方式,企业越来越多地转向云平台,以寻求更大的IT敏捷性、可扩展性和业务连续性。 基于云计算的IT系统获得的好处是多方面的,但是在将企业IT系统迁移到云平台,同时确保员工、客户和供应链的“一切照旧”的过程中并非没有挑战。采用强有力的策略将使企业能够最好地获得回报,同时使流程尽可能高效和直接。 实施前需要精心策划 随着全球云计算市场的成熟,越来越多的首席信息官提出令人信服的商业案例来采用云计算。企业将其IT系统迁移到云中可能会产生很大的吸引力,但是实际上是不现实的。并非所有内容都可以迁移或应该迁移,并且还需要考虑迁移的顺序以及对业务和员工的影响。考虑企业的独特需求对于制定可获得云计算优势,而又不影响安全性、日常业务活动、现有遗留系统或浪费预算的计划至关重要。 并非所有内容都将迁移到云平台 许多应用程序和服务仍未针对虚拟环境进行优化,更不用说云计算了。无论企业的云计算战略多么雄心勃勃,都可能会留下大量的数据中心资源处理重要的数据和应用程序。支持这些系统可能是一个持续的挑战,尤其是当企业将更多的重要预算和资源放入云中时。 短期战略和长期战略的需要 针对长期、中期和短期目标制定云迁移策略可能会有所帮助。长期计划可能是将80%的应用程序和数据存储移至云中。但是在短期内,企业将需要考虑在进行云迁移时如何保持现有数据、硬件和应用程序的可访问性和安全性。第三方供应商可以在过渡期间帮助维护原有系统和硬件,以减轻干扰并确保业务连续性。 小心处置废旧硬盘和硬件 云迁移将不可避免地涉及某些硬件的淘汰。从安全角度来看,必须确保所有存储数据的安全,以避免使企业面临数据泄露的风险。许多企业低估了与硬盘相关的安全风险,或者错误地认为常规软件管理方法会提供足够的保护。 云迁移并不意味着减少工作量 尽管投资云计算可以将减少现场硬件和IT经理管理应用程序的数量,但这并不意味着减少工作量。采用云计算需要大量监督工作,以确保供应商满足服务水平协议,控制预算并避免云蔓延。这项至关重要的工作需要不同的技能,因此企业将需要考虑提高员工技能,并对员工进行再培训以管理他们不断变化的角色。 内部部署和云计算集成 云计算还带来了更加难以应对的集成挑战。许多IT管理人员发现,他们必须开发出将基于内部部署的硬件系统与云中的硬件系统集成的方法,以确保数据和应用程序可以彼此协同工作。在许多情况下,这涉及确保网络可以处理各种信息源之间的数据传输。但是,使云计算系统和非云系统相互协作可能非常困难,这不仅涉及难以管理的复杂项目,而且由于用于内部部署数据中心设施的资源较少而变得复杂。 提高IT成本效率 随着将更多预算从现场转移到云计算系统和其他IT外包服务上,许多IT管理人员在现场IT基础设施上的支出减少了。随着越来越多的数据中心需要采用云计算属性来跟上广泛的技术战略,企业的财务压力越来越大。寻找提高IT成本效率的方法对于应对内部部署数据中心维护挑战至关重要。 简化持续的IT成本 随着企业将业务迁移到云平台,随着原有的IT日趋老化,专用的硬件维护和操作系统支持策略使组织与OEM扩展维护服务相比,可以降低维护成本,同时还可以提供更灵活的服务计划。在许多情况下,第三方维护提供商可以为IT管理人员提供所需的服务,而成本却几乎降低了一半。最终结果是,IT团队可以腾出资源用于内部数据中心,并为支持仍在现场环境中运行的系统做好准备。尽管硬件维护计划可能无法解决所有问题,但它们提供了一致的财政和运营措施,使IT团队可以在出现问题时更轻松地管理其数据存储问题。

优秀的个人博客,低调大师

Spark最佳实践-项目规范

前言 大数据开发的日常工作中,开发人员经常需要使用 Spark、Flink 等计算引擎作为工具来实现一些 业务逻辑 的计算。 以 Spark 为例,开发人员会使用 SparkSQL、DataFrame、RDD 等不同形式的API来实现业务需求。 通常情况下,简单的需求都可以通过 SparkSQL、DataFrame 很方便的实现,其简洁的API也是其深受数据分析师青睐的原因之一。 但是正是因为 SparkSQL、DataFrame 的高层次封装,在 复杂度较高的计算需求 实现中,可能会出现 实现复杂或者API的功能性无法满足,或者千方百计实现需求之后 性能表现低下,代码段复杂而庞大 的情况。 尽管Spark允许开发人员通过UDF、UDAF等形式提供自定义的函数功能,但是此时很多人会选择使用较为底层的RDD接口进行开发:可控性好、开发与调试方便、性能强劲。 但是使用RDD接口来开发业务需求时,很多小的项目团队并没有一个统一的项目规范,需求开发完全由开发人员个人自己发挥。 各个业务项目的大致流程基本是相同的: 创建SparkSession 用 spark.table or spark.textFile 等API读取数据源 进行RDD的各种 Transformation 和 Action 操作 得到数据结果之后再调用 saveAsTable or saveAsTextFile 写入外部数据源中 虽然看起来流程挺一致的,但是其中仍然存在以下问题: 业务代码混乱 团队成员代码风格不一,有的喜欢一长串一长串的写,有的喜欢将过程封装 即使将过程封装了,但是封装的边界没有明确定义,仍然会有人不小心“越界” 读写数据源的API使用不统一 各个计算引擎对各个数据源都有不同的读写API接口提供使用,一些比较繁杂的API可能会被人“错误”使用 同时也会有人时常忘记对应接口如何使用,反复查阅资料 重复的编码工作 理论上所有业务项目,除了业务逻辑是变化的之外,其余应该都是一个不变的模板 开发人员应该专注于变化的业务逻辑,而不是每次都要分一些精力出来处理其他“边边角角”的事情 没有规范任由团队成员发挥的话,尽管有些成员能写一手漂亮的代码,但是你并不能保证所有人都这么优秀。 时间一久项目中代码的 坏味道 会越来越多,最后混乱的程度可能会超出你的想象。 为了解决以上问题,我们建议:定义一个项目规范,所有业务项目都需要遵守这个规范。 俗话说,有规矩成方圆。 有了项目规范,所有人都遵守这个标准来开发。 有了这个标准,我们就可以在标准化的基础上做很多事情,比如 定义自动化工具来帮助开发人员解放双手。 本文讨论的项目规范可以作为一种参考,以供读者与相关开发人员翻阅。 一、项目规范 和Java项目规范类似,以 模块化项目 的结构来定义项目规范可以为业务项目提供 结构化标准,其可以规整所有 混乱的业务项目结构。 项目结构标准化的重要性: 项目统一管理与生成 方便快速搭框架 所有开发人员遵守相同的编码规范 易于交接与维护 以下模块划分和Java项目类似,略微有些细节差异。 1.1 api模块 业务计算逻辑模块,不应该出现任何 Spark等执行框架的API 以 保持模块独立性与可移植。 理论上该模块可以独立构成一个单机程序执行,这样可以将最重要的业务逻辑根据需要迁移到任意计算引擎中,如 Spark 到 Spark Streaming、Flink 甚至 Hive UDF 等。 对外只提供接口调用,不可直接在外部实例化具体类(工厂模式) 所有service业务逻辑需要有对应的测试用例 事务控制、所有异常捕获和处理 依赖common 1.2 common模块 项目内通用的常量、枚举、POJO实体类、工具函数等,视情况分离,可集成到 context 中 不包含任何业务逻辑 不依赖其他模块 相关工具保持单例 1.3 context模块 Spark或者其他程序 执行入口,负责初始化各种计算引擎的环境变量。 系统 全局配置(conf)与脚本(bin) 集中管理 依赖server、api、common 程序关键点需要打印日志以便后续debug使用 1.4 server模块 整个项目中整合了业务逻辑调用、数据源读写等操作的模块,需求简单的情况下可以直接集成到 context 中。 该模块中根据不同的接口操作类,还划分了 dal、service与manager三个包。 1.4.1 dal包 主要是对数据进行操作,如读写常用的库:Hive、MySQL、HBase;以及读写文件系统:HDFS。 dal中的所有使用都由接口来定义,不同的接口实现使用不同的应用框架API,如Spark、Flink应该为两个独立的dal实现,在后续service使用过程中可以自由切换。 需要遵循以下原则: 所有bean对象,定义在dal 不得在dal写各种业务逻辑、数据清洗逻辑 一张表对应一个dal接口、一个bean,对应多个独立的dao实现 不允许在1个dao中同时操作多个表 包结构如下: basic: basic包下主要放一些基础对象,如BaseDao,所有dao都需要完善 TABLE_NAME bean: 定义数据源表结构,不同的数据源可以定义在不同的包中,如hive、hbase、mysql等 dao: 接口具体实现,用来操作数据表。如:增删改查 1.4.2 service包 和dao对接,一个service对应一个dao,service的使用都由接口来定义。 一个service下有两个实现包: 正常实现包:直接对接dao,简单处理一些判断:如参数不合法校验等。 测试实现包:模拟数据,可以不通过dao获取,从本地文件生成或代码中生成。 不同的计算框架有不同的service实现,如spark、flink等(需要传入其环境变量)。 1.4.3 manager包 调用service包实现数据增删改查 调用api模块进行业务逻辑组合 提供函数接口给context模块调用执行 二、代码框架 基于以上项目模块的划分,我们可以看到,api、common是 每次都会变化的业务逻辑和通用属性的抽取,而 context 是根据业务需要的计算引擎和运行环境设置的 执行入口。 以上三个模块都是 根据业务需求变化比较大的,而server模块则是负责对 其他各个模块的调用与整合,最后通过 manager 提供统一的函数接口给 context 入口调用执行。 所以 server 模块是这个项目规范中可以 自动化 起来的重点目标。 基于这个目标,我们开发了一个 大数据业务开发 基准项目的雏形,开发人员能够做到开箱即用,不必再花太多精力在研究计算引擎与各个数据源的接口和API如何调用,专注于业务逻辑的实现,提升开发效率。 项目地址:https://github.com/chubbyjiang/aisql-bigdata-base 使用介绍 org.aisql.bigdata.base.framework包中提供了几种常见大数据项目需要用到的数据源。 framework 以 模块化项目 的结构提供了 各个数据源基础的Dao、Service接口与默认实现。 配合自动化的代码生成工具,可以一键生成 server 模块的代码文件直接使用。 现在我们来看一下规范+自动化的威力,例如现有 default.t_users 表需要读取。 开发人员仅需要生成代码文件并复制到项目中,写代码如下: val service = new UsersService //读取整个表 val allRdd:RDD[Users] = service.selectAll() //字段筛选 val allRdd:RDD[Users] = service.selectAllWithCols(Seq("name","age")) //条件过滤 val allRdd:RDD[Users] = service.selectAllByWhere("age>10") //读取1000条数据 val demoRdd:RDD[Users] = service.selectDemo() //写入表 service.insertInto(demoRDD) service.createTable(demoRDD) 是不是 so easy? 其实所做的内容也就是在 server 模块中封装了 常用的不同计算引擎对不同数据源的读写操作API,并 自动化了 bean、dal、service 三个部分的代码生成。 使得开发人员可以直接使用 service 提供的数据操作接口 读出数据源 后 调用业务计算逻辑 处理完毕后 写入数据源 中。 通过对项目模块的标准化规范,我们可以以一个 比较统一和简单易懂的开发方式 来进行需求落地。 虽然刚开始使用规范的时候会有人觉得繁琐与不耐烦,如果是手动开发的话谁都会烦,都是一些重复性的苦力活儿,这就是框架规范的缺点:特别繁琐。 但是配套做一些自动化工具来使用的话,相信大部分开发人员都会觉得很酸爽,某种程度上标准化项目就是这么来提升开发效率的。

优秀的个人博客,低调大师

Kubernetes 日志查询分析实践

本文将介绍如何基于日志服务实现对 Kubernetes(以下简称 K8s)日志的采集以及查询分析,此外,还附带了对 Ingress、Audit 方案的简要介绍。为了方便大家通过操作来加深理解,本文提供了详细的操作步骤以及对应截图和配置代码。 准备工作 为了完成后续的相关操作,我们需要准备一个 K8s 集群,操作步骤如下: 登陆容器服务控制台。 创建一个标准托管集群(杭州区域),在向导中勾选上【使用 EIP 暴露 API Server】 和【使用日志服务】。 集群创建完毕后,回到集群列表页面,点击【更多->通过 CloudShell 管理集群】。 在 CloudShell 中输入 kubectl get ds -n kube-system,结果中显示的 logtail-ds 即为了实现数据采集所安装的日志服务组件。 打开日志服务控制台,可以看到和 K8s 集群 ID 所对应的 project 也已经创建完毕。 操作截图如下: 图:创建托管集群(步骤 2) 图:打开 CloudShell(步骤 3) 图:在 CloudShell 中查看日志服务组件(步骤 4) 图:打开日志服务控制台,查看 project(步骤 5) 1. 数据采集 在 K8s 环境下,容器日志数据从大体上分为两类:容器标准输出和容器内文本文件,前者是容器特有的一种日志存在形式,后者和传统的文本文件日志类似,只是文件存放在各个容器内部,相互之间隔离。下面我们将介绍如何对这两种类型的日志进行采集。 1.1. Mock 数据 我们将使用如下两个 YAML 文件分别生成标准输出和容器内文件两种形式的 mock 数据。 容器标准输出 # 创建两个 pod 来生成 mock 数据 apiVersion: batch/v1 kind: Job metadata: name: nginx-stdout-log-demo-1 namespace: nginx-stdout spec: template: metadata: name: nginx-stdout-log-demo-1 spec: containers: - name: nginx-stdout-log-demo-1 image: registry.cn-hangzhou.aliyuncs.com/log-service/docker-log-test:latest command: ["/bin/mock_log"] args: ["--stderr=false", "--stdout=true", "--log-type=nginx", "--total-count=100000000", "--logs-per-sec=5"] restartPolicy: Never --- apiVersion: batch/v1 kind: Job metadata: name: nginx-stdout-log-demo-2 namespace: nginx-stdout spec: template: metadata: name: nginx-stdout-log-demo-2 spec: containers: - name: nginx-stdout-log-demo-2 image: registry.cn-hangzhou.aliyuncs.com/log-service/docker-log-test:latest command: ["/bin/mock_log"] args: ["--stderr=false", "--stdout=true", "--log-type=nginx", "--total-count=100000000", "--logs-per-sec=5"] restartPolicy: Never 容器内文本文件(/var/log/access.log) apiVersion: batch/v1 kind: Job metadata: name: nginx-file-log-demo namespace: nginx-file spec: template: metadata: name: nginx-file-log-demo spec: restartPolicy: Never containers: - name: nginx-file-log-demo image: registry.cn-hangzhou.aliyuncs.com/log-service/docker-log-test:latest command: ["/bin/mock_log"] args: ["--log-type=nginx", "--stdout=false", "--stderr=false", "--path=/var/log/access.log", "--total-count=100000000", "--logs-per-sec=5"] 操作步骤: 打开 CloudShell,参考准备工作中的步骤 3。 在集群中应用上面提及的两个 YAML(Github)。 执行 kubectl get pods 查看负责生成日志的几个 Pod。 查看两个 Pod 生成日志的情况(根据实际情况替换命令中的 pod 名) 标准输出:执行 kubectl logs -n nginx-stdout --tail=10 nginx-stdout-log-demo-1-7kvwx。 容器内文件:执行 kubectl exec -n nginx-file nginx-file-log-demo-7frsp -- bash -c "tail /var/log/access.log"。 $ kubectl create namespace nginx-stdout $ kubectl create -f https://raw.githubusercontent.com/goclis/kubernetes-mock-log/master/pod_nginx_stdout.yaml $ kubectl create namespace nginx-file $ kubectl create -f https://raw.githubusercontent.com/goclis/kubernetes-mock-log/master/pod_nginx_file.yaml 命令:生成 mock 数据(步骤 2) $ kubectl get pods -A NAMESPACE NAME READY STATUS RESTARTS AGE nginx-file nginx-file-log-demo-7frsp 1/1 Running 0 2m9s nginx-stdout nginx-stdout-log-demo-1-7kvwx 1/1 Running 0 2m12s nginx-stdout nginx-stdout-log-demo-2-4x7vw 1/1 Running 0 2m12s 命令:查看日志服务组件(步骤 3) 1.2. 采集标准输出 操作步骤: 登陆日志服务控制台,点击进入集群 ID 对应的 project。 创建一个 logstore 用于存储标准输出日志,比如 k8s-stdout。 在 logstore 中新增 Logtail 配置,类型为【Docker 标准输出】,选择现有机器组中前缀为 k8s-group 的机器组。 在【数据源设置】页面,填写【配置名称】和【插件配置】。 操作截图如下: 图:创建 Logtail 采集配置 图:选择 Docker 标准输出配置 图:选择现有机器组 图:选择 k8s-group 开头的机器组 图:填写 Docker 标准输出采集配置内容 以下为两个可选的采集配置(使用 IncludeLabel 分别采集两个 namespace 下的数据,参考): 配置:采集 namespace nginx-stdout { "inputs": [ { "detail": { "IncludeLabel": { "io.kubernetes.pod.namespace": "nginx-stdout" }, "ExcludeLabel": {} }, "type": "service_docker_stdout" } ] } 配置:采集 namespace kube-system { "inputs": [ { "detail": { "IncludeLabel": { "io.kubernetes.pod.namespace": "kube-system" }, "ExcludeLabel": {} }, "type": "service_docker_stdout" } ] } 1.3. 采集容器内文件 操作步骤: 登陆日志服务控制台,点击进入集群 ID 对应的 project。 创建一个 logstore 用于存储容器内文件日志,比如 nginx-file。 在 logstore 中新增 Logtail 配置,类型为【Docker 文件】,选择现有机器组中前缀为 k8s-group 的机器组。 在【数据源设置】页面,填写【配置名称】和具体的配置信息(采集文件的路径、Label 等),示例为采集 /var/log/access.log。 图:选择 Docker 文件配置 图:填写 Docker 文件采集配置内容 2. 日志查询 2.1. 设置字段索引 & 开启日志聚类 为了使用日志服务提供的查询、日志聚类等功能,首先需要对索引进行配置。操作步骤如下: 登陆日志服务控制台,进入集群 ID 对应的 project,从左侧导航栏的 logstore 中选择先前创建的 k8s-stdout,展开点击查询分析进行查询控制台。 点击右上角的【查询分析属性 -> 设置索引】。 在弹出窗口中勾选上【日志聚类】,然后点击【自动生成索引】。 点击【确定】保存索引。 操作截图如下: 图:进入 logstore 查询分析界面 图:索引配置入口 图:开启日志聚类 图:自动生成字段索引 2.2. 基本查询 在配置完索引后,我们可以在查询输入框中使用查询语句可以快速地筛选日志,以下是一些示例: 查看命名空间 nginx-stdout 下的日志:_namespace_:nginx-stdout 查看其他命名空间下的日志:not _namespace_: nginx-stdout 查看命名空间 kube-system 下指定 pod 的日志:_namespace_: kube-system and _pod_name_: xxxxxx 在实际查询过程中,我们可以通过直接点击查询结果中的内容来快速填充查询语句,截图如下。 图:点击查询结果中的内容 图:查询语句快速填充 2.3. 日志聚类 & 上下文查询 & LiveTail 在排查问题时,我们一般会组合使用日志聚类、上下文查询以及 LiveTail 这三个功能来辅助问题排查。 首先,利用日志聚类来快速地查看日志模式,发现其中怀疑的问题日志。 接着,利用上下文查询,来跟踪问题日志前后的日志,辅助我们定位问题。 最后,在根据问题做出调整后,使用 LiveTail 来查看最新日志的变化情况,确认是否达到修改预期。 以下假设应用 pod 是 metrics-server,我们可以借助这套方法来对它进行分析: 查询输入框输入 metrics-server,点击查询分析,可以看到所有范围(默认为最近 15 分钟)的全部日志,一般来说会很多。 由于日志较多,为了发现日志模式,我们切换到【日志聚类】标签页,可以看到这段时间内的日志在模式上分为有限的几类。我们可以拖动 pattern 进度条选择粒度,对于特定 pattern,点击【日志数量】来查看具体日志。 悬停到日志时间左侧的图标,点击弹出菜单中的【上下文浏览】,在弹出页面中同样可以进行筛选,并点击【更早】、【更新】来查看指定日志的上文和下文。 悬停到日志时间左侧的图标,点击弹出菜单中的【LiveTail】。 图:日志聚类结果 图:上下文查询入口 图:上下文查询 图:LiveTail 3. Ingress & Audit 方案 除了 K8s 环境下基本的日志采集、查询分析功能以外,我们还针对 K8s 环境下的 Ingress、审计(Audit)日志提供了方案。 3.1. Ingress 为了在集群中部署 Ingress 方案,只需要在集群已安装日志服务组件的基础上,应用如下的 YAML 文件即可: apiVersion: log.alibabacloud.com/v1alpha1 kind: AliyunLogConfig metadata: # your config name, must be unique in you k8s cluster name: k8s-nginx-ingress spec: # logstore name to upload log logstore: nginx-ingress # product code, only for k8s nginx ingress productCode: k8s-nginx-ingress # logtail config detail logtailConfig: inputType: plugin # logtail config name, should be same with [metadata.name] configName: k8s-nginx-ingress inputDetail: plugin: inputs: - type: service_docker_stdout detail: IncludeLabel: io.kubernetes.container.name: nginx-ingress-controller Stderr: false Stdout: true processors: - type: processor_regex detail: KeepSource: false Keys: - client_ip - x_forward_for - remote_user - time - method - url - version - status - body_bytes_sent - http_referer - http_user_agent - request_length - request_time - proxy_upstream_name - upstream_addr - upstream_response_length - upstream_response_time - upstream_status - req_id - host NoKeyError: true NoMatchError: true Regex: ^(\S+)\s-\s\[([^]]+)]\s-\s(\S+)\s\[(\S+)\s\S+\s"(\w+)\s(\S+)\s([^"]+)"\s(\d+)\s(\d+)\s"([^"]*)"\s"([^"]*)"\s(\S+)\s(\S+)+\s\[([^]]*)]\s(\S+)\s(\S+)\s(\S+)\s(\S+)\s(\S+)\s*(\S*).* SourceKey: content 该 YAML 会在集群对应的日志服务 project 中创建一个名为 nginx-ingress 的 logstore,存储相关的日志,并且会对应地创建一系列基于 Ingress 日志所构建的详细报表,辅助我们分析 Ingress 日志。 图:Ingress 概览 更多信息可以阅读《Kubernetes Ingress 日志分析入门》。 审计(Audit) 目前,审计方案会在集群创建时自动应用,相关的日志会存储在日志服务 project 下以 audit- 为前缀的 logstore 中,其中包含针对集群操作的详细日志,比如资源(Pod、Deploy)的创建与删除、集群的扩容记录等。类似地,审计方案同样提供了一系列详细报表。 图:审计中心概览 更多信息可以阅读《最全 Kubernetes 审计日志方案》。 参考文档 Kubernetes 日志采集流程 容器文本日志采集 容器标准输出 扫码加入钉钉群

优秀的个人博客,低调大师

Nginx Ingress Controller 入门实践

Ingress是什么? 在 Kubernetes 集群中,Ingress是授权入站连接到达集群服务的规则集合,提供七层负载均衡能力。可以给 Ingress 配置提供外部可访问的 URL、负载均衡、SSL、基于名称的虚拟主机等。简单来说Ingress说一些规则集合,这些规则可以实现url到Kubernetes中的service这一层的路由功能。既然Ingress只是规则,那么这些规则的具体实现是怎么样的呢?是有Ingress-Controller来实现的,目前比较常见使用较多的是Nginx-Ingress-Controller。 可以这样理解一下,nginx-ingress-controller是一个nginx应用,它能干什么呢?它能代理后端的service,它能根据Ingress的配置,将对应的配置翻译成nginx应用的配置,来实现七层路由的功能。既然nginx-ingress-controller是作为一个类似网关的这么一个应用,那么我的nginx-ingress-controller这个应用本身就是需要在集群外能够访问到的,那么我是需要对外暴露nginx-ingress-controller这个应用的,在k8s中是通过创建一个LoadBalancer的Service:nginx-ingress-lb来暴露nginx-ingress-controller这个应用的。对应的,我们也就知道了nginx-ingress-controller这个应用从外部访问是通过nginx-ingress-lb这个service关联的SLB(负载均衡产品)来进行的。至于对应的slb的相关配置策略可以参考一下之前的文章,关于服务实现的内容。 简单的请求链路如下: 客户端 --> slb --> nginx-ingress-lb service --> nginx-ingress-controller pod --> app service --> app pod 我们使用Ingress来暴露服务,那么需要创建对应的资源,要想功能正常,nginx-ingress-controller的pod需要正常运行,nginx-ingress-lb service和slb监听配置正常才行,Ingress要关联的后端应用服务也是需要配置正确,包括应用pod运行正常,应用的service配置正确。 然后我们需要创建对应的Ingress来实现我们的需求。我们先创建一个简单的Ingress来大体看下具体的功能是什么样子的。我们这条Ingress的目的要实现:请求域名:ingress.test.com,实际请求会到后端的tomcat应用中。 相关配置: apiVersion: apps/v1beta2 kind: Deployment metadata: labels: app: tomcat name: tomcat namespace: default spec: progressDeadlineSeconds: 600 replicas: 1 revisionHistoryLimit: 10 selector: matchLabels: app: tomcat strategy: rollingUpdate: maxSurge: 25% maxUnavailable: 25% type: RollingUpdate template: metadata: labels: app: tomcat spec: containers: - image: 'tomcat:latest' imagePullPolicy: Always name: tomcat resources: requests: cpu: 100m memory: 200Mi terminationMessagePath: /dev/termination-log terminationMessagePolicy: File dnsPolicy: ClusterFirst restartPolicy: Always schedulerName: default-scheduler securityContext: {} terminationGracePeriodSeconds: 30 --- apiVersion: v1 kind: Service metadata: name: tomcat-svc namespace: default spec: clusterIP: 172.21.6.143 ports: - port: 8080 protocol: TCP targetPort: 8080 #service常见配置错误的地方,targetPort必须是pod暴露的端口,不能是其他的 selector: app: tomcat sessionAffinity: None type: ClusterIP --- apiVersion: extensions/v1beta1 kind: Ingress metadata: name: tomcat namespace: default spec: rules: - host: ingress.test.com http: paths: - backend: serviceName: tomcat-svc servicePort: 8080 path: / 在Ingress创建成功后会自动生成一个端点IP,我们应该将域名:ingress.test.com做A记录解析到这个端点IP。这样我们访问域名:ingress.test.com,实际请求会请求到我们的tomcat应用。 测试结果: #curl http://端点IP -H "host:ingress.test.com" -I HTTP/1.1 200 Date: Thu, 26 Sep 2019 04:55:39 GMT Content-Type: text/html;charset=UTF-8 Connection: keep-alive Vary: Accept-Encoding nginx-ingress-controller 配置分析 yaml如下: apiVersion: apps/v1beta2 kind: Deployment metadata: labels: app: ingress-nginx name: nginx-ingress-controller namespace: kube-system spec: progressDeadlineSeconds: 600 replicas: 2 revisionHistoryLimit: 10 selector: matchLabels: app: ingress-nginx strategy: rollingUpdate: maxSurge: 25% maxUnavailable: 25% type: RollingUpdate template: metadata: annotations: prometheus.io/port: '10254' prometheus.io/scrape: 'true' labels: app: ingress-nginx spec: affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - podAffinityTerm: labelSelector: matchExpressions: - key: app operator: In values: - ingress-nginx topologyKey: kubernetes.io/hostname weight: 100 containers: - args: - /nginx-ingress-controller - '--configmap=$(POD_NAMESPACE)/nginx-configuration' - '--tcp-services-configmap=$(POD_NAMESPACE)/tcp-services' - '--udp-services-configmap=$(POD_NAMESPACE)/udp-services' - '--annotations-prefix=nginx.ingress.kubernetes.io' - '--publish-service=$(POD_NAMESPACE)/nginx-ingress-lb' - '--v=2' env: - name: POD_NAME valueFrom: fieldRef: apiVersion: v1 fieldPath: metadata.name - name: POD_NAMESPACE valueFrom: fieldRef: apiVersion: v1 fieldPath: metadata.namespace image: >- registry-vpc.cn-shenzhen.aliyuncs.com/acs/aliyun-ingress-controller:v0.22.0.5-552e0db-aliyun imagePullPolicy: IfNotPresent livenessProbe: failureThreshold: 3 httpGet: path: /healthz port: 10254 scheme: HTTP initialDelaySeconds: 10 periodSeconds: 10 successThreshold: 1 timeoutSeconds: 1 name: nginx-ingress-controller ports: - containerPort: 80 name: http protocol: TCP - containerPort: 443 name: https protocol: TCP readinessProbe: failureThreshold: 3 httpGet: path: /healthz port: 10254 scheme: HTTP periodSeconds: 10 successThreshold: 1 timeoutSeconds: 1 resources: {} securityContext: capabilities: add: - NET_BIND_SERVICE drop: - ALL procMount: Default runAsUser: 33 terminationMessagePath: /dev/termination-log terminationMessagePolicy: File volumeMounts: - mountPath: /etc/localtime name: localtime readOnly: true dnsPolicy: ClusterFirst initContainers: - command: - /bin/sh - '-c' - | sysctl -w net.core.somaxconn=65535 sysctl -w net.ipv4.ip_local_port_range="1024 65535" sysctl -w fs.file-max=1048576 sysctl -w fs.inotify.max_user_instances=16384 sysctl -w fs.inotify.max_user_watches=524288 sysctl -w fs.inotify.max_queued_events=16384 image: 'registry-vpc.cn-shenzhen.aliyuncs.com/acs/busybox:latest' imagePullPolicy: Always name: init-sysctl resources: {} securityContext: privileged: true procMount: Default terminationMessagePath: /dev/termination-log terminationMessagePolicy: File nodeSelector: beta.kubernetes.io/os: linux restartPolicy: Always schedulerName: default-scheduler securityContext: {} serviceAccount: nginx-ingress-controller serviceAccountName: nginx-ingress-controller terminationGracePeriodSeconds: 30 volumes: - hostPath: path: /etc/localtime type: File name: localtime --- apiVersion: v1 kind: Service metadata: labels: app: nginx-ingress-lb name: nginx-ingress-lb namespace: kube-system spec: clusterIP: 172.21.11.181 externalTrafficPolicy: Local healthCheckNodePort: 32435 ports: - name: http nodePort: 31184 port: 80 protocol: TCP targetPort: 80 - name: https nodePort: 31972 port: 443 protocol: TCP targetPort: 443 selector: app: ingress-nginx sessionAffinity: None type: LoadBalancer 其中需要特别注意的配置是容器的args配置: --configmap=$(POD_NAMESPACE)/nginx-configuration 表明nginx-ingress-controller使用是哪个namespace下configmap来读取nginx-ingress-controller的nginx配置。默认是使用kube-system/nginx-configuration这个configmap。 --publish-service=$(POD_NAMESPACE)/nginx-ingress-lb 表明选择使用nginx-ingress-controller的Ingress的端点地址是使用的哪一个LoadBalancer的Service的扩展IP。默认是使用kube-system/nginx-ingress-lb这个Service。 --ingress-class=INGRESS_CLASS 这个配置是对nginx-ingress-controller自身的一个标识,表示我是谁,没有配置就是默认的“nginx”。这个配置有什么用呢?是用来让Ingress选择我要使用的ingress-controller是谁,Ingress通过注解:kubernetes.io/ingress.class: ""决定选择哪一个ingress-controller,如果没有配置那么就是选择--ingress-class=“nginx”这个ingress-controller。 如何在一个阿里云kubernetes集群里面部署多套Nginx Ingress Controller参考文档: https://yq.aliyun.com/articles/645856 之前我们也说了Ingress是规则,会下发到ingress-controller实现相关功能,那我们就来看下下发到ingress-controller的配置究竟是什么样。我们可以进入到nginx-ingress-controller的pod内来查看一下nginx配置。在pod内的/etc/nginx/nginx.conf里面,除了一些公共的配置外,上面的Ingress生成了如下的nginx.conf配置: ## start server ingress.test.com server { server_name ingress.test.com ; listen 80; set $proxy_upstream_name "-"; location / { set $namespace "default"; set $ingress_name "tomcat"; set $service_name "tomcat-svc"; set $service_port "8080"; set $location_path "/"; rewrite_by_lua_block { balancer.rewrite() } access_by_lua_block { balancer.access() } header_filter_by_lua_block { } body_filter_by_lua_block { } log_by_lua_block { balancer.log() monitor.call() } port_in_redirect off; set $proxy_upstream_name "default-tomcat-svc-8080"; set $proxy_host $proxy_upstream_name; client_max_body_size 100m; proxy_set_header Host $best_http_host; # Pass the extracted client certificate to the backend # Allow websocket connections proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection $connection_upgrade; proxy_set_header X-Request-ID $req_id; proxy_set_header X-Real-IP $the_real_ip; proxy_set_header X-Forwarded-For $the_real_ip; proxy_set_header X-Forwarded-Host $best_http_host; proxy_set_header X-Forwarded-Port $pass_port; proxy_set_header X-Forwarded-Proto $pass_access_scheme; proxy_set_header X-Original-URI $request_uri; proxy_set_header X-Scheme $pass_access_scheme; # Pass the original X-Forwarded-For proxy_set_header X-Original-Forwarded-For $http_x_forwarded_for; # mitigate HTTPoxy Vulnerability # https://www.nginx.com/blog/mitigating-the-httpoxy-vulnerability-with-nginx/ proxy_set_header Proxy ""; # Custom headers to proxied server proxy_connect_timeout 10s; proxy_send_timeout 60s; proxy_read_timeout 60s; proxy_buffering off; proxy_buffer_size 4k; proxy_buffers 4 4k; proxy_request_buffering on; proxy_http_version 1.1; proxy_cookie_domain off; proxy_cookie_path off; # In case of errors try the next upstream server before returning an error proxy_next_upstream error timeout; proxy_next_upstream_tries 3; proxy_pass http://upstream_balancer; proxy_redirect off; } } ## end server ingress.test.com Nginx.conf里面的配置比较多,这里就不在一一详解,后续我们再针对一些常见的功能配置进行说明。 同时最新版本的nginx-ingress-controller已经默认开启了Upstream的动态更新,可以在nginx-ingress-controller的pod内请求:curl http://127.0.0.1:18080/configuration/backends 查看。具体内容如下: [{"name":"default-tomcat-svc-8080","service":{"metadata":{"creationTimestamp":null},"spec":{"ports":[{"protocol":"TCP","port":8080,"targetPort":8080}],"selector":{"app":"tomcat"},"clusterIP":"172.21.6.143","type":"ClusterIP","sessionAffinity":"None"},"status":{"loadBalancer":{}}},"port":8080,"secureCACert":{"secret":"","caFilename":"","pemSha":""},"sslPassthrough":false,"endpoints":[{"address":"172.20.2.141","port":"8080"}],"sessionAffinityConfig":{"name":"","cookieSessionAffinity":{"name":"","hash":""}},"upstreamHashByConfig":{"upstream-hash-by-subset-size":3},"noServer":false,"trafficShapingPolicy":{"weight":0,"header":"","cookie":""}},{"name":"upstream-default-backend","port":0,"secureCACert":{"secret":"","caFilename":"","pemSha":""},"sslPassthrough":false,"endpoints":[{"address":"127.0.0.1","port":"8181"}],"sessionAffinityConfig":{"name":"","cookieSessionAffinity":{"name":"","hash":""}},"upstreamHashByConfig":{},"noServer":false,"trafficShapingPolicy":{"weight":0,"header":"","cookie":""}}] 我们可以看到这里有ingress关联的service及其endpoint的映射关系,这样可以就可以请求到具体的pod的业务了。 路由配置的动态更新可以参考文档了解一下:https://yq.aliyun.com/articles/692732 在后续的文章我们再详细讲一些常见的使用场景。


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册