首页 文章 精选 留言 我的

精选列表

搜索[多租户],共10000篇文章
优秀的个人博客,低调大师

多图详解万星 Restful 框架原理与实现

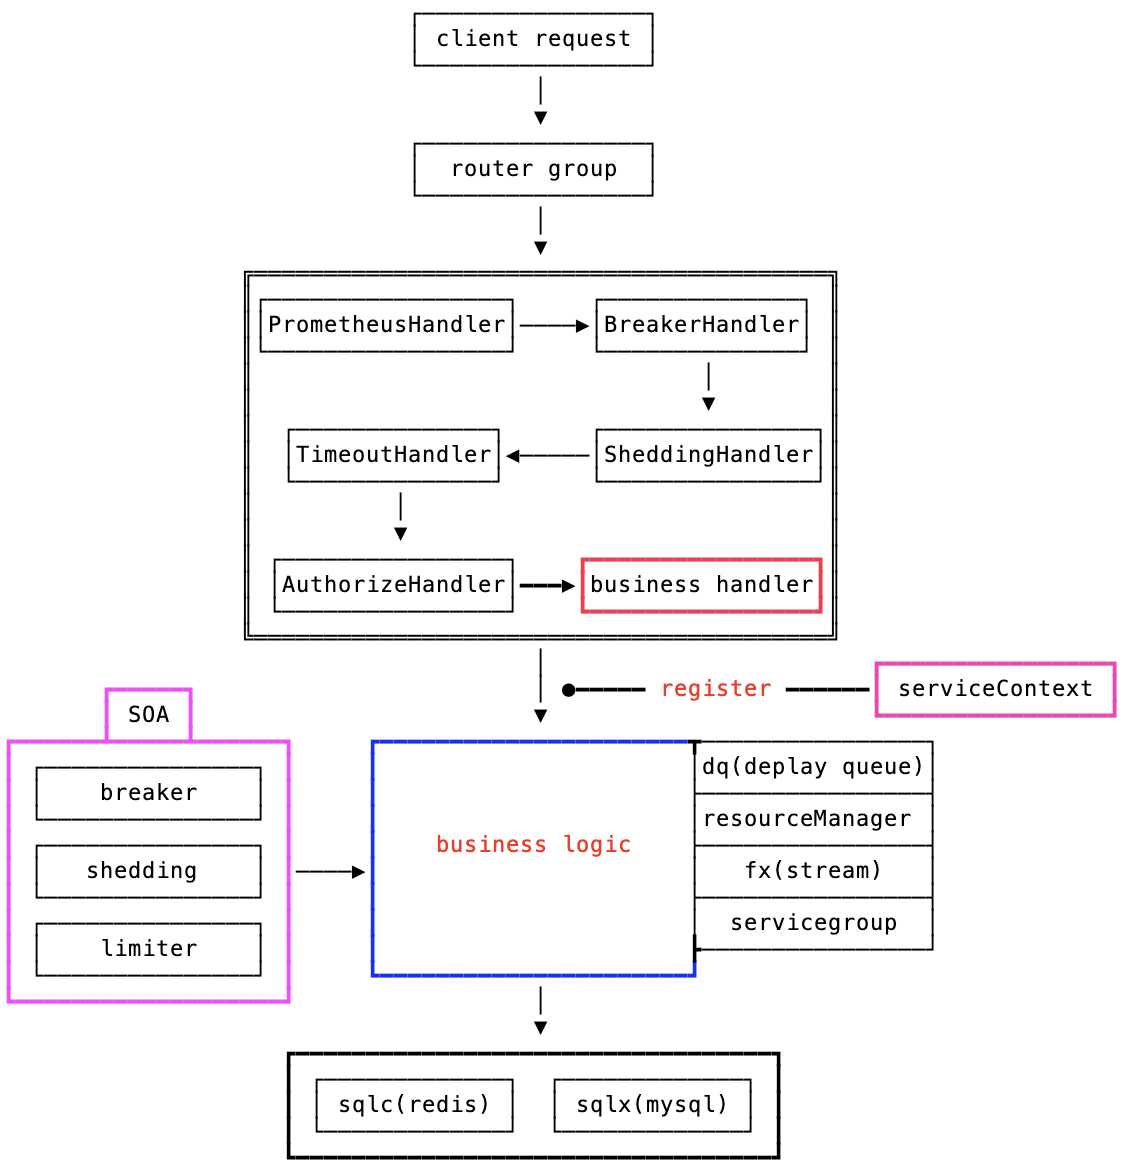
rest框架概览 我们先通过 go-zero 自带的命令行工具 goctl 来生成一个 api service,其 main 函数如下: func main() { flag.Parse() var c config.Config conf.MustLoad(*configFile, &c) ctx := svc.NewServiceContext(c) server := rest.MustNewServer(c.RestConf) defer server.Stop() handler.RegisterHandlers(server, ctx) fmt.Printf("Starting server at %s:%d...\n", c.Host, c.Port) server.Start() } 解析配置文件 将配置文件传入,初始化 serviceContext 初始化 rest server 将 context 注入 server 中: 注册路由 将 context 中的启动的 endpoint 同时注入到 router 当中 启动 server 接下来我们来一步步讲解其设计原理!Let's Go! web框架 从日常开发经验来说,一个好的 web 框架大致需要满足以下特性: 路由匹配/多路由支持 支持自定义中间件 框架和业务开发完全解耦,方便开发者快速开发 参数校验/匹配 监控/日志/指标等服务自查功能 服务自保护(熔断/限流) go-zero rest设计 > https://github.com/zeromicro/go-zero/tree/master/rest 概览 借助 context (不同于 gin 的 context),将资源初始化好 → 保存在 serviveCtx 中,在 handler 中共享(至于资源池化,交给资源自己处理,serviveCtx 只是入口和共享点) 独立 router 声明文件,同时加入 router group 的概念,方便开发者整理代码结构 内置若干中间件:监控/熔断/鉴权等 利用 goctl codegen + option 设计模式,方便开发者自己控制部分中间件的接入 上图描述了 rest 处理请求的模式和大部分处理路径。 框架内置的中间件已经帮开发者解决了大部分服务自处理的逻辑 同时 go-zero 在 business logic 处也给予开发者开箱即用的组件(dq、fx 等) 从开发模式上帮助开发者只需要关注自己的 business logic 以及所需资源准备 下面我们来细说一下整个 rest 是如何启动的? 启动流程 上图描述了整体 server 启动经过的模块和大致流程。准备按照如下流程分析 rest 实现: 基于 http.server 封装以及改造:把 engine(web框架核心) 和 option 隔离开 多路由匹配采取 radix-tree 构造 中间件采用洋葱模型 → []Middleware http parse 解析以及匹配校验 → httpx.Parse() 在请求过程会收集指标 (createMetrics()) 以及监控埋点 (prometheus) server engine封装 > 点开大图观看 engine 贯穿整个 server 生命周期中: router 会携带开发者定义的 path/handler,会在最后的 router.handle() 执行 注册的自定义中间件 + 框架中间件,在 router handler logic 前执行 在这里:go-zero 处理的粒度在 route 上,封装和处理都在 route 一层层执行 路由匹配 那么当 request 到来,首先是如何到路由这一层的? 首先在开发最原始的 http server ,都有这么一段代码: type helloHandler struct{} func (h *helloHandler) ServeHTTP(w http.ResponseWriter, r *http.Request) { w.Write([]byte("Hello, world!")) } func main() { http.Handle("/", &helloHandler{}) http.ListenAndServe(":12345", nil) } http.ListenAndServe() 内部会执行到:server.ListenAndServe() 我们看看在 rest 里面是怎么运用的: 而传入的 handler 其实就是:router.NewRouter() 生成的 router。这个 router 承载了整个 server 的处理函数集合。 同时 http.Server 结构在初始化时,是把 handler 注入到里面的: type Server struct { ... Handler Handler } func start(..., handler http.Handler, run func(srv *http.Server) error) (err error) { server := &http.Server{ Addr: fmt.Sprintf("%s:%d", host, port), Handler: handler, } ... return run(server) } 在 http.Server 接收 req 后,最终执行的也是:handler.ServeHTTP(rw, req) 所以内置的 router 也需要实现 ServeHTTP 。至于 router 自己是怎么实现 ServeHTTP :无外乎就是寻找匹配路由,然后执行路由对应的 handle logic。 解析参数 解析参数是 http 框架需要提供的基本能力。在 goctl code gen 生成的代码中,handler 层已经集成了 req argument parse 函数: // generate by goctl func QueryAllTaskHandler(ctx *svc.ServiceContext) http.HandlerFunc { return func(w http.ResponseWriter, r *http.Request) { // custom request in .api file var req types.QueryAllTaskRequest // parse http request if err := httpx.Parse(r, &req); err != nil { httpx.Error(w, err) return } l := logic.NewEventLogic(r.Context(), ctx) resp, err := l.QueryAllTask(req) baseresponse.FormatResponseWithRequest(resp, err, w, r) } } 进入到 httpx.Parse() ,主要解析以下几块: > https://github.com/zeromicro/go-zero/blob/master/rest/httpx/requests.go#L32:6 解析path 解析form表单 解析http header 解析json > Parse() 中的 参数校验 的功能见: > > https://go-zero.dev/cn/api-grammar.html 中的 tag修饰符 Tips 学习源码推荐 fork 出来边看边写注释和心得,可以加深理解,以后用到这块功能的时候也可以回头翻阅。 项目地址 https://github.com/zeromicro/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

基于token的多平台身份认证架构设计

1概述 在存在账号体系的信息系统中,对身份的鉴定是非常重要的事情。 随着移动互联网时代到来,客户端的类型越来越多, 逐渐出现了一个服务器,N个客户端的格局。 不同的客户端产生了不同的用户使用场景,这些场景: 有不同的环境安全威胁 不同的会话生存周期 不同的用户权限控制体系 不同级别的接口调用方式 综上所述,它们的身份认证方式也存在一定的区别。 本文将使用一定的篇幅对这些场景进行一些分析和梳理工作。 2使用场景 下面是一些在IT服务常见的一些使用场景: 用户在web浏览器端登录系统,使用系统服务 用户在手机端(Android/iOS)登录系统,使用系统服务 用户使用开放接口登录系统,调用系统服务 用户在PC处理登录状态时通过手机扫码授权手机登录(使用得比较少) 用户在手机处理登录状态进通过手机扫码授权PC进行登录(比较常见) 通过对场景的细分,得到如下不同的认证token类别: 原始账号密码类别 用户名和密码 API应用ID/KEY 会话ID类别 浏览器端token 移动端token API应用token 接口调用类别 接口访问token 身份授权类别 PC和移动端相互授权的token 3token的类别 不同场景的token进行如下几个维度的对比: 天然属性对比: 使用成本 本认证方式在使用的时候,造成的不便性。比如: 账号密码需要用户打开页面然后逐个键入 二维码需要用户掏出手机进行扫码操作 变化成本 本认证方式,token发生变化时,用户需要做出的相应更改的成本: 用户名和密码发生变化时,用户需要额外记忆和重新键入新密码 API应用ID/KEY发生变化时,第三方应用需要重新在代码中修改并部署 授权二维码发生变化时,需要用户重新打开手机应用进行扫码 环境风险 被偷窥的风险 被抓包的风险 被伪造的风险 可调控属性对比: 使用频率 在网路中传送的频率 有效时间 此token从创建到终结的生存时间 最终的目标:安全和影响。 安全和隐私性主要体现在: token 不容易被窃取和盗用(通过对传送频率控制) token 即使被窃取,产生的影响也是可控的(通过对有效时间控制) 关于隐私及隐私破坏后的后果,有如下的基本结论: 曝光频率高的容易被截获 生存周期长的在被截获后产生的影响更严重和深远 遵守如下原则: 变化成本高的token不要轻易变化 不轻易变化的token要减少曝光频率(网络传输次数) 曝光频率高的token的生存周期要尽量短 将各类token的固有特点及可控属性进行调控后,对每个指标进行量化评分(1~5分),我们可以得到如下的对比表: 备注: user_name/passwd和app_id/app_key是等价的效果 4token的层级关系 参考上一节的对比表,可以很容易对这些不同用途的token进行分层,主要可以分为4层: 密码层 最传统的用户和系统之间约定的数字身份认证方式 会话层 用户登录后的会话生命周期的会话认证 调用层 用户在会话期间对应用程序接口的调用认证 应用层 用户获取了接口访问调用权限后的一些场景或者身份认证应用 token的分层图如下: 在一个多客户端的信息系统里面,这些token的产生及应用的内在联系如下: 用户输入用户名和用户口令进行一次性认证 在不同的终端里面生成拥有不同生命周期的会话token 客户端会话token从服务端交换生命周期短但曝光频繁的接口访问token 会话token可以生成和刷新延长access_token的生存时间 access_token可以生成生存周期最短的用于授权的二维码的token 使用如上的架构有如下的好处: 良好的统一性。可以解决不同平台上认证token的生存周期的归一化问题 良好的解耦性。核心接口调用服务器的认证 access_token 可以完成独立的实现和部署 良好的层次性。不同平台的可以有完全不同的用户权限控制系统,这个控制可以在会话层中各平台解决掉 4.1账号密码 广义的账号/密码有如下的呈现方式: 传统的注册用户名和密码 应用程序的app_id/app_key 它们的特点如下: 会有特别的意义 比如:用户自己为了方便记忆,会设置有一定含义的账号和密码。 不常修改 账号密码对用户有特别含义,一般没有特殊情况不会愿意修改。 而app_id/app_key则会写在应用程序中,修改会意味着重新发布上线的成本 一旦泄露影响深远 正因为不常修改,只要泄露了基本相当于用户的网络身份被泄露,而且只要没被察觉这种身份盗用就会一直存在 所以在认证系统中应该尽量减少传输的机会,避免泄露。 4.2客户端会话token 功能:充当着session的角色,不同的客户端有不同的生命周期。 使用步骤: 用户使用账号密码,换取会话token 不同的平台的token有不同的特点。 Web平台生存周期短 主要原因: 环境安全性 由于web登录环境一般很可能是公共环境,被他人盗取的风险值较大 输入便捷性 在PC上使用键盘输入会比较便捷 移动端生存周期长 主要原因: 环境安全性 移动端平台是个人用户极其私密的平台,它人接触的机会不大 输入便捷性 在移动端上使用手指在小屏幕上触摸输入体验差,输入成本高 4.3access_token 功能:服务端应用程序api接口访问和调用的凭证。 使用步骤: 使用具有较长生命周期的会话token来换取此接口访问token。 其曝光频率直接和接口调用频率有关,属于高频使用的凭证。 为了照顾到隐私性,尽量减少其生命周期,即使被截取了,也不至于产生严重的后果。 注意:在客户端token之下还加上一个access_token, 主要是为了让具有不同生命周期的客户端token最后在调用api的时候, 能够具有统一的认证方式。 4.4pam_token 功能:由已经登录和认证的PC端生成的二维码的原始串号(Pc Auth Mobile)。 主要步骤如下: PC上用户已经完成认证,登录了系统 PC端生成一组和此用户相关联的pam_token PC端将此pam_token的使用链接生成二维码 移动端扫码后,请求服务器,并和用户信息关联 移动端获取refresh_token(长时效的会话) 根据 refresh_token 获取 access_token 完成正常的接口调用工作 备注: 生存周期为2分钟,2分钟后过期删除 没有被使用时,每1分钟变一次 被使用后,立刻删除掉 此种认证模式一般不会被使用到 4.5map_token 功能:由已经登录的移动app来扫码认证PC端系统,并完成PC端系统的登录(Mobile Auth Pc)。 主要步骤: 移动端完成用户身份的认证登录app 未登录的PC生成匿名的map_token 移动端扫码后在db中生成map_token和用户关联(完成签名) db同时针对此用户生成web_token PC端一直以map_token为参数查找此命名用户的web_token PC端根据web_token去获取access_token 后续正常的调用接口调用工作 备注: 生存周期为2分钟,2分钟后过期删除 没有被使用时,每1分钟变一次 被使用后,立刻删除掉 5小结与展望 本文所设计的基于token的身份认证系统,主要解决了如下的问题: token的分类问题 token的隐私性参数设置问题 token的使用场景问题 不同生命周期的token分层转化关系 本文中提到的设计方法,在应用层中可以适用于且不限于如下场景中: 用户登录 有时效的优惠券发放 有时效的邀请码发放 有时效的二维码授权 具有时效手机/邮件验证码 多个不同平台调用同一套API接口 多个平台使用同一个身份认证中心 至于更多的使用场景,就需要大家去发掘了。 关于如何在技术上实现不同token的生存周期问题,将在后续文章中进行介绍,敬请期待。 补充内容:关于具备生命周期的token的技术实现方式 1 http://www.cnblogs.com/beer/p/6030882.html

优秀的个人博客,低调大师

Scala 3.0.0-M3 发布,多范式编程语言

Scala 3.0.0-M3 已经发布。 作为“开发人员预览版”,Scala 3.0.0-M3 承载着收集 Scala 开发人员和用户反馈的任务。如果在 2020 年 12 月 18 日至 2021 年 1 月中旬之间未出现重大问题,Scala 中心团队和社区贡献者将继续使用相同的 API 在 2021 年 1 月底发布 Scala 3-RC1 版本。 更新细节 语言特性 given 语句中移除 as#10538 在模式中移除 as#10565 修复#10484: 切换回旧的上下文函数闭包语法#10487 添加可匹配特征#10670 元编程 添加 Expr.asTerm#10694 移除Expr.StringContext.unapply#10675 移除 reflect.LambdaType#10548 ...... 详情查看Scala 3.0.0-M3 版本细节 延伸阅读 Scala 3 版本规划

优秀的个人博客,低调大师

精选VS Code高频插件,让你多陪陪npy!

1.TODO Highlight 高亮显示你的 TODO、FIXME,支持自定义关键字和外观,可以起到良好的提示作用。 2.Vetur + Prettier + ESLint 解决冲突后配合使用完美格式化代码,能交给机器做的一定要学会偷懒。 3.Highlight Matching Tag 实时高亮匹配标签,不用在 HTML 中眼花缭乱的找标签了。 4.javascript console utils 快速生成 console.log() ,调试利器,妈妈再也不用担心你的指关节。 5.Code Runner 一键运行代码,支持很多语言。 6.Comment Translate 插件使用 Google Translate API 翻译注释,功能强大,在看开源项目源代码的时候很有用(英文好的话请忽略)。 7.Image preview 图片预览,可以在代码行号左侧槽位(或hover时)预览图片。 8.Version Lens 显示包版本信息,在 package.json 中显示包最新版本等信息。 9.vscode-pigments 实时显示css, sass, jsx中的颜色。 10.Auto Close Tag 自动补全标签。 11.Auto Rename Tag 同步修改标签。 12.Bracket Pair Colorizer 不同颜色高亮显示匹配的括号。 13.Code Spell Checker 单词拼写检查。 14.WakaTime 编程时间记录工具,在它的官网 Dashboard 中以图形化方式展示你的编程时间,让你更清晰的掌握你的时间都去哪了。 最后 关注公众号【前端宇宙】,每日获取好文推荐 添加微信,入群交流 本文分享自微信公众号 - 前端宇宙(gh_8184da923ced)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

利用ELK分析Nginx日志生产实战(高清多图)

本文以api.mingongge.com.cn域名为测试对象进行统计,日志为crm.mingongge.com.cn和risk.mingongge.com.cn请求之和(此二者域名不具生产换环境统计意义),生产环境请根据具体需要统计的域名进行统计。 由于涉及生产线上服务器,故本文部分服务器IP做了打码处理。 一、服务介绍 1.1、ELK ELK是三个开源软件的缩写,分别表示:Elasticsearch , Logstash, Kibana , 它们都是开源软件。新增了一个FileBeat,它是一个轻量级的日志收集处理工具(Agent),Filebeat占用资源少,适合于在各个服务器上搜集日志后传输给Logstash,官方也推荐此工具。 Elasticsearch是个开源分布式搜索引擎,提供搜集、分析、存储数据三大功能。它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。 Logstash 主要是用来日志的搜集、分析、过滤日志的工具,支持大量的数据获取方式。一般工作方式为c/s架构,client端安装在需要收集日志的主机上,server端负责将收到的各节点日志进行过滤、修改等操作在一并发往elasticsearch上去。 Kibana 也是一个开源和免费的工具,Kibana可以为 Logstash 和ElasticSearch 提供的日志分析友好的 Web 界面,可以帮助汇总、分析和搜索重要数据日志。 1.2、Nginx Nginx("engine x") 是一个高性能的HTTP和反向代理服务器,也是一个IMAP/POP3/SMTP代理服务器。 Nginx 是由 Igor Sysoev 为俄罗斯访问量第二的 Rambler.ru 站点开发的,第一个公开版本0.1.0发布于2004年10月4日。其将源代码以类BSD许可证的形式发布,因它的稳定性、丰富的功能集、示例配置文件和低系统资源的消耗而闻名。Nginx是一款轻量级的Web服务器/反向代理服务器及电子邮件(IMAP/POP3)代理服务器,并在一个BSD-like 协议下发行。由俄罗斯的程序设计师Igor Sysoev所开发,供俄国大型的入口网站及搜索引擎Rambler(俄文:Рамблер)使用。其特点是占有内存少,并发能力强,事实上nginx的并发能力确实在同类型的网页服务器中表现较好,中国大陆使用nginx网站用户有:新浪、网易、腾讯等。 本文中前端使用了nginx的反向代理功能,并使用了nginx的HTTP功能。 1.3、Kafka Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据。这种动作(网页浏览,搜索和其他用户的行动)是在现代网络上的许多社会功能的一个关键因素。 这些数据通常是由于吞吐量的要求而通过处理日志和日志聚合来解决。 对于像Hadoop一样的日志数据和离线分析系统,但又要求实时处理的限制,这是一个可行的解决方案。Kafka的目的是通过Hadoop的并行加载机制来统一线上和离线的消息处理,也是为了通过集群来提供实时的消息。 二、架构要求 2.1、架构描述 使用filebeat收集nginx日志,输出到kafka;logstash从kafka中消费日志,通过grok进行数据格式化,输出到elasticsearch中,kibana从elasticsearch中获取日志,进行过滤出图. 2.2、系统版本 CentOSLinuxrelease7.2.1511(Core)3.10.0-514.26.2.el7.x86_64 2.3、软件版本 jdk1.8.0_144nginx-1.12.2filebeat-6.3.2awurstmeister/kafka(docker image)logstash-6.5.4elasticsearch-6.4.0kibana-6.4.0 三、linux系统环境配置与优化 #查看服务器硬件信息dmidecode|grep"Product Name"#查看CPU型号grepname /proc/cpuinfo#查看CPU个数grep"physical id"/proc/cpuinfo#查看内存大小grepMemTotal /proc/meminfo 四、系统初始化 4.1、关闭防火墙 systemctlstopfilewalld 4.2、关闭selinux setenforce0sed -i's#SELINUX=enforcing#SELINUX=disabled#g'/etc/selinux/config 4.3、添加普通账户 useradd elsearchecho"******"|passwd--stdin elsearch 4.4、配置yum源 cat/etc/yum.repos.d/CentOS-Base.repo[base]name=CentOS-$releaseverenabled=1failovermethod=prioritybaseurl=http://mirrors.cloud.aliyuncs.com/centos/$releasever/os/$basearch/gpgcheck=1gpgkey=http://mirrors.cloud.aliyuncs.com/centos/RPM-GPG-KEY-CentOS-7[updates]name=CentOS-$releaseverenabled=1failovermethod=prioritybaseurl=http://mirrors.cloud.aliyuncs.com/centos/$releasever/updates/$basearch/gpgcheck=1gpgkey=http://mirrors.cloud.aliyuncs.com/centos/RPM-GPG-KEY-CentOS-7[extras]name=CentOS-$releaseverenabled=1failovermethod=prioritybaseurl=http://mirrors.cloud.aliyuncs.com/centos/$releasever/extras/$basearch/gpgcheck=1gpgkey=http://mirrors.cloud.aliyuncs.com/centos/RPM-GPG-KEY-CentOS-7 4.5、清理开机自启动服务 fori in `chkconfig --list|grep3:on|awk'{print$1}'`;dochkconfig$ioff;donefori in crond network rsyslog sshd;dochkconfig --level3$ion;donechkconfig--list|grep3:on 4.6、服务器时间同步 echo'*/5 * * * * /usr/sbin/ntpdate time.windows.com > /dev/null2>&1'>>/var/spool/cron/root 4.7、加大文件描述符 echo'* - nofile 65535'>>/etc/security/limits.conftail -1/etc/security/limits.conf#重新登陆后生效(无需重启)ulimit -n(重新登陆后查看) 4.8、内核参数调优(可不操作) \cp/etc/sysctl.conf/etc/sysctl.conf.bakcat>>/etc/sysctl.conf<<EOFnet.ipv4.tcp_timestamps=0net.ipv4.tcp_synack_retries=2net.ipv4.tcp_syn_retries=2net.ipv4.tcp_mem=94500000915000000927000000net.ipv4.tcp_max_orphans=3276800net.core.wmem_default=8388608net.core.rmem_default=8388608net.core.rmem_max=16777216net.core.wmem_max=16777216net.ipv4.tcp_rmem=40968738016777216net.ipv4.tcp_wmem=40966553616777216net.core.netdev_max_backlog=32768net.core.somaxconn=32768net.ipv4.tcp_syncookies=1net.ipv4.tcp_tw_reuse=1net.ipv4.tcp_tw_recycle=1net.ipv4.tcp_fin_timeout=1net.ipv4.tcp_keepalive_time=1200net.ipv4.tcp_max_syn_backlog=65536net.ipv4.ip_local_port_range=102465535EOF/sbin/sysctl-p 五、部署开始 5.1、更改nginx日志输出格式 5.1.1、定义日志格式 cat/etc/nginx/nginx.conflog_format main'$remote_addr-$remote_user[$time_local]"$request" ''$status$body_bytes_sent"$http_referer" ''"$http_user_agent" "$http_x_forwarded_for"'; 5.1.2、加载日志格式到对应域名配置中 cat/etc/nginx/conf.d/vhost/api.mingongge.com.cn.confserver {listen80;server_name newtest-msp-api.mingongge.com.cn;access_log /var/log/nginx/api.mingongge.com.cn.logmain;} 5.1.3、reload生效 nginx-s reload 5.1.4、清空原输出文件,并查看输出的日志格式 :> /var/log/nginx/api.mingongge.com.cn.logtailf /var/log/nginx/api.mingongger.com.cn.log1xx.2xx.72.175- - [18/Mar/2019:13:51:17+0800]"GET/user/fund/113 HTTP/1.1"200673"-""Mozilla/5.0 (WindowsNT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) sun/1.5.6 Chrome/69.0.3497.106Electron/4.0.3 Safari/537.36""-" 5.2、配置kafka 测试环境使用docker起的kafka,kafka部署掠过,以下任选一种 5.2.1、方法一 创建kafka topic ./kafka-topics.sh--create--topicnginxlog--replication-factor1--partitions1--zookeeperlocalhost:2181 5.2.2、方法二 auto.create.topics.enable=true 开启kafka自动创建topic配置 5.2.3、filebeat部署完成后确认kafka topic中有数据 ./kafka-console-consumer.sh--bootstrap-server192.168.0.53:9091--from-beginning--topicnginxlog 输出如下 {"@timestamp":"2019-03-14T07:16:50.140Z","@metadata":{"beat":"filebeat","type":"doc","version":"6.3.2","topic":"nginxlog"},"fields":{"log_topics":"nginxlog"},"beat":{"version":"6.3.2","name":"test-kafka-web","hostname":"test-kafka-web"},"host":{"name":"test-kafka-web"},"source":"/var/log/nginx/newtest-msp-api.mingongge.com.cn-80.log","offset":114942,"message":"116.226.72.175- - [14/Mar/2019:15:16:49+0800] newtest-msp-api.mingongge.com.cn POST\"/upstream/page\" \"-\" 200 6314\"http://newtest-msp-crm.mingongge.com.cn/\" 200 192.168.0.49:60070.024 0.024 \"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36(KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36\"\"-\""}Processedatotal of7516messages 测试环境中kafka地址为 192.168.0.53:9091 **5.3、配置filebeat收集nginx日志** 5.3.1、安装filebeat cd/opt/ && wgethttp://download.mingongge.com.cn/download/software/filebeat-6.3.2-x86_64.rpmyum localinstall filebeat-6.3.2-x86_64.rpm -y 5.3.2、编辑配置文件 cat/etc/filebeat/filebeat.ymlfilebeat.prospectors:- input_type:logenabled: truepaths:- /var/log/nginx/api.mingongge.com.cn.log#收集日志路径fields:log_topics:nginxlog #kafka中topic名称json.keys_under_root:truejson.overwrite_keys:trueoutput.kafka:enabled: truehosts:["192.168.0.53:9091"] #kafka地址topic:'%{[fields][log_topics]}'#kafka中topic名称partition.round_robin:reachable_only: falsecompression: gzipmax_message_bytes:1000000required_acks:1 5.3.3、启动filebeat& 开机启动 systemctlstartfilebeatsystemctlenablefilebeat 5.4、配置logstash 5.4.1 编辑配置 cat /usr/local/logstash/config/nginx.confinput {kafka {type =>"nginxlog"topics =>["nginxlog"]bootstrap_servers=> ["192.168.0.53:9091"]group_id =>"nginxlog"auto_offset_reset=> latestcodec =>"json"}}filter {if[type] =="nginxlog"{grok {match => {"message"=>"%{COMBINEDAPACHELOG}"}remove_field =>"message"}date {match => ["timestamp","dd/MMM/YYYY:HH:mm:ss Z"]}geoip {source =>"clientip"target =>"geoip"database =>"/usr/local/logstash/config/GeoLite2-City.mmdb"add_field => ["[geoip][coordinates]","%{[geoip][longitude]}"]#添加字段coordinates,值为经度add_field => ["[geoip][coordinates]","%{[geoip][latitude]}"]#添加字段coordinates,值为纬度}mutate {convert => ["[geoip][coordinates]","float"]}useragent {source =>"agent"target =>"userAgent"}}}output {if[type] =='nginxlog'{elasticsearch {hosts =>["http://192.168.0.48:9200"]index =>"logstash-nginxlog-%{+YYYY.MM.dd}"}stdout {codec =>rubydebug}}} 5.4.2、使用配置文件启动logstash服务,观察输出 /usr/local/logstash/bin/logstash -f nginx.conf{"httpversion"=>"1.1","verb"=>"GET","auth"=>"-","@timestamp"=>2019-03-18T06:41:27.000Z,"type"=>"nginxlog","json"=> {},"source"=>"/var/log/nginx/newtest-msp-api.mingongge.com.cn-80.log","fields"=>{"log_topics"=>"nginxlog"},"response"=>"200","offset"=>957434,"host"=> {"name"=>"test-kafka-web"},"beat"=> {"hostname"=>"test-kafka-web","version"=>"6.3.2","name"=>"test-kafka-web"},"bytes"=>"673","request"=>"/user/fund/113","timestamp"=>"18/Mar/2019:14:41:27 +0800","referrer"=>"\"-\"","userAgent"=> {"os"=>"Windows","major"=>"4","patch"=>"3","build"=>"","minor"=>"0","os_name"=>"Windows","device"=>"Other","name"=>"Electron"},"geoip"=> {"ip"=>"1xx.2xx.72.175","country_name"=>"China","coordinates"=> [[0]121.4012,[1]31.0449],"region_name"=>"Shanghai","location"=> {"lat"=>31.0449,"lon"=>121.4012},"continent_code"=>"AS","timezone"=>"Asia/Shanghai","longitude"=>121.4012,"city_name"=>"Shanghai","country_code2"=>"CN","region_code"=>"SH","latitude"=>31.0449,"country_code3"=>"CN"},"@version"=>"1","clientip"=>"1xx.2xx.72.175","ident"=>"-","agent"=>"\"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36(KHTML, like Gecko) sun/1.5.6 Chrome/69.0.3497.106 Electron/4.0.3Safari/537.36\""} 5.4.3、后台启动logstash 确认出现以上输出后,将logstash分离出当前shell,并放在后台运行 nohup /usr/local/logstash/bin/logstash -f nginx.conf &>/dev/null& 5.5、kibana配置 5.5.1、修改kibana配置 /usr/local/kibana-6.5.4-linux-x86_64/config/kibana.yml#增加高德地图tilemap.url:'http://webrd02.is.autonavi.com/appmaptile?lang=zh_cn&size=1&scale=1&style=7&x={x}&y={y}&z={z}' 5.5.2、创建Index Pattern 5.5.3、IP访问TOP5 选择柱形图 添加X轴,以geoip.ip为order by字段 5.5.4 、PV 选择metric 默认统计总日志条数,即为PV数 **5.5.5、全球访问地图** 选择map Field选择geoip.location 选择添加高德地图 5.5.6、实时流量 选择线条图 5.5.7、操作系统 选择饼图 5.5.8、登陆次数 过滤login关键字,并做count统计 5.5.9、访问地区 5.5.10、Dashboard展示 IP访问Top5:每日客户端IP请求数最多的前五个(可分析出攻击者IP) PV:每日页面访问量 全球访问图:直观的展示用户来自哪个国家哪个地区 实时流量:根据@timestamp字段来展示单位时间的请求数(可根据异常峰值判断是否遭遇攻击) 操作系统:展示客户端所用设备所占比重 登陆次数:通过过滤request中login的访问记录,粗略估算出进行过登陆的次数 访问地区:展示访问量最多的国家或地区 需展示其他指标,可进行自由发挥
优秀的个人博客,低调大师

一个@Transaction哪里来这么多坑?

点击蓝色“程序员DMZ”关注我哟 好看记得加个“星标”哈! 前言 在之前的文章中已经对Spring中的事务做了详细的分析了,这篇文章我们来聊一聊平常工作时使用事务可能出现的一些问题(本文主要针对使用@Transactional进行事务管理的方式进行讨论)以及对应的解决方案 事务失效 事务回滚相关问题 读写分离跟事务结合使用时的问题 事务失效 事务失效我们一般要从两个方面排查问题 数据库层面 数据库层面,数据库使用的存储引擎是否支持事务?默认情况下MySQL数据库使用的是Innodb存储引擎(5.5版本之后),它是支持事务的,但是如果你的表特地修改了存储引擎,例如,你通过下面的语句修改了表使用的存储引擎为MyISAM,而MyISAM又是不支持事务的 altertabletable_nameengine=myisam; 这样就会出现“事务失效”的问题了 「解决方案」:修改存储引擎为Innodb。 业务代码层面 业务层面的代码是否有问题,这就有很多种可能了 我们要使用Spring的声明式事务,那么需要执行事务的Bean是否已经交由了Spring管理?在代码中的体现就是类上是否有 @Service、 Component等一系列注解 「解决方案」:将Bean交由Spring进行管理(添加@Service注解) @Transactional注解是否被放在了合适的位置。在上篇文章中我们对Spring中事务失效的原理做了详细的分析,其中也分析了Spring内部是如何解析 @Transactional注解的,我们稍微回顾下代码: 注解解析 ❝ 代码位于:AbstractFallbackTransactionAttributeSource#computeTransactionAttribute中 ❞ 也就是说,默认情况下你无法使用@Transactional对一个非public的方法进行事务管理 「解决方案」:修改需要事务管理的方法为public。 出现了自调用。什么是自调用呢?我们看个例子 @ServicepublicclassDmzService{publicvoidsaveAB(Aa,Bb){saveA(a);saveB(b);}@TransactionalpublicvoidsaveA(Aa){dao.saveA(a);}@TransactionalpublicvoidsaveB(Bb){dao.saveB(a);}} 上面三个方法都在同一个类DmzService中,其中saveAB方法中调用了本类中的saveA跟saveB方法,这就是自调用。在上面的例子中saveA跟saveB上的事务会失效 那么自调用为什么会导致事务失效呢?我们知道Spring中事务的实现是依赖于AOP的,当容器在创建dmzService这个Bean时,发现这个类中存在了被@Transactional标注的方法(修饰符为public)那么就需要为这个类创建一个代理对象并放入到容器中,创建的代理对象等价于下面这个类 publicclassDmzServiceProxy{privateDmzServicedmzService;publicDmzServiceProxy(DmzServicedmzService){this.dmzService=dmzService;}publicvoidsaveAB(Aa,Bb){dmzService.saveAB(a,b);}publicvoidsaveA(Aa){try{//开启事务startTransaction();dmzService.saveA(a);}catch(Exceptione){//出现异常回滚事务rollbackTransaction();}//提交事务commitTransaction();}publicvoidsaveB(Bb){try{//开启事务startTransaction();dmzService.saveB(b);}catch(Exceptione){//出现异常回滚事务rollbackTransaction();}//提交事务commitTransaction();}} 上面是一段伪代码,通过startTransaction、rollbackTransaction、commitTransaction这三个方法模拟代理类实现的逻辑。因为目标类DmzService中的saveA跟saveB方法上存在@Transactional注解,所以会对这两个方法进行拦截并嵌入事务管理的逻辑,同时saveAB方法上没有@Transactional,相当于代理类直接调用了目标类中的方法。 我们会发现当通过代理类调用saveAB时整个方法的调用链如下: 实际上我们在调用saveA跟saveB时调用的是目标类中的方法,这种清空下,事务当然会失效。 常见的自调用导致的事务失效还有一个例子,如下: @ServicepublicclassDmzService{@Transactionalpublicvoidsave(Aa,Bb){saveB(b);}@Transactional(propagation=Propagation.REQUIRES_NEW)publicvoidsaveB(Bb){dao.saveB(a);}} 当我们调用save方法时,我们预期的执行流程是这样的 也就是说两个事务之间互不干扰,每个事务都有自己的开启、回滚、提交操作。 但根据之前的分析我们知道,实际上在调用saveB方法时,是直接调用的目标类中的saveB方法,在saveB方法前后并不会有事务的开启或者提交、回滚等操作,实际的流程是下面这样的 由于saveB方法实际上是由dmzService也就是目标类自己调用的,所以在saveB方法的前后并不会执行事务的相关操作。这也是自调用带来问题的根本原因:「自调用时,调用的是目标类中的方法而不是代理类中的方法」 「解决方案」: 自己注入自己,然后显示的调用,例如: @ServicepublicclassDmzService{//自己注入自己@AutowiredDmzServicedmzService;@Transactionalpublicvoidsave(Aa,Bb){dmzService.saveB(b);}@Transactional(propagation=Propagation.REQUIRES_NEW)publicvoidsaveB(Bb){dao.saveB(a);}} 这种方案看起来不是很优雅 利用AopContext,如下: @ServicepublicclassDmzService{@Transactionalpublicvoidsave(Aa,Bb){((DmzService)AopContext.currentProxy()).saveB(b);}@Transactional(propagation=Propagation.REQUIRES_NEW)publicvoidsaveB(Bb){dao.saveB(a);}} ❝ 使用上面这种解决方案需要注意的是,需要在配置类上新增一个配置 //exposeProxy=true代表将代理类放入到线程上下文中,默认是false@EnableAspectJAutoProxy(exposeProxy=true) ❞ 个人比较喜欢的是第二种方式 这里我们做个来做个小总结 总结 一图胜千言 事务失效的原因 事务回滚相关问题 回滚相关的问题可以被总结为两句话 想回滚的时候事务却提交了 想提交的时候被标记成只能回滚了(rollback only) 先看第一种情况:「想回滚的时候事务却提交了」。这种情况往往是程序员对Spring中事务的rollbackFor属性不够了解导致的。 ❝ Spring默认抛出了未检查unchecked异常(继承自 RuntimeException 的异常)或者 Error才回滚事务;其他异常不会触发回滚事务,已经执行的SQL会提交掉。如果在事务中抛出其他类型的异常,但却期望 Spring 能够回滚事务,就需要指定rollbackFor属性。 ❞ 对应代码其实我们上篇文章也分析过了,如下: 回滚代码 ❝ 以上代码位于:TransactionAspectSupport#completeTransactionAfterThrowing方法中 ❞ 默认情况下,只有出现RuntimeException或者Error才会回滚 publicbooleanrollbackOn(Throwableex){return(exinstanceofRuntimeException||exinstanceofError);} 所以,如果你想在出现了非RuntimeException或者Error时也回滚,请指定回滚时的异常,例如: @Transactional(rollbackFor=Exception.class) 第二种情况:「想提交的时候被标记成只能回滚了(rollback only)」。 对应的异常信息如下: Transactionrolledbackbecauseithasbeenmarkedasrollback-only 我们先来看个例子吧 @ServicepublicclassDmzService{@AutowiredIndexServiceindexService;@TransactionalpublicvoidtestRollbackOnly(){try{indexService.a();}catch(ClassNotFoundExceptione){System.out.println("catch");}}}@ServicepublicclassIndexService{@Transactional(rollbackFor=Exception.class)publicvoida()throwsClassNotFoundException{//......thrownewClassNotFoundException();}} 在上面这个例子中,DmzService的testRollbackOnly方法跟IndexService的a方法都开启了事务,并且事务的传播级别为required,所以当我们在testRollbackOnly中调用IndexService的a方法时这两个方法应当是共用的一个事务。按照这种思路,虽然IndexService的a方法抛出了异常,但是我们在testRollbackOnly将异常捕获了,那么这个事务应该是可以正常提交的,为什么会抛出异常呢? 如果你看过我之前的源码分析的文章应该知道,在处理回滚时有这么一段代码 rollBackOnly设置 在提交时又做了下面这个判断(这个方法我删掉了一些不重要的代码) commit_rollbackOnly 可以看到当提交时发现事务已经被标记为rollbackOnly后会进入回滚处理中,并且unexpected传入的为true。在处理回滚时又有下面这段代码 抛出异常 最后在这里抛出了这个异常。 ❝ 以上代码均位于AbstractPlatformTransactionManager中 ❞ 总结起来,「主要的原因就是因为内部事务回滚时将整个大事务做了一个rollbackOnly的标记」,所以即使我们在外部事务中catch了抛出的异常,整个事务仍然无法正常提交,并且如果你希望正常提交,Spring还会抛出一个异常。 「解决方案」: 这个解决方案要依赖业务而定,你要明确你想要的结果是什么 内部事务发生异常,外部事务catch异常后,内部事务自行回滚,不影响外部事务 ❝ 将内部事务的传播级别设置为nested/requires_new均可。在我们的例子中就是做如下修改: //@Transactional(rollbackFor=Exception.class,propagation=Propagation.REQUIRES_NEW)@Transactional(rollbackFor=Exception.class,propagation=Propagation.NESTED)publicvoida()throwsClassNotFoundException{//......thrownewClassNotFoundException();} ❞ 虽然这两者都能得到上面的结果,但是它们之间还是有不同的。当传播级别为requires_new时,两个事务完全没有联系,各自都有自己的事务管理机制(开启事务、关闭事务、回滚事务)。但是传播级别为nested时,实际上只存在一个事务,只是在调用a方法时设置了一个保存点,当a方法回滚时,实际上是回滚到保存点上,并且当外部事务提交时,内部事务才会提交,外部事务如果回滚,内部事务会跟着回滚。 内部事务发生异常时,外部事务catch异常后,内外两个事务都回滚,但是方法不抛出异常 ❝ @TransactionalpublicvoidtestRollbackOnly(){try{indexService.a();}catch(ClassNotFoundExceptione){//加上这句代码TransactionInterceptor.currentTransactionStatus().setRollbackOnly();}} ❞ 通过显示的设置事务的状态为RollbackOnly。这样当提交事务时会进入下面这段代码 显示回滚 最大的区别在于处理回滚时第二个参数传入的是false,这意味着回滚是回滚是预期之中的,所以在处理完回滚后并不会抛出异常。 读写分离跟事务结合使用时的问题 读写分离一般有两种实现方式 配置多数据源 依赖中间件,如 MyCat 如果是配置了多数据源的方式实现了读写分离,那么需要注意的是:「如果开启了一个读写事务,那么必须使用写节点」,「如果是一个只读事务,那么可以使用读节点」 如果是依赖于MyCat等中间件那么需要注意:「只要开启了事务,事务内的SQL都会使用写节点(依赖于具体中间件的实现,也有可能会允许使用读节点,具体策略需要自行跟DB团队确认)」 基于上面的结论,我们在使用事务时应该更加谨慎,在没有必要开启事务时尽量不要开启。 ❝ 一般我们会在配置文件配置某些约定的方法名字前缀开启不同的事务(或者不开启),但现在随着注解事务的流行,好多开发人员(或者架构师)搭建框架的时候在service类上加上了@Transactional注解,导致整个类都是开启事务的,这样严重影响数据库执行的效率,更重要的是开发人员不重视、或者不知道在查询类的方法上面自己加上@Transactional(propagation=Propagation.NOT_SUPPORTED)就会导致,所有的查询方法实际并没有走从库,导致主库压力过大。 ❞ 其次,关于如果没有对只读事务做优化的话(优化意味着将只读事务路由到读节点),那么@Transactional注解中的readOnly属性就应该要慎用。我们使用readOnly的原本目的是为了将事务标记为只读,这样当MySQL服务端检测到是一个只读事务后就可以做优化,少分配一些资源(例如:只读事务不需要回滚,所以不需要分配undo log段)。但是当配置了读写分离后,可能会可能会导致只读事务内所有的SQL都被路由到了主库,读写分离也就失去了意义。 总结 本文为事务专栏最后一篇啦!这篇文章主要是总结了工作中事务相关的常见问题,想让大家少走点弯路!希望大家可以认真读完哦,有什么问题可以直接在后台私信我或者加我微信! 这篇文章也是整个Spring系列的最后一篇文章,之后可能会出一篇源码阅读心得,跟大家聊聊如何学习源码。 另外今年也给自己定了个小目标,就是完成SSM框架源码的阅读。目前来说Spring是完成,接下来就是SpringMVC跟MyBatis。 在分析MyBatis前,会从JDBC源码出发,然后就是MyBatis对配置的解析、MyBatis执行流程、MyBatis的缓存、MyBatis的事务管理以及MyBatis的插件机制。 在学习SpringMVC前,会从TomCat出发,先讲清楚TomCat的原理,我们再来看SpringMVC。整个来说相比于Spring源码,我觉得应该不算特别难。 希望在这个过程中可以跟大家一起进步!!! 我叫DMZ,一个陪你一起慢慢进步的小菜鸟~! 往期精选 Spring事务源码分析专题(一)JdbcTemplate使用及源码分析 Spring事务源码分析专题(二)Mybatis的使用及跟Spring整合原理分析 Spring事务专题(三)事务的基本概念,Mysql事务处理原理 Spring事务专题(四)Spring中事务使用、抽象机制及模拟Spring事务实现 本文分享自微信公众号 - 程序员DMZ(programerDmz)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册