首页 文章 精选 留言 我的

精选列表

搜索[在线编辑器],共10000篇文章
优秀的个人博客,低调大师

ShowDoc v2.6.1 发布,IT 团队的在线 API 文档工具

更新内容: showdoc正式支持plantuml,包括时序图、用例图、类图、组件图、状态图等等。你可以使用markdown代码块声明plantuml,然后中间插入plantuml语句。详情请看文档https://www.showdoc.cc/p/69d2f7ad6306f13363bb803e755068c7 更新步骤请参考请参考手册的升级安装部分:https://www.showdoc.cc/help?page_id=13732 关于Showdoc的详细介绍,请看:https://www.showdoc.cc/help

优秀的个人博客,低调大师

ShowDoc v2.5.5 发布,IT 团队的在线 API 文档工具

更新内容: 1,管理目录的时候可以通过拖动的方式对目录进行排序和转移 2,编辑页面的时候可以通过拖动的方式对页面进行排序 3,优化项目列表页的项目拖动排序效果 4,优化小屏幕笔记本下的显示效果 更新步骤请参考请参考手册的升级安装部分:https://www.showdoc.cc/help?page_id=13732 关于Showdoc的详细介绍,请看:https://www.showdoc.cc/help

优秀的个人博客,低调大师

领课教育—在线教育系统(部署文档)

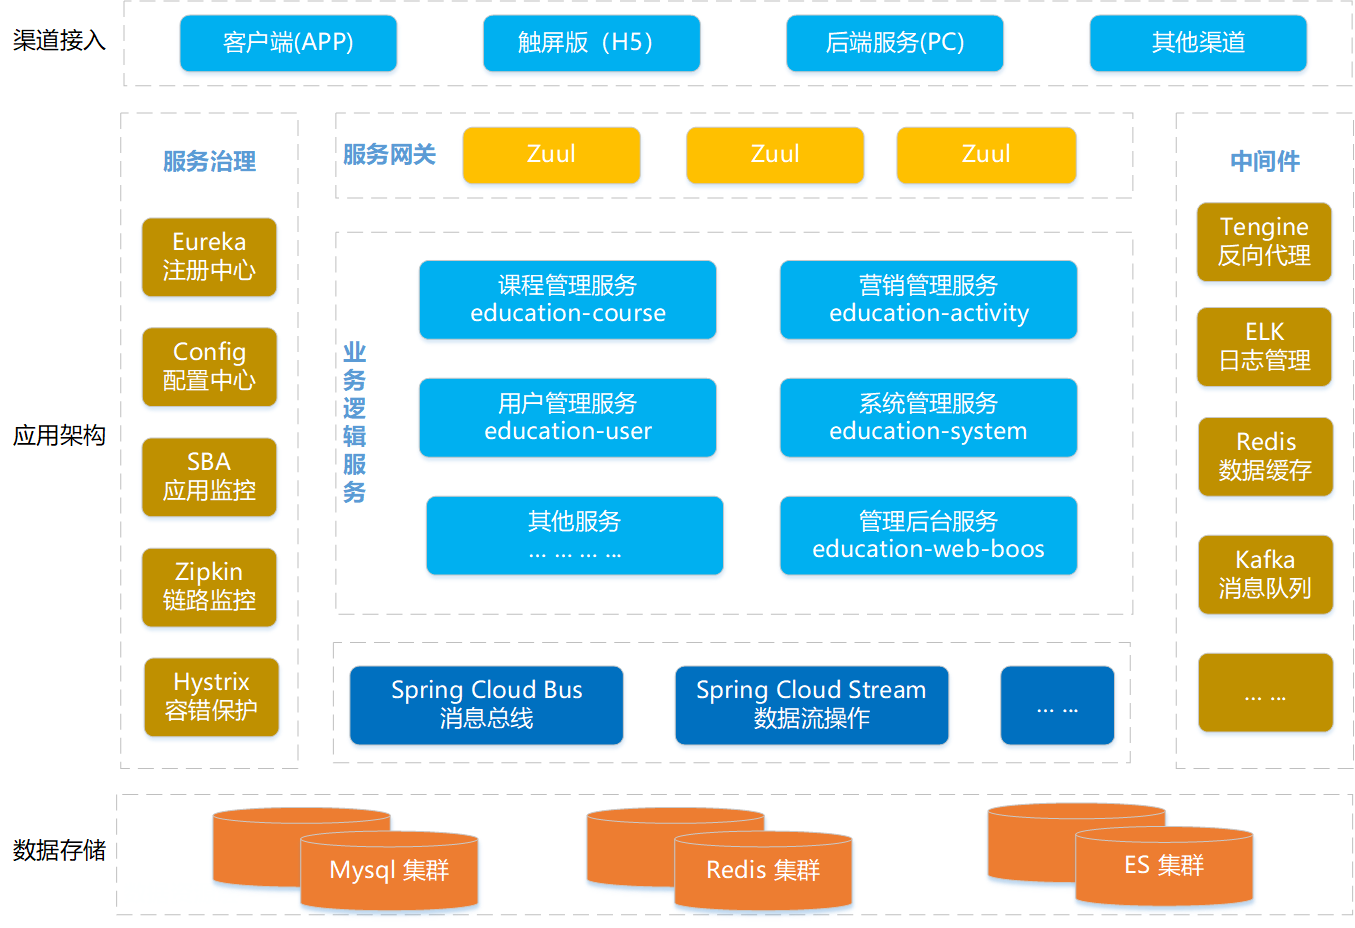
1、项目源码导入 源码地址:https://gitee.com/roncoocom/roncoo-education 觉得我们项目还不错的朋友记得给个Star哦! 2、项目导入问题解决方法 (1)pom.xml文件报错,如图。 解答:这个是因为jdk和maven导致的,需要把Eclipse改为使用本地JDK(默认为JRE),maven最低版本要求3.5+ (2)很多get、set方法报错,如图。 解答:由于本项目使用了lombok来优化代码,消除冗长代码,所以如果 Eclipse没配置有lombok这个jar会 报错,需要配置lombok。 在Eclipse根目录加入lombok,eclipse.ini文件加入-javaagent:lombok.jar,重启eclipse即可。 使用IDEA的同学,也可以安装对应的插件 3、数据库脚本导入 获取数据库脚本,请加群! 群查找请看:https://gitee.com/roncoocom/roncoo-education 4、项目运行 (1)模块介绍: 注册中心(roncoo-education-server-eureka)配置中心(roncoo-education-server-config)课程模块(roncoo-education-course)用户模块(roncoo-education-user)系统模块(roncoo-education-system)后台模块(roncoo-education-boss)定时器(roncoo-education-job)网关工程(roncoo-education-gateway)链路监控(roncoo-education-server-zipkin)应用监控(roncoo-education-server-admin) (2)修改注册中心(application-dev.properties): info.eureka.host=localhost # 设置不注册自身eureka.client.register-with-eureka=falseeureka.client.fetch-registry=false (3)修改课程、用户、系统、后台模块、应用监控,定时器,网关(bootstrap.properties): info.eureka.host01=localhostinfo.eureka.host02=localhostspring.profiles.active=dev (4)修改配置中心(application-dev.properties): spring.data.elasticsearch.cluster-nodes= 节点spring.data.elasticsearch.cluster-name=集群名称spring.redis.host=redis地址spring.redis.port=redis端口spring.redis.password=redis密码 (5)修改配置中心模块工程数据库连接(roncoo-education-course-service-dev.properties)、(roncoo-education-user-service-dev.properties)和(roncoo-education-system-service-dev.properties): spring.datasource.druid.url=本地数据库连接spring.datasource.druid.username=mysql账号spring.datasource.druid.password=mysql密码mysql密码使用durid加密:java -cp druid-1.0.16.jar com.alibaba.druid.filter.config.ConfigTools 你的密码 (6)启动顺序:注册中心 → 配置中心→模块工程 → 定时器 → 网关工程 → 应用监控、链路监控(可以不启动) 注册中心地址:http://localhost:5761管理后台地址:http://localhost:5800网关服务地址:http://localhost:5840 5、运营后台运行 项目名称:roncoo-education-bossapi——主要存放了各个工程的接口config——主要配置网关地址,经过网关请求后台接口views——主要是存放页面修改config里index.js的dev为开发环境网关地址: 本地ip+网关端口修改config里build.js为开发环境网关地址: ip+网关端口 前端运行需要用到node Node版本:9.0.0以上 编译使用:安装依赖:npm install本地开发 启动项目:npm run dev打包正式环境:npm run build访问地址:http://localhost:5800/ 6、前端导入运行 前端源码地址:https://gitee.com/roncoocom/roncoo-education-webapi——主要存放了各个工程的接口config——主要配置网关地址,经过网关请求后台接口pages——主要是存放页面修改config里conf.js的开发环境网关地址: 本地ip+网关端口/#/ 前端运行需要用到Node Node版本: 9.0.0以上 编译使用:npm installnpm run dev前端访问地址:http://127.0.0.1:3000/

优秀的个人博客,低调大师

实时计算如何帮助淘宝实现在线「实时选品」?

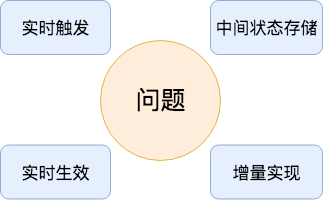
一、背景介绍 随着淘宝内容化的深入发展,实时选品的需求越来越强烈。对于某些实时性要求较高的产品(SPU)而言,运营小二希望自己圈定产品池可以当天实时生效,以供创作者写文章使用。该需求对选品的实时性要求较高,比较适合流式计算的特点。因此,本文采用Blink实时流计算技术来实现该功能,实际应用中取得较好效果。 二、解决方案 2.1 问题分析 要实现实时选品的需求,需要解决如下几个问题: 实时触发问题:流计算必须要有触发数据源,用户提交的特征数据存储在idb中,idb如何与Blink计算流程建立关联? 中间状态存储问题:Blink计算过程中,依据业务场景需要记录上一次中间计算状态,如何存储这些中间状态,并在需要时实时读取? 实时生效问题:Blink计算结果需要最终在搜索引擎生效,Blink如何跟搜索引擎交互,使计算结果实时生效? 增量问题:如果没有增量过程,离线全量切换数据期间,会覆盖部分已更新的数据,入如何增量追数据? 针对上述问题,可采用TT+Blink+Hbase+Swift的方式解决。流程中引入TT可解决实时触发问题,引入Hbase解决中间存储问题,引入Swift解决实时生效和增量问题。TT、Hbase和Swift介绍如下: TT日志:阿里日志采集系统,用户可以对日志进行订阅,TT与idb(数据库)、Blink有较好支持,是idb和Blink交互的重要媒介。 Hbase:开源的非关系型分布式数据库,与Blink有较好的接口交互,可用于存储和读取中间计算状态。 Swift:阿里搜索事业部自主研发的消息系统,目前主搜索实时都是基于该系统进行消息传输的,可基于该系统解决引擎实时生效和增量问题。 2.2 实现流程 Blink流程被分为“日志解析节点”、“Query拆分节点”、“请求SP服务节点”、“数据处理节点”、“回写TT节点”、“Swift消息节点”6个节点,每次实时计算大致经历如下几部分: 用户提交选品特征数据,数据保存到idb(数据库)并同步到TT日志。 TT日志更新会触发Blink任务,日志解析节点会先解析TT日志,获取选品特征数据。 Query拆分节点先预估SPU数量,然后根据SPU数量确定并发请求数,并拼接Sp参数。 请求Sp服务节点并发请求Sp服务,获取SPU信息。 数据计算节点从Hbase中读取中间状态数据,根据业务逻辑进行计算。 计算结果回写Hbase数据库,用于下次计算使用。 回写TT节点和Swift消息节点同时回写TT和Swift。 dump接受Swift消息,将数据更新至引擎,实现数据实时生效。 TT记录计算结果,回写ODPS,用于离线全量计算。 2.3 实现细节 选品功能的实现主要在于Blink任务的开发,开发Blink任务前,需先了解UDF、UDTF、UDAF的概念。 Blink开发主要集中在UDF的实现上,首先根据流计算的过程,划分出多个计算节点(例如实现流程中的“Query拆分节点”和“请求Sp节点”都是独立的计算节点),然后针对每个节点的实现逻辑,确定UDF分类,实现UDF类。以“请求Sp节点”为例说明具体实现过程: 节点分析:“请求Sp节点”的业务场景是一个“一对多”的过程,因此采用UDTF类型实现。 封装UDTF类:该类需要继承TableFunction,其中T为自己定义的pojo,用于向下个运行节点传递。 节点输出:需要定义自己的Pojo类(上一步提到的T),这样节点的输出才能在下个节点中看到。 主函数流程串联:Blink开发流程需要一个主函数将各个计算节点关联起来,达到流计算的目的,建议主函数用Scala语言开发,代码更加通俗易懂。 2.4 参考代码 以下是“请求Sp节点”的UDTF实现代码,基本思路是将请求Sp的返回结果并发输出到下一级节点上。 public class SearchEngineUdtf extends TableFunction<EngineFields> { private static final Logger logger = LoggerFactory.getLogger(SearchEngineUdtf.class); /** * 请求引擎获取召回字段 * @param params */ public void eval(String params) { SpuSearchResult<String> spuSearchResult = SpuSearchEngineUtil.getFromSpuSearch(params); if(spuSearchResult.getSuccess()){ //结果解析 JSONObject kxuanObj = SpuSearchEngineUtil.getSpResponseJson(spuSearchResult, "sp_kxuan"); if(null == kxuanObj || kxuanObj.isEmpty()){ logger.error("sp query: " + spuSearchResult.getSearchURL()); logger.error(String.format("[%s],%s", Constant.ERR_PAR_SP_RESULT,"get key:sp_kxuan data failed! ")); }else { List<EngineFields> engineFieldsList = SpuSearchEngineUtil.getSpAuction(kxuanObj); //并发输出到数据流 for(EngineFields engineFields : engineFieldsList){ collect(engineFields); } } }else { logger.error(String.format("[%s],%s",Constant.ERR_REQ_SP, "request SpuEngine failed!")); } } } 2.5 运维发布 目前,集群发布Blink任务并未完全实现自动化,Blink任务开发完成后,发布上线流程需要如上几步完成。任务发布完成后,可登录yarn上查看任务节点的运行情况。 三、成果总结 功能发布上线后,运营小二圈定的万级别的SPU选品池,可实现分钟级生效,对创作者选品效率有很大提升。 四、作者简介 作者:崔庆磊,花名:辰昕,阿里巴巴-搜索事业部-搜索系统服务平台-高级开发工程师。 15年加入阿里,主要从事内容化选品服务端开发相关工作,熟悉搜索引擎服务及流式计算等相关技术。 如果您有实时报表/实时数据大屏/实时金融风控/实时电商推荐等相关实时化数据处理需求,可以加入如下钉钉交流群!

优秀的个人博客,低调大师

浅谈 ~windows2003操作系统的分区在线扩展

话说由于有些客户的业务系统在2003上运行了好多年,即使迁移到了虚拟化后,仍然不想更换操作系统,windows 2003不像2008或2012操作系统对磁盘的扩展那么方便,直接扩展卷点两下鼠标就可以了。 早上看了下有的朋友写的针对于windows 2003虚拟机的虚拟磁盘扩容后怎么增加分区容量的文章,我也特意写了以下几个方式进行总结。 搭建了一个实验的环境对几种方法进行演示: windows 2003操作系统,此虚拟机共有4块硬盘,分别用于3个实验测试 1、使用diskpart命令对磁盘1扩容演示 磁盘1:己划分一个分区E,扩容了虚拟机的磁盘大小后,在操作系统里重新扫描磁盘看到该磁盘有未分配空间 2、使用Dell Basic Disk Expansiona 工具对磁盘0扩容演示 磁盘0:操作系统盘C,扩容了虚拟机的磁盘大小后,在操作系统里重新扫描磁盘看到该磁盘有未分配空间 3、使用动态磁盘方式对磁盘2和磁盘3的容量进行整合演示 磁盘2:做动态磁盘使用 磁盘3:做动态磁盘使用 --------------------------使用Diskpart命令扩展分区-------------------------- 在cmd命令窗口输入diskpart命令,输入list vol查看当前卷情况。 使用select vol e:选中 然后输入extend进行分区扩展,速度很快就扩展完毕。 --------------------------使用Dell Basic Disk Expansion工具-------------------------- 把工具文件夹拷贝到C盘根目录下(放到哪里其它都可以),在cmd下进入到该目录下。 执行 extpart.ext c: 9216(表示针对C分区扩展9126MB大小) 扩展完毕后整个磁盘0的剩余容量全部划分到C盘。 --------------------------基于动态磁盘的分区扩展-------------------------- 这种扩展方式依靠windows的动态磁盘功能。在对磁盘2初始化后,再选择磁盘2,转换到态磁盘(如果生产环境中己有磁盘原来是基本卷要转换成动态卷也可以,但会转换时会进行卸载磁盘操作,建议停止业务后再进行。) 转换成功后,改磁盘为动态 然后创建分区F(创建过程略) 接下来,我们要对磁盘3也初始化,再转换成动态磁盘,这样新就可以把磁盘3的空间进接扩容到F分区。 磁盘3转成动态后,右键F分区,选择扩展卷 选中磁盘3,点击添加到右侧 磁盘F的分区大小变成两个磁盘的容量之和 最后总结一下几种方式: 对于使用diskpart和dell的分区工具当然是首推荐的方式,优点在于不用停止分区工作,直接就可以扩容,而且没有什么问题。 对于动态卷的方式虽然也很快但是存在个问题,动态磁盘是由操作系统控制的,如果操作系统出再病毒或是其它故障,导致无法启动,那么该磁盘的里资料很难再读取到。 PS:本人对客户的虚拟化环境中,虚拟机都是C盘单独分一个虚拟磁盘,不知道各位怎么做的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册