首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

ElasticSearch学习笔记之原理介绍

ElasticSearch是一个基于Lucene的搜索服务器。它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口。Elasticsearch是用Java开发的,并作为Apache许可条款下的开放源码发布,是当前流行的企业级搜索引擎。设计用于云计算中,能够达到实时搜索,稳定,可靠,快速,安装使用方便。 揭面: 架构图: 架构各模块介绍: Lucence Directory:是lucene的框架服务发现以及选主 ZenDiscovery: 用来实现节点自动发现,还有Master节点选取,假如Master出现故障,其它的这个节点会自动选举,产生一个新的Master; Plugins:插件可以通过自定的方式扩展加强Elasticsearch的基本功能,比如可以自定义类型映射,分词器,本地脚本,自动发现等; Scripting:使用脚本语言可以计算自定义表达式的值,比如计算自定义查询相关度评分。支持的脚本语言有groovy,js,mvel(1.3.0废弃),python等; Disovery:该模块主要负责集群中节点的自动发现和Master节点的选举。节点之间使用p2p的方式进行直接通信,不存在单点故障的问题。Elasticsearch中,Master节点维护集群的全局状态,比如节点加入和离开时进行shard的重新分配; River:代表es的一个数据源,也是其它存储方式(如:数据库)同步数据到es的一个方法。它是以插件方式存在的一个es服务,通过读取river中的数据并把它索引到es中; Gateway:模块用于存储es集群的元数据信息; Zen Discovery:zen发现机制是elasticsearch默认的内建模块。它提供了多播和单播两种发现方式,能够很容易的扩展至云环境。zen发现机制是和其他模块集成的,例如所有节点间通讯必须用trasport模块来完成。 核心概念: 集群(Cluster):ES集群是一个或多个节点的集合,它们共同存储了整个数据集,并提供了联合索引以及可跨所有节点的搜索能力。多节点组成的集群拥有冗余能力,它可以在一个或几个节点出现故障时保证服务的整体可用性。 集群靠其独有的名称进行标识,默认名称为“elasticsearch”。节点靠其集群名称来决定加入哪个ES集群,一个节点只能属一个集群; 节点(node):一个节点是一个逻辑上独立的服务,可以存储数据,并参与集群的索引和搜索功能, 一个节点也有唯一的名字,群集通过节点名称进行管理和通信; 主节点:主节点的主要职责是和集群操作相关的内容,如创建或删除索引,跟踪哪些节点是群集的一部分,并决定哪些分片分配给相关的节点。稳定的主节点对集群的健康是非常重要的。虽然主节点也可以协调节点,路由搜索和从客户端新增数据到数据节点,但最好不要使用这些专用的主节点。一个重要的原则是,尽可能做尽量少的工作。 对于大型的生产集群来说,推荐使用一个专门的主节点来控制集群,该节点将不处理任何用户请求。 数据节点:持有数据和倒排索引。 客户端节点:它既不能保持数据也不能成为主节点,该节点可以响应用户的情况,把相关操作发送到其他节点;客户端节点会将客户端请求路由到集群中合适的分片上。对于读请求来说,协调节点每次会选择不同的分片处理请求,以实现负载均衡。 部落节点:部落节点可以跨越多个集群,它可以接收每个集群的状态,然后合并成一个全局集群的状态,它可以读写所有节点上的数据。 索引(Index): ES将数据存储于一个或多个索引中,索引是具有类似特性的文档的集合。类比传统的关系型数据库领域来说,索引相当于SQL中的一个数据库,或者一个数据存储方案(schema)。索引由其名称(必须为全小写字符)进行标识,并通过引用此名称完成文档的创建、搜索、更新及删除操作。一个ES集群中可以按需创建任意数目的索引。 文档类型(Type):类型是索引内部的逻辑分区(category/partition),然而其意义完全取决于用户需求。因此,一个索引内部可定义一个或多个类型(type)。一般来说,类型就是为那些拥有相同的域的文档做的预定义。例如,在索引中,可以定义一个用于存储用户数据的类型,一个存储日志数据的类型,以及一个存储评论数据的类型。类比传统的关系型数据库领域来说,类型相当于“表”。 文档(Document) :文档是Lucene索引和搜索的原子单位,它是包含了一个或多个域的容器,基于JSON格式进行表示。文档由一个或多个域组成,每个域拥有一个名字及一个或多个值,有多个值的域通常称为“多值域”。每个文档可以存储不同的域集,但同一类型下的文档至应该有某种程度上的相似之处。相当于数据库的“记录” Mapping: 相当于数据库中的schema,用来约束字段的类型,不过 Elasticsearch 的 mapping 可以自动根据数据创建。 ES中,所有的文档在存储之前都要首先进行分析。用户可根据需要定义如何将文本分割成token、哪些token应该被过滤掉,以及哪些文本需要进行额外处理等等。 分片(shard) :ES的“分片(shard)”机制可将一个索引内部的数据分布地存储于多个节点,它通过将一个索引切分为多个底层物理的Lucene索引完成索引数据的分割存储功能,这每一个物理的Lucene索引称为一个分片(shard)。 每个分片其内部都是一个全功能且独立的索引,因此可由集群中的任何主机存储。创建索引时,用户可指定其分片的数量,默认数量为5个。 Shard有两种类型:primary和replica,即主shard及副本shard。 Primary shard用于文档存储,每个新的索引会自动创建5个Primary shard,当然此数量可在索引创建之前通过配置自行定义,不过,一旦创建完成,其Primary shard的数量将不可更改。 Replica shard是Primary Shard的副本,用于冗余数据及提高搜索性能。 每个Primary shard默认配置了一个Replica shard,但也可以配置多个,且其数量可动态更改。ES会根据需要自动增加或减少这些Replica shard的数量。 ES集群可由多个节点组成,各Shard分布式地存储于这些节点上。 ES可自动在节点间按需要移动shard,例如增加节点或节点故障时。简而言之,分片实现了集群的分布式存储,而副本实现了其分布式处理及冗余功能。 创建索引: 过程:当分片所在的节点接收到来自协调节点的请求后,会将该请求写入translog,并将文档加入内存缓存。如果请求在主分片上成功处理,该请求会并行发送到该分片的副本上。当translog被同步到全部的主分片及其副本上后,客户端才会收到确认通知。 内存缓冲会被周期性刷新(默认是1秒),内容将被写到文件系统缓存的一个新段(segment)上。虽然这个段并没有被同步(fsync),但它是开放的,内容可以被搜索到。 每30分钟,或者当translog很大的时候,translog会被清空,文件系统缓存会被同步。这个过程在Elasticsearch中称为冲洗(flush)。在冲洗过程中,内存中的缓冲将被清除,内容被写入一个新段。段的fsync将创建一个新的提交点,并将内容刷新到磁盘。旧的translog将被删除并开始一个新的translog。 ES如何做到实时检索? 由于在buffer中的索引片先同步到文件系统缓存,再刷写到磁盘,因此在检索时可以直接检索文件系统缓存,保证了实时性。 这一步刷到文件系统缓存的步骤,在 Elasticsearch 中,是默认设置为 1 秒间隔的,对于大多数应用来说,几乎就相当于是实时可搜索了。 不过对于 ELK 的日志场景来说,并不需要如此高的实时性,而是需要更快的写入性能。我们可以通过 /_settings接口或者定制 template 的方式,加大 refresh_interval 参数。 当segment从文件系统缓存同步到磁盘时发生了错误怎么办? 数据会不会丢失? 由于Elasticsearch 在把数据写入到内存 buffer 的同时,其实还另外记录了一个 translog日志,如果在这期间故障发生时,Elasticsearch会从commit位置开始,恢复整个translog文件中的记录,保证数据的一致性。 等到真正把 segment 刷到磁盘,且 commit 文件进行更新的时候, translog 文件才清空。这一步,叫做flush。同样,Elasticsearch 也提供了 /_flush 接口。 索引数据的一致性通过 translog 保证,那么 translog 文件自己呢? Elasticsearch 2.0 以后为了保证不丢失数据,每次 index、bulk、delete、update 完成的时候,一定触发刷新translog 到磁盘上,才给请求返回 200 OK。这个改变在提高数据安全性的同时当然也降低了一点性能 检索文档: 搜索相关性 相关性是由搜索结果中Elasticsearch打给每个文档的得分决定的。默认使用的排序算法是tf/idf(词频/逆文档频率)。词频衡量了一个词项在文档中出现的次数 (频率越高 == 相关性越高),逆文档频率衡量了词项在全部索引中出现的频率,是一个索引中文档总数的百分比(频率越高 == 相关性越低)。最后的得分是tf-idf得分与其他因子比如(短语查询中的)词项接近度、(模糊查询中的)词项相似度等的组合 更新删除索引: 删除和更新也都是写操作。但是Elasticsearch中的文档是不可变的,因此不能被删除或者改动以展示其变更。那么,该如何删除和更新文档呢? 磁盘上的每个段都有一个相应的.del文件。当删除请求发送后,文档并没有真的被删除,而是在.del文件中被标记为删除。该文档依然能匹配查询,但是会在结果中被过滤掉。当段合并(我们将在本系列接下来的文章中讲到)时,在.del文件中被标记为删除的文档将不会被写入新段。 接下来我们看更新是如何工作的。在新的文档被创建时,Elasticsearch会为该文档指定一个版本号。当执行更新时,旧版本的文档在.del文件中被标记为删除,新版本的文档被索引到一个新段。旧版本的文档依然能匹配查询,但是会在结果中被过滤掉。 物理删除索引:当索引数据不断增长时,对应的segment也会不断的增多,查询性能可能就会下降。因此,Elasticsearch会触发segment合并的线程,把很多小的segment合并成更大的segment,然后删除小的segment,当这些标记为删除的segment不会被复制到新的索引段中。 Elasticseach查询: Elasticseach查询分为两种,结构化查询和全文查询; 尽管统一称之为query DSL,事实上Elasticsearch中存在两种DSL:查询DSL(query DSL)和过滤DSL(filter DSL)。 查询子句和过滤子句的自然属性非常相近,但在使用目的上略有区别。 简单来讲,当执行full-text查询或查询结果依赖于相关度分值时应该使用查询DSL,当执行精确值(extac-value)查询或查询结果仅有“yes”或“no”两种结果时应该使用过滤DSL。 Filter DSL计算及过滤速度较快,且适于缓存,因此可有效提升后续查询请求的执行速度。而query DSL不仅要查找匹配的文档,还需要计算每个文件的相关度分值,因此为更重量级的查询,其查询结果不会被缓存。 不过,得益于倒排索引,一个仅返回少量文档的简单query或许比一个跨数百万文档的filter执行起来并得显得更慢。 Elasticsearch支持许多的query和filter,但最常用的也不过几种。 Filter DSL中常见的有term Filter、terms Filter、range Filter、exists and missing Filters和bool Filter。 而Query DSL中常见的有match_all、match 、multi_match及bool Query。鉴于时间关系,这里不再细述,朋友们可参考官方文档学习。 Queries用于查询上下文,而filters用于过滤上下文,不过,Elasticsearch的API也支持此二者合并运行。 组合查询可用于合并查询子句,组合过滤用于合并过滤子句,然而,Elasticsearch的使用习惯中,也常会把filter用于query上进行过滤。不过,很少有机会需要把query用于filter上的。 结构化搜索:是指查询包含内部结构的数据。日期,时间,和数字都是结构化的:它们有明确的格式给你执行逻辑操作。一般包括比较数字或日期的范围,或确定两个值哪个大。 文本也可以被结构化。一包蜡笔有不同的颜色:红色,绿色,蓝色。一篇博客可能被打上 分布式 和 搜索的标签。电子商务产品有商品统一代码(UPCs) 或其他有着严格格式的标识。 通过结构化搜索,你的查询结果始终是 是或非;是否应该属于集合。结构化搜索不关心文档的相关性或分数,它只是简单的包含或排除文档。 这必须是有意义的逻辑,一个数字不能比同一个范围中的其他数字更多。它只能包含在一个范围中,或不在其中。类似的,对于结构化文本,一个值必须相等或不等。这里没有 更匹配 的概念。 所谓的全文搜索查询通常是指在给定的文本域内部搜索指定的关键字,但搜索操作该需要真正理解查询者的目的,例如: (1) 搜索“UK”应该返回包含“United Kingdom”的相关文档; (2) 搜索“jump”应该返回包含“JUMP”、“jumped”、“jumps”、“jumping”甚至是“leap”的文档; 为了完成此类全文搜域的搜索,ES必须首先分析文本并将其构建成为倒排索引(inverted index),倒排索引由各文档中出现的单词列表组成,列表中的各单词不能重复且需要指向其所在的各文档。 因此,为了创建倒排索引,需要先将各文档中域的值切分为独立的单词(也称为term或token),而后将之创建为一个无重复的有序单词列表。这个过程称之为“分词(tokenization)”。 其次,为了完成此类full-text域的搜索,倒排索引中的数据还需进行“正规化(normalization)”为标准格式,才能评估其与用户搜索请求字符串的相似度。 这里的“分词”及“正规化”操作也称为“分析(analysis)”。 Analysis过程由两个步骤的操作组成:首先将文本切分为terms(词项)以适合构建倒排索引,其次将各terms正规化为标准形式以提升其“可搜索度”。这两个步骤由分析器(analyzers)完成。 一个分析器通常需要由三个组件构成:字符过滤器(Character filters)、分词器(Tokenizer)和分词过滤器(Token filters)组成。 字符过滤器:在文本被切割之前进行清理操作,例如移除HTML标签,将&替换为字符等; 分词器:将文本切分为独立的词项;简单的分词器通常是根据空白及标点符号进行切分; 分词过滤器:转换字符(如将大写转为小写)、移除词项(如移除a、an、of及the等)或者添加词项(例如,添加同义词); Elasticsearch内置了许多字符过滤器、分词器和分词过滤器,用户可按需将它们组合成“自定义”的分析器。 与SOLR比对: 三种使用方式: 使用案例: 1)维基百科,类似百度百科,牙膏,牙膏的维基百科,全文检索,高亮,搜索推荐; 2)The Guardian(国外新闻网站),类似搜狐新闻,用户行为日志(点击,浏览,收藏,评论)+社交网络数据(对某某新闻的相关看法),数据分析,给到每篇新闻文章的作者,让他知道他的文章的公众反馈(好,坏,热门,垃圾,鄙视,崇拜); 3)Stack Overflow(国外的程序异常讨论论坛),IT问题,程序的报错,提交上去,有人会跟你讨论和回答,全文检索,搜索相关问题和答案,程序报错了,就会将报错信息粘贴到里面去,搜索有没有对应的答案; 4)GitHub(开源代码管理),搜索上千亿行代码; 5)电商网站,检索商品; 6)日志数据分析,logstash采集日志,ES进行复杂的数据分析(ELK技术,elasticsearch+logstash+kibana); 7)商品价格监控网站,用户设定某商品的价格阈值,当低于该阈值的时候,发送通知消息给用户,比如说订阅牙膏的监控,如果高露洁牙膏的家庭套装低于50块钱,就通知我,我就去买; 8)BI系统,商业智能,Business Intelligence。比如说有个大型商场集团,BI,分析一下某某区域最近3年的用户消费金额的趋势以及用户群体的组成构成,产出相关的数张报表,最近3年,每年消费金额呈现100%的增长,而且用户群体85%是高级白领,开一个新商场。ES执行数据分析和挖掘,Kibana进行数据可视化; 9)国内:站内搜索(电商,招聘,门户,等等),IT系统搜索(OA,CRM,ERP,等等),数据分析(ES热门的一个使用场景) 原文发布时间为:2018-08-22 本文作者:等待九月 本文来自云栖社区合作伙伴“我的小碗汤”,了解相关信息可以关注“我的小碗汤”。

优秀的个人博客,低调大师

Redux中间件的原理

中间件顾名思义就是谁和谁的中间, 在图中 View在Redux会派发一个Action, Action通过Store的Dispatch方法派发给Store, Store接收到Action 连同之前State 一同传给Reducer Reducer会返回一个新的数据给Store Store然后去改变自己的State 这个是Redux的标准流程 Redux的中间件的中间是指 Action 和 Store 之间的关系 Action 只能是一个对象 派发Store 这个是在没有使用redux-thunk情况下, 在使用redux-thunk Action 可以为一个函数 所以Dispatch方法就是Action和Store的中间件 就是对Dispatch方法的封装 利用react-thunk对Dispatch方法进行封装 这时给Dispatch传入是一个对象 它会直接把这个对象传给Store 如果Dispatch传入是一个函数的话 先执行 然后会根据你传入的参数不同进行不同的事情

优秀的个人博客,低调大师

浅谈OceanBase的锁机制原理

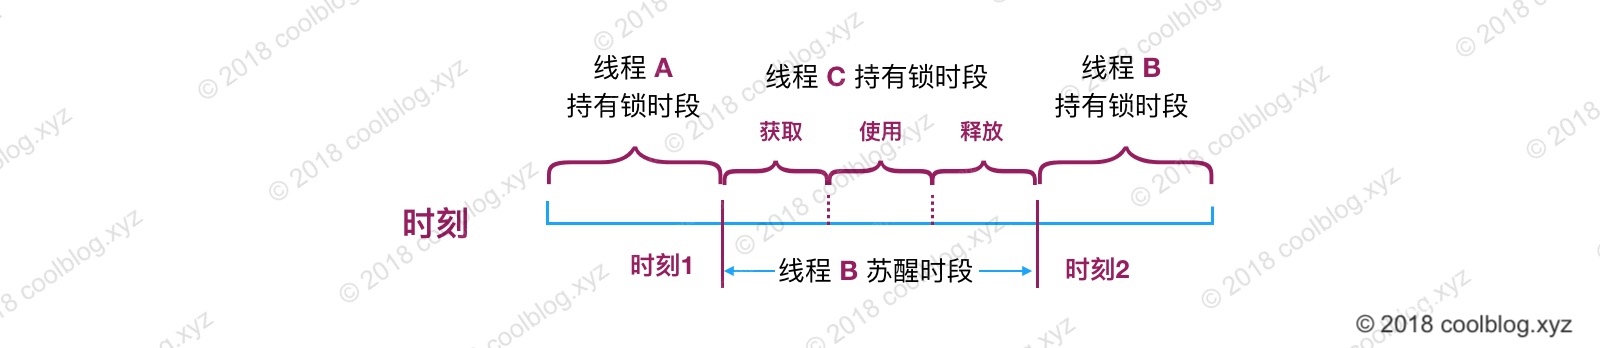
OceanBase锁定粒度为行锁,默认情况下的隔离级别为读取已提交(read committed)。另外,读操作总是读取某个版本的快照数据,不需要加锁。 只写事务(修改单行):事务预提交时对待修改的数据行加写锁,事务提交时释放写锁。 只写事务(修改多行):事务预提交时对待修改的多个数据行加写锁,事务提交时释放写锁。为了保证一致性,采用两阶段镇的方式实现,即需要在事务预提交阶段获取所有数据行的写锁,如果获取某行写锁失败,整个事务执行失败。 读写事务(read commited):读写事务中的读操作读取某个版本的快照,写操作的加锁方式与只写事务相同。 为了保证系统并发性能,OceanBase暂时不支持更高的隔离级别。另外,为了支持对一致性要求很高的业务,OceanBase允许用户显式锁住某个数据行。例如,有一张账务表account(account_id,balance),其中account_id为主键。假设需要从A账户(account_id=1)向B账户(account_id=2)转账100元,那么,A账户需要减少100元,B账户需要增加100元,整个转账操作是一个事务,执行过程中需要防止A账户和B账户被其他事务并发修改。 如以下代码所示,OceanBase提供了”select...for update”语句用于显示锁住A账户或者B账户,防止转账过程中被其他事务并发修改。 select balance as balance_a from account where account id=1 for update; //锁住A账户 select balance as balance_b from account where account_id=2 for update; //锁住B账户 事务执行过程中可能会发生死锁,例如事务T1持有账户A的写锁并尝试获取账户B的写锁,事务T2持有账户B的写锁并尝试获取账户A的写锁,这两个事务因为循环等待而出现死锁。OceanBase目前处理死锁的方式很简单,事务执行过程中如果超过一定时间无法获取写锁,则自动回滚。

优秀的个人博客,低调大师

支持向量机原理推导(二)

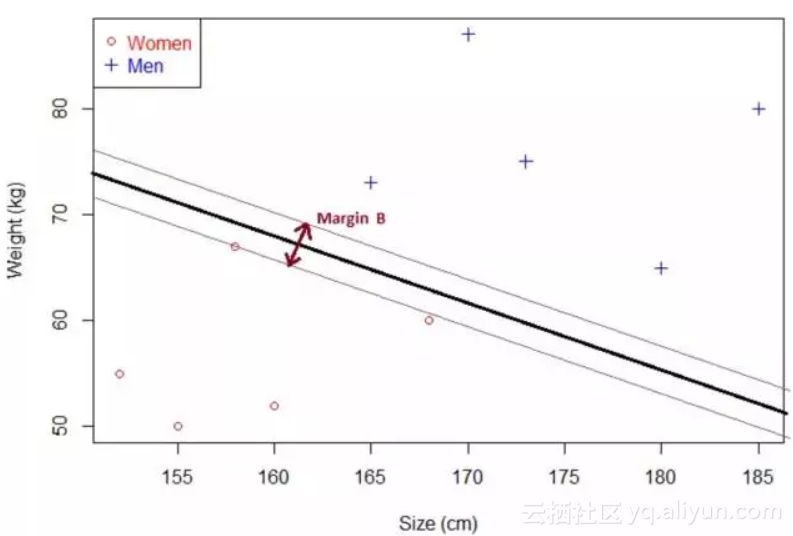
上一节我们讲述了间隔公式是如何得到的,这一节讲述要得到最大间隔时的分割超平面所要的条件是什么。 在上图中我们可以看到间隔为MarginB/2,但是我们很容易发现黑线还可以向上移动从而得到更大的间隔,当移动到是最上面红线与第一个Men数据点相交时便得到最大间隔了,如下图: 下面我们就根据这个思路求出得到最大间隔时所要满足的条件。 如上图,我们设分割超平面为g:W•X+b=0,以它为对称轴的两条线为h:W•X+b=1;f:W•X+b=-1 首先必须满足在h与f线之间没有任何数据,然后便是支持向量正好在这两条线上。即: 对于蓝色类都满足W•X+b≥1,且至少有一个点瞒住W•X+b=1; 对于红色类都满足W•X+b≤-1,且至少有一个点瞒住W•X+B=-1; 我们设蓝色类与红色类的标签分别为(1,-1),那么我们把不等式与各自对应的标签相乘便可

优秀的个人博客,低调大师

GBDT原理-Gradient Boosting Decision Tree

背景 决策树是一种基本的分类与回归方法。决策树模型具有分类速度快,模型容易可视化的解释,但是同时是也有容易发生过拟合,虽然有剪枝,但也是差强人意。 提升方法(boosting)在分类问题中,它通过改变训练样本的权重(增加分错样本的权重,减小分队样本的的权重),学习多个分类器,并将这些分类器线性组合,提高分类器性能。boosting数学表示为: f(x)=w0+∑m=1Mwmϕm(x) 其中w是权重, ϕ是弱分类器的集合,可以看出最终就是基函数的线性组合。 于是决策树与boosting结合产生许多算法,主要有提升树、GBDT等。本文主要是GBDT学习笔记。 Gradient Boosting Gradient Boosting是一种Boosting的方法,它主要的思想是,每一次建立模型是在之前建立模型损失函数的梯度下降方向。损失函数是评价模型性能(一般为拟合程度+正则项),认为损失函数越小,性能越好。而让损失函数持续下降,就能使得模型不断改性提升性能,其最好的方法就是使损失函数沿着梯度方向下降(讲道理梯度方向上下降最快)。 Gradient Boost是一个框架,里面可以套入很多不同的算法。 提升树-boosting tree 以决策树为基函数的提升方法称为提升树,其决策树可以是分类树OR回归树。提升树模型可以表示为决策树的加法模型。 fM(x)=∑m=1MT(x;Θm) 其中, T(x;Θm)表示决策树, Θm 表示树的参数,M为树的个数。 回归问题提升树算法 输入:训练数据集 T={(x1,y1),(x2,y2),⋅⋅⋅,(xN,yN)},xi∈χ=Rn,yi∈γ={−1,+1},i=1,2,⋅⋅⋅,N; 输出:提升树 fM(x) 初始化 f0(x)=0 对于 m=1,2,...M: 计算残差(后一棵树拟合前一颗树残差): rmi=yi−fm−1(xi) 拟合残差学习一个回归树,得到 T(x;Θm) 更新 fm(x)=fm−1(x)+T(x;Θm) M次迭代之后得到提升树: fM(x)=∑m=1MT(x;Θm) ​ Gradient Boosting Decision Tree 提升树的学习优化过程中,损失函数平方损失和指数损失时候,每一步优化相对简单,但对于一般损失函数优化的问题,Freidman提出了Gradient Boosting算法,其利用了损失函数的负梯度在当前模型的值 −[∂L(y,f(xi))∂f(xi)]f(x)=fm−1(x) 作为回归问题提升树算法的残差近似值,去拟合一个回归树。 算法 输入:训练数据集 T={(x1,y1),(x2,y2),⋅⋅⋅,(xN,yN)},xi∈χ=Rn,yi∈γ={−1,+1},i=1,2,⋅⋅⋅,N; 输出:回归树 fM(x) 初始化 f0(x)=argminc∑i=1NL(yi,c) 对m=1,2,..M 对i=1,2,…,N,计算 rmi=−[∂L(y,f(xi))∂f(xi)]f(x)=fm−1(x) 对 rmi拟合一颗回归树,得到第m棵树的叶结点区域Rmj,j=1,2,...J,即一棵由J个叶子节点组成的树。 对 j=1,2,...J,计算 cmj=argminc∑xi∈RmjL(yi,fm−1(xi)+c) 2.2,2.3这一步相当于回归树递归在遍历所有切分变量j和切分点s找到最优j,s,然后在每个节点区域求最优的c。参考回归树生成算法 更新 fm(x)=fm−1(x)+∑j=1JcmjI(x∈Rmj) 得到回归树 f^(x)=fM(x)=∑m=1Mfm(x)=∑m=1M∑j=1JcmjI(x∈Rmj) 算法1步获得使得损失函数最小的常数估计值,是一个只有根节点的树。在2.1步计算损失函数的负梯度在当前模型的值,将它作为残差估计。在2.2步估计回归树的叶结点区域,来拟合残差的近似值。在2.3步利用线性搜索估计回归树叶结点区域的值,使损失函数最小化。2.4更新回归树。第3步获得输出的最终模型。 Shrinkage Shrinkage的思想认为,每次走一小步逐渐逼近结果的效果,要比每次迈一大步很快逼近结果的方式更容易避免过拟合。即它不完全信任每一个棵残差树,它认为每棵树只学到了真理的一小部分,累加的时候只累加一小部分,通过多学几棵树弥补不足。 数学方程对比: 之前:fm(x)=fm−1(x)+∑j=1JcmjI(x∈Rmj) Shrinkage:fm(x)=fm−1(x)+step∗∑j=1JcmjI(x∈Rmj) Shrinkage仍然以残差作为学习目标,但对于残差学习的结果,只累加一小部分,step一般取值0.001-0.01(非gradient的step),使得各个树的残差是渐变而不是陡变的,即将大步切成了小步。Shrinkage能减少过拟合发生也是经验证明的,目前还没有看到从理论的证明。 总结 原始的boosting算法开始时,为每一个样本赋上一个权重值。在每一步训练中得到的模型,会使得数据点的估计有对有错,在每一步结束后,增加分错的点的权重,减少分对的点的权重,这样使得某些点如果老是被分错,那么就会被“严重关注”,也就被赋上一个很高的权重。然后等进行了N次迭代(由用户指定),将会得到N个简单的分类器(basic learner),然后我们将它们组合起来(比如说可以对它们进行加权、或者让它们进行投票等),得到一个最终的模型。 那么GBDT算法中并未有权重的改变,哪里有boosting思想 ? Gradient Boosting与Boosting区别在于,每一计算的是为了减少上一次的残差,下一个模型主要在残差减少的梯度方上建立模型,使得残差往梯度方向上减少。 虽然不同,但是GBDT算法会更关注那些梯度比较大的样本,和Boosting思想类似。 附录 CSDN原文:http://blog.csdn.net/shine19930820/article/details/65633436

优秀的个人博客,低调大师

大数据技术原理与应用

推荐一个视频: http://study.163.com/course/courseMain.htm?courseId=1002887002 章节1课程介绍 课时1课程介绍06:53 章节2大数据概述 课时2大数据概述第1部分26:56 课时3大数据概述第2部分31:11 课时4大数据概述第3部分13:04 章节3大数据处理架构Hadoop 课时5大数据处理架构Hadoop第1部分26:52 课时6大数据处理架构Hadoop第2部分20:50 课时7大数据处理架构Hadoop第3部分15:14 课时8大数据处理架构Hadoop第4部分18:43 章节4分布式文件系统HDFS 课时9分布式文件系统HDFS第1部分24:43 课时10分布式文件系统HDFS第2部分20:15 课时11分布式文件系统HDFS第3部分20:19 课时12分布式文件系统HDFS第4部分21:33 章节5分布式数据库HBase 课时13分布式数据库HBase第1部分24:49 课时14分布式数据库HBase第2部分26:17 课时15分布式数据库HBase第3部分30:37 课时16分布式数据库HBase第4部分25:26 章节6NoSQL数据库 课时17NoSQL数据库第1部分23:45 课时18NoSQL数据库第2部分26:44 课时19NoSQL数据库第3部分23:09 课时20NoSQL数据库第4部分16:24 章节7云数据库 课时21云数据库第1部分21:59 课时22云数据库第2部分28:40 课时23云数据库第3部分31:04 课时24云数据库第4部分21:28 章节8MapReduce 课时25MapReduce第1部分25:11 课时26MapReduce第2部分28:17 课时27MapReduce第3部分26:35 课时28MapReduce第4部分19:40 章节9基于Hadoop的数据仓库Hive 课时29基于Hadoop的数据仓库Hive第1部分29:10 课时30基于Hadoop的数据仓库Hive第2部分25:56 课时31基于Hadoop的数据仓库Hive第3部分23:30 课时32基于Hadoop的数据仓库Hive第4部分25:17 章节10Hadoop架构再探讨 课时33Hadoop架构再探讨第1部分28:32 课时34Hadoop架构再探讨第2部分25:58 课时35Hadoop架构再探讨第3部分21:39 课时36Hadoop架构再探讨第4部分35:39 章节11Spark 课时37Spark第1部分30:15 课时38Spark第2部分31:38 课时39Spark第3部分35:53 课时40Spark第4部分26:05 章节12流计算 课时41流计算第1部分30:17 课时42流计算第2部分35:36 课时43流计算第3部分33:41 课时44流计算第4部分26:43 章节13图计算 课时45图计算第1部分28:51 课时46图计算第2部分35:38 课时47图计算第3部分34:47 课时48图计算第4部分30:30 章节14大数据在不同领域的应用 课时49大数据在不同领域的应用第1部分22:41 课时50大数据在不同领域的应用第2部分24:09 课时51大数据在不同领域的应用第3部分25:09 章节15附录:大数据在线课程建设团队风采 课时52附录:大数据在线课程建设团队风

优秀的个人博客,低调大师

ZABBIX实现原理及架构详解

ZABBIX是完全开源的工具,整合了CACTI和NAGIOS等特性。 zabbix功能很强大,如何理解zabbix的功能,我们可以和cacti、nagios的功能对比一下: cacti是一款数据采集,数据存储,外加web界面展示的工具,它负责阈值范围内的实时变化,但是对超过阈值的告警功能很薄弱 优点:实时监控数据变化,以web页面的方式呈现,更直观。 缺点:告警不及时 nagios是一款告警功能很强大的工具,它不关心阈值范围内的变化,只关心状态变化(超过阈值),然后报警。报警方式通过邮件,短信等。 优点:告警反映迅速。 缺点:监控主机数量有限,承载低 zabbix = cacti + nagios 优点:基于两款工具优点于一身并更强大,实现企业级分布式监控。 缺点:2.2版本带宽占用大但是升级到2.4版本后更节省了带宽资源,其它再无发现。 zabbix监控功能的实现 监控主机zabbix有专用的agent,可以监控Linux,Windows等 监控网络设备zabbix通过SNMP,ssh(不多用) 可监控对象 设备:服务器,路由器,交换机 软件:OS,网络,应用程序 主机性能指标监控 故障监控: down机,服务不可用,主机不可达 支持数据库存储类型 abbix-database: MySQL, PGSQL(postgreSQL)、Oracle、DB2、SQLite Zabbix架构中的组件 zabbix-server: C语言 zabbix-agent: C语言 zabbix-web:GUI,用于实现zabbix设定和展示,PHP开发 zabbix-proxy: 分布式监控环境中的专用组件 监控流程 一个监控系统运行的大概的流程是这样的: agentd需要安装到被监控的主机上,它负责定期收集各项数据,并发送到zabbix server端,zabbix server将数据存储到数据库中,zabbix web根据数据在前端进行展现和绘图。这里agentd收集数据分为主动和被动两种模式: 主动:agent请求server获取主动的监控项列表,并主动将监控项内需要检测的数据提交给server/proxy 被动:server向agent请求获取监控项的数据,agent返回数据。 【主动监测】通信过程如下: zabbix首先向ServerActive配置的IP请求获取active items,获取并提交active tiems数据值server或者proxy。很多人会提出疑问:zabbix多久获取一次active items?它会根据配置文件中的RefreshActiveChecks的频率进行,如果获取失败,那么将会在60秒之后重试。分两个部分: 获取ACTIVE ITEMS列表 Agent打开TCP连接(主动检测变成Agent打开) Agent请求items检测列表 Server返回items列表 Agent 处理响应 关闭TCP连接 Agent开始收集数据 主动检测提交数据过程如下: Agent建立TCP连接 Agent提交items列表收集的数据 Server处理数据,并返回响应状态 关闭TCP连接 【被动监测】通信过程如下: Server打开一个TCP连接 Server发送请求agent.ping\n Agent接收到请求并且响应<HEADER><DATALEN>1 Server处理接收到的数据1 关闭TCP连接 这里,被动模式每次都需要打开一个tcp连接,这样当监控项越来越多时,就会出现server端性能问题了。 那实际监控中是用主动的还是被动的呢?这里主要涉及两个地方: 1、新建监控项目时,选择的是zabbix代理还是zabbix端点代理程式(主动式),前者是被动模式,后者是主动模式。 2、agentd配置文件中StartAgents参数的设置,如果为0,表示禁止被动模式,否则开启。一般建议不要设置为0,因为监控项目很多时,可以部分使用主动,部分使用被动模式。 常用的监控架构平台 1、server-agentd模式: 这个是最简单的架构了,常用于监控主机比较少的情况下。 2、server-proxy-agentd模式: 这个常用于比较多的机器,使用proxy进行分布式监控,有效的减轻server端的压力。 下图描述了上述两种方式: Zabbix逻辑架构 定义一个template模板,里面包括多个items,trigger,graphs套用给host或者hostgroups。 server监控项目items通过zabbix poller进程(可以有多个进程实现并发处理)包括snmp,agent协议收集被监控主机信息。 如果阈值超过triggers触发器规定,就是形成一个events事件,然后actions处理动作(包括运行预先定制的脚本,不成功发送email或SMS)。 在服务器升级的时候提前设定maintenance维护模式不对服务器产生告警通知。通过逻辑拓扑图展示工作流程 Zabbix Server启动后都有那些进程? 本文转自 dengaosky 51CTO博客,原文链接:http://blog.51cto.com/dengaosky/1963871,如需转载请自行联系原作者

优秀的个人博客,低调大师

android基础进度条原理

下面详细介绍ProgressBar 一、说明 在某些操作的进度中的可视指示器,为用户呈现操作的进度,还它有一个次要的进度条,用来显示中间进度,如在流媒体播放的缓冲区的进度。一个进度条也可不确定其进度。在不确定模式下,进度条显示循环动画。这种模式常用于应用程序使用任务的长度是未知的。 二、XML重要属性 android:progressBarStyle:默认进度条样式 android:progressBarStyleHorizontal:水平样式 三、重要方法 getMax():返回这个进度条的范围的上限 getProgress():返回进度 getSecondaryProgress():返回次要进度 incrementProgressBy(int diff):指定增加的进度 isIndeterminate():指示进度条是否在不确定模式下 setIndeterminate(boolean indeterminate):设置不确定模式下 setVisibility(int v):设置该进度条是否可视 四、重要事件 onSizeChanged(int w, int h, int oldw, int oldh):当进度值改变时引发此事件 看一下实现代码 packagecom.smart; importjava.util.Timer; importjava.util.TimerTask; importandroid.app.Activity; importandroid.os.Bundle; importandroid.os.Handler; importandroid.os.Message; importandroid.widget.ProgressBar; publicclassMainextendsActivity{ privateProgressBarprogressBar; privateHandlerhandler=newHandler(){ publicvoidhandleMessage(Messagemsg){ switch(msg.what){ case1: intcurrentProgress=progressBar.getProgress()+2; if(currentProgress>progressBar.getMax()) currentProgress=0;//断送进度条 progressBar.setProgress(currentProgress);//显示进度条进度 break; } super.handleMessage(msg); } }; privateTimerTasktimerTask=newTimerTask(){ //信息 @Override publicvoidrun(){ Messagemessage=newMessage(); message.what=1; handler.sendMessage(message); } }; @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.main); progressBar=(ProgressBar)findViewById(R.id.progressbar); Timertimer=newTimer(); timer.schedule(timerTask,0,500); //第二个参数为:从0开始,第三个参数为:它的速度,越大越慢,越小越快。 } } main.xml文件 <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:orientation="vertical" android:layout_width="fill_parent" android:layout_height="fill_parent" > <ProgressBar android:id="@+id/progressbar" android:layout_width="fill_parent" android:layout_height="wrap_content" android:layout_marginTop="20dp" android:max="100" style="?android:attr/progressBarStyleHorizontal" /> </LinearLayout> 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/510427,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop 之 NameNode 元数据原理

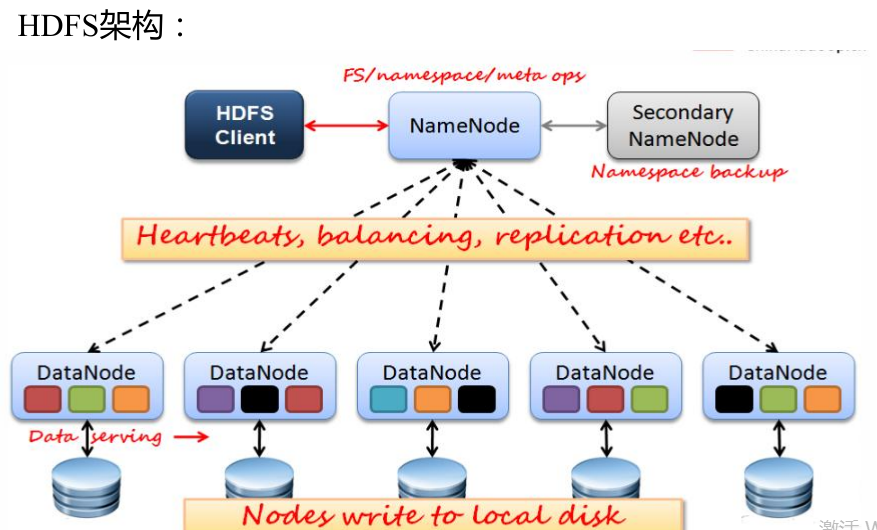
在对NameNode节点进行格式化时,调用了FSImage的saveFSImage()方法和FSEditLog.createEditLogFile()存储当前的元数据。Namenode主要维护两个文件,一个是fsimage,一个是editlog。 fsimage :保存了最新的元数据检查点,包含了整个HDFS文件系统的所有目录和文件的信息。对于文件来说包括了数据块描述信息、修改时间、访问时间等;对于目录来说包括修改时间、访问权限控制信息(目录所属用户,所在组)等。简单的说,Fsimage就是在某一时刻,整个hdfs 的快照,就是这个时刻hdfs上所有的文件块和目录,分别的状态,位于哪些个datanode,各自的权限,各自的副本个数等。 注意:Block的位置信息不会保存到fsimage,Block保存在哪个DataNode(由DataNode启动时上报)。 editlog :主要是在NameNode已经启动情况下对HDFS进行的各种更新操作进行记录,HDFS客户端执行所有的写操作都会被记录到editlog中。 读取元数据: 启动NameNode节点时,又要从镜像和编辑日志中读取元数据。 写入元数据: 在NameNode运行时会将内存中的元数据信息存储到所指定的文件,即${dfs.name.dir}/current目录下的fsimage文件,此外还会将另外一部分对NameNode更改的日志信息存储到${dfs.name.dir}/current目录下的edits文件中。fsimage文件和edits文件可以确定NameNode节点当前的状态,这样在NameNode节点由于突发原因崩溃时,可以根据这两个文件中的内容恢复到节点崩溃前的状态,所以对NameNode节点中内存元数据的每次修改都必须保存下来。但是如果每次都保存到fsimage文件中,这样效率就特别低效,所以引入编辑日志文件edits,保存对对元数据的修改信息,也就是fsimage文件保存NameNode节点中某一时刻内存中的元数据(即目录树),edits保存这一时刻之后的对元数据的更改信息。 镜像的保存: SecondaryNameNode:主要由两个作用,一是镜像备份(不是NN的备份,但可以做备份),二是日志与镜像的定期合并。 第一步:将hdfs更新记录写入一个新的文件——edits.new。 第二步:将fsimage和editlog通过http协议发送至secondary namenode。 第三步:将fsimage与editlog合并,生成一个新的文件——fsimage.ckpt。这步之所以要在secondary namenode中进行,是因为比较耗时,如果在namenode中进行,或导致整个系统卡顿。 第四步:将生成的fsimage.ckpt通过http协议发送至namenode。 第五步:重命名fsimage.ckpt为fsimage,edits.new为edits。 第六步:等待下一次checkpoint触发SecondaryNameNode进行工作,一直这样循环操作。 注:checkpoint触发的条件可以在core-site.xml文件中进行配置。fs.checkpoint.period表示多长时间记录一次hdfs的镜像。默认是1小时。fs.checkpoint.size表示一次记录多大的size,默认64M。例如如下: <property> <name>fs.checkpoint.period</name> <value>3600</value> <description>The number of seconds between two periodic checkpoints. </description> </property> <property> <name>fs.checkpoint.size</name> <value>67108864</value> <description>The size of the current edit log (in bytes) that triggers a periodic checkpoint even if the fs.checkpoint.period hasn't expired. </description> </property> 文章可以转载,必须以链接形式标明出处。 本文转自 张冲andy 博客园博客,原文链接:http://www.cnblogs.com/andy6/p/7353092.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

lvs之 lvs原理架构介绍

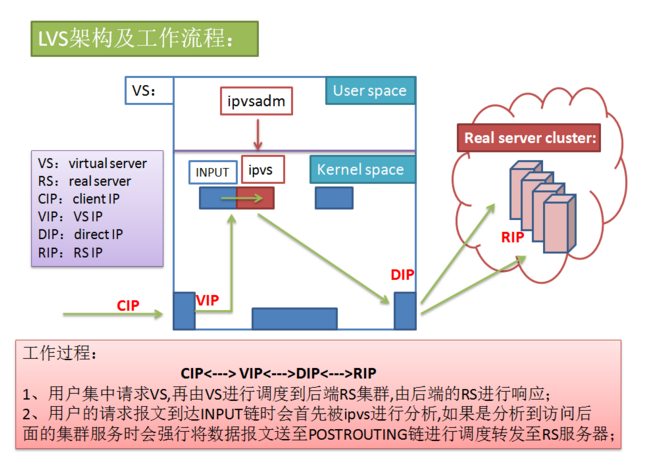
一、 概念 lvs的术语: Router:GWIP vs:virtual server,director rs:real server CIP:client IP VIP:virtual server IP DIP:ditecter IP(connect with rs) RIP:real server IP 用户请求的IP一定是VIP,否则vs就失去了负载均衡的调度意义 LVS方式的cluster从结构上可分为两部分:前端的负载均衡器(称之为director)和后端的真实服务器(称之为real server)。cluster前端的director将来自外界的请求调度到cluster后端不同的real server去执行。real server负责真正的提供各种应用服务,比如:Web、FTP、Mail等服务。real server的数量可以根据实际需求进行增加、减少。 二、lvs的工作过程 三、lvs的类型 lvs有三种通用标准模型 (1)lvs-nat (网络地址映射) (2)lvs-dr (直接路由) (3)lvs-tun (IP隧道) 3.1、 LVS NAT的特性(实质是多目标的DNAT): 1、RS应该使用私有地址; 2、RS的网关的必须指向DIP; 3、RIP和DIP必须在同一网段内; 4、请求和响应的报文都得经过Director;在高负载场景中,Director很可能成为系统性能瓶颈; 5、支持端口映射; 6、RS可以使用任意支持集群服务的OS; lvs-nat:工作流程如图: 3.2、 LVS DR类型的特性: 1、RS可以使用私有地址;但也可以使用公网地址,此时可以直接通过互联网连入RS以实现配置、监控等; 2、RS的网关一定不能指向DIP; 3、RS跟Dirctory要在同一物理网络内(不能由路由器分隔,因为VS通过封装MAC地址到RS); 4、请求报文经过Directory,但响应报文一定不经过Director 5、不支持端口映射; 6、RS可以使用大多数的操作系统; 由于DR类型中,VS、RS的VIP都是一样,如果在同一网段内会造成地址冲突,因此要解决地址冲突有一下三种方法: 禁止RS响应对VIP的ARP广播请求: 1、在前端路由上实现静态MAC地址VIP的绑定; 前提:得有路由器的配置权限; 缺点:Directory故障转时,无法更新此绑定; 2、arptables 前提:在各RS在安装arptables程序,并编写arptables规则 缺点:依赖于独特功能的应用程序 3、修改Linux内核参数 前提:RS必须是Linux; 缺点:适用性差; 两个参数: arp_announce:定义通告模式 arp_ignore:定义收到arp请求的时响应模式 配置专用路由,以使得响应报文首先通过vip所配置的lo上的别名接口 lvs-dr:工作流程如图 3.2、 lvs-tun:IP隧道 1、RIP、DIP、VIP都得是公网地址; 2、RS的网关不会指向也不可能指向DIP; 3、请求报文经过Directory,但响应报文一定不经过Director; 4、不支持端口映射; 5、RS的OS必须得支持隧道功能; lvs-tun:工作流程如图:也是基于lvs-dr的模型,只不过不同的是,rs和vs不必在同一个物理的网络(实现物理冗余),而是通过隧道技术进行vs和rs间的通信 四、 lvs十个调度算法:rr、wrr、lc、wlc、lblc、lblcr、dh、sh、sed、nq 1.轮叫调度(Round Robin)(简称rr) 2.加权轮叫(Weighted Round Robin)(简称wrr) 3.最少链接(Least Connections)(LC) 4.加权最少链接(Weighted Least Connections)(WLC) 5.基于局部性的最少链接(Locality-Based Least Connections)(LBLC) 6.带复制的基于局部性最少链接(Locality-Based Least Connections with Replication)(LBLCR) 7.目标地址散列(Destination Hashing)(DH) 8.源地址散列(Source Hashing)(SH) 9. 最短的期望的延迟(Shortest Expected Delay Scheduling SED)(SED) 10.最少队列调度(Never Queue Scheduling NQ)(NQ) 最常用的两个算法介绍: 2.加权轮叫(Weighted Round Robin)(简称wrr) 调度器通过“加权轮叫”调度算法根据真实服务器的不同处理能力来调度访问请求。这样可以保证处理能力强的服务器能处理更多的访问流量。调度器可以自动问询真实服务器的负载情况,并动态地调整其权值。 4.加权最少链接(Weighted Least Connections)(WLC) 在集群系统中的服务器性能差异较大的情况下,调度器采用“加权最少链接”调度算法优化负载均衡性能,具有较高权值的服务器将承受较大比例的活动连接负载。调度器可以自动问询真实服务器的负载情况,并动态地调整其权值。 说明: 部分参考http://6638225.blog.51cto.com/6628225/1866241 感谢作者。 文章可以转载,必须以链接形式标明出处。 本文转自 张冲andy 博客园博客,原文链接: http://www.cnblogs.com/andy6/p/7017155.html ,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册