Spring Boot 启动优化实践
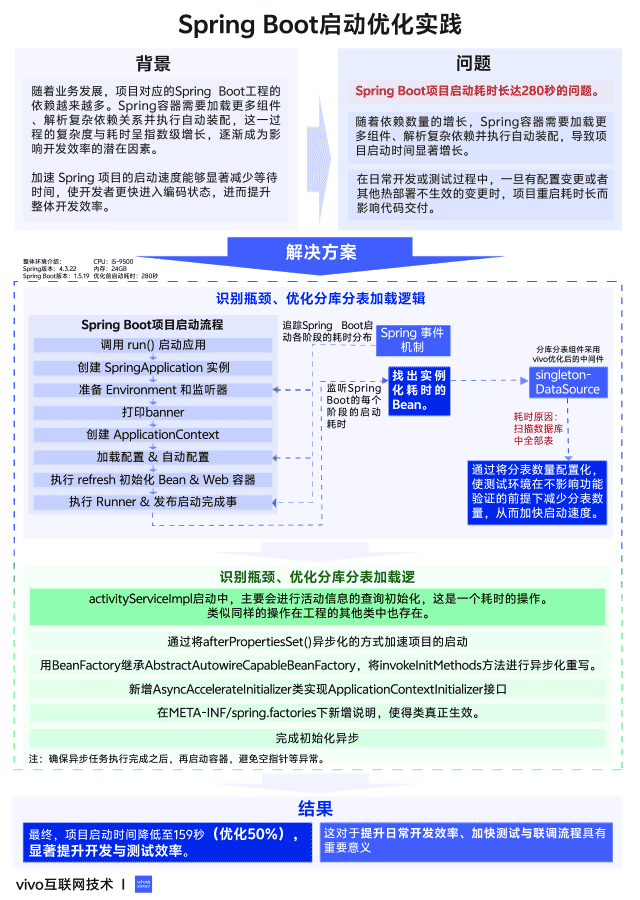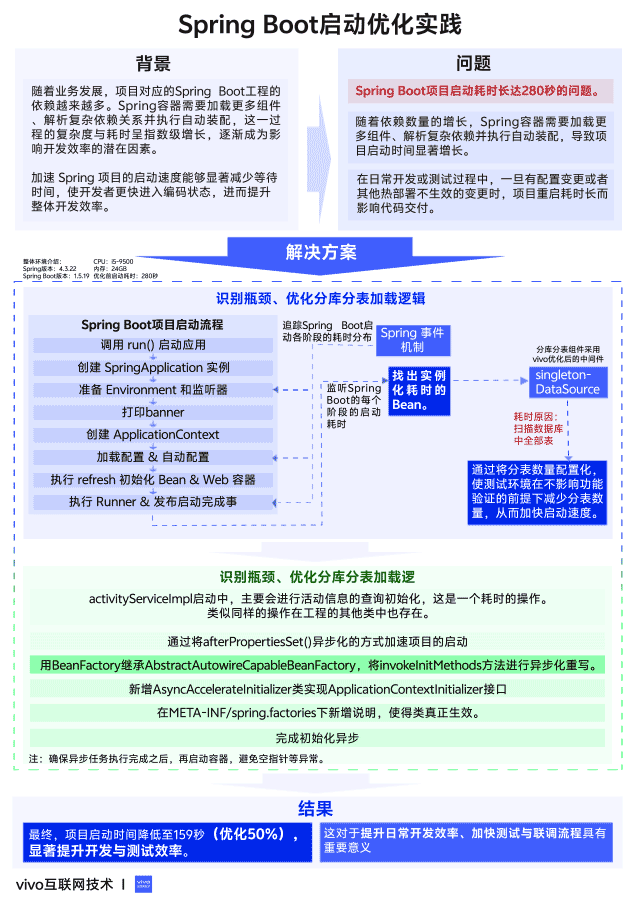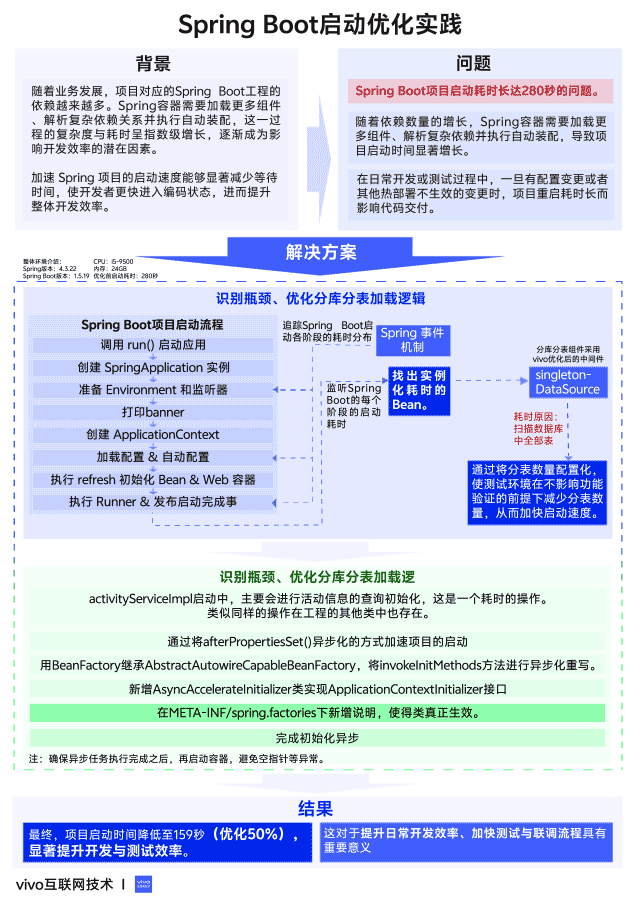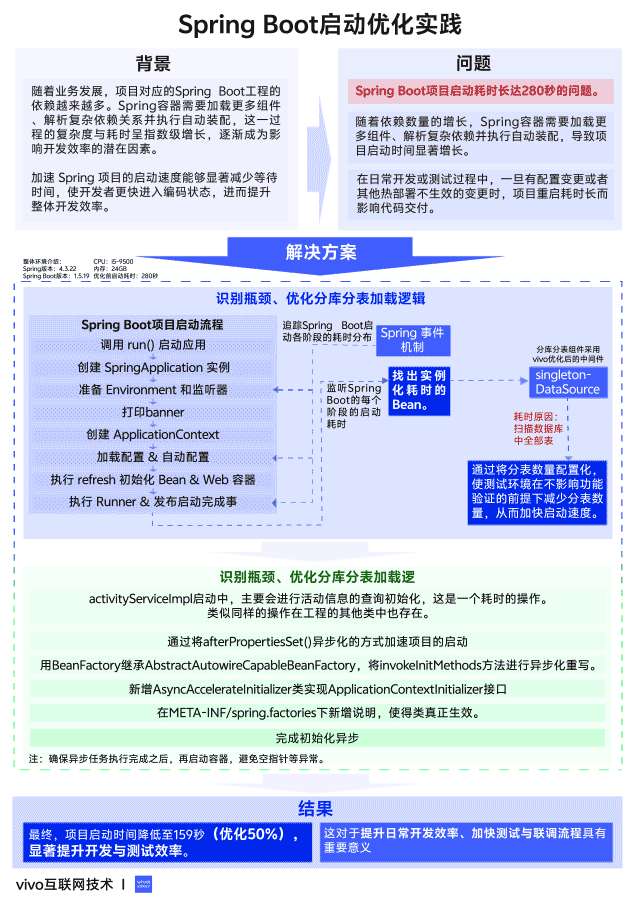
作者:vivo 互联网服务器团队- Liu Di 本文系统性分析并优化了一个Spring Boot项目启动耗时高达 280 秒的问题。通过识别瓶颈、优化分库分表加载逻辑、异步初始化耗时任务等手段,最终将启动耗时缩短至 159 秒,提升近 50%。文章涵盖启动流程分析、性能热点识别、异步初始化设计等关键技术细节,适用于大型Spring Boot项目的性能优化参考。 文章太长?1分钟看图抓住核心观点👇 一、前言 随着业务的发展,笔者项目对应的Spring Boot工程的依赖越来越多。随着依赖数量的增长,Spring 容器需要加载更多组件、解析复杂依赖并执行自动装配,导致项目启动时间显著增长。在日常开发或测试过程中,一旦因为配置变更或者其他热部署不生效的变更时,项目重启就需要等待很长的时间影响代码的交付。加快Spring项目的启动可以更好的投入项目中,提升开发效率。 整体环境介绍: Spring版本:4.3.22 Spring Boot版本:1.5.19 CPU:i5-9500 内存:24GB 优化前启动耗时:280秒 二、Spring Boot项目启动流程介绍 Spring Boot项目主要启动流程都在org.spring- framework.boot.SpringApplication#run(java.lang.String...)方法中: public ConfigurableApplicationContext run(String... args) { StopWatch stopWatch = new StopWatch(); stopWatch.start(); // Spring上下文 ConfigurableApplicationContext context = null; FailureAnalyzers analyzers = null; configureHeadlessProperty(); // 初始化SpringApplicationRunListener监听器 SpringApplicationRunListeners listeners = getRunListeners(args); listeners.starting(); try { ApplicationArguments applicationArguments = new DefaultApplicationArguments( args); // 环境准备 ConfigurableEnvironment environment = prepareEnvironment(listeners, applicationArguments); // 打印banner Banner printedBanner = printBanner(environment); // 创建上下文 context = createApplicationContext(); analyzers = new FailureAnalyzers(context); // 容器初始化 prepareContext(context, environment, listeners, applicationArguments, printedBanner); // 刷新容器内容 refreshContext(context); afterRefresh(context, applicationArguments); // 结束监听广播 listeners.finished(context, null); stopWatch.stop(); if (this.logStartupInfo) { new StartupInfoLogger(this.mainApplicationClass) .logStarted(getApplicationLog(), stopWatch); } return context; } catch (Throwable ex) { handleRunFailure(context, listeners, analyzers, ex); throw new IllegalStateException(ex); } } 可以看到在启动流程中,监听器应用在了应用的多个生命周期中。并且Spring Boot中也预留了针对listener的扩展点。我们可以借此实现一个自己的扩展点去监听Spring Boot的每个阶段的启动耗时,实现如下: @Slf4j public class MySpringApplicationRunListener implements SpringApplicationRunListener{ private Long startTime; public MySpringApplicationRunListener(SpringApplication application, String[] args){ } @Override public void starting(){ startTime = System.currentTimeMillis(); log.info("MySpringListener启动开始 {}", LocalTime.now()); } @Override public void environmentPrepared(ConfigurableEnvironment environment){ log.info("MySpringListener环境准备 准备耗时:{}毫秒", (System.currentTimeMillis() - startTime)); startTime = System.currentTimeMillis(); } @Override public void contextPrepared(ConfigurableApplicationContext context){ log.info("MySpringListener上下文准备 耗时:{}毫秒", (System.currentTimeMillis() - startTime)); startTime = System.currentTimeMillis(); } @Override public void contextLoaded(ConfigurableApplicationContext context){ log.info("MySpringListener上下文载入 耗时:{}毫秒", (System.currentTimeMillis() - startTime)); startTime = System.currentTimeMillis(); } @Override public void finished(ConfigurableApplicationContext context, Throwable exception){ log.info("MySpringListener结束 耗时:{}毫秒", (System.currentTimeMillis() - startTime)); startTime = System.currentTimeMillis(); } } 接着还需要在classpath/META-INF目录下新建spring.factories文件,并添加如下文件内容: org.springframework.boot.SpringApplicationRunListener=com.vivo.internet.gameactivity.api.web.MySpringApplicationRunListener 至此,借助Listener机制,我们能够追踪Spring Boot启动各阶段的耗时分布,为后续性能优化提供数据支撑。 contextLoaded事件是在run方法中的prepareContext()结束时调用的,因此contextLoaded事件和finished事件之间仅存在两个语句:refreshContext(context)和afterRefresh (context,applicationArguements)消耗了285秒的时间,调试一下就能发现主要耗时在refreshContext()中。 三、AbstractApplicationContext#refresh refreshContext()最终调用到org.spring-framework.context.support.AbstractApplicationContext#refresh方法中,这个方法主要是beanFactory的预准备、对beanFactory完成创建并进行后置处理、向容器添加bean并且给bean添加属性、实例化所有bean。通过调试发现,finishBeanFactoryInitialization(beanFactory) 方法耗时最久。该方法负责实例化容器中所有的单例 Bean,是启动性能的关键影响点。 四、找出实例化耗时的Bean Spring Boot也是利用的Spring的加载流程。在Spring中可以实现InstantiationAwareBeanPost- Processor接口去在Bean的实例化和初始化的过程中加入扩展点。因此我们可以实现该接口并添加自己的扩展点找到处理耗时的Bean。 @Service public class TimeCostCalBeanPostProcessor implements InstantiationAwareBeanPostProcessor { private Map<String, Long> costMap = Maps.newConcurrentMap(); @Override public Object postProcessBeforeInstantiation(Class<?> beanClass, String beanName) throws BeansException { if (!costMap.containsKey(beanName)) { costMap.put(beanName, System.currentTimeMillis()); } return null; } @Override public boolean postProcessAfterInstantiation(Object bean, String beanName) throws BeansException { return true; } @Override public PropertyValues postProcessPropertyValues(PropertyValues pvs, PropertyDescriptor[] pds, Object bean, String beanName) throws BeansException { return pvs; } @Override public Object postProcessBeforeInitialization(Object bean, String beanName) throws BeansException { return bean; } @Override public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException { if (costMap.containsKey(beanName)) { Long start = costMap.get(beanName); long cost = System.currentTimeMillis() - start; // 只打印耗时长的bean if (cost > 5000) { System.out.println("bean: " + beanName + "\ttime: " + cost + "ms"); } } return bean; } } 具体原理就是在Bean开始实例化之前记录时间,在Bean初始化完成后记录结束时间,打印实例化到初始化的时间差获得Bean的加载总体耗时。结果如图: 可以看到有许多耗时在10秒以上的类,接下来可以针对性的做优化。值得注意的是,统计方式为单点耗时计算,未考虑依赖链上下文对整体加载顺序的影响,实际优化还需结合依赖关系分析。 五、singletonDataSource @Bean(name = "singletonDataSource") public DataSource singletonDataSource(DefaultDataSourceWrapper dataSourceWrapper) throws SQLException { //先初始化连接 dataSourceWrapper.getMaster().init(); //构建分库分表数据源 String dataSource0 = "ds0"; Map<String, DataSource> dataSourceMap = new HashMap<>(); dataSourceMap.put(dataSource0, dataSourceWrapper.getMaster()); //分库分表数据源 DataSource shardingDataSource = ShardingDataSourceFactory.createDataSource (dataSourceMap,shardingRuleConfiguration, prop); return shardingDataSource; } singletonDataSource是一个分库分表的数据源,连接池采用的是Druid,分库分表组件采用的是公司内部优化后的中间件。通过简单调试代码发现,整个Bean耗时的过程发生在createDataSource方法,该方法中会调用createMetaData方法去获取数据表的元数据,最终运行到loadDefaultTables方法。该方法如下图,会遍历数据库中所有的表。因此数据库中表越多,整体就越耗时。 笔者的测试环境数据库中有很多的分表,这些分表为了和线上保持一致,分表的数量都和线上是一样的。 因此在测试环境启动时,为了加载这些分表会更加的耗时。可通过将分表数量配置化,使测试环境在不影响功能验证的前提下减少分表数量,从而加快启动速度。 六、初始化异步 activityServiceImpl启动中,主要会进行活动信息的查询初始化,这是一个耗时的操作。类似同样的操作在工程的其他类中也存在。 @Service public class ActivityServiceImpl implements ActivityService, InitializingBean{ // 省略无关代码 @Override public void afterPropertiesSet() throws Exception { initActivity(); } // 省略无关代码 } 可以通过将afterPropertiesSet()异步化的方式加速项目的启动。 观察Spring源码可以注意到afterPropertiesSet方法是在AbstractAutowireCapableBeanFactory# invokeInitMethods中调用的。在这个方法中,不光处理了afterPropertiesSet方法,也处理了init-method。 因此我们可以写一个自己的BeanFactory继承AbstractAutowireCapableBeanFactory,将invokeInitMethods方法进行异步化重写。考虑到AbstractAutowireCapableBeanFactory是个抽象类,有额外的抽象方法需要实现,因此继承该抽象类的子类DefaultListableBeanFactory。具体实现代码如下: public class AsyncInitListableBeanFactory extends DefaultListableBeanFactory{ public AsyncInitBeanFactory(ConfigurableListableBeanFactory beanFactory){ super(beanFactory); } @Override protected void invokeInitMethods(String beanName, Object bean, RootBeanDefinition mbd)throws Throwable { if (beanName.equals("activityServiceImpl")) { AsyncTaskExecutor.submitTask(() -> { try { super.invokeInitMethods(beanName, bean, mbd); } catch (Throwable throwable) { throwable.printStackTrace(); } }); } else { super.invokeInitMethods(beanName, bean, mbd); } } } 又因为Spring在refreshContext()方法之前的prepareContext()发放中针对initialize方法提供了接口扩展(applyInitializers())。因此我们可以通过实现该接口并将我们的新的BeanFactory通过反射的方式更新到Spring的初始化流程之前。 public interface ApplicationContextInitializer<C extends ConfigurableApplicationContext> { /** * Initialize the given application context. * @param applicationContext the application to configure */ void initialize(C applicationContext); } 改造后的代码如下,新增AsyncAccelerate- Initializer类实现ApplicationContextInitializer接口: public class AsyncBeanFactoryInitializer implements ApplicationContextInitializer<ConfigurableApplicationContext> { @SneakyThrows @Override public void initialize(ConfigurableApplicationContext applicationContext){ if (applicationContext instanceof GenericApplicationContext) { AsyncInitListableBeanFactory beanFactory = new AsyncInitListableBeanFactory(applicationContext.getBeanFactory()); Field field = GenericApplicationContext.class.getDeclaredField("beanFactory"); field.setAccessible(true); field.set(applicationContext, beanFactory); } } } public class AsyncBeanInitExecutor{ private static final int CPU_COUNT = Runtime.getRuntime().availableProcessors(); private static final AtomicReference<ThreadPoolExecutor> THREAD_POOL_REF = new AtomicReference<>(); private static final List<Future<?>> FUTURES = new ArrayList<>(); /** * 创建线程池实例 */ private static ThreadPoolExecutor createThreadPoolExecutor(){ int poolSize = CPU_COUNT + 1; return new ThreadPoolExecutor(poolSize, poolSize, 50L, TimeUnit.SECONDS, new LinkedBlockingQueue<>(), new ThreadPoolExecutor.CallerRunsPolicy() ); } /** * 确保线程池已初始化(线程安全) */ private static void ensureThreadPoolExists(){ if (THREAD_POOL_REF.get() != null) { return; } ThreadPoolExecutor executor = createThreadPoolExecutor(); if (!THREAD_POOL_REF.compareAndSet(null, executor)) { executor.shutdown(); // 另一线程已初始化成功 } } /** * 提交异步初始化任务 * * @param task 初始化任务 * @return 提交后的 Future 对象 */ public static Future<?> submitInitTask(Runnable task) { ensureThreadPoolExists(); Future<?> future = THREAD_POOL_REF.get().submit(task); FUTURES.add(future); return future; } /** * 等待所有初始化任务完成并释放资源 */ public static void waitForInitTasks(){ try { for (Future<?> future : FUTURES) { future.get(); } } catch (Exception ex) { throw new RuntimeException("Async init task failed", ex); } finally { FUTURES.clear(); shutdownThreadPool(); } } /** * 关闭线程池并重置引用 */ private static void shutdownThreadPool(){ ThreadPoolExecutor executor = THREAD_POOL_REF.getAndSet(null); if (executor != null) { executor.shutdown(); } } } 实现类后,还需要在META-INF/spring.factories下新增说明org.springframework.context. ApplicationContextInitializer=com.xxx.AsyncAccelerateInitializer,这样这个类才能真正生效。 这样异步化以后还有一个点需要注意,如果该初始化方法执行耗时很长,那么会存在Spring容器已经启动完成,但是异步初始化任务没执行完的情况,可能会导致空指针等异常。为了避免这种问题的发生,还要借助于Spring容器启动中finishRefresh()方法,监听对应事件,确保异步任务执行完成之后,再启动容器。 public class AsyncInitCompletionListener implements ApplicationListener<ContextRefreshedEvent>, ApplicationContextAware, PriorityOrdered{ private ApplicationContext currentContext; @Override public void setApplicationContext(ApplicationContext applicationContext)throws BeansException { this.currentContext = applicationContext; } @Override public void onApplicationEvent(ContextRefreshedEvent event){ if (event.getApplicationContext() == currentContext) { AsyncBeanInitExecutor.waitForInitTasks(); } } @Override public int getOrder(){ return Ordered.HIGHEST_PRECEDENCE; } } 七、总结 启动优化后的项目实际测试结果如下: 通过异步化初始化和分库分表加载优化,项目启动时间从 280 秒缩短至 159 秒,提升约 50%。这对于提升日常开发效率、加快测试与联调流程具有重要意义。