首页 文章 精选 留言 我的

精选列表

搜索[SEO优化],共10000篇文章
优秀的个人博客,低调大师

表驱动法,逻辑控制优化利器

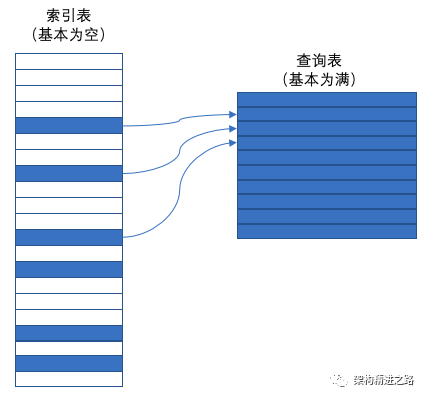
hello,大家好,我是张张,「架构精进之路」公号作者。 最近好多同学在开发过程中谈到设计表结构的一些idea,为了让大家少走一些弯路,今天就计划聊聊表驱动法吧~ 1、概念介绍 表驱动法 是一种编程模式,从表里查找信息而不使用逻辑语句(if/else) 事实上,凡是能通过逻辑语句来选择的事物,都可以通过查表来选择。 对简单的情况而言,使用逻辑语句更为容易和直白,但随着逻辑链的越来越复杂,查表法也就愈发显得更具有吸引力。 应用原则 适当的情况下,采用表驱动法,所生成的代码会比复杂的逻辑代码更简单,更容易修改,而且效率更高。 2、应用实践 2.1 直接访问 2.1.1 今天周几? 传统写法: String today = "周日";Switch( dayForMonth % 7 ){ case 0 : today = "周日"; case 1 : today = "周一"; case 2 : today = "周二"; case 3 : today = "周三"; case 4 : today = "周四"; case 5 : today = "周五"; default: today = "周六"; } 表驱动法: String [] weekday = new String[]{"周日","周一","周二","周三","周四","周五","周六"}; String today = weekday [ dayForMonth % 7 ]; 2.1.2 每个月多少天? 传统写法: if(1 == iMonth) { iDays = 31;} else if(2 == iMonth) { iDays = 28;} else if(3 == iMonth) { iDays = 31;} else if(4 == iMonth) { iDays = 30;} else if(5 == iMonth) { iDays = 31;} else if(6 == iMonth) { iDays = 30;} else if(7 == iMonth) { iDays = 31;} else if(8 == iMonth) { iDays = 31;} else if(9 == iMonth) { iDays = 30;} else if(10 == iMonth) { iDays = 31;} else if(11 == iMonth) { iDays = 30;} else if(12 == iMonth) { iDays = 31;} 表驱动法: 把逻辑写成 map 或是 list,一目了然,可以搞个2维数组还加上了闰年的逻辑。 const monthDays = [ [31, 28, 31, 30, 31, 30, 31, 31, 30, 31, 30, 31], [31, 29, 31, 30, 31, 30, 31, 31, 30, 31, 30, 31]]function getMonthDays(month, year) { let isLeapYear = (year % 4 === 0) && (year % 100 !== 0 || year % 400 === 0) ? 1 : 0 return monthDays[isLeapYear][(month - 1)];}console.log(getMonthDays(2, 2000)) 2.2 索引访问 有时只用一个简单的数学运算还无法把 age 这样的数据转换成为表键值,这种情况可以通过索引访问的方法加以解决。 索引应用:先用一个基本类型的数据从一张索引表中查出一个键值,然后在用这一键值查出需要的主数据。 举例: 有100件商品,商店物品编号(范围 0000-9999) 创建两张表:索引表(0-9999),物品(查询)表(0-100) 索引访问有两个优点: 如果主查询表的每条记录都很大,那创建一个浪费了很多空间的数组所用的空间,要比建立主查询表所用的空间小得多。 操作索引中的记录比操作主查询表的的记录更方便,编写到表里面的数据比嵌入代码的数据更容易维护。 2.3 阶梯访问 这种访问方法不像索引结构那样直接,但是它要比索引访问方法节省空间。 阶梯结构的基本思想:表中的记录对于不同数据范围有效,而不是对不同的数据点有效。 举例: 一个等级评定的应用程序,其中“B”记录所对应的范围是 75.0%-90.0% >= 90.0% A <90.0% B <75.0% C <65.0% D <50.0% F 这种划分范围用在查询表中是不合适的,因为你不能用简单的数据转换函数来把表键值转换成 A-F 字母所代表的等级。用索引也不合适,因为这里用的是浮点数。 在应用阶梯方法的时候,必须谨慎的处理范围的端点。 Dim rangeLimit() As Double = {50.0, 65.0, 75.0, 90.0, 100.0}Dim grade() As String={"F", "D", "C", "B", "A"}maxGradeLevel = grade.Length - 1// assign a grad to a student based on the student's scoregradeLevel= 0 studentGrade = ”A" while( studentGrade = "A" and gradeLevel < maxGradeLevel ) if( studentScore < rangeLimit( gradeLevel ) ) then studentGrade = grade ( gradeLevel) end if gradeLevel = gradeLevel + 1 wend 与其他表驱动法相比,这种方法的优点在于它很适合处理那些无规则的数据。 在使用阶梯访问时需要注意的一些细节: 1)留心边界端点 注意边界:< 与 <=,确认循环能够在找出最高一级区间后恰当地终止。 2)考虑用二分查找取代顺序查找 如果列表很大,可以把它替换成一个准二分查找法,从头查找是很耗费性能的 3)考虑用索引访问来取代阶梯访问 阶梯访问中的查找操作可能会比较耗时,如果执行速度很重要,那可以考虑用索引访问来取代阶梯查找,即以牺牲存储空间来换取速度。 2.4 构造查询键值 如上述例子,我们希望能够将数据作为键值直接访问表,这样既简单又快速。 但是问题或者数据通常并不是这样友好,那就需要引出 构造查询键值 的方法。 费率与年龄、性别、婚姻及交费年数等不同情况而变动。 1)复制信息从而能够直接使用键值 age补齐:50 岁以上的年龄都复制一份 50 岁的费率。 这样优点在于表自身结构非常简单那,访问表的逻辑也很简单; 缺点在于复制生成的冗余信息会浪费空间,也即是利用空间换效率。 2)转换键值以使其能够直接使用 费率表查询时,用一个函数将 age 转换为另一个数值。 在此例子中,该函数必须把所有介于 0-5 直接的年龄转换成一个键值,例如 5,同时把所有超过 50 的年龄都转换成另一个键值,例如 50。 这样在检索前可以用 min()和 max()函数来做这一转换。 例如,你可以用下述表达式:max(min(50, age), 17) 来生成一个介于 17-50 之间的表键值。 3)把键值转换提取城独立子程序 如果你必须要构造一些数据来让它们像表键值一样使用,那就把数据到键值的转换操作提取成独立的子程序。这样可避免在不同位置执行了不同的转换,也使得转换操作修改起来更加容易。 任务是个方法,不再是数值了,这里我们可以利用 Dart 这样的支持高阶函数的语言特性,把方法当做一个对象存储在表中。 var data = <String, Map>{ "A": { "name": "AA", "action": (name) => print(name + "/AA"), }, "B": { "name": "BB", "action": (name) => print(name + "/BB"), }, }; var action = data["A"]["action"]; action("kk"); 3、总结 1)如何从表中查数据? List item 直接访问 索引访问 阶梯访问 2)在表里存些什么? 数据 动作(action)-描述该动作的代码/该动作的子程序的引用。 表驱动法提供了一种复杂的逻辑和继承结构的替换方案。如果你发现自己对某个应用程序的逻辑或者继承关系感到困惑,那是否可以通过一个查询表来加以简化。 使用表的关键决策是决定如何去访问表,可以采取直接访问、索引访问或阶梯访问 使用表的另一项关键决策是决定如何去把什么内容放入表中 需要保存浮点数和范围数时,使用阶梯访问的形式。 Thanks for reading! 关注公众号,免费领学习资料 如果您觉得还不错,欢迎关注和转发~ 本文分享自微信公众号 - 架构精进之路(jiagou_jingjin)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

千万级索引的聚合性能优化

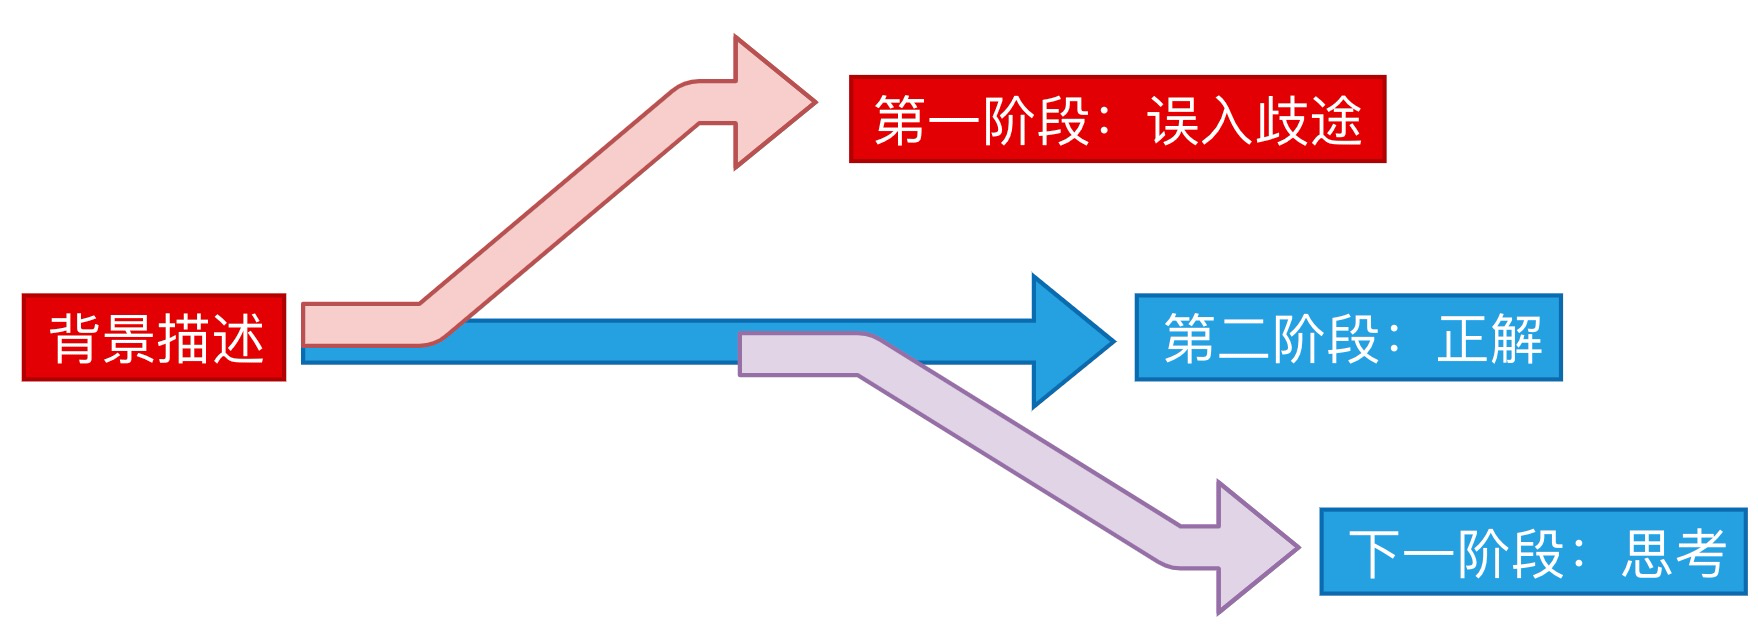
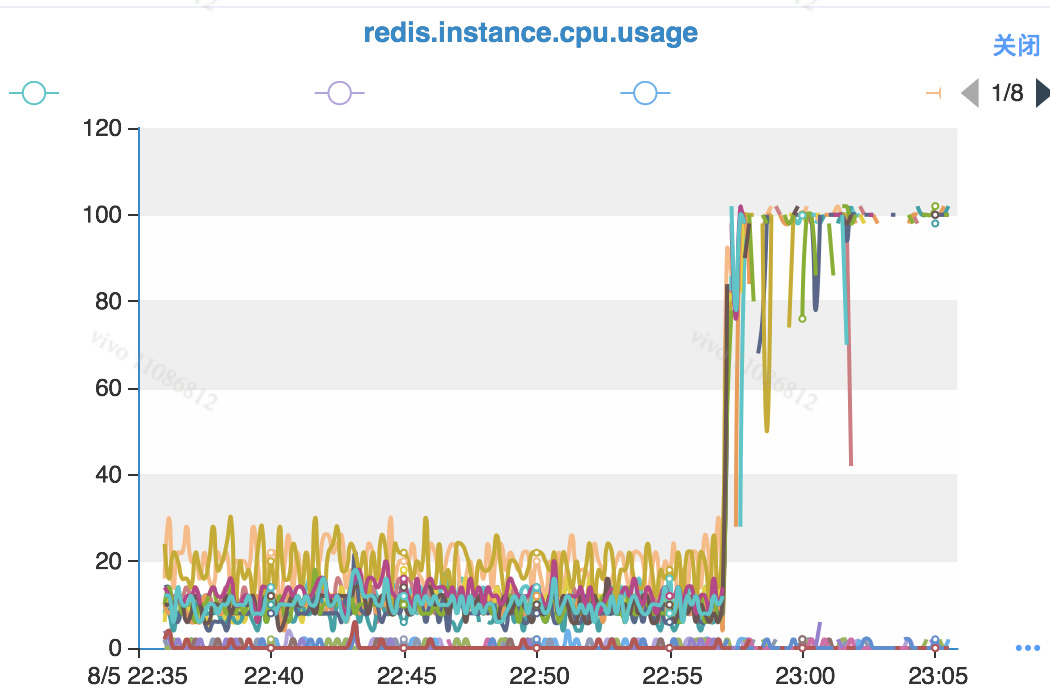
当搜索引擎 ElasticSearch 面对千万级索引量的去重统计时,该如何实现快速的响应。本文将结合我们的亲身经历,为读者朋友呈现生产环境中遇到这类问题时的解决思路。 1. 背景 在数周前的某一天,交易团队的同学发现运行在某云上面的订单索引存在严重的增量同步延迟问题,且已经对业务造成了影响。所以将该索引的流量切换到自研搜索平台中,虽说自研搜索不存在增量延迟情况,但却发现查询的 RT 竟高达十几秒,依旧无法解决业务面临的困境。 当时获知该情况时还是比较错愕的,接口 RT 的增长通常是个渐进式的过程,既然存在性能问题应该在早期就有所表现,不至于突然暴涨至十几秒。进一步了解情况后,得知一年前由于当时的自研搜索平台基建不够成熟,该索引的查询流量便一直由三方云服务承接。过去这么长时间,自研搜索平台仅保留着该索引的增量功能,但从未对外提供检索服务。而如今突然将查询流量导入自研平台,不曾预料到会存在如此严重的查询性能问题。 ElasticSearch 作为一款能够轻松应对上亿规模检索的分布式搜索引擎,却发生如此“反常”的表现,下意识就觉得症结应该出在我们的使用方式上。在抓取了相关的 DSL 语句后很快便定位到了问题根源,主要由于业务场景中会对某个查询字段作去重后的计数统计,用到了 ES 中 cardinality 这一项聚合功能。这原本是个非常普通的操作,然而由于匹配到的订单索引数高达千万级,此时的聚合操作需要消耗大量的计算资源,以致RT暴涨。 2. 原因 为了证实慢查是因聚合所致,我们先后做了两次对比实验。 第一次包含去重查询,涉及数据量1450W,用时超 7 秒。 (为什么没有上文提到的超10秒?这是因为期间我们做过一次ES集群扩容,增加节点和分片数后执行效率有所提升) 第二次移除聚合语句,此时的查询耗时仅 184 毫秒。 要了解背后的差异,我们需要先对cardinality建立认知。它是基于 HyperLogLog++ (HLL)算法实现的一种近似度量算法。这涉及到对输入条件作 hash 运算,然后根据哈希运算的结果中的 bits 做概率估算从而得到基数。 HLL 本身便是一种非常高效的算法,可毕竟还是需要对全量的数据集合都做一遍 hash 运算。如果是几万、几十万的统计量,用户对于由此产生额外的几十毫秒,甚至上百毫秒性能开销是不太敏感的。可倘若统计量达到百万级,乃至千万级,计算时长增加了几十倍,上百倍,慢查的体感则非常明显。 至此,我们可以得出一个结论:引发慢查的直接原因是由于需要参与 hash 运算的数据集合过于庞大。 3. 步入误区 找到原因后,便可以对症下药。不过很遗憾,当时我们采取的第一个解决方案不仅没有获得预期的效果,反而引发了其他问题。 起初我们认为,既然导致慢查的直接原因是参与 hash 运算的数据量太多了,那我们是否可以在保证不改变召回结果的前提下,通过减少参与聚合统计的数据量来改善性能。 虽然这种聚合方式会导致统计结果失真,但由于系统本就要求召回结果限制在1万以内( 比如匹配查询条件的索引数有2万条,但系统提供的分页能力最多查询前1万条索引),这意味着只需针对排序的前1万条记录作聚合也是可被接受的。 顺着这个思路,我从 ES 文档中找到了 terminate_after。该属性会限制查询请求在每个索引分片中召回的记录数,缓解了因匹配索引数过多而引发的资源开销。 乍一看这确实是我们需要的解决方案,可是上线后才发现使用 terminate_after之后召回的结果不是“最佳”匹配,仅仅是符合过滤条件而已,最直观的表现便是排序效果失效,因此不得已只能弃用该方案。 4. 寻找正解 既然无法减少聚合数据集,我们便只能从节省 hash 运算开销这个方向入手。幸运的是, ElasticSearch 已经为此提供了很好的解决方案,即:hash预运算。 这是一种将 Hash 运算的过程从查询阶段的实时计算,前置到索引创建阶段的策略。在创建索引的同时,计算出待聚合字段的 hash 值并写入索引文件,查询环节便可直接对 hash 进行统计。该策略尤为适用读多写少,且聚合基数庞大的场景。 而要启用该策略,我们还需要对ES集群和搜索工程做一些调整。具体如下: 在ES集群中安装mapper-murmur3插件并重启服务。 sudobin/elasticsearch-plugininstallmapper-murmur3 修改索引模板,为聚合字段设置 hash field。 { "mappings": { "trade_id": { "type" : "keyword", "fields" : { "hash" : { "type" : "murmur3" } } } } } 改写查询时的DSL语句,采用<聚合字段>.hash的形式查询。 通过 hash 预运算的方式,我们可以看到查询性能由原先的 7 秒多骤降至不到500ms,几乎可以算是完美解决了聚合的性能问题。 5. 思考 虽说本次遇到的问题算是得到了圆满的解决,但是在我看来 hash 预运算也只能作为阶段性方案。假设我们需要统计的数据集合高达数亿、数十亿、百亿,届时我们依旧陷入了因量变而导致质变的局面。 所以,我认为最终的解决方案还是需要在数据的统计量上作出妥协,回归到一开始误入的那条“歧途“。只不过目前还未找到一种即保留排序效果,又能限制聚合索引数量的最优解。如对此有研究的朋友,欢迎留言交流。

优秀的个人博客,低调大师

百万并发下的nginx优化之道!!!

@[TOC](文章目录) # 一、nginx地址重写 ### 1、nginx地址重写(rewrite)介绍 nginx地址重写的主要功能是实现URL地址的重定向。服务器获得一个来访的URL请求,然后改写成服务器可以处理的另一个URL 语法格式: rewrite 旧的地址(支持正则) 新的地址 标签(可忽略) ### 2、主文件配置方式与步骤 #### ① 基本配置转发 ```powershell [root@localhost ~]# vim /usr/local/nginx/conf/nginx.conf //编辑主配置文件 server { listen 80; server_name web.com.cn; rewrite "/a.html$" /b.html; //地址重写配置 [root@localhost ~]# /usr/local/nginx/sbin/nginx -s reload //重启nginx服务 ``` #### ② 基本正则转发 ```powershell [root@localhost ~]# vim /usr/local/nginx/conf/nginx.conf //编辑主配置文件 server { listen 80; server_name web.com.cn; rewrite ^/ http://www.baidu.com.cn; //地址重写配置^/指的是匹配/usr/local/nginx/html下的所有网页,访问任何网站的时候都会跳转到baidu.com.cn下 [root@localhost ~]# /usr/local/nginx/sbin/nginx -s reload //重启nginx服务 ``` #### ③ 高级正则地址重写 ```powershell [root@localhost ~]# vim /usr/local/nginx/conf/nginx.conf //编辑主配置文件 server { listen 80; server_name web.com.cn; rewrite ^/(.*)$ http://www.baidu.com.cn/$1; //地址重写配置,使用正则,()代表保留,nginx使用$1代表第一个保留字串,$2则代表第二个保留字串 [root@localhost ~]# /usr/local/nginx/sbin/nginx -s reload //重启nginx服务 ``` # 二、LNMP动态网站 L:linux操作系统 N:Nginx网站服务软件 M:Mysql、MariaDB数据库 P:网站开发语言(PHP) ### 1、LNMP原理: nginx:单独部署,只能处理静态数据; 静态数据:指的是每次打开或者访问的时候,都是看到相同的内容,不会发生变化的 动态数据:每次运行,执行时都可以得到不同的结果 #### ① lnmp对静态数据的处理过程 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210707233722441.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2MDAxOTMz,size_16,color_FFFFFF,t_70)![在这里插入图片描述](https://img-blog.csdnimg.cn/20210707233801209.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2MDAxOTMz,size_16,color_FFFFFF,t_70) #### ② lnmp对动态数据的处理过程 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210707233629525.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2MDAxOTMz,size_16,color_FFFFFF,t_70) ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210707233850347.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2MDAxOTMz,size_16,color_FFFFFF,t_70) ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210707233858432.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2MDAxOTMz,size_16,color_FFFFFF,t_70) ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210707233904469.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzQ2MDAxOTMz,size_16,color_FFFFFF,t_70) ### 2、部署LNMP网站 #### ① 搭建nginx ```powershell [root@localhost ~]# yum -y install gcc pcre-devel openssl-devel //安装依赖包 [root@localhost ~]# tar -xf nginx-1.16.1 //解压编译包 [root@localhost ~]# cd nginx-1.16.1 [root@localhost nginx-1.16.1]# --prefix=/usr/local/nginx \ --with-http_ssl_module [root@localhost nginx-1.16.1]# make && make install //编译安装 ``` #### ② 安装MariaDB数据库 ```powershell [root@localhost ~]# yum -y install mariadb-server mariadb mariadb-devel ``` #### ③ 安装php解释器 ```powershell [root@localhost ~]# yum -y install php php-fpm php-mysql ``` #### ④ 启动所有服务 ```powershell [root@localhost ~]# /usr/local/nginx/sbin/nginx //启动nginx服务 [root@localhost ~]# systemctl start mariadb //开启mariadb服务 [root@localhost ~]# systemctl start php-fpm //开启php-fpm服务 [root@localhost ~]# systemctl enable mariadb //设置mariadb服务开机自启 [root@localhost ~]# systemctl enable php-fpm //设置php-fpm服务开机自启 ``` # 三、配置动静分离 ### 1、location语法 ```powershell localtion /test { deny 10.10.10.10; //拒绝10.10.10.10 } localtion /video { /*允许20.20.20.20,其它的禁用*/ allow 20.20.20.20; deny all; } localtion / { allow all; //允许所有 } ``` ### 2、修改配置文件,配置nginx动静分离 ```powershell [root@localhost ~]# vim /usr/local/nginx/conf/nginx.conf // location 处理静态网页 localtion / { root html; index index.html index.htm; } location ~\.php$ { root html; fastcgi_pass 127.0.0.1:9000; //指定转发请求 fastcgi_index index.php; //php为默认页面 include fastcgi.conf; } [root@localhost ~]# /usr/local/nginx/sbin/nginx -s reload //重启服务 [root@localhost ~]# iptables -F // 清空防火墙策略 ```

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册