首页 文章 精选 留言 我的

精选列表

搜索[项目归档],共10000篇文章
优秀的个人博客,低调大师

Jenkins CI持续集成项目基础配置

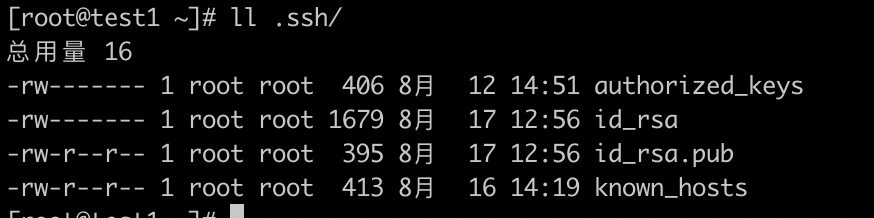
1. 安装Jenkins sudo wget -O /etc/yum.repos.d/jenkins.repo \ https://pkg.jenkins.io/redhat-stable/jenkins.repo sudo rpm --import https://pkg.jenkins.io/redhat-stable/jenkins.io.key sudo yum upgrade sudo yum install epel-release java-11-openjdk-devel sudo yum install jenkins sudo systemctl daemon-reload 引用自:https://www.jenkins.io/doc/book/installing/linux/#red-hat-centos 2. 打开http://ip:8080 按提示操作,并安装推荐插件 3. Jenkins安装插件 ① Git 插件 ② Docker 插件 ③ Kubernetes ④ Kubernetes Cli ⑤ Config File Provider ⑥ Pipeline Utility Steps 4. Jenkins服务器安装 maven git docker jdk(安装jenkins时已经启动) 5. 配置Credentials添加证书从git上拉代码 Jenkins服务器生成密钥: ssh-keygen -t rsa -C "ci@huanke.com" 使用阿里云的codeup的话,先创建个拉取的ram账户(例如:ci),在codeup中将ram账户ci给授权为开发权限。 然后阿里云登陆ci账户,上传服务器的id_rsa.pub 到codeup仓库的ci个人设置下的ssh公钥,并设置为只读权限。 最后Jenkins设置git拉去代码凭据

优秀的个人博客,低调大师

面试系列五 之 项目涉及技术Spark

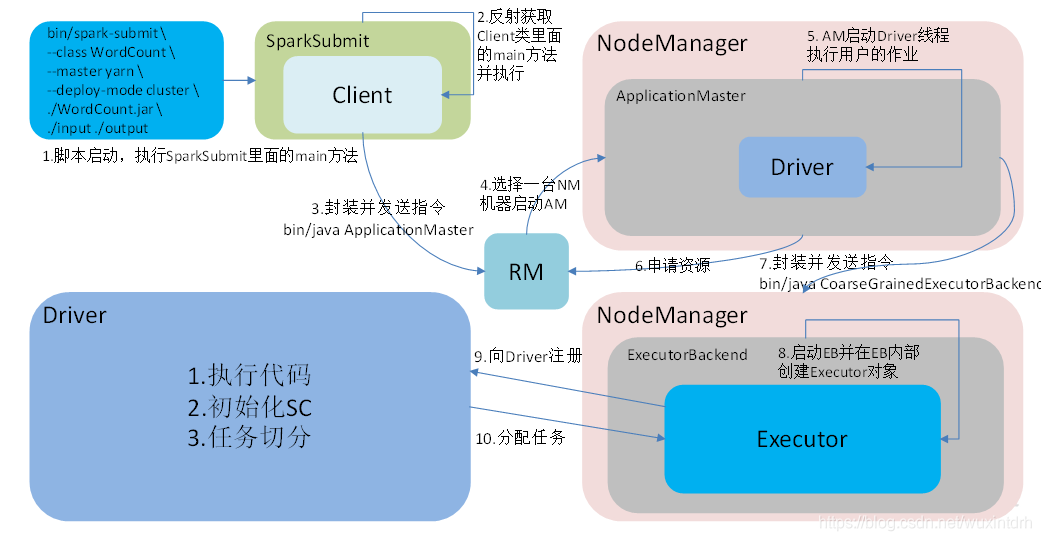
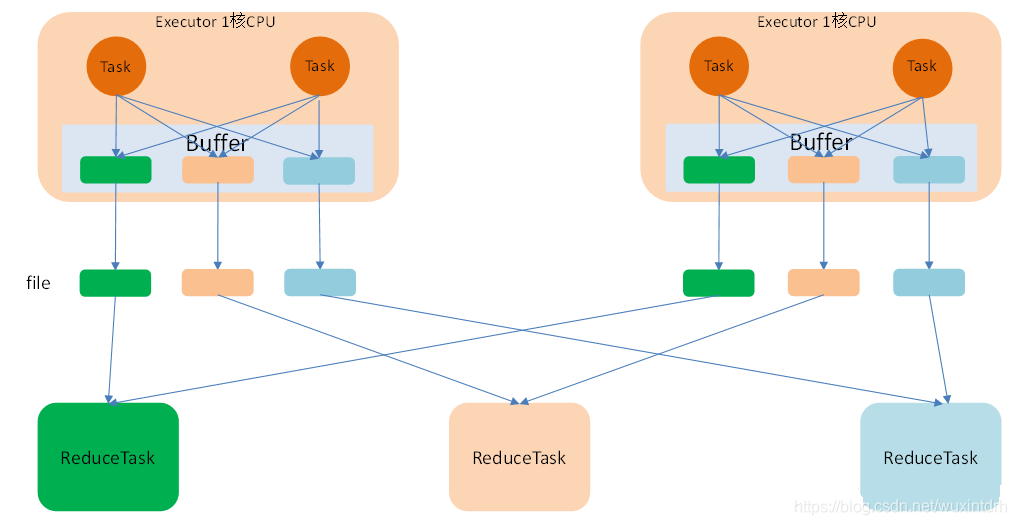
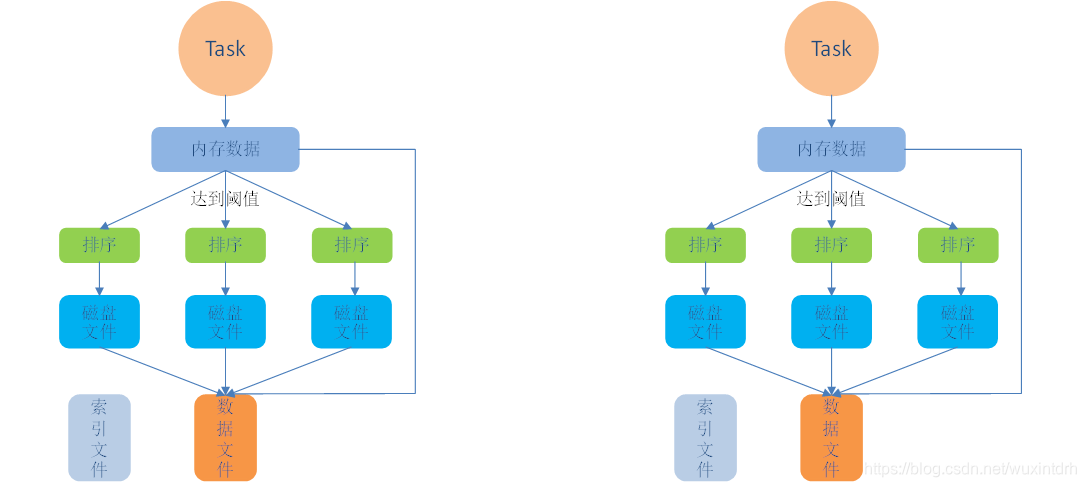
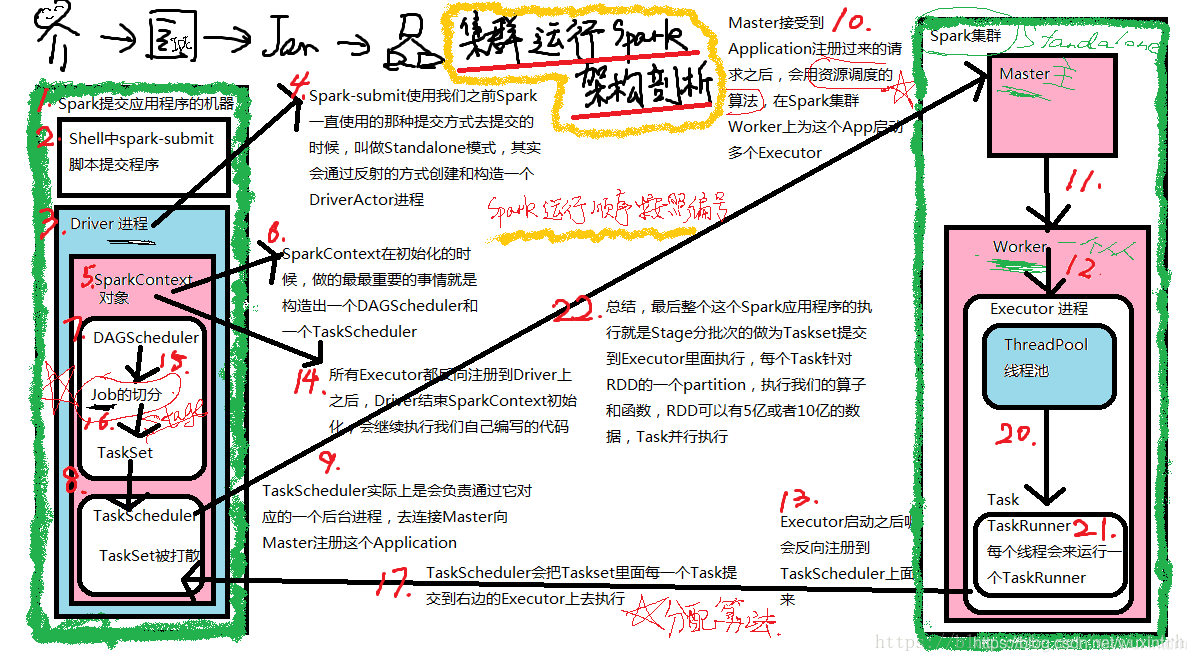
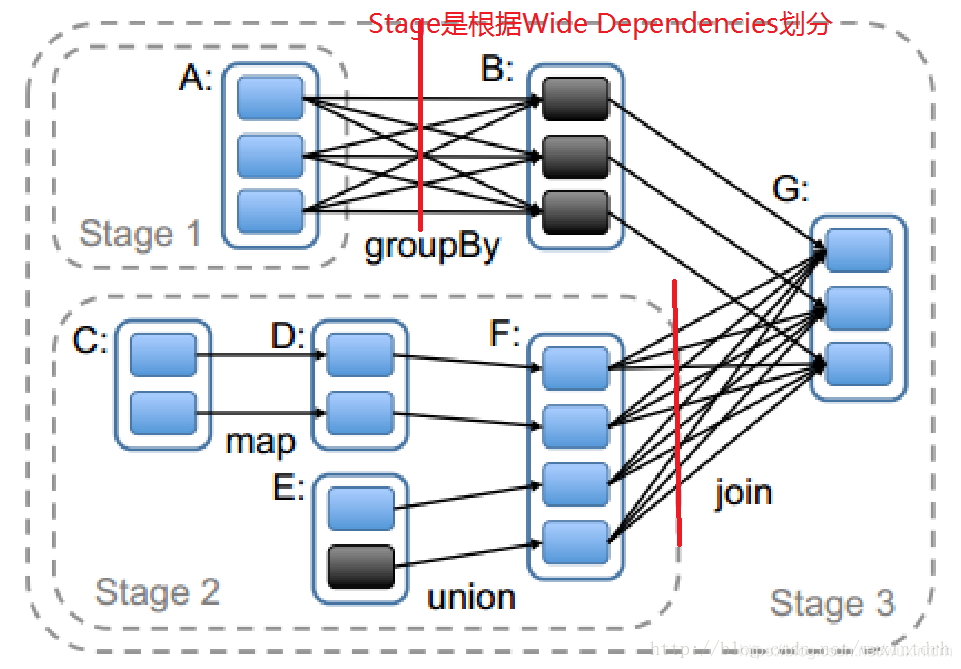
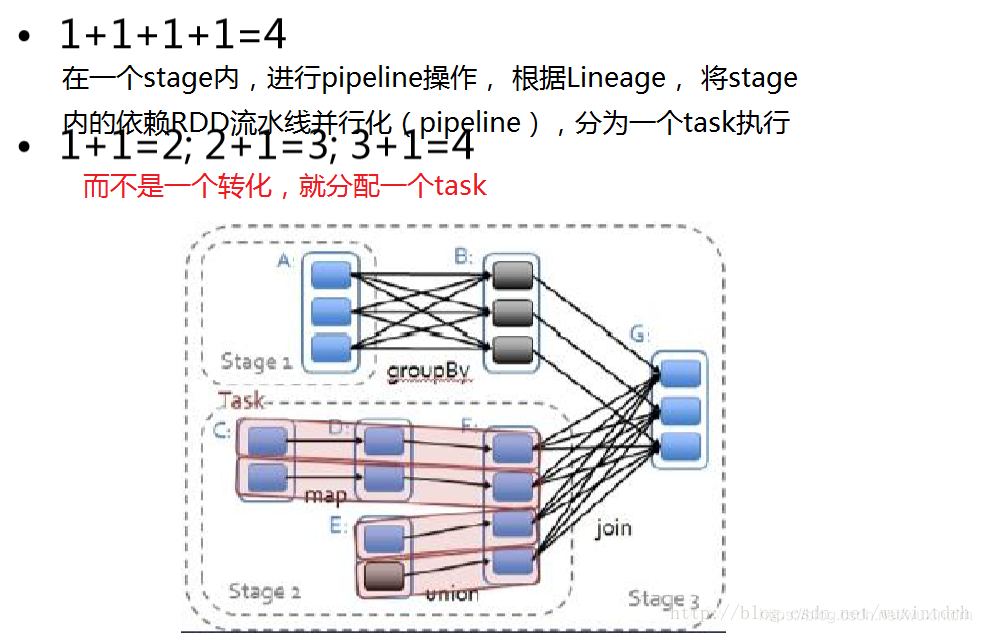
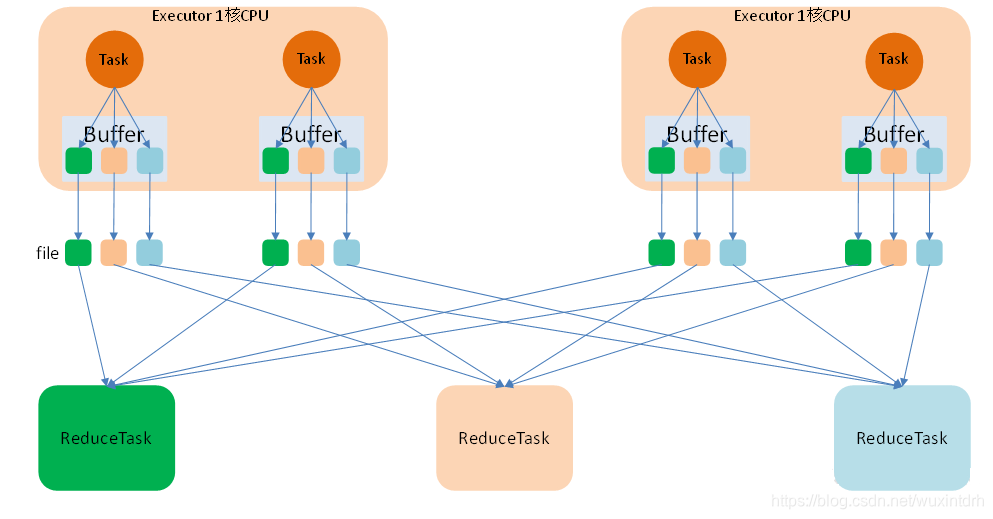
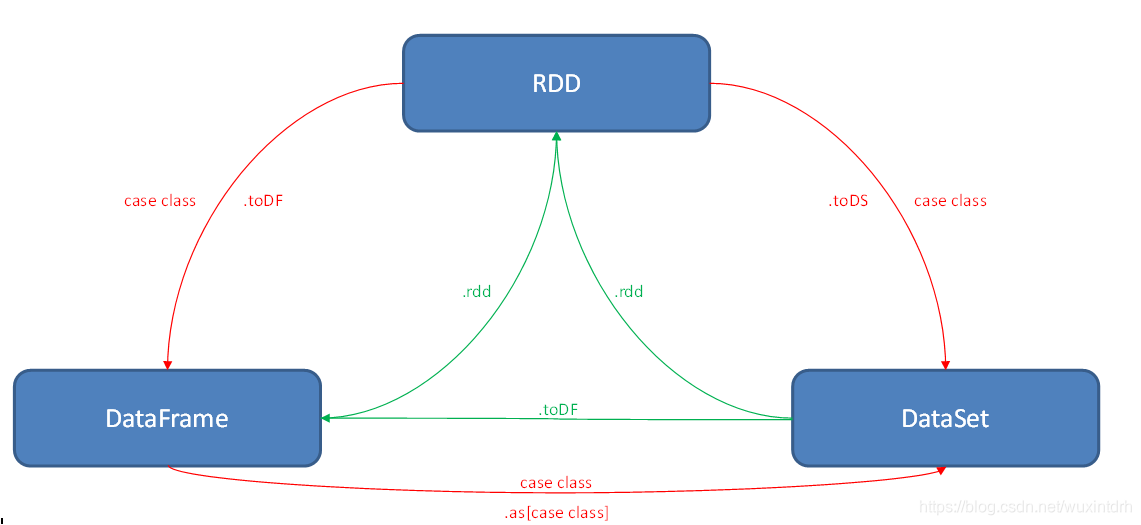
# 一、Spark ### 1.1 Spark有几种部署方式?请分别简要论述 - 1)Local:运行在一台机器上,通常是练手或者测试环境。 - 2)Standalone:构建一个基于Mster+Slaves的资源调度集群,Spark任务提交给Master运行。是Spark自身的一个调度系统。 - 3)Yarn: Spark客户端直接连接Yarn,不需要额外构建Spark集群。有yarn-client和yarn-cluster两种模式,主要区别在于:Driver程序的运行节点。 - 4)Mesos:国内大环境比较少用。 ### 1.2 Spark任务使用什么进行提交,javaEE界面还是脚本 Shell 脚本。 ### 1.3 Spark提交作业参数(重点) 1)在提交任务时的几个重要参数 - executor-cores —— 每个executor使用的内核数,默认为1,官方建议2-5个,我们企业是4个 - num-executors —— 启动executors的数量,默认为2 - executor-memory —— executor内存大小,默认1G - driver-cores —— driver使用内核数,默认为1 - driver-memory —— driver内存大小,默认512M 2)边给一个提交任务的样式 ```shell spark-submit \ --master local\[5\] \ --driver-cores 2 \ --driver-memory 8g \ --executor-cores 4 \ --num-executors 10 \ --executor-memory 8g \ --class PackageName.ClassName XXXX.jar \ --name "Spark Job Name" \ InputPath \ OutputPath ``` ### 1.4 简述Spark的架构与作业提交流程(画图讲解,注明各个部分的作用)(重点) 参考: https://blog.csdn.net/wuxintdrh/article/details/70956686 #### 1.4.1、standlone ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220315942.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) #### 1.4.2、yarn-cluster ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220419919.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 1.5 如何理解Spark中的血统概念(RDD)(笔试重点) 参考:https://blog.csdn.net/wuxintdrh/article/details/70840323 `RDD`在`Lineage`依赖方面分为两种`Narrow Dependencies`与`Wide Dependencies`用来解决数据容错时的高效性以及划分任务时候起到重要作用。 ### 1.6 简述Spark的宽窄依赖,以及Spark如何划分stage,每个stage又根据什么决定task个数? (笔试重点) Stage:根据RDD之间的依赖关系的不同将Job划分成不同的Stage,遇到一个宽依赖则划分一个Stage。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220618234.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) Task:Stage是一个TaskSet,将Stage根据分区数划分成一个个的Task。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620220643695.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 1.7 请列举Spark的transformation算子(不少于8个),并简述功能(重点) **参考: https://blog.csdn.net/wuxintdrh/article/details/80815731** 1)map(func):返回一个新的RDD,该RDD由每一个输入元素经过func函数转换后组成. 2)mapPartitions(func):类似于map,但独立地在RDD的每一个分片上运行,因此在类型为T的RD上运行时,func的函数类型必须是Iterator\[T\] => Iterator\[U\]。假设有N个元素,有M个分区,那么map的函数的将被调用N次,而mapPartitions被调用M次,一个函数一次处理所有分区。 3)reduceByKey(func,\[numTask\]):在一个(K,V)的RDD上调用,返回一个(K,V)的RDD,使用定的reduce函数,将相同key的值聚合到一起,reduce任务的个数可以通过第二个可选的参数来设置。 4)aggregateByKey (zeroValue:U,\[partitioner: Partitioner\]) (seqOp: (U, V) => U,combOp: (U, U) => U: 在kv对的RDD中,,按key将value进行分组合并,合并时,将每个value和初始值作为seq函数的参数,进行计算,返回的结果作为一个新的kv对,然后再将结果按照key进行合并,最后将每个分组的value传递给combine函数进行计算(先将前两个value进行计算,将返回结果和下一个value传给combine函数,以此类推),将key与计算结果作为一个新的kv对输出。 5)combineByKey(createCombiner: V=>C, mergeValue: (C, V) =>C, mergeCombiners: (C, C) =>C): 对相同K,把V合并成一个集合。 1.createCombiner: combineByKey() 会遍历分区中的所有元素,因此每个元素的键要么还没有遇到过,要么就和之前的某个元素的键相同。如果这是一个新的元素,combineByKey()会使用一个叫作createCombiner()的函数来创建那个键对应的累加器的初始值 2.mergeValue: 如果这是一个在处理当前分区之前已经遇到的键,它会使用mergeValue()方法将该键的累加器对应的当前值与这个新的值进行合并 3.mergeCombiners: 由于每个分区都是独立处理的, 因此对于同一个键可以有多个累加器。如果有两个或者更多的分区都有对应同一个键的累加器, 就需要使用用户提供的 mergeCombiners() 方法将各个分区的结果进行合并。 … 根据自身情况选择比较熟悉的算子加以介绍。 ### 1.8 请列举Spark的action算子(不少于6个),并简述功能(重点) **参考: https://blog.csdn.net/wuxintdrh/article/details/80815731** 1)reduce: 2)collect: 3)first: 4)take: 5)aggregate: 6)countByKey: 7)foreach: 8)saveAsTextFile: ### 1.9 请列举会引起Shuffle过程的Spark算子,并简述功能。 reduceBykey: groupByKey: … ByKey: ### 1.10 简述Spark的两种核心Shuffle(HashShuffle与SortShuffle)的工作流程(包括未优化的HashShuffle、优化的HashShuffle、普通的SortShuffle与bypass的SortShuffle)(重点) 未经优化的HashShuffle: ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221116623.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 优化后的Shuffle: ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221221471.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 普通的SortShuffle: ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221316761.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 当 `shuffle read task` 的 数 量 小 于 等 于 `spark.shuffle.sort`。 `bypassMergeThreshold` 参数的值时(默认为 200),就会**启用 bypass 机制**。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620221412460.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70#pic_center) ### 1.11 Spark常用算子reduceByKey与groupByKey的区别,哪一种更具优势?(重点) reduceByKey:按照key进行聚合,**在shuffle之前有combine(预聚合)操作**,返回结果是RDD\[k,v\]。 groupByKey:按照key进行分组,直接进行shuffle。 开发指导:reduceByKey比groupByKey,建议使用。但是需要注意是否会影响业务逻辑。 ### 1.12 Repartition和Coalesce关系与区别 1)关系: 两者都是用来改变RDD的partition数量的,repartition底层调用的就是coalesce方法:`coalesce(numPartitions, shuffle = true)` 2)区别: **repartition一定会发生shuffle,coalesce根据传入的参数来判断是否发生shuffle** 一般情况下 - 增大rdd的partition数量使用repartition - 减少partition数量时使用coalesce ### 1.13 分别简述Spark中的缓存机制(cache和persist)与checkpoint机制,并指出两者的区别与联系 都是做RDD持久化的 `cache`:内存,不会截断血缘关系,使用计算过程中的数据缓存。 `checkpoint`:磁盘,**截断血缘关系**,在ck之前必须没有任何任务提交才会生效,ck过程会额外提交一次任务。 ### 1.14 简述Spark中共享变量(广播变量和累加器)的基本原理与用途。(重点) **累加器(accumulator)**是Spark中提供的一种分布式的变量机制,其原理类似于mapreduce,即分布式的改变,然后聚合这些改变。累加器的一个常见用途是在调试时对作业执行过程中的事件进行计数。而广播变量用来高效分发较大的对象。 共享变量出现的原因: 通常在向 Spark 传递函数时,比如使用 map() 函数或者用 filter() 传条件时,可以使用驱动器程序中定义的变量,但是集群中运行的每个任务都会得到这些变量的一份新的副本,更新这些副本的值也不会影响驱动器中的对应变量。 Spark的两个共享变量,累加器与广播变量,分别为结果聚合与广播这两种常见的通信模式突破了这一限制。 ### 1.15 当Spark涉及到数据库的操作时,如何减少Spark运行中的数据库连接数? 使用foreachPartition代替foreach,在foreachPartition内获取数据库的连接。 ### 1.16 简述SparkSQL中RDD、DataFrame、DataSet三者的区别与联系? (笔试重点) **1)RDD** 优点: - 编译时类型安全 - 编译时就能检查出类型错误 - 面向对象的编程风格 - 直接通过类名点的方式来操作数据 缺点: - 序列化和反序列化的性能开销 - 无论是集群间的通信, 还是IO操作都需要对对象的结构和数据进行序列化和反序列化。 - GC的性能开销,频繁的创建和销毁对象, 势必会增加GC **2)DataFrame** DataFrame引入了`schema`和`off-heap` schema : RDD每一行的数据, 结构都是一样的,这个结构就存储在schema中。 Spark通过schema就能够读懂数据, 因此在通信和IO时就只需要序列化和反序列化数据, 而结构的部分就可以省略了。 **3)DataSet** DataSet结合了RDD和DataFrame的优点,并带来的一个新的概念`Encoder`。 当序列化数据时,Encoder产生字节码与off-heap进行交互,能够达到按需访问数据的效果,而不用反序列化整个对象。Spark还没有提供自定义Encoder的API,但是未来会加入。 **三者之间的转换:** ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210620222320481.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 1.17 SparkSQL中join操作与left join操作的区别? join和sql中的inner join操作很相似,返回结果是前面一个集合和后面一个集合中匹配成功的,过滤掉关联不上的。 leftJoin类似于SQL中的左外关联left outer join,返回结果以第一个RDD为主,关联不上的记录为空。 部分场景下可以使用left semi join替代left join: 因为 left semi join 是 in(keySet) 的关系,**遇到右表重复记录,左表会跳过****,****性能更高**,而 left join 则会一直遍历。**但是left semi join 中最后 select 的结果中只许出现左表中的列名**,因为右表只有 join key 参与关联计算了 ### 1.18 请手写出wordcount的Spark代码实现(Scala)(手写代码重点) ```scala val conf: SparkConf = new SparkConf().setMaster("local\[*\]").setAppName("WordCount") val sc = new SparkContext(conf) sc.textFile("/input") .flatMap(_.split(" ")) .map((_,1)) .reduceByKey(_+_) .saveAsTextFile("/output") sc.stop() ``` ### 1.19、 如何使用[Spark实现topN](https://blog.csdn.net/wuxintdrh/article/details/72810306)的获取(描述思路或使用伪代码)(重点) 方法1: - (1)按照key对数据进行聚合(groupByKey) - (2)将value转换为数组,利用scala的sortBy或者sortWith进行排序(mapValues)数据量太大,会OOM。 方法2: - (1)取出所有的key - (2)对key进行迭代,每次取出一个key利用spark的排序算子进行排序 方法3: - (1)自定义分区器,按照key进行分区,使不同的key进到不同的分区 - (2)对每个分区运用spark的排序算子进行排序 ### 1.20 京东:调优之前与调优之后性能的详细对比(例如调整map个数,map个数之前多少、之后多少,有什么提升) 这里举个例子。比如我们有几百个文件,会有几百个map出现,读取之后进行join操作,会非常的慢。这个时候我们可以进行coalesce操作,比如240个map,我们合成60个map,也就是窄依赖。这样再shuffle,过程产生的文件数会大大减少。提高join的时间性能。 # 二、SparkStreaming 参考: https://chbxw.blog.csdn.net/article/details/80809898 ### 2.1、 SparkStreaming有哪几种方式消费Kafka中的数据,它们之间的区别是什么? **1、基于Receiver的方式** 这种方式使用Receiver来获取数据。Receiver是使用Kafka的高层次Consumer API来实现的。receiver从Kafka中获取的数据都是存储在Spark Executor的内存中的(如果突然数据暴增,大量batch堆积,很容易出现内存溢出的问题),然后Spark Streaming启动的job会去处理那些数据。 然而,在默认的配置下,这种方式可能会因为底层的失败而丢失数据。如果要启用高可靠机制,让数据零丢失,就必须启用Spark Streaming的预写日志机制(Write Ahead Log,WAL)。该机制会同步地将接收到的Kafka数据写入分布式文件系统(比如HDFS)上的预写日志中。所以,即使底层节点出现了失败,也可以使用预写日志中的数据进行恢复。 **2、基于Direct的方式** 这种新的不基于Receiver的直接方式,是在Spark 1.3中引入的,从而能够确保更加健壮的机制。替代掉使用Receiver来接收数据后,这种方式会周期性地查询Kafka,来获得每个topic+partition的最新的offset,从而定义每个batch的offset的范围。当处理数据的job启动时,就会使用Kafka的简单consumer api来获取Kafka指定offset范围的数据。 **优点如下**: **简化并行读取**:如果要读取多个partition,不需要创建多个输入DStream然后对它们进行union操作。Spark会创建跟Kafka partition一样多的RDD partition,并且会并行从Kafka中读取数据。所以在Kafka partition和RDD partition之间,有一个一对一的映射关系。 **高性能**:如果要保证零数据丢失,在基于receiver的方式中,需要开启WAL机制。这种方式其实效率低下,因为数据实际上被复制了两份,Kafka自己本身就有高可靠的机制,会对数据复制一份,而这里又会复制一份到WAL中。而基于direct的方式,不依赖Receiver,不需要开启WAL机制,只要Kafka中作了数据的复制,那么就可以通过Kafka的副本进行恢复。 **一次且仅一次的事务机制**。 **3、对比:** 基于receiver的方式,是使用Kafka的高阶API来在ZooKeeper中保存消费过的offset的。这是消费Kafka数据的传统方式。这种方式配合着WAL机制可以保证数据零丢失的高可靠性,但是却无法保证数据被处理一次且仅一次,可能会处理两次。因为Spark和ZooKeeper之间可能是不同步的。 基于direct的方式,使用kafka的简单api,Spark Streaming自己就负责追踪消费的offset,并保存在checkpoint中。Spark自己一定是同步的,因此可以保证数据是消费一次且仅消费一次。 **在实际生产环境中大都用Direct方式** ### 2.2 简述SparkStreaming窗口函数的原理(重点) 窗口函数就是在原来定义的SparkStreaming计算批次大小的基础上再次进行封装,每次计算多个批次的数据,同时还需要传递一个滑动步长的参数,用来设置当次计算任务完成之后下一次从什么地方开始计算。 图中time1就是SparkStreaming计算批次大小,虚线框以及实线大框就是窗口的大小,必须为批次的整数倍。虚线框到大实线框的距离(相隔多少批次),就是滑动步长。 # 三、SparkSQL # 关注我的公众号【宝哥大数据】,更多干货 ![在这里插入图片描述](https://img-blog.csdnimg.cn/2021062022354047.png)
优秀的个人博客,低调大师

jar包转换pom依赖文件 maven项目

文章目录 所需的源码 pom依赖 效果图 所需的源码 package com.example.demo.test; import java.io.File; import java.io.FileInputStream; import java.io.FileNotFoundException; import java.io.IOException; import java.util.jar.JarInputStream; import java.util.jar.Manifest; import org.dom4j.Element; import org.dom4j.dom.DOMElement; import org.jsoup.Jsoup; import com.alibaba.fastjson.JSONObject; public class MakePomFromJars { public static void main(String[] args) throws FileNotFoundException, IOException { Element dependencys = new DOMElement("dependencys"); //jar包路径 File dir = new File("D:\\SSM-Demo6-3\\WebRoot\\WEB-INF\\lib"); for (File jar : dir.listFiles()) { JarInputStream jis = new JarInputStream(new FileInputStream(jar)); Manifest mainmanifest = jis.getManifest(); jis.close(); if (mainmanifest == null) { System.err.println(jar.getName()); continue; } String bundleName = mainmanifest.getMainAttributes().getValue("Bundle-Name"); String bundleVersion = mainmanifest.getMainAttributes().getValue("Bundle-Version"); Element ele = null; System.out.println(jar.getName()); StringBuffer sb = new StringBuffer(jar.getName()); if (bundleName != null) { bundleName = bundleName.toLowerCase().replace(" ", "-"); sb.append(bundleName + "\t").append(bundleVersion); ele = getDependices(bundleName, bundleVersion); System.out.println(sb.toString()); System.out.println(ele.asXML()); } if (ele == null || ele.elements().size() == 0) { bundleName = ""; bundleVersion = ""; String[] ns = jar.getName().replace(".jar", "").split("-"); for (String s : ns) { if (Character.isDigit(s.charAt(0))) { bundleVersion += s + "-"; } else { bundleName += s + "-"; } } if (bundleVersion.endsWith("-")) { bundleVersion = bundleVersion.substring(0, bundleVersion.length() - 1); } if (bundleName.endsWith("-")) { bundleName = bundleName.substring(0, bundleName.length() - 1); } ele = getDependices(bundleName, bundleVersion); sb.setLength(0); sb.append(bundleName + "\t").append(bundleVersion); System.out.println(sb.toString()); System.out.println(ele.asXML()); } ele = getDependices(bundleName, bundleVersion); if (ele.elements().size() == 0) { ele.add(new DOMElement("groupId").addText("not find")); ele.add(new DOMElement("artifactId").addText(bundleName)); ele.add(new DOMElement("version").addText(bundleVersion)); } dependencys.add(ele); System.out.println(); } System.out.println(dependencys.asXML()); } public static Element getDependices(String key, String ver) { Element dependency = new DOMElement("dependency"); // 设置代理 // System.setProperty("http.proxyHost", "127.0.0.1"); // System.setProperty("http.proxyPort", "8090"); try { String url = "http://search.maven.org/solrsearch/select?q=a%3A%22" + key + "%22%20AND%20v%3A%22" + ver + "%22&rows=3&wt=json"; org.jsoup.nodes.Document doc = Jsoup.connect(url).ignoreContentType(true).timeout(30000).get(); String elem = doc.body().text(); JSONObject response = JSONObject.parseObject(elem).getJSONObject("response"); if (response.containsKey("docs") && response.getJSONArray("docs").size() > 0) { JSONObject docJson = response.getJSONArray("docs").getJSONObject(0); Element groupId = new DOMElement("groupId"); Element artifactId = new DOMElement("artifactId"); Element version = new DOMElement("version"); groupId.addText(docJson.getString("g")); artifactId.addText(docJson.getString("a")); version.addText(docJson.getString("v")); dependency.add(groupId); dependency.add(artifactId); dependency.add(version); } } catch (Exception e) { e.printStackTrace(); } return dependency; } } pom依赖 <!--jar包转换pom依赖文件 --> <!-- https://mvnrepository.com/artifact/dom4j/dom4j --> <dependency> <groupId>dom4j</groupId> <artifactId>dom4j</artifactId> <version>1.6.1</version> </dependency> <dependency> <groupId>commons-logging</groupId> <artifactId>commons-logging</artifactId> <version>1.2</version> </dependency> <!-- https://mvnrepository.com/artifact/org.jsoup/jsoup --> <dependency> <groupId>org.jsoup</groupId> <artifactId>jsoup</artifactId> <version>1.13.1</version> </dependency> 效果图 jar包位置 控制台pom依赖生成 参考连接:my.oschina.net/zhhzhfya/blog/735050 本文到这里就结束了,你学会了吗?有问题欢迎讨论! 给大家分享一个我平时找jar包和pom依赖文件的网站:https://mvnrepository.com/ 如本文对你有用,那就一键三连吧!

优秀的个人博客,低调大师

项目中首次使用DBUnit拾遗

文章目录 测试准备 测试类配置 - BusDeviceTestApp 测试类 - DeviceLogServiceTest Excel数据准备注意点 测试数据准备 Maven 包导入 Unitils额外配置(数据库连接) 参考 正文 参考 测试整合之王Unitils(单元测试系列) 正文 测试准备 测试数据准备 dev_equipment_info.xlsx - 测试数据 expected_dev_equipment_info.xlsx - 测试后数据 Excel数据准备注意点 日期/时间格式 使用 'yyyy-mm-dd hh:mm:ss’格式 每个sheet表的首行为数据表字段名称 sheet名称需要与表名完全相同,也可以使用database.tableName格式的sheet名 一个excel数据表可以同时有多个数据表 Excel最后一行数据之后,不能只是清除内容,导入时无法识别 Maven 包导入 在pom.xml的dependencies中,增加 com.github.yangjianzhouspring-boot-unitils-starter1.3.0.RELEASE Unitils额外配置(数据库连接) application-ut.properties 存放于resources下,其内容可参考 database.driverClassName=com.mysql.jdbc.Driver #此数据库连接信息 database.url=jdbc:mysql://127.0.0.1/septictank_device #此数据库连接用户名 database.userName=root #此数据库连接用户密码 database.password=123456 #此数据库连接的schema database.schemaNames=septictank_device #此数据库数据库类型:oracle/mysql/postgres等 database.dialect=mysql dataSource.beanName=druidDataSource 测试类配置 - BusDeviceTestApp packagecom.citylink.device; importcom.unitils.boot.autoconfigure.ConfigurableApplicationContextAware; importorg.springframework.boot.SpringApplication; importorg.springframework.boot.autoconfigure.SpringBootApplication; importorg.springframework.context.annotation.ComponentScan; @SpringBootApplication @ComponentScan(basePackages={"com.citylink.device"},basePackageClasses= {ConfigurableApplicationContextAware.class,DataSourcePostProcessorExt.class}) publicclassBusDeviceTestApp{ publicstaticvoidmain(String[]args){ SpringApplication.run(BusDeviceTestApp.class,args); } } 主要实现以下功能: basePackages = {“com.citylink.device”},扫描需要注入上下文的业务bean ConfigurableApplicationContextAware.class,为测试提供上下文,以便@SpringBean,@SpringBeanByName,@SpringBeanByType等从上下文中注入bean DataSourcePostProcessorExt.class,为替换系统中原有的dataSource bean的类,如测试时一直使用系统原数据库,很有可能是相应的dataSource未被正常替换 packagecom.citylink.device; importorg.springframework.beans.BeansException; importorg.springframework.beans.factory.config.BeanPostProcessor; importorg.springframework.stereotype.Component; importorg.unitils.database.UnitilsDataSourceFactoryBean; importjavax.sql.DataSource; @Component publicclassDataSourcePostProcessorExtimplementsBeanPostProcessor{ publicDataSourcePostProcessorExt(){ } publicObjectpostProcessBeforeInitialization(Objectbean,StringbeanName)throwsBeansException{ returnbean; } publicObjectpostProcessAfterInitialization(Objectbean,StringbeanName)throwsBeansException{ if(beaninstanceofDataSource){ try{ return(newUnitilsDataSourceFactoryBean()).getObject(); }catch(Exceptionvar4){ thrownewRuntimeException("replacedatabasethrowexception,cannotcontinuetoprocess",var4); } }else{ returnbean; } } } 测试类 - DeviceLogServiceTest packagecom.citylink.device; importcom.citylink.device.pojo.Device; importcom.citylink.device.service.IDeviceService; importcom.citylink.security.common.msg.ObjectRestResponse; importcom.unitils.boot.util.UnitilsBootBlockJUnit4Cla***unner; importorg.junit.Assert; importorg.junit.Test; importorg.junit.runner.RunWith; importorg.springframework.boot.test.context.SpringBootTest; importorg.unitils.dbunit.annotation.DataSet; importorg.unitils.dbunit.annotation.ExpectedDataSet; importorg.unitils.spring.annotation.SpringBeanByType; importjava.util.List; @RunWith(UnitilsBootBlockJUnit4Cla***unner.class) @SpringBootTest(classes=BusDeviceTestApp.class) @DataSet("dev_equipment_info.xlsx") publicclassDeviceLogServiceTest{ @SpringBeanByType privateIDeviceServicedeviceService; @Test @ExpectedDataSet("expected_dev_equipment_info.xlsx") publicvoidtestSelectAll(){ ObjectRestResponseorr=deviceService.selectAll(); Assert.assertTrue(orr.isRel()); ListdeviceList=(List)orr.getData(); System.out.println("deviceList.size()="+deviceList.size()); } }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册