首页 文章 精选 留言 我的

精选列表

搜索[包管理器],共10000篇文章
优秀的个人博客,低调大师

ChineseUtil v1.1.2 发布,PHP 中文工具包

PHP 中文工具类 ChineseUtil,支持汉字转拼音、拼音分词、简繁互转、数字、金额大写; 本类库字典数据总共收录 73925 个汉字,包括:3955 个简体字,1761 个繁体字,68209 个其它汉字。 码云:https://gitee.com/yurunsoft/ChineseUtil Github:https://github.com/Yurunsoft/ChineseUtil v1.1.2 更新内容 * 修复一系列因 PHP 版本、环境、模式,导致的转换差异问题 * 测试用例加持,保证类库稳定性 使用说明 Composer 直接安装 composer require yurunsoft/chinese-util Composer 项目配置引入 "require": { "yurunsoft/chinese-util" : "~1.0" } 功能 汉字转拼音 use \Yurun\Util\Chinese; use \Yurun\Util\Chinese\Pinyin; $string = '恭喜發財!123'; echo $string, PHP_EOL; echo '全拼:', PHP_EOL; var_dump(Chinese::toPinyin($string, Pinyin::CONVERT_MODE_PINYIN)); echo '首字母:', PHP_EOL; var_dump(Chinese::toPinyin($string, Pinyin::CONVERT_MODE_PINYIN_FIRST)); echo '读音:', PHP_EOL; var_dump(Chinese::toPinyin($string, Pinyin::CONVERT_MODE_PINYIN_SOUND)); echo '读音数字:', PHP_EOL; var_dump(Chinese::toPinyin($string, Pinyin::CONVERT_MODE_PINYIN_SOUND_NUMBER)); echo '自选返回格式 + 以文本格式返回 + 自定义分隔符:', PHP_EOL; var_dump(Chinese::toPinyin($string, Pinyin::CONVERT_MODE_PINYIN | Pinyin::CONVERT_MODE_PINYIN_SOUND_NUMBER, ' ')); echo '所有结果:', PHP_EOL; var_dump(Chinese::toPinyin($string)); echo '不分割无拼音字符:', PHP_EOL; var_dump(Chinese::toPinyin($string, Pinyin::CONVERT_MODE_PINYIN, ' ', false)); // 结果太长,请自行运行代码查看 拼音分词 use \Yurun\Util\Chinese; $string2 = 'xianggang'; echo '"', $string2, '"的分词结果:', PHP_EOL; var_dump(Chinese::splitPinyin($string2)); /** 输出结果: "xianggang"的分词结果: array(2) { [0]=> string(12) "xi ang gang " [1]=> string(11) "xiang gang " } * / 简繁互转 use \Yurun\Util\Chinese; $string3 = '中华人民共和国!恭喜發財!'; echo '"', $string3, '"的简体转换:', PHP_EOL; var_dump(Chinese::toSimplified($string3)); echo '"', $string3, '"的繁体转换:', PHP_EOL; var_dump(Chinese::toTraditional($string3)); /** 输出结果: "中华人民共和国!恭喜發財!"的简体转换: array(1) { [0]=> string(39) "中华人民共和国!恭喜发财!" } "中华人民共和国!恭喜發財!"的繁体转换: array(1) { [0]=> string(39) "中華人民共和國!恭喜發財!" } * / 数字转换 use Yurun\Util\Chinese\Number; function test($number) { $chinese = Number::toChinese($number, [ 'tenMin' => true, // “一十二” => “十二” ]); $afterNumber = Number::toNumber($chinese); echo $number, '=>', $chinese, '=>', $afterNumber, '=>', 0 === bccomp($number, $afterNumber, 20) ? 'true' : 'false', PHP_EOL; } test(1.234); test(-1234567890.666); test(pi()); /** 输出结果: 1.234=>一点二三四=>1.234=>true -1234567890.666=>负十二亿三千四百五十六万七千八百九十点六六六=>-1234567890.666=>true 3.1415926535898=>三点一四一五九二六五三五八九八=>3.1415926535898=>true */ 金额数字转换 use Yurun\Util\Chinese\Money; function test($number) { $chinese = Money::toChinese($number, [ 'tenMin' => true, // “一十二” => “十二” ]); $afterMoney = Money::toNumber($chinese); echo $number, '=>', $chinese, '=>', $afterMoney, '=>', 0 === bccomp($number, $afterMoney) ? 'true' : 'false', PHP_EOL; } test(1.234); test(-1234567890.666); /** 输出结果: 1.234=>壹圆贰角叁分肆厘=>1.234=>true -1234567890.666=>负壹拾贰亿叁仟肆佰伍拾陆万柒仟捌佰玖拾圆陆角陆分陆厘=>-1234567890.666=>true */

优秀的个人博客,低调大师

golang的filepath包的几个函数的细微区别

Clean(),Dir(),ABS()配合Walk()使用的时候,由于前三个函数返回值的细微差别,会造成遍历目录的时候,得到的结果不一样.filepath.Abs("./myDoc")//返回所给路径的绝对路径这时候遍历没有问题, 2019/06/12 10:50:31 监控 : 1, D:\workspace\go-wikitten\src\myDoc 2019/06/12 10:50:31 文件 : 2, myDoc\.gitkeep 2019/06/12 10:50:31 文件 : 3, myDoc\Sample HTML document.html 2019/06/12 10:50:31 文件 : 4, myDoc\Sample Markdown document.md 2019/06/12 10:50:31 监控 : 5, D:\workspace\go-wikitten\src\myDoc\code snippets (expand me!) 2019/06/12 10:50:31 文件 : 6, myDoc\code snippets (expand me!)\Bash.sh 2019/06/12 10:50:31 文件 : 7, myDoc\code snippets (expand me!)\CSS.css 2019/06/12 10:50:31 文件 : 8, myDoc\code snippets (expand me!)\JavaScript.js 2019/06/12 10:50:31 文件 : 9, myDoc\code snippets (expand me!)\PHP.php 2019/06/12 10:50:31 文件 : 10, myDoc\code snippets (expand me!)\Python.py 2019/06/12 10:50:31 文件 : 11, myDoc\code snippets (expand me!)\Ruby.rb 2019/06/12 10:50:31 文件 : 12, myDoc\code snippets (expand me!)\SQL.sql 2019/06/12 10:50:31 文件 : 13, myDoc\code snippets (expand me!)\Scheme.scm 2019/06/12 10:50:31 文件 : 14, myDoc\code snippets (expand me!)\XML.xml 2019/06/12 10:50:31 文件 : 15, myDoc\index.md 2019/06/12 10:50:31 监控 : 16, D:\workspace\go-wikitten\src\myDoc\you can also 2019/06/12 10:50:31 监控 : 17, D:\workspace\go-wikitten\src\myDoc\you can also\nest directories 2019/06/12 10:50:31 文件 : 18, myDoc\you can also\nest directories\binary files are OK too.jpg path.Clean("./myDoc")); //返回等价的最短路径 //1.用一个斜线替换多个斜线 //2.清除当前路径. //3.清除内部的..和他前面的元素 //4.以/..开头的,变成/由于我的目录不存在1,3,4的情况,所以遍历也是符合我的期望,只是把绝对路径换成了相对路径 2019/06/12 10:56:18 监控 : 1, myDoc 2019/06/12 10:56:18 文件 : 2, myDoc\.gitkeep 2019/06/12 10:56:18 文件 : 3, myDoc\Sample HTML document.html 2019/06/12 10:56:18 文件 : 4, myDoc\Sample Markdown document.md 2019/06/12 10:56:18 监控 : 5, myDoc\code snippets (expand me!) 2019/06/12 10:56:18 文件 : 6, myDoc\code snippets (expand me!)\Bash.sh 2019/06/12 10:56:18 文件 : 7, myDoc\code snippets (expand me!)\CSS.css 2019/06/12 10:56:18 文件 : 8, myDoc\code snippets (expand me!)\JavaScript.js 2019/06/12 10:56:18 文件 : 9, myDoc\code snippets (expand me!)\PHP.php 2019/06/12 10:56:18 文件 : 10, myDoc\code snippets (expand me!)\Python.py 2019/06/12 10:56:18 文件 : 11, myDoc\code snippets (expand me!)\Ruby.rb 2019/06/12 10:56:18 文件 : 12, myDoc\code snippets (expand me!)\SQL.sql 2019/06/12 10:56:18 文件 : 13, myDoc\code snippets (expand me!)\Scheme.scm 2019/06/12 10:56:18 文件 : 14, myDoc\code snippets (expand me!)\XML.xml 2019/06/12 10:56:18 文件 : 15, myDoc\index.md 2019/06/12 10:56:18 监控 : 16, myDoc\you can also 2019/06/12 10:56:18 监控 : 17, myDoc\you can also\nest directories 2019/06/12 10:56:18 文件 : 18, myDoc\you can also\nest directories\binary files are OK too.jpg path.Dir("./myDoc")); //返回路径最后一个元素的目录 //路径为空则返回.这个遍历,刚开始的时候,我以为是正确的,后面才发现不对了.首先,额外监控了给定目录的父目录,也就是myDoc的父目录,参见第一行输出其次,如果目录下没有文件,接着还是目录,参见输出的17和18行,遍历的时候跳过去了 2019/06/12 10:48:30 监控 : 1, . 2019/06/12 10:48:30 文件 : 2, myDoc\.gitkeep 2019/06/12 10:48:30 文件 : 3, myDoc\Sample HTML document.html 2019/06/12 10:48:30 文件 : 4, myDoc\Sample Markdown document.md 2019/06/12 10:48:30 监控 : 5, myDoc 2019/06/12 10:48:30 文件 : 6, myDoc\code snippets (expand me!)\Bash.sh 2019/06/12 10:48:30 文件 : 7, myDoc\code snippets (expand me!)\CSS.css 2019/06/12 10:48:30 文件 : 8, myDoc\code snippets (expand me!)\JavaScript.js 2019/06/12 10:48:30 文件 : 9, myDoc\code snippets (expand me!)\PHP.php 2019/06/12 10:48:30 文件 : 10, myDoc\code snippets (expand me!)\Python.py 2019/06/12 10:48:30 文件 : 11, myDoc\code snippets (expand me!)\Ruby.rb 2019/06/12 10:48:30 文件 : 12, myDoc\code snippets (expand me!)\SQL.sql 2019/06/12 10:48:30 文件 : 13, myDoc\code snippets (expand me!)\Scheme.scm 2019/06/12 10:48:30 文件 : 14, myDoc\code snippets (expand me!)\XML.xml 2019/06/12 10:48:30 文件 : 15, myDoc\index.md 2019/06/12 10:48:30 监控 : 16, myDoc 2019/06/12 10:48:30 监控 : 17, myDoc\you can also 2019/06/12 10:48:30 文件 : 18, myDoc\you can also\nest directories\binary files are OK too.jpg

优秀的个人博客,低调大师

hanlp自然语言处理包的基本使用--python

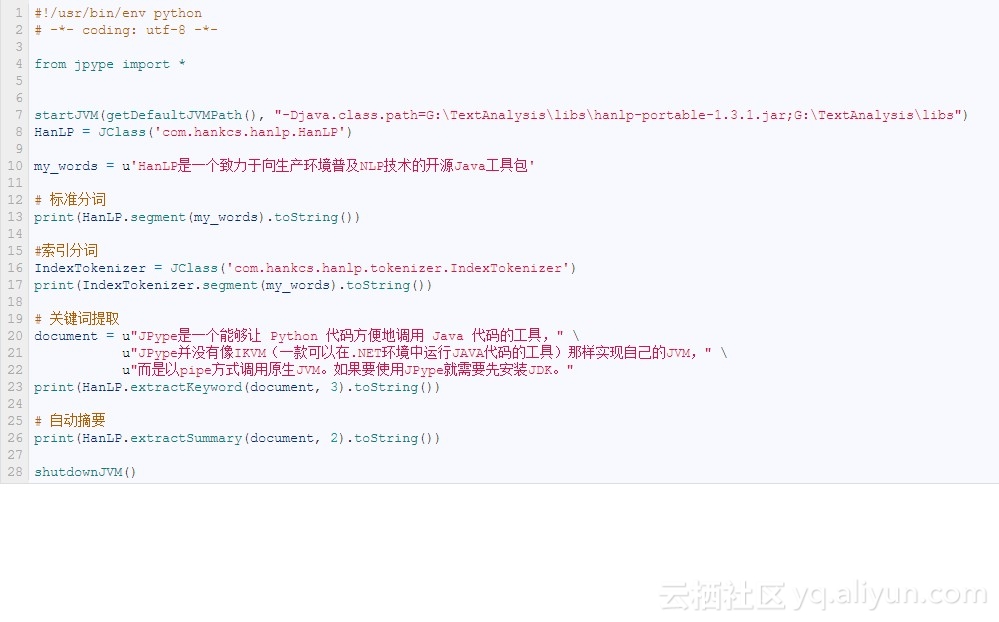
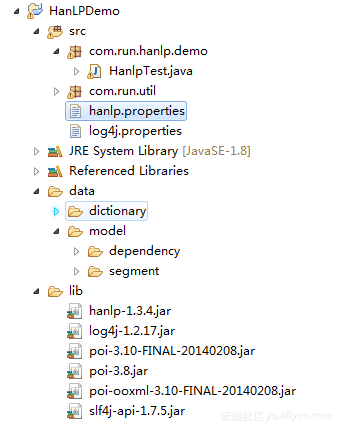
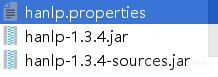
hanlp拥有:中文分词、命名实体识别、摘要关键字、依存句法分析、简繁拼音转换、智能推荐。 这里主要介绍一下hanlp的中文分词、命名实体识别、依存句法分析,这里就不介绍具体的hanlp的安装了,百度教程很多,可以看这里:http://hanlp.com/里面也有相关的一些介绍。 我以前还使用过jieba分词和LTP,综合来说,LTP是做的相对要好一点,特别是中文处理这一块,但是它的最大缺点是不开源,而hanlp功能更齐全而且开源,更加有利于大家的项目开发的使用。 首先使用hanlp对中文进行处理的前提是大家已经安装好了hanlp: 第一将这几个放在你的项目下, 然后点击hanlp.propertiess,更改 保证你的data数据在这个目录之下 下面贴上一些处理自然语言的基本方法(以下代码并非原创,来自于百度上的大神): #-*- coding:utf-8 -*- from jpype import * startJVM(getDefaultJVMPath(), "-Djava.class.path=D:\python_projects\zhengzebiaodashi\hanlp\hanlp-1.3.4.jar;D:\python_projects\zhengzebiaodashi\hanlp", "-Xms1g", "-Xmx1g") # 启动JVM,Linux需替换分号;为冒号: print("=" * 30 + "HanLP分词" + "=" * 30) HanLP = JClass('com.hankcs.hanlp.HanLP') # 中文分词 print(HanLP.segment('你好,欢迎在Python中调用HanLP的API')) print("-" * 70) print("=" * 30 + "标准分词" + "=" * 30) StandardTokenizer = JClass('com.hankcs.hanlp.tokenizer.StandardTokenizer') print(StandardTokenizer.segment('你好,欢迎在Python中调用HanLP的API')) print("-" * 70) # NLP分词NLPTokenizer会执行全部命名实体识别和词性标注 print("=" * 30 + "NLP分词" + "=" * 30) NLPTokenizer = JClass('com.hankcs.hanlp.tokenizer.NLPTokenizer') print(NLPTokenizer.segment('中国科学院计算技术研究所的宗成庆教授正在教授自然语言处理课程')) print("-" * 70) print("=" * 30 + "索引分词" + "=" * 30) IndexTokenizer = JClass('com.hankcs.hanlp.tokenizer.IndexTokenizer') termList = IndexTokenizer.segment("主副食品"); for term in termList: print(str(term) + " [" + str(term.offset) + ":" + str(term.offset + len(term.word)) + "]") print("-" * 70) print("=" * 30 + " N-最短路径分词" + "=" * 30) # CRFSegment = JClass('com.hankcs.hanlp.seg.CRF.CRFSegment') # segment=CRFSegment() # testCase ="今天,刘志军案的关键人物,山西女商人丁书苗在市二中院出庭受审。" # print(segment.seg("你看过穆赫兰道吗")) print("-" * 70) print("=" * 30 + " CRF分词" + "=" * 30) print("-" * 70) print("=" * 30 + " 极速词典分词" + "=" * 30) SpeedTokenizer = JClass('com.hankcs.hanlp.tokenizer.SpeedTokenizer') print(NLPTokenizer.segment('江西鄱阳湖干枯,中国最大淡水湖变成大草原')) print("-" * 70) print("=" * 30 + " 自定义分词" + "=" * 30) CustomDictionary = JClass('com.hankcs.hanlp.dictionary.CustomDictionary') CustomDictionary.add('攻城狮') CustomDictionary.add('单身狗') HanLP = JClass('com.hankcs.hanlp.HanLP') print(HanLP.segment('攻城狮逆袭单身狗,迎娶白富美,走上人生巅峰')) print("-" * 70) print("=" * 20 + "命名实体识别与词性标注" + "=" * 30) NLPTokenizer = JClass('com.hankcs.hanlp.tokenizer.NLPTokenizer') print(NLPTokenizer.segment('中国科学院计算技术研究所的宗成庆教授正在教授自然语言处理课程')) print("-" * 70) document = "水利部水资源司司长陈明忠9月29日在国务院新闻办举行的新闻发布会上透露," \ "根据刚刚完成了水资源管理制度的考核,有部分省接近了红线的指标," \ "有部分省超过红线的指标。对一些超过红线的地方,陈明忠表示,对一些取用水项目进行区域的限批," \ "严格地进行水资源论证和取水许可的批准。" print("=" * 30 + "关键词提取" + "=" * 30) print(HanLP.extractKeyword(document, 8)) print("-" * 70) print("=" * 30 + "自动摘要" + "=" * 30) print(HanLP.extractSummary(document, 3)) print("-" * 70) # print("="*30+"地名识别"+"="*30) # HanLP = JClass('com.hankcs.hanlp.HanLP') # segment = HanLP.newSegment().enablePlaceRecognize(true) # testCase=["武胜县新学乡政府大楼门前锣鼓喧天", # "蓝翔给宁夏固原市彭阳县红河镇黑牛沟村捐赠了挖掘机"] # for sentence in testCase : # print(HanLP.segment(sentence)) # print("-"*70) # print("="*30+"依存句法分析"+"="*30) # print(HanLP.parseDependency("徐先生还具体帮助他确定了把画雄鹰、松鼠和麻雀作为主攻目标。")) # print("-"*70) text = r"算法工程师\n 算法(Algorithm)是一系列解决问题的清晰指令,也就是说,能够对一定规范的输入,在有限时间内获得所要求的输出。如果一个算法有缺陷,或不适合于某个问题,执行这个算法将不会解决这个问题。不同的算法可能用不同的时间、空间或效率来完成同样的任务。一个算法的优劣可以用空间复杂度与时间复杂度来衡量。算法工程师就是利用算法处理事物的人。\n \n 1职位简介\n 算法工程师是一个非常高端的职位;\n 专业要求:计算机、电子、通信、数学等相关专业;\n 学历要求:本科及其以上的学历,大多数是硕士学历及其以上;\n 语言要求:英语要求是熟练,基本上能阅读国外专业书刊;\n 必须掌握计算机相关知识,熟练使用仿真工具MATLAB等,必须会一门编程语言。\n\n2研究方向\n 视频算法工程师、图像处理算法工程师、音频算法工程师 通信基带算法工程师\n \n 3目前国内外状况\n 目前国内从事算法研究的工程师不少,但是高级算法工程师却很少,是一个非常紧缺的专业工程师。算法工程师根据研究领域来分主要有音频/视频算法处理、图像技术方面的二维信息算法处理和通信物理层、雷达信号处理、生物医学信号处理等领域的一维信息算法处理。\n 在计算机音视频和图形图像技术等二维信息算法处理方面目前比较先进的视频处理算法:机器视觉成为此类算法研究的核心;另外还有2D转3D算法(2D-to-3D conversion),去隔行算法(de-interlacing),运动估计运动补偿算法(Motion estimation/Motion Compensation),去噪算法(Noise Reduction),缩放算法(scaling),锐化处理算法(Sharpness),超分辨率算法(Super Resolution),手势识别(gesture recognition),人脸识别(face recognition)。\n 在通信物理层等一维信息领域目前常用的算法:无线领域的RRM、RTT,传送领域的调制解调、信道均衡、信号检测、网络优化、信号分解等。\n 另外数据挖掘、互联网搜索算法也成为当今的热门方向。\n" print("=" * 30 + "短语提取" + "=" * 30) print(HanLP.extractPhrase(text, 10)) print("-" * 70) shutdownJVM() 但是我最近需要自定义一个词典,该怎么办呢,继续往下看: 第一:以**.txt命名自己的词典 第二:将其加入到hanlp.propertiess中,我加入的是poems.txt,如下 第三:删除CustomDictionary.txt.bin文件,然后运行代码,记住要等程序运行完哦,我加入的词典有47万行,运行了14分钟,不过后面运行就快了 # -*- coding:utf-8 -*- from jpype import * import time i=time.time() startJVM(getDefaultJVMPath(), "-Djava.class.path=D:\python_projects\zhengzebiaodashi\hanlp\hanlp-1.3.4.jar;D:\python_projects\zhengzebiaodashi\hanlp", "-Xms1g", "-Xmx1g") # 启动JVM,Linux需替换分号;为冒号: HanLP = JClass('com.hankcs.hanlp.HanLP') CustomDictionary = JClass('com.hankcs.hanlp.dictionary.CustomDictionary') list=HanLP.parseDependency("李白的诗有哪些?") print list j=time.time() print j-i shutdownJVM() 李白 李白 b b _ 3 定中关系 _ _ 的 的 uude1_1右附加关系 _ _ 诗 诗 n n _ 4 主谓关系 _ _ 有 有 v vyou _ 0 核心关系 _ _ 哪些 哪些 r ry _ 4 动宾关系 _ _ ? ? wp w _ 4 标点符号 _ _ 2.16999983788 大家有没有发现,李白的词性是b,这是什么鬼,其实这是我自己词典中添加的:李白b 200(词 词性 权值) 如果大家觉得有些词典不需要,可以将其路径删除,如下: 本文转自ybf&yyj的博客

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册