首页 文章 精选 留言 我的

精选列表

搜索[Flowable流程审批],共10000篇文章
优秀的个人博客,低调大师

新服务器环境安装和项目部署流程

记录一下在服务器部署项目的过程,长期更新 涉及:Java、tomcat、nginx、mysql、ssl、域名、服务器 docker方式搭建服务器环境参考:使用docker快速搭建服务器环境 环境 阿里云ECS服务器、阿里云购买的域名、阿里云购买的ssl CentOS 6.9 64位 购买服务器 配置安全组 配置常用端口访问,比如22、8080、3306等 购买域名 购买域名为 xxxxx.com 购买后,在阿里云里可以购买免费的ssl证书(百度有教)。 解析xxx.xxxxx.com到服务器ip 备案。国内服务器需要备案,否则无法通过域名访问到你的网站。你也可以选择使用https方式暂时免去备案 服务器环境配置 远程登录服务器 Windows下远程管理服务器软件:WinSCP Windows下SSH登录服务器软件:Xshell Mac下远程管理服务器软件:ForkLift Mac下SSH登录服务器软件:autossh工具 下载Java安装包下载 注意,需要手动下载,因为oracle下载Java的时候有个同意协议的操作,如果用命令行方式安装Java,会出问题。所以直接手动下载,然后上传到服务器内即可。我安装的是server-jre-8u181-linux-x64.tar.gz 安装Java 我的解压路径 /usr/java/ 命令行操作 tar -zxvf jdk-8u161-linux-x64.tar.gz vi /etc/profile source /etc/profile vi编辑profile文件时,输入下面的文字(注意Java解压路径) #set java environment JAVA_HOME=/usr/java/jdk1.8.0_161 JRE_HOME=/usr/java/jdk1.8.0_161/jre CLASS_PATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib PATH=$PATH:$JAVA_HOME/bin:$JRE_HOME/bin export JAVA_HOME JRE_HOME CLASS_PATH PATH 下载Tomcat下载地址 和Java一样,手动下载,然后上传到服务器 安装Tomcat 把下载下来的压缩包解压到目录,我的解压路径 /usr/tomcat/ 命令行操作 tar zxvf apache-tomcat-9.0.6.tar.gz 设置Tomcat Host Manager 网页访问(可选) 进入 tomcat根目录/conf/tomcat-users.xml,进入以下代码添加用户 <role rolename="manager-gui"/> <role rolename="admin-gui"/> <user username="admin" password="admin123" roles="admin-gui,manager-gui"/> 这样admin这个用户就可以用网页登录Host Manager、Server Status和Manager App。如果不做此操作,日后要发布应用必须使用命令行。 设置tomcat开机自启动(推荐) 进入 /etc/rc.d/rc.local 加入以下配置,注意路径 export JAVA_HOME=/usr/java/jdk1.8.0_161 /usr/tomcat/apache-tomcat-9.0.6/bin/startup.sh start 然后设置rc.local为可执行文件,并重启服务器 chmod +x /etc/rc.d/rc.local shutdown -r now 重启完成后重新登录服务器,检查tomcat是否启动。如果什么都不返回,则tomcat服务未开启 lsof -i:8080 如果报错找不到命令,则yum方式安装 yum install lsof 使用Nginx 如果需要在服务器里多域名访问多个项目,如公司产品和公司官网。则可以使用nginx进行代理。注意前提是购买的域名已经解析到了服务器(将ip解析到xxx.xxxxx.com) 安装Nginx 建议使用编译方式安装,教程: CentOS6.9编译安装Nginx1.12更新: 以下内容留作备忘,不需要看 需要注意的是,安装pcre的时候,在解压了pcre包后,进行make等操作成功以后,要将pcre文件夹放/usr/src下,而后在编译nginx时,需要这样: ./configure --with-pcre=/usr/src/pcre目录 make make install 否则可能会报错找不到pcre 配置nginxnginx服务器安装及配置文件详解Nginx配置端口转发 映射 以及连接超时问题Linux(CentOS)下设置nginx开机自动启动和chkconfig管理 配置举例(配置了https 访问 Tomcat访问页): 有几点要注意 如果你要所有项目都使用https,则需要将他们配置在443端口的ssl配置节点。 nginx访问静态资源可能会报错Permission Denied,此时应该讲nginx用户改为root,如代码里第一行 关于域名ssl证书的设置,阿里云里有教 阿里云可以配置免费ssl,但是只能配置单域名ssl user root; # 用户为root worker_processes 1; error_log logs/error.log; #error_log logs/error.log notice; #error_log logs/error.log info; pid logs/nginx.pid; events { worker_connections 2048; } http { include mime.types; default_type application/octet-stream; #log_format main '$remote_addr - $remote_user [$time_local] "$request" ' # '$status $body_bytes_sent "$http_referer" ' # '"$http_user_agent" "$http_x_forwarded_for"'; access_log logs/access.log ; sendfile on; #tcp_nopush on; #keepalive_timeout 0; keepalive_timeout 65; #gzip on; # HTTPS server 证书 server { listen 443; server_name xxx.xxxxx.com; # 阿里云里配置的域名,此域名已经申请了ssl证书 ssl on; root html; index index.html index.htm; ssl_certificate cert/212312312321367.pem; #阿里云里下载的证书文件 ssl_certificate_key cert/2149412231235300167.key;#阿里云里下载的证书文件 ssl_session_timeout 5m; ssl_ciphers ECDHE-RSA-AES128-GCM-SHA256:ECDHE:ECDH:AES:HIGH:!NULL:!aNULL:!MD5:!ADH:!RC4; ssl_protocols TLSv1 TLSv1.1 TLSv1.2; ssl_prefer_server_ciphers on; # 访问 https://xxx.xxxxx.com/tomcat 可直接访问tomcat管理页面 location /tomcat { proxy_pass http://127.0.0.1:8080/manager/html; proxy_redirect off; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; } # 配置tomcat管理页的静态资源,不配置的话,访问tomcat管理页时图片等资源无法加载 # 这里我将webapp/ROOT下的管理页静态资源复制到了 /usr/local/nginx/html/下 location ~* \.(gif|jpg|jpeg|css|js|png)$ { root /usr/local/nginx/html/; } } } 此时访问 https://xxx.xxxxx.com/manager就可以访问Tomcat管理页 安装Mysql 检查系统是否安装其他版本的MYSQL数据 yum list installed | grep mysql yum -y remove mysql-libs.x86_64 安装MYSQL数据库 更新:简便安装方法:centos6.9安装mysql 准备工作 wget http://repo.mysql.com/mysql-community-release-el6-5.noarch.rpm rpm -ivh mysql-community-release-el6-5.noarch.rpm yum repolist all | grep mysql yum install mysql-community-server -y 设置为开机启动 chkconfig --list | grep mysqld chkconfig mysqld on 设置密码 /usr/bin/mysqladmin -u root password 123456 设置远程访问(可选) root登录数据库,输入 # 注意填写root的密码 GRANT ALL PRIVILEGES ON *.* TO 'root'@'%' IDENTIFIED BY 'youpassword' WITH GRANT OPTION; # 重载授权表 FLUSH PRIVILEGES; 如果设置后依旧无法访问,则检查服务器是否开启3306端口,或检查/etc/my.cnf里是否有bind-address=127.0.0.1,有则注释掉

优秀的个人博客,低调大师

XGboost数据比赛实战之调参篇(完整流程)

这一篇博客的内容是在上一篇博客Scikit中的特征选择,XGboost进行回归预测,模型优化的实战的基础上进行调参优化的,所以在阅读本篇博客之前,请先移步看一下上一篇文章。 我前面所做的工作基本都是关于特征选择的,这里我想写的是关于XGBoost参数调整的一些小经验。之前我在网站上也看到很多相关的内容,基本是翻译自一篇英文的博客,更坑的是很多文章步骤讲的不完整,新人看了很容易一头雾水。由于本人也是一个新手,在这过程中也踩了很多大坑,希望这篇博客能够帮助到大家!下面,就进入正题吧。 首先,很幸运的是,Scikit-learn中提供了一个函数可以帮助我们更好地进行调参: sklearn.model_selection.GridSearchCV 常用参数解读: estimator:所使用的分类器,如果比赛中使用的是XGBoost的话,就是生成的model。比如: model = xgb.XGBRegressor(**other_params) param_grid:值为字典或者列表,即需要最优化的参数的取值。比如:cv_params = {'n_estimators': [550, 575, 600, 650, 675]} scoring :准确度评价标准,默认None,这时需要使用score函数;或者如scoring='roc_auc',根据所选模型不同,评价准则不同。字符串(函数名),或是可调用对象,需要其函数签名形如:scorer(estimator, X, y);如果是None,则使用estimator的误差估计函数。scoring参数选择如下: 具体参考地址:http://scikit-learn.org/stable/modules/model_evaluation.html 这次实战我使用的是r2这个得分函数,当然大家也可以根据自己的实际需要来选择。 调参刚开始的时候,一般要先初始化一些值: learning_rate: 0.1 n_estimators: 500 max_depth: 5 min_child_weight: 1 subsample: 0.8 colsample_bytree:0.8 gamma: 0 reg_alpha: 0 reg_lambda: 1 链接:XGBoost常用参数一览表 你可以按照自己的实际情况来设置初始值,上面的也只是一些经验之谈吧。 调参的时候一般按照以下顺序来进行: 1、最佳迭代次数:n_estimators if __name__ == '__main__': trainFilePath = 'dataset/soccer/train.csv' testFilePath = 'dataset/soccer/test.csv' data = pd.read_csv(trainFilePath) X_train, y_train = featureSet(data) X_test = loadTestData(testFilePath) cv_params = {'n_estimators': [400, 500, 600, 700, 800]} other_params = {'learning_rate': 0.1, 'n_estimators': 500, 'max_depth': 5, 'min_child_weight': 1, 'seed': 0, 'subsample': 0.8, 'colsample_bytree': 0.8, 'gamma': 0, 'reg_alpha': 0, 'reg_lambda': 1} model = xgb.XGBRegressor(**other_params) optimized_GBM = GridSearchCV(estimator=model, param_grid=cv_params, scoring='r2', cv=5, verbose=1, n_jobs=4) optimized_GBM.fit(X_train, y_train) evalute_result = optimized_GBM.grid_scores_ print('每轮迭代运行结果:{0}'.format(evalute_result)) print('参数的最佳取值:{0}'.format(optimized_GBM.best_params_)) print('最佳模型得分:{0}'.format(optimized_GBM.best_score_)) 写到这里,需要提醒大家,在代码中有一处很关键: model = xgb.XGBRegressor(**other_params)中两个*号千万不能省略!可能很多人不注意,再加上网上很多教程估计是从别人那里直接拷贝,没有运行结果,所以直接就用了 model = xgb.XGBRegressor(other_params)。悲剧的是,如果直接这样运行的话,会报如下错误: xgboost.core.XGBoostError: b"Invalid Parameter format for max_depth expect int but value... 不信,请看链接:xgboost issue 以上是血的教训啊,自己不运行一遍代码,永远不知道会出现什么Bug! 运行后的结果为: [Parallel(n_jobs=4)]: Done 25 out of 25 | elapsed: 1.5min finished 每轮迭代运行结果:[mean: 0.94051, std: 0.01244, params: {'n_estimators': 400}, mean: 0.94057, std: 0.01244, params: {'n_estimators': 500}, mean: 0.94061, std: 0.01230, params: {'n_estimators': 600}, mean: 0.94060, std: 0.01223, params: {'n_estimators': 700}, mean: 0.94058, std: 0.01231, params: {'n_estimators': 800}] 参数的最佳取值:{'n_estimators': 600} 最佳模型得分:0.9406056804545407 由输出结果可知最佳迭代次数为600次。但是,我们还不能认为这是最终的结果,由于设置的间隔太大,所以,我又测试了一组参数,这次粒度小一些: cv_params = {'n_estimators': [550, 575, 600, 650, 675]} other_params = {'learning_rate': 0.1, 'n_estimators': 600, 'max_depth': 5, 'min_child_weight': 1, 'seed': 0, 'subsample': 0.8, 'colsample_bytree': 0.8, 'gamma': 0, 'reg_alpha': 0, 'reg_lambda': 1} 运行后的结果为: [Parallel(n_jobs=4)]: Done 25 out of 25 | elapsed: 1.5min finished 每轮迭代运行结果:[mean: 0.94065, std: 0.01237, params: {'n_estimators': 550}, mean: 0.94064, std: 0.01234, params: {'n_estimators': 575}, mean: 0.94061, std: 0.01230, params: {'n_estimators': 600}, mean: 0.94060, std: 0.01226, params: {'n_estimators': 650}, mean: 0.94060, std: 0.01224, params: {'n_estimators': 675}] 参数的最佳取值:{'n_estimators': 550} 最佳模型得分:0.9406545392685364 果不其然,最佳迭代次数变成了550。有人可能会问,那还要不要继续缩小粒度测试下去呢?这个我觉得可以看个人情况,如果你想要更高的精度,当然是粒度越小,结果越准确,大家可以自己慢慢去调试,我在这里就不一一去做了。 2、接下来要调试的参数是min_child_weight以及max_depth: 注意:每次调完一个参数,要把 other_params对应的参数更新为最优值。 cv_params = {'max_depth': [3, 4, 5, 6, 7, 8, 9, 10], 'min_child_weight': [1, 2, 3, 4, 5, 6]} other_params = {'learning_rate': 0.1, 'n_estimators': 550, 'max_depth': 5, 'min_child_weight': 1, 'seed': 0, 'subsample': 0.8, 'colsample_bytree': 0.8, 'gamma': 0, 'reg_alpha': 0, 'reg_lambda': 1} 运行后的结果为: [Parallel(n_jobs=4)]: Done 42 tasks | elapsed: 1.7min [Parallel(n_jobs=4)]: Done 192 tasks | elapsed: 12.3min [Parallel(n_jobs=4)]: Done 240 out of 240 | elapsed: 17.2min finished 每轮迭代运行结果:[mean: 0.93967, std: 0.01334, params: {'min_child_weight': 1, 'max_depth': 3}, mean: 0.93826, std: 0.01202, params: {'min_child_weight': 2, 'max_depth': 3}, mean: 0.93739, std: 0.01265, params: {'min_child_weight': 3, 'max_depth': 3}, mean: 0.93827, std: 0.01285, params: {'min_child_weight': 4, 'max_depth': 3}, mean: 0.93680, std: 0.01219, params: {'min_child_weight': 5, 'max_depth': 3}, mean: 0.93640, std: 0.01231, params: {'min_child_weight': 6, 'max_depth': 3}, mean: 0.94277, std: 0.01395, params: {'min_child_weight': 1, 'max_depth': 4}, mean: 0.94261, std: 0.01173, params: {'min_child_weight': 2, 'max_depth': 4}, mean: 0.94276, std: 0.01329...] 参数的最佳取值:{'min_child_weight': 5, 'max_depth': 4} 最佳模型得分:0.94369522247392 由输出结果可知参数的最佳取值:{'min_child_weight': 5, 'max_depth': 4}。(代码输出结果被我省略了一部分,因为结果太长了,以下也是如此) 3、接着我们就开始调试参数:gamma: cv_params = {'gamma': [0.1, 0.2, 0.3, 0.4, 0.5, 0.6]} other_params = {'learning_rate': 0.1, 'n_estimators': 550, 'max_depth': 4, 'min_child_weight': 5, 'seed': 0, 'subsample': 0.8, 'colsample_bytree': 0.8, 'gamma': 0, 'reg_alpha': 0, 'reg_lambda': 1} 运行后的结果为: [Parallel(n_jobs=4)]: Done 30 out of 30 | elapsed: 1.5min finished 每轮迭代运行结果:[mean: 0.94370, std: 0.01010, params: {'gamma': 0.1}, mean: 0.94370, std: 0.01010, params: {'gamma': 0.2}, mean: 0.94370, std: 0.01010, params: {'gamma': 0.3}, mean: 0.94370, std: 0.01010, params: {'gamma': 0.4}, mean: 0.94370, std: 0.01010, params: {'gamma': 0.5}, mean: 0.94370, std: 0.01010, params: {'gamma': 0.6}] 参数的最佳取值:{'gamma': 0.1} 最佳模型得分:0.94369522247392 由输出结果可知参数的最佳取值:{'gamma': 0.1}。 4、接着是subsample以及colsample_bytree: cv_params = {'subsample': [0.6, 0.7, 0.8, 0.9], 'colsample_bytree': [0.6, 0.7, 0.8, 0.9]} other_params = {'learning_rate': 0.1, 'n_estimators': 550, 'max_depth': 4, 'min_child_weight': 5, 'seed': 0, 'subsample': 0.8, 'colsample_bytree': 0.8, 'gamma': 0.1, 'reg_alpha': 0, 'reg_lambda': 1} 运行后的结果显示参数的最佳取值:{'subsample': 0.7,'colsample_bytree': 0.7} 5、紧接着就是:reg_alpha以及reg_lambda: cv_params = {'reg_alpha': [0.05, 0.1, 1, 2, 3], 'reg_lambda': [0.05, 0.1, 1, 2, 3]} other_params = {'learning_rate': 0.1, 'n_estimators': 550, 'max_depth': 4, 'min_child_weight': 5, 'seed': 0, 'subsample': 0.7, 'colsample_bytree': 0.7, 'gamma': 0.1, 'reg_alpha': 0, 'reg_lambda': 1} 运行后的结果为: [Parallel(n_jobs=4)]: Done 42 tasks | elapsed: 2.0min [Parallel(n_jobs=4)]: Done 125 out of 125 | elapsed: 5.6min finished 每轮迭代运行结果:[mean: 0.94169, std: 0.00997, params: {'reg_alpha': 0.01, 'reg_lambda': 0.01}, mean: 0.94112, std: 0.01086, params: {'reg_alpha': 0.01, 'reg_lambda': 0.05}, mean: 0.94153, std: 0.01093, params: {'reg_alpha': 0.01, 'reg_lambda': 0.1}, mean: 0.94400, std: 0.01090, params: {'reg_alpha': 0.01, 'reg_lambda': 1}, mean: 0.93820, std: 0.01177, params: {'reg_alpha': 0.01, 'reg_lambda': 100}, mean: 0.94194, std: 0.00936, params: {'reg_alpha': 0.05, 'reg_lambda': 0.01}, mean: 0.94136, std: 0.01122, params: {'reg_alpha': 0.05, 'reg_lambda': 0.05}, mean: 0.94164, std: 0.01120...] 参数的最佳取值:{'reg_alpha': 1, 'reg_lambda': 1} 最佳模型得分:0.9441561344357595 由输出结果可知参数的最佳取值:{'reg_alpha': 1, 'reg_lambda': 1}。 6、最后就是learning_rate,一般这时候要调小学习率来测试: cv_params = {'learning_rate': [0.01, 0.05, 0.07, 0.1, 0.2]} other_params = {'learning_rate': 0.1, 'n_estimators': 550, 'max_depth': 4, 'min_child_weight': 5, 'seed': 0, 'subsample': 0.7, 'colsample_bytree': 0.7, 'gamma': 0.1, 'reg_alpha': 1, 'reg_lambda': 1} 运行后的结果为: [Parallel(n_jobs=4)]: Done 25 out of 25 | elapsed: 1.1min finished 每轮迭代运行结果:[mean: 0.93675, std: 0.01080, params: {'learning_rate': 0.01}, mean: 0.94229, std: 0.01138, params: {'learning_rate': 0.05}, mean: 0.94110, std: 0.01066, params: {'learning_rate': 0.07}, mean: 0.94416, std: 0.01037, params: {'learning_rate': 0.1}, mean: 0.93985, std: 0.01109, params: {'learning_rate': 0.2}] 参数的最佳取值:{'learning_rate': 0.1} 最佳模型得分:0.9441561344357595 由输出结果可知参数的最佳取值:{'learning_rate': 0.1}。 我们可以很清楚地看到,随着参数的调优,最佳模型得分是不断提高的,这也从另一方面验证了调优确实是起到了一定的作用。不过,我们也可以注意到,其实最佳分数并没有提升太多。提醒一点,这个分数是根据前面设置的得分函数算出来的,即: optimized_GBM = GridSearchCV(estimator=model, param_grid=cv_params, scoring='r2', cv=5, verbose=1, n_jobs=4) 中的scoring='r2'。在实际情境中,我们可能需要利用各种不同的得分函数来评判模型的好坏。 最后,我们把得到的最佳参数组合扔到模型里训练,就可以得到预测的结果了: def trainandTest(X_train, y_train, X_test): # XGBoost训练过程,下面的参数就是刚才调试出来的最佳参数组合 model = xgb.XGBRegressor(learning_rate=0.1, n_estimators=550, max_depth=4, min_child_weight=5, seed=0, subsample=0.7, colsample_bytree=0.7, gamma=0.1, reg_alpha=1, reg_lambda=1) model.fit(X_train, y_train) # 对测试集进行预测 ans = model.predict(X_test) ans_len = len(ans) id_list = np.arange(10441, 17441) data_arr = [] for row in range(0, ans_len): data_arr.append([int(id_list[row]), ans[row]]) np_data = np.array(data_arr) # 写入文件 pd_data = pd.DataFrame(np_data, columns=['id', 'y']) # print(pd_data) pd_data.to_csv('submit.csv', index=None) # 显示重要特征 # plot_importance(model) # plt.show() 好了,调参的过程到这里就基本结束了。正如我在上面提到的一样,其实调参对于模型准确率的提高有一定的帮助,但这是有限的。最重要的还是要通过数据清洗,特征选择,特征融合,模型融合等手段来进行改进! 完整代码可到我的GitHub上进行下载。(声明一点,我的代码质量不是很好,大家参考一下思路就行) 更多干货,欢迎去听我的GitChat:

优秀的个人博客,低调大师

谢烟客---------Linux之DNS请求流程及资源记录定义

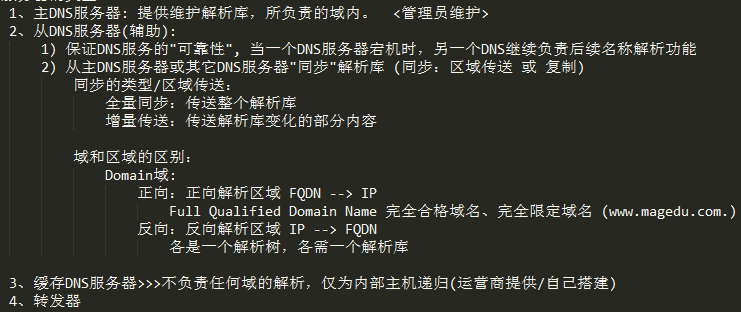
DNS类型/同步类型/域和区域的区别 SOA内部数据特性 DNS负载均衡(Load balance)的实现 缓存DNS服务器 缓存定义、作用、多级缓存 一次完整的解析请求 解析答案 DNS分布式特点 区域解析库/RR/RR_TYPE A记录的轮循、多主机名对同一个主机、泛域名解析 <<反反复复,多次权衡的结果 >> DNS类型、同步类型、区域和域的区别 SOA内部数据特性 DNS负载均衡(Load balance)的实现 缓存DNS服务器 缓存定义、作用、多级缓存 一次完整的解析请求 本地主机发起递归,运营商缓存DNS迭代 本地主机发起递归,本地缓存DNS迭代 解析答案 DNS分布式特点 区域解析库:由众多RR组成 RR: 资源记录类型Resource Record详细记录所有主机名和IP对应的关系 RR_TYPE: RR格式: name [TTL] IN RR_TYPE vlaue 1)TTL: 解析结果的缓存时长,单位是"s" 秒 2)@ at可以引用区域名 3)相邻多个资源记录,name相同时,可以省略name 4)每个NS,MX记录对应一个A记录 SOA, NS, MX, A, PTR, CNAME SOA记录 1 2 3 4 5 6 7 8 例如: @ 86400 INSOA@linux.magedu.com.( 20170916 ;serial 10M;refresh 5M;retry 1W;expire 1D;TTL ) NS 记录 MX记录 A记录 PTR记录 CNAME记录 本文转自 lccnx 51CTO博客,原文链接:http://blog.51cto.com/sonlich/1965799,如需转载请自行联系原作者

优秀的个人博客,低调大师

iOS:使用集成的支付宝SDK的支付流程

基本步骤: 1.先与支付宝签约,获得商户的ID(partner)和账号ID(seller),这一部分主要是又公司负责; 2.下载相应的公钥私钥文件,用来给签名进行加密; 3.下载支付宝集成的SDK,网址:https://club.alipay.com/ 里面提供了非常详细的文档、如何签名、如何获取公钥私钥、如何调用支付接口等; 4.生成订单信息; 5.调用支付宝客户端,由支付宝客户端跟支付宝安全服务器打交道; 6.支付宝支付完成后,返回支付结果给商户客户端和服务器。 SDK里有集成支付功能的一个Demo: 要想支付接口可以参考以下文件夹的库文件(把这三个添加到呢的客户端中) 演示实例: 调用支付接口可以参考AlixPayDemoViewController的下面方法 -(void)tableView:(UITableView *)tableView didSelectRowAtIndexPath:(NSIndexPath *)indexPath 如何创建订单 ( 订单根据自己公司看是什么样的) 如何签名 如何调用支付接口 都在这个方法里面了 1 // 2 //选中商品调用支付宝快捷支付 3 // 4 - (void)tableView:(UITableView *)tableView didSelectRowAtIndexPath:(NSIndexPath *)indexPath 5 { 6 /* 7 *点击获取prodcut实例并初始化订单信息 8 */ 9 Product *product = [_products objectAtIndex:indexPath.row]; 10 11 /* 12 *商户的唯一的parnter和seller。 13 *本demo将parnter和seller信息存于(AlixPayDemo-Info.plist)中,外部商户可以考虑存于服务端或本地其他地方。 14 *签约后,支付宝会为每个商户分配一个唯一的 parnter 和 seller。 15 */ 16 //如果partner和seller数据存于其他位置,请改写下面两行代码 17 NSString *partner = [[NSBundle mainBundle] objectForInfoDictionaryKey:@"Partner"]; 18 NSString *seller = [[NSBundle mainBundle] objectForInfoDictionaryKey:@"Seller"]; 19 20 //partner和seller获取失败,提示 21 if ([partner length] == 0 || [seller length] == 0) 22 { 23 UIAlertView *alert = [[UIAlertView alloc] initWithTitle:@"提示" 24 message:@"缺少partner或者seller。" 25 delegate:self 26 cancelButtonTitle:@"确定" 27 otherButtonTitles:nil]; 28 [alert show]; 29 [alert release]; 30 return; 31 } 32 33 /* 34 *生成订单信息及签名 35 *由于demo的局限性,本demo中的公私钥存放在AlixPayDemo-Info.plist中,外部商户可以存放在服务端或本地其他地方。 36 */ 37 //将商品信息赋予AlixPayOrder的成员变量 38 AlixPayOrder *order = [[AlixPayOrder alloc] init]; 39 order.partner = partner; 40 order.seller = seller; 41 order.tradeNO = [self generateTradeNO]; //订单ID(由商家自行制定) 42 order.productName = product.subject; //商品标题 43 order.productDescription = product.body; //商品描述 44 order.amount = [NSString stringWithFormat:@"%.2f",product.price]; //商品价格 45 order.notifyURL = @"http://www.xxx.com"; //回调URL 46 47 //应用注册scheme,在AlixPayDemo-Info.plist定义URL types,用于快捷支付成功后重新唤起商户应用 48 NSString *appScheme = @"AlixPayDemo"; 49 50 //将商品信息拼接成字符串 51 NSString *orderSpec = [order description]; 52 NSLog(@"orderSpec = %@",orderSpec); 53 54 //获取私钥并将商户信息签名,外部商户可以根据情况存放私钥和签名,只需要遵循RSA签名规范,并将签名字符串base64编码和UrlEncode 55 id<DataSigner> signer = CreateRSADataSigner([[NSBundle mainBundle] objectForInfoDictionaryKey:@"RSA private key"]); 56 NSString *signedString = [signer signString:orderSpec]; 57 58 //将签名成功字符串格式化为订单字符串,请严格按照该格式 59 NSString *orderString = nil; 60 if (signedString != nil) { 61 orderString = [NSString stringWithFormat:@"%@&sign=\"%@\"&sign_type=\"%@\"", 62 orderSpec, signedString, @"RSA"]; 63 64 //获取快捷支付单例并调用快捷支付接口 65 AlixPay * alixpay = [AlixPay shared]; 66 int ret = [alixpay pay:orderString applicationScheme:appScheme]; 67 68 if (ret == kSPErrorAlipayClientNotInstalled) { 69 UIAlertView * alertView = [[UIAlertView alloc] initWithTitle:@"提示" 70 message:@"您还没有安装支付宝快捷支付,请先安装。" 71 delegate:self 72 cancelButtonTitle:@"确定" 73 otherButtonTitles:nil]; 74 [alertView setTag:123]; 75 [alertView show]; 76 [alertView release]; 77 } 78 else if (ret == kSPErrorSignError) { 79 NSLog(@"签名错误!"); 80 } 81 82 } 83 84 [tableView deselectRowAtIndexPath:indexPath animated:YES]; 85 } 只要集成的关键就是下面这几步: //.封装订单模型 AlixPayOrder *order = [[AlixPayOrder alloc] init]; // 生成订单描述 NSString *orderSpec = [order description]; //2.签名 id<DataSigner> signer = CreateRSADataSigner(@“私钥key”); // 传入订单描述 进行 签名 NSString *signedString = [signer signString:orderSpec]; //3.生成订单字符串 NSString *orderString = [NSString stringWithFormat:@"%@&sign=\"%@\"&sign_type=\"%@\"", orderSpec, signedString, @"RSA"]; //4.调用支付接口 AlixPay * alixpay = [AlixPay shared]; // appScheme:商户自己的协议头 int ret = [alixpay pay:orderString applicationScheme:appScheme]; 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 本文转自当天真遇到现实博客园博客,原文链接:http://www.cnblogs.com/XYQ-208910/p/5024104.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

无人审批刷脸办照 广州上线全程电子化商事登记系统;法国巴黎银行推出人工智能系统用于加强交易处理

日前,天津市科委表示,按照国家部署决策,天津市正式启动实施“人工智能科技重大专项”,借助中国新一代人工智能发展战略研究院年内在天津建成的契机,谋划建设国内首个具有中国特色“大智能”创新体系,让智能生活早日惠及百姓生活。 据了解,“大智能”创新体系,涵盖智能制造、智能交通、智能家居、智慧金融、智能医疗等多个领域。天津市出台的人工智能重大专项重点围绕“523”工作任务开展实施,即推动智能传感、脑机协同、生物特征识别、语义音视频分析识别、智能网联车5项细分领域关键共性技术创新,开展智能制造、智能网联车2个应用示范,强化战略研究、超级计算、创新服务3大服务支撑平台建设。 天津市科委负责人表示,天津产业结构调整已经为现代产业新体系建设打下了良好的基础。天津将抓住科技创新促进产业转型这一有利时机,从顶层设计入手,完善人工智能领域的科研和产业布局,

优秀的个人博客,低调大师

中小企业的内容生产,正在从手艺变成流程

对企业营销部门来说,内容的需求量已经换了一个量级。公众号、短视频脚本、产品详情页、行业问答,各平台的更新节奏叠加起来,过去支撑一个渠道的工作量被放大到数倍。供给侧的配置却很少同步调整:一到两个人的内容小组,一名熟练编辑一周可稳定产出三五篇稿件,是我们在大量中小企业里见过的典型结构。需求翻倍的投入、几乎不变的产能,这个缺口只能靠更换生产方式来填平。AI Agent 进入企业视野,对应的正是这个缺口。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册