首页 文章 精选 留言 我的

精选列表

搜索[Flowable流程审批],共10000篇文章
优秀的个人博客,低调大师

Logstash 7.5.2 发布,开源服务端数据处理流程

Logstash 是开源的服务器端数据处理管道,能够同时从多个来源采集数据,转换数据,然后将数据发送到你最喜欢的“存储库”中。目前,Logstash 7.5.2已正式发布,该版本更新内容如下: Logstash 7.5.1 发行说明 修复:Java Execution -通过将类缓存从 ComputeStepSyntaxElement 移到 CompiledPipeline,提高 Logstash 启动时间 #11490 修复:Java Execution -通过仅在所有 WorkerLoops 都完全初始化后才启动,避免在过滤器和输出编译未完成时启动输入#11492 修复:通过使 get_thread_id 为“nil safe”来避免nil本机线程出现问题#11458 更新 JrJackson 和Jackson依赖项#11478 Pluginsedit Beats Input 更新了 Netty 依赖性,并删除了对不安全的 CBC 密码的支持 #376 更新了 Jackson 依赖 #375 File Input 修复: exclude 处理中的回归。 模式与文件名而不是完整路径匹配。#237 发布说明 下载地址

优秀的个人博客,低调大师

Logstash 7.5.1 发布,开源服务端数据处理流程

Logstash 是开源的服务器端数据处理管道,能够同时从多个来源采集数据,转换数据,然后将数据发送到你最喜欢的“存储库”中。目前,Logstash 7.5.1已正式发布,该版本更新内容如下: Logstash 7.5.1 发行说明 通过包含相关 DLQ 的路径来提高报告完整 DLQ 时日志消息的实用性#11280 修复:消除了管道引用通过脱机插件包安装的基于Java的插件时管道启动时可能发生的崩溃#11340 修复:常见的 remove_field 插件选项现在可以在@metadata字段上正常工作#11342 修复:不要将 ThreadContext 泄漏到系统中#11356 修复:消除了 7.2.0 中引入的回归#11401 修复:使用空的 kibana 零件处理cloud-id#11435 patch release的 bump依赖#11438 Plugins Dns Filter 添加了有关 nameserver 选项的文档,该文档依赖于 /etc/resolv.conf 来配置解析器 Elasticsearch Filter 放松对 Elasticsearch gem 的限制#120 Grok Filter 在多匹配方案中改进了 grok 过滤器性能。#153 Jdbc_static Filter 解决了使用 Java 11 进行驱动程序验证的问题#51 ...... 更多详细信息可查看发行说明 下载地址:https://www.elastic.co/cn/downloads/logstash

优秀的个人博客,低调大师

Logstash 7.5.0 发布,开源服务端数据处理流程

Logstash 是开源的服务器端数据处理管道,能够同时从多个来源采集数据,转换数据,然后将数据发送到你最喜欢的“存储库”中。目前,Logstash 7.5.0已正式发布,该版本更新内容如下: Logstash 7.5.0发行说明 为多个管道提供所有设置#11076 在 Pipelines.yml 文件中支持替换#11081 每个管道提供日志附加程序#11108 在 OpenSSL 套接字规范中使用 2048 位密钥#11115 添加管道配置的来源#11123 从 log4j2.properties中删除 10k 字符截断#11206 如果 Java 运行时小于 11,则从系统属性中删除#11225修复#11221 [DOC] 将 metricbeat 添加为监视选项#11190 Plugins Kafka Integration Kafka 集成插件的初始版本(将以前分开的 Kafka 插件和共享的依赖项组合到单个代码库中) Rabbitmq Integration RabbitMQ 集成插件的初始版本(将以前分开的 RabbitMQ 插件和共享的依赖项组合到单个代码库中) Elasticsearch Output 修复了文档中的措辞和更正的选项#881#883 弃用:添加了有关将 Logstash 的默认发行版与 OSS 版本的 ES 连接的警告#875 添加了用于连接到 ES 8.x 的模板#871 添加了对 ES 8.x 的 sniffing 支持#878 详细信息:https://www.elastic.co/guide/en/logstash/7.5/logstash-7-5-0.html 下载地址:https://www.elastic.co/cn/downloads/logstash

优秀的个人博客,低调大师

阿里巴巴小程序繁星计划活动补贴申领流程

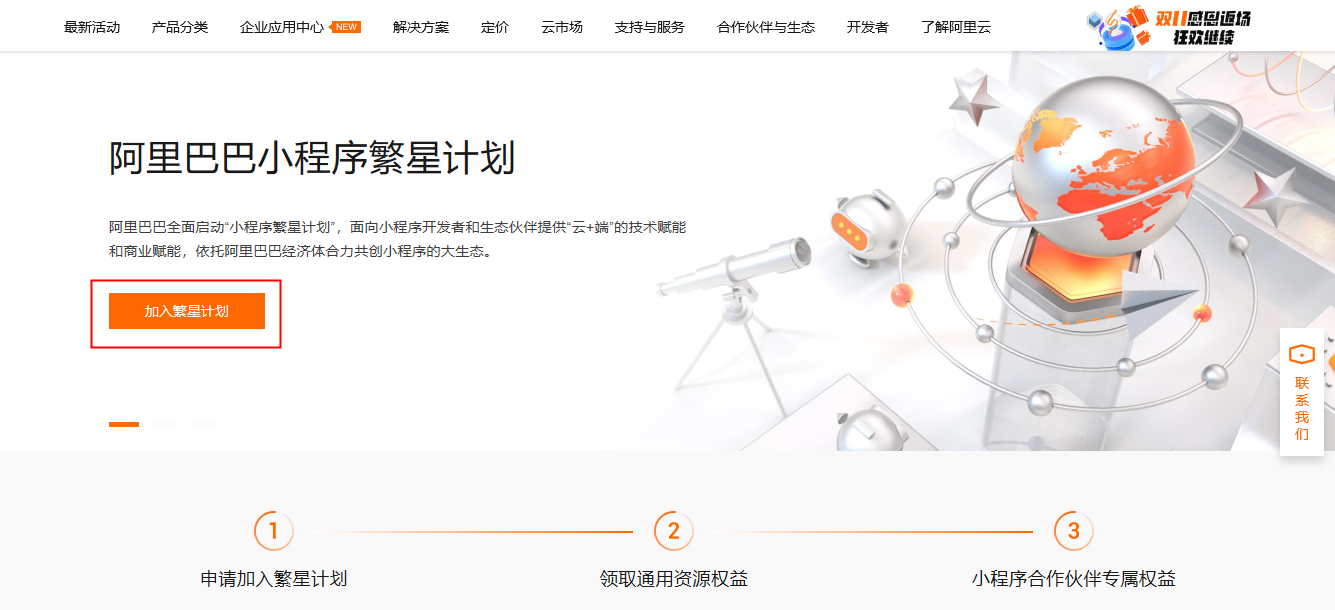
阿里巴巴小程序繁星计划补贴活动正式开启,使用阿里云开发支付宝小程序,新增小程序首月活>=100,即可获得100元阿里云无门槛代金券。想要入驻阿里巴巴小程序繁星计划的合作伙伴,具体操作步骤如下: 步骤一:申请阿里巴巴小程序繁星计划合作伙伴 1). 打开阿里巴巴小程序繁星计划活动页,申请加入繁星计划。 2). 在用户类型中选择小程序合作伙伴。 3). 完成申请人信息的填写,并点击提交。 步骤二:入驻支付宝服务市场 1). 打开支付宝开放平台,选择立即入驻。 2). 选择扫码登陆或者账密登录。 3).完成入驻身份的填写,并点击提交入驻申请。 步骤三:入驻完成后,合作伙伴通过支付宝服务市场发布小程序应用即可享受扶持领取代金券。建议使用小程序serverless,现在是免费的哦~ 温馨提示:获得的代金券将在1月发放到阿里云账户中。 想要了解更多活动详细说明

优秀的个人博客,低调大师

Flink1.9 Create table 语句转换 为 Operation流程分析

本文主要描述 Flink1.9 新提供的 create table sql 通过 Calcite 解析,校验 并注册到catalog的过程。样例SQL: CREATE TABLE user_log ( user_id VARCHAR, item_id VARCHAR, category_id VARCHAR, behavior VARCHAR, ts TIMESTAMP ) WITH ( 'connector.type' = 'kafka', -- 使用 kafka connector 'connector.version' = 'universal', -- kafka 版本,universal 支持 0.11 以上的版本 'connector.topic' = 'xc_user_behavior', -- kafka topic 'connector.startup-mode' = 'earliest-offset', -- 从起始 offset 开始读取 'connector.properties.0.key' = 'zookeeper.connect', -- 连接信息 'connector.properties.0.value' = '172.16.8.107:2181', 'connector.properties.1.key' = 'bootstrap.servers', 'connector.properties.1.value' = '172.16.8.107:9092', 'update-mode' = 'append', 'format.type' = 'json', -- 数据源格式为 json 'format.derive-schema' = 'true' -- 从 DDL schema 确定 json 解析规则 ) 带着两个疑问:1:如何自定义create table 语法(之后会另外写一篇), 2:create table 的表信息是如何注册到catalog上的,供之后的select 语句查询; 一:StreamTableEnvironment.create() 关注:Planner 的初始化 实例化一个CatalogManager(元数据管理器) --初始化一个GenericInMemroyCatalog作为默认的Catalog 实例化StreamPlanner(本文以流作为背景,所以实例化目标为StreamPlanner) 初始化StreamPlanner继承的超类PlannerContext 可以看到提供了统一生成Calcite FrameworkConfig的函数createFrameworkConfig,关注其中对defaultSchema的设置,(之前实例的CatalogManager的包装类CatalogManagerCalciteSchema作为默认的Schema),另外ParserFactory参数也需要关注下,FlinkSqlParserImpl.FACTORY 这个是flink 基于Calcite 扩展的支持DDL的解析类; 初始化查询优化器: RelOptPlanner planner = new VolcanoPlanner(frameworkConfig.getCostFactory(), frameworkConfig.getContext());//基于cost的优化器 到这一步Planner环境初始化相关的操作已经完成。 二:解析Create table Sql语句:StreamTableEnvironment.sqlUpdate(createSqlStr) StreamTableEnvironment 调用 之前初始化环境过程中创建的 StreamPlanner 解析create table 语句 生成 CreateTableOperation; 其中生成Operation 的部分主体是: 生成Planner PlannerContext基于统一提供的createFrameworkConfig() 生成FlinkPlannerImpl。 FlinkPlannerImpl 解析 DDL语句 生成SqlNode(如何根据Calcite自定义Table create 这个会后会另外单独写一篇)。 调用validate() 对create table 信息进行校验, 包括table 的column, primaryKeys,uniqueKeys,partitionKey设置是否正确,这个校验不包括对create table 语法的校验,create 语法的校验在parse阶段已经处理过; org.apache.flink.table.planner.operations.SqlToOperationConverter#convert:将SqlNode转换为org.apache.flink.table.operations.ddl.CreateTableOperation,当然convert()方法包含对Query, Create, Drop, Insert 的处理,本文只关注convertCreateTable模块; 调用TableEnvironmentImpl#registerCatalogTableInternal 把生成的CreateTableOperation注册到CatalogManager 上, 注册的元数据信息之后可以被sql 查询引用; 调用GenericInMemoryCatalog#createTable 将表的信息添加到catalog 元数据上;

优秀的个人博客,低调大师

【Kubernetes系列】第8篇 CI/CD之全流程实践

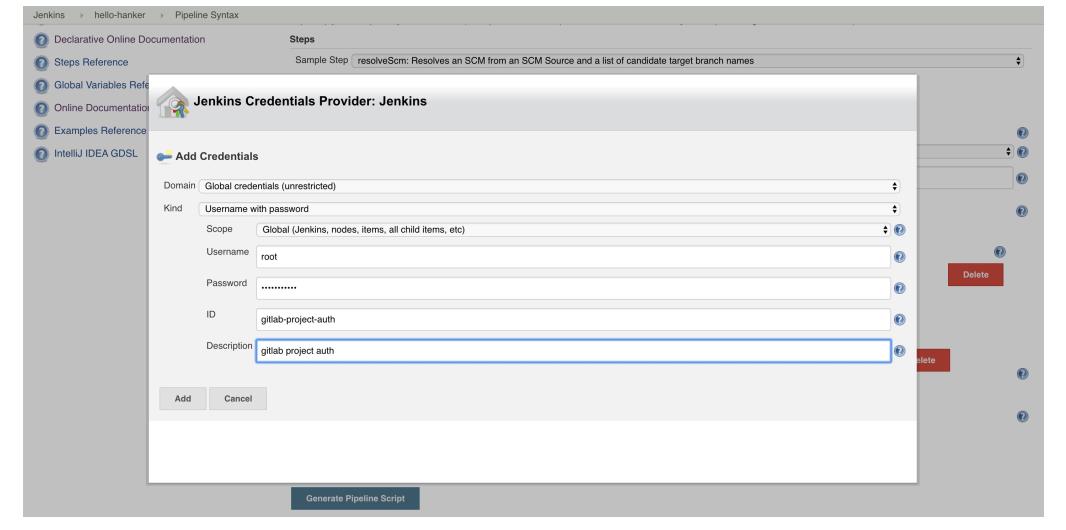
前言 本实践中已经的示例代码及jenkins-agent镜像已经推送归档至github,-->传送门 注意本实践中均为内网数据,你测试时一定要改为自己的环境的有效数据。 由于本实践涉及组件较多,若有操作不明确的话,你可以后台留言,我们一起完善。 具体操作时若有不清楚,或是错误可以留言,大家一起解决。 1. 准备基础数据 配置gitlab 创建项目 上传示例代码 _注_: 本次示例使用的gitlab项目地址为:http://gitlab.hanker.com/colynn/hanker-hello.git 配置harbor 创建项目, 用于存储构建的镜像 _注_: 本次示例使用的harbor地址为 10.0.0.185:5000/hanker/hanker-hello:v1 jenkins 验证信息 添加 gitlab 帐号信息 _操作指引_:【Credentials】-> 【System】-> 【Global credentials】-> 【Add Credentials】 harbor 信息 _操作指引_:【Credentials】-> 【System】-> 【Global credentials】-> 【Add Credentials】 k8s namespace验证信息 在你的k8s master节点上执行如下操作: 1.创建serviceaccount $ kubectl -n devops create serviceaccount jenkins-robot 命令输出: serviceaccount/jenkins-robot created 2.角色绑定 $ kubectl -n devops create rolebinding jenkins-robot-binding --clusterrole=cluster-admin --serviceaccount=devops:jenkins-robot 命令输出: rolebinding.rbac.authorization.k8s.io/jenkins-robot-binding created 3.获取 ServiceAccount $ kubectl -n devops get serviceaccount jenkins-robot -o go-template --template='{{range .secrets}}{{.name}}{{"\n"}}{{end}}' jenkins-robot-token-n8w6b 4.基于base64解码 ServiceToken $ kubectl -n devops get secrets jenkins-robot-token-n8w6b -o go-template --template '{{index .data "token"}}' | base64 --decode 命令输出: eyJhbGciOiJSUzI1NiIsImtpZCI6IiJ9.eyJpc3MiOiJrdWJlcm5ldGVzL3NlcnZpY2VhY2NvdW50Iiwia3ViZXJuZXRlcy5pby9zZXJ2aWNlYWNjb3VudC9uYW1lc3BhY2UiOiJkZXZvcHMiLCJrdWJlcm5ldGVzLmlvL3NlcnZpY2VhY2NvdW50L3NlY3JldC5uYW1lIjoiamVua2lucy1yb2JvdC10b2tlbi1uOHc2YiIsImt1YmVybmV0ZXMuaW8vc2VydmljZWFjY291bnQvc2VydmljZS1hY2NvdW50Lm5hbWUiOiJqZW5raW5zLXJvYm90Iiwia3ViZXJuZXRlcy5pby9zZXJ2aWNlYWNjb3VudC9zZXJ2aWNlLWFjY291bnQudWlkIjoiOTcyZTY0OGYtMTYxZC00NmM5LWI0ZjgtYjFkNTdlOWY4NTBjIiwic3ViIjoic3lzdGVtOnNlcnZpY2VhY2NvdW50OmRldm9wczpqZW5raW5zLXJvYm90In0.ArQvcaEqCaeU1ZcJ6nOC5rLaTZr_vLDrpLCt87asltMUWj2gSli_mXUTrl09hBnBDXI3A1D4rJXHKLHjIAA4nN8qRIRGbpqSNzDwmqJr-jmmmWWZFrZ3n3Al9-13KJnNOK8pcWr70rt3Rsigt4B6CIQ0-ZLK8BZhvROJSifeOfJ6xe2KBqdXBv1ccZZZfEhPLgGbaR5yWm5jLvOMr2MQiPDrZoHOEkcMt-C0xipytOp4sJCJ4bQhb-UoMu1owYydxbd6O7xO71fvqP_bMDpZXC601nA2ggK7h-vi6CJffHv5MM59q8X_DWe1NnZS6KXiMmkXqAmBn10Yu20PNj-kjg 5.添加 Secret text验证信息 _操作指引_:【首页】->【Credentials】-> 【System】-> 【Global credentials】-> 【Add Credentials】-> 选择【Secret text】类型 然后将上一步 解码的结果 更新至 Secret, Pipeline 中 2. 如何创建 jenkins pipeline 1. 创建jenkins pipeline item _操作指引_:【首页】->【New Item】 2. pipeline script 步骤说明 _注_: pipeline主要包含三个阶段(检出代码、制作镜像、部署服务),下面跟大家解释下,如何编写pipeline, 借助Pipeline Syntax生成的只是部分代码,你可以根据语言规范将其完善。 1.阶段1,检出代码 _操作指引_:【首页】->【hanker-hello-demo】-> 【Pipeline Syntax】 _注_: 本实践中选取的 git: Git 类型,当然你也可以选择 checkout: Check out from version control 获取到该步骤的脚本 git credentialsId: 'gitlab-project-auth', url: 'http://gitlab.hanker.com/colynn/hanker-hello.git' 2.阶段2,构建镜像 _操作指引_:类似于 阶段1, 完善获取该步骤脚本 script { withDockerRegistry(credentialsId: 'harbor-auth', url: 'http://10.0.0.185:5000') { def customImage = docker.build("10.0.0.185:5000/devops/hanker-hello:v1") customImage.push() } } _注_: 支持本阶段需要jenkins-agent镜像里包含docker命令。 3.阶段3. 部署服务 _参考_: jenkins kubernetes cli plugin _注_: 支持本阶段需要jenkins-agent镜像里包含kubectl命令。 3. 设置 pipeline _注_: General/ Build Triggers/ Advanced Project Options 这三块你可以根据自己需要设置,将各阶段的脚本合并,更新至 Pipline -> Script内。 合并后的pipeline脚本内容如下: pipeline { agent any stages { stage('checkout') { steps { git credentialsId: 'gitlab-project-auth', url: 'http://gitlab.hanker.com/colynn/hanker-hello.git' } } stage('docker-publish') { steps{ script { withDockerRegistry(credentialsId: 'harbor-auth', url: 'http://10.0.0.185:5000') { def customImage = docker.build("10.0.0.185:5000/devops/hanker-hello:v1") customImage.push() } } } } stage('application-deploy') { steps { withKubeConfig([credentialsId: '5a5517f3-3d38-459d-bafc-12b55beeb588', serverUrl: 'https://10.0.0.182:6443']) { sh '/usr/bin/kubectl apply -f k8s-setup.yml' } } } } } 3. 触发构建 4. 结果确认 1.确认 jenkina-agent 启动状态; $ kubectl -n devops get pods |grep jnlp jnlp-sh8zl 1/1 Running 0 14s // 查看jenkins-agent pod日志 $ kubectl -n devops logs -f [jenkins-agent-pod-name] _注_: 如果长时间没有启动jenkins-agent, 可以确认下集群内是否有足够的资源。 2.确认pipeline 执行状态; 3.确认harbor镜像仓库里是否已经有新推送的镜像 _注_: harbor里的项目是需要你先创建好的,不然推送时会报错。 4.确认部署的服务状态 k8s master节点上执行如下操作: $ kubectl -n devops get pod,deployment,svc,ingress |grep hanker-hello pod/hanker-hello-5b7586f86d-5j7kk 1/1 Running 0 173m deployment.extensions/hanker-hello 1/1 1 1 3h8m service/hanker-hello-svc ClusterIP 10.233.22.19 <none> 8080/TCP 3h8m ingress.extensions/hanker-hello-ingress hanker-hello-demo.dev.hanker.net 80 3h8m 附录 自定义jenkins-agent镜像 ## 基于 https://github.com/Kubernetes-Best-Pratice/jenkins-jnlp-agent.git $ git checkout https://github.com/Kubernetes-Best-Pratice/jenkins-jnlp-agent.git $ cd jenkins-jnlp-agent $ docker build . $ docker tag tag-name custom-private-repository-addr _注_: 你也可以基于基础镜像创建自定义的镜像 可以做的更完善 配置webhook, 自动触发jenkins job; 当前我们实践时构建的镜像版本使用的是固定的, 你是否可以将其替换为依赖pipeline环境变量或是传参的形式,将其变是更有意义; 上一篇文章中在设置【配置Kubernetes Pod Template】时,我们提到可以挂载主机或是网络共享存储,你是否可以通过这个将你的构建快起来; 我们的示例代码使用的go, 直接是镜像内打包,如何更好的就好的其他语言的构建,你可以参考Using Docker with Pipeline; 你想过如何下载构建过程中的产物吗,等等。 参考链接 : https://github.com/jenkinsci/kubernetes-cli-plugin/blob/master/README.md 下载kubectl: https://docs.docker.com/ee/ucp/user-access/kubectl/

优秀的个人博客,低调大师

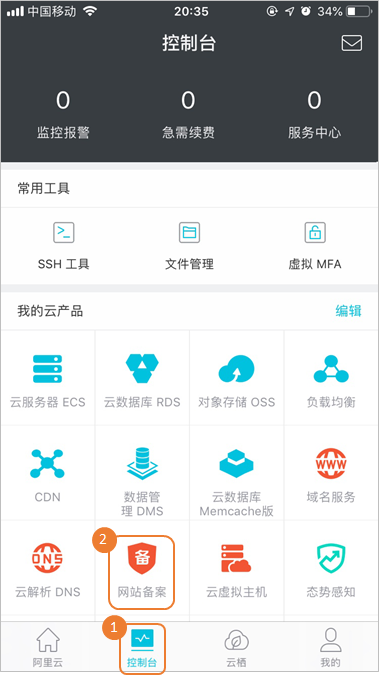
阿里云服务器怎么用APP备案操作流程

阿里云APP端申请备案是现在比较流行的备案方法,方便快捷,适合新手使用。 阿里云2000券免费领取(阿里云券的作用:购买阿里云产品,最后支付结算的时候,阿里云券可抵扣一部分费用。 要注意的是,目前支持首次备案和新增网站(原备案不在阿里云)两种备案场景。暂时不支持新增网站(原备案在阿里云)、接入备案、变更备案等其他备案场景,其他的备案场景都可在PC端操作。 使用阿里云APP端申请备案时,备案申请操作步骤如下: 1、登录阿里云APP,进入APP备案操作入口。 如果在APP端备案时,系统提示前往PC端进行操作,那么你当前的场景就只能在PC端操作了。 2、填写信息及备案接入产品验证备案类型 填写主办单位信息和网站等信息,根据备案类型上传主办单位的证件材料,并进行真实性核验。 3、选择买好的服务器,进行产品验证。 阿里云2000券免费领取(阿里云券的作用:购买阿里云产品,最后支付结算的时候,阿里云券可抵扣一部分费用。 说明:如果无法选择服务器实例,可能是因为无可用备案服务号,建议更换有可用备案服务号的服务器。更多可能无法选择实例的可能原因及 系统会根据填写信息自动判定要办理的备案类型。 4、填写主体信息和网站信息 填写网站信息以及办理备案的个人或者单位的真实信息。上传主体负责人和网站负责人的证件,并进行网站负责人的真实性核验。 5、上传资料 上传证件照片或证件彩色扫描件。 6、信息核验 在提交备案申请订单前,请您在此步骤中仔细确认您的主体、网站、接入等备案信息是否正确,确认无误后提交备案订单。 说明:如果使用PC端进行备案申请,在移动端完成资料上传和真实性核验后,您可在移动端继续信息核验。如果您的登录账号无法登录阿里云APP,就要去PC端继续操作信息核验。 7、备案初审 提交备案申请后,阿里云备案审核专员会对备案信息初步审核。 8、管局审核初审完成后,阿里云备案审核专员会将备案申请转交至对应管局处做最终的管局审核。管局审核通过后您的备案即已完成,审核结果会发送至短信、邮箱。 9、不管阿里审核,还是管局审核期间,在工作时间内都要保持手机有人接听状态,老魏就是因为审核专员多次打电话无人接听,延误了备案时间。 阿里云2000券免费领取(阿里云券的作用:购买阿里云产品,最后支付结算的时候,阿里云券可抵扣一部分费用。

优秀的个人博客,低调大师

6张图说清楚Tomcat原理及请求流程

前言 很多东西在时序图中体现的已经非常清楚了,没有必要再一步一步的作介绍,本文以图为主,然后对部分内容加以简单解释。绘制图形使用的工具是 PlantUML + Visual Studio Code + PlantUML Extension 本文对 Tomcat 的介绍以 Tomcat-9.0.0.M22 为标准。Tomcat-9.0.0.M22 是 Tomcat 目前最新的版本,但尚未发布,它实现了 Servlet4.0 及 JSP2.3 并提供了很多新特性,需要 1.8 及以上的 JDK 支持等等,详情请查阅 Tomcat-9.0-docOverviewConnector Init and StartRequtst ProcessAcceptorPollerWorkerContainerAt last Overview Connector 启动以后会启动一组线程用于不同阶段的请求处理过程。Acceptor 线程组。用于接受新连接,并将新连接封装一下,选择一个 Poller 将新连接添加到 Poller 的事件队列中。Poller 线程组。用于监听 Socket 事件,当 Socket 可读或可写等等时,将 Socket 封装一下添加到 worker 线程池的任务队列中。worker 线程组。用于对请求进行处理,包括分析请求报文并创建 Request 对象,调用容器的 pipeline 进行处理。Acceptor、 Poller、 worker 所在的 ThreadPoolExecutor 都维护在 NioEndpoint 中。 Connector Init and Start initServerSocket(),通过 ServerSocketChannel.open() 打开一个 ServerSocket,默认绑定到 8080 端口,默认的连接等待队列长度是 100, 当超过 100 个时会拒绝服务。我们可以通过配置 conf/server.xml 中 Connector 的 acceptCount 属性对其进行定制。createExecutor() 用于创建 Worker 线程池。默认会启动 10 个 Worker 线程,Tomcat 处理请求过程中,Woker 最多不超过 200 个。我们可以通过配置 conf/server.xml 中 Connector 的 minSpareThreads 和 maxThreads 对这两个属性进行定制。Pollor 用于检测已就绪的 Socket。 默认最多不超过 2 个, Math.min(2,Runtime.getRuntime().availableProcessors());。我们可以通过配置 pollerThreadCount 来定制。Acceptor 用于接受新连接。默认是 1 个。我们可以通过配置 acceptorThreadCount 对其进行定制。欢迎大家关注我的公种浩【程序员追风】,文章都会在里面更新,整理的资料也会放在里面。 Requtst Process Acceptor Acceptor 在启动后会阻塞在 ServerSocketChannel.accept(); 方法处,当有新连接到达时,该方法返回一个 SocketChannel。配置完 Socket 以后将 Socket 封装到 NioChannel 中,并注册到 Poller, 值的一提的是,我们一开始就启动了多个 Poller 线程,注册的时候,连接是公平的分配到每个 Poller 的。 NioEndpoint 维护了一个 Poller 数组,当一个连接分配给 pollers[index] 时,下一个连接就会分配给 pollers[(index+1)%pollers.length].addEvent() 方法会将 Socket 添加到该 Poller 的 PollerEvent 队列中。到此 Acceptor 的任务就完成了。 Poller selector.select(1000)。当 Poller 启动后因为 selector 中并没有已注册的 Channel,所以当执行到该方法时只能阻塞。所有的 Poller 共用一个 Selector,其实现类是 sun.nio.ch.EPollSelectorImplevents() 方法会将通过 addEvent() 方法添加到事件队列中的 Socket 注册到 EPollSelectorImpl,当 Socket 可读时, Poller 才对其进行处理createSocketProcessor() 方法将 Socket 封装到 SocketProcessor 中, SocketProcessor 实现了 Runnable 接口。 worker 线程通过调用其 run() 方法来对 Socket 进行处理。execute(SocketProcessor) 方法将 SocketProcessor 提交到线程池,放入线程池的 workQueue 中。 workQueue 是 BlockingQueue 的实例。到此 Poller 的任务就完成了。 Worker worker 线程被创建以后就执行 ThreadPoolExecutor 的 runWorker() 方法,试图从 workQueue 中取待处理任务,但是一开始 workQueue 是空的,所以 worker 线程会阻塞在 workQueue.take() 方法。当新任务添加到 workQueue后, workQueue.take() 方法会返回一个 Runnable,通常是 SocketProcessor, 然后 worker 线程调用 SocketProcessor 的 run() 方法对 Socket 进行处理。createProcessor() 会创建一个 Http11Processor, 它用来解析 Socket,将 Socket 中的内容封装到 Request 中。注意这个 Request 是临时使用的一个类,它的全类名是 org.apache.coyote.Request,postParseRequest() 方法封装一下 Request,并处理一下映射关系 (从 URL 映射到相应的 Host、 Context、 Wrapper)。CoyoteAdapter 将 Rquest 提交给 Container 处理之前,并将 org.apache.coyote.Request 封装到 org.apache.catalina.connector.Request,传递给 Container 处理的 Request 是 org.apache.catalina.connector.Request。connector.getService().getMapper().map(),用来在 Mapper 中查询 URL 的映射关系。映射关系会保留到 org.apache.catalina.connector.Request 中, Container 处理阶段 request.getHost() 是使用的就是这个阶段查询到的映射主机,以此类推 request.getContext()、 request.getWrapper() 都是。connector.getService().getContainer().getPipeline().getFirst().invoke() 会将请求传递到 Container 处理,当然了 Container 处理也是在 Worker 线程中执行的,但是这是一个相对独立的模块,所以单独分出来一节。 Container 需要注意的是,基本上每一个容器的 StandardPipeline 上都会有多个已注册的 Valve,我们只关注每个容器的 Basic Valve。其他 Valve 都是在 Basic Valve 前执行。request.getHost().getPipeline().getFirst().invoke() 先获取对应的 StandardHost,并执行其 pipeline。request.getContext().getPipeline().getFirst().invoke() 先获取对应的 StandardContext, 并执行其 pipeline。request.getWrapper().getPipeline().getFirst().invoke() 先获取对应的 StandardWrapper,并执行其 pipeline。最值得说的就是 StandardWrapper 的 Basic Valve, StandardWrapperValveallocate() 用来加载并初始化 Servlet,值的一提的是 Servlet 并不都是单例的,当 Servlet 实现了 SingleThreadModel 接口后, StandardWrapper 会维护一组 Servlet 实例,这是享元模式。当然了 SingleThreadModel 在 Servlet 2.4 以后就弃用了。createFilterChain() 方法会从 StandardContext 中获取到所有的过滤器,然后将匹配 Request URL 的所有过滤器挑选出来添加到 filterChain 中。doFilter() 执行过滤链, 当所有的过滤器都执行完毕后调用 Servlet 的 service() 方法。 Reference 《How Tomcat works》《Tomcat 架构解析》-- 刘光瑞Tomcat-9.0-docapache-tomcat-9.0.0.M22-srctomcat 架构分析 (connector NIO 实现) 最后欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

Python全栈 Web(JavaScript 运算符、流程控制)

运算符: 赋值运算符:= 算术运算符:+ - * / % 自增自减:++ -- 自增自减在单独使用时放前放后没区别 如果参与其他运算时分前缀和后缀 ++ 在后 先使用后自增 ++ 在前 先自增后使用 关系运算符 >、 >=、 <、 <=、 ==、 != ===全等/恒等 !==不全等/不恒等 关系运算符的结果都为boolean类型 数字与字符串进行比较: 实现自动转换数据类型在比较 如果转换成功 按照数字比较 失败会变成NaN与数字比较 永远都是false 字符串之间的比较: 每个字符分别按照Unicode编码比较大小 如果当前字符相同进行后移 不相同直接出结果 == != 先进行数据转换后进行比较 只进行值得比较 === !== 直接进行数据比较 进行数据转换 同时判断数据类型和值是否完全相等 逻辑运算符: !非 对现有条件进行取反 非真

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册