首页 文章 精选 留言 我的

精选列表

搜索[CEL策略],共10000篇文章
优秀的个人博客,低调大师

点击链接跳转时信息已被获取,火狐浏览器决定更新隐私策略

当你在电脑网页上浏览信息时,轻轻点击鼠标,发送一个访问请求,这时你的信息就已经被对方获取。 因为当你单击链接从一个页面跳转到另一个页面时,对第二个页面的请求包含一个HTTP header,它就是referrer(引用)。 “引用”里包含很多用户隐私信息。“它记录了用户在引用网站上阅读了哪些文章,甚至包括用户在网站上的账户信息。”Mozilla安全团队的Dimi Lee和Christoph Kerschbaumer表示。 为了更好地保护用户隐私,Mozilla 3月22日宣布,将在下一个web浏览器Firefox 87版本中,引入更加注重隐私保护的默认引用政策(default Referrer Policy)。 更新后,浏览器将自动过滤用户敏感信息,例如引用网址中的访问路径和查询字符串信息。 而引用网址中包含的信息很容易被攻击者利用。只要筛查内部网络服务器日志,你会发现引用网址中包含大量敏感信息,包括但不限于政府和企业内部的主机信息。 如果攻击者欺骗目标访问服务器上的网站,那攻击者就可以从网络服务器的访问日志或分析软件中获取内部名称等敏感信息。 FireFox 87版本中更新的默认引用政策 “新的默认引用政策不仅会过滤从HTTPS到HTTP的请求信息,而且还会过滤所有跨源请求的路径和查询信息,”Dimi Lee和Christoph Kerschbaumer补充。 “Firefox将对所有导航请求、重定向请求和子资源请求(图像、样式、脚本)应用新的默认引用政策,提供更私密的浏览体验。” 在保护隐私方面,Fiefox还做了很多尝试。上一版本Firefox 86中加入了全插件保护政策(Total Cookie Protection),把每个网站的Cookie保存在一个单独的“Cookie jar”中,防止网络追踪者掌握用户的网络活动。 从85版本开始,Firefox增加了超级插件保护功能,通过隔离每个访问网站的缓存和网络连接,阻止追踪者跨网站追踪用户。 【责任编辑:赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

在MaxCompute中配置Policy策略遇到结果不一致的问题

通过policy配置权限过程中遇到的一些问题 背景信息: 本文以如下场景为基准进行编写,如下: 用户通过DataWorks-简单模式使用MaxCompute; 用户具有DataWorks默认角色,如DataWorks开发者角色; 用户通过console提交policy配置精细化权限管控, 本案例以禁止某一些用户群体(role)可以删除以tb_开头的表为例来展开讨论。 解决方案: 通过policy进行deny某个role禁止删除以tb_开头的表,同时将属于这一部分的user都添加到该角色中。具体如下: create roledenydroprole; put policyt_policy.json on role`denydroprole;` grant `denydroprole to RAM$..;` t_policy.json配置文件如下: {

优秀的个人博客,低调大师

Hystrix 服务的隔离策略对比,信号量与线程池隔离的差异

hytrix支持线程池隔离和信号量隔离 信号量隔离适应非网络请求,因为是同步的请求,无法支持超时,只能依靠协议本身 线程池隔离,即,每个实例都增加个线程池进行隔离 先给个总结对比: 隔离方式 是否支持超时 是否支持熔断 隔离原理 是否是异步调用 资源消耗 线程池隔离 支持,可直接返回 支持,当线程池到达maxSize后,再请求会触发fallback接口进行熔断 每个服务单独用线程池 可以是异步,也可以是同步。看调用的方法 大,大量线程的上下文切换,容易造成机器负载高 信号量隔离 不支持,如果阻塞,只能通过调用协议(如:socket超时才能返回) 支持,当信号量达到maxConcurrentRequests后。再请求会触发fallback 通过信号量的计数器 同步调用,不支持异步 小,只是个计数器 看官网的定义引用理解 信号量的隔离: it executes on the calling thread and concurrent requests are limited by the semaphore count - 引自官网 自我理解: 每次调用线程,当前请求通过计数信号量进行限制,当信号大于了最大请求数(maxConcurrentRequests)时,进行限制,调用fallback接口快速返回。 最重要的是,信号量的调用是同步的,也就是说,每次调用都得阻塞调用方的线程,直到结果返回。这样就导致了无法对访问做超时(只能依靠调用协议超时,无法主动释放) 官网对信号量隔离的描述建议 Generally the only time you should use semaphore isolation forHystrixCommands is when the call is so high volume (hundreds per second, per instance) that the overhead of separate threads is too high; this typically only applies to non-network calls. 理解下两点: 隔离的细粒度太高,数百个实例需要隔离,此时用线程池做隔离开销过大 通常这种都是非网络调用的情况下 线程池隔离: it executes on a separate thread and concurrent requests are limited by the number of threads in the thread-pool 通过每次都开启一个单独线程运行。它的隔离是通过线程池,即每个隔离粒度都是个线程池,互相不干扰 Commands executed in threads have an extra layer of protection against latencies beyond what network timeouts can offer. 线程池隔离方式,等于多了一层的保护措施,可以通过hytrix直接设置超时,超时后直接返回。 分享个以前的一个误解 以前对zuul网关的一个误解,以为网关用的是线程池隔离是属于异步调用的,以为只要用了线程池隔离,不需要去考虑本身具体的线程池大小了。 具体看源码: 调用的是hytrix command的excute方法,hytrix的官网原文说明如下: execute()— blocks, then returns the single response received from the dependency (or throws an exception in case of an error) execute是一个阻塞方法,也就是说,如果不合理的设置线程池的大小,和超时时间,还是有可能把zuul的线程消耗完。从而失去对服务的保护作用 公众号: 何锦彬 2018.09.21

优秀的个人博客,低调大师

吴恩达《深度学习》第三门课(2)机器学习策略二

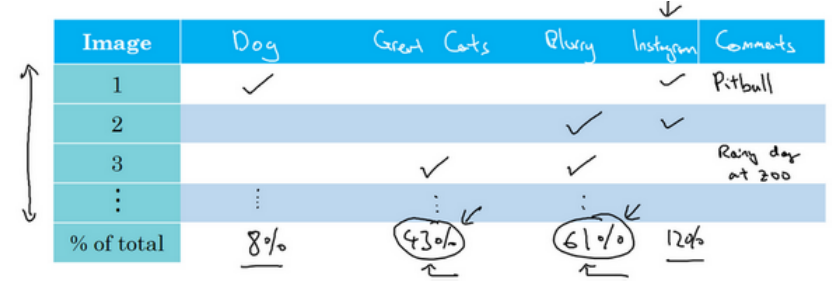
2.1进行误差分析 (1)一识别猫为案例,错误率为10%,这时系统还可以有较大提升空间,这时该往哪方面努力呢?可以通过误差分析,具体可以拿出100个分类错误的样本,然后利用表格统计每个样本分类错误的原因(如下图所示),比如很模糊,狗和猫很像,有滤镜等,一个样本出错可以同时有多个原因,统计看因为什么原因导致分类错误的比例最高,那么就应该着重花功夫在那上面。 (2)根据上面的统计也可以预估出如果完美解决该问题可以带来多大性能的提升,比如100张样本中有5张图把狗误认为了猫,所以即使解决了狗识别成猫的问题,最终能带来的性能提升是从90%到90.5%。 2.2清楚标记错误的数据 (1)深度学习对于训练集样本(注意此处只讲了是训练集)样本随机标注错误其实表现出很强的健壮性,一般没有必要去修正训练集样本的错误标注(一来没必要,而来训练集可能非常之大耗时耗力)。 (2)对于验证集而言,务必将验证集的操作运用到测试集上,保证二者的同分布。 (3)同样在误差分析的表格中添加一列作为样本标记错误导致的,看看他的占比,比如说修正能提升0.6%,那么如果现在误差是10%的话,显然其他原因可提升性能空间更大,应优先考虑,但是当误差只有2%时,这时就不得不考虑到样本标记错误了,因为它已经成为主要原因了。 (4)在验证集、测试集上看分类错误的样本上的样本标记错误的同时,也应该看判断正确的样本里是否有标记错误,那也是需要修正的,否则如果只修正算法出错的样本,你对算法的偏差故居可能会变大。 2.3快速搭建你的第一个系统,并进行迭代 (1)针对一个你第一次处理的新问题:总之一句话就是尽快确定验证集、测试集和单一指标,即有了目标,然后迅速建立起一个系统,即使很粗糙也没有关系。有了这个系统之后就可以用它做偏差方差分析,做误差分析,进而知道下一步该往哪方面优化了。 (2)如果你已经很有经验了,又或者你面对的问题有非常多的学术文献可以借鉴,比如人脸识别设备,那么可以在大量文献的基础之上,一开始就构建比较复杂的系统。 2.4在不同的划分上进行训练并测试 (1)猫分类案例:20万张照片是网络爬取的高清照,10000张是用户上传的模糊的低像素的照片,以下是两种划分方法: 1.将200 000和10 000张合并在一起,然后205000作为训练集,2500作为开发集,2500作为测试集,这样虽然三者同分布,但是优化的目标(开发集)中其实非常多的都是来自网络的照片,不是真实场景中的,所以最终应用的效果并不会很好。不赞同这种方式。 2.将5000张用户照片放入到200 000张照片中组成训练集,然后2500张来自用户的作为开发集,2500张来自用户的作为开发集,这样的划分效果会更加。 (2)语音激活汽车后视镜案例:500 000段语音以及20 000段与后视镜语音激活相关的语音,分类方法类似上面的第二种,将10 000段与后视镜语音激活相关的放入500 000段中组成训练集,5000段与后视镜语音激活相关的做开发集,剩下5000段作为测试集,这样效果为佳。 2.5不匹配数据划分的偏差与方差 (1)当训练集和开发集/测试集不同分布时会出现数据不匹配,这时开发集误差减去训练集误差得到的不一定是方差了,所以提出在训练集中拿出一部分数据,组成训练-开发集,训练-开发集与训练集同分布,这样训练-开发集的误差减去训练集的误差就是系统方差了。 (2)如下图所示:训练集误差减去人类水平误差得到偏差,训练--开发集误差减去训练集误差得到的是方差,开发集/测试集误差减去训练-开发集误差得到的是数据不匹配带来的误差。 (3)有时会发现开发集/测试集误差比训练-开发集还要小,原因是因为训练时使用了非常难的样本,而在实际中很少出现这么难的样本。 (4)很遗憾的是关于数据不匹配造成的误差并没有什么很系统的方法来解决。 2.6定位数据不匹配 (1)如果发现存在数据不匹配问题,建议做错误分析,或者看看开发集和训练集,试图找出这两个数据集分布到底有什么不同,然后看看有没有办法手机更多看起来像开发集的数据作训练。 (2)案例1:后视镜语音激活。发现在开发集中有很多汽车噪声,而训练集中没有,这就是造成分布不同的一大原因,解决办法就是录很多汽车噪声的声音,然后与安静的训练集进行合成形成更像开发集的训练集。这里需要注意一点是录噪声的时间多应该尽可能的多,比如1000个小时,而不是用相同的1个小时噪声取合成,这样人听起来没什么区别,但是神经网络可能已经对那一小时噪声过拟合了。下图是语音的合成: (3)汽车目标检测同样如此,在用计算机视觉合成汽车图像作为数据集时,应该合成尽可能多的种类的汽车,而不是就一二十汽车,虽然他们都很逼真,如下图所示: 2.7迁移学习 (1)迁移学习最常用的场景:如果尝试优化任务B的性能,通常这个任务的数据相对较少,例如,在放射科很难收集足够多的X射线扫描图片,所以这种情况下,你可能找一个相关但不同的业务,如图像识别,其中你可能有一百万张图片训练过了,并从中学到很多低层次特征,所以那也许能帮助网络在任务B在放射科任务上做的更好,尽管任务B没有那么多数据。注意也有不起作用的时候,那就是任务A实际上数据量比任务B要少,这种情况下增益可能不多。 (2)迁移学习方法:一般去掉别人网络的最后一层,然后重新按照需求添加最后一层或者几层,这一层或者几层从新赋初值,前面的权重利用别人已经训练好的权重(较做预训练pre-training),然后根据新数据来训练添加的网络的权重(叫做微调fine tuning),如果数据量多的话,可以训练整个网络权重,少的话就训练后天添加的。如下图示意: 2.8多任务学习 (1)一个网络中学习多个任务,如下图中:是否有人、是否有车、是否有交通灯、是否有停车牌,这就是一个多任务,一个样本中可以有多个标签,这也是与softmax区别的地方,softmax一个样本中只有一个标签。 (2)多样本是Y的输出如下: 神经网络结构如下: 损失函数如下: (3)把多个任务放在一个网络中比分成多个网络独立完成一个任务表现出了更好的性能,这就是多任务学习的力量。 (4)以上面的例子为例,有时候不一定每个样本都有四个完整的标签,可以有一个,可能三个,标签如下所示,问号表示没有,这时候忽略问号掉即可,只对有标签的进行求和。 (5)当满足下面情况时,多任务学习才有意义: 1.如果你训练的一组任务,可以共用低层次特征。 2.如果每个任务的数据量接近时(这个不一定绝对)。 3.神经网络足够的大,神经网络不够大时可能出现单独训练效果更好。 (6)迁移学习目前使用频率高于多任务学习,图像目标检测算是多任务学习中一个典型的例子了。 2.9什么是端到端的深度学习 (1)端到端学习简而言之就是以前有一些数据处理系统或学习系统,它需要多个阶段的处理,那么端到端深度学习就是忽略所有这些不同的阶段,用单个神经网络代替。如语音识别为例,输入是音频,输出就是文本,不需要这个中间人工操作。 (2)只有数据非常足的时候端到端深度学习的厉害之处才能表现出来。 (3)案例1两步走实现人脸识别门禁:第一步是检测图像中人脸的位置裁剪出来,然后进行人脸识别。这样每一步多比较简单,都有相对应足够多的数据。如果直接从图像到人的判断其数据量不足,难度非常大。 (4)案例2:从小孩的手的X射线图中判断小孩的年龄也是两步骤:第一是分割出图像中的手指,然后测量手指长度再根据手指长度与年龄关系的表判断小孩的年龄。这种更容易实现,如果直接从图像到年龄难度大,数据少。 (5)其他像语音识别,翻译等都可以通过端到端学习。 2.10是否要使用端到端的深度学习 (1)归根到底还是看数据量,如果够的话可以使用端到端,不够的化采用多步方式。 (2)端到端的好处:用数据说话,避免了引入人的成见;所需的手工设计的组件更少,所以也简化了你的设计工作流程。 (3)端到端的缺点:需要特别大的数据量,往往没有那么多;它排除了可能有用的手工设计组件,学习算法有两个主要的知识来源:一个是数据,另一个使人手工设计的任何东西,如组件、功能或者其他东西。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册