首页 文章 精选 留言 我的

精选列表

搜索[思考模型],共10000篇文章
优秀的个人博客,低调大师

企业数字化出海:多云环境下的运维治理与SRE实践思考

在全球化业务扩张背景下,多云架构已成为企业构建海外业务技术底座的标准配置。阿里云国际、腾讯云国际及亚马逊云(AWS)等平台凭借全球机房分布,为不同区域的算力需求提供了有力支撑。然而,对于运维团队而言,如何处理多平台配置差异、跨境财务合规及跨时区运维响应,是决定出海业务稳定性与运维效率的关键要素。

优秀的个人博客,低调大师

---一次开发过程中的思考

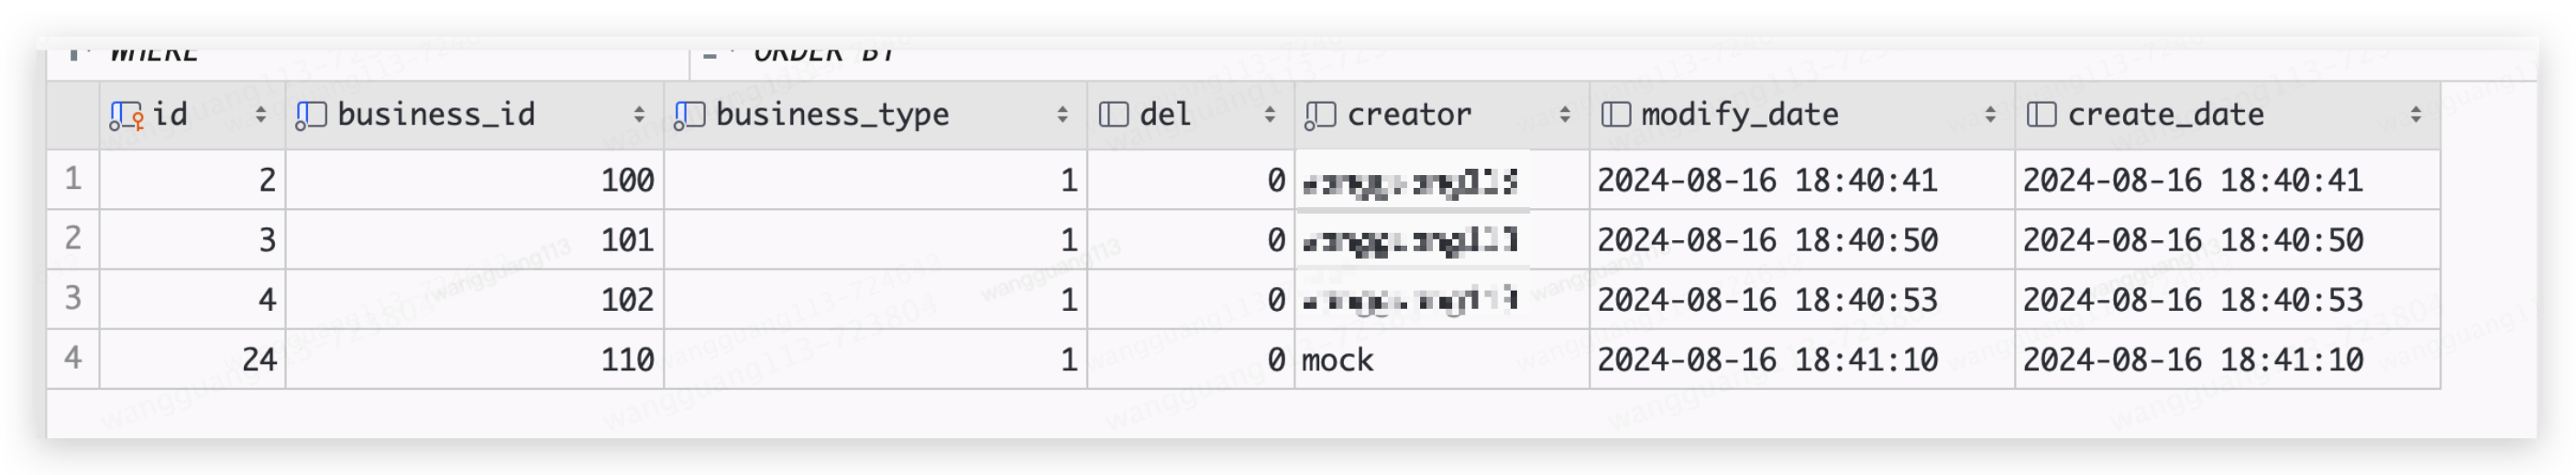
前情提要: 最近新接了一个需求,需要去创建两张表,其中有一张表需要根据业务id和业务类型建立唯一索引,对数据唯一性进行约束。 因为涉及到业务嘛,表结构就进行缩略了 表结构示例如下: CREATE TABLE `example_table` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '自增主键', `business_id` bigint(20) unsigned NOT NULL COMMENT '业务ID', `business_type` tinyint(3) unsigned NOT NULL COMMENT '业务类型,', `del` tinyint(1) unsigned DEFAULT '0' COMMENT '删除标识,0表示未删除,1表示删除', `creator` varchar(50) NOT NULL COMMENT '创建人PIN', `modify_date` datetime DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间', `create_date` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', PRIMARY KEY (`id`), UNIQUE KEY `uk_business_id_and_type` (`business_id`,`business_type`) ) ENGINE=InnoDB AUTO_INCREMENT=2 DEFAULT CHARSET=utf8mb4 COMMENT='示例表' 既然表建立好,那么就是发挥我们编码能力的时候了...此处省略一堆编码时间。 编码结束,自测结束,信心满满的找前端同学进行联调。 因为联调嘛,mock了很多同样的business_id和bussiness_type的数据,结果到了数据库,因为唯一索引的约束,报了一堆错误,插入都失败了。 终于调整了一下mock数据,插入成功了。 但是发生了一个比较神奇的现象    主键不是连续自增的了~~ 中间丢失的自增主键去哪了?? 关于自增主键 自增主键是我们在设计数据库表结构时经常使用的主键生成策略,主键的生成可以完全依赖数据库,在新增数据的时候,我们只需要将主键设置为null,0或者不设置该字段,数据库就会为我们自动生成一个主键值。 首先,我们要知道 自增主键保存在哪里~ 不同的引擎对于自增值的保存策略不同 1.MyISAM引擎的自增值保存在数据文件中 2.InnoDB引擎的自增值,在MySQL5.7及之前的版本,自增值保存在内存里,并没有持久化。每次重启后,第一次打开表的时候,都会去找自增值的最大值max(id),然后将max(id)+步长(建表语句中的指定步长)作为这个表当前的自增值。在MySQL8.0版本,将自增值的变更记录在了redo log中,重启的时候依靠redo log恢复重启之前的值。 了解了自增主键的保存机制,再了解一下主键这个"自增"逻辑~   插入一条语句分配自增主键id值的流程如图所示。 自增主键不连续的情况 细心的小伙伴一定发现了~咦,这个ID=声明值的话,ID就可以能被随意指定了,那么ID就可能存在不是自增的情况了! 是的,这其实就是第一种自增主键不连续的情况。 第二种不连续的情况就是我们在联调中遇到的问题了 简单来做个测试,目前数据就像一开始的图一样,id自增到了24,下一个插入的应该是25,那么执行一条sql insert into example_table values (null,111,1,0,'mock',now(),now());   插入成功了一条数据,主键是连续自增的。 那么我们模拟一条错误的sql呢(`creator`字段指定错类型)~: insert into example_table values (null,112,1,0,mock,now(),now()); 果然,执行sql 的时候报出异常:   继续执行一条正确的正常的sql,插入结果:   主键还是连续自增的。这个发生错误为什么自增主键还是连续的呢。我们模拟一下之前联调遇到的情况,插入一条 sql: insert into example_table values (null,112,1,0,'mock',now(),now()); 因为id=26的数据buiness_id和bussiness_type 跟新插入的这条数据一样,那么肯定会因为唯一索引插入不成功,果然,执行结果如下:   那么,我们修改一下sql继续插入呢? insert into example_table values (null,113,1,0,'mock',now(),now())   主键发生了"断代",27的主键跑丢了... 明明都是sql插入的时候错误,为什么结果会有差异呢,有的时候主键会丢失,有的时候主键不会丢失呢,想要弄明白这个问题,就需要先明白一下一条sql的执行过程:   这里只是针对本文需要关注的点(相信小伙伴对这个执行过程肯定也是非常了解的😏) 所以说 主键有没有丢失的核心关键就是有没有走到 执行引擎有没有去分配主键。一旦走到了分配主键就不会进行回滚。 既然一旦分配了主键就不会回滚,那是不是事务回滚之后主键也不会回滚至之前的值呢? 第三种就是这样,事务回滚也会导致主键“丢失”: 举个栗子: insert into example_table values (null,114,1,0,'mock',now(),now());   回滚这条语句。并继续执行上面那条语句   29这个id就“丢失”了。 有好奇的小伙伴就会问了,问什么mysql-innodb不提供一种回滚主键id的机制呢? 我理解的是,1、没有必要 ;2、影响性能; 自增主键锁并不是一个事务锁,而是每次申请完就马上释放,以便允许别的事务再申请。但在MySQL5.0版本的时候,自增锁的范围是语句级别。也就是说,如果一个语句申请了一个表自增锁,这个锁会等语句执行结束以后才释放。MySQL5.1.22版本引入了一个新策略,新增参数innodb_autoinc_lock_mode,默认值是1。 1.这个参数设置为0:表示采用之前MySQL5.0版本的策略,即语句执行结束后才释放锁。 2.这个参数设置为1:普通insert语句,自增锁在申请之后就马上释放。批量插入数据的语句,自增锁还是要等语句结束后才被释放。 3.这个参数设置为2:所有的申请自增主键的动作都是申请后就释放锁。 我们假设一个场景主键id是可以回滚的,根据上面的自增主键锁的规则。事务A申请了一个自增主键id=29,事务B申请了一个自增主键id=30,在申请了之后就会被释放,如果这个时候事务A进行了回滚,事务B执行完毕,这个时候就需要将id回滚到29,但是id30已经存在表中了。那么肯定会需要一个类似现在的redolog,undolog的"存储单元"去存储主键id的分配情况,如果再有一个事务C过来申请主键id,这个时候就会出现很多种情况去考虑,1:我要申请的主键id是否已经分配出去了。如果已经没有还好,如果有的话,需要去找到一个允许我插入的最小的id(这个最小的成本就会比目前直接选择最大的id性能要查很多。)2:我是批量插入,我需要申请一批id,这种情况想想就很抓马,因为这一批次中的id可能存在多个已经存在的情况。 而且就算主键id可以回滚,那么我插入数据的顺序,跟id的大小就存在悖论关系了,在业务层面就不能根据id去做一些判断了,这也无疑增加了业务层面的复杂性。所以主键id是可以回滚是一个ROI极低的方案了。 在上面的说到的自增主键的分配策略也可以想到: 第四种不连续的情况:批量申请的主键id,如果出现没有使用完,或者批量插入出现问题导致的主键id不连续。 当然这里说的批量插入不是 insert into example_table values (null,111,1,0,'mock',now(),now()),(null,112,1,0,'mock',now(),now()); 这样的语句,因为这种语句在sql解析的时候就可以明确需要插入多少条目,id也就会直接进行分配到具体的条目。 但是对于 insert...select 这种批量插入语句,因为大部分都是执行多表操作,所以实际操作的条数是不可确定的。 在进行分配主键id的时候,会有一个策略: 1. 语句执行过程中,第一次申请自增 id,会分配 1 个; 2. 1 个用完以后,这个语句第二次申请自增 id,会分配 2 个; 3. 2 个用完以后,还是这个语句,第三次申请自增 id,会分配 4 个; 4. 依此类推,同一个语句去申请自增 id,每次申请到的自增 id 个数都是上一次的两倍。 create table `example_table_2` like `example_table`; #使用批量插入语句 从example_table中读取数据, 往example_table_2中插入数据 insert into example_table_2 select null, business_id, business_type, del, creator, modify_date, create_date from example_table; 这个时候的执行结果如图:   那么按照预期 第一次分配id=1,第二次分配id是[2,3],第三次分配id区间是[4,7],第四次分配区间是[8,15],那么执行下面语句: #插入一条数据 预期主键id应该是16 insert into example_table_2 values (null,200,1,0,'mock',now(),now());   果然执行结果符合预期结果。 这个语句在实际业务中使用的很少,mysql在这个语句里面还是有很多设计的,大家可以看看官方文档详细的了解一下 https://dev.mysql.com/doc/refman/8.0/en/insert-select.html 还有一种情况是主键id设置的步长不为1 这种情况一般都是发生在表的设计初期,所以出现不自增的话也是符合预期的。  写在最后 MySQL是作为大家都经常接触的DB,相信大家都会有一定的认知,自增主键不连续大家肯定也遇到过,这次在联调过程中遇到这个情况,在跟别的小伙伴分享的时候,突然就想写一篇文章,文章里面如果有不正确或者不准确的地方也欢迎大家斧正~说实话,作为一名交易端的研发人员,业务开发任务压力真的蛮大的,我也迷茫过,如何在这个过程中成长,珍惜我们遇到的问题,将遇到的问题记录在册,深追问题,你会发现有很多问题其实真的是因为我们某些知识的薄弱点造成的。然后将我们觉得值得分享的利用碎片时间整理成文章分享出来,其实这篇文章从我开始写到到最后成稿也历时11天之久,但是不管怎么样,只要我们从中有收获就可以了~最后,希望大家都可以成为自己心目中的技术达人。 To enjoy is to be young,To enjoy is to be your own goal!

优秀的个人博客,低调大师

记一次生产慢sql索引优化及思考 | 京东云技术团队

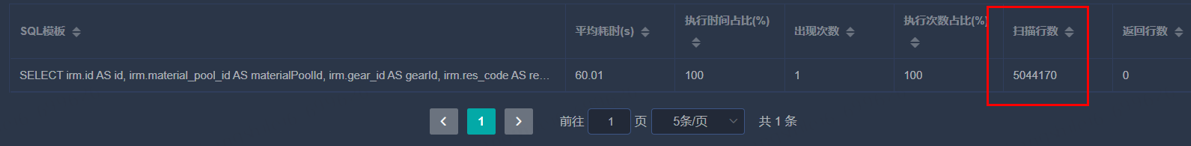
一 问题重现 夜黑风高的某一晚,突然收到一条运营后台数据库慢sql的报警,耗时竟然达到了60s。  看了一下,还好不是很频繁,内心会更加从容排查问题,应该是特定条件下没有走到索引导致,如果频繁出现慢查询,可能会将数据库连接池打满,导致数据库不可用,从而导致应用不可用。 二 问题排查 报警自带定位慢sql语句,这个是很早就上线的一条sql语句,下面对sql语句进行了简化: select * from xxx where gear_id=xxx and examine=xxx order by id desc limit 10,这是个简单的根据流量池gear_id查询,按照主键id倒序进行分页查询10条数据的语句。 在examine=2时查询速度很快,但是在examine=3时,查询速度极慢,然后分别在不同的examine下查看执行计划,得到的执行计划都是一致的。 查看执行计划,发现possible_keys中有idx_gear_id索引,但是实际用到的key却是PRIMARY,并且extra中明确用了where条件进行数据过滤。到现在就明白了这个sql是在主键聚簇索引上进行扫描,然后用where语句条件进行过滤,时间耗费在这了。 这个也解释了为什么examine在不同状态下的耗时不一样,取决于where过滤扫描的行数,扫描行数越多,执行越慢,但同一个问题是都没走到我们已有的索引idx_gear_id。 当单表数量较小时,无论有没有索引,或者走主键索引扫描或者普通索引都很快,很容易忽略这些问题,此时的表现就是你好,我好,大家好,然后随着数据量的增大,当达到千万级别或者亿级时,慢查询的问题就凸显出来了。 三 原理剖析 为什么mysql会选择这个不合适的主键聚簇索引? 以常用的InnoDb存储引擎为例,看一下聚簇索引和非聚簇索引查询区别: 聚簇索引:通常就是按照每张表的主键构造一颗B+树,叶子节点中存放的就是整张表的行记录数据,即数据和主键都在索引上 非聚簇索引:表的二级索引字段(比如唯一索引,联合索引等)构造的一颗B+树,叶子节点存储的是Key字段+主键值,即非聚集索引的叶节仍然是索引节点,但它有一个指向最终数据索引的指针。 聚簇索引查询原理: 非聚簇索引查询原理(二级索引查询): 由以上的索引数据结构可以看出,因为聚簇索引将索引和数据保存在同一个B+树中,因此通常从聚簇索引中获取数据比非聚簇索引更快,而非聚簇索引在获取到叶子节点的主键后,需要再次查询主键索引,即回表查询行记录数据。当然如果查询的列只是索引字段,比如查询姓名和年龄,可以创建联合索引,即索引存储的内容即为需要查询的内容,这种查询速度往往比主键索引更快,这种索引查询又称为覆盖索引。 什么是回表? 将以上的索引数据映射成常见的用户表user的索引为例,上面的聚簇索引就是以id字段为主键的索引,name字段为非聚簇索引,还有age等其他表字段是非索引字段,示例sql:select * from user where id = 1; 这条 SQL 语句就不需要回表。原因是根据主键的查询方式,则只需要搜索 id聚簇索引这棵 B+ 树,就可以查到对应的数据。 但当我们使用非聚簇索引 name 这个索引来查询 name = b 的记录时就要用到回表。原因是通过 name 这个二级索引查询方式,则需要先搜索 name 索引树,然后得到主键 id,即PK的值为 1,再到主键id聚簇索引树再搜索一次。这种根据二级索引查询到主键id,再根据主键id查询主键聚簇索引的过程就称为回表。 回到为什么mysql会选择这个不合适的主键聚簇索引问题本身,mysql执行器认为使用二级索引查出来的数据太多了,还需要基于磁盘做临时存储进行排序,然后排序取出10条,然后进行回表查询字段,性能可能会很差,所以采用了直接采用了按顺序扫描主键聚簇索引,和where条件gear_id=xxx and examine=xxx进行对比,最多放10条即可,这种情况就是数量小的时候没问题,但是当数据量大的时候,就需要一直扫描所有的数据,直到查到符合where条件的10条数据为止,同时耗时也急剧增长。 四 解决问题 为了快速解决问题,可以采用强制索引force index,即在写sql语句时指定使用具体的索引 sql示例 :select * from xxx force index (idx_gear_id) where gear_id=xxx and examine=3 order by id desc limit 10,强制使用idx_gear_id这个索引。 以下为使用强制索引的执行计划: 可以看到实际使用的索引key就是idx_gear_id,执行耗时在几百毫秒,运营后台的业务人员完全可接受。 五 长期优化 由于表的数据越来越多,查询条件错综复杂,还有用json字段查询问题,决定将数据异构到es查询,将json字段打平,es天然支持复杂的查询条件,查询响应更快。 es数据同步方案:  在ES数据同步链路中,通过京东科技中间件DTS监听数据库的binlog,将索引字段(查询条件字段)及业务唯一id写入ES。 在业务运营查询时,根据复杂的查询条件,先去ES查询,将业务唯一id查出,再根据业务唯一id去DB中查询业务明细数据,同时解决了业务查询的复杂性和查询性能。 作者:京东科技张石磊 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

图解+代码|常见限流算法以及限流在单机分布式场景下的思考

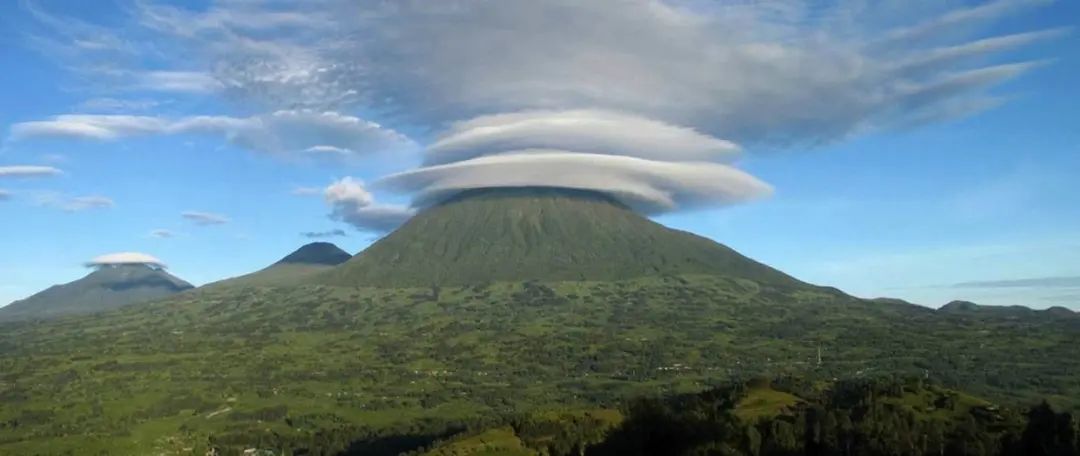
大家好,我是 yes。 今天来说说限流的相关内容,包括常见的限流算法、单机限流场景、分布式限流场景以及一些常见限流组件。 当然在介绍限流算法和具体场景之前我们先得明确什么是限流,为什么要限流?。 任何技术都要搞清它的来源,技术的产生来自痛点,明确痛点我们才能抓住关键对症下药。 限流是什么? 首先来解释下什么是限流? 在日常生活中限流很常见,例如去有些景区玩,每天售卖的门票数是有限的,例如 2000 张,即每天最多只有 2000 个人能进去游玩。 题外话:我之前看到个新闻,最不想卖门票的景区“卢旺达火山公园”,每天就卖 32 张,并且每张门票需要 1 万元! 卢旺达火山公园 再回到主题,那在我们工程上限流是什么呢?限制的是 「流」,在不同场景下「流」的定义不同,可以是每秒请求数、每秒事务处理数、网络流量等等。 而通常我们说的限流指代的是 限制到达系统的并发请求数,使得系统能够正常的处理 部分 用户的请求,来保证系统的稳定性。 限流不可避免的会造成用户的请求变慢或者被拒的情况,从而会影响用户体验。因此限流是需要在用户体验和系统稳定性之间做平衡的,即我们常说的 trade off。 对了,限流也称流控(流量控制)。 为什么要限流? 前面我们有提到限流是为了保证系统的稳定性。 日常的业务上有类似秒杀活动、双十一大促或者突发新闻等场景,用户的流量突增,后端服务的处理能力是有限的,如果不能处理好突发流量,后端服务很容易就被打垮。 亦或是爬虫等不正常流量,我们对外暴露的服务都要以最大恶意去防备我们的调用者。我们不清楚调用者会如何调用我们的服务。假设某个调用者开几十个线程一天二十四小时疯狂调用你的服务,不做啥处理咱服务也算完了。更胜的还有 DDos 攻击。 还有对于很多第三方开发平台来说,不仅仅是为了防备不正常流量,也是为了资源的公平利用,有些接口都免费给你用了,资源都不可能一直都被你占着吧,别人也得调的。 高德开放平台流量限制说明 当然加钱的话好商量。 在之前公司还做过一个系统,当时SaaS版本还没出来。因此系统需要部署到客户方。 当时老板的要求是,我们需要给他个限流降级版本,不但系统出的方案是降级后的方案,核心接口每天最多只能调用20次,还需要限制系统所在服务器的配置和数量,即限制部署的服务器的CPU核数等,还限制所有部署的服务器数量,防止客户集群部署,提高系统的性能。 当然这一切需要能动态配置,因为加钱的话好商量。客户一直都不知道。 估计老板在等客户说感觉系统有点慢吧。然后就搞个2.0版本?我让我们研发部加班加点给你搞出来。 小结一下,限流的本质是因为后端处理能力有限,需要截掉超过处理能力之外的请求,亦或是为了均衡客户端对服务端资源的公平调用,防止一些客户端饿死。 常见的限流算法 有关限流算法我给出了对应的图解和相关伪代码,有些人喜欢看图,有些人更喜欢看代码。 计数限流 最简单的限流算法就是计数限流了,例如系统能同时处理100个请求,保存一个计数器,处理了一个请求,计数器加一,一个请求处理完毕之后计数器减一。 每次请求来的时候看看计数器的值,如果超过阈值要么拒绝。 非常的简单粗暴,计数器的值要是存内存中就算单机限流算法。存中心存储里,例如 Redis 中,集群机器访问就算分布式限流算法。 优点就是:简单粗暴,单机在 Java 中可用 Atomic 等原子类、分布式就 Redis incr。 缺点就是:假设我们允许的阈值是1万,此时计数器的值为0, 当1万个请求在前1秒内一股脑儿的都涌进来,这突发的流量可是顶不住的。缓缓的增加处理和一下子涌入对于程序来说是不一样的。 而且一般的限流都是为了限制在指定时间间隔内的访问量,因此还有个算法叫固定窗口。 计数器限流伪代码实现 固定窗口限流 它相比于计数限流主要是多了个时间窗口的概念。计数器每过一个时间窗口就重置。规则如下: 请求次数小于阈值,允许访问并且计数器 +1; 请求次数大于阈值,拒绝访问; 这个时间窗口过了之后,计数器清零; 固定窗口限流伪代码实现 看起来好像很完美,实际上还是有缺陷的。 固定窗口临界问题 假设系统每秒允许 100 个请求,假设第一个时间窗口是 0-1s,在第 0.55s 处一下次涌入 100 个请求,过了 1 秒的时间窗口后计数清零,此时在 1.05 s 的时候又一下次涌入100个请求。 虽然窗口内的计数没超过阈值,但是全局来看在 0.55s-1.05s 这 0.1 秒内涌入了 200 个请求,这其实对于阈值是 100/s 的系统来说是无法接受的。 固定窗口 为了解决这个问题引入了滑动窗口限流。 滑动窗口限流 滑动窗口限流解决固定窗口临界值的问题,可以保证在任意时间窗口内都不会超过阈值。 相对于固定窗口,滑动窗口除了需要引入计数器之外还需要记录时间窗口内每个请求到达的时间点,因此对内存的占用会比较多。 规则如下,假设时间窗口为 1 秒: 记录每次请求的时间 统计每次请求的时间 至 往前推1秒这个时间窗口内请求数,并且 1 秒前的数据可以删除。 统计的请求数小于阈值就记录这个请求的时间,并允许通过,反之拒绝。 滑动窗口 滑动窗口伪代码实现 但是滑动窗口和固定窗口都无法解决短时间之内集中流量的突击。 我们所想的限流场景,例如每秒限制 100 个请求。希望请求每 10ms 来一个,这样我们的流量处理就很平滑,但是真实场景很难控制请求的频率。因此可能存在 5ms 内就打满了阈值的情况。 当然对于这种情况还是有变型处理的,例如设置多条限流规则。不仅限制每秒 100 个请求,再设置每 10ms 不超过 2 个。 再多说一句,这个滑动窗口可与TCP的滑动窗口不一样。TCP的滑动窗口是接收方告知发送方自己能接多少“货”,然后发送方控制发送的速率。 接下来再说说漏桶,它可以解决时间窗口类算法的痛点,使得流量更加的平滑。 漏桶算法 如下图所示,水滴持续滴入漏桶中,底部定速流出。如果水滴滴入的速率大于流出的速率,当存水超过桶的大小的时候就会溢出。 规则如下: 请求来了放入桶中 桶内请求量满了拒绝请求 服务定速从桶内拿请求处理 漏桶 漏桶伪代码实现 可以看到水滴对应的就是请求。它的特点就是宽进严出,无论请求多少,请求的速率有多大,都按照固定的速率流出,对应的就是服务按照固定的速率处理请求。“他强任他强,老子尼克杨”。 看到这想到啥,是不是和消息队列思想有点像,削峰填谷。一般而言漏桶也是由队列来实现的,处理不过来的请求就排队,队列满了就开始拒绝请求。看到这又想到啥,线程池不就是这样实现的嘛? 经过漏洞这么一过滤,请求就能平滑的流出,看起来很像很挺完美的?实际上它的优点也即缺点。 面对突发请求,服务的处理速度和平时是一样的,这其实不是我们想要的,面对突发流量我们希望在系统平稳的同时,提升用户体验即能更快的处理请求,而不是和正常流量一样,循规蹈矩的处理(看看,之前滑动窗口说流量不够平滑,现在太平滑了又不行,难搞啊)。 而令牌桶在应对突击流量的时候,可以更加的“激进”。 令牌桶算法 令牌桶其实和漏桶的原理类似,只不过漏桶是定速地流出,而令牌桶是定速地往桶里塞入令牌,然后请求只有拿到了令牌才能通过,之后再被服务器处理。 当然令牌桶的大小也是有限制的,假设桶里的令牌满了之后,定速生成的令牌会丢弃。 规则: 定速的往桶内放入令牌 令牌数量超过桶的限制,丢弃 请求来了先向桶内索要令牌,索要成功则通过被处理,反之拒绝 令牌桶 看到这又想到啥?Semaphore 信号量啊,信号量可控制某个资源被同时访问的个数,其实和咱们拿令牌思想一样,一个是拿信号量,一个是拿令牌。只不过信号量用完了返还,而咱们令牌用了不归还,因为令牌会定时再填充。 再来看看令牌桶的伪代码实现,可以看出和漏桶的区别就在于一个是加法,一个是减法。 令牌桶伪代码实现 可以看出令牌桶在应对突发流量的时候,桶内假如有 100 个令牌,那么这 100 个令牌可以马上被取走,而不像漏桶那样匀速的消费。所以在应对突发流量的时候令牌桶表现的更佳。 限流算法小结 上面所述的算法其实只是这些算法最粗略的实现和最本质的思想,在工程上其实还是有很多变型的。 从上面看来好像漏桶和令牌桶比时间窗口算法好多了,那时间窗口算法有啥子用,扔了扔了? 并不是的,虽然漏桶和令牌桶对比时间窗口对流量的整形效果更佳,流量更加得平滑,但是也有各自的缺点(上面已经提到了一部分)。 拿令牌桶来说,假设你没预热,那是不是上线时候桶里没令牌?没令牌请求过来不就直接拒了么?这就误杀了,明明系统没啥负载现在。 再比如说请求的访问其实是随机的,假设令牌桶每 20ms 放入一个令牌,桶内初始没令牌,这请求就刚好在第一个 20ms 内有两个请求,再过 20ms 里面没请求,其实从 40ms 来看只有 2 个请求,应该都放行的,而有一个请求就直接被拒了。这就有可能造成很多请求的误杀,但是如果看监控曲线的话,好像流量很平滑,峰值也控制的很好。 再拿漏桶来说,漏桶中请求是暂时存在桶内的。这其实不符合互联网业务低延迟的要求。 所以漏桶和令牌桶其实比较适合阻塞式限流场景,即没令牌我就等着,这就不会误杀了,而漏桶本就是等着。比较适合后台任务类的限流。而基于时间窗口的限流比较适合对时间敏感的场景,请求过不了您就快点儿告诉我,等的花儿都谢了(给阿姨倒一杯卡布奇诺。为什么我会突然打这句话??)。 单机限流和分布式限流 本质上单机限流和分布式限流的区别其实就在于 “阈值” 存放的位置。 单机限流就上面所说的算法直接在单台服务器上实现就好了,而往往我们的服务是集群部署的。因此需要多台机器协同提供限流功能。 像上述的计数器或者时间窗口的算法,可以将计数器存放至 Tair 或 Redis 等分布式 K-V 存储中。 例如滑动窗口的每个请求的时间记录可以利用 Redis 的 zset 存储,利用ZREMRANGEBYSCORE 删除时间窗口之外的数据,再用 ZCARD计数。 像令牌桶也可以将令牌数量放到 Redis 中。 不过这样的方式等于每一个请求我们都需要去Redis判断一下能不能通过,在性能上有一定的损耗,所以有个优化点就是 「批量」。例如每次取令牌不是一个一取,而是取一批,不够了再去取一批。这样可以减少对 Redis 的请求。 不过要注意一点,批量获取会导致一定范围内的限流误差。比如你取了 10 个此时不用,等下一秒再用,那同一时刻集群机器总处理量可能会超过阈值。 其实「批量」这个优化点太常见了,不论是 MySQL 的批量刷盘,还是 Kafka 消息的批量发送还是分布式 ID 的高性能发号,都包含了「批量」的思想。 当然分布式限流还有一种思想是平分,假设之前单机限流 500,现在集群部署了 5 台,那就让每台继续限流 500 呗,即在总的入口做总的限流限制,然后每台机子再自己实现限流。 限流的难点 可以看到每个限流都有个阈值,这个阈值如何定是个难点。 定大了服务器可能顶不住,定小了就“误杀”了,没有资源利用最大化,对用户体验不好。 我能想到的就是限流上线之后先预估个大概的阈值,然后不执行真正的限流操作,而是采取日志记录方式,对日志进行分析查看限流的效果,然后调整阈值,推算出集群总的处理能力,和每台机子的处理能力(方便扩缩容)。 然后将线上的流量进行重放,测试真正的限流效果,最终阈值确定,然后上线。 我之前还看过一篇耗子叔的文章,讲述了在自动化伸缩的情况下,我们要动态地调整限流的阈值很难,于是基于TCP拥塞控制的思想,根据请求响应在一个时间段的响应时间P90或者P99值来确定此时服务器的健康状况,来进行动态限流。在他的 Ease Gateway 产品中实现了这套算法,有兴趣的同学可以自行搜索。 其实真实的业务场景很复杂,需要限流的条件和资源很多,每个资源限流要求还不一样。所以我上面就是嘴强王者。 罗老师V5 限流组件 一般而言我们不需要自己实现限流算法来达到限流的目的,不管是接入层限流还是细粒度的接口限流其实都有现成的轮子使用,其实现也是用了上述我们所说的限流算法。 比如Google Guava 提供的限流工具类 RateLimiter,是基于令牌桶实现的,并且扩展了算法,支持预热功能。 阿里开源的限流框架Sentinel 中的匀速排队限流策略,就采用了漏桶算法。 Nginx 中的限流模块 limit_req_zone,采用了漏桶算法,还有 OpenResty 中的 resty.limit.req库等等。 具体的使用还是很简单的,有兴趣的同学可以自行搜索,对内部实现感兴趣的同学可以下个源码看看,学习下生产级别的限流是如何实现的。 最后 今天只是粗略讲解了限流相关的内容,具体应用到工程上还是有很多点需要考虑的,并且限流只是保证系统稳定性中的一个环节,还需要配合降级、熔断等相关内容。以后有机会再讲讲。 往期推荐: Kafka请求处理全流程分析 Kafka索引设计的亮点:https://juejin.im/post/5efdeae7f265da22d017e58d Kafka日志段读写分析:https://juejin.im/post/5ef6b94ae51d4534a1236cb0 我是yes,一个在互联网摸爬滚打且莫得感情的工具人。 本文分享自微信公众号 - yes的练级攻略(yes_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

阿里工业互联网平台“思考”:一场从0到1的蜕变

文/周雅 阿里云总裁胡晓明(花名孙权)曾在一场媒体采访中透露了自己的业务秘籍,说他永远记住两句话,一是“拓展商业边界”,二是“商业驱动技术进步”。 这句话不失为阿里的真实写照。的确,企业的安身立命之道,从来都不止于实验室里的技术,更要让技术产生商业价值,形成一个良性循环,为整个产业链乃至生态圈谋利益。但要说技术与商业无缝结合的企业,阿里可谓典型一家,比如阿里生态、蚂蚁生态、菜鸟生态,都是这一模式的缩影;再比如2018广东云栖大会,我们看到了从技术引入商业的背后逻辑。 产业发展的必然 工业互联网算是一个老生常谈的话题,中国作为全球制造业基地之一,谈起来更是迫在眉睫。说起来,是源于中国制造企业的“诟病”:内部出现产能过剩、成本上涨等发展问题,外部面临劳动力、土地和能源等成本不断走高。前富士康工业互联网公司董事长陈永正曾在一次独家专访中告诉赛博

优秀的个人博客,低调大师

瑞为CEO詹东晖:从安防到零售,我在思考什么

虽然已近不惑之年,但詹东晖看起来像一个二十多岁的男人。瑞为是他的第二家公司,规模不大,但从一开始,他就在做自己喜欢的事情。 2012年他创业做人工智能,从最开始的智能安防领域,到现在如火如荼的智慧零售业务。这两者看起来好似格格不入,然而里面的技术及逻辑都是相通的。聊天中发现,对于未来,他已经有更大布局了。 见到詹东晖是一个工作日的早上,九点左右到达,彼时他已经在办公室工作一个多小时。他现在的烦恼是如何能建立更多渠道以及如何更好解决复杂场景下的人脸识别率问题。 詹东晖说,目前我们能解决90%以上的复杂场景下的识别问题,大概还有10%左右搞不定,这已经是目前的最好水平了,这真的太难了! 初生牛犊闯“安防” 说到安防,他第一次移开了目光,一直平缓的语气突然顿了一下:要知道,12年做人脸识别真的没有什么方向。这几年AI的发展带动深度学习的全面商业化

优秀的个人博客,低调大师

沸腾物联网下的冷思考:打破壁垒与抢占时间窗口同等重要

目前,全球物联网市场小步快跑,中国的产业热度尤为高涨,约有上千家企业围绕物联网开展相关工作。但是,如果认真分析现在运营商提供的网络,对满足未来物联网的需求还是存在一定弊端。比如芯片、终端、传感器在功耗、成本方面仍然有待提高和改善。如何破解这些壁垒,与抢占时间窗口一样重要。 行业热度超高温 据IDC预测,到2020年,全球物联网连接数将达到281亿,收入规模将超过7万亿美元;而Gartner给出的连接数预计为268亿,收入规模达到3000亿美元;GSMA则认为到2020年,物联网连接数将超过300亿,其中基于蜂窝技术的连接数将达到10-20 亿。虽然各方预测数有所不同,但物联网给行业所带来的丰厚回报吸引着产业链众多企业纷纷进军。尤其是运营商更是把物联网视作下一个盈利蓝海而竞相布局。 自NB-IoT标准获得国际组织3GPP通过以来,其具备的广覆盖、低成本、低功耗以及大连接数等特性备受行业青睐并纷纷投入,而NB-IoT作为通信业向万物互联迈进的重要敲门砖,也成为运营商眼中的香饽饽。2016年6月,NB-IoT的核心标准刚刚冻结,中国电信就迅速采取行动,在10月份开启了5G的一个招标,预计全网能够部署基站30万个,和现CDMA网络进行部署,快速形成低频4G和NB-IoT的网络覆盖。截至目前,全网基站的部署已经完成了接近50%,将在6月底建成全球最大的NB-IoT网络,为下一步物联网的发展坚定了坚实的基础。 据中国电信股份有限公司物联网分公司总经理赵建军介绍,从整个外网测试来看,原本NB-IoT性能的指标、覆盖的能力测试非常乐观,4G NB-IoT网络附加的能力比同频段的网络覆盖强1倍,平均的速率也达到预期的标准。 另外,中国电信还与华为、深圳水务签订了NB-IoT智慧城市建设协议,与海尔、海信签订了智能家电合作协议,共同研发基于新一代NB-loT技术的物联网智慧生活解决方案。 中国移动则在车联网领域积极尝试,配合政府一方面推动V2X商业频谱的发放,另一方面也在大力推进在上海、重庆、杭州等六地的LTE—V2X技术实验,积极推动V2X产品及应用研发,加快产业成熟进程。并依托于NGMN、5GAA、TIAA等产业联盟及组织推进中国自主核心生态的构建。 而将物联网列为三大创新战略之一的中国联通,将在2017年继续推进北京、上海、广州、深圳、银川、长沙、福州等重点城市的NB-IoT商用部署。目前,中国联通已在上海迪士尼乐园内进行大规模NB-IoT外场启动试验,为游客提供实时停车位信息等服务。 在这样一个背景下,产业的热度非常之高就不足为奇。 冷静之后看弊端 虽然NB-IoT的商用条件日趋成熟,中国企业热情高涨,各大机构也都做了非常乐观的预期。但是随着NB-IoT渗透更多垂直行业,对电信运营商来说,要满足未来物联网的需求还是有一些弊端。一方面,NB-IoT芯片、终端、传感器在功耗、成本方面仍存在不足。另一方面,系统的可靠性有待提升,包括很多物联网都会基于私有的通信协议影响规模部署和发展。 在此前,华为副董事长兼轮值CEO胡厚崑就曾经表示,要想刺激NB-IoT大规模发展,通信模块成本必须低于5美元,如果成本降到1美元以内则会带来爆发式增长。但目前NB-IoT芯片加模组的价格还难以做到5美元以下。这让许多企业部署NB-IoT产生顾虑。 国内运营商如此扫除物联网发展路上的这些障碍? 据了解,提出网络智能化重构的中国电信正在打造多网并存的,能够符合各种带宽、各种速率、各种服务质量保障连接的精品网络。“从2G和3G当中,目前中国电信的800M的CDMA网络运行情况我们希望把它保持好,我们非常不看好在2G、3G当中承担更好的物联网连接”,中国电信物联网分公司总经理赵建军表示。 据了解,中国电信整个4G网络平台,目前全网已有80多个基站,建成了1.8G精品网络,当前正在和NB-IoT一起在800M网络规模部署,快速推进外场测试,同时加强5G网络的研究。 打造基础网络的同时,中国电信也在积极构建自身的平台,希望通过公共平台的搭建、平台能力的开放,为应用开发的厂家提供更好的开发环境,最终提高整个物联网开发和部署的成本周期。 中国移动近期则还是以NB-IoT为主。 “整个蜂窝物联网方面,中国移动聚焦在围绕低功耗、长续航、广覆盖大连接的垂直行业需求,聚焦终端模组、网络以及物联网平台、致力于提供业界领先的端、管、云服务体系。基于中国移动物联网的OneNET我们会提供应用规划网络连接的能力,为物联网的应用提供一些简单的服务”,中国移动物联网研究院相关人士表示。 随着物联网时代加速到来,对于电信运营商来说,NB-IoT商用之路充满了很多机遇,也带来很大挑战。构建清晰的商业模式,从网络、应用、安全等方面未雨绸缪,与抢占时间窗口一样重要。 本文转自d1net(转载)

优秀的个人博客,低调大师

QCon思考之通过Quora和Spotify案例,直击数据处理背后的魅影

有的同学很困惑米国人不看知乎怎么知道那么多知识呢?米国人当然看Quora啦,Quora是一个问答社交软件,问答社交的特点就是有各种各样的计数器,比如帖子的支持、反对、评论数量,用户的关注、粉丝数量等等,随着用户量的增加、帖子的增多、以及带来的互动的增长,Quora处理的数据也是爆炸式增长。Quora从第一天开始就长在云上(AWS),生产环境使用MySQL和HBase做存储,使用RefShift和Spark用来做数据分析,在这些组件的基础上Quora做了一个数据服务叫Quanta,Quanta的设计约束是: A:数据更新之后不能丢失,要求持久化到disk B:有billion级别的counter,单机放不下,所以需要分布式集群 C:每秒写>10W次,每秒读>100W次,只能用追加写 D:读写都要很快 E:资源和负载能够线性扩展,而

优秀的个人博客,低调大师

从真假美猴王谈起 - 让套牌车、克隆x 无处遁形的技术手段思考

标签 PostgreSQL , RFID , 物联网 , IoT , 套牌车 , 克隆车 , Wavelet , 图像相似度 , 传输加密 , 伪装 背景 西游记想必大家小时候都看过吧,其中有一集“真假美猴王”还记得吗? 假的美猴王简直是克隆的,和孙悟空一模一样。一开始菩提祖师、如来佛祖、观音菩萨、就连最亲近的师父、师兄弟都分辨不出来,最后师父使出紧箍咒的绝招才辨别出来。 打假在现实世界中的需求也非常旺盛,诸如我们看到的一些商品的防伪码验证、水印验证、钞票的一些特征验证等等。 但是大多数的防伪手段是很容易模仿的,包括电话,网站的防伪验证。钞票也一样,再难也有人会去搞。 再往广泛的场景去想,还有更多的真假美猴王,比如套牌车(克隆车),克隆人,ip伪装,MAC伪装。 有什么技术手段可以真正的解决真假美猴王的问题呢? 我们接下来从套牌车谈起. 什么是套牌车

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册