hadoop1.0安装部署(一)
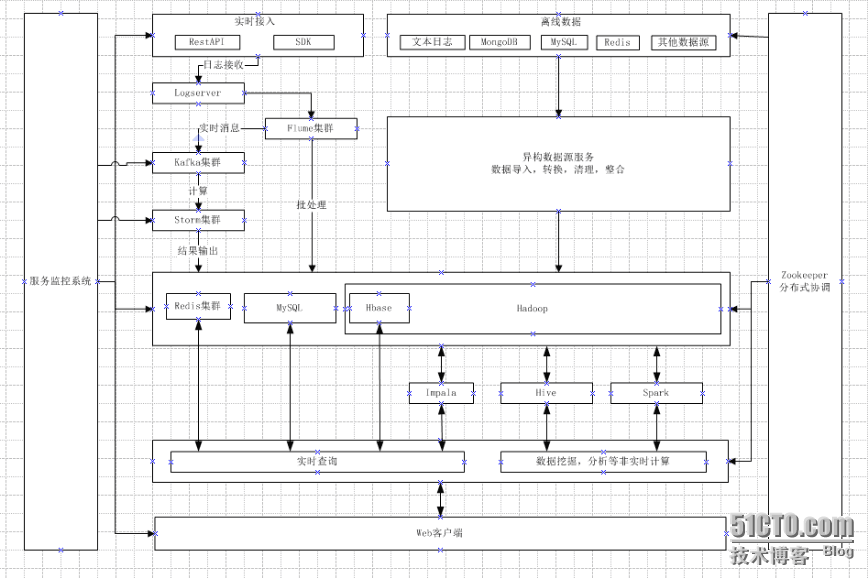
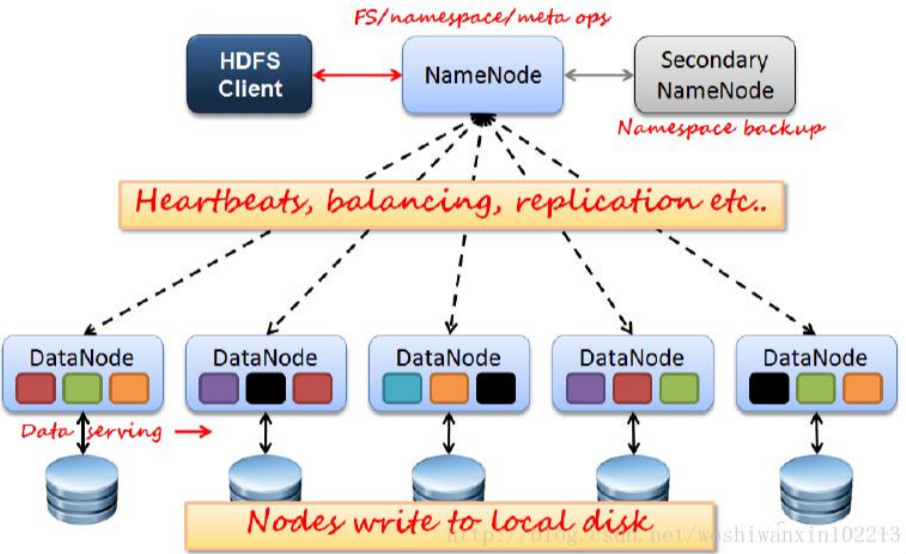
一、需求 公司线上运行有hadoop1.0和hadoop2.0,由于hadoop1.0没有处理jobtracker失败机制,它是一个单点故障,但业务还是以1.0为主,会慢慢过渡到2.0。 二、架构图 二、知识点储备 1、hadoop中NameNode、DataNode、Secondary、NameNode、JobTracker TaskTracker介绍 http://zouqingyun.blog.51cto.com/782246/1656353 2、hadoop有三种运行模式 独立(或本地)模式 无需运行任何守护进程,所有程序都在同一个JVM上执行。在独立模式下测试和调试MapReduce程序很方便,因此该模式在开发阶段比较合适 伪分布模式 Hadoop守护进程运行在本地机器上,模拟一个小规模集群 全分布模式 Hadoop守护进程运行在一个集群上。 2、Hadoop的配置文件: hadoop-env.sh: 用于定义hadoop运行环境相关的配置信息,比如配置JAVA_HOME环境变量、为hadoop的JVM指定特定的选项、指定日志文件所在的目录路径以及master和slave文件的位置等; core-site.xml: 用于定义系统级别的参数,如HDFS URL、Hadoop的临时目录以及用于rack-aware集群中的配置文件的配置等,此中的参数定义会覆盖core-default.xml文件中的默认配置; hdfs-site.xml: HDFS的相关设定,如文件副本的个数、块大小及是否使用强制权限等,此中的参数定义会覆盖hdfs-default.xml文件中的默认配置; mapred-site.xml:HDFS的相关设定,如reduce任务的默认个数、任务所能够使用内存的默认上下限等,此中的参数定义会覆盖mapred-default.xml文件中的默认配置; masters: hadoop的secondary-masters主机列表,当启动Hadoop时,其会在当前主机上启动NameNode和JobTracker,然后通过SSH连接此文件中的主机以作为备用NameNode; slaves:Hadoop集群的slave主机列表,master启动时会通过SSH连接至此列表中的所有主机并为其启动DataNode和taskTracker进程; 三、基本环境准备 1、机器 1 2 3 4 IP地址主机名扮演的角色 10.1 . 2.214 masterNameNode,JobTracker 10.1 . 2.215 slave-oneDataNode,TaskTracker 10.1 . 2.216 slave-twoSecondaryNameNode,DataNode和TaskTrakcer 2、系统版本 1 2 3 CentOSrelease 6.5 2.6 . 32 - 431 .el6.x86_64 3、关闭3台所有防火墙 service iptables stop 4、集群环境,时间同步很重要 master 启动ntpd服务 1 2 [root@master~]#servicentpdstart 正在启动ntpd:[确定] 添加定时网络时间服务器 1 2 3 4 [root@master~]#crontab-e nocrontab for root-usinganemptyone 30 ****/usr/sbin/ntpdatentp.sjtu.edu.cn>/dev/ null 2 >& 1 slave-one 1 2 [root@slave-one~]#crontab-l 10 ****/usr/sbin/ntpdate 10.1 . 2.214 >/dev/ null 2 >& 1 slave-two 1 2 [root@slave-twon~]#crontab-l 10 ****/usr/sbin/ntpdate 10.1 . 2.214 >/dev/ null 2 >& 1 5、三台主机hosts要对应 1 2 3 4 5 6 7 8 [root@master~]#vim/etc/hosts 127.0 . 0.1 localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 127.0 . 0.1 localhostlocalhost.localdomainlocalhost4localhost4.localdomain4 :: 1 localhostlocalhost.localdomainlocalhost6localhost6.localdomain6 10.1 . 2.214 master 10.1 . 2.215 slave-one 10.1 . 2.216 slave-two 6、安全起见,运行Hadoop需要以普通用户的身份进行,因此,接下来先建立运行hadoop进程的用户hadoop并给其设定密码。其他两台也一样 1 2 3 4 [root@master~]#vim/etc/hosts [root@master~]#groupaddhadoop [root@master~]#useradd-ghadoophadoop [root@master~]#echo "123456" |passwd--stdinhadoop 7、配置hadoop用户能够以基于密钥的验正方式登录本地主机,以便Hadoop可远程启动各节点上的Hadoop进程并执行监控等额外的管理工作。注意了,3台都要做相互免密钥! 1 2 3 4 [root@master~]#suhadoop [hadoop@master~]$ssh-keygen-trsa-P '' [hadoop@master~]$ssh-copy-id-i.ssh/id_rsa.pubhadoop@ 10.1 . 2.215 [hadoop@master~]$ssh-copy-id-i.ssh/id_rsa.pubhadoop@ 10.1 . 2.216 8、修改文件名柄 默认情况下,linux最大文件句柄数为1024个。服务器在大并发达到极限时,就会报出“too many open files”。这对集群来说,数量大时,会挂掉的 vim /etc/security/limits.conf 1 2 *softnofile 102400 *hardnofile 102400 重新登录,执行ulimit -a,ok ,参数生效了 四、安装配置hadoop集群 1、安装包准备 1 2 3 hadoop- 1.0 . 4 .tar.gz jdk1. 7 .0_25.tar.gz 2、安装jdk 2.1 安装JDK Hadoop依赖于1.6 update 8或更新版本的Java环境 1 [root@masterhadoop1. 0 ]#tarjdk-8u66-linux-x64.gz-C/usr/local/ 2.2Hadoop运行时需要能访问到如前安装的Java环境,这可以通过将其二进制程(/usr/local/jdk1.8.0_66)所在的目录添加至PATH环境变量的路径中实现,也可以通过设定hadoop-env.sh脚本来进行。这里采用前一种方式,编辑/etc/profile.d/java.sh,在文件中添加如下内容: 1 2 3 JAVA_HOME=/usr/usr/local/jdk1. 8 .0_66 PATH=$JAVA_HOME/bin:$PATH exportJAVA_HOMEPATH 2.3hadoop用户,并执行如下命令测试jdk环境配置是否就绪。 1 2 3 4 [hadoop@masterdata0]$java-version javaversion "1.7.0_25" Java(TM)SERuntimeEnvironment(build 1.7 .0_25-b15) JavaHotSpot(TM) 64 -BitServerVM(build 23.25 -b01,mixedmode) 3、hadoop安装配置 3.1安装 1 2 3 [root@masterhadoop1. 0 ]#tarxfhadoop- 1.0 . 4 .tar.gz-C/usr/local/ [root@masterhadoop1. 0 ]#chownhadoop:hadoop/usr/local/hadoop- 1.0 . 4 /-R 3.2 Java环境变量两种方法 3.2.1编辑/etc/profile.d/hadoop.sh,设定HADOOP_HOME环境变量的值为hadoop的解压目录,并让其永久有效。编辑/etc/profile,添加如下内容 1 2 3 HADOOP_BASE=/usr/local/hadoop- 1.0 . 4 PATH=$HADOOP_BASE/bin:$PATH exportHADOOP_BASEPATH 3.2.2 去到conf配置目录下找到环境变量文件hadoop-env.sh 确认JAVA_HOME路径是否正确 1 exportJAVA_HOME=/usr/local/jdk1. 8 .0_66 3.3 切换至hadoop用户,并执行如下命令测试hadoop是否就绪。 1 2 3 4 5 6 [hadoop@masterroot]$hadoopversion JavaHotSpot(TM) 64 -BitServerVMwarning:UsingincrementalCMS is deprecatedandwilllikelyberemoved in afuturerelease Hadoop 1.0 . 4 Subversionhttps: //svn.apache.org/repos/asf/hadoop/common/branches/branch-1.0-r1393290 CompiledbyhortonfoonWedOct 3 05 : 13 : 58 UTC 2012 Fromsource with checksumfe2baea87c4c81a2c505767f3f9b71f4 3.4 配置文件,在/usr/local/usr/local/hadoop-1.0.4/conf/目录下 3.4.1 hadoop-env.sh 记录脚本用到的环境变量,以运行hadoop namenode内存空间分配在这里为4096,在master机器上设置 1 exportHADOOP_HEAPSIZE= 4096 3.4.1core-site.xml 注意fs.default.name属性要正确配置,该属性用于配置namenode节点,我们都知道一个hadoop系统中一般只有一个namenode节点管理所有的datanode,所以设置一定要正确:hdfs://master:9000。一般默认都是9000端口 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 <?xmlversion= "1.0" ?> <?xml-stylesheettype= "text/xsl" href= "configuration.xsl" ?> <!--Putsite-specificpropertyoverrides in this file.--> <configuration> <property> <name>fs. default .name</name> <value>hdfs: //master:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/data0/hadoop/tmp</value> </property> <property> <name>io.file.buffer.size</name> <value> 65536 </value> </property> </configuration> 3.4.2hdfs-site.xml dfs.replication属性,顾名思义表示指定的hadoop文件块的备份数量,一般默认是3份,可以设为1 dfs.name.dir属性,非常重要,用来设置存放namenode数据的目录,如果这个目录访问失败,则会导致namenode启动失败 dfs.data.dir属性,用来指定datanode上本地存放数据的目录,与namenode的设置独立没有关系 dfs.name.dir属性,非常重要,namenode用来存储永久性的元数据的目录列表。namenode在列表上的各个目录中均存放相同元数据文件,如果这个目录访问失败,则会导致namenode启动失败 dfs.data.dir属性,用来指定datanode上本地存放数据块的目录列表,与namenode的设置独立没有 关系 fs.checkpoint.dir属性,辅助namenode存放检查点的目录列表。在所列的每个目录中均存放一份检查点文件副本 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 <?xmlversion= "1.0" ?> <?xml-stylesheettype= "text/xsl" href= "configuration.xsl" ?> <!--Putsite-specificpropertyoverrides in this file.--> <configuration> <property> <name>dfs.name.dir</name> <value>/data0/hadoop/dfs/name</value> </property> <property> <name>dfs.data.dir</name> </property> <property> <name>fs.checkpoint.dir</name> <value>/data0/hadoop/dfs/namesecondary</value> </property> <property> <name>fs.checkpoint.period</name> <value> 600 </value> <description>Thenumberofsecondsbetweentwoperiodiccheckpoints.</description> </property> <property> <name>dfs.namenode.handler.count</name> <value> 20 </value> <description>Thenumberofserverthreads for thenamenode.</description> </property> <property> <name>dfs.replication</name> <value> 2 </value> </property> <property> <name>dfs.datanode.du.reserved</name> <value> 32212254720 </value> <description>(30GB)Reservedspace in bytespervolume.Alwaysleave this muchspacefree for nondfs use .</description> </property> <property> <name>dfs.datanode.max.xcievers</name> <value> 4096 </value> <description>Thenumberofserverthreads for thedatanode.</description> </property> <property> <name>fs.trash.interval</name> <value> 300 </value> <description>time in minutes, 300 means 5 hours</description> </property> <property> <name>dfs.http.address</name> <!-- Thisshouldonlybe set onmaster Causeweneedtoaccesstheweb interface ofnamenode&jobtracker for WLAN <value>dcnamenode1: 50070 </value> --> <value> 0.0 . 0.0 : 50070 </value> </property> <property> <name>dfs.secondary.http.address</name> <value>slave-two: 50090 </value> </property> <property> <name>dfs.balance.bandwidthPerSec</name> <value> 5242880 </value> <description>Defaultvalue is 1048576 (1mb),that 'stooslow,setitto5242880(5mb).Wecann' t set ittoahighvalue,e.g.20mb, this willaffecttheexecutionofmap/reducetask.</description> </property> <property> <name>dfs.hosts.exclude</name> <value>/home/hadoop/hadoop- 1.0 . 4 /conf/exclude_hosts</value> <description>Namesafilethatcontainsalistofhoststhatare notpermittedtoconnecttothenamenode.Thefullpathnameofthe filemustbespecified.Ifthevalue is empty,nohostsare excluded.</description> </property> </configuration> 3.4.3mapred-site.xml mapred.jop.tracker属性用来设置JobTracker的主机、IP地址和端口,本机的话可以设置为:master:9001 maped.local.dir属性,逗号分隔的目录名称,默认值${hadoop.tmp.dir}/mapred.local。存储作业的中间数据的目录列表。作业终止时,数据被清除 maped.system.dir属性,类型为URI,默认值${hadop.tmp.dir}/mapred/system。在作业运行期间存储共享文件的目录,相对于fs.default.name maped.task tracker.map.tasks.maximum属性,类型为int,默认值为2,在任一时刻。允许在tasktracker上运行的map任务的最大数量 mapred.tasktracker.reduce.tasks.maximum属生,类型为string,默认值为-Xmx200m。JVM选项,用于启动运行map和reduce任务的tasktracker子进程。该属性可以针对每个作业进行设置。例如,可以设置JVM属性,支支技调试 mapreduce.map.java.opts属性,类型为String,默认值-Xmx200m。JVM选项,针对运行map的任务的子进程(在1.x版本中不出现) mapreduce.reduce.java.opts属性,类型为String,默认值-Xmx200m。JVM选项,针对运行reduce任务的子进程(在1.x版本中不出现) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 <?xmlversion= "1.0" ?> <?xml-stylesheettype= "text/xsl" href= "configuration.xsl" ?> <!--Putsite-specificpropertyoverrides in this file.--> <configuration> <property> <name>mapred.job.tracker</name> <value>master: 9001 </value> </property> <property> <name>mapred.job.tracker.http.address</name> <value> 0.0 . 0.0 : 50030 </value> </property> <property> <name>mapred.local.dir</name> <value>/data0/hadoop/mapred/map_loc</value> </property> <property> <name>mapred.system.dir</name> <value>/hadoop/mapred/system</value> </property> <property> <name>mapreduce.jobtracker.staging.root.dir</name> <value>/hadoop/mapred/staging</value> </property> <property> <name>mapred.job.tracker.handler.count</name> <value> 20 </value> </property> <property> <name>mapred.acls.enabled</name> <value> false </value> </property> <property> <name>mapred.tasktracker.map.tasks.maximum</name> <value> 8 </value> </property> <property> <name>mapred.tasktracker.reduce.tasks.maximum</name> <value> 4 </value> </property> <property> <name>mapred.child.java.opts</name> <value>-Xmx2048M-Xms512M</value> </property> <property> <name>io.sort.mb</name> <value> 320 </value> </property> <property> <name>io.sort.factor</name> <value> 50 </value> </property> <property> <name>mapred.reduce.slowstart.completed.maps</name> <value> 0.80 </value> </property> </configuration> 3.4.4masters 运行辅助namenode的机器列表(每行一个) 1 slave-two 3.4.5slavees 运行datanode和tasktracker的机器列表(每行一个) 1 2 slave-one slave-two 3.5 另外两台机器配置 3.5.1 把maseter下/usr/local/hadoop-1.0.4,/usr/local/jdk1.7.0_25,/etc/这两个目录和/etc/profile.d/hadoop.sh,/etc/profile.d/java.sh复制到另外两台机器,注意改好hadoop权限 1 2 3 4 [hadoop@masterlocal]$scp-r/etc/profile.d/java.shroot@ 10.1 . 2.215 :/etc/profile.d/ [hadoop@masterlocal]$scp-r/etc/profile.d/java.shroot@ 10.1 . 2.215 :/etc/profile.d/ [hadoop@masterlocal]$scp-r/usr/local/hadoop- 1.0 . 4 root@ 10.1 . 2.216 :/usr/local/ [hadoop@masterlocal]$scp-rusr/local/jdk1. 7 .0_25root@ 10.1 . 2.216 :/usr/local/jdk1. 7 .0_25 3.6 格式化名称节点 以hadoop用户运行如下命令 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 [hadoop@masterroot]$hadoopnamenode-format 16 / 01 / 08 19 : 11 : 37 INFOnamenode.NameNode:STARTUP_MSG: /************************************************************ STARTUP_MSG:StartingNameNode STARTUP_MSG:host=master/10.1.2.214 STARTUP_MSG:args=[-format] STARTUP_MSG:version=1.0.4 STARTUP_MSG:build=https://svn.apache.org/repos/asf/hadoop/common/branches/branch-1.0-r1393290;compiledby'hortonfo'onWedOct305:13:58UTC2012 ************************************************************/ 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet:VMtype= 64 -bit 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet: 2 %maxmemory= 19.815 MB 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet:capacity= 2 ^ 21 = 2097152 entries 16 / 01 / 08 19 : 11 : 37 INFOutil.GSet:recommended= 2097152 ,actual= 2097152 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:fsOwner=hadoop 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:supergroup=supergroup 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:isPermissionEnabled= true 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:dfs.block.invalidate.limit= 100 16 / 01 / 08 19 : 11 : 37 INFOnamenode.FSNamesystem:isAccessTokenEnabled= false accessKeyUpdateInterval= 0 min(s),accessTokenLifetime= 0 min(s) 16 / 01 / 08 19 : 11 : 37 INFOnamenode.NameNode:Cachingfilenamesoccuringmorethan 10 times 16 / 01 / 08 19 : 11 : 37 ERRORnamenode.NameNode:java.io.IOException:Cannotcreatedirectory/data0/hadoop/dfs/name/current atorg.apache.hadoop.hdfs.server.common.Storage$StorageDirectory.clearDirectory(Storage.java: 297 ) atorg.apache.hadoop.hdfs.server.namenode.FSImage.format(FSImage.java: 1320 ) atorg.apache.hadoop.hdfs.server.namenode.FSImage.format(FSImage.java: 1339 ) atorg.apache.hadoop.hdfs.server.namenode.NameNode.format(NameNode.java: 1164 ) atorg.apache.hadoop.hdfs.server.namenode.NameNode.createNameNode(NameNode.java: 1271 ) atorg.apache.hadoop.hdfs.server.namenode.NameNode.main(NameNode.java: 1288 ) 16 / 01 / 08 19 : 11 : 37 INFOnamenode.NameNode:SHUTDOWN_MSG: /************************************************************ SHUTDOWN_MSG:ShuttingdownNameNodeatmaster/10.1.2.214 ************************************************************/ 提示出错,无法创建/data0/hadoop目录,由此在三台机集事先创建/data0/hadoop目录并赋值于属主属组hadoop,再来执行 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 [hadoop@masterdata0]$hadoopnamenode-format 16 / 01 / 08 19 : 34 : 30 INFOnamenode.NameNode:STARTUP_MSG: /************************************************************ STARTUP_MSG:StartingNameNode STARTUP_MSG:host=master/10.1.2.214 STARTUP_MSG:args=[-format] STARTUP_MSG:version=1.0.4 STARTUP_MSG:build=https://svn.apache.org/repos/asf/hadoop/common/branches/branch-1.0-r1393290;compiledby'hortonfo'onWedOct305:13:58UTC2012 ************************************************************/ 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet:VMtype= 64 -bit 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet: 2 %maxmemory= 19.815 MB 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet:capacity= 2 ^ 21 = 2097152 entries 16 / 01 / 08 19 : 34 : 30 INFOutil.GSet:recommended= 2097152 ,actual= 2097152 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:fsOwner=hadoop 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:supergroup=supergroup 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:isPermissionEnabled= true 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:dfs.block.invalidate.limit= 100 16 / 01 / 08 19 : 34 : 30 INFOnamenode.FSNamesystem:isAccessTokenEnabled= false accessKeyUpdateInterval= 0 min(s),accessTokenLifetime= 0 min(s) 16 / 01 / 08 19 : 34 : 30 INFOnamenode.NameNode:Cachingfilenamesoccuringmorethan 10 times 16 / 01 / 08 19 : 34 : 30 INFOcommon.Storage:Imagefileofsize 112 saved in 0 seconds. 16 / 01 / 08 19 : 34 : 30 INFOcommon.Storage:Storagedirectory/data0/hadoop/dfs/namehasbeensuccessfullyformatted. 16 / 01 / 08 19 : 34 : 30 INFOnamenode.NameNode:SHUTDOWN_MSG: /************************************************************ SHUTDOWN_MSG:ShuttingdownNameNodeatmaster/ 10.1 . 2.214 ************************************************************ 出现“Storage directory /data0/hadoop/dfs/name has been successfully formatted.”一行信息表明对应的存储已经格式化成功。 3.7 启动hadoop 1 2 3 4 5 6 7 8 9 10 [hadoop@masterdata0]$start-dfs.sh startingnamenode,loggingto/data0/hadoop/logs/hadoop-hadoop-namenode-master.out 10.1 . 2.216 :startingdatanode,loggingto/data0/hadoop/logs/hadoop-hadoop-datanode-slave-two.out 10.1 . 2.215 :startingdatanode,loggingto/data0/hadoop/logs/hadoop-hadoop-datanode-slave-one.out 10.1 . 2.216 :startingsecondarynamenode,loggingto/data0/hadoop/logs/hadoop-hadoop-secondarynamenode-slave-two.out [hadoop@masterdata0]$start-mapred.sh startingjobtracker,loggingto/data0/hadoop/logs/hadoop-hadoop-jobtracker-master.out 10.1 . 2.216 :startingtasktracker,loggingto/data0/hadoop/logs/hadoop-hadoop-tasktracker-slave-two.out 10.1 . 2.215 :startingtasktracker,loggingto/data0/hadoop/logs/hadoop-hadoop-tasktracker-slave-one.out 也可以start-all.sh来执行 3.8 运行jps命令查看正在运行的Hadoop进程 1 2 3 [hadoop@masterdata0]$jps|grep-iv "jps" 30772 NameNode 30960 JobTracker 1 2 3 4 [hadoop@slave-oneconf]$jps 27826 TaskTracker 27311 DataNode 28640 Jps 1 2 3 4 [hadoop@slave-twoconf]$jps|grep-vijps 12359 SecondaryNameNode 12773 TaskTracker 12268 DataNode 3.9 Hadoop守护进程的地址和端口 Hadoop守护进程一般同时运行RPC和HTTP两个服务器,RPC服务器支技守护进程间的通信,HTTP服务器则提供与用户交互的Web页面。 3.9.1 RPC服务器属性 fs.default.name属性,默认值file:///。被设为一个HDFS的URI时,该属性描述namenode的RPC服务器地址和端口,若未指定,默认8080端口 dfs.datanode.ipc.address属性,默认值0.0.0.0:50020。datanode的RPC服务器地址和端口 mapred.job.tracker属性,默认值local。被设为主机名称和端口号时,该属性指定jobtracker的RPC服务器地址和端口。常用端口号8021 mapred.taksk.tracker.report.address属性,默认值127.0.0.1:0。trakstracker的RPC服务器地址和端口号,tasktracker的子JVM利用它和tasktracker通信。在本例中,使用任一空闲端口均可行的。因为服务器仅绑定回送地址。仅当本机没有回送地址时才需要变更默认设置。 3.9.1 HTTP服务器的属性 mapred.job.tracker.http.address,默认值0.0.0.0:50030。jobtarcker的HTTP服务器地址和端口 mapred.task.tracker.http.address,默认值0.0.0.0:50060。tasktracker的HTTP服务器地址和端口 dfs.http.address,默认值0.0.0.0:50070。namenode的HTTP服务器地址和端口 dfs.datanode.http.address,默认值0.0.0.0:50075。datanode的HTTP服务器地址和端口 dfs.secondary.http.address,默认值0.0.0.0:50090。辅助namenode的HTTP服务器地址和端口 4.jobtracker界面 5.Namenode界面 本文转自 zouqingyun 51CTO博客,原文链接:http://blog.51cto.com/zouqingyun/1732659,如需转载请自行联系原作者