首页 文章 精选 留言 我的

精选列表

搜索[notepad  ],共10025篇文章
优秀的个人博客,低调大师

分布式处理与大数据平台(RabbitMQ&Celery&Hadoop&Spark&Storm&Elasticsearch)

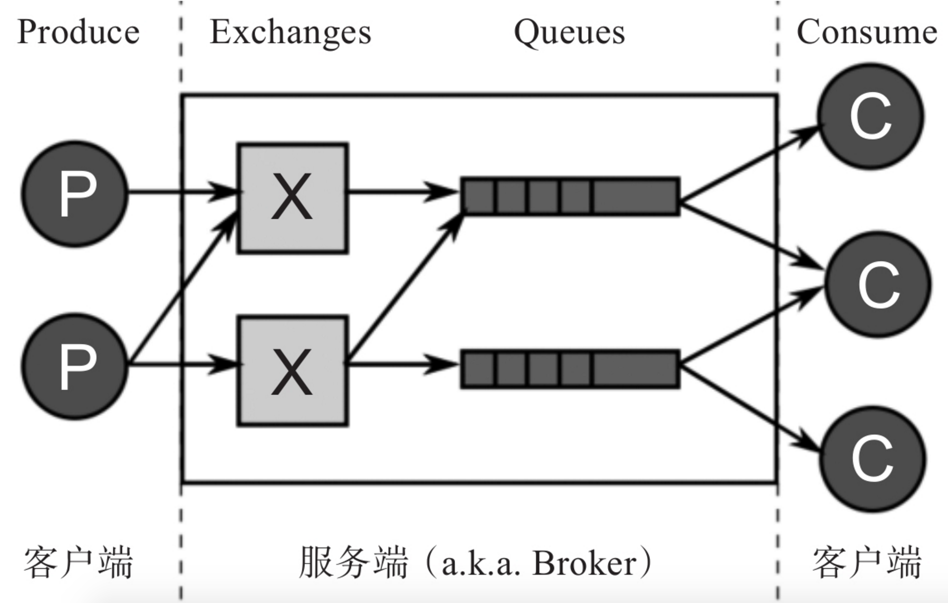
热门的消息队列中间件RabbitMQ,分布式任务处理平台Celery,大数据分布式处理的三大重量级武器:Hadoop、Spark、Storm,以及新一代的数据采集和分析引擎Elasticsearch。 RabbitMQ RabbitMQ是一个支持Advanced Message Queuing Protocol(AMQP)的开源消息队列实现,由Erlang编写,因以高性能、高可用以及可伸缩性出名。它支持多种客户端,如:Java、Python、PHP、.NET、Ruby、JavaScript等。它主要用于在分布式系统中存储和转发消息,方便组件之间的解耦,消息的发送者无需知道消息使用者的存在,反之亦然。 AMQP架构中有两个主要组件:Exchange和Queue,两者都在服务端,又称Broker,由RabbitMQ实现的。客户端通常有Producer和Consumer两种类型。 在使用RabbitMQ过程中需要注意的是,它将数据存储在Node中,默认情况为hostname。因此在使用docker run指令运行容器的时候,应该通过-h/--hostname参数指定每一个rabbitmq daemon运行的主机名。这样就可以轻松地管理和维护数据了: $ docker run -d --hostname my-rabbit --name some-rabbit rabbitmq:3 3f28f6290e05375363ee661151170d37fbc89ada004c3235f02997b711b4cb2b 用户使用rabbitmqctl工具进行远程管理,或跨容器管理的时候,会需要设置持久化的cookie。这里可以使用RABBITMQ_ERLANG_COOKIE参数进行设置: $ docker run -d --hostname my-rabbit --name some-rabbit -e RABBITMQ_ERLANG_COOKIE='secret cookie here'rabbitmq:3 使用cookie连接至一个独立的实例: $ docker run -it --rm --link some-rabbit:my-rabbit -e RABBITMQ_ERLANG_COOKIE='secret cookie here'rabbitmq:3 bash root@f2a2d3d27c75:/# rabbitmqctl -n rabbit@my-rabbit list_users Listing users ... guest [administrator] 同样,用户也可以使用RABBITMQ_NODENAME简化指令: $ docker run -it --rm --link some-rabbit:my-rabbit -e RABBITMQ_ERLANG_COOKIE='secret cookie here'-e RABBITMQ_NODENAME=rabbit@my-rabbit rabbitmq:3 bash root@f2a2d3d27c75:/# rabbitmqctl list_users Listing users ... guest [administrator] 默认情况下,rabbitmq会安装并启动一些管控插件,如rabbitmq:3-management。通常可以通过默认用户名密码以及标准管控端口15672访问这些插件: $ docker run -d --hostname my-rabbit --name some-rabbit rabbitmq:3-management 用户可以通过浏览器访问http://container-ip:15672,如果需要从宿主机外访问,则使用8080端口: $ docker run -d --hostname my-rabbit --name some-rabbit -p 8080:15672 rabbitmq:3-management 如果需要修改默认用户名与密码(guest:guest),则可以使用RABBITMQ_DEFAULT_USER和RABBITMQ_DEFAULT_PASS环境变量: $ docker run -d --hostname my-rabbit --name some-rabbit -e RABBITMQ_DEFAULT_USER=user -e RABBITMQ_DEFAULT_PASS=password rabbitmq:3-management 如果需要修改默认vhost,可以修改RABBITMQ_DEFAULT_VHOST环境变量: $ docker run -d --hostname my-rabbit --name some-rabbit -e RABBITMQ_DEFAULT_VHOST=my_vhost rabbitmq:3-management 然后连接至daemon: $ docker run --name some-app --link some-rabbit:rabbit -d application-that-uses-rabbitmq 用户也可以访问官方镜像仓库,并对Dockerfile进行更多定制。 Celery 除了通用的消息队列外,任务队列在分布式处理中也十分重要。任务队列的输入是工作的一个单元,称为任务,有多个工作者监听队列来获取任务并执行。 Celery是一个简单、灵活、高可用、高性能的开源(BSD许可)分布式任务处理系统,专注于实时处理的任务队列管理,同时也支持任务调度。Celery基于Python实现,跟包括Django、Pyramid、Pylons、Flask、Tornado等Web框架都无缝集成,有庞大的用户与贡献者社区。Celery可以单机运行,也可以在多台机器上运行,甚至可以跨越数据中心运行。 1.使用官方镜像 启动一个celery worker,即RabbitMQ Broker: $ docker run --link some-rabbit:rabbit --name some-celery -d celery:latest 检查集群状态: $ docker run --link some-rabbit:rabbit --rm celery celery status 启动一个celery worker,即Redis Broker: $ docker run --link some-redis:redis -e CELERY_BROKER_URL=redis://redis --namesome-celery -d celery 检查集群状态: $ docker run --link some-redis:redis -e CELERY_BROKER_URL=redis://redis --rmcelery celery status 2.使用Celery库 如果用户使用的框架已有Celery库,那么使用起来会更方便。 下面是Python中调用Celery的hello world程序: from celery import Celery app = Celery('hello', broker='amqp://guest@localhost//') @app.task def hello(): return 'hello world' Hadoop 作为当今大数据处理领域的经典分布式平台,Apache Hadoop主要基于Java语言实现,由三个核心子系统组成:HDFS、YARN、MapReduce,其中,HDFS是一套分布式文件系统;YARN是资源管理系统,MapReduce是运行在YARN上的应用,负责分布式处理管理。如果从操作系统的角度看,HDFS相当于Linux的ext3/ext4文件系统,而Yarn相当于Linux的进程调度和内存分配模块。 1.使用官方镜像 可以通过docker run指令运行镜像,同时打开bash命令行,如下所示: $ docker run -it sequenceiq/hadoop-docker:2.7.0 /etc/bootstrap.sh -bash bash-4.1# 此时可以查看各种配置信息和执行操作,例如查看namenode日志等信息: bash-4.1# cat /usr/local/hadoop/logs/hadoop-root-namenode-d4e1e9d8f24f.out ulimit -a for user root core file size (blocks, -c) 0 data seg size (kbytes, -d) unlimited scheduling priority (-e) 0 file size (blocks, -f) unlimited pending signals (-i) 7758 max locked memory (kbytes, -l) 64 max memory size (kbytes, -m) unlimited open files (-n) 1048576 pipe size (512 bytes, -p) 8 POSIX message queues (bytes, -q) 819200 real-time priority (-r) 0 stack size (kbytes, -s) 8192 cpu time (seconds, -t) unlimited max user processes (-u) unlimited virtual memory (kbytes, -v) unlimited file locks (-x) unlimited 2.安装验证 需要验证Hadoop环境是否安装成功。打开容器的bash命令行环境,进入Hadoop目录: bash-4.1# cd $HADOOP_PREFIX bash-4.1# pwd /usr/local/hadoop 然后通过运行Hadoop内置的实例程序来进行测试: bash-4.1# bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.0.jargrep input output'dfs[a-z.]+' 16/08/31 10:00:11 INFO client.RMProxy: Connecting to ResourceManager at /0.0.0.0:8032 16/08/31 10:00:15 INFO input.FileInputFormat: Total input paths to process : 31 16/08/31 10:00:16 INFO mapreduce.JobSubmitter: number of splits:31 ... 最后可以使用hdfs指令检查输出结果: bash-4.1# bin/hdfs dfs -cat output/* Spark Apache Spark是一个围绕速度、易用性和复杂分析构建的大数据处理框架,基于Scala开发。最初在2009年由加州大学伯克利分校的AMPLab开发,并于2010年成为Apache的开源项目之一。与Hadoop和Storm等其他大数据和MapReduce技术相比,Spark支持更灵活的函数定义,可以将应用处理速度提升一到两个数量级,并且提供了众多方便的实用工具,包括SQL查询、流处理、机器学习和图处理等。 Spark体系架构包括如下三个主要组件:数据存储、API、管理框架,如图13-3所示。 1.使用官方镜像 用户可以使用sequenceiq/spark镜像,版本方面支持Hadoop 2.6.0,Apache Spark v1.6.0(CentOS)。同时此镜像还包含Dockerfile,用户可以基于它构建自定义的Apache Spark镜像。 用户使用docker pull指令直接获取镜像: $ docker pull sequenceiq/spark:1.6.0 也可以使用docker build指令构建spark镜像: $ docker build --rm -t sequenceiq/spark:1.6.0 . 另外,用户在运行容器时,需要映射YARN UI需要的端口: $ docker run -it -p 8088:8088 -p 8042:8042 -h sandbox sequenceiq/spark:1.6.0 bash 启动后,可以使用bash命令行来查看namenode日志等信息: bash-4.1# cat /usr/local/hadoop/logs/hadoop-root-namenode-sandbox.out 2.验证 基于YARN部署Spark系统时,用户有两种部署方式可选:YARN客户端模式和YARN集群模式。 下面分别论述两种部署方式。 1.YARN客户端模式 在YARN客户端模式中,SparkContext(或称为驱动程序,driver program)运行在客户端进程中,应用的master仅处理来自YARN的资源管理请求: #运行spark shell spark-shell \ --master yarn-client \ --driver-memory 1g \ --executor-memory 1g \ --executor-cores 1 #执行以下指令,若返回1000则符合预期 scala> sc.parallelize(1 to 1000).count() 2.YARN集群模式 在YARN集群模式中,Spark driver驱动程序运行于应用master的进程中,即由YARN从集群层面进行管理。 下面,用户以Pi值计算为例子,展现两种模式的区别: Pi计算(YARN集群模式): #执行以下指令,成功后,日志中会新增记录"Pi is roughly 3.1418" #集群模式下用户必须制定--files参数,以开启metrics spark-submit \ --class org.apache.spark.examples.SparkPi \ --files $SPARK_HOME/conf/metrics.properties \ --master yarn-cluster \ --driver-memory 1g \ --executor-memory 1g \ --executor-cores 1 \ $SPARK_HOME/lib/spark-examples-1.6.0-hadoop2.6.0.jar Pi计算(YARN客户端模式): #执行以下指令,成功后,命令行将显示"Pi is roughly 3.1418" spark-submit \ --class org.apache.spark.examples.SparkPi \ --master yarn-client \ --driver-memory 1g \ --executor-memory 1g \ --executor-cores 1 \ $SPARK_HOME/lib/spark-examples-1.6.0-hadoop2.6.0.jar 3.容器外访问Spark 如果需要从容器外访问Spark环境,则需要设置YARN_CONF_DIR环境变量。只能使用根用户访问Docker的HDFS环境。 yarn-remote-client文件夹内置远程访问的配置信息: export YARN_CONF_DIR="`pwd`/yarn-remote-client" 当用户从容器集群外部,使用非根用户访问Spark环境时,则需要配置HADOOP_USER_NAME环境变量: export HADOOP_USER_NAME=root Storm Apache Storm是一个实时流计算框架,由Twitter在2014年正式开源,遵循Eclipse Public License 1.0。Storm基于Clojure等语言实现。 Storm集群与Hadoop集群在工作方式上十分相似,唯一区别在于Hadoop上运行的是MapReduce任务,在Storm上运行的则是topology。MapReduce任务完成处理即会结束,而topology则永远在等待消息并处理(直到被停止)。 使用Compose搭建Storm集群 利用Docker Compose模板,用户可以在本地单机Docker环境快速地搭建一个Apache Storm集群,进行应用开发测试。 1.Storm示例架构,Storm架构图。 其中包含如下容器: ·Zookeeper:Apache Zookeeper三节点部署。 ·Nimbus:Storm Nimbus。 ·Ui:Storm UI ·Supervisor:Storm Supervisor(一个或多个)。 ·Topology:Topology部署工具,其中示例应用基于官方示例storm-starter代码构建。 2.本地开发测试 首先从Github下载需要的代码: $ gitclonehttps://github.com/denverdino/docker-storm.git $ cd docker-swarm/local 代码库中的docker-compose.yml文件描述了典型的Storm应用架构。 用户可以直接运行下列命令构建测试镜像: $ docker-compose build 现在可以用下面的命令来一键部署一个Storm应用: $ docker-compose up -d 当UI容器启动后,用户可以访问容器的8080端口来打开操作界面。 利用如下命令,可以伸缩supervisor的数量,比如伸缩到3个实例: $ docker-compose scale supervisor=3 用户也许会发现Web界面中并没有运行中的topology。这是因为Docker Compose目前只能保证容器的启动顺序,但是无法确保所依赖容器中的应用已经完全启动并可以被正常访问了。为了解决这个问题,需要运行下面的命令来再次启动topolgoy服务应用来提交更新的拓扑: $ docker-compose start topology 稍后刷新Storm UI,可以发现Storm应用已经部署成功了。 Elasticsearch Elasticsearch是一个基于Lucene的开源搜索服务器,主要基于Java实现。它提供了一个分布式的,多租户的全文搜索引擎,内含RESTful web接口。 Elasticsearch提供了实时的分布式数据存储和分析查询功能,很容易扩展到上百台服务器,支持处理PB级结构化或非结构化数据。配合Logstash、Kibana等组件,可以快速构建一套对日志消息的分析平台。 可以使用官方镜像,快速运行Elasticsearch容器: $ docker run -d elasticsearch 也可以在启动时传入一些额外的配置参数: $ docker run -d elasticsearch elasticsearch -Des.node.name="TestNode" 目前使用的镜像内含默认配置文件,包含了预先定义好的默认配置。 如果用户要使用自定义配置,可以使用数据卷,挂载自定义配置文件至/usr/share/elasticsearch/config: $ docker run -d -v "$PWD/config":/usr/share/elasticsearch/config elasticsearch 如果需要数据持久化,可以使用数据卷指令,挂载至/usr/share/elasticsearch/data: $ docker run -d -v "$PWD/esdata":/usr/share/elasticsearch/data elasticsearch 此镜像会暴露9200 9300两个默认的HTTP端口,可以通过此端口进行服务访问。9200端口是对外提供服务的API使用的端口。9300端口是内部通信端口,这些通信包括心跳,集群内部信息同步。 小结 分布式处理与大数据处理领域的典型热门工具,包括Rabbitmq、Celery、Hadoop、Spark、Storm和Elasticsearch等。这些开源项目的出现,极大降低了开发者进行分布式处理和数据分析的门槛。 实际上,摩尔定律的失效,必将导致越来越多的复杂任务必须采用分布式架构进行处理。在新的架构和平台下,如何实现高性能、高可用性,如何让应用容易开发、方便调试,都是十分复杂的问题。已有的开源平台项目提供了很好的实现参考,方便用户将更多的精力放到核心业务的维护上。通过基于容器的部署和使用,极大简化了对如此复杂系统的使用和维护。

优秀的个人博客,低调大师

java并发编程笔记3-同步容器&并发容器&闭锁&栅栏&信号量

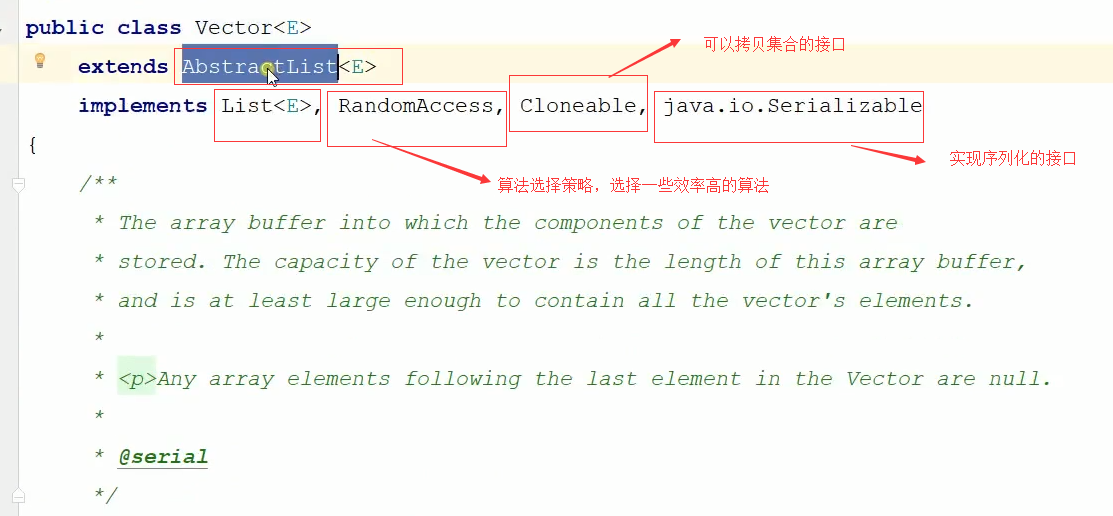
一.同步容器: 1.Vector容器实现了List接口,Vector实际上就是一个数组,和ArrayList类似,但是Vector中的方法都是synchronized方法,即进行了同步措施。保证了线程安全。源码如下图: 可以看到这些方法都加了synchronized。即加了同步操作。 2.Hashtable集合。HashTable实现了Map接口,它和HashMap很相似,但是HashTable进行了同步处理,而HashMap没有源码如下: 可以看到HashTable的实现方法也用到了synchronized同步。 3.Collections类中提供的静态工厂方法创建的类,在Collections类中提供了大量的方法,比如对集合或者容器进行排序、查找等操作。最重要的是,在它里面提供了几个静态工厂方法来创建同步容器类;源码如下图: 可以看到Collection类的静态工厂方法的内部实现也是使用了synchronized同步。 同步容器都是线程安全的。但是对于复合操作(迭代、缺少即加入、导航:根据一定的顺序寻找下一个元素),有时可能需要使用额外的客户端加锁进行保护。在一个同步容器中,复合操作是安全的。但是当其他线程能够并发修改容器的时候,它们就可能不会按照期望工作了。 例如: 几个单局语句是原子性的,但是一复合就不是在原子性的了。因为几条原子性的语句合起来就存在了时间差,这就出现线程安全的问题了,因为当一个线程进行删除容器中某个元素时,另外一个线程比这个线程已经先一步删除了该元素,这是导致抛出并发修改异常。 注意,并不是多线程才出现并发修改异常,单线程也会,比如,一个List,用iterator进行迭代,然后你没用iterator.remove()方法,而是直接用list.remove()方法就会发生并发修改异常。 这是就要手工 进行加synchronized了,如下: 有一些原因造成我们不愿意在迭代期间对容器加锁,当其它线程需要访问容器时,必须等待,直到迭代结束,如果容器很大,或者对每一个元素执行的任务耗时比较长,它们可能需要等待很长一段时间。另外,如果对元素的操作还要持有另一个锁,这是一个产生死锁风险的因素。在迭代期间,对容器加锁的一个替代方法是复制容器,因为复制是线程限制的,没有其他的线程能够在迭代期间对其进行修改,这样就消除了ConcurrentModificationException发生的可能性。但是如果容器非常大,复制起来这就非常消耗性能。 同步容器中的方法采用了synchronized进行了同步,这必然会影响到执行性能.同步容器将所有对容器状态的访问都串行化了,这样保证了线程的安全性,但代价就是严重降低了并发性,当多个线程竞争容器时,吞吐量严重降低。 二.并发容器 java5.0开始针对多线程并发访问设计,提供了并发性能较好的并发容器,引入了java.util.concurrent包。主要解决了两个问题: 1).根据具体场景进行设计,尽量避免synchronized,提供并发性。 2).定义了一些并发安全的复合操作,并且保证并发环境下的迭代操作不会出错。 1.ConcurrentHashMap并发容器,来替代同步的哈希Map实现。ConcurrentHashMap实现采用了散列机制,但是采用了分段锁(Lock Striping)机制提供了并发性能。其内部的结构可以让其在进行写操作的时候能够将锁的粒度保持地尽量地小,不用对整个ConcurrentHashMap加锁。 ConcurrentHashMap是由Segment数组结构和HashEntry数组结构组成,分段锁是对Segments中每一个Segment加锁,Segment是一种可重入锁ReentrantLock,在ConcurrentHshMap里扮演锁的角色,HashEntry则用于存储键值对数据。一个ConcurrentHashMap里包含一个Segment数组,Segment的结构和HashMap类似,是一种数组和链表结构,一个Segment里包含一个HashEntry数组,每一个HashEntry是一个链表结构的元素,每个Segment守护着HashEntry数组里的元素,当对HashEntry数组的数据进行修改时,必须首先获得它对应的Segment的锁。 并发环境下实现更的吞吐量,而在单线程环境下只损失非常小的性能。ConcurrentHashMap结构如下图: 没有则增加: V putIfAbsent(key,value):表示如果不存在(新的entry),那么会向map中添加该键值对,并返回null。 如果已经存在,那么不会覆盖已有的值,直接返回已经存在的值。 相等则移除: boolean remove(Object key, Object value) :当key对应到指定的value时,才移除该key-value对。 相等则替换: boolean replace(K key, V oldValue, V newValue) :当key对应到指定的value时,才替换key对应的value值。 拥有则替换: V replace(K key,V value):只有目前将键的条目映射到某一值时,才替换该键的条目。 1.1ConcurrentHashMap的使用注意项目 ConcurrentHashMap 虽然为并发安全的组件,但是使用不当还是会导致程序错误,通过使用简单的案例来复现这些问题并给出开发时候如何进行避免的策略。 这里借用直播的一个场景,直播业务中,每个直播间对应一个 topic,每个用户进入直播间时候会把自己设备 id 绑定到这个 topic 上,也就是一个 topic 对应一堆用户设备,可知可以使用 map 来维护这些信息,key 为 topic,value 为设备的 list。下面通过代码模拟多用户同时进入直播间时候 map 信息的维护,代码如下: public class ConcurrentHashMapTest { //(1)创建map,key为topic,value为设备列表 static ConcurrentHashMap<String, List<String>> map = new ConcurrentHashMap<String, List<String>>(); public static void main(String[] args) { //(2)进入直播间topic1 线程one Thread threadOne = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device1"); list1.add("device2"); map.put("topic1", list1); System.out.println(JSON.toJSONString(map)); } }); //(3)进入直播间topic1 线程two Thread threadTwo = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device11"); list1.add("device22"); map.put("topic1", list1); System.out.println(JSON.toJSONString(map)); } }); //(4)进入直播间topic2 线程three Thread threadThree = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device111"); list1.add("device222"); map.put("topic2", list1); System.out.println(JSON.toJSONString(map)); } }); //(5)启动线程 threadOne.start(); threadTwo.start(); threadThree.start(); } } 运行结果如下: 或者如下的运行结果: 可知 topic1 房间中的用户会丢失一部分,这是因为 put 方法如果发现 map 里面存在这个 key, 则使用 value 覆盖该 key 对应的老的 value 值,而 putIfAbsent 方法则如果已经存在该 key 则返回该 key 对应的 value 并不进行覆盖,如果不存在则会新增该 key,并且判断和写入是原子性操作。使用 putIfAbsent 替代 put 方法后代码如下: public class ConcurrentHashMapTest1 { //(1)创建map,key为topic,value为设备列表 static ConcurrentHashMap<String, List<String>> map = new ConcurrentHashMap<String, List<String>>(); public static void main(String[] args) { //(2)进入直播间topic1 线程one Thread threadOne = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device1"); list1.add("device2"); //(2.1) List<String> oldList = map.putIfAbsent("topic1", list1); if(null != oldList){ oldList.addAll(list1); } System.out.println(JSON.toJSONString(map)); } }); //(3)进入直播间topic1 线程two Thread threadTwo = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device11"); list1.add("device22"); List<String> oldList = map.putIfAbsent("topic1", list1); if(null != oldList){ oldList.addAll(list1); } System.out.println(JSON.toJSONString(map)); } }); //(4)进入直播间topic2 线程three Thread threadThree = new Thread(new Runnable() { public void run() { List<String> list1 = new ArrayList<String>(); list1.add("device111"); list1.add("device222"); List<String> oldList = map.putIfAbsent("topic2", list1); if(null != oldList){ oldList.addAll(list1); } System.out.println(JSON.toJSONString(map)); } }); //(5)启动线程 threadOne.start(); threadTwo.start(); threadThree.start(); } } 运行结果如下: 如上代码(2.1)使用 map.putIfAbsent 方法添加新设备列表,如果 topic1 在 map 中不存在则放入 topic1 和对应设备列表到 map,要注意的是这个判断不存在和放入是原子性操作,这时候放入后会返回 null。如果 topic1 已经在 map 里面存在,则调用 putIfAbsent 会返回 topic1 对应的设备里面,代码发现返回的设备列表不为 null 则把新的设备列表添加到返回的设备列表里面,从而问题得到解决。 总结:put(K key, V value) 方法如果 key 已经存在则使用 value 覆盖原来的值并返回原来的值,如果不存在则把 value 放入并返回 null。而 putIfAbsent(K key, V value) 方法如果 key 已经存在则直接返回原来对应的值并不使用 value 覆盖,如果 key 不存在则存入 value 并返回 null,另外要注意判断 key 不存在和存入是原子操作。 2.CopyOnWriteArrayList/set并发容器 CopyOnWrite容器即写时复制的容器。通俗的理解是当我们往一个容器添加元素的时候,不直接往当前容器添加,而是先将当前容器进行Copy,复制出一个新的容器,然后新的容器里添加元素,添加完元素之后,再将原容器的引用指向新的容器。 这样做的好处是我们可以对CopyOnWrite容器进行并发的读,而不需要加锁,因为当前容器不会添加任何元素。所以CopyOnWrite容器也是一种读写分离的思想,读和写不同的容器。大部分用于读操作,写操作少,因为如果的数据很大,你每次进行写操作 都要进行拷贝,重新复制一份数组,这开销很大的。 源码如下: CopyOnWrite容器有很多优点,但是同时也存在两个问题,即内存占用问题和数据一致性问题: 1.内存问题:因为CopyOnWrite的写时复制机制,所以在进行写操作的时候,内存里会同时驻扎两个对象的内存,旧的对象和新写入的对象(注意:在复制的时候只是复制容器里的引用,只是在写的时候会创建新对象添加到新容器里,而旧容器的对象还在使用,所以有两份对象内存)。 如果这些对象占用的内存比较大,比如说200M左右,那么再写入100M数据进去,内存就会占用300M,那么这个时候很有可能造成频繁的Yong GC和Full GC。 之前我们系统中使用了一个服务由于每晚使用CopyOnWrite机制更新大对象,造成了每晚15秒的Full GC,应用响应时间也随之变长。 2.数据一致性问题:CopyOnWrite容器只能保证数据的最终一致性,不能保证数据的实时一致性。 3.BlockingQueue阻塞队列并发容器:Java 5.0之后新增加了Queue(队列)和BlockingQueue(阻塞队列)。Queue的底层实现其实就是一个LinkedList。队列是典型的FIFO先进先出的实现。阻塞队列提供了很多现成的方法可以满足我们实现生产者—消费者模型。 生产者—消费者模型简单理解就是一个缓冲容器,协调生产者和消费者之间的关系。生产者生产数据扔到容器里,消费者直接从容器里消费数据,大家不需要关心彼此,只需要和容器打交道,这样就实现了生产者和消费者的解耦。 队列分为有界队列和无界队列,无界队列会因为数据的累计造成内存溢出,使用时要小心。阻塞队列有很多种实现,最常用的有ArrayBlockingQueue和LinkedBlockingQueue。 阻塞队列提供了阻塞的take和put方法,如果队列已满,那么put方法将等待队列有空间时在执行插入操作;如果队列为空,那么take方法将一直阻塞直到有元素可取。有界队列是一个强大的资源管理器,它能抑制产生过多的工作项,使程序更加健壮。 三.闭锁(CountDownLatch) 闭锁相当于一扇门,在闭锁到达结束状态之前,这扇门一直是关闭着的,没有任何线程可以通过,当到达结束状态时,这扇门才会打开并容许所有线程通过。它可以使一个或多个线程等待一组事件发生。 闭锁状态包括一个计数器,初始化为一个正式,正数表示需要等待的事件数量。countDown方法递减计数器,表示一个事件已经发生,而await方法等待计数器到达0,表示等待的事件已经发生。 CountDownLatch强调的是一个线程(或多个)需要等待另外的n个线程干完某件事情之后才能继续执行。 应用场景: 1、确保某个计算在其所有资源都被初始化之后才继续执行。二元闭锁(只有两个状态)可以用来表示“资源R已经被初始化”,而所有需要R操作都必须先在这个闭锁上等待。 2、确保某个服务在所有其他服务都已经启动之后才启动。这时就需要多个闭锁。让S在每个闭锁上等待,只有所有的闭锁都打开后才会继续运行。 3、等待直到某个操作的参与者(例如,多玩家游戏中的玩家)都就绪再继续执行。在这种情况下,当所有玩家都准备就绪时,闭锁将到达结束状态。 代码例子: public class Test2 { public static void main(String[] args) { //参数代表等待线程的数量 final CountDownLatch latch = new CountDownLatch(2); new Thread(){ @Override public void run() { try { System.out.println("子线程" + Thread.currentThread().getName() + "正在执行"); Thread.sleep(3000); System.out.println("子线程" + Thread.currentThread().getName() + "执行完毕"); //子线程完成 latch.countDown(); } catch (InterruptedException e) { e.printStackTrace(); } } }.start(); new Thread(){ public void run() { try { System.out.println("子线程" + Thread.currentThread().getName() + "正在执行"); Thread.sleep(3000); System.out.println("子线程" + Thread.currentThread().getName() + "执行完毕"); //子线程完成 latch.countDown(); } catch (InterruptedException e) { e.printStackTrace(); } } }.start(); try { System.out.println("等待2个子线程执行完毕。。。。"); //进行等待 latch.await(); System.out.println("2个子线程已经执行完毕"); System.out.println("继续执行主线程"); } catch (InterruptedException e) { e.printStackTrace(); } } } 运行结果如下: 可以看到主线程等待两个子线程执行完毕后,才能继续执行主线程。 四.栅栏 栅栏(Bariier)类似于闭锁,它能阻塞一组线程知道某个事件发生。栅栏与闭锁的关键区别在于,所有的线程必须同时到达栅栏位置,才能继续执行。闭锁用于等待等待时间,而栅栏用于等待线程。 CyclicBarrier 可以使一定数量的参与方反复的在栅栏位置汇聚,它在并行迭代算法中非常有用:将一个问题拆成一系列相互独立的子问题。当线程到达栅栏位置时,调用await() 方法,这个方法是阻塞方法, 直到所有线程到达了栅栏位置,那么栅栏被打开,此时所有线程被释放,而栅栏将被重置以便下次使用。 比方说数据写入的例子,多个子线程写数据库,必须都写完了,其他任务才能继续,如下图: public class Test3 { public static void main(String[] args) { int N = 4; CyclicBarrier barrier = new CyclicBarrier(N); for (int i = 0;i<N;i++){ new Writer(barrier).start(); } } static class Writer extends Thread{ private CyclicBarrier cyclicBarrier; public Writer(CyclicBarrier cyclicBarrier){ this.cyclicBarrier = cyclicBarrier; } @Override public void run() { System.out.println("线程"+Thread.currentThread().getName()+"正在写入数据。。。。。"); try { Thread.sleep(5000);//以睡眠来模拟写入数据操作 System.out.println("线程"+Thread.currentThread().getName()+"写入数据完毕,等待其他线程写入"); cyclicBarrier.await(); //await()的数量都达到了指定N时,才继续放行。 } catch (InterruptedException e) { e.printStackTrace(); } catch (BrokenBarrierException e) { e.printStackTrace(); } System.out.println("所有线程写入完毕,继续处理其他任务。。。。"); } } } 结果如下: 另一种形式的栅栏是Exchanger,它是一种两方(Two-Party)栅栏,各方在栅栏位置上交换数据。例如当一个线程想缓冲区写入数据,而另一个线程从缓冲区中读取数据。这些线程可以使用 Exchanger 来汇合,并将慢的缓冲区与空的缓冲区交换。当两个线程通过 Exchanger 交换对象时,这种交换就把这两个对象安全的发布给另一方。 Exchanger 可能被视为 SynchronousQueue 的双向形式。我们也可以用两个SynchronousQueue来实现 Exchanger的功能。 五。信号量 信号量用于对有限数量的资源的同时并发访问数进行控制。若有m个资源,但有n条线程(n>m),因此同一时刻只能允许m条线程访问资源,此时可以使用Semaphore控制访问该资源的线程数量。 闭锁控制访问的时间,而信号量则用来控制访问某个特定资源的操作数量,控制空间。而且闭锁只能够减少,一次性使用,而信号量则申请可释放,可增可减。 计数信号量还可以用来实现某种资源池,或者对容器施加边界。 Semaphone 管理这一组许可(permit),可通过构造函数指定。同时提供了阻塞方法acquire,用来获取许可。同时提供了release方法表示释放一个许可。 Semaphone 可以将任何一种容器变为有界阻塞容器,如用于实现资源池。例如数据库连接池。我们可以构造一个固定长度的连接池,使用阻塞方法 acquire和release获取释放连接,而不是获取不到便失败。 (当然,一开始设计时就使用BlockingQueue来保存连接池的资源是一种更简单的方法) 例子如下: public class Test3 { public static void main(String[] args) { int N = 8;//工人数 Semaphore semaphore = new Semaphore(5);//机器数 for (int i = 0;i<N;i++){ new Worker(i,semaphore).start(); } } static class Worker extends Thread{ private int num; private Semaphore semaphore; public Worker(int num,Semaphore semaphore){ this.num = num; this.semaphore = semaphore; } @Override public void run() { try { semaphore.acquire(); System.out.println("工人"+this.num+"占用一个机器在生产。。。"); Thread.sleep(2000); System.out.println("工人"+this.num+"释放机器"); semaphore.release(); } catch (InterruptedException e) { e.printStackTrace(); } } } } 运行结果如下: 可以看到信号量对有限数量的资源的同时并发访问数进行控制

优秀的个人博客,低调大师

让 ESS 更灵活的新特性:UserData &amp; KeyPair &amp; RamRole &amp; Tags

弹性伸缩(Elastic Scaling Service, ESS)是一种根据业务需求和策略,自动调整其弹性计算资源的管理服务,在满足业务需求高峰增长时无缝地增加 ECS 实例,并在业务需求下降时自动减少 ECS 实例以节约成本。 为了提供更加弹性、灵活的伸缩服务,ESS 弹性伸缩配置中新增了 UserData、KeyPair、RamRole、Tags 四个特性。使用 UserData,您可以快速安全的完成自动化的配置过程,在 ECS 实例数量随着业务需求弹性变化的同时,您还能够安全、快速地完成应用级别的扩容和缩容。您还可以通过配置 KeyPair、Tags 等参数,实现更加高效、智能的 ECS 实例管理服务。 本文将详细介绍 ESS 新增的四个特性,并结合具体场景,向您阐述这些特性在 ESS 中的使用方式。您可以根据自己的业务场景,

优秀的个人博客,低调大师

容器服务&amp;&amp;AHAS Sentinel 弹性 Demo

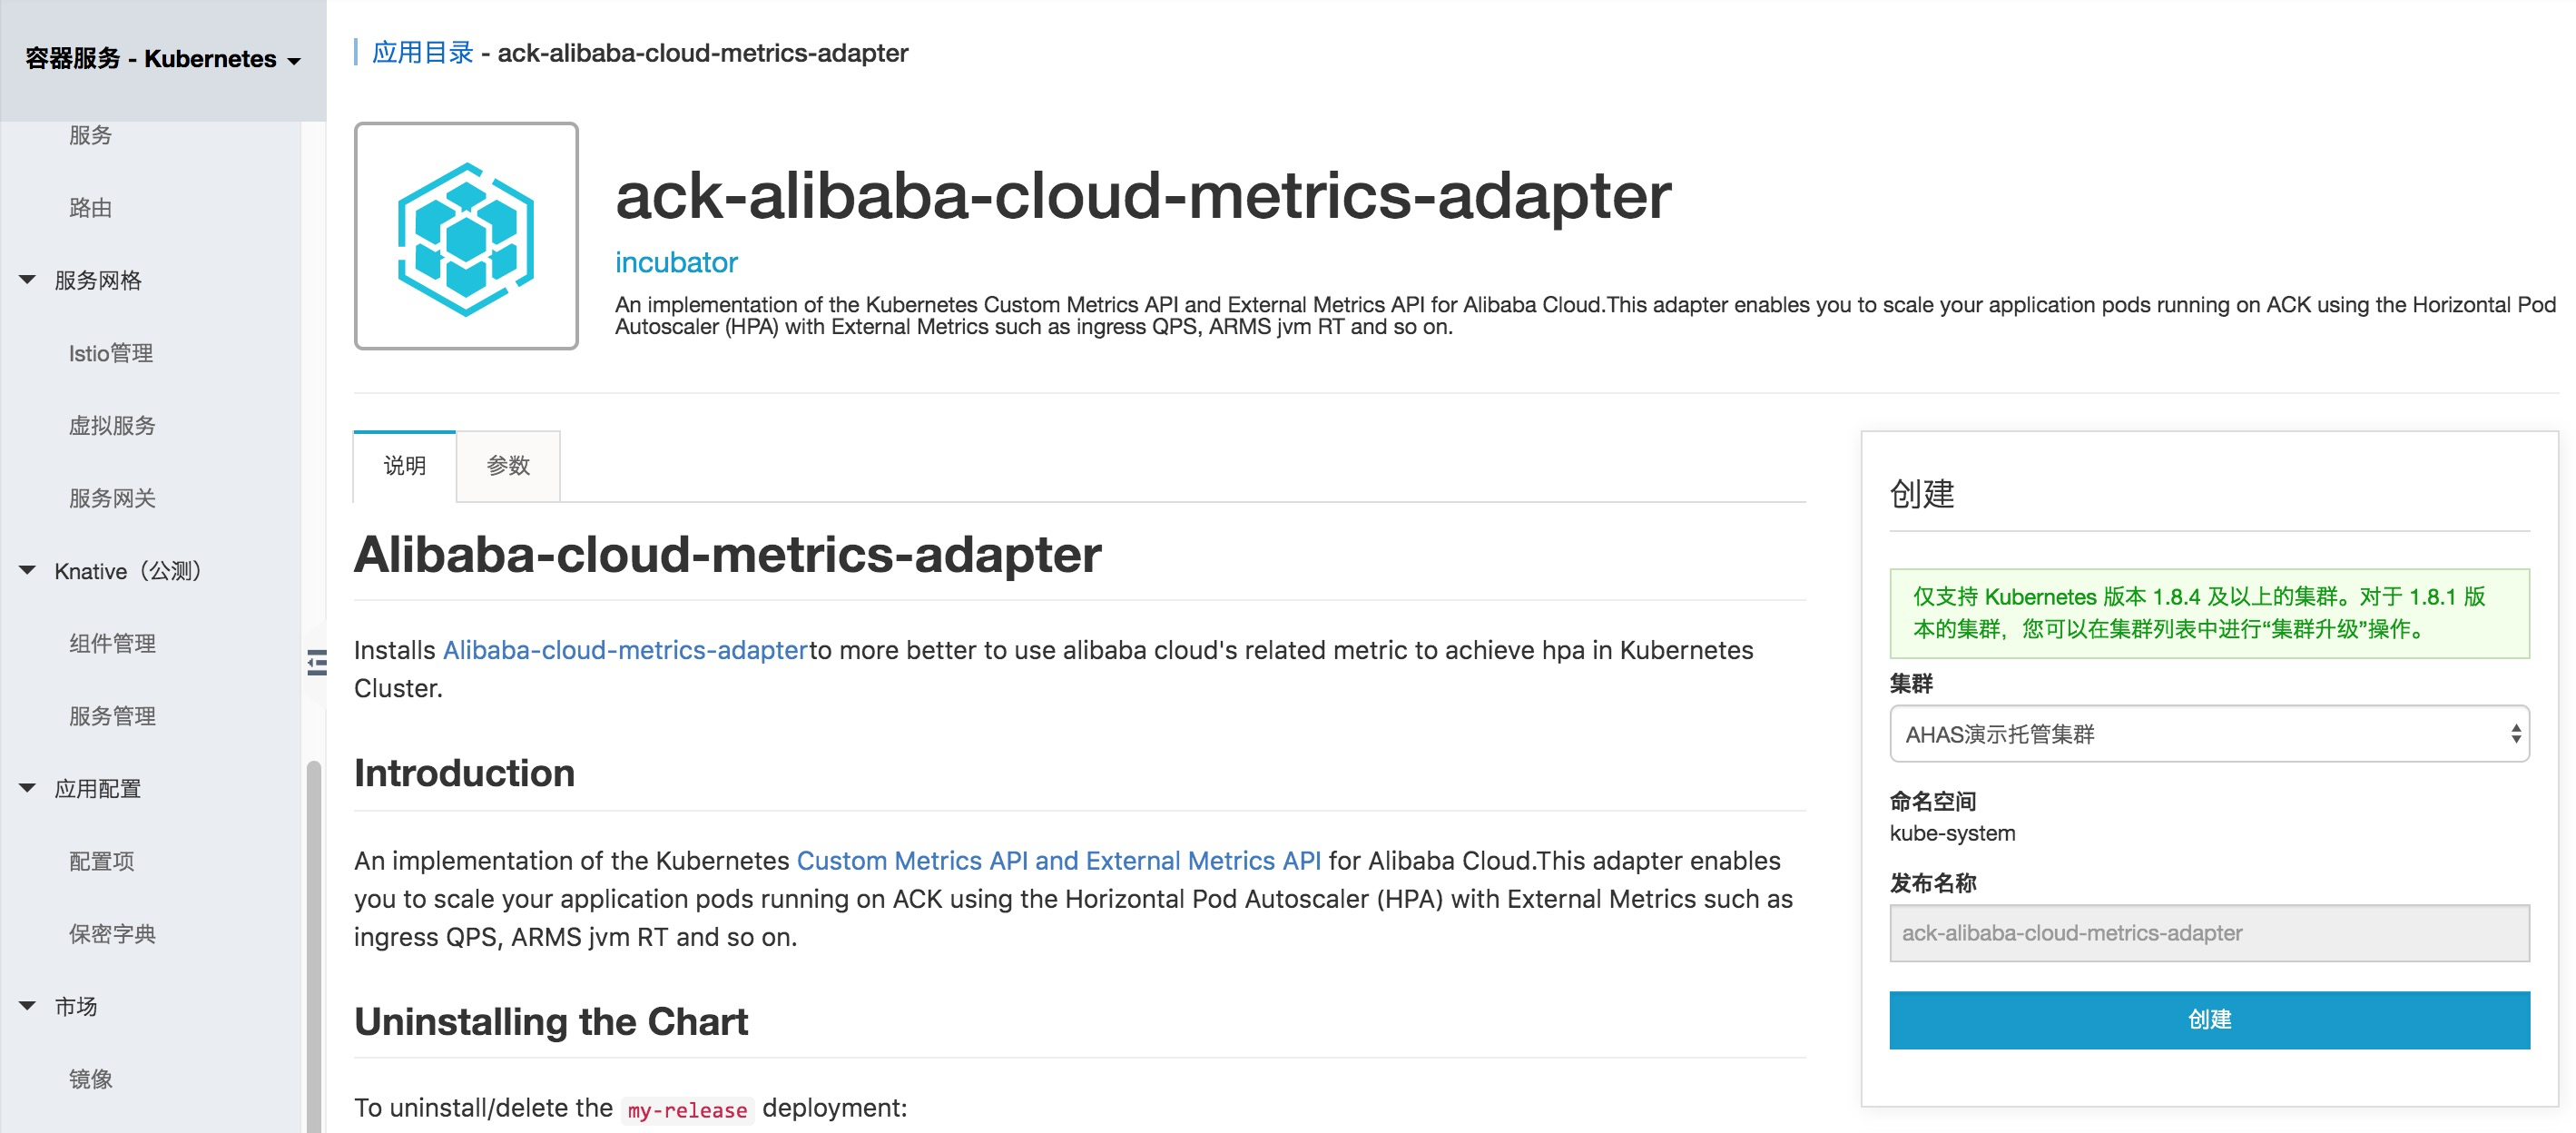
应用高可用服务 AHAS(Application High Availability Service)是一款阿里云应用高可用服务相关产品。只要容器服务中的 Java 应用接入了 AHAS 应用流控组件后,用户的应用实例就可以自动根据 AHAS Sentinel 收集的指标(如 QPS、平均响应时间等)进行弹性伸缩,使得系统可以自动根据实时的流量情况进行扩缩容,保证系统的可用性。 0. 安装 alibaba-cloud-metrics-adapter 可以直接在容器服务控制台 应用目录 中安装 alibaba-cloud-metrics-adapter。 相关 repo:https://github.com/AliyunContainerService/alibaba-cloud-metrics-adapter 1. 安装 AHAS Sen

优秀的个人博客,低调大师

Docker 上传镜像&amp;amp;拉取镜像

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_36367789/article/details/81623850 与git相似,docker也有自己的镜像仓库,官方仓库网站是https://hub.docker.com/,其实我们平时docker pull xxx就是从该仓库得到的镜像(在不设置国内镜像加速的情况下)。它和git仓库很相似。 创建账号 DockerHub:https://hub.docker.com/ 很多人在这里就出了问题,为什么都填完了但是不能点注册按钮呢?因为该网站目前来说注册是需要翻墙的,注册成功后再关闭翻墙。 我重新上传一个项目做示范,该镜像是从hub上pull到的一个nginx镜像,我把它上传到我的公开仓库。 上传镜像 先登录docker hub账号。 docker login [root@FantJ ~]# docker login Login with your Docker ID to push and pull images from Docker Hub. If you don't have a Docker ID, head over to https://hub.docker.com to create one. Username (fantj): fantj Password: Login Succeeded [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]# docker tag docker.io/nginx fantj/nginx [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB fantj/nginx latest ae513a47849c 4 weeks ago 109 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]# docker push fantj/nginx The push refers to a repository [docker.io/fantj/nginx] 7ab428981537: Mounted from library/nginx 82b81d779f83: Mounted from library/nginx d626a8ad97a1: Mounted from library/nginx latest: digest: sha256:e4f0474a75c510f40b37b6b7dc2516241ffa8bde5a442bde3d372c9519c84d90 size: 948 [root@FantJ ~]# 流程大概是:登录->tag操作->push 注:tag 的第二个参数的前缀是你的hub账户名 拉取镜像 我先把服务器上的镜像删除掉,然后再从hub中拉取镜像。 # 删除本地fantj/nginx镜像 [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB fantj/nginx latest ae513a47849c 4 weeks ago 109 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]# docker rmi fantj/nginx Untagged: fantj/nginx:latest Untagged: fantj/nginx@sha256:e4f0474a75c510f40b37b6b7dc2516241ffa8bde5a442bde3d372c9519c84d90 [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB # 从hub中拉取fantj/nginx镜像 [root@FantJ ~]# docker pull fantj/nginx Using default tag: latest Trying to pull repository docker.io/fantj/nginx ... latest: Pulling from docker.io/fantj/nginx Digest: sha256:e4f0474a75c510f40b37b6b7dc2516241ffa8bde5a442bde3d372c9519c84d90 Status: Downloaded newer image for docker.io/fantj/nginx:latest [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB docker.io/fantj/nginx latest ae513a47849c 4 weeks ago 109 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]#

优秀的个人博客,低调大师

Class文件结构&amp;amp;字节码指令

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_36367789/article/details/81605625 class文件结构 无符号数 表 Class文件设计理念和意义 1. 魔数magic 证明magic作用 minor_version、major_version 2. constant_pool_count 3. constant_pool[]常量池 3.1 CONSTANT_Class_info结构 3.2 CONSTANT_Fieldref_info, CONSTANT_Methodref_info和CONSTANT_InterfaceMethodref_info结构 3.3 CONSTANT_String_info结构 3.4CONSTANT_Integer_info和CONSTANT_Float_info结构 3.5CONSTANT_Long_info和CONSTANT_Double_info结构 3.6 CONSTANT_NameAndType_info结构 3.7 CONSTANT_Utf8_info结构 3.8 CONSTANT_MethodHandle_info结构 3.9 CONSTANT_MethodType_info结构 3.10 CONSTANT_InvokeDynamic_info结构 4. access_flags:访问标志 5. this_class:类索引 6. super_class:父类索引 7. interfaces_count:接口计数器 8. interfaces[]:接口表 9. fields_count:字段计数器 10. fields[]:字段表 11. methods_count:方法计数器 12. methods[]:方法表 13. attributes_count:属性计数器 14. attributes[]:属性表 14.1 ConstantValue属性 14.2 Code属性 14.3 StackMapTable属性 字节码指令 常量入栈指令 局部变量值转载到栈中指令 将栈顶值保存到局部变量中指令 wide指令 通用(无类型)栈操作指令 类型转换指令 整数运算 浮点运算 逻辑运算——移位运算 逻辑运算——按位布尔运算 控制流指令——条件跳转指令 控制流指令——比较指令 控制流指令——无条件跳转指令 控制流指令——表跳转指令 控制流指令——异常和finally 对象操作指令 数组操作指令 方法调用指令 方法返回指令 线程同步指令 一个简单的demo分析 Test.java javap -v Test.class class文件结构 Class文件存储的内容称为字节码(ByteCode),包含了JVM指令集和符号表以及若干其他辅助信息。 class文件是一组以8位字节为基础单位的二进制流,各个数据项目严格按照顺序紧凑的排列在Class文件中,中间没有添加任何分隔符,整个Class文件中存储的内容几乎全部是程序运行的必要的数据,没有空隙存在。 当遇到8位字节以上的空间的数据项时,则会按照高位在前的方式分割成若干个8位字节进行存储。 Class文件中有两种数据类型,分别是无符号数和表。 无符号数 无符号数属于基本的数据类型,以u1、u2、u4、u8来表示一个字节、两个字节…的无符号数;无符号数用来描述数字、索引引用、数量值或UTF-8编码构成的字符串值。 表 表是由多个无符号数或其他表作为数据项构成的复合数据类型,一般以”_info”结尾,用来描述class文件的数据结构。 特点:节省存储空间,提高处理性能 ClassFile { u4 magic; u2 minor_version; u2 major_version; u2 constant_pool_count; cp_info constant_pool[constant_pool_count-1]; u2 access_flags; u2 this_class; u2 super_class; u2 interfaces_count; u2 interfaces[interfaces_count]; u2 fields_count; field_info fields[fields_count]; u2 methods_count; method_info methods[methods_count]; u2 attributes_count; attribute_info attributes[attributes_count]; } 魔数 Class文件版本 常量池 访问标志 类索引,父类索引,接口索引集合 字段表集合 方法表集合 属性表集合 u2表示无符号数2个字节 u4表示无符号数4个字节 Class文件设计理念和意义 1. 魔数magic 魔数的唯一作用是确定这个文件是否为一个能被虚拟机所接受的Class文件。魔数值固定为0xCAFEBABE,不会改变。 证明magic作用 创建一个class文件 magic.class ,内容是magic test,直接运行java magic操作: 84407@FantJ MINGW64 ~/Desktop $ java magictest ▒▒▒▒: ▒▒▒▒▒▒▒▒ magictest ʱ▒▒▒▒ LinkageError java.lang.ClassFormatError: Incompatible magic value 1886741100 in class file magictest 报错意思是:magic矛盾,然后给了个magic value的十进制数,那么可以识别的magic十进制应该是多少呢。 应该是3405691582 那么,然后我用javac编译的正常java文件生成class文件,用binary viewer 查看: minor_version、major_version 魔数往后后面四位:表示字节码版本,分别表示Class文件的副、主版本。当今用的最广的几个版本: jdk1.8:52 jdk1.7:51 jdk1.6:50 对应版本号是52,是jdk1.8 版本向下兼容 2. constant_pool_count 常量池计数器,值等于constant_pool表中的成员数加1,占用两个字节 3. constant_pool[]常量池 Java虚拟机指令执行时依赖常量池(constant_pool)表中的符号信息。 所有的常量池项都具有如下通用格式: cp_info { u1 tag; u1 info[]; } info[]项的内容tag由的类型所决定。tag有效的类型和对应的取值在下表列出 常量类型 值 CONSTANT_Class 7 CONSTANT_Fieldref 9 CONSTANT_Methodref 10 CONSTANT_InterfaceMethodref 11 CONSTANT_String 8 CONSTANT_Integer 3 CONSTANT_Float 4 CONSTANT_Long 5 CONSTANT_Double 6 CONSTANT_NameAndType 12 CONSTANT_Utf8 1 CONSTANT_MethodHandle 15 CONSTANT_MethodType 16 CONSTANT_InvokeDynamic 18 3.1 CONSTANT_Class_info结构 表示类或接口 CONSTANT_Class_info { u1 tag; u2 name_index; } name_index必须是对常量池的一个有效索引 3.2 CONSTANT_Fieldref_info, CONSTANT_Methodref_info和CONSTANT_InterfaceMethodref_info结构 字段: CONSTANT_Fieldref_info { u1 tag; u2 class_index; u2 name_and_type_index; } 方法: CONSTANT_Methodref_info { u1 tag; u2 class_index; u2 name_and_type_index; } 接口方法: CONSTANT_InterfaceMethodref_info { u1 tag; u2 class_index; u2 name_and_type_index; } class_index必须是对常量池的有效索引,常量池在该索引处的项必须是CONSTANT_Class_info结构,表示一个类或接口,当前字段或方法是这个类或接口的成员。 CONSTANT_Methodref_info结构的class_index项的类型必须是类(不能是接口)。CONSTANT_InterfaceMethodref_info结构的class_index项的类型必须是接口(不能是类)。CONSTANT_Fieldref_info结构的class_index项的类型既可以是类也可以是接口。 name_and_type_index必须是对常量池的有效索引,表示当前字段或方法的名字和描述符。 在一个CONSTANT_Fieldref_info结构中,给定的描述符必须是字段描述符。而CONSTANT_Methodref_info和CONSTANT_InterfaceMethodref_info中给定的描述符必须是方法描述符。 3.3 CONSTANT_String_info结构 用来表示String的结构 CONSTANT_String_info { u1 tag; u2 string_index; } string_index必须是对常量池的有效索引,常量池在该索引处的项必须是CONSTANT_Utf8_info 结构,表示一组Unicode码点序列,这组Unicode码点序列最终会被初始化为一个String对象。 3.4CONSTANT_Integer_info和CONSTANT_Float_info结构 表示4字节(int和float)的数值常量: CONSTANT_Integer_info { u1 tag; u4 bytes; } CONSTANT_Float_info { u1 tag; u4 bytes; } 3.5CONSTANT_Long_info和CONSTANT_Double_info结构 表示8字节(long和double)的数值常量 CONSTANT_Long_info { u1 tag; u4 high_bytes; u4 low_bytes; } CONSTANT_Double_info { u1 tag; u4 high_bytes; u4 low_bytes; } 3.6 CONSTANT_NameAndType_info结构 表示字段或方法,但是和前面介绍的3个结构不同,CONSTANT_NameAndType_info结构没有标识出它所属的类或接口 CONSTANT_NameAndType_info { u1 tag; u2 name_index; u2 descriptor_index; } name_index项的值必须是对常量池的有效索引,常量池在该索引处的项必须是CONSTANT_Utf8_info结构,这个结构要么表示特殊的方法名,要么表示一个有效的字段或方法的非限定名(Unqualified Name)。 descriptor_index项的值必须是对常量池的有效索引,常量池在该索引处的项必须是CONSTANT_Utf8_info结构,这个结构表示一个有效的字段描述符或方法描述符。 3.7 CONSTANT_Utf8_info结构 用于表示字符串常量的值 CONSTANT_Utf8_info { u1 tag; u2 length; u1 bytes[length]; } CONSTANT_Utf8_info结构中的内容是以length属性确定长度的 3.8 CONSTANT_MethodHandle_info结构 表示方法句柄 CONSTANT_MethodHandle_info { u1 tag; u1 reference_kind; u2 reference_index; } reference_kind项的值必须在1至9之间(包括1和9),它决定了方法句柄的类型。 1. 如果reference_kind项的值为1(REF_getField)、2(REF_getStatic)、3(REF_putField)或4(REF_putStatic),那么常量池在reference_index索引处的项必须是CONSTANT_Fieldref_info结构,表示由一个字段创建的方法句柄。 2. 如果reference_kind项的值是5(REF_invokeVirtual)、6(REF_invokeStatic)、7(REF_invokeSpecial)或8(REF_newInvokeSpecial),那么常量池在reference_index索引处的项必须是CONSTANT_Methodref_info结构,表示由类的方法或构造函数创建的方法句柄。 3. 如果reference_kind项的值是9(REF_invokeInterface),那么常量池在reference_index索引处的项必须是CONSTANT_InterfaceMethodref_info结构,表示由接口方法创建的方法句柄。 4. 如果reference_kind项的值是5(REF_invokeVirtual)、6(REF_invokeStatic)、7(REF_invokeSpecial)或9(REF_invokeInterface),那么方法句柄对应的方法不能为实例初始化()方法或类初始化方法()。 5. 如果reference_kind项的值是8(REF_newInvokeSpecial),那么方法句柄对应的方法必须为实例初始化()方法。 3.9 CONSTANT_MethodType_info结构 表示方法类型 CONSTANT_MethodType_info { u1 tag; u2 descriptor_index; } 3.10 CONSTANT_InvokeDynamic_info结构 表示invokedynamic指令所使用到的引导方法(Bootstrap Method)、引导方法使用到动态调用名称(Dynamic Invocation Name)、参数和请求返回类型、以及可以选择性的附加被称为静态参数(Static Arguments)的常量序列。 CONSTANT_InvokeDynamic_info { u1 tag; u2 bootstrap_method_attr_index; u2 name_and_type_index; } bootstrap_method_attr_index项的值必须是对当前Class文件中引导方法表的bootstrap_methods[]数组的有效索引。 name_and_type_index项的值必须是对当前常量池的有效索引,常量池在该索引处的项必须是CONSTANT_NameAndType_info结构,表示方法名和方法描述符。 4. access_flags:访问标志 访问标志,access_flags是一种掩码标志,用于表示某个类或者接口的访问权限及基础属性。access_flags的取值范围和相应含义见下表。 标记名 值 含义 ACC_PUBLIC 0x0001 可以被包的类外访问。 ACC_FINAL 0x0010 不允许有子类。 ACC_SUPER 0x0020 当用到invokespecial指令时,需要特殊处理的父类方法。 ACC_INTERFACE 0x0200 标识定义的是接口而不是类。 ACC_ABSTRACT 0x0400 不能被实例化。 ACC_SYNTHETIC 0x1000 标识并非Java源码生成的代码。 ACC_ANNOTATION 0x2000 标识注解类型 ACC_ENUM 0x4000 标识枚举类型 5. this_class:类索引 this_class的值必须是对constant_pool表中项目的一个有效索引值。 是一个对constant_pool表中项目的一个有效索引值,表示指向常量池的第几个位置。 6. super_class:父类索引 表示这个Class文件所定义的类的直接父类,如果Class文件的super_class的值为0,那这个Class文件只可能是定义的是java.lang.Object类,只有它是唯一没有父类的类 是一个对constant_pool表中项目的一个有效索引值,表示指向常量池的第几个位置。 7. interfaces_count:接口计数器 表示有这个类有几个接口。 8. interfaces[]:接口表 成员所表示的接口顺序和对应的源代码中给定的接口顺序(从左至右)一样,即interfaces[0]对应的是源代码中最左边的接口。 是一个对constant_pool表中项目的一个有效索引值,表示指向常量池的第几个位置。 表示当前类或接口的直接父接口数量 9. fields_count:字段计数器 表示当前Class文件fields[]数组的成员个数 10. fields[]:字段表 每个成员都必须是一个fields_info结构的数据项,描述当前类或接口声明的所有字段,但不包括从父类或父接口继承的部分。 用于表示当前类或接口中某个字段的完整描述 field_info { u2 access_flags; u2 name_index; //对常量池的一个有效索引 u2 descriptor_index; //对常量池的一个有效索引 u2 attributes_count; //当前字段的附加属性的数量 attribute_info attributes[attributes_count]; } access_flags项的值是用于定义字段被访问权限和基础属性的掩码标志。access_flags的取值范围和相应含义见下表所示: 标记名 值 说明 ACC_PUBLIC 0x0001 public,表示字段可以从任何包访问。 ACC_PRIVATE 0x0002 private,表示字段仅能该类自身调用。 ACC_PROTECTED 0x0004 protected,表示字段可以被子类调用。 ACC_STATIC 0x0008 static,表示静态字段。 ACC_FINAL 0x0010 final,表示字段定义后值无法修改。 ACC_VOLATILE 0x0040 volatile,表示字段是易变的。 ACC_TRANSIENT 0x0080 transient,表示字段不会被序列化。 ACC_SYNTHETIC 0x1000 表示字段由编译器自动产生。 ACC_ENUM 0x4000 enum,表示字段为枚举类型。 attributes表的每一个成员的值必须是attribute结构,一个字段可以有任意个关联属性。 11. methods_count:方法计数器 methods_count的值表示当前Class文件methods[]数组的成员个数,Methods[]数组中每一项都是一个method_info结构的数据项。 12. methods[]:方法表 method_info结构可以表示类和接口中定义的所有方法,包括实例方法、类方法、实例初始化方法方法和类或接口初始化方法方法。methods[]数组只描述当前类或接口中声明的方法,不包括从父类或父接口继承的方法。 methods[]数组中的每个成员都必须是一个method_info结构的数据项,用于表示当前类或接口中某个方法的完整描述。 method_info { u2 access_flags; u2 name_index; u2 descriptor_index; u2 attributes_count; attribute_info attributes[attributes_count]; } access_flags项的值是用于定义当前方法的访问权限和基本属性的掩码标志,access_flags的取值范围和相应含义见下表所示。 标记名 值 说明 ACC_PUBLIC 0x0001 public,方法可以从包外访问 ACC_PRIVATE 0x0002 private,方法只能本类中访问 ACC_PROTECTED 0x0004 protected,方法在自身和子类可以访问 ACC_STATIC 0x0008 static,静态方法 ACC_FINAL 0x0010 final,方法不能被重写(覆盖) ACC_SYNCHRONIZED 0x0020 synchronized,方法由管程同步 ACC_BRIDGE 0x0040 bridge,方法由编译器产生 ACC_VARARGS 0x0080 表示方法带有变长参数 ACC_NATIVE 0x0100 native,方法引用非java语言的本地方法 ACC_ABSTRACT 0x0400 abstract,方法没有具体实现 ACC_STRICT 0x0800 strictfp,方法使用FP-strict浮点格式 ACC_SYNTHETIC 0x1000 方法在源文件中不出现,由编译器产生 name_index和 descriptor_index 两属性是对常量池的一个有效索引 attributes_count的项的值表示这个方法的附加属性的数量。 attributes 表的每一个成员的值必须是attribute结构,一个方法可以有任意个与之相关的属性。 13. attributes_count:属性计数器 attributes表中每一项都是一个attribute_info结构的数据项。 attributes_count的值表示当前Class文件attributes表的成员个数。 14. attributes[]:属性表 attributes表的每个项的值必须是attribute_info结构,在Class文件格式中的ClassFile结构、field_info结构,method_info结构和Code_attribute结构都有使用,所有属性的通用格式如下: attribute_info { u2 attribute_name_index; u4 attribute_length; u1 info[attribute_length]; } attribute_name_index必须是对当前Class文件的常量池的有效16位无符号索引。表示当前属性的名字。 attribute_length项的值给出了跟随其后的字节的长度,这个长度不包括attribute_name_index和attribute_name_index项的6个字节。 14.1 ConstantValue属性 ConstantValue属性是定长属性,位于field_info结构的属性表中。如果该字段为静态类型(即field_info结构的access_flags项设置了ACC_STATIC标志),则说明这个field_info结构表示的常量字段值将被分配为它的ConstantValue属性表示的值,这个过程也是类或接口申明的常量字段(Constant Field)初始化的一部分。这个过程发生在引用类或接口的类初始化方法执行之前。 ConstantValue_attribute { u2 attribute_name_index; u4 attribute_length; u2 constantvalue_index; } attribute_name_index项的值,必须是一个对常量池的有效索引。 attribute_length项的值固定为2。 constantvalue_index项的值,必须是一个对常量池的有效索引。 14.2 Code属性 Code属性是一个变长属性,位于method_info结构的属性表。一个Code属性只为唯一一个方法、实例类初始化方法或类初始化方法保存Java虚拟机指令及相关辅助信息。所有Java虚拟机实现都必须能够识别Code属性。如果方法被声明为native或者abstract类型,那么对应的method_info结构不能有明确的Code属性,其它情况下,method_info有必须有明确的Code属性。 Code_attribute { u2 attribute_name_index; u4 attribute_length; u2 max_stack; u2 max_locals; u4 code_length; u1 code[code_length]; u2 exception_table_length; { u2 start_pc; u2 end_pc; u2 handler_pc; u2 catch_type; } exception_table[exception_table_length]; u2 attributes_count; attribute_info attributes[attributes_count]; } attribute_name_index项的值必须是对常量池的有效索引 attribute_length项的值表示当前属性的长度,不包括开始的6个字节。 max_stack项的值给出了当前方法的操作数栈在运行执行的任何时间点的最大深度。 max_locals项的值给出了分配在当前方法引用的局部变量表中的局部变量个数,包括调用此方法时用于传递参数的局部变量。long和double型的局部变量的最大索引是max_locals-2,其它类型的局部变量的最大索引是max_locals-1. code_length项给出了当前方法的code[]数组的字节数,code_length的值必须大于0,即code[]数组不能为空。 code[]数组给出了实现当前方法的Java虚拟机字节码。 exception_table_length项的值给出了exception_table[]数组的成员个数量。 exception_table[]数组的每个成员表示code[]数组中的一个异常处理器(Exception Handler)。exception_table[]数组中,异常处理器顺序是有意义的(不能随意更改)。 start_pc和end_pc两项的值表明了异常处理器在code[]数组中的有效范围。 handler_pc项表示一个异常处理器的起点 如果catch_type项的值不为0,那么它必须是对常量池的一个有效索引 attributes_count项的值给出了Code属性中attributes表的成员个数。 属性表的每个成员的值必须是attribute结构。一个Code属性可以有任意数量的可选属性与之关联。 14.3 StackMapTable属性 StackMapTable属性是一个变长属性,位于Code属性的属性表中。这个属性会在虚拟机类加载的类型阶段被使用。 StackMapTable_attribute { u2 attribute_name_index; u4 attribute_length; u2 number_of_entries; stack_map_frame entries[number_of_entries]; } attribute_name_index项的值必须是对常量池的有效索引 attribute_length项的值表示当前属性的长度,不包括开始的6个字节。 number_of_entries项的值给出了entries表中的成员数量。Entries表的每个成员是都是一个stack_map_frame结构的项。 entries表给出了当前方法所需的stack_map_frame结构。 …更多的属性就不在这一一贴了,太多了,需要的时候查官方文档即可:https://docs.oracle.com/javase/specs/jvms/se8/html/jvms-4.html#jvms-4.4 字节码指令 java虚拟机指令由一个字节长度的,代表某种特定操作含义的数字(称之为操作码),以及随后的代表此操作所需参数的操作数而构成。 操作码的长度为1个字节,所以最大只有256条 常量入栈指令 局部变量值转载到栈中指令 将栈顶值保存到局部变量中指令 wide指令 通用(无类型)栈操作指令 类型转换指令 整数运算 浮点运算 逻辑运算——移位运算 逻辑运算——按位布尔运算 控制流指令——条件跳转指令 控制流指令——比较指令 控制流指令——无条件跳转指令 控制流指令——表跳转指令 控制流指令——异常和finally 对象操作指令 数组操作指令 方法调用指令 方法返回指令 线程同步指令 指令参考:https://blog.csdn.net/web_code/article/details/12164733 一个简单的demo分析 Test.java public class Test { public static void main(String[] args) { int a = 10; int b = 20; int c = a+b; System.out.println(c); } } javap -v Test.class #2 = Fieldref #24.#25 // java/lang/System.out:Ljava/io/PrintStream; #3 = Methodref #26.#27 // java/io/PrintStream.println:(I)V public static void main(java.lang.String[]); descriptor: ([Ljava/lang/String;)V flags: (0x0009) ACC_PUBLIC, ACC_STATIC Code: stack=2, locals=4, args_size=1 0: bipush 10 //把10扩展成int入栈 2: istore_1 //将栈顶int类型值保存到局部变量1中 3: bipush 20 //把20扩展成int入栈 5: istore_2 //将栈顶int类型值保存到局部变量2中 6: iload_1 //从局部变量1中装载int类型值入栈 7: iload_2 //从局部变量2中装载int类型值入栈 8: iadd // 将栈顶两int类型数相加,结果入栈。 9: istore_3 //将栈顶int类型值保存到局部变量3中 10: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream;获取静态字段的值。#2表示常量池的索引 13: iload_3 14: invokevirtual #3 // Method java/io/PrintStream.println:(I)V 运行时方法绑定调用方法。 17: return //void函数返回。

优秀的个人博客,低调大师

Java Web &amp;&amp; PHP 对比——嵌入篇

Java Web学习笔记——同时与PHP对比 博主在在学习Java Web,因为之前有学习过PHP,感觉二者有相似之处也有不同之处。所以在学习Java Web过程中,总结一下,希望能有所收获。 1、JSP的java代码嵌入和PHP文件中的PHP代码嵌入。(二者必须是Jsp文件或PHP文件才能实现嵌入html元素) 1.1JSP: //for循环输出表单 <% for ($i=0; $i < 5 ; $i++) { //for循环 %> <tr> <td>张三</td> <td>29</td> </tr> <% } //for循环结束 %> 1.2PHP: //for循环输出表单 <?php for ($i=0; $i < 5 ; $i++) { //for循环 ?> <tr> <td>张三</td> <td>29</td> </tr> <?php } //for循环结束 ?> 输出

优秀的个人博客,低调大师

Java Web &amp;&amp; PHP 对比——Cookie篇

Java Web学习笔记——同时与PHP对比 博主在在学习Java Web,因为之前有学习过PHP,感觉二者有相似之处也有不同之处。所以在学习Java Web过程中,总结一下,希望能有所收获。 2、JSP和PHP的Cookie设置和获取 2.1JSP: <% //设置cookie Cookie name = new Cookie("name","JSP"); // 设置cookie过期时间为1小时。 name.setMaxAge(60*60); // 在响应头部添加cookie response.addCookie( name ); //获取Cookie Cookie[] cookies =request.getCookies(); if( cookies != null ){ for (int i = 0; i < cookies.length; i++){ cookie = cookies[i]; out.print(cookie.getName());+":"+cookie.getValue()+"</br>"); } %> 2.2PHP: <?php setcookie("user", "PHP", time()+3600); //设置cookie echo $_COOKIE["user"]; // 输出 cookie 值 ?>

优秀的个人博客,低调大师

Android LruCache &amp;amp; DiskLruCache cooperate working in ListView

package zhangphil.cache; import android.app.ListActivity; import android.graphics.Bitmap; import android.graphics.BitmapFactory; import android.support.annotation.NonNull; import android.support.annotation.Nullable; import android.os.Bundle; import android.util.Log; import android.util.LruCache; import android.view.View; import android.view.ViewGroup; import android.widget.ArrayAdapter; import android.widget.ImageView; import java.io.ByteArrayOutputStream; import java.io.InputStream; import java.io.OutputStream; import java.security.MessageDigest; public class MainActivity extends ListActivity { private LruCache<String, Bitmap> mLruCache; private DiskLruCache mDiskLruCache; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); int CACHE_SIZE = 8 * 1024 * 1024; mLruCache = new LruCache(CACHE_SIZE); try { mDiskLruCache = DiskLruCache.open(this.getCacheDir(), 1, 1, CACHE_SIZE * 10); } catch (Exception e) { e.printStackTrace(); } ArrayAdapter mAdapter = new ArrayAdapter(this, 0) { @NonNull @Override public View getView(int position, @Nullable View convertView, @NonNull ViewGroup parent) { ImageView image = new ImageView(getContext()); load(R.mipmap.ic_launcher, image); return image; } @Override public int getCount() { return 20; } }; setListAdapter(mAdapter); } private void load(int id, ImageView image) { String key = null; if (id == R.mipmap.ic_launcher) { key = getMD5("R.mipmap.ic_launcher"); } //首先查找LruCache中的缓存 Bitmap bmp = mLruCache.get(key); if (bmp == null) { Log.d("LruCache缓存", "没有,继续深入到DiskLruCache读取。"); bmp = readFromDiskLruCache(key); if (bmp == null) { Log.d("LruCache与DiskLruCache", "没有缓存,开始创建新数据资源并缓存之。"); bmp = BitmapFactory.decodeResource(getResources(), id); //初次创建新资源,更新到DiskLruCache writeToDiskLruCache(key, bmp); } else { image.setImageBitmap(bmp); } //更新到LruCache缓存中,以待下一次使用。 mLruCache.put(key, bmp); Log.d("LruCache缓存", "写入完成。"); } else { //命中缓存 Log.d("LruCache缓存", "已有,复用。"); image.setImageBitmap(bmp); } } private void writeToDiskLruCache(String key, Bitmap bmp) { try { DiskLruCache.Editor editor = mDiskLruCache.edit(key); //把Bitmap转化为byte数组存储 ByteArrayOutputStream baos = new ByteArrayOutputStream(); bmp.compress(Bitmap.CompressFormat.PNG, 100, baos); byte[] bytes = baos.toByteArray(); //再次把Bitmap数组写进为DiskLruCache准备的输出流。 OutputStream os = editor.newOutputStream(0); os.write(bytes); os.flush(); //正式写入DiskLruCache editor.commit(); Log.d("DiskLruCache缓存", "写入缓存资源完毕。"); } catch (Exception e) { e.printStackTrace(); } } private Bitmap readFromDiskLruCache(String key) { DiskLruCache.Snapshot snapShot = null; try { snapShot = mDiskLruCache.get(key); } catch (Exception e) { e.printStackTrace(); } Bitmap bmp = null; if (snapShot != null) { Log.d("DiskLruCache缓存", "发现资源,复用。"); InputStream is = snapShot.getInputStream(0); bmp = BitmapFactory.decodeStream(is); } else { Log.d("DiskLruCache缓存", "没有发现缓存资源。"); } return bmp; } private String getMD5(String msg) { MessageDigest md = null; try { md = MessageDigest.getInstance("MD5"); } catch (Exception e) { e.printStackTrace(); } md.reset(); md.update(msg.getBytes()); byte[] bytes = md.digest(); String result = ""; for (byte b : bytes) { result += String.format("%02x", b); } return result; } }

优秀的个人博客,低调大师

Android -- ADT变化&amp;aar&amp;Lint

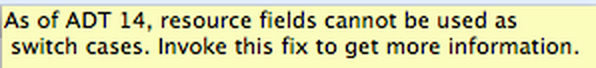
Switch Case switch case 常用的使用方法: switch(v.getId()){ case R.id.btn1: doClick1(); break; } 在ADT中的改变 在正常的 Android 项目中,资源R类里的常量是这样声明的: public static final int main=0x7f030004; 然而,到 ADT 14为止,在类库项目中,他们会被这样声明: public static int main=0x7f030004; 原因 在库项目中这些常量都不是final的。原因很简单:当多个库项目整合时,字段的实际值(必须是唯一的)可能会出现碰撞。在ADT 14 之前,所有这样的字段都是final的,所以导致所有的库被使用的时候,主项目必须编译他们的所有资源和相关 Java 代码。这样的性能是很差的,因为它使构建的速度非常慢。它还阻碍了不包含源代码的库项目的分发,限制库项目的使用范围。 字段不再是 final 的原因是意味着库jar包可以只编译一次,并且能直接在其他项目中复用。以及允许分发库项目的二进制版本(将在 r15出现),这使得构建更快。 影响 以下代码不能再编译通过: switch(v.getId()){ case R.id.btn1: doClick1(); break; } 只能换成: if(v.getId() == R.id.btn1){ doClick1(); } //else if(...){....}else{...} 我是天王盖地虎的分割线 aar “aar”包是 Android 的类库项目的二进制发行包。 文件扩展名是.aar,maven 项目类型应该也是aar,但文件本身是带有以下各项的 zip 文件: /AndroidManifest.xml(mandatory) /classes.jar(mandatory) /res/(mandatory) /R.txt(mandatory) /assets/(optional) /libs/.jar(optional) /jni//.so(optional) /proguard.txt(optional) /lint.jar(optional) 这些条目是直接位 zip 文件根目录的。 R.txt 文件是aapt带参数--output-text-symbols的输出结果。 我是天王盖地虎的分割线 Lint Android lint工具是一个静态代码分析工具,检查你的Android项目源文件潜在的bug,并优化改进,确保正确性、安全性、性能、可用性、可访问性和国际化。 概述 Android SDK提供了一个代码扫描工具,称为lint。可以帮助您轻松地识别并纠正问题与结构质量的代码,不必执行应用程序或编写任何测试用例。每个问题检测到该工具报告的一个描述消息和严重性级别,您可以快速地优先考虑的关键改进。您还可以配置一个问题的严重性级别,忽略不相关的问题,或提高的严重程度。这个工具有一个命令行接口,所以您可以很容易地集成到您的自动化测试过程。 Lint工具可以检查你android工程潜在的bug和优化改进,以确保正确性、安全性、性能、可用性、可访问性和国际性。您可以从命令行运行lint,或eclipse中运行lint。 lint优点 除了测试Android应用程序满足其功能需求,重要的是要确保代码没有结构性问题。代码结构简陋的可靠性和效率的影响你的Android应用程序,使您的代码很难维护。例如,如果XML资源文件包含未使用的名称空间,这占用空间并产生不必要的处理。其他的结构性问题,比如使用弃用元素或API调用所不支持的目标API版本,可能会导致代码未能正确地运行。 Android lint是在ADT 16提供的新工具,它是一个代码扫描工具,能够帮助我们识别代码结构存在的问题。主要包括: 布局性能(以前是layoutopt工具,可以解决无用布局、嵌套太多、布局太多) 未使用到资源 不一致的数组大小 国际化问题(硬编码) 图标的问题(重复的图标,错误的大小) 可用性问题(如不指定的文本字段的输入型) manifest文件的错误 命令行用法 lint是命令工具,在SDK 的tools/ 目录下: $ lint /src/ 可以通过添加 --disable argument,禁用一个特定的检查,或一列的检查,例如: $ lint --disable MissingTranslation,UnusedIds,Usability:Icons /src/ 可以通过--check标志指定运行哪些确切的检查。这让你可以在代码库中查找一个具体的问题,比如: $ lint --check MissingPrefix /src/ 使用--show命令加上 id 列表或类别 (或不带参数查看全部)可以获取指定的问题的解释: $ lint --show MissingPrefix 要生成 HTML 报告,只需要添加--html文件名作为参数: $ lint --html /tmp/report.html 运行lint --help以获取可用参数的相关信息。 更多 http://developer.android.com/tools/help/lint.html 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/4783337.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

[React-Native]环境配置&amp;amp;HelloWorld

一、前言 手头有mac、有开发者证书,不想浪费资源,之前做过iOS开发,还会对移动开发表示关注,现在移动开发目前用Rect Native也是一个热潮,加上之前有web开发经验,然后就有了学习的冲动。Keep learning, make me happy! 二、环境配置 需要mac设备 需要Xcode6.3版本以上 安装Node.js:https://nodejs.org/download/ 建议安装watchman,终端命令:brew install watchman 安装flow:brew install flow 三、Hello,React-Native 现在我们需要创建一个React-Native的项目,因此可以按照下面的步骤: 打开终端,开始React-Native开发的旅程吧。 1. 安装命令行:sudo npm install -g react-native-cli 2. 创建HelloWorld项目:react-native init HelloWorld 3. 找到创建的HelloWorld项目,双击HelloWorld.xcodeproj即可在xcode中打开项目。xcodeproj是xcode的项目文件。 4. 在xcode中,使用快捷键cmd + R即可启动项目。基本的Xcode功能可以熟悉,比如模拟器的选择等。 5. 启动完成你应该会看到运行效果 四、初识HelloWorld工程 Xcode里面的代码目录结构暂时不用管了,打开HelloWorld项目文件夹,找到index.ios.js文件。 index.ios.js文件就是React-Native JS 开发之旅的入口文件了。 先来个感性的认识,修改一 些文本,下一篇会解读里面的代码。用文本编辑器打开index.ios.js文件。 (1)找到代码部分: <Text style={styles.welcome}> Welcome to React Native! </Text> 修改成 <Text style={styles.welcome}> React-Native入门学习 </Text> (2)修改welcome标签的样式 welcome: { fontSize: 20, textAlign: 'center', margin: 10, }, 修改成: welcome: { fontSize: 20, textAlign: 'center', margin: 10, color: 'red', }, (3)如果有前端开发经验这些应该很容易理解,然后重新运行看效果 五、理解怎么运行到js脚本里面的 恭喜你 如果不搞懂上面这一个原理,参考学习官网的话你会发现第一个例子你就跑不起来,然后就会郁闷了。 六、运行官网的一个HelloWorld案例 在上面的基础上,我们来学习官网的案例。我们通过命令创建出来的HelloWorld有点复杂,我们可以删除重新写一个简单的HelloWorld开始。 参考官网第一篇教程 import React, { Component } from 'react'; import { AppRegistry, Text } from 'react-native'; class HelloWorldApp extends Component { render() { return ( <Text>Hello world!</Text> ); } } AppRegistry.registerComponent('HelloWorldApp', () => HelloWorldApp); 如果你只是复制到index.ios.js文件中会出现报错,因为程序启动的时候找不到这个文件中的注册的HelloWorldApp类 修改: AppRegistry.registerComponent('HelloWorld', () => HelloWorldApp); 然后cmmand+d重新Reload即可,不需要重启应用,这也意味着React Native开发应用可以热更新 提示:隐藏状态栏 这里我们没有设置文本都位置,默认就是在左上角,会跟状态栏重叠,我们可以隐藏状态栏即可 运行效果 七、真机调试 网上好多文章讲述如何iOS真机调试,但都有问题,编译会报错,后来发现可能是版本不一致,我用的是目前最新版本0.40, (1)修改Signing (2)修改IP 真机运行效果:

优秀的个人博客,低调大师

Openstack 中的消息总线 &amp;amp; AMQP

目录 目录 消息总线 消息总线的原理 AMQP 消息总线 Openstack 采用了面向服务的开发模式(有别于面向对象和面向过程),需要我们去考虑各个服务之间和各项目之间是如何传递消息的。 Restful API:项目之间的通信。 消息总线:项目内部的服务之间的通信。 使用这种架构模式的好处在于:保证了各个项目对外提供服务的 API 接口可以被不同的客户端类型所调用。即,只要可以调用这个 API 接口,那么 Client 是使用什么技术来实现,Service 都不会受到影响,也不需要作出改变。Server 和 Client 做到了模块化的分离。除此之外,还能够保证项目内部通信接口的可扩展性和可靠性,可以支持大规模的部署。 消息总线:可以实现一些服务向总线发送信息,其他的服务从总线上获取消息的效果。就类似于回转寿司的回转带,所有人都可以往回转带上放寿司和取寿司,这样的话只需要有足够的位置,就能够随时加入或减少客人,而且并不会影响整个寿司店的运作。 消息总线的原理 项目内部各服务进程之间的通信使用了:oslo.messaging库所提供的函数方法。同时还需要以下两种技术作为支撑。 远程过程调用 RPC:一个服务进程可以调用其他远程服务进程的方法。调用的方式: call():远程方法会被同步执行,调用者会被阻塞直到返回方法的结果,在一些调用时间较长的场合中使用会对效率又很大的影响。( call() 调用的远程服务的方法会被马上执行,在执行的过程中还会把调用者的进程阻塞掉,知道返回结果为止。) cast():远程服务的方法会被异步执行,调用者不会被阻塞,结果也无须立即返回,可以在一个合适的时机(人为干预)去执行并返回结果。所以也要求调用者利用其他的方法来查询这次远程调用的结果。 事件通知:某一个服务进程将事件通知发送到消息总线上,所有在消息总线上且对该事件通知感兴趣的服务进程都可以将该事件通知获取并进行处理,执行的结果并不需要返回给事件发送者。这种方式不仅可以在项目组件内部的进程服务通信间实现,还可以在项目之间的通信中实现(EG. Ceilometer)。 AMQP AMQP高级消息队列协议:是一个基于应用层的,用于异步消息传递的协议规范。其功能包括了: 消息的导向/ 消息的队列/ 消息的路由/ 消息的可靠性/ 消息的安全性。不同的AMQP实现方式之间可以通过定义消息在网络上传输时的字节流格式来进行互相操作。 在一个实现了 AMQP协议 的中间件消息队列服务中,如:RabbitMQ。当由生产者发出的不同的消息被发送到 RabbitMQ Server 中的 Queue 时,RabbitMQ 会根据不同的条件把 Queue 中的请发传递给不同的消费者。如果消费者无法接收,那么这个消息,就会自动的把消息缓存在内存或者磁盘中。这些操作是由 RebbitMQ 中的 Exchange 和 Queue 来实现的( Exchange或Queue的数量不定 ): Excange(信息交换):决定了消息的路由转发,根据接收到的消息中的 Info (从消息属性/消息头/消息体中提取)来与绑定表匹配(消息的 routing key 和 Queue 的 binding key 匹配)以此来决定将消息转发到哪一个 Queue 中,然后消费者再从 Queue 中获取消息并进行处理。 Queue(消息队列):作为 消息存储 和 分发 实体,负责将消息缓存在内存或者磁盘中,并且按照一定的顺序将这些消息分发给一个或多个消费者。 注:Excange 负责将消息转发到 Queue 中,转发的判断依据是从消息中获取的routing key 与 Queue 中的 binding key 匹配结果。

优秀的个人博客,低调大师

hadoop(1):centos 安装 hadoop &amp;amp; hive

1,关于hive Hive是一个基于Hadoop的数据仓库平台。通过hive,我们可以方便地进行ETL的工作。hive定义了一个类似于SQL的查询语言:HQL,能 够将用户编写的QL转化为相应的Mapreduce程序基于Hadoop执行。 Hive是Facebook 2008年8月刚开源的一个数据仓库框架,其系统目标与 Pig 有相似之处,但它有一些Pig目前还不支持的机制,比如:更丰富的类型系统、更类似SQL的查询语言、Table/Partition元数据的持久化等。 本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/47617975 未经博主允许不得转载。 网站首页: http://hive.apache.org/ 2,安装 首先要安装hadoop https://hadoop.apache.org/ 直接下载tar.gz解压缩。最新版本2.7.1。 tar -zxvf hadoop-2.7.1.tar.gz mv hadoop-2.7.1 hadoop 下载地址: http://hive.apache.org/downloads.html 直接解压缩就可以。最新版本 1.2.1。 tar -zxvf apache-hive-1.2.1-bin.tar.gz mv apache-hive-1.2.1 apache-hive 设置环境变量: export JAVA_HOME=/usr/java/default export CLASS_PATH=$JAVA_HOME/lib export PATH=$JAVA_HOME/bin:$PATH export HADOOP_HOME=/data/hadoop export PATH=$HADOOP_HOME/bin:$PATH export HIVE_HOME=/data/apache-hive export PATH=$HIVE_HOME/bin:$PATH 3,启动hive,创建表 hive 官网:https://cwiki.apache.org/confluence/display/Hive/Home 配置环境变量就可以启动hive了,这个hive是一个本机环境,只依赖hadoop,只有有hadoop环境变量就行。 创建数据表,和mysql非常类似 参考:http://www.uml.org.cn/yunjisuan/201409235.asp https://cwiki.apache.org/confluence/display/Hive/LanguageManual+DDL # hive Logging initialized using configuration in jar:file:/data/apache-hive/lib/hive-common-1.2.1.jar!/hive-log4j.properties hive> show databases; OK default Time taken: 1.284 seconds, Fetched: 1 row(s) hive> use default; OK Time taken: 0.064 seconds hive> show tables; OK Time taken: 0.051 seconds hive> CREATE TABLE user_info(uid INT,name STRING) > PARTITIONED BY (create_date STRING) > ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' > STORED AS TEXTFILE; OK Time taken: 0.09 seconds 使用apache hive 创建数据库表的时候有可能会遇到问题: FAILED: ParseException line 5:2 Failed to recognize predicate 'date'. Failed rule: 'identifier' in column specification 说明关键字冲突了。不能使用date,user等关键字。 指定存储格式为 Sequencefile 时,把txt格式的数据导入表中,hive 会报文件格式错 Failed with exception Wrong file format. Please check the file's format. FAILED: Execution Error, return code 1 from org.apache.hadoop.hive.ql.exec.MoveTask 4,导入数据 hive不支持用insert语句一条一条的进行插入操作,也不支持update操作。数据是以load的方式加载到建立好的表中。 数据一旦导入就不可以修改。因为hadoop是这个特性。 创建两个数据文件: /data/user_info_data1.txt 121,zhangsan1 122,zhangsan2 123,zhangsan3 /data/user_info_data2.txt 124,zhangsan4 125,zhangsan5 126,zhangsan6 数据导入:分别将数据导入到两个分区中。 hive> LOAD DATA LOCAL INPATH '/data/user_info_data1.txt' OVERWRITE INTO TABLE user_info PARTITION (create_date='20150801'); Loading data to table default.user_info partition (create_date=20150801) Partition default.user_info{create_date=20150801} stats: [numFiles=1, numRows=0, totalSize=42, rawDataSize=0] OK Time taken: 0.762 seconds hive> LOAD DATA LOCAL INPATH '/data/user_info_data2.txt' OVERWRITE INTO TABLE user_info PARTITION (create_date='20150802'); Loading data to table default.user_info partition (create_date=20150802) Partition default.user_info{create_date=20150802} stats: [numFiles=1, numRows=0, totalSize=42, rawDataSize=0] OK Time taken: 0.403 seconds 5,查询 直接查询即可。 hive> select * from user_info where create_date = 20150801; OK 121 zhangsan1 20150801 122 zhangsan2 20150801 123 zhangsan3 20150801 Time taken: 0.099 seconds, Fetched: 3 row(s) 更多查询函数参考: hive 函数大全和用户自定义函数 https://cwiki.apache.org/confluence/display/Hive/LanguageManual+UDF 6,总结 本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/47617975 未经博主允许不得转载。 hive可以非常方便的进行离线数据统计,因为数据一旦录入是不能进行修改的。 hive的语法和mysql非常相似,可以充分利用hadoop进行数据统计,可以进行多次join而不用担心效率问题。 目前,有一个小问题没有解决,是数据导入必须使用textfile,不是压缩文件类型。 这个问题的具体描述参考: http://blog.163.com/xiaoy2002@126/blog/static/6797953420128118227663/

优秀的个人博客,低调大师

Hexo 入门指南(一) - 简介 &amp;amp; 准备

Hexo是一个开源的静态博客生成器,用node.js开发,作者是台湾大学生tommy351。 为什么是博客 对于个人网站来说,没有比博客更合适的形式了。在博客中,文章才是最主要的,一切都显得主次分明,干净利落。相比之下,论坛中主题和回复鱼龙混杂,阅读体验非常差。同时,博客比论坛的数据库小很多,便于维护。 为什么是静态博客 很多人选择在虚拟主机或vps上面搭建动态博客。但是这些主机商通常“免费的不稳定,稳定的不免费”。前一段时间,我观察了我的个人博客友链上面的几个站点,一部分在十几天之后就销声匿迹了。独立博客如此麻烦的维护工作,能不能减轻一些呢?正如阮一峰前辈所说,blogger分为三个阶段。最开始,是门户博客。之后,是独立博客。最后,觉得独立博客自己管理起来费劲,便找个别人来管的空间,自己负责写就好。如果我们能够找到这样的空间,在自己保留最大控制权前提下,由别人托管,会省去不少事情。 静态博客编译之后是纯html页面,优点就是支持它的环境十分好找,例如github、gitcafe、七牛云存储等站点都支持静态页面托管,自然是我们的首选了。由于github page在国内访问较慢,这篇文章用gitcafe做示范。gitcafe是天朝本地化的github,同样提供展示页和域名绑定功能,不需要备案,就是爽。 但是静态博客并非没有缺点。动态博客更新文章时,脚本是不变的,只需要更新数据库。静态博客要频繁改动文件,不支持增量式上传的东西,比如ftp,就难于管理。此外,还要十分熟悉git各种命令,才能部署页面。 准备工作 git node.js markdown编辑器 gitcafe 域名 markdown编辑器是非必须的,只要你熟悉语法,随便一个编辑器来写都不是问题。 域名也是非必须的,gitcafe pages服务提供免费的二级域名。注册域名的教程这里就不写了。 安装 git git的客户端,本人推荐git-scm。 linux下面,在bash中键入: (Ubuntu, Debian) $ sudo apt-get install git (Fedora, Red Hat, CentOS) $ sudo yum install git windows或mac下,直接到git-scm官网下载安装。 安装 node.js linux下: $ sudo apt-get install nodejs $ sudo apt-get install npm yum同理。 windows或者mac下,直接到node.js官网下载安装。 windows还要设置环境变量,把node.js安装路径写进path里面,用半角分号分隔。 markdown 编辑器 windows下推荐markdown pad。 mac下推荐mou。 gitcafe 首先注册一个账号,之后点击查看如何使用pages服务。 相关网页 Hexo主页 Hexo github 地址 git book

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册