首页 文章 精选 留言 我的

精选列表

搜索[速度],共10005篇文章
优秀的个人博客,低调大师

河南移动物联网建设“加速度

移动“行车卫士”让用户放心出行 众所周知,电动车以其经济实用、使用方便等特点,成为广大人民群众普遍使用的交通工具。据不完全统计,当前中国电动车保有量约2.5亿辆,年销量过千万;据河南省公安厅交警总队统计,全省电动车保有量至少1000万辆,郑州拥有超出200万辆的电动车。与此同时,由于电动车结构简单、防盗功能差,成为违法犯罪常见的袭击目标,盗窃率居高不下。 如何破解?一直深耕智慧城市建设的河南移动给出了自己的答案:行车卫士。据介绍,行车卫士是中国移动在物联网领域可形成市场规模的重点产品之一,是指利用在车内安装定位追踪防盗终端,可通过WEB端和手机客户端来实现车辆智能报警、定位监控、自主防盗等功能,主要面对电动车、摩托车等轻量级车辆,主打安防告警、轨迹回放、电子围栏等功能,对于平原地区电动车辆多、丢失率高、破案难等问题尤为适用。 据了解,行车卫士甫一推出,驻马店、漯河、郑州、平顶山、洛阳等省辖市的当地政府综治办、政法委或公安局就通过打造平安城市等为契机,进行了积极推广,并取得了良好的效果, 相关统计数据显示,截至目前全省共计16380辆电动车安装了“行车卫士”,切实有效地加强了电动自行车的防盗管理工作,在社会上得到了较好的口碑。 “再也不纠结上下楼送快递的过程中车子无人看管了!”顺丰公司的一位快递小哥如是点赞河南移动的行车卫士,说自从安装了行车卫士之后,不但没有丢过车子,还提升了公司及同事之间的业务效率。 值得注意的是,在行车卫士之外,河南移动还推出了公车管理、车载诊断等“车联网”产品,同样受到了市场的广泛追捧。其中公车管理是针对顺应国家号召打造的政府、企业公务用车管理的车联网系统,实现公务用车的调度管理、油耗管理、电子围栏、档案管理等功能,是提高公务用车规范管理的重要信息化工具。而车载诊断是面向私家车市场推出的车联网产品,实现车况诊断、驾驶行为评测、轨迹回放等功能。该产品与驾驶行为评测大数据相结合,对于保险行业具有极大的价值,能够与车险营销、快速定损等保险业务紧密结合。 “大连接”战略催生亿元级市场蛋糕 事实上,产品不断的“车联网”只是河南移动发力物联网建设的其中一隅,在它之外,相关物联网产品的应用领域已经覆盖能源抄表、移动支付、安防监控、城市管理等板块。 比如,基于传感器核心技术的“智慧燃气”项目,向全国重点企业以及市政企业,提供燃气信息化管理平台、智慧燃气地下管网综合监管平台、燃气管线巡检、管网防腐监测、工商业用户可燃气体泄漏监测、家用燃气泄漏报警监测及低功耗远传系统等项目解决方案。提供物联卡+API+APN+云平台的解决方案,实现传感器设备安全、高效、传输数据的同时,做到了实时数据的监控。 无独有偶,同样基于提供“物联卡+API+APN+云平台”的智慧水务项目,也可以通过物联网传输,向用户提供数据采集与监控系统、GIS地理信息系统、智慧水厂、智能调度、二次供水设施管理、智能抄收、智能计量、智能阶梯收费、客户服务、热线系统、工程管理系统、水力模型等解决方案。 同时,在水、电、燃气电子抄表上,河南移动为加快研发和生产模组化的智能水、电、燃气抄表,提高其产业价值,对拟利用中移物联网公司开发的通信模组嵌入智能电表,解决传统电子抄表设备在长生命周期中SIM卡稳定性的问题。 而在智慧公安建设层面,车载动态执法取证系统则为交通执法部门提供了取证的“好帮手”:通过物联卡,借助优质高效的4G网络实现视频取证、查车报警、雷达测速、视频录像、GPS定位、系统管理等功能。远程调度处置:公司通过物联卡,实现多种突发事件的现场监控及警力布置调度。 此外,驾培车辆车载监控项目提供APN专线+平台+终端一体化解决方案,通过远程监控,有效杜绝驾校教练员弄虚作假,伪造学时的违规行为发生,有效提升了对驾校培训的监督和管理水平。 对此,河南移动的相关负责人表示,中国移动一直致力于物联网领域的发展,确立了“大连接”的发展战略,从人财物各个方面加强物联网的投入,促进物联网市场规模的快速增长。一是确立“大连接”发展战略,从思想意识层面确立物联网发展的战略指导地位;二是成立专业的物联网公司,强化物联网云管端各层次物联网产品的研发生产;三是成立专业团队负责物联网市场的拓展,加强物联网项目市场、物联网标准化产品的营销推广;四是开放合作,与物联网产业链合作共拓物联网市场。具体到2016年,河南移动则将根据物联网市场需求,加大物联网市场合作力度,达到用户百万级、收入亿元级的市场。 ====================================分割线================================ 本文转自d1net(转载)

优秀的个人博客,低调大师

提高 SharePoint 页面访问速度之SQL优化

前面两篇文章我们和大家一起讨论到了SharePoint IIS的应用池回收,W3WP进程数和重置回收等方面的优化,今天来和大家讲讲后端SQL服务器的优化。 对于SQL的优化,今天主要介绍的就是两点,CPU的优化和内存的优化。 很多同学在装好SQL之后,其实并没有对内存优化进行设置,导致SQL的内存分配很不合理,针对于SharePoint,建议设置SQL的使用内存最少为 8192 MB,最多为 20480 MB 这个临界值。 如上设置,注意,这里的配置值和运行值一定要配置两次,并且要保证其一直,否则不会生效,如果不匹配,多点击几次即可。 默认情况下,这两个值的设置是不一样的,需要我们点击配置项,点击确定保存,再输入值,点击运行项目,再点击确定。多设置几次,两个地方反复点OK,多试几次。 OK,说完内存,现在我们来说下CPU,在一个SharePoint环境里面,或者私有云环境里面,正常情况下,SQL的CPU应该至少要跑在 40% ,伴随着硬盘会有频繁的读写IO。 如果CPU占用不高,磁盘IO读写也不高,那就是SQL拖了后腿,SQL一旦拖后腿了,前端web服务器再怎么优化和牛X,用户访问也还是会很慢的。 默认情况下,SQL和IIS一样,针对每个请求,也只会有一个人员来为你服务,但是其实SQL本来是可以用很多个人员来为你服务的,用来处理你的query,但是你如果不优化它,它就会偷懒,默认只激活一个服务员为你工作。 同样在SQL实例的处理器选项中,注意下面三个值。 这里建议是128线程起,最多可以开128个线程来并发为前端提供查询服务。 并且勾选 强化SQL优先级。 最后和内存配置项一样,记得在 配置值和运行值上都多设置几次,确保相同的数值生效。 在最大工作线程这个地方,默认是0,就是只开放1个线程来进行服务,也就是说随便你又多少个查询过来,只有一个服务人员接待,后面的查询全部请排队。 OK,在修改了SQL的内存和CPU配置项之后,大家可以尝试重启一下SQL Server服务,或者直接重启服务器,效果还是很明显的。今天的讨论就到这里,欢迎大家一起共同探讨,谢谢大家!

优秀的个人博客,低调大师

“GitHub 在 Safari 上的加载速度极其缓慢”

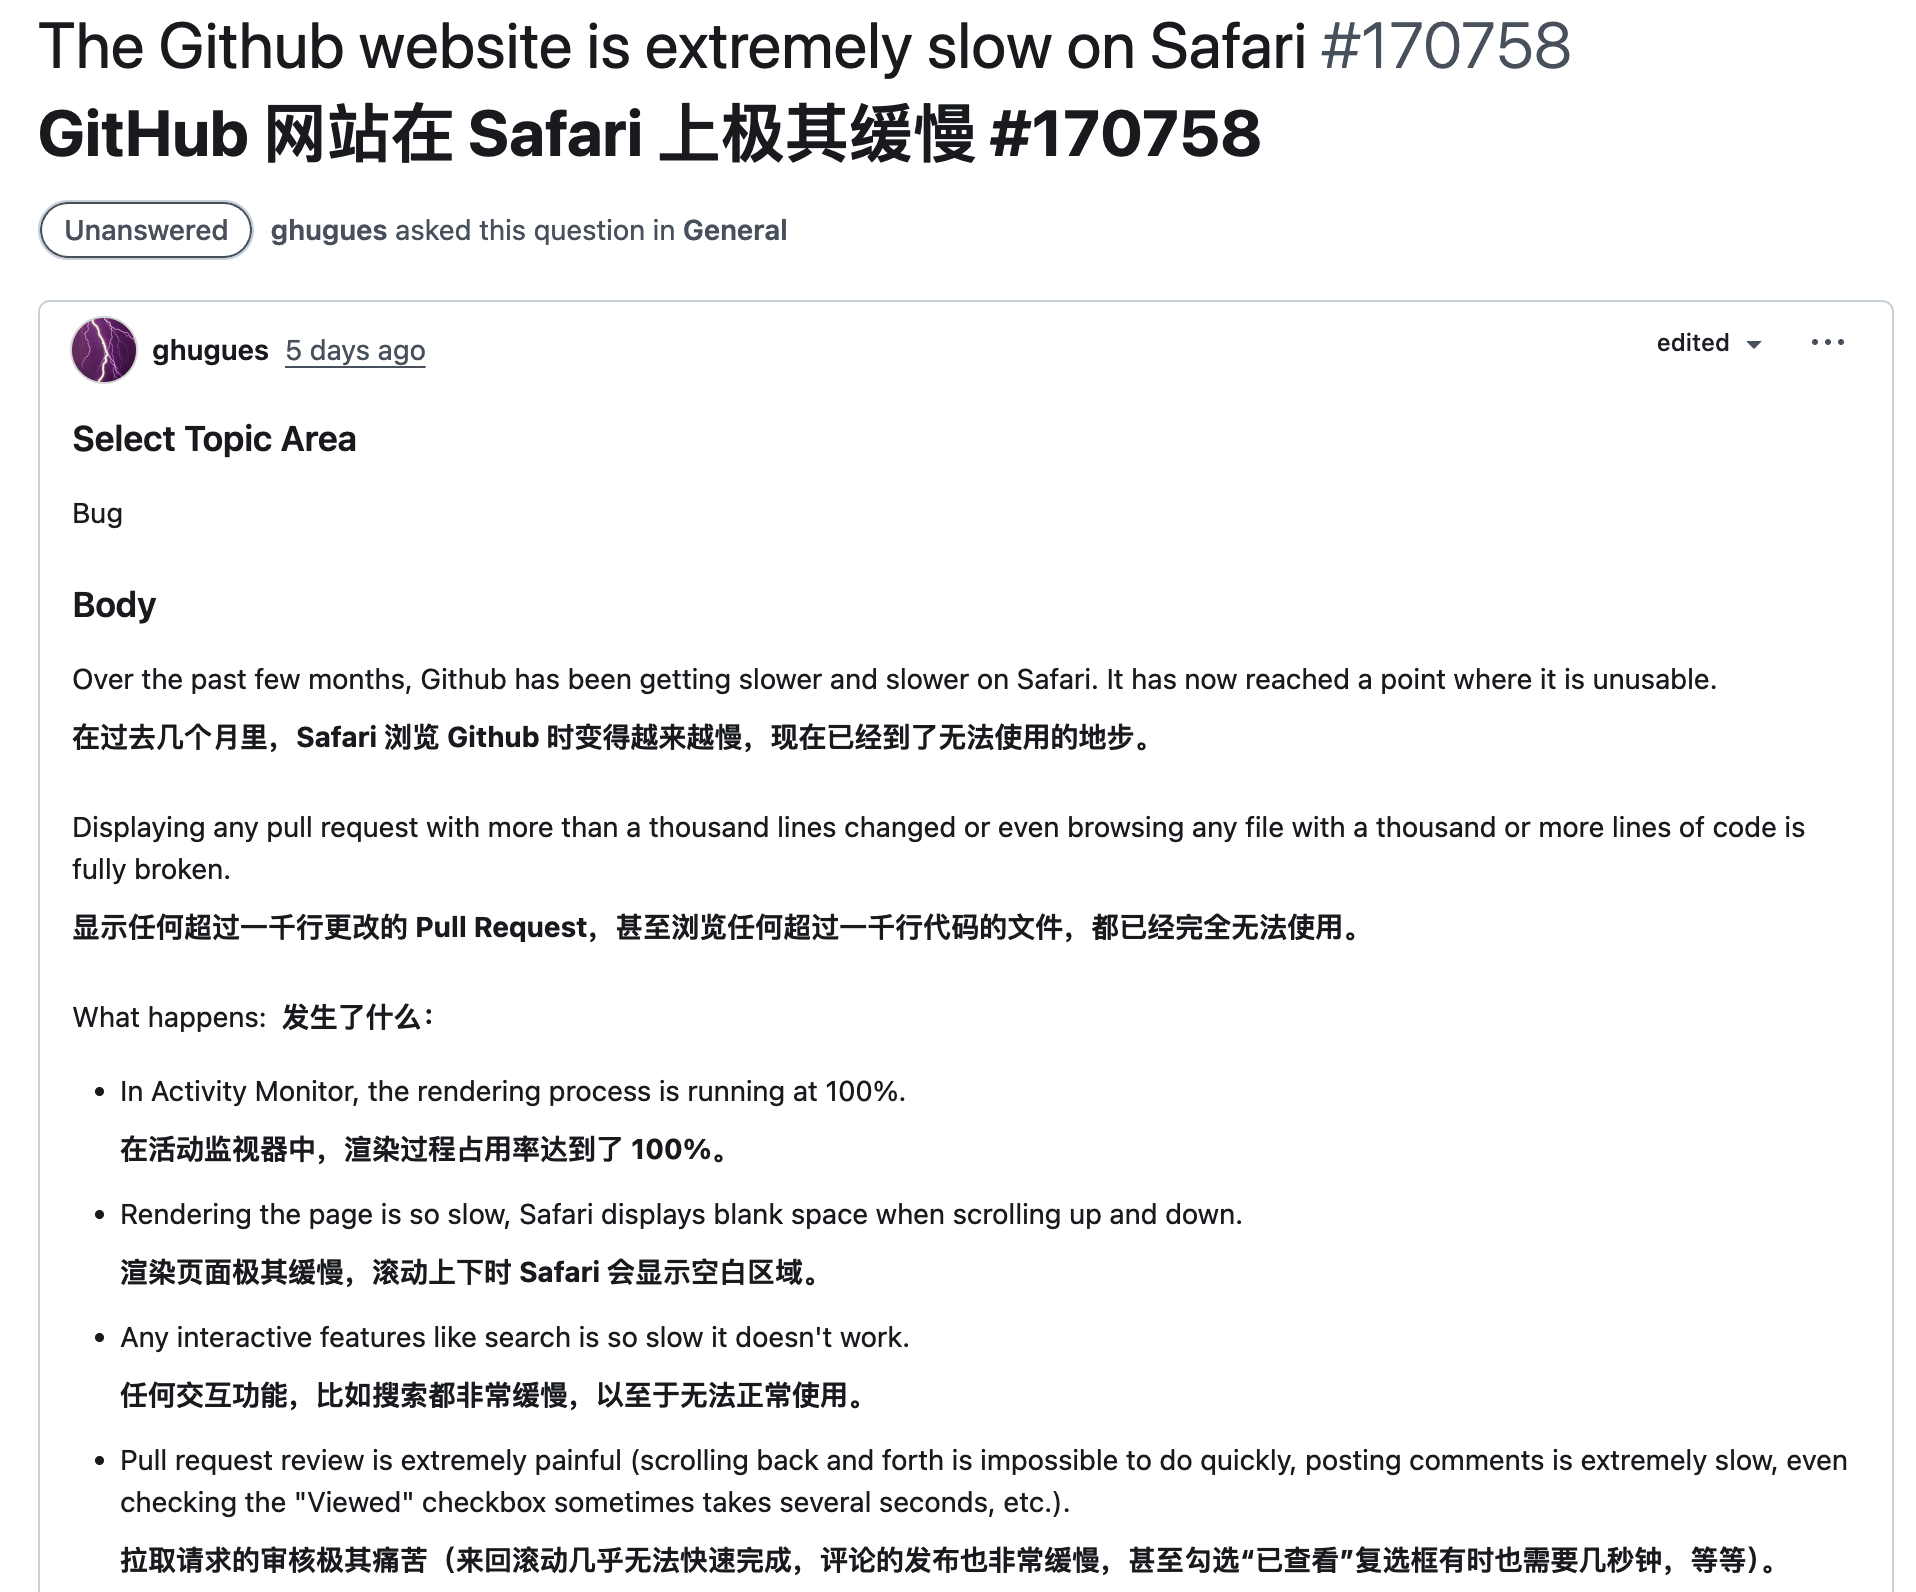
近日有开发者向 GitHub 反馈称,他在 Safari 浏览器上访问 GitHub 越来越缓慢,已接近“不可用”状态: 渲染进程 CPU 使用率高达 100%。 上下滚动时页面显示有空白,不流畅。 搜索与其他交互功能变得极其迟钝。 PR 评论非常难操作,即便标记「Viewed」也需耗费几秒钟以上。 系统为 M4 Max 16-core + 48GB RAM,性能非常强,但 GitHub 是唯一存在问题的网站。 Chrome 表现明显更好,但在处理非常大的 PR(成千行代码)时仍会卡顿。 https://github.com/orgs/community/discussions/170758 GitHub bots 表示反馈已提交供产品团队进一步评估。在这条反馈的评论区中,多位用户也表示遇到了相同问题,包括 PR 页面完全卡死,按钮点击无响应,标记标签等操作耗时显著。 GitHub 维护者询问了用户的 Safari 版本,用户反馈多数使用 Safari 18.6 (20621.3.11.11.3)(macOS Sequoia)。有开发者称可能是 GitHub 前端最近变更的 CSS 触发了 Safari 的性能缺陷。

优秀的个人博客,低调大师

XtarBackup 8.0.33-28 prepare 速度提升 20 倍!

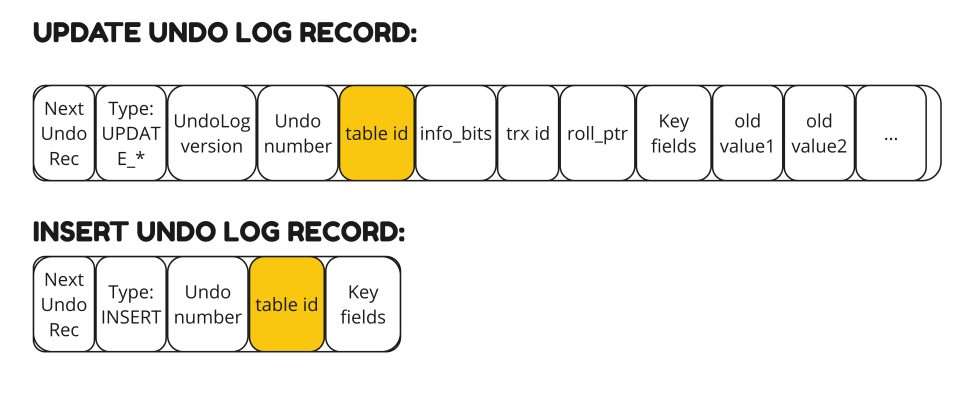
在这篇博文中,我们将描述 Percona XtraBackup 8.0.33-28 的改进,这显著减少了备份准备所需的时间,以便进行恢复操作。 Percona XtraBackup 中的这一改进显着缩短了新节点加入 Percona XtraDB 集群(PXC) 所需的时间。 Percona XtraDB Cluster 使用 Percona XtraBackup 在节点之间执行 SST(状态快照传输)。当一个新节点加入集群时,会从 DONOR 到 JOINER 执行 SST。 JOINER 使用 PXB 从 DONOR 流式传输数据目录。 JOINER 必须在使用它之前准备备份。 观察到,当 DONOR 拥有大量表空间(一百万个)时,JOINER 一侧的 XtraBackup 无法完成数据准备阶段(xtrabackup -prepare)。 Prepare 阶段 Percona XtraBackup 复制 InnoDB 数据文件。数据在服务器并发修改数据文件时内部不一致,因为服务器并发地修改数据文件。 Percona XtraBackup 对文件执行崩溃恢复,以再次创建一致的可用数据库。 这称为 Prepare 操作(xtrabackup -prepare)。 XtraBackup Prepare 操作分两个阶段进行: Redo Log 应用 Undo Log 应用 Redo Log 应用阶段 将 Redo Log 文件修改的更改应用于页面。 此阶段没有行或事务的概念。Redo 应用阶段不会使数据库与事务一致。服务器可以刷新或写入未提交事务的更改到 Redo Log 中。 XtraBackup 仍应用记录在 Redo Log 中的修改,并且 Redo Log 应用阶段不会撤消这些更改。为此,我们必须使用 Undo Log。 Undo Log 应用阶段 Undo Log 应用阶段(也称为回滚阶段),将读取 Undo Log 页面中的更改以撤消事务。然后它们再次应用于页面(例如,再次写入旧值),并写入磁盘。在此阶段之后,备份过程中所有未提交的事务都会被回滚。 Undo Log 记录有两种类型:INSERT Undo Log 记录和 UPDATE Undo Log 记录。 删除记录标记被视为 UPDATE UNDO Log 记录的子类型。 格式如下所示: 当服务器写入这些记录时,它不会与每个记录一起写入索引/表信息。它只将“table_id”写入作为 UNDO LOG 记录的一部分。 table_id 用于获取表架构。 从 Undo Log 记录中获取表架构和关键字段用于创建索引搜索元组(Key)。 此搜索元组(Key)用于查找要执行撤消操作的记录。 所以,给定一个 table_id,你如何获取表架构/定义? 在服务器上初始化“数据字典”(DD)引擎和 DD 缓存后,存储引擎可以请求表定义。例如,InnoDB 根据也称为“se_private_id”的 table_id 请求表定义。 与服务器不同,Percona XtraBackup 无法访问“数据字典”(DD)。初始化 DD 引擎和缓存会增加复杂性和其他服务器依赖项。XtraBackup 不会简单地像服务器一样访问表对象。 为何 Percona XtraBackup 受到数以千计的企业信赖? Percona XtraBackup 初始化 InnoDB 引擎,并需要所有目的(回滚、导出等)的“InnoDB 表对象”,也称为 dict_table_t。XtraBackup 依靠序列化字典信息(SDI)。 这是表的 JSON 表示形式。 对于 InnoDB 表空间,该信息存储在表空间内。从 8.0 开始,IBD 文件是“自描述的”;例如,表架构在 IBD 文件中可用。 让我们看一个示例表。 CREATE TABLE test.t1(a INT PRIMARY KEY, b INT); CREATE TABLE 语句在 test 目录中创建一个名为 t1.ibd 的文件。例如,mysql datadir/test/t1.ibd。 因此 t1.ibd 包含有关表结构(列、它们的类型、索引数量、索引中的列、外键等)的信息作为 SDI。 使用名为“ibd2sdi”的工具从 IBD 文件中提取 SDI。 ibd2sdi data/test/t1.ibd > t1.sdi 如您所见,表名在“dd_object:name”字段中,列信息存储在“dd_object:columns”数组中。 以往的设计(8.0.33-28 之前) XtraBackup 从每个 IBD 读取 SDI 并将 每个 IBD 中的所有表加载到缓存中作为不可驱逐的。本质上,通过将表加载为不可驱逐来禁用 LRU 缓存。 每个表保留在内存中,直到 XtraBackup 退出。 这种方法的问题: 加载不需要回滚的表。 从读取表的 SDI 页面进行不必要的 IO 操作。 加载不必要的表会增加准备所需的时间。 占用内存可能导致 OOM。 如果备份目录包含大量 表/IBD 文件,则会导致 XtraBackup Prepare 操作崩溃。 加入 PXC 集群的节点需要更多内存并花费很长时间加入集群。 为什么 XtraBackup 会将表加载为“不可驱逐”?我们可以只是将它们加载为可驱逐来解决问题吗?假设一个表被驱逐,必须再次加载它。XtraBackup 将如何知道包含被驱逐表的表空间(IBD)?它必须再次扫描每个 IBD 才能找到被驱逐的表。 新的设计(8.0.33-28 开始) 为了将表加载为可驱逐的,必须建立 table_id 和包含表的表空间 space_id 之间的关系。它是通过扫描数据字典表 mysql.indexes 和 mysql.index_partitions 的 B 树页面完成的。 建立此 table_id→space_id 关系后,它将在事务回滚期间使用。在这种新设计中,只有在它们上面有事务回滚时,才会加载用户表。 新设计如下: 当达到缓存大小限制或由后台主线程时,缓存中的表将被逐出。 新设计的好处(xtrabackup -prepare): 使用更少的内存 使用更少的 IO 更快的准备 即使有大量表也能成功完成 节点更快地完成 SST 过程并快速加入 PXC 集群 节点需要更少的内存才能加入 PXC 集群 压测 在其他大小的备份目录上对 xtrabackup -prepare 进行基准测试,如 10K、50K、100K 和 250K 表。性能改进如下: 结论 正如您所见,从 Percona XtraBackup 8.0.33-28 开始,具有字典缓存的 xtrabackup -prepare 更快、更高效。 改进将取决于备份目录中的表空间文件(IBD)数量。 新节点加入 PXC 集群所需的时间也大大减少,因为 SST 过程将更快完成。 更多技术文章,请访问:https://opensource.actionsky.com/ 关于 SQLE 爱可生开源社区的 SQLE 是一款面向数据库使用者和管理者,支持多场景审核,支持标准化上线流程,原生支持 MySQL 审核且数据库类型可扩展的 SQL 审核工具。 SQLE 获取 类型 地址 版本库 https://github.com/actiontech/sqle 文档 https://actiontech.github.io/sqle-docs/ 发布信息 https://github.com/actiontech/sqle/releases 数据审核插件开发文档 https://actiontech.github.io/sqle-docs/docs/dev-manual/plugins/howtouse

优秀的个人博客,低调大师

XtraBackup 8.0.33-28 prepare 速度提升 20 倍!

在这篇博文中,我们将描述 Percona XtraBackup 8.0.33-28 的改进,这显著减少了备份准备所需的时间,以便进行恢复操作。 Percona XtraBackup 中的这一改进显着缩短了新节点加入 Percona XtraDB 集群(PXC) 所需的时间。 Percona XtraDB Cluster 使用 Percona XtraBackup 在节点之间执行 SST(状态快照传输)。当一个新节点加入集群时,会从 DONOR 到 JOINER 执行 SST。 JOINER 使用 PXB 从 DONOR 流式传输数据目录。 JOINER 必须在使用它之前准备备份。 观察到,当 DONOR 拥有大量表空间(一百万个)时,JOINER 一侧的 XtraBackup 无法完成数据准备阶段(xtrabackup -prepare)。 Prepare 阶段 Percona XtraBackup 复制 InnoDB 数据文件。数据在服务器并发修改数据文件时内部不一致,因为服务器并发地修改数据文件。 Percona XtraBackup 对文件执行崩溃恢复,以再次创建一致的可用数据库。 这称为 Prepare 操作(xtrabackup -prepare)。 XtraBackup Prepare 操作分两个阶段进行: Redo Log 应用 Undo Log 应用 Redo Log 应用阶段 将 Redo Log 文件修改的更改应用于页面。 此阶段没有行或事务的概念。Redo 应用阶段不会使数据库与事务一致。服务器可以刷新或写入未提交事务的更改到 Redo Log 中。 XtraBackup 仍应用记录在 Redo Log 中的修改,并且 Redo Log 应用阶段不会撤消这些更改。为此,我们必须使用 Undo Log。 Undo Log 应用阶段 Undo Log 应用阶段(也称为回滚阶段),将读取 Undo Log 页面中的更改以撤消事务。然后它们再次应用于页面(例如,再次写入旧值),并写入磁盘。在此阶段之后,备份过程中所有未提交的事务都会被回滚。 Undo Log 记录有两种类型:INSERT Undo Log 记录和 UPDATE Undo Log 记录。 删除记录标记被视为 UPDATE UNDO Log 记录的子类型。 格式如下所示: 当服务器写入这些记录时,它不会与每个记录一起写入索引/表信息。它只将“table_id”写入作为 UNDO LOG 记录的一部分。 table_id 用于获取表架构。 从 Undo Log 记录中获取表架构和关键字段用于创建索引搜索元组(Key)。 此搜索元组(Key)用于查找要执行撤消操作的记录。 所以,给定一个 table_id,你如何获取表架构/定义? 在服务器上初始化“数据字典”(DD)引擎和 DD 缓存后,存储引擎可以请求表定义。例如,InnoDB 根据也称为“se_private_id”的 table_id 请求表定义。 与服务器不同,Percona XtraBackup 无法访问“数据字典”(DD)。初始化 DD 引擎和缓存会增加复杂性和其他服务器依赖项。XtraBackup 不会简单地像服务器一样访问表对象。 为何 Percona XtraBackup 受到数以千计的企业信赖? Percona XtraBackup 初始化 InnoDB 引擎,并需要所有目的(回滚、导出等)的“InnoDB 表对象”,也称为 dict_table_t。XtraBackup 依靠序列化字典信息(SDI)。 这是表的 JSON 表示形式。 对于 InnoDB 表空间,该信息存储在表空间内。从 8.0 开始,IBD 文件是“自描述的”;例如,表架构在 IBD 文件中可用。 让我们看一个示例表。 CREATE TABLE test.t1(a INT PRIMARY KEY, b INT); CREATE TABLE 语句在 test 目录中创建一个名为 t1.ibd 的文件。例如,mysql datadir/test/t1.ibd。 因此 t1.ibd 包含有关表结构(列、它们的类型、索引数量、索引中的列、外键等)的信息作为 SDI。 使用名为“ibd2sdi”的工具从 IBD 文件中提取 SDI。 ibd2sdi data/test/t1.ibd > t1.sdi 如您所见,表名在“dd_object:name”字段中,列信息存储在“dd_object:columns”数组中。 以往的设计(8.0.33-28 之前) XtraBackup 从每个 IBD 读取 SDI 并将 每个 IBD 中的所有表加载到缓存中作为不可驱逐的。本质上,通过将表加载为不可驱逐来禁用 LRU 缓存。 每个表保留在内存中,直到 XtraBackup 退出。 这种方法的问题: 加载不需要回滚的表。 从读取表的 SDI 页面进行不必要的 IO 操作。 加载不必要的表会增加准备所需的时间。 占用内存可能导致 OOM。 如果备份目录包含大量 表/IBD 文件,则会导致 XtraBackup Prepare 操作崩溃。 加入 PXC 集群的节点需要更多内存并花费很长时间加入集群。 为什么 XtraBackup 会将表加载为“不可驱逐”?我们可以只是将它们加载为可驱逐来解决问题吗?假设一个表被驱逐,必须再次加载它。XtraBackup 将如何知道包含被驱逐表的表空间(IBD)?它必须再次扫描每个 IBD 才能找到被驱逐的表。 新的设计(8.0.33-28 开始) 为了将表加载为可驱逐的,必须建立 table_id 和包含表的表空间 space_id 之间的关系。它是通过扫描数据字典表 mysql.indexes 和 mysql.index_partitions 的 B 树页面完成的。 建立此 table_id→space_id 关系后,它将在事务回滚期间使用。在这种新设计中,只有在它们上面有事务回滚时,才会加载用户表。 新设计如下: 当达到缓存大小限制或由后台主线程时,缓存中的表将被逐出。 新设计的好处(xtrabackup -prepare): 使用更少的内存 使用更少的 IO 更快的准备 即使有大量表也能成功完成 节点更快地完成 SST 过程并快速加入 PXC 集群 节点需要更少的内存才能加入 PXC 集群 压测 在其他大小的备份目录上对 xtrabackup -prepare 进行基准测试,如 10K、50K、100K 和 250K 表。性能改进如下: 结论 正如您所见,从 Percona XtraBackup 8.0.33-28 开始,具有字典缓存的 xtrabackup -prepare 更快、更高效。 改进将取决于备份目录中的表空间文件(IBD)数量。 新节点加入 PXC 集群所需的时间也大大减少,因为 SST 过程将更快完成。 更多技术文章,请访问:https://opensource.actionsky.com/ 关于 SQLE 爱可生开源社区的 SQLE 是一款面向数据库使用者和管理者,支持多场景审核,支持标准化上线流程,原生支持 MySQL 审核且数据库类型可扩展的 SQL 审核工具。 SQLE 获取 类型 地址 版本库 https://github.com/actiontech/sqle 文档 https://actiontech.github.io/sqle-docs/ 发布信息 https://github.com/actiontech/sqle/releases 数据审核插件开发文档 https://actiontech.github.io/sqle-docs/docs/dev-manual/plugins/howtouse

优秀的个人博客,低调大师

NestJS v10 发布,速度提升 20 倍

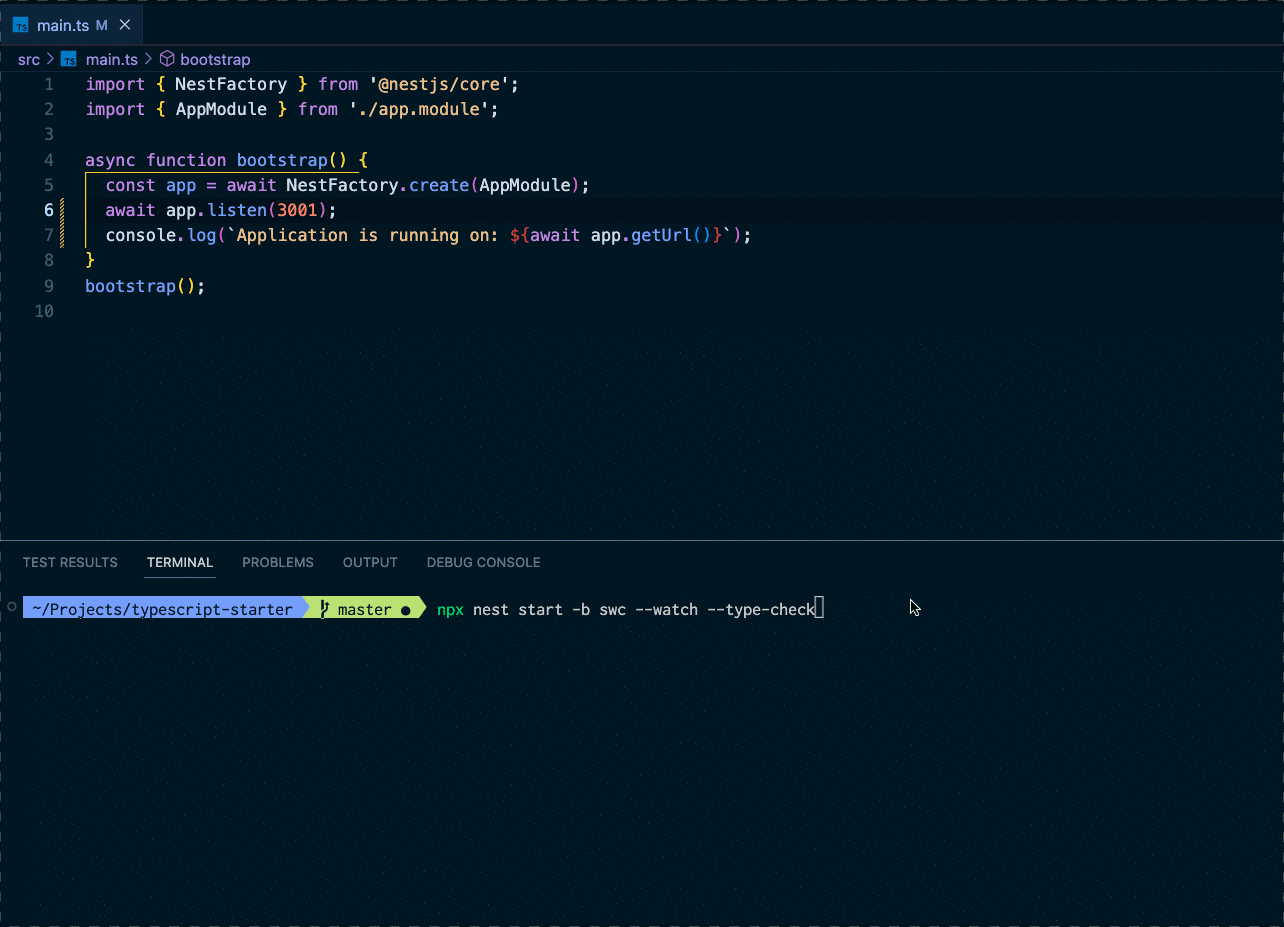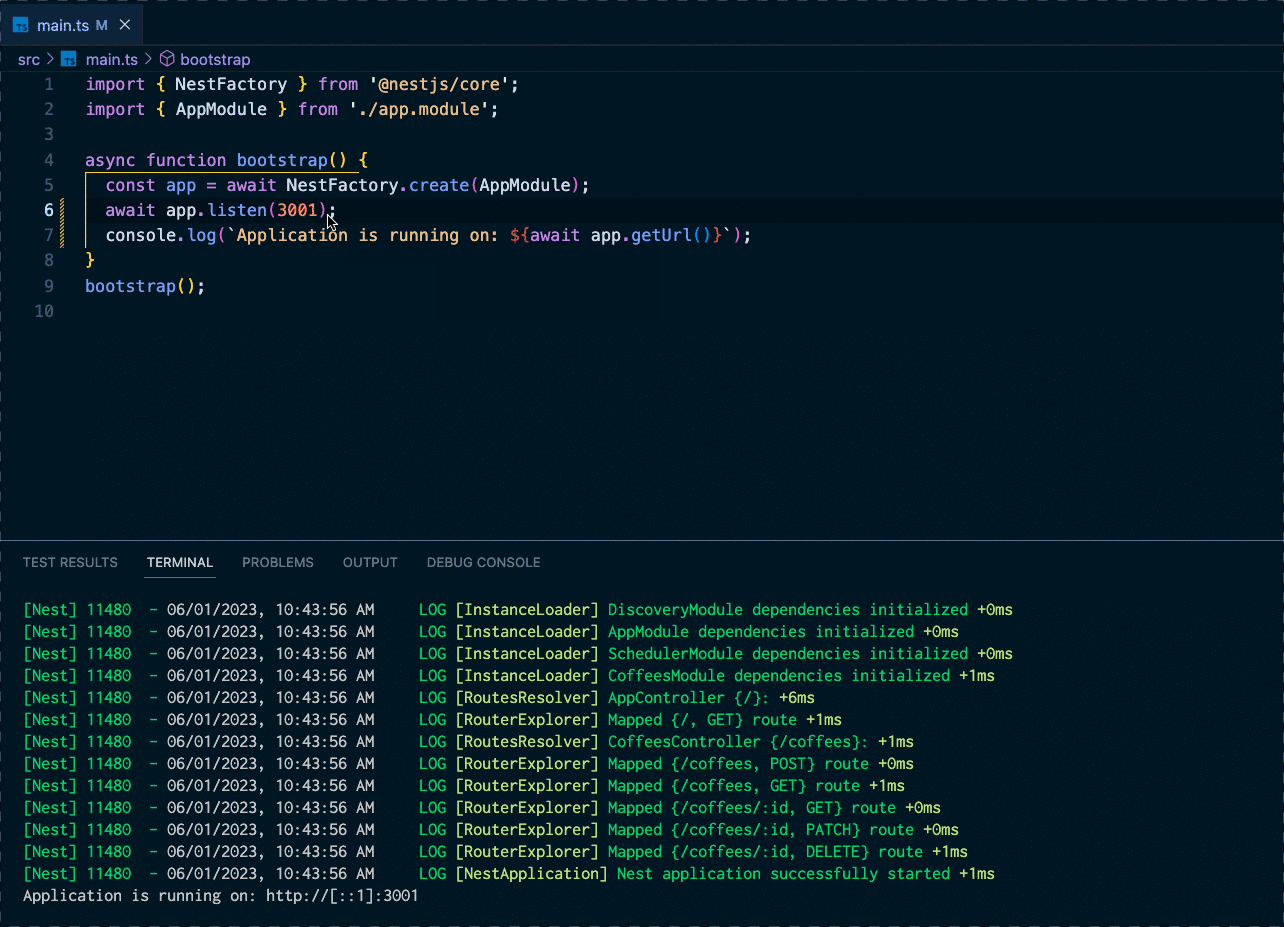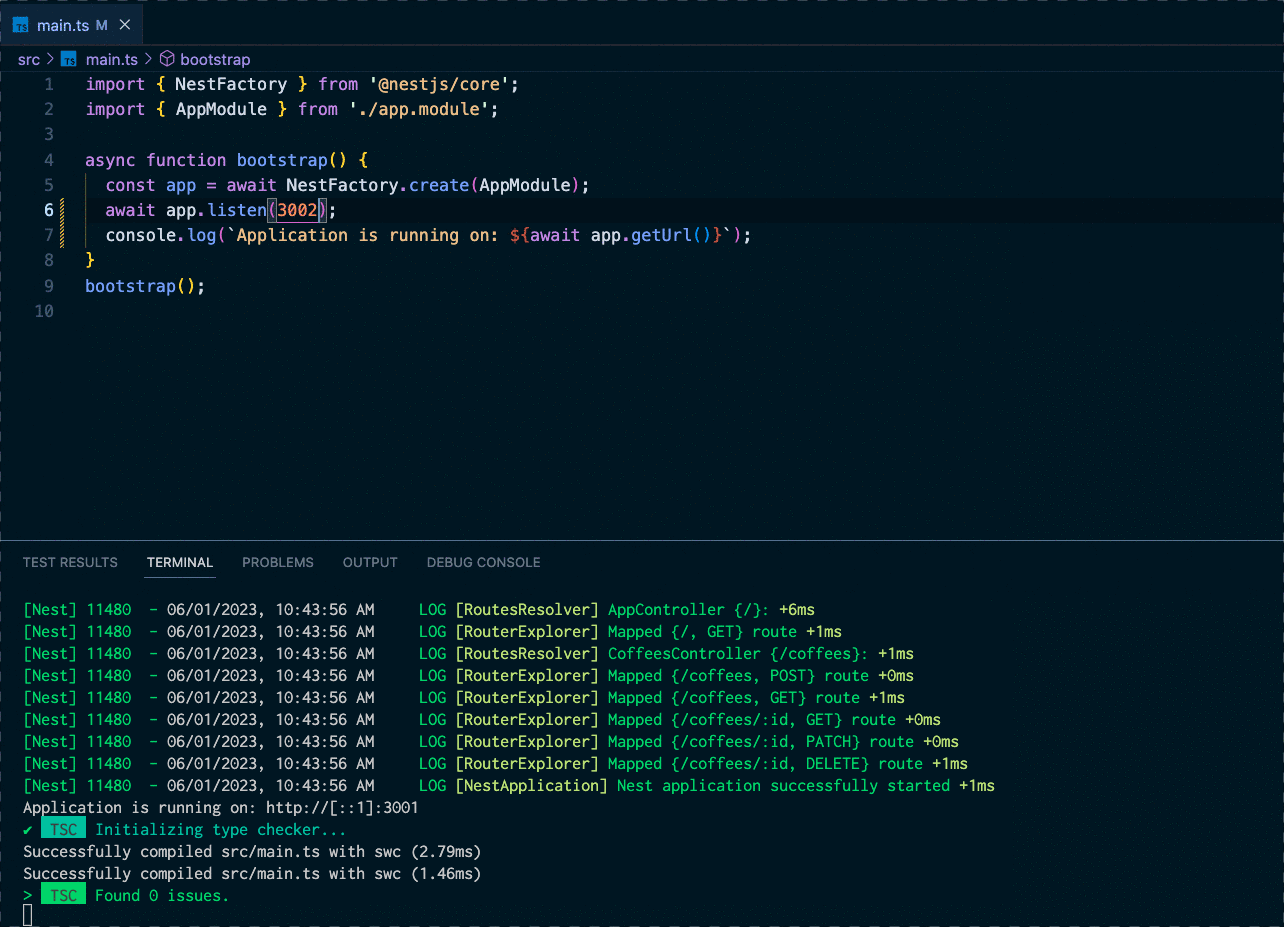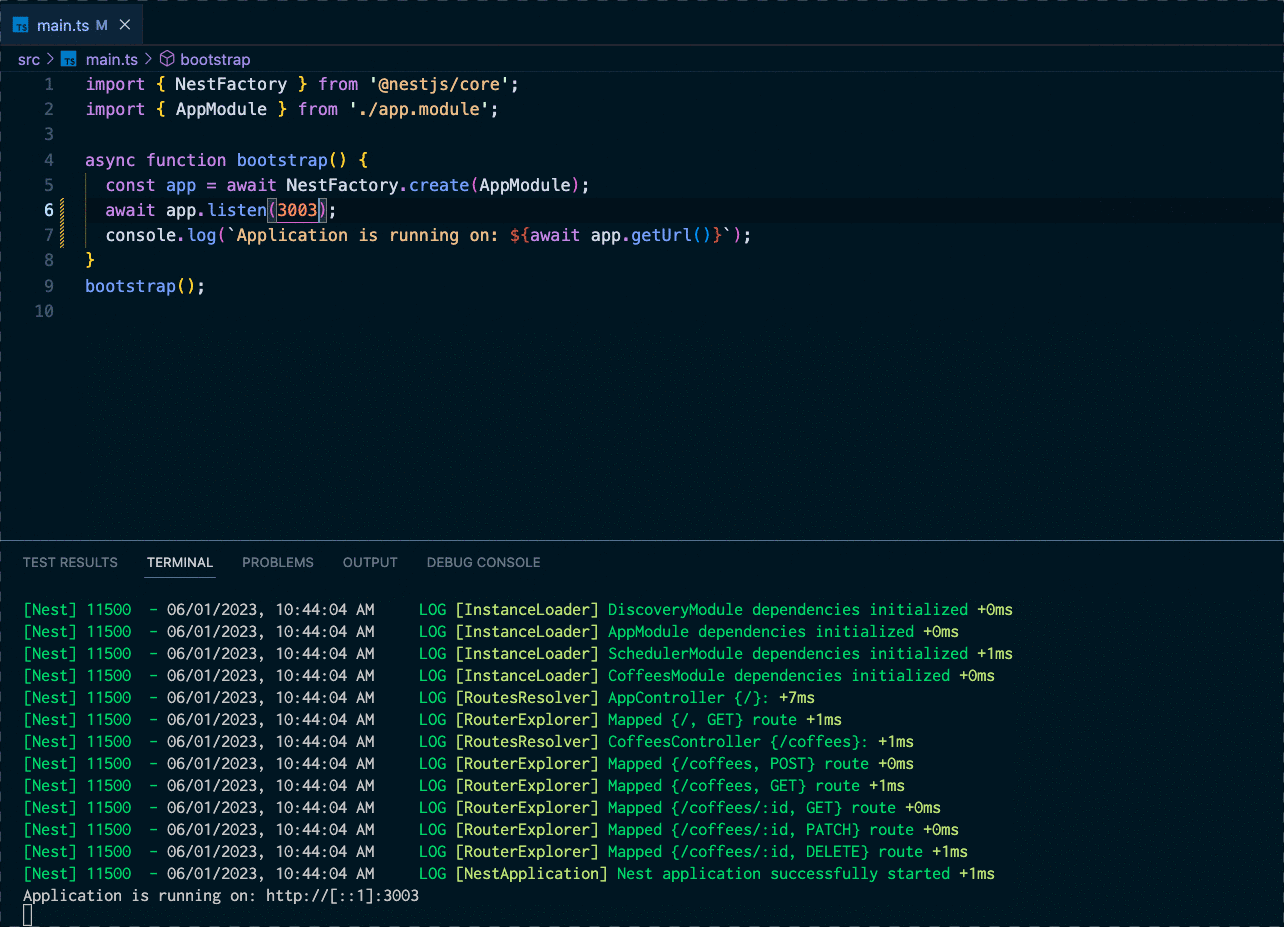
NestJS 是一个 TypeScript Node.js 框架,帮助你建立企业级高效和可扩展的 Node.js 应用程序。 近日 NestJS v10 正式发布。这个版本带来了大量的错误修复、改进和新功能。 SWC SWC(Speedy Web Compiler)是一个基于 Rust 的可扩展平台,将 SWC 与 Nest CLI 一起使用可以大大加快你的开发过程。SWC 大约比默认的 TypeScript 编译器快 20 倍。 在 NestJS v10 中,你可以通过简单地将-b swc标志传递给nest start命令来使用 SWC,如下所示: 在测试中重写模块 NestJS 10 引入了一个新功能,允许你在测试中重写模块。当你想一次性模拟整个模块而不是单独模拟每个时,这个功能特别有用。 Test.createTestingModule({ ...}) .overrideModule(LoggerModule) .useModule(LoggerTestingModule) .compile(); Redis 通配符订阅 在 NestJS v10 中,增加了对 Redis 通配符订阅的支持。这个功能允许你订阅所有符合给定模式的消息。只要你在你的微服务配置中把wildcards配置属性设置为true,如下所示: const app = await NestFactory.createMicroservice<MicroserviceOptions>( AppModule, { transport: Transport.REDIS, options: { host: 'localhost', port: 6379, wildcards: true, // 👈 THIS IS NEW }, }); CacheModule CacheModule 已经从 @nestjs/common 包中删除,现在可以将其作为一个独立的包 @nestjs/cache-manager 来使用。这一改变是为了避免在 @nestjs/common 包中出现不必要的依赖。 放弃 Node.js v12 的支持 从 NestJS 10 开始,将不再支持 Node.js v12,NestJS 10 需要 Node.js v16 或更高版本。 CLI 插件 NestJS CLI 插件现在需要 TypeScript >= v4.8,旧版本的 TypeScript 将不再被支持。 更多详情可查看:https://github.com/nestjs/nest/releases/tag/v10.0.0

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册