Java NIO之缓冲区
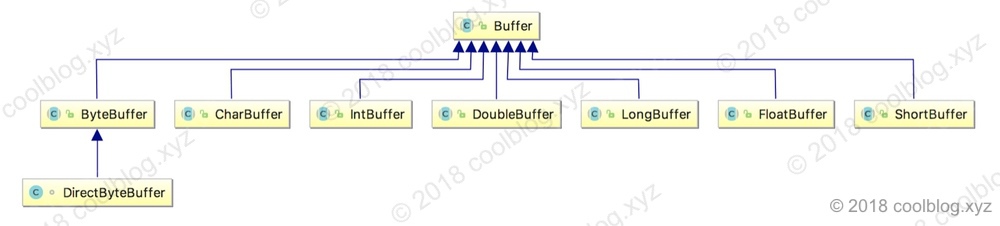
1.简介 Java NIO 相关类在 JDK 1.4 中被引入,用于提高 I/O 的效率。Java NIO 包含了很多东西,但核心的东西不外乎 Buffer、Channel 和 Selector。本文中,我们先来聊聊的 Buffer 的实现。Channel 和 Selector 将在随后的文章中讲到。 2.继承体系 Buffer 的继承类比较多,用于存储各种类型的数据。包括 ByteBuffer、CharBuffer、IntBuffer、FloatBuffer 等等。这其中,ByteBuffer 最为常用。所以接下来将会主要分析 ByteBuffer 的实现。Buffer 的继承体系图如下: 3.属性及相关操作 Buffer 本质就是一个数组,只不过在数组的基础上进行适当的封装,方便使用。 Buffer 中有几个重要的属性,通过这几个属性来显示数据存储的信息。这个属性分别是: 属性 说明 capacity容量 Buffer 所能容纳数据元素的最大数量,也就是底层数组的容量值。在创建时被指定,不可更改。 position 位置 下一个被读或被写的位置 limit 上界 可供读写的最大位置,用于限制position,position < limit mark 标记 位置标记,用于记录某一次的读写位置,可以通过 reset 重新回到这个位置 3.1 ByteBuffer 初始化 ByteBuffer 可通过 allocate、allocateDirect 和 wrap 等方法初始化,这里以 allocate 为例: public static ByteBuffer allocate(int capacity) { if (capacity < 0) throw new IllegalArgumentException(); return new HeapByteBuffer(capacity, capacity); } HeapByteBuffer(int cap, int lim) { super(-1, 0, lim, cap, new byte[cap], 0); } ByteBuffer(int mark, int pos, int lim, int cap, byte[] hb, int offset) { super(mark, pos, lim, cap); this.hb = hb; this.offset = offset; } 上面是 allocate 创建 ByteBuffer 的过程,ByteBuffer 是抽象类,所以实际上创建的是其子类 HeapByteBuffer。HeapByteBuffer 在构造方法里调用父类构造方法,将一些参数值传递给父类。最后父类再做一次中转,相关参数最终被传送到 Buffer 的构造方法中了。我们再来看一下 Buffer 的源码: public abstract class Buffer { // Invariants: mark <= position <= limit <= capacity private int mark = -1; private int position = 0; private int limit; private int capacity; Buffer(int mark, int pos, int lim, int cap) { // package-private if (cap < 0) throw new IllegalArgumentException("Negative capacity: " + cap); this.capacity = cap; limit(lim); position(pos); if (mark >= 0) { if (mark > pos) throw new IllegalArgumentException("mark > position: (" + mark + " > " + pos + ")"); this.mark = mark; } } } Buffer 创建完成后,底层数组的结构信息如下: 上面的几个属性作为公共属性,被放在了 Buffer 中,相关的操作方法也是封装在 Buffer 中。那么接下来,我们来看看这些方法吧。 3.2 ByteBuffer 读写操作 ByteBuffer 读写操作时通过 get 和 put 完成的,这两个方法都有重载,我们只看其中一个。 // 读操作 public byte get() { return hb[ix(nextGetIndex())]; } final int nextGetIndex() { if (position >= limit) throw new BufferUnderflowException(); return position++; } // 写操作 public ByteBuffer put(byte x) { hb[ix(nextPutIndex())] = x; return this; } final int nextPutIndex() { if (position >= limit) throw new BufferOverflowException(); return position++; } 读写操作都会修改 position 的值,每次读写的位置是当前 position 的下一个位置。通过修改 position,我们可以读取指定位置的数据。当然,前提是 position < limit。Buffer 中提供了position(int) 方法用于修改 position 的值。 public final Buffer position(int newPosition) { if ((newPosition > limit) || (newPosition < 0)) throw new IllegalArgumentException(); position = newPosition; if (mark > position) mark = -1; return this; } 当我们向一个刚初始化好的 Buffer 中写入一些数据时,数据存储示意图如下: 如果我们想读取刚刚写入的数据,就需要修改 position 的值。否则 position 将指向没有存储数据的空间上,读取空白空间是没意义的。如上图,我们可以将 position 设置为 0,这样就能从头读取刚刚写入的数据。 仅修改 position 的值是不够的,如果想正确读取刚刚写入的数据,还需修改 limit 的值,不然还是会读取到空白空间上的内容。我们将 limit 指向数据区域的尾部,即可避免这个问题。修改 limit 的值通过 limit(int) 方法进行。 public final Buffer limit(int newLimit) { if ((newLimit > capacity) || (newLimit < 0)) throw new IllegalArgumentException(); limit = newLimit; if (position > limit) position = limit; if (mark > limit) mark = -1; return this; } 修改后,数据存储示意图如下: 上面为了正确读取写入的数据,需要两步操作。Buffer 中提供了一个便利的方法,将这两步操作合二为一,即 flip 方法。 public final Buffer flip() { // 1. 设置 limit 为当前位置 limit = position; // 1. 设置 position 为0 position = 0; mark = -1; return this; } 3.3 ByteBuffer 标记 我们在读取或写入的过程中,可以在感兴趣的位置打上一个标记,这样我们可以通过这个标记再次回到这个位置。Buffer 中,打标记的方法是 mark,回到标记位置的方法时 reset。简单看下源码吧。 public final Buffer mark() { mark = position; return this; } public final Buffer reset() { int m = mark; if (m < 0) throw new InvalidMarkException(); position = m; return this; } 打标记及回到标记位置的流程如下: 4.DirectByteBuffer 在 ByteBuffer 初始化一节中,我介绍了 ByteBuffer 的 allocate 方法,该方法实际上创建的是 HeapByteBuffer 对象。除了 allocate 方法,ByteBuffer 还有一个方法 allocateDirect。这个方法创建的是 DirectByteBuffer 对象。两者有什么区别呢?简单的说,allocate 方法所请求的空间是在 JVM 堆内进行分配的,而 allocateDirect 请求的空间则是在 JVM 堆外的,这部分空间不被 JVM 所管理。那么堆内空间和堆空间在使用上有什么不同呢?用一个表格列举一下吧。 空间类型 优点 缺点 堆内空间 分配速度快 JVM 整理内存空间时,堆内空间的位置会被搬动,比较笨重 堆外空间 1. 空间位置固定,不用担心空间被 JVM 随意搬动 2. 降低堆内空间的使用率 1. 分配速度慢 2. 回收策略比较复杂 DirectByteBuffer 牵涉的底层技术点比较多,想要弄懂,还需要好好打基础才行。由于本人目前能力很有限,关于 DirectByteBuffer 只能简单讲讲。待后续能力提高时,我会再来重写这部分的内容。如果想了解这方面的内容,建议大家看看其他的文章。 5.总结 Buffer 是 Java NIO 中一个重要的辅助类,使用比较频繁。在不熟悉 Buffer 的情况下,有时候很容易因为忘记调用 flip 或其他方法导致程序出错。不过好在 Buffer 的源码不难理解,大家可以自己看看,这样可以避免出现一些奇怪的错误。 好了,本文到这里就结束了,谢谢阅读! 本文在知识共享许可协议 4.0 下发布,转载需在明显位置处注明出处 作者:coolblog 本文同步发布在我的个人博客:http://www.coolblog.xyz/?r=cb 本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。