首页 文章 精选 留言 我的

精选列表

搜索[关系代数],共10001篇文章
优秀的个人博客,低调大师

ARM MOV和 LDR指令关系

ARM是RISC结构,数据从内存到CPU之间的移动只能通过L/S指令来完成,也就是ldr/str指令。 比如想把数据从内存中某处读取到寄存器中,只能使用ldr 比如: ldr r0, 0x12345678就是把0x12345678这个地址中的值存放到r0中。 而mov不能干这个活,mov只能在寄存器之间移动数据,或者把立即数移动到寄存器中,这个和x86这种CISC架构的芯片区别最大的地方。 x86中没有ldr这种指令,因为x86的mov指令可以将数据从内存中移动到寄存器中。 另外还有一个就是ldr伪指令,虽然ldr伪指令和ARM的ldr指令很像,但是作用不太一样。ldr伪指令可以在立即数前加上=,以表示把一个地址写到某寄存器中,比如: ldr r0, =0x12345678 这样,就把0x12345678这个地址写到r0中了。所以,ldr伪指令和mov是比较相似的。只不过mov指令限制了立即数的长度为8位,也就是不能超过512。而ldr伪指令没有这个限制。如果使用ldr伪指令时,后面跟的立即数没有超过8位,那么在实际汇编的时候该ldr伪指令是被转换为mov指令的。 ARM中LDR伪指令与LDR加载指令 ARM指令集中,LDR通常都是作加载指令的,但是它也可以作伪指令。 LDR伪指令的形式是“LDR Rn,=expr”。下面举一个例子来说明它的用法。 COUNT EQU 0x40003100 …… LDR R1,=COUNT MOV R0,#0 STR R0,[R1] COUNT是我们定义的一个变量,地址为0x40003100。这中定义方法在汇编语言中是很常见的,如果使用过单片机的话,应该都熟悉这种用法。 LDR R1,=COUNT是将COUNT这个变量的地址,也就是0x40003100放到R1中。 MOV R0,#0是将立即数0放到R0中。最后一句STR R0,[R1]是一个典型的存储指令,将R0中的值放到以R1中的值为地址的存储单元去。实际就是将0放到地址为0x40003100的存储单元中去。可 见这三条指令是为了完成对变量COUNT赋值。用三条指令来完成对一个变量的赋值,看起来有点不太舒服。这可能跟ARM的采用RISC有关。 下面还有一个例子 ;将COUNT的值赋给R0 LDR R1,=COUNT LDR R0,[R1] LDR R1,=COUNT这条伪指令,是怎样完成将COUNT的地址赋给R1,有兴趣的可以看它编译后的结果。这条指令实际上会编译成一条LDR指令和一条DCD伪指令。 LDR 的两种用法 1)LDR pc, =MyHandleIRQ 表示将MyHandleIRQ符号放入pc寄存器中 2)LDR PC,MyHandleIRQ 表示将读取存储器中MyHandleIRQ符号所表示的地址中的值,及需要多读一次存储器。 分类: arm solve 本文转自wanqi博客园博客,原文链接http://www.cnblogs.com/wanqieddy/archive/2011/10/08/2202268.html :如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop Hive与Hbase关系 整合

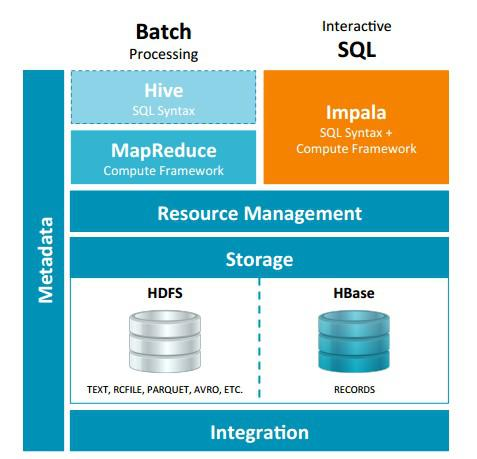
用hbase做数据库,但因为hbase没有类sql查询方式,所以操作和计算数据很不方便,于是整合hive,让hive支撑在hbase数据库层面 的 hql查询.hive也即 做数据仓库 1. 基于Hadoop+Hive架构对海量数据进行查询:http://blog.csdn.net/kunshan_shenbin/article/details/7105319 2. HBase 0.90.5 + Hadoop 1.0.0 集成:http://blog.csdn.net/kunshan_shenbin/article/details/7209990 本文的目的是要讲述怎样让Hbase和Hive能互相訪问,让Hadoop/Hbase/Hive协同工作。合为一体。 本文測试步骤主要參考自:http://running.iteye.com/blog/898399 当然。这边博文也是依照官网的步骤来的:http://wiki.apache.org/hadoop/Hive/HBaseIntegration 1. 拷贝hbase-0.90.5.jar和zookeeper-3.3.2.jar到hive/lib下。 注意:怎样hive/lib下已经存在这两个文件的其它版本号(比如zookeeper-3.3.1.jar),建议删除后使用hbase下的相关版本号。 2. 改动hive/conf下hive-site.xml文件。在底部加入例如以下内容: [html] view plaincopy <!-- <property> <name>hive.exec.scratchdir</name> <value>/usr/local/hive/tmp</value> </property> --> <property> <name>hive.querylog.location</name> <value>/usr/local/hive/logs</value> </property> <property> <name>hive.aux.jars.path</name> <value>file:///usr/local/hive/lib/hive-hbase-handler-0.8.0.jar,file:///usr/local/hive/lib/hbase-0.90.5.jar,file:///usr/local/hive/lib/zookeeper-3.3.2.jar</value> </property> 注意:假设hive-site.xml不存在则自行创建,或者把hive-default.xml.template文件改名后使用。 详细请參见:http://blog.csdn.net/kunshan_shenbin/article/details/7210020 3. 拷贝hbase-0.90.5.jar到全部hadoop节点(包含master)的hadoop/lib下。 4. 拷贝hbase/conf下的hbase-site.xml文件到全部hadoop节点(包含master)的hadoop/conf下。 注意。hbase-site.xml文件配置信息參照:http://blog.csdn.net/kunshan_shenbin/article/details/7209990 注意,假设3,4两步跳过的话。执行hive时非常可能出现例如以下错误: [html] view plaincopy org.apache.hadoop.hbase.ZooKeeperConnectionException: HBase is able to connect to ZooKeeper but the connection closes immediately. This could be a sign that the server has too many connections (30 is the default). Consider inspecting your ZK server logs for that error and then make sure you are reusing HBaseConfiguration as often as you can. See HTable's javadoc for more information. at org.apache.hadoop. hbase.zookeeper.ZooKeeperWatcher. 參考:http://blog.sina.com.cn/s/blog_410d18710100vlbq.html 如今能够尝试启动Hive了。 单节点启动: > bin/hive -hiveconf hbase.master=master:60000 集群启动: > bin/hive -hiveconf hbase.zookeeper.quorum=slave 怎样hive-site.xml文件里没有配置hive.aux.jars.path,则能够依照例如以下方式启动。 > bin/hive --auxpath /usr/local/hive/lib/hive-hbase-handler-0.8.0.jar, /usr/local/hive/lib/hbase-0.90.5.jar, /usr/local/hive/lib/zookeeper-3.3.2.jar -hiveconf hbase.zookeeper.quorum=slave 接下来能够做一些測试了。 1.创建hbase识别的数据库: [sql] view plaincopy CREATE TABLE hbase_table_1(key int, value string) STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler' WITH SERDEPROPERTIES ("hbase.columns.mapping" = ":key,cf1:val") TBLPROPERTIES ("hbase.table.name" = "xyz"); hbase.table.name 定义在hbase的table名称 hbase.columns.mapping 定义在hbase的列族 2.使用sql导入数据 a) 新建hive的数据表 [sql] view plaincopy <span><span></span></span>hive> CREATE TABLE pokes (foo INT, bar STRING); b) 批量插入数据 [sql] view plaincopy hive> LOAD DATA LOCAL INPATH './examples/files/kv1.txt' OVERWRITE INTO TABLE pokes; c) 使用sql导入hbase_table_1 [sql] view plaincopy hive> INSERT OVERWRITE TABLE hbase_table_1 SELECT * FROM pokes WHERE foo=86; 3. 查看数据 [sql] view plaincopy hive> select * from hbase_table_1; 这时能够登录Hbase去查看数据了. > /usr/local/hbase/bin/hbase shell hbase(main):001:0> describe 'xyz' hbase(main):002:0> scan 'xyz' hbase(main):003:0> put 'xyz','100','cf1:val','www.360buy.com' 这时在Hive中能够看到刚才在Hbase中插入的数据了。 hive> select * from hbase_table_1 4. hive訪问已经存在的hbase 使用CREATE EXTERNAL TABLE [sql] view plaincopy CREATE EXTERNAL TABLE hbase_table_2(key int, value string) STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler' WITH SERDEPROPERTIES ("hbase.columns.mapping" = "cf1:val") TBLPROPERTIES("hbase.table.name" = "some_existing_table"); 多列和多列族(Multiple Columns and Families) 1.创建数据库 Java代码 CREATE TABLE hbase_table_2(key int, value1 string, value2 int, value3 int) STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler' WITH SERDEPROPERTIES ( "hbase.columns.mapping" = ":key,a:b,a:c,d:e" ); 2.插入数据 Java代码 INSERT OVERWRITE TABLE hbase_table_2 SELECT foo, bar, foo+1, foo+2 FROM pokes WHERE foo=98 OR foo=100; 这个有3个hive的列(value1和value2,value3),2个hbase的列族(a,d) Hive的2列(value1和value2)相应1个hbase的列族(a。在hbase的列名称b,c)。hive的另外1列(value3)相应列(e)位于列族(d) 3.登录hbase查看结构 Java代码 hbase(main):003:0> describe "hbase_table_2" DESCRIPTION ENABLED {NAME => 'hbase_table_2', FAMILIES => [{NAME => 'a', COMPRESSION => 'N true ONE', VERSIONS => '3', TTL => '2147483647', BLOCKSIZE => '65536', IN_M EMORY => 'false', BLOCKCACHE => 'true'}, {NAME => 'd', COMPRESSION => 'NONE', VERSIONS => '3', TTL => '2147483647', BLOCKSIZE => '65536', IN _MEMORY => 'false', BLOCKCACHE => 'true'}]} 1 row(s) in 1.0630 seconds 4.查看hbase的数据 Java代码 hbase(main):004:0> scan 'hbase_table_2' ROW COLUMN+CELL 100 column=a:b, timestamp=1297695262015, value=val_100 100 column=a:c, timestamp=1297695262015, value=101 100 column=d:e, timestamp=1297695262015, value=102 98 column=a:b, timestamp=1297695242675, value=val_98 98 column=a:c, timestamp=1297695242675, value=99 98 column=d:e, timestamp=1297695242675, value=100 2 row(s) in 0.0380 seconds 5.在hive中查看 Java代码 hive> select * from hbase_table_2; OK 100 val_100 101 102 98 val_98 99 100 Time taken: 3.238 seconds 參考资料: http://running.iteye.com/blog/898399 http://heipark.iteye.com/blog/1150648 http://www.javabloger.com/article/apache-hadoop-hive-hbase-integration.html 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5094133.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

基于EMR的新一代数据湖存储加速技术详解

摘要:本文整理自阿里云开源大数据平台数据湖存储团队孙大鹏在7月17日阿里云数据湖技术专场交流会的分享。本篇内容主要分为两个部分: 背景介绍 JindoData 数据湖存储解决方案 点击查看直播回放 背景介绍 大数据行业蓬勃发展,主要源自于通讯技术的发展,全球数据规模,预计2025年将增长到163ZB,相当于全球60亿人,平均每人27TB数据。数据量爆发式增长,使得企业拥有了更多数据资源。更多数据意味着需要更大的存储。此外,数据本身极具价值,因此要挖掘数据价值并进行充分利用,以此反向推动业务的发展和改造。 大数据技术的发展趋势是云化、轻量化、服务化。数据湖、与云融合、实时计算已经成为大数据领域的关键词。存算分离概念在云计算早期已被提出。存储与计算耦合的自建平台会造成额外成本,且受限于本地网络带宽。有了云计算以后,网络带宽得到了很大缓解。可以按量收费,提供服务化、容器化的能力,更好地做运维开发。 业界存储架构演进 早期的大数据基于 HDFS 构建数仓。 HDFS 是非常好的分布式存储选型,单集群可稳定支撑到 4-6 亿文件规模,数据量可达 100 PB 。但是 HDFS 运维成本比较高,存储作为基础组件,一旦存储出现问题,则意味着整个业务被中断。此外,达到4-6亿文件规模,100PB数据量后,再进行扩展则会出现问题。 因此,社区提出了 HDFS Federation 方案。将 HDFS 集群进行扩展,并将业务进行拆分,大业务可以独立使用一组 NameNode,可突破单组 NameNode JVM 的限制,实现了HDFS 元数据和容量的横向扩展。此外,社区开发了 NS Router 组件,帮助更好地使用 HDFS 元数据。 随着 HDFS 的扩展,其运维成本也成倍增加。业界开始选择利用对象存储的高可用、高吞吐,基于云上对象存储构建数据湖。每个云厂商都会从设计到运维上投入大量人力、物力保证对象存储可靠、稳定、高效。 从存算一体到云原生数据湖 开源大数据平台经历了几次大的演进。 第一代开源大数据平台EMR,为更好地将 Hadoop 搬到云上提供了基础运维。在线下使用物理机,在云上使用 ECS 本地盘机型,即可实现与物理机近似的存储能力和成本。其特点为将线下 IDC 集群搬上云,可以通过云简化集群部署和扩容,但不解决 HDFS 的上线、运维等问题。 第二代开源大数据平台EMR 将 OSS 和 S3 对象存储作为 storage connector 引入集群。当存储集群达到一定规模后,温数据、冷数据可以转存到 OSS 或 S3 对象存储,进一步降低存储成本。 第三代开源大数据平台的特点为本地集群基本不保留任何元数据,而是保留在云上。DLF使用 Table 替代了 Hive Metastore 元数据方案,表的元数据通过云服务托管,利用 OSS 做存储,使集群基本实现无状态。因此,用户只需创建好集群即可使用资源,体验极佳。且可以对接更多存储引擎,互相之间能够实现隔离,比如离线、在线可以利用云上元数据和存储实现集群分离。 数据湖存储演进之路 数据湖存储的演进主要也分为三个阶段: 数据湖1.0:存算分离架构,冷热分层,以Hadoop生态为主。 数据湖2.0:以对象存储为中心,统一存储承载生产业务、大规模、高性能。 数据湖3.0:以对象存储为中心,构建企业数据湖全兼容、多协议、统一元数据。 JindoData 数据湖存储解决方案 经过不断演化,最终实现了 JindoData 数据湖存储解决方案。JindoData 是存储加速项目。JindoFS 存储系统构建在 OSS 之上,提供了文件元数据功能和目录功能,可以和 NameNode 进行比对,解决了对象存储在模拟文件系统时的操作比如 rename 等问题。Jindo FSx 是存储加速系统,负责解决带宽问题。客户端或计算集群侧有存储资源,如果都通过网络,则延时、效率与 HDFS 存在差距,经过不断地放大后,用户会逐渐感受到性能差距。因此需要 Jindo FSx 存储加速系统来解决带宽和延时问题。 基于以上两大核心系统,我们对上层提供了 HDFS API 和 POSIX API ,两个 API 基本可以满足大数据平台上对存储的使用需求,Flink 、Hadoop 、Spark 等大数据相关组件可以直接通过相关 API 方便地接入。比如当前新兴的 AI 训练可以将中间结果、TFRecord等通过 POSIX API 存到对象存储系统里。 JindoSDK 生态工具解决了和生态对接问题,比如与计算对接、本地 POSIX 挂载。JindoDistCP 解决从 OSS 和 HDFS 之间的数据迁移,JindoTable 能够以表粒度做迁移,JindoShell 能够帮助我们更好地使用对象存储。 底层数据源可以对接 HDFS、对象存储、NAS以及阿里云OSS。 JindoSDK:超级数据湖SDK JindoSDK 是对接生态的重要 SDK,上层可以对接各种引擎,下层对接各种存储。通常,很多组件和存储都是基于烟囱式开发,导致 SDK 能力规格存在很大偏差。因此我们重点打造了 Native Core 层,使用 C++ 语言开发,对上层抽象出了 ObjectStore API 、DataStream API 和 FileSystem API。 通过 Cython 对接 Python SDK, 通过 JNI 对接 Hadoop SDK,通过 C SDK 对接 Jindo Fuse,使上层所有计算引擎都可以使用相同的一套原生 SDK。因此,SDK 层面改进后,上层全链路都可以享受 SDK 改进带来的收益,比如文件系统元数据操作优化、IO 路径的读写优化、安全、灵活的 STS 配置策略等。 ObjectStore是对象存储的接口,OSS、S3 都可以归结到 ObjectStore 内部API。上图左下角为 Jindo Native SDK 和 OSS Java SDK 的性能对比,可以看到 Jindo SDK 性能平均提升 2.2 倍。 Hadoop SDK 访问 OSS ,性能也可以得到全面提升。几个 SDK 广泛应用在 EMR 生产集群,其稳定性等性能都已经过阿里云上的产品验证。 JindoFS:构建在OSS上的高性能存储系统 JindoFS 重点解决了超大规模 HDFS 存储集群的挑战,比如单组 NameNode 架构存在容量限制,如果想突破容量限制,必须投入极高的运维成本,需要运维十多个服务包括NameNode、ZKFC 、ZK、JN;同时,元数据运维重启时间可高达几个小时,参数调优、JVM GC、全局锁等问题也存在挑战。除此之外,DataNode 做节点上下线、集群节点替换、HDFS 内部 balancer 等都需要解决。 早期,受限于当时的技术,使用 QJM 架构来解决上述痛点。而随着 Raft 在业界广泛推广和使用,JindoFS 选择基于 Raft 架构建元数据,内部只需三个 NamespaceService 节点,避免了 HDFS 大量服务部署。 运维成本上,实现了分钟级重启。通过C++语言开发,性能非常好。基于 OSS 存储,可以大大简化顶层设计,服务也更高效,且本地 block 可以用作缓存。 半托管的 JindoFS 通过这套元数据可以解决 HDFS 的运维复杂度以及 OSS 接口的损耗,满足用户“对系统稳定可靠、运维简单、节省成本;对象存储数据湖和 HDFS 相比性能只好不差”的需求。 随着 JindoFS 半托管的深入使用,我们发现即使运维简单,但因为需要为用户在半托管上部署一套服务,也会给用户带来一定的运维成本。因此我们实现了基于云原生容器化和存储服务化的JindoFS数据湖3.0架构, 数据层面, OSS 服务可以提供两层 API ,分别是对象 API 和目录 API,通过两套 API 组合使用,可以基本满足所有高性能元数据和存储需求。客户实际部署时,可以将 SDK 以及 JindoFSx加速等组件部署在线下、容器或 ECS 里,使容器上的组件也可以更好地使用云上服务。 JindoFS 使用了对象存储作为底层存储,因此可以实现冷热分层,可以根据对象文件生命周期的不同,选择标准型、低频型、归档型和冷归档型四种模式,最大程度地节省成本。归档类型适合长期存储但可能很长时间不读的数据,低频适合读得比较少的数据。 JindoFSx:高性能/性价比的存储加速系统 JindoFSx 缓存加速系统部署在 worker 上。很多对象存储远端有一定的网络开销,而如果全走网络请求,会导致延时增加。IO 越短,GPU 机器成本也可以发挥到最大。JindoFSx 可以在内部进行分层,能够对本地存储资源进行管理。通过 JindoSDK 对上层对接了各种 ETL、交互式分析、实时计算、机器学习等组件,底层可以对接不同数据源。比如阿里云上可能要访问其他云的对象存储,带宽性能上可能无法满足高性能查询的需求。但部署 JindoFSx 以后,对数据进行缓存、预热即可基本满足存储需求。 JindoFSx 实现了分布式缓存架构,包括 Namespace、Storage,上层有一套 NameSpaceService 服务做文件元数据层面的加速,通过文件系统接口暴露给 JindoSDK,供上层应用使用,以此解决 IO 密集、带宽受限、远端数据访问的问题。 生态工具和场景 上图为数据湖存储对接计算引擎的大图,通过 OSS 可以方便地对接各种服务和存储。 我们在数据流层面做了异步数据预读、复用,使得读取 Parquet/ORC 格式时可以实现高效寻址,利用缓存使数据读取更高效。 对象存储上的 rename 操作比较重,因此我们设计了JindoCommitter,基于对象存储系统的 Multiple Upload,结合 OSS 文件系统层面的定制支持,可以实现在保证数据一致性前提下无需 rename 操作的 Job Committer。在 OSS 上运行作业时,只要加上Jindocommitter ,即可同时保证 Hadoop V1 版本的事务性和 Hadoop V2 版本的高性能。 目录 rename 的优化提供了针对 EMR 优化前缀重命名接口,目录 rename 降低到毫秒级并保证原子性。另外,我们支持了 fast copy,对比大部分对象存储对于 object 的copy 操作需要将数据进行真实拷贝, fast copy只需在内部做一次索引转换,避免了数据真实拷贝。 很多数据湖引擎是基于文件系统原子 rename 特性设计的,即对象如果已经存在,则不能被二次覆盖。对于这个重要特性,我们在 OSS 上做了重点支持。首先,OSS 是一个强一致性存储,比如向 bucket 里写入 object,如果没有强一致的保证,在 list 时可能无法获取到最新的对象。其次,对象存储的 rename是 Key 覆盖, Key 级别对象不会检查文件是否存在。而数据湖场景下,原子 rename 特性,我们实现了两种方案:在 SDK 层面基于 OTS 构建原子 Rename 的能力。同时进行深度优化后,已经可以实现 OSS 原生原子性 rename 支持,不依赖任何外部服务,可以在文件做 copy 时进行强一致的检测。 对象存储是不支持 Flush 的,而像 Flink、Flume 这类引擎对 Flush 的依赖是比较重的,我们在对象存储上也做了深度优化,虽然不能保证完整的 Flush 语义,即数据 Flush 以后立刻可见,但是可以保证 Flush 以后数据不丢,对于 Flume 层面来说已经完全满足实际使用需求。 Flink 里使用了 MPU 接口,实现了 recoverable writer 的可恢复写入。 数据湖生态的 JindoTable 是专门为结构化数据设计一套工具集,可以帮助降低存储成本和维护成本。 JindoTable 可以以表维度做数据冷热转换。比如表存在 OSS 或 HDFS 上,可以通过JindoTable 操作 Hive MetaStore 等的数据,可以按照 DB 级别、表级别、前缀级别做生命周期转换,可以很方便地进行冷热数据统计,并按特点进行数据分层操作。 Hadoop 原生 DistCP 在对象存储和 HDFS 同步数据会存在一些问题,比如拷贝策略、存储类型、数据校验等支持。JindoDistCP 重点解决这类问题:JindoDistCP 上实现了异构 checksum 比对,HDFS 和对象存储的 checksum 算法是不同的,传统的做法无法将HDFS 和对象直接做 checksum 比对,在 JindoDistCP 里进行了透明的 checksum 转换,保证了写入和传输过程中的数据准确性。 此外,我们对 JindoDistCP 的内核也进行了重新优化,实现了动态拷贝,类似抢占式拷贝的方式,大文件和小文件可以快速同时并行,带宽利用率大幅提高。 问答 Q:JindoFS 和 HDFS 性能数据对比如何? A:后续会逐步发布测试数据,JindoFS 本身设计上有一定优势。在 HDFS 里做 rename、delete 等操作,特别是对大目录进行操作时,会存在大量的加锁和检查操作。随着文件数量变大,时间也会递增;这些操作在 JindoFS 上的时间是稳定的。 Q:JindoFS 只有三个节点,最大能够支持多大文件数量? A:早期版本是一般是三节点组 raft,这种模式可以稳定支持十亿级别,相比于 HDFS 有两倍的提升。现在的 3.0 云原生架构下,用户通过 endpoint 访问,元数据服务可以在内部进行横向扩展。 Q:JindoFS 和 Alluxio 的对比? A:JindoFS 是元数据的管理和优化,Alluxio 是一套开源分布式缓存加速服务,其功能定位与 JindoFSx 比较接近。Alluxio 主打开源,Jindo 在对象存储上做了较多优化,加上 Native 底层,理论上性能会有一定优势。 Q:HDFS 上 k8s 场景是否有具体的实践? A:HDFS 是一个存储引擎,每个存储节点是有状态的。HDFS 部署在 k8s 节点也需要重度的运维,比如释放需要首先进行 HDFS Decommission 操作,要日常对节点进行 balance 等,k8s 部署 HDFS 无明显优势。 更多信息: 产品官网 [1] 数据湖构建Data Lake Formation:https://www.aliyun.com/product/bigdata/dlf [2] 开源大数据平台EMR: https://www.aliyun.com/product/emapreduce [3] 大数据知识图谱: https://developer.aliyun.com/learning/topic/bigdata 数据湖系列 [1] 数据湖揭秘—Delta Lake: https://developer.aliyun.com/article/909818 [2] 数据湖构建—如何构建湖上统一的数据权限: https://developer.aliyun.com/article/918403 [3] 关于 Data Lake 的概念、架构与应用场景介绍:https://developer.aliyun.com/article/944650 [4] 数据湖架构及概念简介: https://developer.aliyun.com/article/1004847 [5] 数据湖统一元数据和权限 https://developer.aliyun.com/article/1008235 [6] 数据湖管理及优化 https://developer.aliyun.com/article/1023298 更多 数据湖 相关技术问题,可扫码加入钉钉交流群~

优秀的个人博客,低调大师

施耐德电气:打造新一代数据中心基础设施

随着全球信息技术的飞跃发展,尤其是我国“互联网+”的全面推进,信息化已经成为经济的重头戏。而数据中心作为信息的重要载体和互联网发展的基石,其规模正随着社会经济的规模而日渐壮大。据不完全统计,我国的数据中心总量已经超过60万个,同时还有大量数据中心处于规划和建设中。与此同时,如何实现数据中心建设的高效集约?如何适应客户动态发展的应用需求?如何摆脱高成本、高能耗以及运维日趋复杂化的困境?已经成为数据中心产业当前普遍面临的现实课题。 施耐德电气信息技术(中国)有限公司(以下简称施耐德电气)数据中心技术专家石葆春认为,想要解决上述问题应该从优化数据中心基础设施方面着手。所谓数据中心基础设施,就是指给IT服务的辅助子系统,包括供配电系统、制冷系统、机柜系统以及监控及运维管理系统。据石葆春介绍,施耐德电气从2002年开始就致力于为用户提供数据中心基础设施的整体解决方案。经过多年发展,施耐德电气在数据中心基础设施各子系统研发方面持续创新,凭借高度集成化的整体解决方案和全生命周期的服务及运维管理方案领跑整个数据中心基础设施的发展。 目前,供配电系统正面临来自于HVDC高压直流和天蝎机柜内带锂电池的电源模块的分散供电模式的挑战。石葆春表示,为了提高可用性和运行效率,降低UPS供配电系统的总拥有成本TCO,施耐德电气采用了革命性的超级旁路优先模式、四电平逆变器技术以及模块化N+1冗余技术,并将在2016年底推出旗舰级的UPS系列产品VX,“VX系列产品将会对不同类型负载、运行环境、市电电网和发电机表现出强大的兼容性与适应性,适用于各个行业的中小型数据中心和关键电源供电等场合。” 随着云计算、物联网等技术的不断演进,数据中心得到了飞速的发展,大量的配电电气设备随之出现,数据中心需要高效运营,最理想的方式是使设备能够互联互通,智慧运行.据施耐德电气高级产品经理伊政潮介绍,在供配电领域,施耐德电气重新定义了新的配电系统架构,即PowerStruxure,通过数字化系统,本地和云端的结合, 打造基于物联网的中低压配电系统. PowerStruxure可以利用区域边缘控制, 大数据分析将底层配电设备的信息进行整理和分析,将系统潜在的电气故障风险控制在萌芽状态,且提供专业的持续服务;如此科学智能的运行使数据中心运营更加高效,可靠, 持续。”伊政潮表示,基于PowerStruxure架构,施耐德电气推出的Smart Panels(低压智能配电柜方案),可以轻松实现对电气设备资产管理,电能质量管理以及能效管理, 在数据中心配电系统的运行可靠性, 运维的高效性上均有显著提升.同时, 随着新一代的全智能性框架断路器MTZ的即将上市, 将使Smart Panels的方案更加灵活高效, 更好的迎合服务于新一代的数据中心配电需求。 除了供配电系统外,许多数据中心管理者在制冷方面正面临着过量供应和温度控制问题的挑战,这可能导致任务遭受重挫以及过高的能耗成本。对此,石葆春表示,大型数据中心采用的创新的制冷系统会从目前的定制化向标准化转变,应用到中小规模的数据中心,例如施耐德电气的高水温级空调,一体化的自然冷却冷冻水机组、两分钟快速启动冷冻水机组、水力模块等,水力模块是将以前分离的水泵、管道、阀门监测这些传感器系统,集成到一个模块里面,在工厂统一制造生产,“我们即将在中国推出的第二代的间接新风水喷淋制冷模块,不仅可适用于像BAT这样的巨头公司,也适用于普通用户,因为它是一个标准化的产品。” 随着信息技术的发展,反应灵敏的数据中心逐渐成为用户的首选。而微模块数据中心由于具备绿色节能、快速安装等优点,已逐渐成为未来几年内大规模替代传统数据中心的新秀。据石葆春介绍,微模块具有很多的优势,降低了对于机房物理空间的要求,微模块的尺寸非常灵活,可以根据客户机房的实际情况进行调整和改变,由于采用的是模块化结构,因此安装部署的速度较快,满足了用户对于快速部署的要求。 在数据中心监控及运维管理系统方面,石葆春表示,施耐德电气进行了跨系统、跨空间、跨供应商的整合创新,“我们将数据中心、供配电系统,甚至整个楼宇通过跨系统整合到一起来实现统一管理,将多个地方的数据中心跨空间整合在一套系统上实现统一监控,再通过跨供应商整合,实现所有供应商不同产品的统一监控、管理和运营。”这些整合创新轻松实现了数据采集、告警、自我优化、能效管理、容量管理、变更管理、报表管理、制冷优化、IT优化等功能,为智能化数据中心奠定了基础。 谈及未来数据中心基础设施的趋势,石葆春认为,随着云计算、大数据、物联网等技术的发展,传统的数据中心很难适应快速部署、灵活适配的需求,只有以模块化、标准化、集成化、预制化、智能化等技术变革为代表的新型数据中心基础设施才能更好的服务于指数级增长的信息和日趋多元化的应用所来带的需求。“我们将在数据中心领域不断探索创新,从技术支持、产品供应到整体解决方案再到全生命周期服务,与业内公司联合形成产业生态链,从而开创灵活、高效、绿色、节能的数据中心新未来。” 本文转自d1net(转载)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册