首页 文章 精选 留言 我的

精选列表

搜索[懒加载],共10000篇文章
优秀的个人博客,低调大师

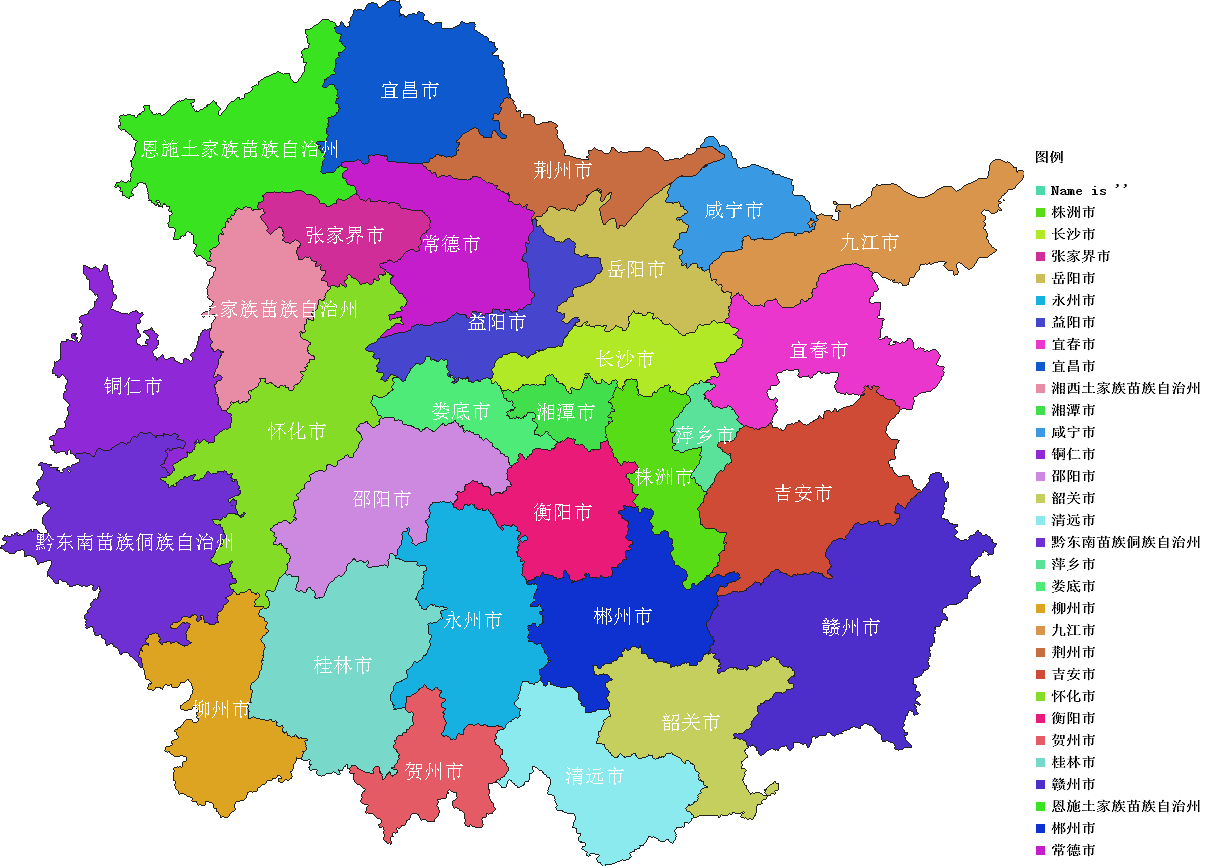
使用Geotools实现将Shp矢量文件加载SLD并合并图例生成-以湖南省周边城市为例

在当今数字化时代,地理信息系统(GIS)技术已成为城市管理、资源规划、环境监测等众多领域不可或缺的工具。GIS 制图作为该技术体系中的核心环节之一,旨在将复杂的地理空间数据以直观、清晰且易于理解的地图形式呈现出来,为决策者提供有力的可视化支持。在 GIS 制图过程中,矢量数据的可视化呈现占据着举足轻重的地位。Shapefile(Shp)格式作为矢量数据的常用存储形式,以其良好的兼容性和通用性,在地理信息数据的交换与共享中得到了广泛应用。然而,仅仅拥有矢量数据还远远不够,如何通过合适的样式定义(SLD)来准确、有效地表达数据所蕴含的地理信息,是实现高质量 GIS 制图的关键所在。

优秀的个人博客,低调大师

时间序列数据库——索引用ES、聚合分析时加载数据用什么?docvalues的列存储貌似更优优势一些。那分布式计算呢?ES做

分布式计算 分布式聚合如何做得快 Elasticsearch/Lucene从最底层就支持数据分片,查询的时候可以自动把不同分片的查询结果合并起来。Elasticsearch的document都有一个uid,默认策略是按照uid 的 hash把文档进行分片。 一个Elasticsearch Index相当于一个MySQL里的表,不同Index的数据是物理上隔离开来的。Elasticsearch的Index会分成多个Shard存储,一 部分Shard是Replica备份。一个Shard是一份本地的存储(一个本地磁盘上的目录),也就是一个Lucene的Index。不同的Shard 可能会被分配到不同的主机节点上。一个Lucene Index会存储很多的doc,为了好管理,Lucene把Index再拆成了Segment存储(子目录)。Segment内的doc数量上限是1的 31次方,这样doc id就只需要一个int就可以存储。Segment对应了一些列文件存储索引(倒排表等)和主存储(DocValues等),这些文件内部又分为小的 Block进行压缩。 时间序列数据一般按照日期分成多个Elasticsearch Index来存储,比如logstash-2014.08.02。查询的时候可以指定多个Elasticsearch Index作为查找的范围,也可以用logstash-*做模糊匹配。 美妙之处在于,虽然数据被拆得七零八落的,在查询聚合的时候甚至需要分为两个阶段完成。但是对于最终用户来说,使用起来就好像是一个数据库表一样。所有的合并查询的细节都是隐藏起来的。 对于聚合查询,其处理是分两阶段完成的: Shard本地的Lucene Index并行计算出局部的聚合结果; 收到所有的Shard的局部聚合结果,聚合出最终的聚合结果。 这种两阶段聚合的架构使得每个shard不用把原数据返回,而只用返回数据量小得多的聚合结果。相比Opentsdb这样的数据库设计更合理。Opentsdb其聚合只在最终节点处完成,所有的分片数据要汇聚到一个地方进行计算,这样带来大量的网络带宽消耗。所以Influxdb等更新的时间序列数据库选择把分布式计算模块和存储引擎进行同机部署,以减少网络带宽的影响。 除此之外Elasticsearch还有另外一个减少聚合过程中网络传输量的优化,那就是Hyperloglog算 法。在计算unique visitor(uv)这样的场景下,经常需要按用户id去重之后统计人数。最简单的实现是用一个hashset保存这些用户id。但是用set保存所有 的用户id做去重需要消耗大量的内存,同时分布式聚合的时候也要消耗大量的网络带宽。Hyperloglog算法以一定的误差做为代价,可以用很小的数据 量保存这个set,从而减少网络传输消耗。 为什么时间序列需要更复杂的聚合? 关系型数据库支持一些很复杂的聚合查询逻辑,比如: Join两张表; Group by之后用Having再对聚合结果进行过滤; 用子查询对聚合结果进行二次聚合。 在使用时间序列数据库的时候,我们经常会怀念这些SQL的查询能力。在时间序列里有一个特别常见的需求就是降频和降维。举例如下: 12:05:05 湖南 81 12:05:07 江西 30 12:05:11 湖南 80 12:05:12 江西 32 12:05:16 湖南 80 12:05:16 江西 30 按1分钟频率进行max的降频操作得出的结果是: 12:05 湖南 81 12:05 江西 32 这种按max进行降频的最常见的场景是采样点的归一化。不同的采集器采样的时间点是不同的,为了避免漏点也会加大采样率。这样就可能导致一分钟内采样多次,而且采样点的时间都不对齐。在查询的时候按max进行降频可以得出一个统一时间点的数据。 按sum进行降维的结果是: 12:05 113 经常我们需要舍弃掉某些维度进行一个加和的统计。这个统计需要在时间点对齐之后再进行计算。这就导致一个查询需要做两次,上面的例子里: 先按1分钟,用max做降频; 再去掉省份维度,用sum做降维。 如果仅仅能做一次聚合,要么用sum做聚合,要么用max做聚合。无法满足业务逻辑的需求。为了避免在一个查询里做两次聚合,大部分的时间序列数据库都要求数据在入库的时候已经是整点整分的。这就要求数据不能直接从采集点直接入库,而要经过一个实时计算管道进行处理。如果能够在查询的时候同时完成降频和降维,那就可以带来一些使用上的便利。 这个功能看似简单,其实非常难以实现。很多所谓的支持大数据的数据库都只支持简单的一次聚合操作。Elasticsearch 将要发布的 2.0 版本的最重量级的新特性是Pipeline Aggregation,它支持数据在聚合之后再做聚合。类似SQL的子查询和Having等功能都将被支持。 总结 时间序列随着Internet of Things等潮流的兴起正变得越来越常见。希望本文可以帮助你了解到那些号称自己非常海量,查询非常快的时间序列数据库背后的秘密。没有完美的数据 库,Elasticsearch也不例外。如果你的用例根本不包括聚合的需求,也许Opentsdb甚至MySQL就是你最好的选择。但是如果你需要聚合海量的时间序列数据,一定要尝试一下Elasticsearch! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6432769.html,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册