首页 文章 精选 留言 我的

精选列表

搜索[并发编程],共10000篇文章
优秀的个人博客,低调大师

gqlengine 开源并发布第一版

gqlengine 是凯斐德科技开源的 一个graphql golang 解决方案(服务端框架),基于graphql-go,但无需繁杂的配置语句,也不像gopher-graphql/graphql-go那样编写 schema 再编写对应 resolver(两次编写业务代码),而是通过 go-reflection,解析给入的 resolver function,自动分析并创建的 graphql 类型。如以下代码: package main import ( "net/http" "github.com/gqlengine/gqlengine" ) type MyInfo struct { gqlengine.IsGraphQLObject `gqlDesc:"my info"` SaySomething string } func MySimpleQuery() error { panic("not implemented") } func main() { engine := gqlengine.NewEngine(gqlengine.Options{ Tracing: true, // enable tracing extensions }) // register your queries, mutations and subscriptions engine.NewQuery(MySimpleQuery) // do NOT forget init the engine if err := engine.Init(); err != nil { panic(err) } // serve for HTTP http.HandleFunc("/api/graphql", engine.ServeHTTP) if err := http.ListenAndServe(":8000", nil); err != nil { panic(err) } } 实际仅需要 engine.NewQuery(MySimpleQuery) 即可,gqlengine 会自动查找该 func 的入参和出参,推导出对应的 graphql 类型,比如 MySimpleQuery 返回了 MyInfo 类型,MyInfo 结构里标记该类型是 GraphQL Object,gqlengine 在 Init() 中就自动创建了该 Object。 GQLEngine 目前已经支持各类 GraphQL 类型的 reflection,同时还具备以下强大特性: Websocket Subscription 支持(继承了 Websocket,使用者无需配置) Multipart Upload(支持通过 graphql 上传任意多个图片、文件等) Tracing extensions(支持对 graphql 调用层次/链路跟踪,结合 playground 支持图形形式观察)

优秀的个人博客,低调大师

死磕 java并发包之LongAdder源码分析

问题 (1)java8中为什么要新增LongAdder? (2)LongAdder的实现方式? (3)LongAdder与AtomicLong的对比? 简介 LongAdder是java8中新增的原子类,在多线程环境中,它比AtomicLong性能要高出不少,特别是写多的场景。 它是怎么实现的呢?让我们一起来学习吧。 原理 LongAdder的原理是,在最初无竞争时,只更新base的值,当有多线程竞争时通过分段的思想,让不同的线程更新不同的段,最后把这些段相加就得到了完整的LongAdder存储的值。 源码分析 LongAdder继承自Striped64抽象类,Striped64中定义了Cell内部类和各重要属性。 主要内部类 // Striped64中的内部类,使用@sun.misc.Contended注解,说明里面的值消除伪共享 @sun.misc.Contended static final class Cell { // 存储元素的值,使用volatile修饰保证可见性 volatile long value; Cell(long x) { value = x; } // CAS更新value的值 final boolean cas(long cmp, long val) { return UNSAFE.compareAndSwapLong(this, valueOffset, cmp, val); } // Unsafe实例 private static final sun.misc.Unsafe UNSAFE; // value字段的偏移量 private static final long valueOffset; static { try { UNSAFE = sun.misc.Unsafe.getUnsafe(); Class<?> ak = Cell.class; valueOffset = UNSAFE.objectFieldOffset (ak.getDeclaredField("value")); } catch (Exception e) { throw new Error(e); } } } Cell类使用@sun.misc.Contended注解,说明是要避免伪共享的。 使用Unsafe的CAS更新value的值,其中value的值使用volatile修饰,保证可见性。 关于Unsafe的介绍请查看【死磕 java魔法类之Unsafe解析】。 关于伪共享的介绍请查看【杂谈 什么是伪共享(false sharing)?】。 主要属性 // 这三个属性都在Striped64中 // cells数组,存储各个段的值 transient volatile Cell[] cells; // 最初无竞争时使用的,也算一个特殊的段 transient volatile long base; // 标记当前是否有线程在创建或扩容cells,或者在创建Cell // 通过CAS更新该值,相当于是一个锁 transient volatile int cellsBusy; 最初无竞争或有其它线程在创建cells数组时使用base更新值,有过竞争时使用cells更新值。 最初无竞争是指一开始没有线程之间的竞争,但也有可能是多线程在操作,只是这些线程没有同时去更新base的值。 有过竞争是指只要出现过竞争不管后面有没有竞争都使用cells更新值,规则是不同的线程hash到不同的cell上去更新,减少竞争。 add(x)方法 add(x)方法是LongAdder的主要方法,使用它可以使LongAdder中存储的值增加x,x可为正可为负。 public void add(long x) { // as是Striped64中的cells属性 // b是Striped64中的base属性 // v是当前线程hash到的Cell中存储的值 // m是cells的长度减1,hash时作为掩码使用 // a是当前线程hash到的Cell Cell[] as; long b, v; int m; Cell a; // 条件1:cells不为空,说明出现过竞争,cells已经创建 // 条件2:cas操作base失败,说明其它线程先一步修改了base,正在出现竞争 if ((as = cells) != null || !casBase(b = base, b + x)) { // true表示当前竞争还不激烈 // false表示竞争激烈,多个线程hash到同一个Cell,可能要扩容 boolean uncontended = true; // 条件1:cells为空,说明正在出现竞争,上面是从条件2过来的 // 条件2:应该不会出现 // 条件3:当前线程所在的Cell为空,说明当前线程还没有更新过Cell,应初始化一个Cell // 条件4:更新当前线程所在的Cell失败,说明现在竞争很激烈,多个线程hash到了同一个Cell,应扩容 if (as == null || (m = as.length - 1) < 0 || // getProbe()方法返回的是线程中的threadLocalRandomProbe字段 // 它是通过随机数生成的一个值,对于一个确定的线程这个值是固定的 // 除非刻意修改它 (a = as[getProbe() & m]) == null || !(uncontended = a.cas(v = a.value, v + x))) // 调用Striped64中的方法处理 longAccumulate(x, null, uncontended); } } (1)最初无竞争时只更新base; (2)直到更新base失败时,创建cells数组; (3)当多个线程竞争同一个Cell比较激烈时,可能要扩容; longAccumulate()方法 final void longAccumulate(long x, LongBinaryOperator fn, boolean wasUncontended) { // 存储线程的probe值 int h; // 如果getProbe()方法返回0,说明随机数未初始化 if ((h = getProbe()) == 0) { // 强制初始化 ThreadLocalRandom.current(); // force initialization // 重新获取probe值 h = getProbe(); // 都未初始化,肯定还不存在竞争激烈 wasUncontended = true; } // 是否发生碰撞 boolean collide = false; // True if last slot nonempty for (;;) { Cell[] as; Cell a; int n; long v; // cells已经初始化过 if ((as = cells) != null && (n = as.length) > 0) { // 当前线程所在的Cell未初始化 if ((a = as[(n - 1) & h]) == null) { // 当前无其它线程在创建或扩容cells,也没有线程在创建Cell if (cellsBusy == 0) { // Try to attach new Cell // 新建一个Cell,值为当前需要增加的值 Cell r = new Cell(x); // Optimistically create // 再次检测cellsBusy,并尝试更新它为1 // 相当于当前线程加锁 if (cellsBusy == 0 && casCellsBusy()) { // 是否创建成功 boolean created = false; try { // Recheck under lock Cell[] rs; int m, j; // 重新获取cells,并找到当前线程hash到cells数组中的位置 // 这里一定要重新获取cells,因为as并不在锁定范围内 // 有可能已经扩容了,这里要重新获取 if ((rs = cells) != null && (m = rs.length) > 0 && rs[j = (m - 1) & h] == null) { // 把上面新建的Cell放在cells的j位置处 rs[j] = r; // 创建成功 created = true; } } finally { // 相当于释放锁 cellsBusy = 0; } // 创建成功了就返回 // 值已经放在新建的Cell里面了 if (created) break; continue; // Slot is now non-empty } } // 标记当前未出现冲突 collide = false; } // 当前线程所在的Cell不为空,且更新失败了 // 这里简单地设为true,相当于简单地自旋一次 // 通过下面的语句修改线程的probe再重新尝试 else if (!wasUncontended) // CAS already known to fail wasUncontended = true; // Continue after rehash // 再次尝试CAS更新当前线程所在Cell的值,如果成功了就返回 else if (a.cas(v = a.value, ((fn == null) ? v + x : fn.applyAsLong(v, x)))) break; // 如果cells数组的长度达到了CPU核心数,或者cells扩容了 // 设置collide为false并通过下面的语句修改线程的probe再重新尝试 else if (n >= NCPU || cells != as) collide = false; // At max size or stale // 上上个elseif都更新失败了,且上个条件不成立,说明出现冲突了 else if (!collide) collide = true; // 明确出现冲突了,尝试占有锁,并扩容 else if (cellsBusy == 0 && casCellsBusy()) { try { // 检查是否有其它线程已经扩容过了 if (cells == as) { // Expand table unless stale // 新数组为原数组的两倍 Cell[] rs = new Cell[n << 1]; // 把旧数组元素拷贝到新数组中 for (int i = 0; i < n; ++i) rs[i] = as[i]; // 重新赋值cells为新数组 cells = rs; } } finally { // 释放锁 cellsBusy = 0; } // 已解决冲突 collide = false; // 使用扩容后的新数组重新尝试 continue; // Retry with expanded table } // 更新失败或者达到了CPU核心数,重新生成probe,并重试 h = advanceProbe(h); } // 未初始化过cells数组,尝试占有锁并初始化cells数组 else if (cellsBusy == 0 && cells == as && casCellsBusy()) { // 是否初始化成功 boolean init = false; try { // Initialize table // 检测是否有其它线程初始化过 if (cells == as) { // 新建一个大小为2的Cell数组 Cell[] rs = new Cell[2]; // 找到当前线程hash到数组中的位置并创建其对应的Cell rs[h & 1] = new Cell(x); // 赋值给cells数组 cells = rs; // 初始化成功 init = true; } } finally { // 释放锁 cellsBusy = 0; } // 初始化成功直接返回 // 因为增加的值已经同时创建到Cell中了 if (init) break; } // 如果有其它线程在初始化cells数组中,就尝试更新base // 如果成功了就返回 else if (casBase(v = base, ((fn == null) ? v + x : fn.applyAsLong(v, x)))) break; // Fall back on using base } } (1)如果cells数组未初始化,当前线程会尝试占有cellsBusy锁并创建cells数组; (2)如果当前线程尝试创建cells数组时,发现有其它线程已经在创建了,就尝试更新base,如果成功就返回; (3)通过线程的probe值找到当前线程应该更新cells数组中的哪个Cell; (4)如果当前线程所在的Cell未初始化,就占有占有cellsBusy锁并在相应的位置创建一个Cell; (5)尝试CAS更新当前线程所在的Cell,如果成功就返回,如果失败说明出现冲突; (5)当前线程更新Cell失败后并不是立即扩容,而是尝试更新probe值后再重试一次; (6)如果在重试的时候还是更新失败,就扩容; (7)扩容时当前线程占有cellsBusy锁,并把数组容量扩大到两倍,再迁移原cells数组中元素到新数组中; (8)cellsBusy在创建cells数组、创建Cell、扩容cells数组三个地方用到; sum()方法 sum()方法是获取LongAdder中真正存储的值的大小,通过把base和所有段相加得到。 public long sum() { Cell[] as = cells; Cell a; // sum初始等于base long sum = base; // 如果cells不为空 if (as != null) { // 遍历所有的Cell for (int i = 0; i < as.length; ++i) { // 如果所在的Cell不为空,就把它的value累加到sum中 if ((a = as[i]) != null) sum += a.value; } } // 返回sum return sum; } 可以看到sum()方法是把base和所有段的值相加得到,那么,这里有一个问题,如果前面已经累加到sum上的Cell的value有修改,不是就没法计算到了么? 答案确实如此,所以LongAdder可以说不是强一致性的,它是最终一致性的。 LongAdder VS AtomicLong 直接上代码: public class LongAdderVSAtomicLongTest { public static void main(String[] args){ testAtomicLongVSLongAdder(1, 10000000); testAtomicLongVSLongAdder(10, 10000000); testAtomicLongVSLongAdder(20, 10000000); testAtomicLongVSLongAdder(40, 10000000); testAtomicLongVSLongAdder(80, 10000000); } static void testAtomicLongVSLongAdder(final int threadCount, final int times){ try { System.out.println("threadCount:" + threadCount + ", times:" + times); long start = System.currentTimeMillis(); testLongAdder(threadCount, times); System.out.println("LongAdder elapse:" + (System.currentTimeMillis() - start) + "ms"); long start2 = System.currentTimeMillis(); testAtomicLong(threadCount, times); System.out.println("AtomicLong elapse:" + (System.currentTimeMillis() - start2) + "ms"); } catch (InterruptedException e) { e.printStackTrace(); } } static void testAtomicLong(final int threadCount, final int times) throws InterruptedException { AtomicLong atomicLong = new AtomicLong(); List<Thread> list = new ArrayList<>(); for (int i=0;i<threadCount;i++){ list.add(new Thread(() -> { for (int j = 0; j<times; j++){ atomicLong.incrementAndGet(); } })); } for (Thread thread : list){ thread.start(); } for (Thread thread : list){ thread.join(); } } static void testLongAdder(final int threadCount, final int times) throws InterruptedException { LongAdder longAdder = new LongAdder(); List<Thread> list = new ArrayList<>(); for (int i=0;i<threadCount;i++){ list.add(new Thread(() -> { for (int j = 0; j<times; j++){ longAdder.add(1); } })); } for (Thread thread : list){ thread.start(); } for (Thread thread : list){ thread.join(); } } } 运行结果如下: threadCount:1, times:10000000 LongAdder elapse:158ms AtomicLong elapse:64ms threadCount:10, times:10000000 LongAdder elapse:206ms AtomicLong elapse:2449ms threadCount:20, times:10000000 LongAdder elapse:429ms AtomicLong elapse:5142ms threadCount:40, times:10000000 LongAdder elapse:840ms AtomicLong elapse:10506ms threadCount:80, times:10000000 LongAdder elapse:1369ms AtomicLong elapse:20482ms 可以看到当只有一个线程的时候,AtomicLong反而性能更高,随着线程越来越多,AtomicLong的性能急剧下降,而LongAdder的性能影响很小。 总结 (1)LongAdder通过base和cells数组来存储值; (2)不同的线程会hash到不同的cell上去更新,减少了竞争; (3)LongAdder的性能非常高,最终会达到一种无竞争的状态; 彩蛋 在longAccumulate()方法中有个条件是n >= NCPU就不会走到扩容逻辑了,而n是2的倍数,那是不是代表cells数组最大只能达到大于等于NCPU的最小2次方? 答案是明确的。因为同一个CPU核心同时只会运行一个线程,而更新失败了说明有两个不同的核心更新了同一个Cell,这时会重新设置更新失败的那个线程的probe值,这样下一次它所在的Cell很大概率会发生改变,如果运行的时间足够长,最终会出现同一个核心的所有线程都会hash到同一个Cell(大概率,但不一定全在一个Cell上)上去更新,所以,这里cells数组中长度并不需要太长,达到CPU核心数足够了。 比如,笔者的电脑是8核的,所以这里cells的数组最大只会到8,达到8就不会扩容了。 欢迎关注我的公众号“彤哥读源码”,查看更多源码系列文章, 与彤哥一起畅游源码的海洋。

优秀的个人博客,低调大师

java并发(二):深入分析volatile实现原理

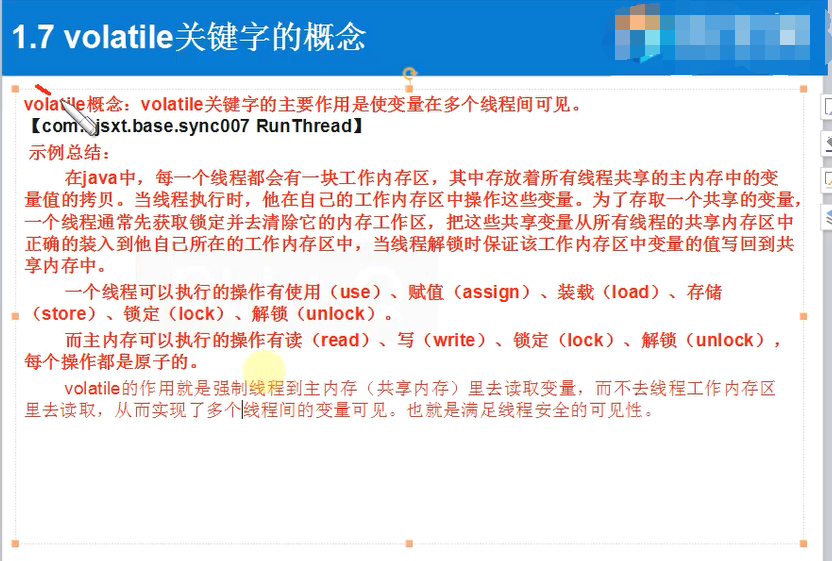
volatile的原理实现可以看这篇文章,真的是从硬件层面上说明了volatile怎样保证可见性 下面这个实例,如果没有设置成volatile关键字,那么线程读的 isRunning永远都是自己私有内存中的,线程将会一直在while循环中 public class RunThread extends Thread{ private volatile boolean isRunning = true; private void setRunning(boolean isRunning){ this.isRunning = isRunning; } public void run(){ System.out.println("进入run方法.."); int i = 0; while(isRunning == true){ //.. } System.out.println("线程停止"); } public static void main(String[] args) throws InterruptedException { RunThread rt = new RunThread(); rt.start(); Thread.sleep(1000); rt.setRunning(false); System.out.println("isRunning的值已经被设置了false"); } } 这是展示volatile虽然有可见性,但是没有原子性: /** * volatile关键字不具备synchronized关键字的原子性(同步) * @author alienware * */ public class VolatileNoAtomic extends Thread{ private static volatile int count = 0; //这个被注释的代码可以保证结果正确 //private static AtomicInteger count = new AtomicInteger(0); private static void addCount(){ for (int i = 0; i < 1000; i++) { count++ ; //这个被注释的代码可以保证结果正确 //count.incrementAndGet(); } System.out.println(count); } public void run(){ addCount(); } public static void main(String[] args) { VolatileNoAtomic[] arr = new VolatileNoAtomic[100]; for (int i = 0; i < 10; i++) { arr[i] = new VolatileNoAtomic(); } for (int i = 0; i < 10; i++) { arr[i].start(); } } } 这是使用atomic,保证原子性的代码: public class AtomicUse { private static AtomicInteger count = new AtomicInteger(0); //多个addAndGet在一个方法内是非原子性的,需要加synchronized进行修饰,保证4个addAndGet整体原子性 /**synchronized*/ public synchronized int multiAdd(){ try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } count.addAndGet(1); count.addAndGet(2); count.addAndGet(3); count.addAndGet(4); //+10 return count.get(); } public static void main(String[] args) { final AtomicUse au = new AtomicUse(); List<Thread> ts = new ArrayList<Thread>(); for (int i = 0; i < 100; i++) { ts.add(new Thread(new Runnable() { @Override public void run() { System.out.println(au.multiAdd()); } })); } for(Thread t : ts){ t.start(); } } } 线程通信 ListAdd2.java,可以看出本来list已经到5了,那么t2应该出while循环抛异常,但是因为它执行了wait方法,释放锁了。而t1得到锁一直执行,虽然t1执行了notify方法,但是只是发出通知而已,只有它的方法执行完才释放锁让t2执行。 package com.bjsxt.base.conn008; import java.util.ArrayList; import java.util.List; import java.util.Queue; import java.util.concurrent.CountDownLatch; import java.util.concurrent.LinkedBlockingDeque; import java.util.concurrent.LinkedBlockingQueue; /** * wait notfiy 方法,wait释放锁,notfiy不释放锁 * @author alienware * */ public class ListAdd2 { private volatile static List list = new ArrayList(); public void add(){ list.add("bjsxt"); } public int size(){ return list.size(); } public static void main(String[] args) { final ListAdd2 list2 = new ListAdd2(); // 1 实例化出来一个 lock // 当使用wait 和 notify 的时候 , 一定要配合着synchronized关键字去使用 final Object lock = new Object(); // final CountDownLatch countDownLatch = new CountDownLatch(1); Thread t1 = new Thread(new Runnable() { @Override public void run() { try { synchronized (lock) { for(int i = 0; i <10; i++){ list2.add(); System.out.println("当前线程:" + Thread.currentThread().getName() + "添加了一个元素.."); Thread.sleep(500); if(list2.size() == 5){ System.out.println("已经发出通知.."); // countDownLatch.countDown(); lock.notify(); } } } } catch (InterruptedException e) { e.printStackTrace(); } } }, "t1"); Thread t2 = new Thread(new Runnable() { @Override public void run() { synchronized (lock) { if(list2.size() != 5){ try { System.out.println("t2进入..."); lock.wait(); // countDownLatch.await(); } catch (InterruptedException e) { e.printStackTrace(); } } System.out.println("当前线程:" + Thread.currentThread().getName() + "收到通知线程停止.."); throw new RuntimeException(); } } }, "t2"); t2.start(); t1.start(); } } package com.xushu.multi; import java.util.LinkedList; import java.util.concurrent.TimeUnit; import java.util.concurrent.atomic.AtomicInteger; public class MyQueue { private LinkedList<Object> list = new LinkedList<Object>(); private AtomicInteger count = new AtomicInteger(0); private final int minSize = 0; private final int maxSize; public MyQueue(int size) { this.maxSize = size; } private final Object lock = new Object(); public void put(Object obj) { synchronized (lock) { if (count.get() == this.maxSize) { try { lock.wait(); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } list.add(obj); count.incrementAndGet(); lock.notify(); System.out.println("新加入的元素为:" + obj); } } public Object take() { Object ret = null; synchronized (lock) { if (count.get() == minSize) { try { lock.wait(); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } ret = list.removeFirst(); count.decrementAndGet(); lock.notify(); } return ret; } public int getSize() { return this.count.get(); } public static void main(String[] args) { final MyQueue mq = new MyQueue(5); mq.put("a"); mq.put("b"); mq.put("c"); mq.put("d"); System.out.println("当前容器的长度:" + mq.getSize()); Thread t1 = new Thread(new Runnable() { @Override public void run() { mq.put("f"); mq.put("g"); mq.put("e"); } }, "t1"); t1.start(); Thread t2 = new Thread(new Runnable() { @Override public void run() { Object o1 = mq.take(); System.out.println("移除的元素为:" + o1); Object o2 = mq.take(); System.out.println("移除的元素为:" + o2); } }, "t2"); try { TimeUnit.SECONDS.sleep(2); } catch (InterruptedException e) { e.printStackTrace(); } t2.start(); } }

优秀的个人博客,低调大师

高并发大容量 NoSQL 解决方案探索

大数据时代,企业对于DBA也提出更高的需求。同时,NoSQL作为近几年新崛起的一门技术,也受到越来越多的关注。本文将基于个推SRA孟显耀先生所负责的DBA工作,和大数据运维相关经验,分享两大方向内容:一、公司在KV存储上的架构演进以及运维需要解决的问题;二、对NoSQL如何选型以及未来发展的一些思考。 据官方统计,截止目前(2018年4月20日)NoSQL有225个解决方案,具体到每个公司,使用的都是其中很小的一个子集,下图中蓝色标注的产品是当前个推正在使用的。 NoSQL 的由来 1946年,第一台通用计算机诞生。但一直到1970年RDMBS的出现,大家才找到通用的数据存储方案。到21世纪,DT时代让数据容量成为最棘手的问题,对此谷歌和亚马逊分别提出了自己的NoSQL解决方案,比如谷歌于2006年提出了Bigtable。2009年的一次技术大会上,NoSQL一词被正式提出,到现在共有225种解决方案。 NoSQL与RDMBS的区别主要在两点:第一,它提供了无模式的灵活性,支持很灵活的模式变更;第二,可伸缩性,原生的RDBMS只适用于单机和小集群。而NoSQL一开始就是分布式的,解决了读写和容量扩展性问题。以上两点,也是NoSQL产生的根本原因。 实现分布式主要有两种手段:副本(Replication)和分片(Sharding)。Replication能解决读的扩展性问题和HA(高可用),但是无法解决读和容量的扩展性。而Sharding可以解决读写和容量的扩展性。一般NoSQL解决方案都是将二者组合起来。 Sharding主要解决数据的划分问题,主要有基于区间划分(如Hbase的Rowkey划分)和基于哈希的划分。为了解决哈希分布式的单调性和平衡性问题,目前业内主要使用虚拟节点。后文所述的Codis也是用虚拟节点。虚拟节点相当于在数据分片和托管服务器之间建立了一层虚拟映射的关系。 目前,大家主要根据数据模型和访问方式进行NoSQL分类。 个推常用的几种 NoSQL 解决方案 个推Redis系统规模如下图。下面介绍一下运维过程遇到的几个问题。 首先是技术架构演进过程。个推以面向APP开发者提供消息推送服务起家,在2012年之前,个推的业务量相对较小,当时我们用Redis做缓存,用MySQL做持久化。在2012-2016年,随着个推业务的高速发展,单节点已经无法解决问题。在MySQL无法解决高QPS、TPS的情况下,我们自研了Redis分片方案。 此外,我们还自研了Redis客户端,用它来实现基本的集群功能,支持自定义读写比例,同时对故障节点的监测和隔离、慢监控以及每个节点健康性进行检查。但这种架构没有过多考虑运维效率的问题,缺少运维工具。 当我们计划完善运维工具的时候,发现豌豆荚团队将Codis开源,给我们提供了一个不错的选项。 个推 Codis+ 的优势 Codis是proxy-based架构,支持原生客户端,支持基于web的集群操作和监控,并且也集成了Redis Sentinel。可以提高我们运维的工作效率,且HA也更容易落地。 但是在使用过程中,我们也发现一些局限。因此我们提出了Codis+,即对Codis做一些功能增强。 第一、 采用2N+1副本方案,解决故障期间Master单点的问题。 第二、Redis准半同步。设置一个阈值,比如slave仅在5秒钟之内可读。 第三、资源池化。能通过类似HBase增加RegionServer的方式去进行资源扩容。 此外,还有机架感知功能和跨IDC的功能。Redis本身是为了单机房而设置的,没有考虑到这些问题。 那么,为什么我们不用原生的rRedis cluster?这里有三个原因:一、原生的集群,它把路由转发的功能和实际上的数据管理功能耦合在一个功能里,如果一个功能出问题就会导致数据有问题;二、在大集群时,P2P的架构达到一致性状态的过程比较耗时,codis是树型架构,不存在这个问题。三、集群没有经过大平台的背书。 此外,关于Redis,我们最近还在看一个新的NoSQL方案Aerospike,我们对它的定位是替换部分集群Redis。Redis的问题在于数据常驻内存,成本很高。我们期望利用Aerospike减少TCO成本。Aerospike有如下特性: 一、Aerospike数据可以放内存,也可以放SSD,并对SSD做了优化。 二、资源池化,运维成本继续降低。 三、支持机架感知和跨IDC的同步,但这属于企业级版本功能。 目前我们内部现在有两个业务在使用Aerospike,实测下来,发现单台物理机搭载单块Inter SSD 4600,可以达到接近10w的QPS。对于容量较大,但QPS要求不高的业务,可以选择Aerospike方案节省TCO。 在NoSQL演进的过程中,我们也遇到一些运维方面的问题。 标准化安装 我们共分了三个部分:OS标准化、Redis文件和目录标准、Redis参数标准化,全部用saltstack + cmdb实现; 扩容和缩容 在技术架构不断演进过程中,扩容和缩容的难度也在变低,原因之一在于codis缓解了一部分问题。当然,如果选择Aerospike,相关操作就会非常轻松。 做好监控,降低运维成本 大部分的运维同学都应该认真阅读《SRE:Google运维揭秘》,它在理论层面和实践层面提出了很多非常有价值的方法论,强烈推荐。 个推 Redis 监控复杂性 三种集群架构:自研、codis2和codis3,这三种架构采集数据的方式并不相同。 三类监控对象:集群、实例、主机,需要有元数据维护逻辑关系,并在全局做聚合。 三种个性化配置:个推的Redis集群,有的集群需要有多副本,有的不需要。有的节点允许满做缓存,有的节点不允许满。还有持久化策略,有的不做持久化,有的做持久化,有的做持久化+异地备份,这些业务特点对我们监控灵活性提出很高的要求。 Zabbix是一个非常完备的监控系统,约三年多的时间里,我都把它作为主要的监控系统平台。但是它有两个缺陷:一是它使用MySQL作为后端存储,TPS有上限;二是不够灵活。比如:一个集群放在一百台机器上,要做聚合指标,就很困难。 小米的open-falcon解决了这个问题,但是也会产生一些新问题。比如告警函数很少,不支持字符串,有时候会增加手工的操作等等。后来我们对它进行功能性补充,便没有遇到大的问题。 下图是个推运维平台。 第一个是IT硬件资源平台,主要维护主机维度的物理信息。比如说主机在哪个机架上接的哪个交换机,在哪个机房的哪一个楼层等等,这是做机架感知和跨IDC等等的基础。 第二个是CMDB,这个是维护主机上的软件信息,主机上装了哪些实例,实例属于哪些集群,我们用了哪些端口,这些集群有什么个性化的参数配置,包括告警机制不一样,全是通过CMDB实现。CMDB的数据消费方包含grafana监控系统和监控采集程序,采集程序由我们自己开发。这样CMDB数据会活起来。如果只是一个静态数据没有消费方,数据就会不一致。 grafana监控系统聚合了多个IDC数据,我们运维每天只需看一下大屏就够了。 Slatstack,用于实现自动化发布,实现标准化并提高工作效率。 采集程序是我们自行研发的,针对公司的业务特点定制化程度很高。还有ELK(不用logstach,用filebeat)做日志中心。 通过以上这些,我们搭建出个推整个监控体系。 下面讲一下搭建过程中遇到的几个坑。 一、主从重置,会导致主机节点压力爆增,主节点无法提供服务。 主从重置有很多原因。 Redis版本低,主从重置的概率很高。Redis3主从重置的概率比Redis2大大减少,Redis4支持节点重启以后也能增量同步,这是Redis本身进行了很多改进。 我们现在主要使用的是2.8.20,属于比较容易能产生主从重置。 Redis的主从重置一般是触发了如下条件中的一个。 1、repl-backlog-size太小,默认是1M,如果你有大量的写入,很容易击穿这个缓冲区;2、repl-timeout,Redis主从默认每十秒钟ping一次,60秒钟ping不推就会主从重置,原因可能是网络抖动、总节点压力过大,无法响应这个包等;3、tcp-baklog,默认是511。操作系统的默认是限制到128,这个可以适度提高,我们提高到2048,这个能对网络丢包现象进行一定容错。 以上都是导致主从重置的原因,主从重置的后果很严重。Master压力爆增无法提供服务,业务就把这个节点定为不可用。响应时间变长 Master所在所有主机的节点都会受到影响。 二、节点过大,部分是人为原因造成的。 第一是拆分节点的效率较低,远远慢于公司业务量的增长。此外,分片太少。我们的分片是500个,codis是1024,codis原生是16384个,分片太少也是个问题。如果做自研的分布式方案,大家一定要把分片数量,稍微设大一点,避免业务发展超过你预期的情况。节点过大之后,会导致持久化的时间增长。我们30G的节点要持久化,主机剩余内存要大于30G,如果没有,你用Swap导致主机持久化时间大幅增长。一个30G的节点持久化可能要4个小时。负载过高也会导致主从重置,引起连锁反应。 关于我们遇到的坑,接下来分享几个实际的案例。 第一个案例是一次主从重置。这个情况是在春节前两天出现的,春节前属于消息推送业务高峰期。我们简单还原一下故障场景。首先是大规模的消息下发导致负载增加;然后,Redis Master压力增大,TCP包积压,OS产生丢包现象,丢包把Redis主从ping的包给丢了,触发了repl-timeout 60秒的阈值,主从就重置了。同时由于节点过大,导致Swap和IO饱和度接近100%。解决的方法很简单,我们先把主从断开。故障原因首先是参数不合理,大都是默认值,其次是节点过大让故障效果进行放大。 第二个案例是codis最近遇到的一个问题。这是一个典型的故障场景。一台主机挂掉后,codis开启了主从切换,主从切换后业务没有受影响,但是我们去重新接主从时发现接不上,接不上就报了错。这个错也不难查,其实就是参数设置过小,也是由于默认值导致。Slave从主节点拉数据的过程中,新增数据留在Master缓冲区,如果Slave还没拉完,Master缓冲区就超过上限,就会导致主从重置,进入一个死循环。 基于这些案例,我们整理了一份最佳实践。 一、配置CPU亲和。Redis是单机点的结构,不亲和会影响CPU的效率。 二、节点大小控制在10G。 三、主机剩余内存最好大于最大节点大小+10G。主从重置需要有同等大小的内存,这个一定要留够,如果不留够,用了Swap,就很难重置成功。 四、尽量不要用Swap。500毫秒响应一个请求还不如挂掉。 五、tcp-backlog、repl-backlog-size、repl-timeout适度增大。 六、Master不做持久化,Slave做AOF+定时重置。 最后是个人的一些思考和建议。选择适合自己的NoSQL,选择原则有五点: 1、业务逻辑。首先要了解自身业务特点,比如是KV型就在KV里面找;如果是图型就在图型里找,这样范围一下会减少70%-80%。 2、负载特点,QPS、TPS和响应时间。在选择NoSQL方案时,可以从这些指标去衡量,单机在一定配置下的性能指标能达到多少?Redis在主机足够剩余情况下,单台的QPS40-50万是完全OK的。 3、数据规模。数据规模越大,需要考虑的问题就越多,选择性就越小。到了几百个TB或者PB级别,几乎没太多选择,就是Hadoop体系。 4、运维成本和可不可监控,能否方便地进行扩容、缩容。 5、其它。比如有没有成功案例,有没有完善的文档和社区,有没有官方或者企业支持。可以让别人把坑踩过之后我们平滑过去,毕竟自己踩坑的成本还是蛮高的。 结语:关于NoSQL的释义,网络上曾有一个段子:从1980年的know SQL,到2005年的Not only SQL,再到今日的No SQL!互联网的发展伴随着技术概念的更新与相关功能的完善。而技术进步的背后,则是每一位技术人的持续的学习、周密的思考与不懈的尝试。 原文发布时间为:2018-09-25 本文来自云栖社区合作伙伴“互联网架构师”,了解相关信息可以关注“互联网架构师”

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册