首页 文章 精选 留言 我的

精选列表

搜索[多模态Agent],共10000篇文章
优秀的个人博客,低调大师

记录TritonServer部署多模型到多GPU踩坑 | 京东云技术团队

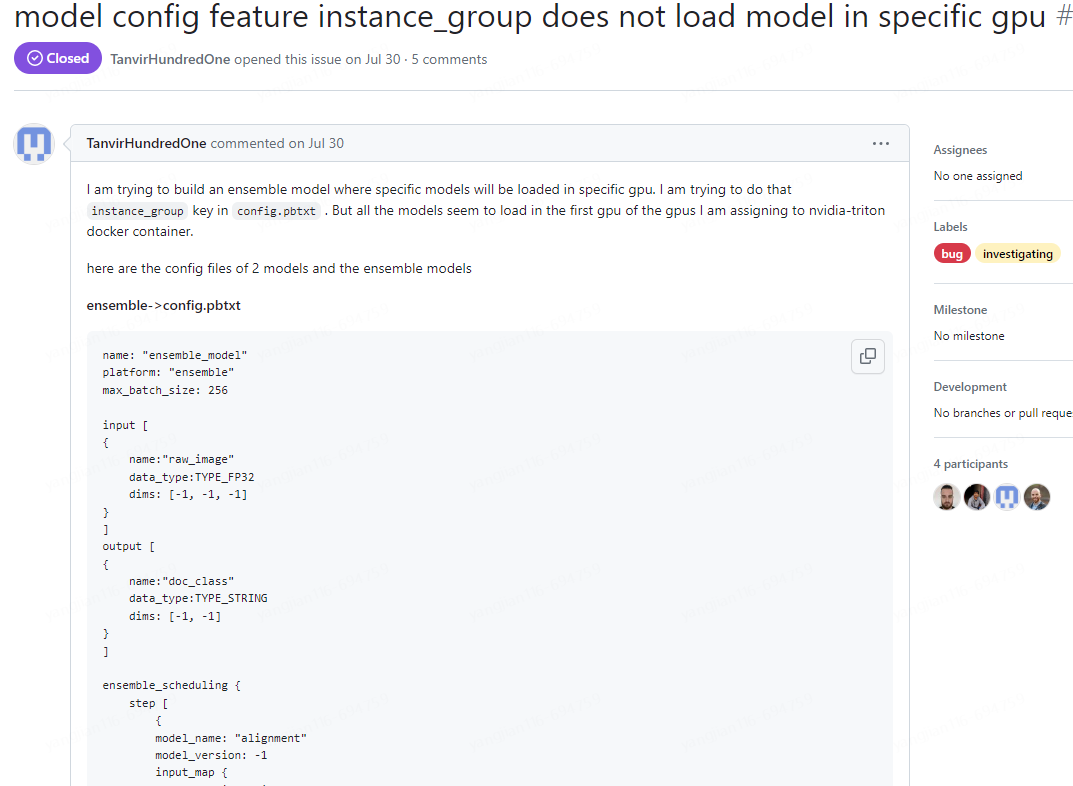
一、问题是怎么发现的 部署chatglm2和llama2到一个4*V100的GPU机器上遇到问题 config.pbtxt 中设置模型分别在指定gpu上部署实例配置不生效 如以下配置为在gpu0上部署本模型,部署count=1个实例,在gpu1上部署本模型,部署count=2个实例 instance_group [ { count: 1 kind: KIND_GPU gpus: [ 0 ] }, { count: 2 kind: KIND_GPU gpus: [ 1 ] } ] 部署时发现,所有模型实例都会被部署到gpu0上面, 由于gpu只有16g显存,在部署第一个模型实例成功后,第二个模型实例也会往gpu0上进行加载,最终导致cuda out of memery. 网上搜索发现有人遇到同样的问题,链接: https://github.com/triton-inference-server/server/issues/6124 二、排查问题的详细过程 大佬回答解决方案: 三、如何解决问题 1.在model.py手动获取config.pbtxt配置的gpu编号gpus:[0] instance_group [ { count: 1 kind: KIND_GPU gpus: [ 0 ] } ] 2.设置可用的GPU编号 os.environ["CUDA_VISIBLE_DEVICES"] = str(device_id) 3.启动成功 四、总结反思:是否可以更快发现问题?如何再次避免等。 triton启动的使用使用 nvidia-smi -l 2 监控显卡想显存, 可以发现所有模型都在往第一个gpu,gpu[0]内加载,发现配置config.pbtxt不生效 作者:京东科技 杨建 来源:京东云开发者社区 转载请注明来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册