首页 文章 精选 留言 我的

精选列表

搜索[个人博客],共10000篇文章
优秀的个人博客,低调大师

Java个人技术知识点总结(数据库篇)

数据库篇 JDBC连接数据库步骤(以MYSQL为例) 1、加载JDBC驱动程序: 通过Class类的forName方法实现,并将驱动地址放进去 成功加载后,会将Driver类的实例注册到DriverManager类中。 2、提供JDBC连接的URL 、创建数据库的连接 •要连接数据库,需要向java.sql.DriverManager请求并获得Connection对象, 该对象就代表一个数据库的连接。 •使用DriverManager的getConnectin()方法传入指定的欲连接的数据库的路径、数 据库的用户名和密码。 Connection con=DriverManager.getConnection(url , username , password); &&&:"jdbc:mysql://localhost/test?user=root&password=123&useUnicode=true&characterEncoding=utf-8”; 3、创建一个Statement •要执行SQL语句,必须获得java.sql.Statement实例 •执行静态SQL语句。通常通过Statement实例实现。 •执行动态SQL语句。通常通过PreparedStatement实例实现。 String sql = “”; Statement st = con.createStatement() ; PreparedStatement pst = con.prepareStatement(sql) ; 4、执行SQL语句 Statement接口提供了executeQuery、executeUpdate、execute三种方法 executeQuery:执行select语句,返回ResultSet结果集 ResultSet rst = pst.executeQuery(); • executeUpdate:执行insert、update、delete语句 pst.executeUpdate(); 5、关闭JDBC对象 操作完成以后要把所有使用的JDBC对象全都关闭,以释放JDBC资源。 数据库连接池 数据库连接池的优点运行原理: 在我们不使用数据库连接池的时候,每次访问数据库都需要创建连接,使用完成之后需要释放关闭连接,而这样是很耗费资源的。当我们使用数据库连接池的时候,在tomcat启动的时候就创建了指定数量的连接,之后当我们程序使用的时候就直接从连接池里面取,而不需要创建,同理,当我们使用完的时候也不需要关闭连接,而是将连接返回到连接池中,供其他请求继续使用。 DBCP:比较稳定。 C3P0:性能比较高。 mysql的数据库导入导出 配置: 首先找到mysql的安装目录,进入bin目录下复制路径、将mysql的bin目录粘贴在计算机环境变量的path中、授权:、登录mysq、将某张表的某个权限赋给某个用户。 grant [select,insert,update,delete,create,drop] on [databaseName].[tableName]to [userName]@[userIP] identified by [‘连接口令’] grant select,insert,update,delete,create,drop on oa_ssh.user to root@[IP] identified by 'root'; 将所有库的所有权限赋给某个用户 grant all privileges on *.* to [userName]@[userIp] identified by [‘连接口令’] grant all privileges on *.* to root@[IP] identified by ‘root'; 将所有库的所有权限赋给所有用户 grant all privileges on *.* to root@'%' identified by ‘root’; 导出本地数据库: mysqldump -u用户名 -p 数据库名 > 磁盘:导出的文件名(加后缀) 远程导出数据库: mysqldump -h IP -u用户名 -p 数据库名称 >导出的文件名(加后缀) 远程导出数据表: mysqldump -u root -p -d --add-drop-table数据库名称 > 导出文件名(加后缀) 导入数据: mysql -u root -p登录成功后 ==》 source 磁盘:导入的文件名(加后缀) jdbc分段批量提交的时候出现异常怎么处理? 通过Map来解决性能问题。首先在分段批量提交的时候,我们不采用事务,这样就保证了合法的数据就自动提交,不合法的数据就自己自动进行回滚,为了避免不合法数据影响后续合法数据的提交,采用定义业务规则字典表,实现对数据的验证,将不合法的数据记录下来,供用户进行后续处理,而合法的数据就全部提交。 jdbc批量处理数据 批量处理数据:(代码优化:提高程序执行性能)降低了java程序代码(客户端)和数据库之间的 网络通信的次数。在jdbc中进行批量插入的核心API为 addBatch,executeBatch大数据量的插入问题:(jdbc,hibernate,ibatis) 1.每次只插入一条和数据库交互多次(很耗时间) 2.批量插入和数据库只交互一次(内存溢出) 3.分段批量插入(推荐) jdbc批量处理数据是通过PreparedStatement对象的 addbatch(), executebatch() clearbatch()进行和数据库的交互。通常我们使用分段批量处理的方式 这样可以提高程序的性能 ,防止内存溢出。 1.每个sql语句都和数据库交互一次(非批量操作) 2.只和数据库交互一次(批量操作)(内存溢出) 当数据达到一定额度的时候就和数据库进行交互,分多次进行(分段批量操作) (500或者1000) pst.addBatch(); if (i > 0 && i%1000 == 0) { pst.executeBatch(); pst.clearBatch(); } Oracle分页 select * from (select * from (select s.*,rownum rn from student s ) where rn<=5) where rn>0 如果你依然觉得有些茫然,不如加入我的Java架构师之路:766529531跟有多年Java开发经验的资深工程师聊一聊。也可获取免费的视频学习资料以及电子书学习资料喔! Oracle的基本数据类型 Oracle的基本数据类型(常用): 1、字符型 Char固定长度字符串 占2000个字节 Varchar2可变长度字符串 占4000个字节 Nvarchar2占2000个字符(最多能存2000个字母/中文) 2、大对象型(lob) Blob:二进制数据 最大长度4G Blob用于存一些图片,视频,文件。 比如:当我们在进行文件上传时,我们一般把上传的文件存在硬盘上,可以不占用数据库,下载时,如果项目迁移时,文件也要跟着迁移。因此我们可以把用blob把它存在数据库中。但这样也增加了数据库的负担。 Clob:字符数据 最大长度4G,可以存大字符串 varchar2和nvarchar2都具有一定的局限性,它们长度有限,但数据库中无论用varchar2或nvarchar2类型,还是用clob,在java端都使用String接收。 3、数值型 Integer整数类型,小的整数。 Float浮点数类型。 Real实数类型。 Number(p,s)包含小数位的数值类型。P表示精度,s表示小数后的位数。 Eg: number(10,2)表示小数点之前可有8位数字,小数点后有2位。 4、日期类型 Date日期(日-月-年) DD-MM-YY(HH-MI-SS) Timestamp跟date比 它可以精确到微秒。精确范围0~9 默认为6. id、rowid、rownum的区别 rowid物理位置的唯一标识。 而id是逻辑上的唯一标识,所以rowid查找速度要快于id,是目前最快的 定位一条记录的方式 rowid和rownum都是"伪数列" 所谓“伪数列”也就是默认隐藏的一个数列。 rownum用于标记结果集中结果顺序的一个字段, 它的特点是按顺序标记,而且是连续的, 换句话说就是只有有rownum=1的记录,才可能有rownum=2的记录。 rownum关键字只能和<或者<=直接关联 如果是>或者=则需要给他起个别名 主键和唯一索引的区别? 在创建主键的同时会生成对应的唯一索引,主键在保证数据唯一性的同时不允许为空,而唯一可以有一个为空数据项,一个表中只能有一个主键,但是一个主键可以有多个字段,一个表中可以有多个唯一索引。 Preparedstatement和statement的区别 用Prepared statement进行开发。Prepared statement是预编译的,而statement不是,在每次执行sql语句的增删改时,如果是一条数据两者没差距,但如果数据量大于1,那么每次执行sql语句statement都要重新编译一次,而Prepared statement不用,Prepared statement的运行效率大于statement;从代码的可维护性和可读性来说,虽然用Prepared statement来代替statement会使代码多出几行,但这样的代码无论从可读性还是可维护性来说,都比直接使用statement的代码高很多档次;最重要的一点,从安全角度来说,使用Prepared statement可以大大提高程序的安全性,因为Prepared statement是用‘?’传参,可以防止sql注入,具有安全性,而statement用的是‘+’字符串拼接,安全性较低。 数据库三范式 第一范式:数据库表中的所有字段值都是不可分解的原子值。 第二范式:需要确保数据库表中的每一列都和主键相关,而不能只与主键的某一部分相关(主要针对联合主键而言) 第三范式:需要确保数据表中的每一列数据都和主键直接相关,而不能间接相关 如果你依然觉得有些茫然,不如加入我的Java架构师之路:766529531跟有多年Java开发经验的资深工程师聊一聊。也可获取免费的视频学习资料以及电子书学习资料喔! 视图概述 视图可以视为“虚拟表”或“存储的查询” 创建视图所依据的表称为“基表” 视图的优点: 提供了另外一种级别的表安全性:隐藏了一些关键的字段 简化的用户的SQL命令 隔离基表结构的改变 存储过程概述 存储过程(Stored Procedure) 可以包含逻辑判断的sql语句集合。 是经过预编译,存在于数据库中。 通过调用指定存储过程的名字(可有参,可无参)来执行。 优点: 简化了复杂的业务逻辑,根据需要可重复使用 屏蔽了底层细节,不暴露表信息即可完成操作 降低网络的通信量,多条语句可以封装成一个存储过程来执行 设置访问权限来提高安全性 提高执行效率,因为它是预编译以及存储在数据库中 缺点: 可移植性差,相同的存储过程并不能跨多个数据库进行操作 大量使用存储过程后,首先会使服务器压力增大,而且维护难度逐渐增加 存储过程的语法: --下面是在oracle数据库下最基本的语法 --仅创建一个名为testProcedure 的无参的存储过程 --IS也可以是AS --如果已经存在名为 testProcedure 的存储过程,下面的语法会出现 名称已被使用的错误 --解决办法: --第一句可以写成 create or replace procedure testProcedure --这样会替换原有的存储过程 --NULL表示任何可以正确执行的sql 语句,但至少一句 create procedure testProcedure IS BEGIN NULL END; 存储过程的参数的分类: IN OUT INOUT 注意: 存储过程之间可相互调用 存储过程一般修改后,立即生效。 索引概述 1、索引的概念 索引就是为了提高数据的检索速度。 数据库的索引类似于书籍的索引。 在书籍中,索引允许用户不必翻阅完整个书就能迅速地找到所需要的信息。 在数据库中,索引也允许数据库程序迅速地找到表中的数据, 而不必扫描整个数据库. 2、索引的优点 1.创建唯一性索引,保证数据库表中每一行数据的唯一性 2.大大加快数据的检索速度,这也是创建索引的最主要的原因 3.减少磁盘IO(向字典一样可以直接定位) 3、索引的缺点 1.创建索引和维护索引要耗费时间,这种时间随着数据量的增加而增加 2.索引需要占用额外的物理空间 3.当对表中的数据进行增加、删除和修改的时候, 索引也要动态的维护,降低了数据的维护速度 4、索引的分类 1.普通索引和唯一性索引 普通索引:CREATE INDEX mycolumn_index ON mytable (myclumn) 唯一性索引:保证在索引列中的全部数据是唯一的 CREATE unique INDEX mycolumn_index ON mytable (myclumn) 2.单个索引和复合索引 单个索引:对单个字段建立索引 复合索引:又叫组合索引,在索引建立语句中同时包含多个字段名, 最多16个字段 CREATE INDEX name_index ON userInfo(firstname,lastname) 3.顺序索引,散列索引,位图索引 必背的sql语句 1:oracle分页 select * from (select t.*, rownum rn from (select * from menu order by id desc) t where rownum < 10) where rn >=5 2: mysql分页 select * from music where id limit 5,5 3:oracle中如何快速将一张表的数据复制到另外一张表中(另外一张表不存在,另外一张 表存在,但数据为空) [if !supportLists]1、[endif].不存在另一张表时: create table新表 as select * from 将要复制的表 [if !supportLists]2、[endif]存在另一张表时: insert into新表名 select 字段 from 将要复制的表名 4:音乐专辑 查询出special 表中的id 专辑名 并下面有多少首歌曲 Select s.id , min(s.sname),count(m.mid) from special s inner join ms m on s.id=m.id group by s.id 5:快速删除一张表(不可事物回滚,也就是没有日志记录) TRUNCATE from表名 6:inner join select查找信息 from 表名 1 inner join 表名2 on 表名1.列名 = 表名2.列名 7:left join 左外连接select查找信息 from 表名1 left join 表名2 on 表名1.列名 = 表名2.列名 8:right join 右外连接select查找信息 from 表名1 right join 表名2 on 表名1.列名 = 表名2.列名 9:oracle中查询遍历树形结构(start with) select * from extmenu start with pid=1 connect by prior id = pid 快速删除父节点以及父节点下的所有节点: Delete from extmenuwhere id in ( elect * from extmenu start with pid=1 connect by prior id = pid ) 10:查询出来60-70,80-90,95-100学生的信息 select * from stu where chengji between 60 and 70 or between 80 and 90 or between 95 and 100 select * from stu where chengji > 60 and chengji < 70 or chengji > 80 and chengji < 90 or chengji > 95 and chengji < 100 11:用exists替换in------进行联表查询 select * from dept where exists(select * from emp where emp.deptno=dept.deptno);或select * from dept d inner join emp e on d.deptno = e.deptno(只查询出两表共同拥有的字段数据) 如果你依然觉得有些茫然,不如加入我的Java架构师之路:766529531跟有多年Java开发经验的资深工程师聊一聊。也可获取免费的视频学习资料以及电子书学习资料喔! 12:删除表中的重复数据: delete from xin a where a.rowid != ( select max(b.rowid) from xin b where a.name = b.name ); 13:row_number(),rank() over ,dense_rank() over 按工资排序 select sal, row_number() over(order by sal desc) rank1, rank() over(order by sal desc) rank, dense_rank() over(order by sal desc) drank from emp 14:select * from (select emp.* from( dense_rank() over(partition by departNo order by sal desc) rk from emp ) Where rk=4 ibatis批量 this.getSqlMapClientTemplate().execute( new SqlMapClientCallback() { public Object doInSqlMapClient( SqlMapExecutor executor) throws SQLException { executor.startBatch(); for (int i = 0, n = list.size(); i < n; i++) { executor.insert( "productAttach.insertProductAttach", list.get(i)); } executor.executeBatch(); return null; } }); ibatis,jdbc,hibernate的分段的实现: 都应该在组装list的时候进行拆分(如:action层加入) if(list.size() % 1000 == 0) { productAttachService.addBatch(list); list.clear(); } if (list.size() > 0) productAttachService.addBatch(list);

优秀的个人博客,低调大师

【java SOAP】对SOAP的一个个人印象

开这个坑源于我现在做的一个项目用到了SOAP。关于SOAP的知识我就不做详细介绍了。我也没有开发过SOAP服务端, 只是要用到客户端。 作为一个意识流选手,我大概说一下我工作过程中对SOAP的印象。 1、 SOAP的出现是为了解决跨平台的问题。比如java调用一个c#或者php写的服务 2、 数据传输是基于xml的。上一点说到是为了解决跨平台的问题,但是很蛋疼的是,并没有很严格的标准去规定xml的数据格式。导致这个标准并不是唯一的。这就非常操蛋了。逆向生成的代码经常没用,甚至使用逆向工具的时候偶尔还会报错(我这个项目还有一点别的原因)。 3、我用Eclipse根wsdl生成的客户端访问SOAP服务特别慢。而且并不是服务端的问题。我用 TCP Monitor 截获了请求,数据返回特别快20ms左右,但是客户端把返回数据处理成相应的bean特别慢。导致整个调用花费了1分钟 4、有很多手写客户端的办法。但是我觉得都太麻烦了。而且像Axis2我不知道为什么从Maven下载依赖下不下来,javax有一个对soap的支持,但是在一些java版本移来移去,java8是有的,java9就移除了。 5、于是我开始自己琢磨在现有的基础上写一个通用的方法去构造请求的内容。一开始想用Axis2,上面说了,下载不下来。。然后就用javax的soap。发现很不灵活,凑不出我项目里要的格式。然后还想过直接用StringBuilder,但是很不好用。最后选择了Dorm4j + javax自带的soap 说到我工作用到的SOAP server。那还是大佬十年前写的,真的很佩服,他们没有什么工具。完全用C根据SOAP协议写了一个SOAP Server。真的是强, 里面的源码是完完全全地对字符串的解析,膜拜大佬。但是估计是只对C#调用做了很多测试。C#的客户端调用特别快。我现在要用java调用,逆向生成的代码把数据传过去有一部分是解析不到的。我现在就是想办法把java调用时的数据做成跟C#调用的数据写成一样的。

优秀的个人博客,低调大师

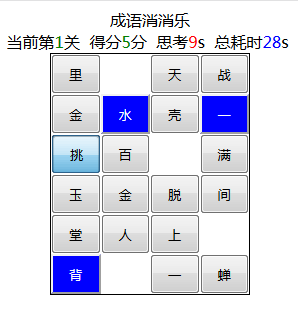
点亮LED的个人空间 JavaScript 正文 JavaScript成语消消乐

一 预览 二 开发步骤 基本面向过程的思想。没有面向对象的部分。 准备好成语库。db.js 选出每一关的成语。 对成语进行乱序。 初始化表格的同时,将单个字放到每个单元格的按钮上展示。 对tbody进行点击事件的监听。事件函数中获取btn。用变量记录选中的文字。 判断得分、判断下一关、判断游戏结束(成语库毕竟用数组来保存。成语数量有限。) 三 代码 只有两个文件:index.html和db.js 1 index.html代码如下: <!DOCTYPE HTML> <HTML> <head> <meta charset="UTF-8" /> <style> table{ margin:0 auto; width:200px; border:1px solid black; } table button{ width:100%; height:40px; } table td{ width:25%; } table td .selectbtn{ background:blue; color:white; } </style> <script type="text/javascript" src="db.js"></script> </head> <body > <div align="center">成语消消乐</div> <div align="center"> 当前第<font color="green" id="current_level_text">1</font>关 得分<font id="gain_scores_txt" color="green">0</font>分 思考<font id="think_time" color="red">0</font>s 总耗时<font id="total_times" color="blue">0</font>s </div> <table border='0' cellpadding='0' cellspacing='0'> <tbody id="mytbody"> </tbody> </table> <script> window.onload=function(){ var XXL={ dom:{ level:document.getElementById("current_level_text"), scores:document.getElementById("gain_scores_txt"), think_time:document.getElementById("think_time"), total_times:document.getElementById("total_times"), tbody:document.getElementById("mytbody") }, dbs:listWords,//从外部js中加载。 chooseData:[],//记录从数据库从取出的成语。 recordChooseText:"",//记录用户选择的文字。 recordChooseBtn:[],//记录用户选择的按钮的jq对象。 current_index:0,//当前关数。 不可调。 every_words:6,//每一关的成语个数。可调。 every_right_num:0,//当前关答对的成语个数。 不可调。 current_words:0,//当前关的成语个数。 ,不可调。 last_time:Date.now(),//最后一次答题时间。 gain_scores:0,//得分。不可调。 every_scores:5,//每题得分。可调。 //从成语库中选取成语。 initWords:function(){ var dbtxt = ""; var start = this.current_index * this.every_words; var end = start + this.every_words <= this.dbs.length ? start + this.every_words : this.dbs.length; //此段是后来完善的。 this.current_words = end - start; if( this.current_words <=0 ){ end = 0; this.current_words = 0; } // for(var i=start;i<end;i++){ dbtxt +=this.dbs[i]; this.chooseData.push(this.dbs[i]); } return dbtxt;//返回乱序前的拼接字符串。 }, luanxu:function(dbtxt){ var luanxu=[]; while(dbtxt.length>0){ var index = parseInt(Math.random()*dbtxt.length); luanxu.push(dbtxt.charAt(index)); dbtxt = dbtxt.substring(0,index)+dbtxt.substring(index+1,dbtxt.length); } return luanxu;//返回乱序后的字符。 }, createTable:function(words){ var len = 0; var tbody = document.getElementById("mytbody"); tbody.innerHTML="";//清空tbody。 var tbodyhtml = ""; for(var i=0;i<XXL.current_words; i++){ var tr = "<tr>"; for(var j=0;j<4;j++){ var td = "<td>" ; td+=("<button type='button'>"+words[len++]+"</button>"); td+="</td>"; tr+=td; } tr+="</tr>"; tbodyhtml+=tr; } tbody.innerHTML = tbodyhtml; }, removeBtn:function(){ for(var i=0;i<XXL.recordChooseBtn.length;i++){ XXL.recordChooseBtn[i].remove(); } }, //下一关。 nextLevel:function(){ //答对成语个数和当前关的成语个数相等。则下一关。 if(this.every_right_num == this.current_words){ //下一关。 this.current_index ++; alert("恭喜您进入第"+ (this.current_index+1) +"关"); //清空当前答对成语个数。 this.every_right_num = 0; //1重新初始化表格。 this.init(); this.dom.level.innerText = this.current_index+1; //判断终极结束。 if(this.current_words <= 0){ alert("您已经是这个宇宙最厉害的人了。"); //重新加载网页。 window.location.reload(); } } }, //检测得分。 check:function(){ //如果点击的按钮个数少于4。直接退出函数。 if(this.recordChooseBtn.length <4)return; //判断选择的成语,是否能够组成一个四字成语。 var find = false;//是否匹配标志位。 for(var i=0;i<this.chooseData.length;i++){ if(this.recordChooseText == this.chooseData[i]){ find = true; break; } } //如果能匹配上。 if(find){ //答对成语个数 ++。 this.every_right_num ++; //界面中消去成语。 this.removeBtn(); //判断是否需要跳转下一关。 this.nextLevel(); //更新答题时间。 this.last_time = Date.now(); //更新得分。 this.gain_scores += this.every_scores; // this.dom.scores.innerText = this.gain_scores; } //还原按钮样式。 document.querySelectorAll(".selectbtn").forEach(function(btn){ btn.className=""; }); //清空按钮数组。 this.recordChooseBtn=[]; //清空选中的成语字符串 this.recordChooseText = ""; }, init:function(){ //1 从成语库中选出当前关的成语。 var worstxt = this.initWords(); //2 准备乱序成语。 var dbs = this.luanxu( worstxt ); //3 准备好界面。 this.createTable(dbs); }, bindEvent:function(){ var _this = this; //对tbody进行点击事件的绑定。利用事件的冒泡。 //当点击子元素时,tbody事件函数能够进行响应。 this.dom.tbody.onclick = function(e){ var btn = e.target;//dom对象。 if( btn.type =="button"){ _this.recordChooseText += btn.innerText; _this.recordChooseBtn.push( btn ); //添加一个class属性,控制选中样式。 btn.className="selectbtn"; //检测得分。 _this.check(); } } }, executeTask:function(){ //定时1s执行一次。 setInterval(function(){ //思考时间 XXL.dom.think_time.innerText = parseInt((Date.now()-XXL.last_time)/1000); //总时间 XXL.dom.total_times.innerText = parseInt( XXL.dom.total_times.innerText )+1; },1000); } }; XXL.init(); XXL.bindEvent(); XXL.executeTask(); }; </script> </body> </HTML>2 db.js文件如下: var listWords=["金蝉脱壳","百里挑一","金玉满堂","背水一战","霸王别姬","天上人间","不吐不快","海阔天空","情非得已","满腹经纶","兵临城下","春暖花开","插翅难逃","黄道吉日","天下无双","偷天换日","两小无猜","卧虎藏龙","珠光宝气","簪缨世族","花花公子","绘声绘影","国色天香","相亲相爱","八仙过海","金玉良缘","掌上明珠","皆大欢喜","逍遥法外","生财有道","极乐世界","情不自禁","愚公移山","魑魅魍魉","龙生九子","精卫填海","海市蜃楼","高山流水","卧薪尝胆","壮志凌云","金枝玉叶","四海一家","穿针引线","无忧无虑","无地自容","三位一体","落叶归根","相见恨晚","惊天动地","滔滔不绝","相濡以沫","长生不死","原来如此","女娲补天","三皇五帝","万箭穿心","水木清华","窈窕淑女","破釜沉舟","天涯海角","牛郎织女","倾国倾城","飘飘欲仙","福星高照","妄自菲薄","永无止境","学富五车","饮食男女","英雄豪杰","国士无双","塞翁失马","万家灯火","石破天惊","精忠报国","养生之道","覆雨翻云","六道轮回","鹰击长空","日日夜夜","厚德载物","亡羊补牢","万里长城","黄金时代","出生入死","一路顺风","随遇而安","千军万马","郑人买履","棋逢对手","叶公好龙","后会无期","守株待兔","凤凰于飞","一生一世","花好月圆","世外桃源","韬光养晦","画蛇添足","青梅竹马","风花雪月","滥竽充数","总而言之","没完没了","欣欣向荣","时光荏苒","差强人意","好好先生","无懈可击","随波逐流","袖手旁观","群雄逐鹿","血战到底","唯我独尊","买椟还珠","龙马精神","一见钟情","喜闻乐见","负荆请罪","三人成虎","河东狮吼","程门立雪","金戈铁马","笑逐颜开","千钧一发","纸上谈兵","风和日丽","邯郸学步","大器晚成","庖丁解牛","甜言蜜语","雷霆万钧","浮生若梦","大开眼界","汗牛充栋","百鸟朝凤","以德服人","白驹过隙","难兄难弟","鬼哭神嚎","声色犬马","指鹿为马","龙争虎斗","雾里看花","男大当婚","未雨绸缪","南辕北辙","三从四德","一丝不挂","高屋建瓴","阳春白雪","杯弓蛇影","闻鸡起舞","四面楚歌","登堂入室","张灯结彩","而立之年","饮鸩止渴","杏雨梨云","龙凤呈祥","勇往直前","左道旁门","莫衷一是","马踏飞燕","掩耳盗铃","大江东去","凿壁偷光","色厉内荏","花容月貌","越俎代庖","鳞次栉比","美轮美奂","缘木求鱼","再接再厉","马到成功","红颜知己","赤子之心","迫在眉睫","风流韵事","相形见绌","诸子百家","鬼迷心窍","星火燎原","画地为牢","岁寒三友","花花世界","纸醉金迷","狐假虎威","纵横捭阖","沧海桑田","不求甚解","暴殄天物","吃喝玩乐","乐不思蜀","身不由己","小家碧玉","文不加点","天马行空","人来人往","千方百计","天高地厚","万人空巷","争分夺秒","如火如荼","大智若愚","斗转星移","七情六欲","大禹治水","空穴来风","孟母三迁","绘声绘色","九五之尊","随心所欲","干将莫邪","相得益彰","借刀杀人","浪迹天涯","刚愎自用","镜花水月","黔驴技穷","肝胆相照","多多益善","叱咤风云","杞人忧天","作茧自缚","一飞冲天","殊途同归","风卷残云","因果报应","无可厚非","赶尽杀绝","天长地久","飞龙在天","桃之夭夭","南柯一梦","口是心非","江山如画","风华正茂","一帆风顺","一叶知秋","草船借箭","铁石心肠","望其项背","头晕目眩","大浪淘沙","纵横天下","有问必答","无为而治","釜底抽薪","吹毛求疵","好事多磨","空谷幽兰","悬梁刺股","白手起家","完璧归赵","忍俊不禁","沐猴而冠","白云苍狗","贼眉鼠眼","围魏救赵","烟雨蒙蒙","炙手可热","尸位素餐","出水芙蓉","礼仪之邦","一丘之貉","鹏程万里","叹为观止","韦编三绝","今生今世","草木皆兵","宁缺毋滥","回光返照","露水夫妻","讳莫如深","贻笑大方","紫气东来","万马奔腾","一诺千金","老马识途","五花大绑","捉襟见肘","瓜田李下","水漫金山","苦心孤诣","可见一斑","五湖四海","虚怀若谷","欲擒故纵","风声鹤唳","毛遂自荐","蛛丝马迹","中庸之道","迷途知返","自由自在","龙飞凤舞","树大根深","雨过天晴","乘风破浪","筚路蓝缕","朝三暮四","患得患失","君子好逑","鞭长莫及","竭泽而渔","飞黄腾达","囊萤映雪","飞蛾扑火","自怨自艾","风驰电掣","白马非马","退避三舍","三山五岳","称心如意","望梅止渴","茕茕孑立","振聋发聩","运筹帷幄","逃之夭夭","杯水车薪","有的放矢","矫枉过正","睚眦必报","姗姗来迟","一鸣惊人","孜孜不倦","一马平川","入木三分","沆瀣一气","天伦之乐","兄弟阋墙","藕断丝连","心猿意马","想入非非","盲人摸象","眉飞色舞","三教九流","高楼大厦","锲而不舍","过犹不及","狗尾续貂","斗酒学士","高山仰止","形影不离","小心翼翼","返璞归真","见贤思齐","按图索骥","枪林弹雨","桀骜不驯","遇人不淑","道貌岸然","名扬四海","虚与委蛇","门可罗雀","水落石出","不卑不亢","无法无天","拔苗助长","大快朵颐","因地制宜","单刀直入","时来运转","天方夜谭","一蹴而就","踌躇满志","战无不胜","插翅难飞","图穷匕见","鬼话连篇","亢龙有悔","望洋兴叹","爱屋及乌","惊鸿一瞥","风华绝代","名胜古迹","如履薄冰","持之以恒","潜移默化","昙花一现","巫山云雨","狡兔三窟","栉风沐雨","骇人听闻","断章取义","曲突徙薪","谢天谢地","脱颖而出","垂帘听政","一马当先","不耻下问","不以为然","春华秋实","欲盖弥彰","人琴俱亡","投鼠忌器","歧路亡羊","金风玉露","落花流水","春风化雨","心如刀割","锱铢必较","一叶障目","来历不明","名副其实","中流砥柱","绕梁三日","安步当车","放荡不羁","天衣无缝","自相矛盾","神机妙算","沧海一粟","冲锋陷阵","龙虎风云","言简意赅","九死一生","铁树开花","画龙点睛","风雨无阻","不耻下问","不以为然","春华秋实","欲盖弥彰","人琴俱亡","投鼠忌器","歧路亡羊","金风玉露","落花流水","春风化雨","心如刀割","锱铢必较","一叶障目","来历不明","名副其实","中流砥柱","绕梁三日","安步当车","放荡不羁","天衣无缝","自相矛盾","神机妙算","沧海一粟","冲锋陷阵","龙虎风云","言简意赅","九死一生","铁树开花","画龙点睛","风雨无阻","坐井观天","奇货可居","浮光掠影","牝鸡司晨","沽名钓誉","天作之合","甚嚣尘上","铩羽而归","劫后余生","泾渭分明","节哀顺变","有恃无恐","不绝如缕","马革裹尸","监守自盗","耳濡目染","金屋藏娇","不约而同","逐鹿中原","龙潭虎穴","江郎才尽","明日黄花","栩栩如生","人山人海","面面相觑","唇亡齿寒","知法犯法","相敬如宾","曾几何时","欢聚一堂","纷至沓来","李代桃僵","毛骨悚然","衣冠禽兽","有凤来仪","见微知著","旗鼓相当","无与伦比","摸金校尉","牛头马面","凤毛麟角","难得糊涂","衣香鬓影","马到功成","鸠占鹊巢","狭路相逢","春秋笔法","厉兵秣马","约法三章","豁然开朗","平步青云","步步为营","蝇营狗苟","心如止水","从善如流","殚精竭虑","十字路口","矢志不渝","九九归一","井底之蛙","居安思危","不一而足","周而复始","望穿秋水","秦晋之好","不落窠臼","司空见惯","怙恶不悛","百年好合","出神入化","身体力行","敬谢不敏","嗤之以鼻","天之骄子","贤妻良母","能说会道","进退维谷","甘之如饴","人心不古","颐指气使","墨守成规","左右逢源","回心转意","插科打诨","别来无恙","翩翩公子","穷兵黩武","舌战群儒","字字珠玑","义无反顾"]; 原文发布时间为:2018年05月23日原文作者:点亮LED 本文来源:开源中国 如需转载请联系原作者

优秀的个人博客,低调大师

大数据行业发展的九大痛点(个人观点)

前言 尽管在Hadoop与NoSQL部署方面做足了准备,同样的问题仍然一次又一次反复出现。现在业界是时候尽快搞定这些麻烦事了。 有时候一艘巨轮的侧方出现了破洞,但业界却决定坐等船体下沉、并把希望寄托在销售救生艇身上。 也有些时候,这些问题似乎并没到要闹出人命的地步——类似我家里浴室的状况,只有往一边拧龙头才会出水。过一阵子我可能会找机会修理一下,但事实上这个问题已经存在了12年之久了。 而在面对大数据业务时,我可以列出九个长久以来一直令人头痛的问题,时至今日它们依然存在着并困扰着无数用户。 分享之前我还是要推荐下我自己创建的大数据学习交流Qun531629188 无论是大牛还是想转行想学习的大学生 小编我都挺欢迎,今天的已经资讯上传到群文件,不定期分享干货, 包括我自己整理的一份最新的适合2018年学习的大数据教程,欢迎初学和进阶中的小伙伴。 大数据痛点一号:GPU编程仍未得到普及 CPU的使用成本仍然较为昂贵,至少与GPU相比要贵得多。如果我们能够面向GPU开发出更理想的执行标准以及更多表现出色的驱动程序,那么相信一个新的市场将由此诞生。就目前来讲,GPU的使用成本优势并没能得到很好的体现,这是因为我们难以针对其进行编程,而且几乎没办法在不建立特定模型的前提下完成这项任务。 这种情况类似于,有些人希望编写出类似于ODBC或者JDBC的代码来处理某些高强度工作,并说服AMD或者英伟达将业务着眼点放在显卡产品之外。假设我们原本已经习惯了使用Spark实现各类计算任务,而且压根不觉得这么做有什么问题; 但仿佛在一夜之间,其他人都开始构建所谓“GPGPU”集群,这自然会让我们有点措手不及之感。 不少技术人员都开始在这方面做出探索,但要想真正让成果实现市场化,我们至少需要搞定两大竞争对手——AMD以及英伟达,也许再加上英特尔。除非它们愿意联手合作,否则如果继续像现在这样把技术保密看作市场成功的实现途径,那么问题永远也找不到理想的答案。 大数据痛点二号: 多工作负载缩放 我们拥有Docker。我们拥有Yarn。我们还拥有Spark、Tez、MapReduce以及未来可能出现的一系列技术方案。我们还拥有多种资源池化实现工具,其中包含各类不同优先级及其它设定。如果大家选择部署一个Java war文件,则可以在PaaS上进行“自动伸缩”。但如果大家希望在Hadoop上实现同样的效果,那么情况就不太一样了。 再有,存储与处理体系之间的交互该如何处理?有时候大家需要以临时性方式对存储资源进行扩展与分发。我应该有能力运行自己的“月末统计”批量任务并将Docker镜像自动部署到任意指定位置。而在我的任务完成之后,系统应当对其进行反部署,并将资源重新分配给其它工作负载。应用程序或者工作负载应该根本不需要在这方面浪费太多精力。 但目前这些要求尚无法实现。我希望大家习惯了编写Chef方案与脚本,因为这是达到以上目标的惟一办法。 大数据痛点三号: NoSQL部署更令人头痛 为什么我已经能够利用ssh与sudo将镜像导入Linux设备、为其指定Ambari并安装像Hadoop这样复杂度极高的项目,但却仍然需要在MongoDB以及大部分其它数据库的部署工作中浪费时间与精力?当然,我也可以编写Chef自动化方案,但恕我仍对此无法认同。 大数据痛点四号:查询分析器/修复器 当初在使用JBoss的时候,我曾经对Hibernate以及后来的JPA/EJB3进行过大量调试。具体来讲,主要工作包括查看日志记录、找出存在n+1类查询的位置、将其纳入join并移除可能影响运行效果的糟糕缓存配置。 但有时候情况又完全相反:我们可以将每一套需要的表添加到系统当中,但其返回速度却慢得让人抓狂。有时候,我打算在复杂程度更高的系统之上查看Oracle Enterprise Manager及其分析结果,但返回的报告却完全是一堆胡言乱语——这意味着其中存在问题。不过我可以同时着眼于两套始终共同协作的表,并据此找到分析当中存在的规律。我甚至考虑过利用编程方式解决问题。 而现在,每次对NoSQL系统进行调整时,我都会发现上述问题以不同形式表现出来:要么是跳转次数太多、要么是查询太过复杂,有时候我们的索引无法与where子句(即范围合并)相匹配。简而言之,我们将大量精力投入到了糟糕或者复杂查询的优化当中,但除了开发者培训课程、我们似乎从来不会对这些查询本身提出质疑。这套系统似乎有种魔性,它同用户的关系类似于:“嘿,你发来了这些查询,我认为它们看起来应该像这样……” 好吧,我猜很多从业者都以完成这些本可以通过自动化方式实现的工作为生。必须承认,我很庆幸自己已经渡过了基层工作时期,再也不用为这些琐事烦恼了。 大数据痛点五号: 分布式代码优化 我估计Spark当中的大量小功能及小设定会带来第四点里提到的各类问题。在编译器方面,大家可以编写优化器来检测循环内的非依赖性操作,同时自动对其进行提取与并行化调整。我在分布式计算领域经常会见到这类情况。所谓“数据科学家”们编写出的Python代码相当垃圾,根本没办法有效进行问题分配,而且会造成大量不必要的内存浪费。在这种情况下,需要由技术从牛挺身而出,尝试理解前面那位“科学家”的想法并进行优化。 问题在于,上述状况几乎跟大家在编译原理书里看到的反而实例一模一样。我猜随着技术的不断发展,未来Zeppelin甚至是Spark本身会站出来帮助大家修复糟糕的代码,并保证其与集群顺畅协作。 大数据痛点六号:分布式名不副实 我得承认,我对Hadoop的第一印象就是在Hive当中输入select count(*) from somesmalltable。我觉得这种使用方式真的非常差劲。大家会发现其中存在问题,并意识到其分布效果并不理想。有些朋友甚至不必参考其它数据(例如行数)就能发现我们没办法实现负载分布。通常来讲,这些只是整体工作当中的一部分(例如查找表),但无论我们实际使用的是Hive、Spark、HDFS还是YARN,其都会首先假设所有问题都已经得到切实分发。其中部分工作需要尽可能避免被分发,因为这样能使其运行速度更快。最让我受不了的就是用select * from thousandrowtable这样的操作拖慢MapReduce任务的运行速度。 大数据痛点七号:机器学习映射 在具体实例当中,我们都能轻松分清集群化问题、聚类问题或者其它一些归类工作。但似乎没人愿意解决真正有难度的部分——对业务体系中的常见部分进行映射、描述问题并通过描述映射找到应当使用的具体算法。 除了金融行业之外,只有10%到30%的企业能够保持有不同于行业常规情况的特色——换言之,我们可以将销售、市场推广、库存、劳动力等因素映射至一套通用模型,而后描述出适合使用的算法。这项工作不仅会改变我们处理业务的方式,同时也能极大扩展市场的整体规模。我们可以将其视为一种面向大数据的设计模式,只不过其更多是在强调业务方面的内容。 大数据痛点八号:安全性 首先,为什么我们只能通过Kerberos实现单点登录?云Web环境之下根本没有类似于Kerberos的方案可用。 其次,厂商之间奇怪的竞争方式对Hadoop造成了极大的扭曲,而这对任何人都不是件好事。在涉及到基础性身份验证及授权层面时,我们不得不使用两套完全不同的堆栈,才能为Hadoop的全部组成部分提供安全性支持。加密方面的产品竞争我还可以理解(各类方案都在以更小、更快、更强为发展目标),但无论是选择Ranger、Sentry或者是其它什么方案,为什么我们就不能拥有一套足以涵盖全部Hadoop项目的验证机制?公平地讲,大数据领域目前的状况比NoSQL还要糟糕; 随便拉来一家宣称“我们热爱开源”的企业都能在自己“企业级”专用版本的LDAP集成部分当中塞进几百行开源代码。 大数据痛点九号:提取、转换与加载 提取、转换与加载(简称ETL)可以说是每个大数据项目当中悄无声息的预算杀手。我们都很清楚自己到底需要利用大数据技术做些什么,但相较于将注意力集中在业务需求身上,现在我们首先得搞定Flume、Oozie、Pig、Sqoop以及Kettle等等。之所以面临这样的情况,是因为我们的原始数据往往处于混乱的状态。但真正令人惊讶的是,没有哪家厂商愿意拿出一套无缝化处理方案来。虽然解决这类问题没办法让你拿到诺贝尔奖,但却能够切实帮助到广大大数据技术用户。

优秀的个人博客,低调大师

个人或是公司如何选择适合自己的云服务器?

近年来,国内云计算的快速发展催动了一个新时代的产生。云计算正不断渗透到各行各业,不管是大型企业还是中小型企业都在争相拥抱云。与此同时,企业内部的IT基础架构正在发生变化,云服务器作为这个时代的产物早已引起人们的关注。 云服务器又叫云计算服务器或云主机。云服务器使用了云计算技术,整合了数据中心三大核心要素:计算、网络与存储。云服务器基于集群服务器技术,虚拟出多个类似独立服务器的部分,具有很高的安全稳定性。 因为云服务器是新时代产物,大多数中小企业对其了解并不深刻,在选择过程中存在很多问题,可能会导致自己的业务在运行过程中出现故障。 对于中小企业来说,在选购云服务器时应该从自身需求出发,应该考虑以下问题: 从需求出发,你是否真的需要云服务器? 中小企业在选择购买云服务器之前,需要对自己的业务需求进行评估,看看自己是否真的需要使用云服务器。 通常情况下,云服务器提供了比传统物理服务器更高的性价比,能够支持企业实现快速分布式部署。如果你对这些方面有非常高的要求的话,可以考虑使用云服务器。 另外,根据云服务器自身的优势,对业务的弹性扩展能力有较高的要求,或者对系统高可用性以及对数据进行快速恢复需求的用户来说,云服务器也是其理想的选择。 云服务器支持的应用比较广泛,包括电子商务、企业网站、OA系统、企业ERP/CRM管理软件、论坛和SNS等等。 选购的云服务器是否具备了必要的功能? 中小企业在采购云服务器之前需要具备一些相关知识。比如云服务器能够实现哪些有别于传统物理服务器的功能? 较传统物理服务器来说,云服务器更具有安全性。因为云服务器具有防ARP攻击和MAC欺骗功能,可进行快照备份,保证数据永久不丢失。而且云服务器比传统的物理服务器更加可靠,因为其是基于服务器集群的,因此具有较高的硬件冗余,能大大降低故障发生率,而传统的服务器会因为资源占用过高或带宽不足时出现宕机情况。 另外,云服务器还具有故障自动迁移功能,如果一台云服务器出现故障,其上面的应用会自动迁移到其他云服务器上面,从而保证业务能够正常运行。 在数据备份方面,云服务器能实现快照备份,当主机出现故障时,能够一键恢复故障前的所有数据。 另一方面,企业用户可以根据自身需要实现实时在线增添服务器配置,一键轻松实现服务器扩展。而过去,企业则需要重新购置新的服务器,然后进行安装部署等。云服务器帮助企业免去了这些麻烦,轻松实现平滑升级。 你的云服务器提供商选对了吗? 中小企业在购买合适的云服务器时需要考虑到厂家这一重要因素,尽量选用知名、正规的云服务器提供商,同时要做到货比三家。 目前很多IT行业服务器巨头已经开始提供有质量保证的云计算产品。互联网企业、电子商务、论坛和社交等中小企业均可以根据不同需求选择合适自己的云服务器。 另外,不得不提的一点是服务商的售后服务情况。 最后,中小企业在云时代的业务发展迅速,因此在购买云服务器时既要考虑到目前运行的日常应用需求,又要立足于企业未来几年的业务发展趋势,避免因升级空间不足而造成性能瓶颈。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册