首页 文章 精选 留言 我的

精选列表

搜索[源码学习],共10000篇文章
优秀的个人博客,低调大师

Spark源码系列RDD详解【转】

1、什么是RDD? 上一章讲了Spark提交作业的过程,这一章我们要讲RDD。简单的讲,RDD就是Spark的input,知道input是啥吧,就是输入的数据。 RDD的全名是Resilient Distributed Dataset,意思是容错的分布式数据集,每一个RDD都会有5个特征:1、有一个分片列表。就是能被切分,和Hadoop一样的,能够切分的数据才能并行计算。2、有一个函数计算每一个分片,这里指的是下面会提到的compute函数。3、对其他的RDD的依赖列表,依赖还具体分为宽依赖和窄依赖,但并不是所有的RDD都有依赖。4、可选:key-value型的RDD是根据哈希来分区的,类似于mapreduce当中的Paritioner接口,控制key分到哪个reduce。5、可选:每一个分片的优先计算位置(preferred locations),比如HDFS的block的所在位置应该是优先计算的位置。对应着上面这几点,我们在RDD里面能找到这4个方法和1个属性,别着急,下面我们会慢慢展开说这5个东东。 //只计算一次 protecteddefgetPartitions:Array[Partition] //对一个分片进行计算,得出一个可遍历的结果 defcompute(split:Partition,context:TaskContext):Iterator[T] //只计算一次,计算RDD对父RDD的依赖 protecteddefgetDependencies:Seq[Dependency[_]]=deps //可选的,分区的方法,针对第4点,类似于mapreduce当中的Paritioner接口,控制key分到哪个reduce @transientvalpartitioner:Option[Partitioner]=None //可选的,指定优先位置,输入参数是split分片,输出结果是一组优先的节点位置 protecteddefgetPreferredLocations(split:Partition):Seq[String]=Nil 2、多种RDD之间的转换下面用一个实例讲解一下吧,就拿我们常用的一段代码来讲吧,然后会把我们常用的RDD都会讲到。 valhdfsFile=sc.textFile(args(1)) valflatMapRdd=hdfsFile.flatMap(s=>s.split("")) valfilterRdd=flatMapRdd.filter(_.length==2) valmapRdd=filterRdd.map(word=>(word,1)) valreduce=mapRdd.reduceByKey(_+_) 这里涉及到很多个RDD,textFile是一个HadoopRDD经过map后的MappredRDD,经过flatMap是一个FlatMappedRDD,经过filter方法之后生成了一个FilteredRDD,经过map函数之后,变成一个MappedRDD,通过隐式转换成 PairRDD,最后经过reduceByKey。 我们首先看textFile的这个方法,进入SparkContext这个方法,找到它。 deftextFile(path:String,minPartitions:Int=defaultMinPartitions):RDD[String]={ hadoopFile(path,classOf[TextInputFormat],classOf[LongWritable],classOf[Text],minPartitions).map(pair=>pair._2.toString) } 看它的输入参数,path,TextInputFormat,LongWritable,Text,同志们联想到什么?写过mapreduce的童鞋都应该知道哈。1、hdfs的地址2、InputFormat的类型3、Mapper的第一个类型4、Mapper的第二类型这就不难理解为什么立马就对hadoopFile后面加了一个map方法,取pair的第二个参数了,最后在shell里面我们看到它是一个MappredRDD了。那么现在如果大家要用的不是textFile,而是一个别的hadoop文件类型,大家会不会使用hadoopFile来得到自己要得到的类型呢,不要告诉我不会哈,不会的赶紧回去复习mapreduce。言归正传,默认的defaultMinPartitions的2太小了,我们用的时候还是设置大一点吧。2.1 HadoopRDD 我们继续追杀下去,看看hadoopFile方法,里面我们看到它做了3个操作。 1、把hadoop的配置文件保存到广播变量里。 2、设置路径的方法3、new了一个HadoopRDD返回好,我们接下去看看HadoopRDD这个类吧,我们重点看看它的getPartitions、compute、getPreferredLocations。先看getPartitions,它的核心代码如下: valinputSplits=inputFormat.getSplits(jobConf,minPartitions) valarray=newArray[Partition](inputSplits.size) for(i<-0untilinputSplits.size){ array(i)=newHadoopPartition(id,i,inputSplits(i)) } 它调用的是inputFormat自带的getSplits方法来计算分片,然后把分片HadoopPartition包装到到array里面返回。 这里顺便顺带提一下,因为1.0又出来一个NewHadoopRDD,它使用的是mapreduce新api的inputformat,getSplits就不要有minPartitions了,别的逻辑都是一样的,只是使用的类有点区别。 我们接下来看compute方法,它的输入值是一个Partition,返回是一个Iterator[(K, V)]类型的数据,这里面我们只需要关注2点即可。1、把Partition转成HadoopPartition,然后通过InputSplit创建一个RecordReader2、重写Iterator的getNext方法,通过创建的reader调用next方法读取下一个值。 //转换成HadoopPartition valsplit=theSplit.asInstanceOf[HadoopPartition] logInfo("Inputsplit:"+split.inputSplit) varreader:RecordReader[K,V]=null valjobConf=getJobConf() valinputFormat=getInputFormat(jobConf) context.stageId,theSplit.index,context.attemptId.toInt,jobConf) //通过Inputform的getRecordReader来创建这个InputSpit的Reader reader=inputFormat.getRecordReader(split.inputSplit.value,jobConf,Reporter.NULL) //调用Reader的next方法 valkey:K=reader.createKey() valvalue:V=reader.createValue() overridedefgetNext()={ try{ finished=!reader.next(key,value) }catch{ caseeof:EOFException=> finished=true } (key,value) } 从这里我们可以看得出来compute方法是通过分片来获得Iterator接口,以遍历分片的数据。getPreferredLocations方法就更简单了,直接调用InputSplit的getLocations方法获得所在的位置。2.2 依赖下面我们看RDD里面的map方法def map[U: ClassTag](f: T => U): RDD[U] = new MappedRDD(this, sc.clean(f))直接new了一个MappedRDD,还把匿名函数f处理了再传进去,我们继续追杀到MappedRDD。 private[spark] classMappedRDD[U:ClassTag,T:ClassTag](prev:RDD[T],f:T=>U) extendsRDD[U](prev){ overridedefgetPartitions:Array[Partition]=firstParent[T].partitions overridedefcompute(split:Partition,context:TaskContext)= firstParent[T].iterator(split,context).map(f) } MappedRDD把getPartitions和compute给重写了,而且都用到了firstParent[T],这个firstParent是何须人也?我们可以先点击进入RDD[U](prev)这个构造函数里面去。def this(@transient oneParent: RDD[_]) = this(oneParent.context , List(new OneToOneDependency(oneParent)))就这样你会发现它把RDD复制给了deps,HadoopRDD成了MappedRDD的父依赖了,这个OneToOneDependency是一个窄依赖,子RDD直接依赖于父RDD,继续看firstParent。 protected[spark]deffirstParent[U:ClassTag]={ dependencies.head.rdd.asInstanceOf[RDD[U]] } 由此我们可以得出两个结论:1、getPartitions直接沿用了父RDD的分片信息2、compute函数是在父RDD遍历每一行数据时套一个匿名函数f进行处理好吧,现在我们可以理解compute函数真正是在干嘛的了它的两个显著作用:1、在没有依赖的条件下,根据分片的信息生成遍历数据的Iterable接口2、在有前置依赖的条件下,在父RDD的Iterable接口上给遍历每个元素的时候再套上一个方法我们看看点击进入map(f)的方法进去看一下 defmap[B](f:A=>B):Iterator[B]=newAbstractIterator[B]{ defhasNext=self.hasNext defnext()=f(self.next()) } 看黄色的位置,看它的next函数,不得不说,写得真的很妙!我们接着看RDD的flatMap方法,你会发现它和map函数几乎没什么区别,只是RDD变成了FlatMappedRDD,但是flatMap和map的效果还是差别挺大的。比如((1,2),(3,4)), 如果是调用了flatMap函数,我们访问到的就是(1,2,3,4)4个元素;如果是map的话,我们访问到的就是(1,2),(3,4)两个元素。有兴趣的可以去看看FlatMappedRDD和FilteredRDD这里就不讲了,和MappedRDD类似。2.3 reduceByKey前面的RDD转换都简单,可是到了reduceByKey可就不简单了哦,因为这里有一个同相同key的内容聚合的一个过程,所以它是最复杂的那一类。那reduceByKey这个方法在哪里呢,它在PairRDDFunctions里面,这是个隐式转换,所以比较隐蔽哦,你在RDD里面是找不到的。 defreduceByKey(partitioner:Partitioner,func:(V,V)=>V):RDD[(K,V)]={ combineByKey[V]((v:V)=>v,func,func,partitioner) } 它调用的是combineByKey方法,过程过程蛮复杂的,折叠起来,喜欢看的人看看吧。 defcombineByKey[C](createCombiner:V=>C, mergeValue:(C,V)=>C, mergeCombiners:(C,C)=>C, partitioner:Partitioner, mapSideCombine:Boolean=true, serializer:Serializer=null):RDD[(K,C)]={ valaggregator=newAggregator[K,V,C](createCombiner,mergeValue,mergeCombiners) if(self.partitioner==Some(partitioner)){ //一般的RDD的partitioner是None,这个条件不成立,即使成立只需要对这个数据做一次按key合并value的操作即可 self.mapPartitionsWithContext((context,iter)=>{ newInterruptibleIterator(context,aggregator.combineValuesByKey(iter,context)) },preservesPartitioning=true) }elseif(mapSideCombine){ //默认是走的这个方法,需要map端的combinber. valcombined=self.mapPartitionsWithContext((context,iter)=>{ aggregator.combineValuesByKey(iter,context) },preservesPartitioning=true) valpartitioned=newShuffledRDD[K,C,(K,C)](combined,partitioner) .setSerializer(serializer) partitioned.mapPartitionsWithContext((context,iter)=>{ newInterruptibleIterator(context,aggregator.combineCombinersByKey(iter,context)) },preservesPartitioning=true) }else{ //不需要map端的combine,直接就来shuffle valvalues=newShuffledRDD[K,V,(K,V)](self,partitioner).setSerializer(serializer) values.mapPartitionsWithContext((context,iter)=>{ newInterruptibleIterator(context,aggregator.combineValuesByKey(iter,context)) },preservesPartitioning=true) } } 按照一个比较标准的流程来看的话,应该是走的中间的这条路径,它干了三件事:1、给每个分片的数据在外面套一个combineValuesByKey方法的MapPartitionsRDD。2、用MapPartitionsRDD来new了一个ShuffledRDD出来。3、对ShuffledRDD做一次combineCombinersByKey。 下面我们先看MapPartitionsRDD,我把和别的RDD有别的两行给拿出来了,很明显的区别,f方法是套在iterator的外边,这样才能对iterator的所有数据做一个合并。 overridevalpartitioner=if(preservesPartitioning)firstParent[T].partitionerelseNone overridedefcompute(split:Partition,context:TaskContext)= f(context,split.index,firstParent[T].iterator(split,context)) } 接下来我们看Aggregator的combineValuesByKey的方法吧。 defcombineValuesByKey(iter:Iterator[_{ if(hadValue)mergeValue(oldValue,kv._2)elsecreateCombiner(kv._2) } //用map来去重,用update方法来更新值,如果没值的时候,返回值,如果有值的时候,通过mergeValue方法来合并 //mergeValue方法就是我们在reduceByKey里面写的那个匿名函数,在这里就是(_+_) while(iter.hasNext){ kv=iter.next() combiners.changeValue(kv._1,update) } combiners.iterator }else{ //用了一个外部排序的map来去重,就不停的往里面插入值即可,基本原理和上面的差不多,区别在于需要外部排序 valcombiners=newExternalAppendOnlyMap[K,V,C](createCombiner,mergeValue,mergeCombiners) while(iter.hasNext){ val(k,v)=iter.next() combiners.insert(k,v) } combiners.iterator } 这个就是一个很典型的按照key来做合并的方法了,我们继续看ShuffledRDD吧。ShuffledRDD和之前的RDD很明显的特征是1、它的依赖传了一个Nil(空列表)进去,表示它没有依赖。2、它的compute计算方式比较特别,这个在之后的文章说,过程比较复杂。3、它的分片默认是采用HashPartitioner,数量和前面的RDD的分片数量一样,也可以不一样,我们可以在reduceByKey的时候多传一个分片数量即可。在new完ShuffledRDD之后又来了一遍mapPartitionsWithContext,不过调用的匿名函数变成了combineCombinersByKey。 combineCombinersByKey和combineValuesByKey的逻辑基本相同,只是输入输出的类型有区别。combineCombinersByKey只是做单纯的合并,不会对输入输出的类型进行改变,combineValuesByKey会把iter[K, V]的V值变成iter[K, C]。 caseclassAggregator[K,V,C]( createCombiner:V=>C, mergeValue:(C,V)=>C, mergeCombiners:(C,C)=>C) ...... } 这个方法会根据我们传进去的匿名方法的参数的类型做一个自动转换。 到这里,作业都没有真正执行,只是将RDD各种嵌套,我们通过RDD的id和类型的变化观测到这一点,RDD[1]->RDD[2]->RDD[3]...... 3、其它RDD平常我们除了从hdfs上面取数据之后,我们还可能从数据库里面取数据,那怎么办呢?没关系,有个JdbcRDD! valrdd=newJdbcRDD( sc, ()=>{DriverManager.getConnection("jdbc:derby:target/JdbcRDDSuiteDb")}, "SELECTDATAFROMFOOWHERE?<=IDANDID<=?", 1,100,3, (r:ResultSet)=>{r.getInt(1)} ).cache() 前几个参数大家都懂,我们重点说一下后面1, 100, 3是咋回事?在这个JdbcRDD里面它默认我们是会按照一个long类型的字段对数据进行切分,(1,100)分别是最小值和最大值,3是分片的数量。比如我们要一次查ID为1-1000,000的的用户,分成10个分片,我们就填(1, 1000,000, 10)即可,在sql语句里面还必须有"? <= ID AND ID <= ?"的句式,别尝试着自己造句哦!最后是怎么处理ResultSet的方法,自己爱怎么处理怎么处理去吧。不过确实觉着用得不方便的可以自己重写一个RDD。作者:岑玉海

优秀的个人博客,低调大师

源码阅读之ArrayList实现细节

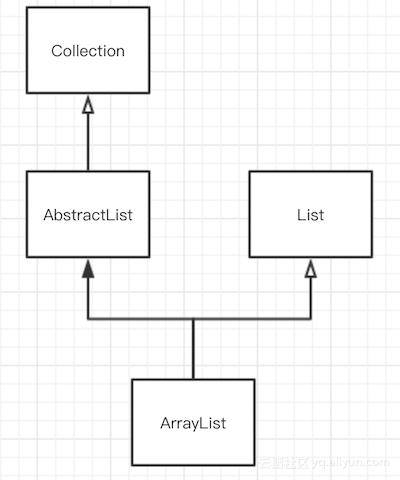
0x00 描述 ArrayList 可以说是 Java 程序猿最为常用的一种数据结构了。ArrayList 是通过数组实现的,容量可以自增的线性表。而数组的优点是计算机可以通过下标计算访问地址,所以访问元素的速度是很快的,时间复杂度为O(1);但数组并不擅长插入和删除操作,这些操作的时间复杂度是O(n)。因此 ArrayList 继承了数组这些特点。 继承关系 ArrayList 继承于 AbstractList 并实现了 List 、RandomAccess、Cloneable 和 Serializable 接口。 而 AbstractList 是继承于 Collection 接口。因此简单的关系图可以表达为 重要属性 elementData 这个是存放数据的 Object 数组 size 记录当前数组元素的个数 modCount 用于记录修改次数,例如增加、删除等操作时此变量会自增。当这个变量异常变化时,会抛出 ConcurrentModificationException 构造方法 public ArrayList() { this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA; } 默认构造函数初始化 elementData 大小为10 空数组。 public ArrayList(int initialCapacity) { if (initialCapacity > 0) { this.elementData = new Object[initialCapacity]; } else if (initialCapacity == 0) { this.elementData = EMPTY_ELEMENTDATA; } else { throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); } } 此方法通过一个 initialCapacity 变量对数组进行初始化。当传入的 initialCapacity 大于0时,elementData就是初始化为大小为 initialCapacity 的空数组;否则就是初始化为大小为0的空数组。 public ArrayList(Collection<? extends E> c) { elementData = c.toArray(); if ((size = elementData.length) != 0) { // c.toArray might (incorrectly) not return Object[](see 6260652) if (elementData.getClass() != Object[].class) elementData = Arrays.copyOf(elementData, size, Object[].class); } else { // replace with empty array. this.elementData = EMPTY_ELEMENTDATA; } } 这个方法是通过一个 Collection 对象进行初始化的。这里调用了 Arrays.copyOf 方法将数组元素进行拷贝,并返回一个新的数组。后文会详细解析这个方法。 0x01 常用方法 add(E e) 给 ArrayList 添加一个元素 public boolean add(E e) { ensureCapacityInternal(size + 1); // Increments modCount!! elementData[size++] = e; return true; } 添加元素之前,调用了 ensureCapacityInternal 方法,确保 elementData 数组有足够的空间。然后数组后面添加一个元素,并把元素个数 size 的值加1。 private void ensureCapacityInternal(int minCapacity) { if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity); } ensureExplicitCapacity(minCapacity); } 在 ensureCapacityInternal 中先判断 elementData 是否为空数组,如果是,则取 DEFAULT_CAPACITY 与 minCapacity 的最大值作为数组的最小容量。 然后再执行 ensureExplicitCapacity 方法。 private void ensureExplicitCapacity(int minCapacity) { modCount++; // overflow-conscious code if (minCapacity - elementData.length > 0) grow(minCapacity); } 先把 modCount 加1,表示对该列表进行了一次操作。 minCapacity 表示目前需要的容量大小。如果它大于目前 elementData 的容量大小,那么就会执行 grow 方法增加数组容量。 private void grow(int minCapacity) { // overflow-conscious code int oldCapacity = elementData.length; int newCapacity = oldCapacity + (oldCapacity >> 1);//右移1位操作相当于除2 if (newCapacity - minCapacity < 0) newCapacity = minCapacity; if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); // minCapacity is usually close to size, so this is a win: elementData = Arrays.copyOf(elementData, newCapacity); } 该方法的逻辑是 先获取到 newCapacity ,它是原来容量大小的1.5倍 如果需要的容量大小 minCapacity 大于原来容量的1.5,那么 newCapacity 就取 minCapacity 如果 newCapacity 还大于最大的容量,那么就执行 hugeCapacity 来计算得到容量大小 最后调用 Arrays.copyOf 方法把 elementData 拷贝到一个新的数组中,这个新数组大小为 newCapacity private static int hugeCapacity(int minCapacity) { if (minCapacity < 0) // overflow throw new OutOfMemoryError(); return (minCapacity > MAX_ARRAY_SIZE) ? Integer.MAX_VALUE : MAX_ARRAY_SIZE; } 因此在调用 add 方法时,如果当前数组 elementData 的容量不够时,就会调用扩容的 grow 方法,把数组扩大为原来的1.5倍的大小。 add(int index, E element) 在指定的 index 位置上添加一个元素 public void add(int index, E element) { if (index > size || index < 0) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); ensureCapacityInternal(size + 1); // Increments modCount!! System.arraycopy(elementData, index, elementData, index + 1, size - index); elementData[index] = element; size++; } 通过上面的 add 方法的走读,这个方法就很好理解了。 先对 index 参数的有效性进行判断; 然后执行 ensureCapacityInternal 确保数组的容量大小是足够的,此时 modCount 也会自增; 再执行 System.arraycopy 方法把数组元素从 index 的位置后移1位;(System.arraycopy 函数后文还会讲到) 最后在 index 位置上赋值,并把 size 加 1。 addAll(Collection<? extends E> c) public boolean addAll(Collection<? extends E> c) { Object[] a = c.toArray(); int numNew = a.length; ensureCapacityInternal(size + numNew); // Increments modCount System.arraycopy(a, 0, elementData, size, numNew); size += numNew; return numNew != 0; } addAll 方法把一个 Collection 对象添加到列表中来。 它会先把 Collection 对象通过 toArray 方法转化为数组,然后再调用 System.arraycopy 进行数据的移动。 addAll(int index, Collection<? extends E> c) public boolean addAll(int index, Collection<? extends E> c) { if (index > size || index < 0) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); Object[] a = c.toArray(); int numNew = a.length; ensureCapacityInternal(size + numNew); // Increments modCount int numMoved = size - index; if (numMoved > 0) System.arraycopy(elementData, index, elementData, index + numNew, numMoved); System.arraycopy(a, 0, elementData, index, numNew); size += numNew; return numNew != 0; } 在 index 位置上添加一个列表 它与上面 addAll 方法的区别就是先从 index 开始移动 numNew 个位置,即空出 numNew 个位置。 然后再空出的 numNew 位置上添加元素。 remove(int index) 删除指定 index 位置上的元素 public E remove(int index) { if (index >= size) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); modCount++; E oldValue = (E) elementData[index]; int numMoved = size - index - 1; if (numMoved > 0) System.arraycopy(elementData, index+1, elementData, index, numMoved); elementData[--size] = null; // clear to let GC do its work return oldValue; } 执行流程为 检查 index 有效性,无效则抛出 IndexOutOfBoundsException 异常 modCount 自增 通过 index 下标取出元素 计算 index 后面需要移动的元素个数 通过 System.arraycopy 将 index 后面的元素都往前移动1位 最后把末尾元素置位 null,并把 size 的值减 1。 remove(Object o) 通过一个元素对象进行删除 public boolean remove(Object o) { if (o == null) { for (int index = 0; index < size; index++) if (elementData[index] == null) { fastRemove(index); return true; } } else { for (int index = 0; index < size; index++) if (o.equals(elementData[index])) { fastRemove(index); return true; } } return false; } 当传一个元素对象进行删除操作时,需要遍历数组,找到该元素在列表中的位置 index; 然后通过 fastRemove 方法进行删除。 private void fastRemove(int index) { modCount++; int numMoved = size - index - 1; if (numMoved > 0) System.arraycopy(elementData, index+1, elementData, index, numMoved); elementData[--size] = null; // clear to let GC do its work } clear() 清空列表 public void clear() { modCount++; // clear to let GC do its work for (int i = 0; i < size; i++) elementData[i] = null; size = 0; } subList(int fromIndex, int toIndex) 获取子列表 public List<E> subList(int fromIndex, int toIndex) { subListRangeCheck(fromIndex, toIndex, size); return new SubList(this, 0, fromIndex, toIndex); } static void subListRangeCheck(int fromIndex, int toIndex, int size) { if (fromIndex < 0) throw new IndexOutOfBoundsException("fromIndex = " + fromIndex); if (toIndex > size) throw new IndexOutOfBoundsException("toIndex = " + toIndex); if (fromIndex > toIndex) throw new IllegalArgumentException("fromIndex(" + fromIndex +") > toIndex(" + toIndex + ")"); } 首先检查下标是否正确,然后构造一个 SubList 对象,这是一个内部类。 SubList 也是继承于 AbstractList。 private class SubList extends AbstractList<E> implements RandomAccess { private final AbstractList<E> parent; private final int parentOffset; private final int offset; int size; SubList(AbstractList<E> parent, int offset, int fromIndex, int toIndex) { this.parent = parent; this.parentOffset = fromIndex; this.offset = offset + fromIndex; this.size = toIndex - fromIndex; this.modCount = ArrayList.this.modCount; } public E set(int index, E e) { if (index < 0 || index >= this.size) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); if (ArrayList.this.modCount != this.modCount) throw new ConcurrentModificationException(); E oldValue = (E) ArrayList.this.elementData[offset + index]; ArrayList.this.elementData[offset + index] = e; return oldValue; } public E get(int index) { if (index < 0 || index >= this.size) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); if (ArrayList.this.modCount != this.modCount) throw new ConcurrentModificationException(); return (E) ArrayList.this.elementData[offset + index]; } ... public void add(int index, E e) { if (index < 0 || index > this.size) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); if (ArrayList.this.modCount != this.modCount) throw new ConcurrentModificationException(); parent.add(parentOffset + index, e); this.modCount = parent.modCount; this.size++; } public E remove(int index) { if (index < 0 || index >= this.size) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); if (ArrayList.this.modCount != this.modCount) throw new ConcurrentModificationException(); E result = parent.remove(parentOffset + index); this.modCount = parent.modCount; this.size--; return result; } ... public boolean addAll(Collection<? extends E> c) { return addAll(this.size, c); } public boolean addAll(int index, Collection<? extends E> c) { if (index < 0 || index > this.size) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); int cSize = c.size(); if (cSize==0) return false; if (ArrayList.this.modCount != this.modCount) throw new ConcurrentModificationException(); parent.addAll(parentOffset + index, c); this.modCount = parent.modCount; this.size += cSize; return true; } ... } SubList 构造方法需要一个父列表。在获取、添加、删除元素的方法中实际上都是调用父列表中的方法。 不过这些操作的方法中会判断 modCount 的值是否已经变化,如果异常改变了,那么就会抛出 ConcurrentModificationException 异常。 forEach(Consumer<? super E> action) 遍历列表元素 public void forEach(Consumer<? super E> action) { Objects.requireNonNull(action); final int expectedModCount = modCount; @SuppressWarnings("unchecked") final E[] elementData = (E[]) this.elementData; final int size = this.size; for (int i=0; modCount == expectedModCount && i < size; i++) { action.accept(elementData[i]); } // Android-note: // Iterator will not throw a CME if we add something while iterating over the *last* element // forEach will throw a CME in this case. if (modCount != expectedModCount) { throw new ConcurrentModificationException(); } } 同样地,此方法中如果 modCount 被异常修改了(例如在其他线程中执行了 add 方法)那么就会抛出 ConcurrentModificationException 异常。 iterator() 获取遍历器 public Iterator<E> iterator() { return new Itr(); } Itr 是一个内部类,实现了 Iterator 接口。 private class Itr implements Iterator<E> { // Android-changed: Add "limit" field to detect end of iteration. // The "limit" of this iterator. This is the size of the list at the time the // iterator was created. Adding & removing elements will invalidate the iteration // anyway (and cause next() to throw) so saving this value will guarantee that the // value of hasNext() remains stable and won't flap between true and false when elements // are added and removed from the list. protected int limit = ArrayList.this.size; int cursor; // index of next element to return int lastRet = -1; // index of last element returned; -1 if no such int expectedModCount = modCount; public boolean hasNext() { return cursor < limit; } @SuppressWarnings("unchecked") public E next() { if (modCount != expectedModCount) throw new ConcurrentModificationException(); int i = cursor; if (i >= limit) throw new NoSuchElementException(); Object[] elementData = ArrayList.this.elementData; if (i >= elementData.length) throw new ConcurrentModificationException(); cursor = i + 1; return (E) elementData[lastRet = i]; } public void remove() { if (lastRet < 0) throw new IllegalStateException(); if (modCount != expectedModCount) throw new ConcurrentModificationException(); try { ArrayList.this.remove(lastRet); cursor = lastRet; lastRet = -1; expectedModCount = modCount; limit--; } catch (IndexOutOfBoundsException ex) { throw new ConcurrentModificationException(); } } ... } 该类中 cursor 属性记录了当前迭代的位置,每调用一次 next 方法都会加 1,lastRet 则记录了上一次的元素位置。 remove 方法则是通过调用外部类的 remove 方法来实现的。 以上两个方法中也需要注意 ConcurrentModificationException 异常的发生。 contains(Object o) 检测是否包含元素 public boolean contains(Object o) { return indexOf(o) >= 0; } public int indexOf(Object o) { if (o == null) { for (int i = 0; i < size; i++) if (elementData[i]==null) return i; } else { for (int i = 0; i < size; i++) if (o.equals(elementData[i])) return i; } return -1; } 可以看出要检测一个元素是否在列表中,是通过遍历来实现的。 System.arraycopy public static native void arraycopy(Object src, int srcPos, Object dest, int destPos,int length); 这是数组拷贝函数,是 native 函数,它经过虚拟机优化的,效率比较高。在 ArrayList 中移动元素就是通过这个方法。 Arrays.copyOf public static <T> T[] copyOf(T[] original, int newLength) { return (T[]) copyOf(original, newLength, original.getClass()); } public static <T,U> T[] copyOf(U[] original, int newLength, Class<? extends T[]> newType) { @SuppressWarnings("unchecked") T[] copy = ((Object)newType == (Object)Object[].class) ? (T[]) new Object[newLength] : (T[]) Array.newInstance(newType.getComponentType(), newLength); System.arraycopy(original, 0, copy, 0, Math.min(original.length, newLength)); return copy; } 可以看出 copyOf 函数最终调用的是 System.arraycopy 方法。本文中 grow 方法就是调用 copyOf 来实现扩容的。 0x02 总结 ArrayList 是基于数组实现的线性表,它支持自动扩容,每次增加原来容量的1.5倍。 通过下标获取元素操作效率高,而删除和插入操作则需要移动元素,效率不高。 remove 函数通过对象删除元素时需要遍历列表,而通过下标 index 删除元素比通过对象删除元素的效率要高。 containts 与 clear方法需要遍历。 subList 获取到子列表,对子列表的修改同样也会修改父列表。 ArrayList 没有同步锁,在多线程操作时需要注意 ConcurrentModificationException 异常。 如果在同一线程中对 ArrayList 操作时引起 modCount 异常改变时,也要注意 ConcurrentModificationException ,这时候要检查代码逻辑问题。

优秀的个人博客,低调大师

Java多线程——FutureTask源码解析

一个很常见的多线程案例是,我们安排主线程作为分配任务和汇总的一方,然后将计算工作切分为多个子任务,安排多个线程去计算,最后所有的计算结果由主线程进行汇总。比如,归并排序,字符频率的统计等等。 我们知道Runnable是不返回计算结果的,如果想利用多线程的话,只能存储到一个实例的内部变量里面进行交互,但存在一个问题,如何判断是否已经计算完成了。用Thread.join是一个方案,但是我们只能依次等待一个线程结束后处理一个线程,如果线程1恰好特别慢,则后续已经完成的线程不能被及时处理。我们希望能够获知线程的执行状态,发现哪个线程处理完就先统计它的计算结果。可以考虑使用Callable和FutureTask来完成。 先说Callable它是一个功能接口,它只有一个方法V call(),计算一个结果,失败的话抛出一个异常。和Runnable不同的是,它不能直接交给Thread来执行,所以需要一个别的类来封装它与Runnable,这个类就是FutureTask。FutureTask是一个类,继承了RunnableFuture,而RunnableFuture是一个多继承接口,它继承了Runnable和 Future,所以FutureTask是可以作为实现了Runnable的实例交给Thread执行。 从内部变量来看,含有一个下层Callable实例,一个状态表示,一个返回结果,以及对运行线程的记录 /** * 任务的运行状态,最初是NEW。运行状态只在set, setException和cancel方法中过度到最终状态。 * 在完成过程中,状态可能发生转移到COMPLETING(在设置结果时)或者INTERRUPTING(仅当中断运行来满足cancel(true)时)。 * 从这些中间状态转移到最终状态使用成本更低有序/懒惰写入,因为值是唯一的且之后不能再修改。 * * Possible state transitions: * NEW -> COMPLETING -> NORMAL * NEW -> COMPLETING -> EXCEPTIONAL * NEW -> CANCELLED * NEW -> INTERRUPTING -> INTERRUPTED */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; /** 下层的callable,运行后为null */ private Callable<V> callable; /** get()操作返回的结果或者抛出的异常*/ private Object outcome; // 不是volatile,由reads/writes状态来保护 /** 运行callable的线程,在run()通过CAS修改*/ private volatile Thread runner; /** 等待线程的Treiber堆栈 */ private volatile WaitNode waiters; 构造函数 构造函数总共有两种重载,第一种直接给出Callable实例 public FutureTask(Callable<V> callable) { if (callable == null) throw new NullPointerException(); this.callable = callable; this.state = NEW; // 确保callable的可见性 } 第二种,给出Runnable实例和期望的返回结果,如果Runnable实例运行成功则返回的是result public FutureTask(Runnable runnable, V result) { this.callable = Executors.callable(runnable, result);//创建一个callable this.state = NEW; // 确保callable的可见性 } run run方法是Thread运行FutureTask内任务的接口。首先,根据最上方的进入条件可以看出,只有成功竞争到修改runnerOffset成功的线程才能执行后续方法,而搜索整个类文件,可以发现只有在run结束后才会重置为null,所以同一时间只能有一个线程执行run方法成功。然后要检查state和callable的状态,因为run会将它们修改。调用callable.call方法获取返回结果,成功的话设置结果,失败的话设置返回结果为异常。无论是否执行成功,runner会被重置为null。 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return;//状态必须是NEW且修改执行线程成功,否则直接返回,避免被多个线程同时执行 try { Callable<V> c = callable; if (c != null && state == NEW) { V result; boolean ran; try { result = c.call();//调用callable.call方法获取返回结果 ran = true;//执行成功 } catch (Throwable ex) { result = null; ran = false;//执行失败 setException(ex);//设置返回异常并唤醒等待线程解除阻塞 } if (ran) set(result);//设置结果 } } finally { //runner直到状态设置完成不能为null来避免并发调用run() runner = null; //在将runner设置为null后需要重新读取state避免漏掉中断 int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } set方法先修改state为COMPLETING,然后将outcome设置为刚才计算出来的结果,最后设置state为NORMAL,并调用finishCompletion。这个方法移除并通知所有等待的线程解除阻塞,调用done(),并将callable设为null。done方法默认是什么也不做。 protected void set(V v) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // 最终状态 finishCompletion();//唤醒等待线程,将callable设为null } } private void finishCompletion() { // assert state > COMPLETING; for (WaitNode q; (q = waiters) != null;) { if (UNSAFE.compareAndSwapObject(this, waitersOffset, q, null)) { for (;;) { Thread t = q.thread; if (t != null) { q.thread = null; LockSupport.unpark(t);//如果线程被park阻塞,解除阻塞 } WaitNode next = q.next; if (next == null) break; q.next = null; // 取消连接帮助gc q = next; } break; } } done();//未重写时什么也不做 callable = null; // to reduce footprint减少覆盖区 } setException跟set逻辑上基本一样,除了设置返回结果是Throwable对象 protected void setException(Throwable t) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) {//修改状态 outcome = t;//结果为Throwable UNSAFE.putOrderedInt(this, stateOffset, EXCEPTIONAL); // 最终状态 finishCompletion(); } } get get方法如果FutureTask已经执行完成则返回结果,否则会等待并阻止线程调度。等待时长可以输入,单位为纳秒,不输入为不限时等待,限时等待超时仍然没有完成会抛出异常。 public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) s = awaitDone(false, 0L);//等待完成 return report(s);//检查时返回结果还是抛出异常 } public V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { if (unit == null) throw new NullPointerException(); int s = state; if (s <= COMPLETING && (s = awaitDone(true, unit.toNanos(timeout))) <= COMPLETING)//限时等待完成 throw new TimeoutException(); return report(s); } awaitDone这个方法会阻塞当前线程(get方法的调用线程)的调度并增加等待结点,阻塞时长根据输入的时间长度决定。如果执行Callable任务的线程完成了运行或者被中断,则会解除栈中等待结点对应线程的阻塞。然后会根据执行结果决定是否要抛出异常还是返回执行完成的结果。 private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false;//是否完成入栈 for (;;) { if (Thread.interrupted()) {//检查线程是否已经被中断 removeWaiter(q);//移除被中断的等待结点 throw new InterruptedException(); } int s = state; if (s > COMPLETING) {//已经完成 if (q != null) q.thread = null;//移除等待 return s; } else if (s == COMPLETING) // cannot time out yet还没有超时 Thread.yield();//已经在赋值,所以只需让出时间片等待赋值完成 //下方都是还在没有完成call方法的情况 else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q);//q加入到栈的最前方 else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) {//超时了 removeWaiter(q);//移除超时的等待结点 return state; } LockSupport.parkNanos(this, nanos);//阻塞当前线程nanos纳秒 } else LockSupport.park(this);//阻塞当前线程 } } cancel cancel输入的参数表示如果当前还在运行中是否要中断执行线程,如果输入参数是false则只有线程已经执行完成或者抛出异常或者已经被中断时可以把状态修改为CANCELLED,如果是true则会中断线程并将状态改为INTERRUPTED。所以,cancel在该任务已经结束或者已被取消,或者竞争修改状态失败时都会失败。如果中断成功,会释放所有被阻塞的等待线程。 public boolean cancel(boolean mayInterruptIfRunning) { if (!(state == NEW && UNSAFE.compareAndSwapInt(this, stateOffset, NEW, mayInterruptIfRunning ? INTERRUPTING : CANCELLED))) return false;//已经完成或者被取消或者竞争取消失败返回false try { // in case call to interrupt throws exception if (mayInterruptIfRunning) { try { Thread t = runner; if (t != null) t.interrupt(); } finally { // final state UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); } } } finally { finishCompletion(); } return true; } 状态检查 非常简单的两个方法。因为CANCELLED是state中最大的,所以只有cancel方法成功才会是这种状态。而isDone只要不是还在运行或者还没有被执行就是返回true。 public boolean isCancelled() { return state >= CANCELLED; } public boolean isDone() { return state != NEW; } 简单的使用示例 public class CallableTest implements Callable<Integer>{ private int start; public CallableTest(int start) { this.start = start; } @Override public Integer call() throws Exception { Thread.sleep(500); return start + 1; } public static void main(String args[]) throws InterruptedException, ExecutionException{ long start = System.currentTimeMillis(); FutureTask<Integer> task1 = new FutureTask<>(new CallableTest(2)); new Thread(task1).start(); FutureTask<Integer> task2 = new FutureTask<>(new CallableTest(4)); new Thread(task2).start(); System.out.println(task1.get() + task2.get());//8 long end = System.currentTimeMillis(); System.out.println(end - start);//506 } }

优秀的个人博客,低调大师

Java多线程——ThreadLocal源码解析

ThreadLocal 这个类提供线程局部变量。这些变量在每一个线程中的正常副本都不相同,每一个线程访问一个副本(通过其 get或 set法),副本有自己独立的变量初始化复制。ThreadLocal实例通常是类中私有的静态字段希望关联状态和线程(例如,一个用户ID或交易ID)。 例如,下面的类为每个线程生成唯一的标识符。一个线程的ID在第一次调用ThreadId.get()时分配并且在后续调用中保持不变。 public class ThreadId { // Atomic integer containing the next thread ID to be assigned private static final AtomicInteger nextId = new AtomicInteger(0); // Thread local variable containing each thread's ID private static final ThreadLocal<Integer> threadId = new ThreadLocal<Integer>() { @Override protected Integer initialValue() { return nextId.getAndIncrement(); } }; // Returns the current thread's unique ID, assigning it if necessary public static int get() { return threadId.get(); } } 每一个线程在活着的时候就持有一个暗示对它线程本地变量拷贝的引用并且ThreadLocal实例可以访问;线程死去后它的线程本地实例拷贝受垃圾回收管辖(除非存在其他对这些副本引用)。 ——以上是对ThreadLocal注释的翻译 ThreadLocal是作为key值存储在ThreadLocalMap里面的,而ThreadLocalMap是一个典型的hash表,它的实例存储在了Thread.threadLocals,并且由于并非所有线程实例都需要用到threadLocals,它是懒汉式的初始化,在第一次插入时才会初始化创建ThreadLocalMap实例。输入的value是一个泛型对象,它可以是Integer、Double等基本装箱类型,也可以是自定义的bean类,可以认为Thread实例t拥有一个ThreadLocalMap实例threadLocals,它是一个hash表,它以ThreadLocal的实例作为key值,以具体内容泛型变量value作为value值,每个线程在存活期间有自己的ThreadLocalMap实例,所以各线程间互不干涉。 public class ThreadLocalTest { ThreadLocal<Long> longLocal = new ThreadLocal<Long>(); ThreadLocal<String> stringLocal = new ThreadLocal<String>(); public void set() { longLocal.set(Thread.currentThread().getId()); stringLocal.set(Thread.currentThread().getName()); } public long getLong() { return longLocal.get(); } public String getString() { return stringLocal.get(); } public static void main(String[] args) throws InterruptedException { final ThreadLocalTest test = new ThreadLocalTest(); test.set(); System.out.println(test.getLong()); System.out.println(test.getString()); Thread thread1 = new Thread() { public void run() { test.set(); System.out.println(test.getLong()); System.out.println(test.getString()); }; }; thread1.start(); thread1.join(); System.out.println(test.getLong()); System.out.println(test.getString()); /*1 main 11 Thread-0 1 main*/ } } 构造函数 因为ThreadLocal的作用是提供实例作为key值,它需要提供的内部变量就是hashcode,而hashcode是由别的方法生成,所以构造函数除了初始化实例外什么也不做 public ThreadLocal() { } set set方法设置当前线程的线程本地变量副本为指定的值。大部分子类不需要重写这个方法,只依靠initialValue来设置线程本地变量值。先获取当前线程中的ThreadLocalMap实例,然后检查是否为null。还没有创建的话需要先新创建一个,将这个ThreadLoca和value值放入map中。 public void set(T value) { Thread t = Thread.currentThread(); ThreadLocalMap map = getMap(t); if (map != null) map.set(this, value); else createMap(t, value); } /** * 获取关联ThreadLocal的map。在InheritableThreadLocal中重写。 */ ThreadLocalMap getMap(Thread t) { return t.threadLocals; } /** * 创建一个关联ThreadLocal的map。在InheritableThreadLocal中重写。 */ void createMap(Thread t, T firstValue) { t.threadLocals = new ThreadLocalMap(this, firstValue); } get get返回这个线程本地变量在当前线程中的副本值。如果这个变量在当前线程中没有值,第一次通过调用initialValue初始化这个值并返回。 public T get() { Thread t = Thread.currentThread(); ThreadLocalMap map = getMap(t); if (map != null) { ThreadLocalMap.Entry e = map.getEntry(this); if (e != null) { @SuppressWarnings("unchecked") T result = (T)e.value; return result; } } return setInitialValue();//map不存在或map中没有这个对象时调用setInitialValue } setInitialValue方法是set方法的变体,用于创建初始化值。如果用户已经重写了set方法,可以用作set方法的替代。 private T setInitialValue() { T value = initialValue();//未重写直接返回null Thread t = Thread.currentThread(); ThreadLocalMap map = getMap(t); if (map != null) map.set(this, value); else createMap(t, value); return value; } initialValue返回此线程局部变量的“初始值”。该方法将在一个线程第一次用get方法访问变量时被调用,除非线程之前调用了 set方法,在这种情况下, initialValue方法不会被这个线程调用。通常情况下,这种方法是每个线程调用一次,但它可能在后续调用get随后调用remove而再次调用。这种实现简单的返回null;如果程序员渴望线程局部变量有一个初始值而不是null,ThreadLocal必须有子类,并重写这个方法。通常情况下,将使用一个匿名内部类。简单来说,如果未set这个ThreadLocal的value值而直接调用get会导致在map中添加一个初始化的value值,如果没有重写ThreadLocal中的这个方法,那么初始值是null。 protected T initialValue() { return null; } remove remove方法移除当前线程的线程本地变量值。如果这个线程本地变量随后被当前线程用get方法读取,它的值会被initialValue重新初始化,除非这之间当前线程调用了set方法。这可能会导致当前线程中多次调用initialValue方法。 public void remove() { ThreadLocalMap m = getMap(Thread.currentThread()); if (m != null)//map未初始化时什么都不做 m.remove(this); } ThreadLocalMap ThreadLocalMap是ThreadLocal的内部类,是一个典型的hash表,只适合存储线程本地变量。没有操作暴露到ThreadLocal类外部。这个类是包私有的,允许在Thread中声明字段。为了帮助解决非常大并且长期存活的使用,hash表条目对key使用WeakReference。然而,因为没有使用引用队列,旧的条目只在表用完空间时才保证移除。 Entry ThreadLocalMap的条目也是自己实现的。这个hash表的条目扩展了WeakReference,使用它的只要引用字段作为k(总是ThreadLocal对象)。注意null的key值(比如entry.get() == null)意味着key不再被引用,因此条目可以从表删除。这样的条目作为“旧条目”在下方代码中被引用。ThreadLocal是弱引用,而value是强引用,如果创建ThreadLocal的线程一直持续运行,那么这个Entry对象中的value就有可能一直得不到回收,发生内存泄露。 static class Entry extends WeakReference<ThreadLocal<?>> { /** 关联这个ThreadLocal的值 */ Object value; Entry(ThreadLocal<?> k, Object v) { super(k);//将ThreadLocal作为key用于构造WeakReference value = v; } } 内部变量和构造函数 table是存储条目的数组,初始大小一定是16 /** * 初始容量,必需是2的指数次 */ private static final int INITIAL_CAPACITY = 16; /** * 表,有必要的话需要resize。table.length必须总是2的指数次 */ private Entry[] table; /** * 表中条目的数量 */ private int size = 0; /** * 到达后要进行resize的大小 */ private int threshold; // Default to 0 构造函数前面在createMap(Thread, T)中已经提到过,创建一个新的map初始化包含firstKey, firstValue)。ThreadLocalMap是懒汉式构建,因此我们只有当有至少一个条目要放入时再创建一个。负载因子至少是2/3。 ThreadLocalMap(ThreadLocal<?> firstKey, Object firstValue) { table = new Entry[INITIAL_CAPACITY]; int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1); table[i] = new Entry(firstKey, firstValue); size = 1; setThreshold(INITIAL_CAPACITY); } /** * 设置resize的门槛保证最差有2/3的负载因子 */ private void setThreshold(int len) { threshold = len * 2 / 3; } 还有一个版本是创建一个新的map包含所有来自父map的可继承的ThreadLocal。只会由createInheritedMap调用。因为较少使用就不说了。 getEntry getEntry获取和key关联的条目。这个方法本身只处理快速通道:已有key直接命中,否则会转移到getEntryAfterMiss。这种设计是为了最大化直接命中的效率,部分通过使这个方法容易非线性读取来实现。 private Entry getEntry(ThreadLocal<?> key) { int i = key.threadLocalHashCode & (table.length - 1);//根据hash值计算出直接命中的位置 Entry e = table[i]; if (e != null && e.get() == key) return e;//命中 else return getEntryAfterMiss(key, i, e);//未命中 } 如果直接目标未命中,需要getEntryAfterMiss来进行线性探测。由于散列的hash值碰撞情况很小,所以比起直接用循环查找的方法效率更高。在线性探测过程中,移动就是最简单的移动到尾部循环至头部,如果发现ThreadLocal为null说明已经被移除,需要删除这个结点的引用使得可以进行回收。 private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) { Entry[] tab = table; int len = tab.length; while (e != null) { ThreadLocal<?> k = e.get(); if (k == key) return e; if (k == null) expungeStaleEntry(i);//不再有引用了,需要删除 else i = nextIndex(i, len);//向后移动一位 e = tab[i]; } return null; } private static int nextIndex(int i, int len) { return ((i + 1 < len) ? i + 1 : 0); } hash 刚才提到了hash和表中对象的关系,那么要研究下ThreadLocalMap的hash值是怎么设计的。首先,要明确的一点是ThreadLocalMap使用的是开放地址法线性探测解决hash碰撞的问题,而hash值是在ThreadLocal中的。我们可以看到ThreadLocal中跟hash值计算有关的部分,用一个AtomicInteger来计算,是static也就是说有一个静态的值每新建一个ThreadLocal实例就会增加,但增加的间隔并不是1,而是0x61c88647,这个值得选取是为了减少碰撞的发生,具体原理和斐波那契散列法以及黄金分割有关。 所以,对于同样的ThreadLocal变量,各线程的ThreadLocalMap中它们都处于同一个数组位置。因此,还是建议每个线程只存一个变量,这样的话所有的线程存放到map中的Key都是相同的ThreadLocal,如果一个线程要保存多个变量,就需要创建多个ThreadLocal,多个ThreadLocal放入Map中时会极大的增加hash冲突的可能。如果必须使用多个变量,0x61c88647可以尽可能减少冲突的发生。因为表的大小永远是2的指数次,所以和len-1进行位与操作等价为直接取模。 /** * ThreadLocal依赖每个线程线性探测hash表关联到每个线程(Thread.threadLocals和inheritableThreadLocals)。 * ThreadLocal对象作为key,通过threadLocalHashCode来查找。 * 这是一个典型的hash值(只在ThreadLocalMaps内有用)消除当同样的线程连续创建ThreadLocal实例常见状况下的冲突,同时不太常见的状况也是良性的。 */ private final int threadLocalHashCode = nextHashCode(); /** * 下一个要给出的hash值,自动更新,从0开始。 */ private static AtomicInteger nextHashCode = new AtomicInteger(); /** * 连续产生的hash值之间的差值-使得连续的线程本地ID变得隐式连续,接近最佳地扩展到大小是2的指数次表的乘法倍数的hash值上。 */ private static final int HASH_INCREMENT = 0x61c88647;//‭0110 0001 1100 1000 1000 0110 0100 0111‬ /** * 返回下一个hash值 */ private static int nextHashCode() { return nextHashCode.getAndAdd(HASH_INCREMENT); } set set没有像get那样使用快速路径是因为使用set创建一个新的条目至少和替换一个已有的是一样频率,这样快速路径会经常失败。set会从hash对应的位置开始线性查找指定的key值,如果找到entry存在但key为null的位置说明已经被remove,使用replaceStaleEntry替换过时的值。如果找到了这个key值则替换已有值。如果找到了entry为null的位置说明还未被使用过,直接新建一个entry放到这个位置上。 private void set(ThreadLocal<?> key, Object value) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { ThreadLocal<?> k = e.get(); if (k == key) { e.value = value;//替换已有值 return; } if (k == null) { replaceStaleEntry(key, value, i);//替换过时的值 return; } } tab[i] = new Entry(key, value);//hash值对应的位置没有插入过元素 int sz = ++size; if (!cleanSomeSlots(i, sz) && sz >= threshold) rehash(); } replaceStaleEntry用一个有指定key的条目替换在set操作中遇到的过时条目。value参数传递的值存储在条目中,无论有这个key的条目是否已经存在。作为一个副作用,这个方法擦除了一趟中所有过时的条目(一趟指两个entry为null位置间的序列)。新的条目放在staleSlot位置上,而从这个位置开始向前和向后倒两个entry为null的位置之间所有key为null的条目都会被清除。 private void replaceStaleEntry(ThreadLocal<?> key, Object value, int staleSlot) { Entry[] tab = table; int len = tab.length; Entry e; //返回检查当前趟中之前的过期条目。我们一次清除整个趟避免因为垃圾回收释放串中的引用而频繁增加的rehash int slotToExpunge = staleSlot; for (int i = prevIndex(staleSlot, len); (e = tab[i]) != null; i = prevIndex(i, len))//从staleSlot开始向前直到entry为null的位置为止最靠前的引用为null的条目 if (e.get() == null) slotToExpunge = i; //寻找key或者趟里后面null位置两者中先发生的 for (int i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) {//循环从staleSlot向后倒entry为null的位置 ThreadLocal<?> k = e.get(); //如果找到key,我们需要交换它和过期条目来保持hash表顺序。新的过期位置或者在它之前任何其他过期位置, //可以被发送给expungeStaleEntry来移除或者rehash趟中的其他所有条目 if (k == key) {//找到了set操作中要插入的key e.value = value; tab[i] = tab[staleSlot];//将key相同的结点与staleSlot位置的结点交换 tab[staleSlot] = e; // 如果有的话开始擦除先前的过期结点 if (slotToExpunge == staleSlot) slotToExpunge = i; cleanSomeSlots(expungeStaleEntry(slotToExpunge), len);//第一个参数是从slotToExpunge到下一个null的位置,第二个参数是table长度 return; } //向前查找没有找到过期条目,在查找key时第一个发现的过期条目还是趟中的第一个 if (k == null && slotToExpunge == staleSlot) slotToExpunge = i; } // 如果没有找到key,将新的条目放在过期的位置 tab[staleSlot].value = null; tab[staleSlot] = new Entry(key, value); // 如果这一趟中还有其他过期条目,擦除它们 if (slotToExpunge != staleSlot) cleanSomeSlots(expungeStaleEntry(slotToExpunge), len); } expungeStaleEntry通过rehash任何在staleSlot与下一个null位置之间可能冲突条目来擦除过期条目。这也擦除了在随后的null之前遇到的所有其他过期条目。返回staleSlot之后下一个null的位置(在staleSlot和这个位置之间的都被检查是否要擦除)。 private int expungeStaleEntry(int staleSlot) { Entry[] tab = table; int len = tab.length; // 擦除在staleSlot的条目 tab[staleSlot].value = null; tab[staleSlot] = null; size--; // 直到遇到null之前rehash Entry e; int i; for (i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) { ThreadLocal<?> k = e.get(); if (k == null) {//key为null说明已经被remove,删除其他数据 e.value = null; tab[i] = null; size--; } else {//key存在,移动到接近hash直接定位的地方 int h = k.threadLocalHashCode & (len - 1); if (h != i) { tab[i] = null; // Unlike Knuth 6.4 Algorithm R, we must scan until // null because multiple entries could have been stale. while (tab[h] != null) h = nextIndex(h, len); tab[h] = e; } } } return i; } cleanSomeSlots检查log2(n)个位置,除非找到了一个过期条目,额外检查log2(table.length)-1个位置。插入时调用这个参数是元素个数,replaceStaleEntry调用时这个参数是table的大小。 private boolean cleanSomeSlots(int i, int n) { boolean removed = false; Entry[] tab = table; int len = tab.length; do { i = nextIndex(i, len); Entry e = tab[i]; if (e != null && e.get() == null) {//找到过期的条目需要清除 n = len; removed = true; i = expungeStaleEntry(i); } } while ( (n >>>= 1) != 0);//n=n/2 return removed; } set在新增一个条目到没有使用过的位置时,导致size增加,同时会触发rehash。会清空所有过期的条目,并根据size大小判断是否需要扩大数组,如果要扩大数组则数组大小*2。 private void rehash() { expungeStaleEntries(); // Use lower threshold for doubling to avoid hysteresis if (size >= threshold - threshold / 4) resize();//size达到了resize的大小,扩大数组 } /** * 两倍扩大表 */ private void resize() { Entry[] oldTab = table; int oldLen = oldTab.length; int newLen = oldLen * 2; Entry[] newTab = new Entry[newLen]; int count = 0; for (int j = 0; j < oldLen; ++j) { Entry e = oldTab[j]; if (e != null) { ThreadLocal<?> k = e.get(); if (k == null) { e.value = null; // Help the GC } else { int h = k.threadLocalHashCode & (newLen - 1); while (newTab[h] != null) h = nextIndex(h, newLen); newTab[h] = e; count++; } } } setThreshold(newLen); size = count; table = newTab; } /** * 清除表中稳定所有过期条目 */ private void expungeStaleEntries() { Entry[] tab = table; int len = tab.length; for (int j = 0; j < len; j++) { Entry e = tab[j]; if (e != null && e.get() == null) expungeStaleEntry(j); } } } remove 移除key对应的条目,直接通过线性探测法找到对应的key值,条目调用clear()方法后key会变为null但条目仍然存在,通过expungeStaleEntry(int)将table中这个位置置为null,并且gc可以回收这个条目。当线程终止时,它的ThreadLocal对象引用会变为null,那么在后续使用中table中不再有引用的条目会被垃圾回收,但是如果线程长时间存活但ThreadLocal对象不再被使用,需要显示的调用remove方法,避免内存泄漏。 private void remove(ThreadLocal<?> key) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) {//线性查找hash值相等的条目 if (e.get() == key) { e.clear();//清除引用 expungeStaleEntry(i);//删掉过期条目 return; } } }

优秀的个人博客,低调大师

Java多线程——ConcurrentHashMap源码解析

在之前讨论HashMap与HashTable时提到过,HashMap没有任何关于线程安全的处理,所以它不适合线程不安全的场景,而HashTable所有的操作方法都是加锁的,所以它是线程安全的,但是由于HashTable的一些设计上的缺陷比如每一次put或者get操作都需要重新对hash值取模来计算它的位置所以效率低。我们可以在多线程环境下通过对调用HashMap的方法进行加锁来确保其安全性,但是这样子效率还是很低。以get来说,我们知道在多线程环境下get需要检查集合中有没有某个key值,它需要根据hash值计算出位置然后检查对应的列表中有无寻找的元素,由于不能确定当前有没有正在插入元素的线程,所以需要加锁来保证安全性。但是,我们知道HashMap本身是箱式hash表,在下标位置不同时,两个线程不会操作同一个链表,所以它们之前相互不影响,也就不存在冲突,可以不用抢占同一个锁。针对不同的箱有不同的锁,这就是ConcurrentHashMap的设计方式——分段锁。 ConcurrentMap也继承了AbstractMap,实现了ConcurrentMap接口,key和value都不能为null这点和HashMap是不同的,JDK1.8采用了Node+CAS+synchronized的设计取代了1.7中的Sgement+HashEntry的设计。并且沿用了HashMap的链表转红黑树的设计。如果会修改集合中内容的方法发现正在进行resize操作,则要帮助先完成resize操作再继续。 ConcurrentMap设计核心是在HashMap箱式链表的结构基础上,每个线程只对一个箱上的结点加锁,不同箱之间不存在线程冲突。对于初始化操作使用乐观锁策略,先新建对象,通过compareAndSwap策略修改值。CAS策略基于CPU指令的支持,比加锁开销要小很多,但是它在操作失败时会自旋而不会阻塞让出CPU时间片,导致如果设计合理线程间冲突小则性能很高,如果线程间冲突严重会显著降低性能。 打开文件一看,都超过6k行了,所以还是采取从常用的方法入口开始逐渐向里追溯的分析方法。主要分析构造函数以及get、put、remove、replace、size几个常用的方法。 主要内部变量 这里需要注意的主要是resize过程中,为了多线程帮助转移原有的链表,用nextTable作为过程中的中间表。然后sizeCtl这个值正负有不同的意义,不再是capacity那样只用来表示容量的。为了避免插入新结点时计数器之前的碰撞,采用了分段式的计数器counterCells。 /** * 箱数组,在第一次插入的时候懒汉式初始化。大小总是2的幂。迭代器可以直接访问。 */ transient volatile Node<K,V>[] table; /** * 下一个使用的表,仅在resize过程中是非null */ private transient volatile Node<K,V>[] nextTable; /** * 基本计数器,主要用于没有争夺时,但也用在表初始化争夺中的返回,通过CAS更新 */ private transient volatile long baseCount; /** * 表初始化和resize控制。为负数时,这个表正在初始化或者resize:-1是初始化,否则是-(1+活跃的resize线程)。 * 未非负数时,表为null时持有创建表时的初始化大小如果是0采用默认大小。初始化之后,持有下一个resize操作的计数界限。 */ private transient volatile int sizeCtl; /** * 在resize时下一个分裂处的下标 */ private transient volatile int transferIndex; /** * 通过CAS锁定的自旋锁,用于resize时或者创建CounterCells时 */ private transient volatile int cellsBusy; /** * 计数器存储格表,非null时大小为2的指数次 */ private transient volatile CounterCell[] counterCells; 构造函数 构造函数最多是3个参数,不输入就采用默认值:表初始大小initialCapacity默认为16;负载因子loadFactor默认为0.75;并发级别concurrencyLevel代表线程数的估计值,默认为1但除了初始大小不能小于这个值以外没有其他作用。这里表的初始大小也会取恰好大于等于参数中初始大小除以负载因子加1和的2的指数次幂作为大小。sizeCtl为下一次扩展集合的边界,也就是容量。 public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { if (!(loadFactor > 0.0f) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); if (initialCapacity < concurrencyLevel) // Use at least as many bins initialCapacity = concurrencyLevel; // as estimated threads long size = (long)(1.0 + (long)initialCapacity / loadFactor); int cap = (size >= (long)MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : tableSizeFor((int)size);//tableSizeFor获取恰好大于等于size的2的指数次幂 this.sizeCtl = cap; } 静态工具方法 spread将hash值的高16位与低16位进行异或,作用是利用hash值的高位减少hash冲突,之前讲过HashMap中直接通过截取与容量大小-1的二进制位长度来进行快速定位数组中的位置。>>>是无符号右移 static final int spread(int h) { return (h ^ (h >>> 16)) & HASH_BITS; } tableSizeFor计算大于等于给定值的最小2的指数次幂。我们知道二进制下低位全是1的数再加1可以获得2的整数次幂,而这个全是1的数的获取方法是,将原数-1后的值的最高位扩展到所有的低位,最后返回的结果再加1。 private static final int tableSizeFor(int c) { int n = c - 1; n |= n >>> 1; n |= n >>> 2; n |= n >>> 4; n |= n >>> 8; n |= n >>> 16; return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1; } 然后是三个CAS方法,都是基于Unsafe调用CPU支持的系统函数完成的 //获取tab中下标为i的元素 static final <K,V> Node<K,V> tabAt(Node<K,V>[] tab, int i) { return (Node<K,V>)U.getObjectVolatile(tab, ((long)i << ASHIFT) + ABASE); } //修改tab中下标为i的元素值为v,要求从内存中取出时的值为c static final <K,V> boolean casTabAt(Node<K,V>[] tab, int i, Node<K,V> c, Node<K,V> v) { return U.compareAndSwapObject(tab, ((long)i << ASHIFT) + ABASE, c, v); } //修改tab中下标为i的元素的值为v static final <K,V> void setTabAt(Node<K,V>[] tab, int i, Node<K,V> v) { U.putObjectVolatile(tab, ((long)i << ASHIFT) + ABASE, v); } put操作 put方法有两种类型put和putIfAbsent,可以看到它们都调用了putVal这个方法,区别在于第三个参数 public V put(K key, V value) { return putVal(key, value, false); } public V putIfAbsent(K key, V value) { return putVal(key, value, true); } putVal就是实际操作了,首先检查箱数组有没有初始化,没有的话先要初始化。然后根据hash值计算出箱的位置,如果箱的位置为空则CAS新增一个结点。如果已有结点,则先检查有没有在做resize操作,有的话协助转移Node,没有在进行resize时对这个箱的结点加锁,检查箱式链表中有没有key值相等的结点,有的话视onlyIfAbsent的参数情况决定要不要覆盖。如果插入了新的结点到链表末尾需要检查链表长度是否达到8需要转为树结构,然后检查是否达到要进行resize的大小。最后的返回值,如果key值已经存在则返回旧的value值,否则返回null。在第一行的检查中我们可以看到,key和value都不能为null,否则抛出NullPointerException。 final V putVal(K key, V value, boolean onlyIfAbsent) { if (key == null || value == null) throw new NullPointerException();//插入的key和value都不能是null int hash = spread(key.hashCode());//高位也参与hash值计算 int binCount = 0; for (Node<K,V>[] tab = table;;) {//tab为箱数组 Node<K,V> f; int n, i, fh; if (tab == null || (n = tab.length) == 0) tab = initTable();//在第一次插入时进行懒汉式初始化箱数组 else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {//tabAt从内存中读取箱数组指定位置 //箱数组指定位置为null if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null)))//期待值n为ull,更新后的值为新建的Node,替换成功时返回true break; //增加到一个空箱时不加锁 } //箱数组指定位置已有Node else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f);//正在resize移动过程中,帮助转移Node else {//存在普通状态Node V oldVal = null; synchronized (f) {//锁箱数组中对应位置的结点 if (tabAt(tab, i) == f) { if (fh >= 0) { binCount = 1;//统计链表长度 for (Node<K,V> e = f;; ++binCount) { K ek; if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) {//存在key相等的Node oldVal = e.val; if (!onlyIfAbsent) e.val = value;//put调用时更新这个结点的value值 break; } Node<K,V> pred = e; if ((e = e.next) == null) { pred.next = new Node<K,V>(hash, key, value, null);//不存在key相等的Node,将新Node添加到链表末尾 break; } } } else if (f instanceof TreeBin) {//树状表 Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal;//存在key相等的结点时返回该结点的value值 break; } } } addCount(1L, binCount);//添加了新的结点时增加基础计数器,并检查是否需要扩大数组 return null;//不存在key相等的结点时返回null } initTable初始化表,大小为记录在sizeCtl中的值,只有在第一次向集合中添加键值对时才会调用。线程会尝试将堆中实例的sizeCtl值设为-1,如果成功的话代表该线程竞争到了初始化创建数组的权限,它将新建一个大小为sizeCtl原本值的Node数组,并修改实例中的table,这里的负载因子一定是按照0.75计算。最后将sizeCtl重置回原本的值。对于没有竞争到的线程会通过Thread.yield()会主动让出线程执行时间,线程转为就绪状态,但这不代表它一定不会立刻再进入运行状态。 private final Node<K,V>[] initTable() { Node<K,V>[] tab; int sc; while ((tab = table) == null || tab.length == 0) { if ((sc = sizeCtl) < 0) Thread.yield(); // 在初始化竞争中失败,自旋 else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {//尝试替换sizeCtl的值为-1,先替换成功的线程竞争成功,由它进行初始化 try { if ((tab = table) == null || tab.length == 0) { int n = (sc > 0) ? sc : DEFAULT_CAPACITY; @SuppressWarnings("unchecked") Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n]; table = tab = nt; sc = n - (n >>> 2);//负载因子是0.75,所以sizeCtl=n-n/4 } } finally { sizeCtl = sc; } break; } } return tab; } addCount在新增结点时被调用,增加count,如果表太小并且还没有resize,初始化转移。如果已经resize,帮助转移。重新检查转移后的占用来看是否需要另一个resize,因为resize比增加要延迟。如果check<0不检查resize,如果check<=1只在没有竞争时检查resize。 private final void addCount(long x, int check) { CounterCell[] as; long b, s; if ((as = counterCells) != null || !U.compareAndSwapLong(this, BASECOUNT, b = baseCount, s = b + x)) {//counterCells存在或者当前增加baseCount存在竞争 CounterCell a; long v; int m; boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[ThreadLocalRandom.getProbe() & m]) == null || !(uncontended = U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x))) {//计数器未初始化或者计数器增加失败 fullAddCount(x, uncontended); return; } if (check <= 1) return; s = sumCount(); } if (check >= 0) { Node<K,V>[] tab, nt; int n, sc; while (s >= (long)(sc = sizeCtl) && (tab = table) != null && (n = tab.length) < MAXIMUM_CAPACITY) {//需要进行resize时循环 int rs = resizeStamp(n);//获取结束位 if (sc < 0) { if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc == rs + 1 || sc == rs + MAX_RESIZERS || (nt = nextTable) == null || transferIndex <= 0) break;//没有在进行resize if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1))//已有nextTab transfer(tab, nt);//转移tab中的内容到nextTable } else if (U.compareAndSwapInt(this, SIZECTL, sc, (rs << RESIZE_STAMP_SHIFT) + 2)) transfer(tab, null);//新建nextTable s = sumCount(); } } } fullAddCount作用是在在计数格不存在或者baseCount增加失败时,尝试初始化计数格或者循环尝试增加baseCount。分析fullAddCount可以发现,计数器数组为空时增加计数器数组大小为2,而传递给addCount的check参数大小是链表长度。 private final void fullAddCount(long x, boolean wasUncontended) { int h; if ((h = ThreadLocalRandom.getProbe()) == 0) {//检查线程本地随机数有没有初始化 ThreadLocalRandom.localInit(); // force initialization强制初始化 h = ThreadLocalRandom.getProbe(); wasUncontended = true; } boolean collide = false; // True if last slot nonempty上一个槽非空时为true for (;;) { CounterCell[] as; CounterCell a; int n; long v; if ((as = counterCells) != null && (n = as.length) > 0) {//counterCells不为空 if ((a = as[(n - 1) & h]) == null) {//当前线程对应的计数器槽为空 if (cellsBusy == 0) { // Try to attach new Cell尝试关联到一个新的计数格 CounterCell r = new CounterCell(x); // Optimistic create乐观创建 if (cellsBusy == 0 && U.compareAndSwapInt(this, CELLSBUSY, 0, 1)) {//CAS算法尝试替换cellsBusy值为1 boolean created = false; try { // Recheck under lock在锁下重新检查 CounterCell[] rs; int m, j; if ((rs = counterCells) != null && (m = rs.length) > 0 && rs[j = (m - 1) & h] == null) { rs[j] = r;//赋值新建的计数格 created = true; } } finally { cellsBusy = 0;//重置cellsBusy为0 } if (created) break; continue; // Slot is now non-empty槽现在是非空 } } collide = false; } else if (!wasUncontended) // CAS already known to fail CAS已经知道失败 wasUncontended = true; // Continue after rehash再重新hash之后继续 else if (U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x)) break;//计数器增加成功则跳出 else if (counterCells != as || n >= NCPU) collide = false; // At max size or stale最大大小或者已经过时 else if (!collide) collide = true; else if (cellsBusy == 0 && U.compareAndSwapInt(this, CELLSBUSY, 0, 1)) {//计数格数组已经存在但不够大,竞争扩展它的权限 try { if (counterCells == as) {// Expand table unless stale除非已经过时否则扩展表 CounterCell[] rs = new CounterCell[n << 1];//新建一个大小为2倍的数组 for (int i = 0; i < n; ++i) rs[i] = as[i];//逐个赋值复制计数格 counterCells = rs;//修改数组 } } finally { cellsBusy = 0;//重置cellsBusy } collide = false; continue; // Retry with expanded table重新检查扩展后的表 } h = ThreadLocalRandom.advanceProbe(h);//伪随机前进并记录给定的探针值 } else if (cellsBusy == 0 && counterCells == as && U.compareAndSwapInt(this, CELLSBUSY, 0, 1)) {//counterCells为空,竞争到初始化的权利 boolean init = false; try { // Initialize table初始化表 if (counterCells == as) { CounterCell[] rs = new CounterCell[2];//计数格表初始化大小为2 rs[h & 1] = new CounterCell(x);//新建计数格 counterCells = rs; init = true; } } finally { cellsBusy = 0; } if (init) break;//初始化成功 } else if (U.compareAndSwapLong(this, BASECOUNT, v = baseCount, v + x)) break; // Fall back on using base使用base回退 } } transfer移动或者复制每个箱中的结点到新的表中,代码很长,大概可以分为几个部分:1如果nextTab为空新建一个;2每个线程分配到一个下标;3检查这个下标是否有存在的结点并且没有其他线程在修改它,有的话对它加锁然后搬运。比较复杂的地方主要是分配下标,考虑到多线程进行操作时,每个箱同时只能由一个线程来处理,如果所有线程都采用从0到n的遍历方式,冲突次数会大幅度上升,这里采取的策略是通过transferIndex来记录下一个线程进入时开始的下标位置进行分段,该值的变化间隔为16或者n/8/CPU值的较大值。对一个箱的搬运工作参照HashMap的工作方式通过高位hash值将链表拆分到数组高位。 private final void transfer(Node<K,V>[] tab, Node<K,V>[] nextTab) { int n = tab.length, stride; if ((stride = (NCPU > 1) ? (n >>> 3) / NCPU : n) < MIN_TRANSFER_STRIDE)//n/8/CPU个数<16 stride = MIN_TRANSFER_STRIDE; // subdivide range细分范围 if (nextTab == null) { // initiating初始化 try { @SuppressWarnings("unchecked") Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n << 1];//新建一个当前表大小2倍的数组给nextTable nextTab = nt; } catch (Throwable ex) { // try to cope with OOME sizeCtl = Integer.MAX_VALUE; return; } nextTable = nextTab; transferIndex = n; } int nextn = nextTab.length; ForwardingNode<K,V> fwd = new ForwardingNode<K,V>(nextTab); boolean advance = true; boolean finishing = false; // to ensure sweep before committing nextTab在提交nextTab前确保扫除完成 for (int i = 0, bound = 0;;) { Node<K,V> f; int fh; while (advance) { int nextIndex, nextBound; if (--i >= bound || finishing) advance = false; else if ((nextIndex = transferIndex) <= 0) { i = -1; advance = false; } else if (U.compareAndSwapInt (this, TRANSFERINDEX, nextIndex, nextBound = (nextIndex > stride ? nextIndex - stride : 0))) {//减小transferIndex的值 bound = nextBound; i = nextIndex - 1; advance = false; } } if (i < 0 || i >= n || i + n >= nextn) {//该线程负责转移部分已经完成 int sc; if (finishing) {//resize完成 nextTable = null; table = nextTab; sizeCtl = (n << 1) - (n >>> 1);//n*0.75 return; } if (U.compareAndSwapInt(this, SIZECTL, sc = sizeCtl, sc - 1)) {//增加一个活跃线程帮助resize if ((sc - 2) != resizeStamp(n) << RESIZE_STAMP_SHIFT) return; finishing = advance = true; i = n; // recheck before commit提交前重新检查 } } else if ((f = tabAt(tab, i)) == null)//表中不存在这个结点 advance = casTabAt(tab, i, null, fwd); else if ((fh = f.hash) == MOVED) advance = true; // already processed已经在移动 else {//表中有这个结点并且没有在移动 synchronized (f) {//每个箱只能由一个线程在处理 if (tabAt(tab, i) == f) { Node<K,V> ln, hn; if (fh >= 0) { int runBit = fh & n; Node<K,V> lastRun = f; for (Node<K,V> p = f.next; p != null; p = p.next) { int b = p.hash & n; if (b != runBit) { runBit = b; lastRun = p; } } if (runBit == 0) { ln = lastRun; hn = null; } else { hn = lastRun; ln = null; } for (Node<K,V> p = f; p != lastRun; p = p.next) { int ph = p.hash; K pk = p.key; V pv = p.val; if ((ph & n) == 0) ln = new Node<K,V>(ph, pk, pv, ln); else hn = new Node<K,V>(ph, pk, pv, hn); } setTabAt(nextTab, i, ln); setTabAt(nextTab, i + n, hn); setTabAt(tab, i, fwd); advance = true; } else if (f instanceof TreeBin) { TreeBin<K,V> t = (TreeBin<K,V>)f; TreeNode<K,V> lo = null, loTail = null; TreeNode<K,V> hi = null, hiTail = null; int lc = 0, hc = 0; for (Node<K,V> e = t.first; e != null; e = e.next) { int h = e.hash; TreeNode<K,V> p = new TreeNode<K,V> (h, e.key, e.val, null, null); if ((h & n) == 0) { if ((p.prev = loTail) == null) lo = p; else loTail.next = p; loTail = p; ++lc; } else { if ((p.prev = hiTail) == null) hi = p; else hiTail.next = p; hiTail = p; ++hc; } } ln = (lc <= UNTREEIFY_THRESHOLD) ? untreeify(lo) : (hc != 0) ? new TreeBin<K,V>(lo) : t; hn = (hc <= UNTREEIFY_THRESHOLD) ? untreeify(hi) : (lc != 0) ? new TreeBin<K,V>(hi) : t; setTabAt(nextTab, i, ln); setTabAt(nextTab, i + n, hn); setTabAt(tab, i, fwd); advance = true; } } } } } } 在putVal时,如果发现箱正在被转移说明resize操作正在进行,调用helpTransfer帮助转移 final Node<K,V>[] helpTransfer(Node<K,V>[] tab, Node<K,V> f) { Node<K,V>[] nextTab; int sc; if (tab != null && (f instanceof ForwardingNode) && (nextTab = ((ForwardingNode<K,V>)f).nextTable) != null) { int rs = resizeStamp(tab.length); while (nextTab == nextTable && table == tab && (sc = sizeCtl) < 0) { if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc == rs + 1 || sc == rs + MAX_RESIZERS || transferIndex <= 0) break; if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1)) {//通过CAS将sizeCtl+1来竞争操作权 transfer(tab, nextTab); break; } } return nextTab; } return table; } get 相比之下,get操作就比较简单了,从堆中找到table中下标位置的结点,然后顺着链表寻找key值相等的结点。find方法是预留给Node的子类重写hash值小于0的方法 public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) {//从内存中获取table指定下标位置的结点 if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val;//找到了指定的key值 } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null;//留给子类的重写方法,否则还是从这个链表中遍历寻找 while ((e = e.next) != null) {//遍历链表寻找hash值 if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } size size返回键值对的数量,最大不能超过整数上限。 public int size() { long n = sumCount(); return ((n < 0L) ? 0 : (n > (long)Integer.MAX_VALUE) ? Integer.MAX_VALUE : (int)n); } 其中的关键是sumCount方法,我们前面提到有baseCount和counterCells数组两个和计数有关的变量,分析addCount时我们可以看到优先增加baseCount的值,如果失败的话找到线程对应的计数格增加它的计数器,所以键值对的个数为两类变量的总和。 final long sumCount() { CounterCell[] as = counterCells; CounterCell a; long sum = baseCount; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) sum += a.value; } } return sum; } remove和replace remove是移除指定的结点,replace是将指定结点替换为指定值。虽然有不同的重载版本,区别是要不要指定结点的value值,但除了一些参数上的判断之外,它们都是基于replaceNode方法来完成的。 public V remove(Object key) { return replaceNode(key, null, null); } public boolean remove(Object key, Object value) { if (key == null) throw new NullPointerException(); return value != null && replaceNode(key, null, value) != null; } public boolean replace(K key, V oldValue, V newValue) { if (key == null || oldValue == null || newValue == null) throw new NullPointerException(); return replaceNode(key, newValue, oldValue) != null; } public V replace(K key, V value) { if (key == null || value == null) throw new NullPointerException(); return replaceNode(key, value, null); } replaceNode实现4个remove/replace操作:替换结点值为v,如果cv不是null则它原本的value需要等于cv,如果结果value值是null则删除这个结点。 final V replaceNode(Object key, V value, Object cv) { int hash = spread(key.hashCode()); for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; if (tab == null || (n = tab.length) == 0 || (f = tabAt(tab, i = (n - 1) & hash)) == null) break;//表不存在或者表为空或者表中找不到hash值对应的结点,直接返回 else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f);//正在resize先帮助转移 else {//表中存在该位置的结点 V oldVal = null; boolean validated = false; synchronized (f) { if (tabAt(tab, i) == f) {//双重确认 if (fh >= 0) {//hash值大于0说明是链表结点 validated = true; for (Node<K,V> e = f, pred = null;;) { K ek; if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { V ev = e.val; if (cv == null || cv == ev || (ev != null && cv.equals(ev))) { oldVal = ev; if (value != null) e.val = value;//value不为null替换值 else if (pred != null)//需要删除结点 pred.next = e.next;//该结点不是链表头 else setTabAt(tab, i, e.next);//该结点时链表头 } break; } pred = e; if ((e = e.next) == null) break; } } else if (f instanceof TreeBin) {//树状链表 validated = true; TreeBin<K,V> t = (TreeBin<K,V>)f; TreeNode<K,V> r, p; if ((r = t.root) != null && (p = r.findTreeNode(hash, key, null)) != null) { V pv = p.val; if (cv == null || cv == pv || (pv != null && cv.equals(pv))) { oldVal = pv; if (value != null) p.val = value; else if (t.removeTreeNode(p)) setTabAt(tab, i, untreeify(t.first)); } } } } } if (validated) { if (oldVal != null) { if (value == null) addCount(-1L, -1);//减少计数器,因为第二个参数是-1所以肯定不会检查resize return oldVal; } break; } } } return null; }

优秀的个人博客,低调大师

Java PipedInputStream PipedOutputStream类源码解析

管道流主要是用于不同线程间的数据交互,可以通过一个PipedInputStream和一个PipedOutputStream相互连接来进行通信,从PipedOutputStream写入字节到PipedInputStream中,所以PipedOutputStream是writer端,PipedInputStream是reader端。 一个PipedInputStream只能与一个PipedOutputStream连接,但是可以通过多个线程共享同一个管道来达到复数生产者和复数消费者的模式,同一个角色相互之间会存在竞争。下面的例子是一个writer和两个reader共用同一个管道流,可以看到两个reader之间根据线程调度随机接收一部分数据。 public class PipeStreamTest implements Runnable { private PipedInputStream in; private PipedOutputStream out; public PipeStreamTest(PipedInputStream in) { this.in = in; } public PipeStreamTest(PipedOutputStream out) { this.out = out; } @Override public void run() { if (this.in != null) { boolean flag = true; while (flag) { try { int a = in.read(); if (a == -1) { flag = false; break; } System.out.println(Thread.currentThread().getName() + " calculate " + String.valueOf(2 * a + 1)); } catch (IOException e) { e.printStackTrace(); flag = false; } } } else { try { Thread.sleep(1000);// 这里阻塞了out,导致in内没有可读取数据被阻塞 } catch (InterruptedException e1) { e1.printStackTrace(); } int a = 5; try { for (int i = 0; i < 5; i++) { out.write(a + i); System.out.println(Thread.currentThread().getName() + " write " + String.valueOf(a)); } out.close(); } catch (IOException e) { e.printStackTrace(); } } } public static void main(String args[]) throws IOException { PipedInputStream in = new PipedInputStream(10); PipedOutputStream out = new PipedOutputStream(in); new Thread(new PipeStreamTest(in)).start(); new Thread(new PipeStreamTest(in)).start(); new Thread(new PipeStreamTest(out)).start(); /*Thread-0 calculate 11 Thread-2 write 5 Thread-2 write 5 Thread-0 calculate 13 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-0 calculate 15 Thread-0 calculate 19 Thread-1 calculate 17*/ } } 对run()进行一些修改,阻塞reader线程,使得writer可以写满缓存区,此时writer会被阻塞,等待有reader读取数据后缓冲区有空余空间再写入,由于Thread.sleep不会被notifyAll()影响,所以在写入了10bytes数据后会存在5s的明显间隔 public void run() { if (this.in != null) { try { Thread.sleep(5000);// 这里阻塞了in,使得out会因没有空间写入而阻塞 } catch (InterruptedException e1) { e1.printStackTrace(); } boolean flag = true; while (flag) { try { int a = in.read(); if (a == -1) { flag = false; break; } System.out.println(Thread.currentThread().getName() + " calculate " + String.valueOf(2 * a + 1)); } catch (IOException e) { e.printStackTrace(); flag = false; } } } else { try { Thread.sleep(1000);// 这里阻塞了out,导致in内没有可读取数据被阻塞 } catch (InterruptedException e1) { e1.printStackTrace(); } int a = 5; try { for (int i = 0; i < 15; i++) { out.write(a + i); System.out.println(Thread.currentThread().getName() + " write " + String.valueOf(a)); } out.close(); } catch (IOException e) { e.printStackTrace(); } } } /* Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 这里出现明显的间隔 Thread-0 calculate 11 Thread-0 calculate 15 Thread-2 write 5 Thread-1 calculate 13 Thread-1 calculate 19 Thread-1 calculate 21 Thread-1 calculate 23 Thread-1 calculate 25 Thread-1 calculate 27 Thread-1 calculate 29 Thread-2 write 5 Thread-2 write 5 Thread-0 calculate 17 Thread-0 calculate 33 Thread-0 calculate 35 Thread-0 calculate 37 Thread-2 write 5 Thread-2 write 5 Thread-1 calculate 31 Thread-0 calculate 39*/ PipedInputStream 下面先来分析一下管道字节输入流PipedInputStream,它继承了InputStream。一个管道输入流需要连接一个管道输出流,管道输入流会提供任何数据字节写入管道输出流。典型地,数据被一个线程从一个PipedInputStream对象中读取,然后数据被另一个线程写到对应的PipedOutputStream。试图由一个线程使用所有对象是不推荐的,这可能导致线程死锁。 管道输入流含有一个缓冲区来解耦一个读操作和写操作。一个管道如果提供数据给相连接的管道输出流的线程不再活动,这个管道状态被称为BROKEN,也就是说如果上面的例子中把in对应的线程循环去掉使它运行完后被终止,此时out再尝试写入就会出现管道BROKEN的异常。 先来看一下跟管道状态有关的内部变量,流的关闭需要输入和输出端都关闭,所以需要两个变量来标志。同时,所有读写操作都需要管道两端建立连接,connected表示是否有连接建立。最后两个线程是输入和输出的操作线程,由于接收需要读取线程是运行状态,读取在缓冲区内为空时需要 /** * 输出流关闭,仅PipedOutputStream.close()调用receivedLast()方法会将它置为true */ boolean closedByWriter = false; /** * 输入流关闭,仅PipedInputStream.close()会将它置为true */ volatile boolean closedByReader = false; /** * 是否有一对输入输出流相互连接 */ boolean connected = false; /* 识别读和写两边需要更加复杂。使用线程组(但是管道在一个线程中怎么办)或者使用final化(但是可能到下一次GC的时间更长) */ Thread readSide;//input流的线程 Thread writeSide;//output流的线程 下面这些内部变量和缓冲区有关。buffer数组是循环缓冲区,这里有in和out两个下标指针,in负责接收,out负责读取,两个下标都是循环的如果达到末端会重新回到0的位置,读取不能超过接收数据的范围。 private static final int DEFAULT_PIPE_SIZE = 1024; /** * 管道循环输入缓冲区默认大小1K */ // 这个值在管道大小允许改变前被用作常数。这个值会为了向下兼容性被持续保持 protected static final int PIPE_SIZE = DEFAULT_PIPE_SIZE; /** * 循环缓冲区,接下来的数据会被放入其中 */ protected byte buffer[]; /** * 循环缓冲区中下一个从连接的管道输出流接收的字节数据将会被存储的位置下标。in<0说明缓冲区是空的,in==out说明缓冲区满了 */ protected int in = -1; /** * 循环缓冲区中下一个将会被这个管道输入流读取的字节下标位置。 */ protected int out = 0; 构造函数方面,可以直接给出管道输出流直接在构造时建立连接,也可以先构造输入流在需要使用时再连接。循环缓冲区的大小可以使用默认的1K,也可以手动指定大小。connect方法用于建立两端的连接,可以在构造时调用也可以手动调用。 /** * 创建一个PipedInputStream连接到管道输出流src。数据字节写入到src中将会成为这个流的输入。 */ public PipedInputStream(PipedOutputStream src) throws IOException { this(src, DEFAULT_PIPE_SIZE); } /** * 跟上面相比这个管道缓冲区的大小是指定的,其他相同 */ public PipedInputStream(PipedOutputStream src, int pipeSize) throws IOException { initPipe(pipeSize); connect(src); } /** * 创建一个还没有连接的PipedInputStream,在使用前必须连接到一个PipedOutputStream */ public PipedInputStream() { initPipe(DEFAULT_PIPE_SIZE); } /** * 创建一个还没有连接的PipedInputStream指定它的缓冲区大小,在使用前必须连接到一个PipedOutputStream */ public PipedInputStream(int pipeSize) { initPipe(pipeSize); } private void initPipe(int pipeSize) { if (pipeSize <= 0) { throw new IllegalArgumentException("Pipe Size <= 0"); } buffer = new byte[pipeSize]; } /** * 引起这个管道输入流连接到管道输出流src。如果这个对象已经连接到某个其他的管道输出流会抛出IOException。 * 如果src是一个未连接的管道输出流,snk是一个未连接的管道输入流,它们可以通过snk.connect(src)或者src.connect(snk)连接,两者效果相同。 */ public void connect(PipedOutputStream src) throws IOException { src.connect(this); } receive方法将字节写入到缓冲区,这是protected方法,再没有继承类的情况下由PipedOutputStream.write方法调用,接收字节会导致下标指针in增加,如果到达右边界,会重置为0。如果当前缓冲区没有空余的空间,这个方法会被阻塞,直到有线程读取了数据使得有空间写入时再继续。 /** * 接收一字节数据,这个方法如果没有有效输入时会阻塞。 */ protected synchronized void receive(int b) throws IOException { checkStateForReceive();//检查管道状态 writeSide = Thread.currentThread();//写线程设为当前线程 if (in == out) awaitSpace();//缓冲区满了,通知所有线程使得读取端读取字节给当前流缓冲区空出位置来接收 if (in < 0) {//in<0表示当前缓冲区为空 in = 0; out = 0; } buffer[in++] = (byte)(b & 0xFF);//将b存储到缓冲区中 if (in >= buffer.length) { in = 0;//因为是循环缓冲区,所以in超过buffer.length时重新回到0的位置 } } /** * 将数据接收到一个字节数组中,这个方法会阻塞到一些输入变得有效。 */ synchronized void receive(byte b[], int off, int len) throws IOException { checkStateForReceive();//检查管道状态 writeSide = Thread.currentThread();//写线程设为当前线程 int bytesToTransfer = len; while (bytesToTransfer > 0) {//还有需要写入的字节 if (in == out) awaitSpace();//缓冲区满了,通知其他线程读取字节空出空间 int nextTransferAmount = 0; if (out < in) {//out<in说明out到in这段是未读取的数据,所以空余空间是buffer.length-in nextTransferAmount = buffer.length - in; } else if (in < out) { if (in == -1) { //当前缓冲区为空,可用空间为buffer.length in = out = 0; nextTransferAmount = buffer.length - in; } else { //in已经到达一次右边界重置为0之后in<out,out到右边界是未读取内容,in不能超过out的值,所以空余空间为out-in nextTransferAmount = out - in; } } if (nextTransferAmount > bytesToTransfer) nextTransferAmount = bytesToTransfer;//要读取的字节数是剩余空间和参数指定长度间的较小值 assert(nextTransferAmount > 0); System.arraycopy(b, off, buffer, in, nextTransferAmount);//将接收的字节复制到缓冲区in开始的位置 bytesToTransfer -= nextTransferAmount; off += nextTransferAmount; in += nextTransferAmount;//in增加读取的字节数 if (in >= buffer.length) { in = 0;//in到达缓冲区边界时重置为0 } } } 然后看下这用到的两个内部方法。checkStateForReceive这个内部方法,确定当前有连接,管道两端都没有被关闭,有活动的读取端线程。当in==out时说明缓冲区满了不能再写入,需要有线程读取使得out增大之后才能再写入,awaitSpace会唤醒所有的等待读取线程,然后等待1s,再检查in==out是否成立,不断循环这个过程。 private void checkStateForReceive() throws IOException { if (!connected) { throw new IOException("Pipe not connected"); } else if (closedByWriter || closedByReader) { throw new IOException("Pipe closed"); } else if (readSide != null && !readSide.isAlive()) { throw new IOException("Read end dead"); } } private void awaitSpace() throws IOException { while (in == out) { checkStateForReceive(); /* full: kick any waiting readers */ notifyAll();//唤醒所有线程,使得有reader读取字节将当前流缓冲区空出来 try { wait(1000);//当前线程等待1s } catch (InterruptedException ex) { throw new java.io.InterruptedIOException(); } } } read方法从缓冲区中读取字节,要求存在连接且读取端没有关闭,如果缓冲区内没有可读取的字节则还需要writer端线程是活跃的。读取多个字节时会先尝试允许阻塞读取一个字节,成功后再读取后面部分,此时不会再阻塞等待所以如果要读取的长度太长则只读取缓冲区内所有可读取的内容,返回的是实际读取的字节数。 /** * 从这个管道输入流读取下一个字节。返回值作为一个整数范围在0-255之间。这个方法一直阻塞到输入数据变得有效,或者探知到流结束或者抛出异常。 */ public synchronized int read() throws IOException { //存在连接,读取端没有关闭,缓存区为空时写入端线程必须活动 if (!connected) { throw new IOException("Pipe not connected"); } else if (closedByReader) { throw new IOException("Pipe closed"); } else if (writeSide != null && !writeSide.isAlive() && !closedByWriter && (in < 0)) { throw new IOException("Write end dead"); } readSide = Thread.currentThread();//读取端线程设为当前线程 int trials = 2;//加起来等待2s,第三次循环缓冲区依然为空没有写入数据则认为管道BROKEN while (in < 0) { if (closedByWriter) { /* 输出管道被writer关闭返回-1 */ return -1; } if ((writeSide != null) && (!writeSide.isAlive()) && (--trials < 0)) { throw new IOException("Pipe broken"); } /* 可能有一个writer在等待 */ notifyAll(); try { wait(1000); } catch (InterruptedException ex) { throw new java.io.InterruptedIOException(); } } int ret = buffer[out++] & 0xFF;//读取out位置的字节并增加out if (out >= buffer.length) { out = 0;//如果out到达buffer右边界,将它重置为0 } if (in == out) { /* in==out说明缓冲区空了 */ in = -1; } return ret; } /** * 从这个管道输入流读取最大len程度的字节数据到字节数组中。如果到达了数据量末端或者len超过了管道缓冲区大小,少于len字节的数据会被读取。 * 如果len是0,没有数据会被读取返回0;否则这个方法会阻塞直到至少1字节输入是有效的,或者到达了流末端或者抛出异常。 */ public synchronized int read(byte b[], int off, int len) throws IOException { //存在连接,读取端没有关闭,缓存区为空时写入端线程必须活动 if (b == null) { throw new NullPointerException(); } else if (off < 0 || len < 0 || len > b.length - off) { throw new IndexOutOfBoundsException(); } else if (len == 0) { return 0; } /* 可能等待第一个字节 */ int c = read();//尝试读取一个字节 if (c < 0) { return -1;//没有读取到直接返回-1 } b[off] = (byte) c;//将读取到的字节存入数组 int rlen = 1; while ((in >= 0) && (len > 1)) { int available; if (in > out) { available = Math.min((buffer.length - out), (in - out));//in>out则可读取的数据是in-out,正常情况下in不能超过buffer.length } else { available = buffer.length - out;//in<out则可读取数据是out到buffer右边界,一次循环只能读取到右边界,从头开始的部分要下一次循环读取 } // 在循环外事先读取的字节 if (available > (len - 1)) { available = len - 1;//读取的字节不能超过参数指定的数量-1因为循环外已经读取了一个字节 } System.arraycopy(buffer, out, b, off + rlen, available);//复制可读取字节 out += available;//out位置移动读取的字节数 rlen += available;//目标位置移动 len -= available;//待读取长度减少 if (out >= buffer.length) { out = 0; } if (in == out) { /* in==out缓冲区为空,将in置为-1,所以循环会跳出 */ in = -1; } } return rlen; } available返回从这个输入流可以读取多少字节不用阻塞 public synchronized int available() throws IOException { if(in < 0) return 0; else if(in == out) return buffer.length;//因为在接收和读取时没有可读取的字节会把in置为-1,所以in==out是缓冲区满了的状态 else if (in > out) return in - out;//in>out时可读取内容是in到out之间 else return in + buffer.length - out;//in<out时是out到buffer右边界再加上buffer左边界到in的内容 } close关闭管道输入流,释放任何和这个流关联的资源 public void close() throws IOException { closedByReader = true;//输入流关闭 synchronized (this) { in = -1;//缓冲区所有数据失效 } } PipedOutputStream PipedOutputStream继承了OutputStream。管道输出流可以连接到一个管道输入流来创建一个通信管道。管道输出流是发送端。一般来说,一个线程将数据写入到一个PipedOutputStream对象,其他线程从连接的PipedInputStream对象读取数据。不推荐使用同一个线程来同时使用两个对象,可能会引起这个线程死锁。如果一个从连接的管道输入流读取数据的线程不再活动,这个管道被称为broken状态。 PipedOutputStream的代码很少,基本上全部都是调用PipedInputStream的方法。 内部变量只有一个private PipedInputStream sink用来判定输入端的状态。 构造方法可以指定输入流,也可以直接用无参构造使用前再手动调用连接方法 /** * 创建一个管道输出流连接到指定的管道输入流。数据字节写入到这个流中将会称为snk的有效输入。 */ public PipedOutputStream(PipedInputStream snk) throws IOException { connect(snk); } /** * 创建一个管道输出流还没有连接管道输入流。它在使用前必须通过接收者或者发送者连接到一个管道输入流。 */ public PipedOutputStream() { } connect方法要求两端都不能有已有的连接,否则会抛出异常 /** * 连接这个管道输出流到一个接收者。如果这个对象已经连接到了某个其他的管道输入流,会抛出IOException。 * 如果snk是一个未连接的管道输入流,src是一个未连接的管道输出流,它们可以通过两种方式连接: * src.connect(snk)或者snk.connect(src)。这两种方式是同样的效果。 */ public synchronized void connect(PipedInputStream snk) throws IOException { if (snk == null) { throw new NullPointerException(); } else if (sink != null || snk.connected) { throw new IOException("Already connected");//如果自身或者snk已经连接到某个管道,则抛出异常 } sink = snk;//因为snk内的属性是protected所以可以被同package的PipedOutputStream直接修改 snk.in = -1; snk.out = 0; snk.connected = true;//连接状态修改 } write方法写入数据到缓冲区,需要检查是否有连接的输入端,输入字符数组时还要检查数组和位置参数是否在正确范围内,最后调用输入流的receive方法 /** * 将指定的字节写入到管道输出流,实现了OutputStream.write */ public void write(int b) throws IOException { if (sink == null) { throw new IOException("Pipe not connected"); } sink.receive(b);//调用PipedInputStream.receive } /** * 将指定的数组中从off偏移开始长度len的字节写入到这个管道输出流。这个方法会阻塞,直到所有的字节都写入到输出流中。 */ public void write(byte b[], int off, int len) throws IOException { if (sink == null) { throw new IOException("Pipe not connected"); } else if (b == null) { throw new NullPointerException(); } else if ((off < 0) || (off > b.length) || (len < 0) || ((off + len) > b.length) || ((off + len) < 0)) { throw new IndexOutOfBoundsException(); } else if (len == 0) { return; } sink.receive(b, off, len); } flush()刷新这个输出流,并且促使任何缓冲的输出数据被写出。这个方法会唤醒所有的字节在管道中等待的读取端进入就绪状态。 public synchronized void flush() throws IOException { if (sink != null) { synchronized (sink) { sink.notifyAll(); } } } close关闭这个管道输出流并释放所有关联的系统资源。这个流不能再用于写字节。 public void close() throws IOException { if (sink != null) { sink.receivedLast(); } } /** * 通知所有等待的线程最后一个字节数据已经被接收 */ synchronized void receivedLast() { closedByWriter = true; notifyAll(); } PipedReader PipedReader是管道字符输入流,总体设计逻辑基本上和PipedInputStream是一致的,它继承了Reader。因为总体上都是一样的,就只挑区别来讲了。 第一个区别,因为是字符流,缓冲区变为字符数组 char buffer[]; receive单个字符把PipedInputStream里两个内部方法直接写到代码里了,然后因为类型的改变这里有强制转换类型的区别。 synchronized void receive(int c) throws IOException { if (!connected) { throw new IOException("Pipe not connected"); } else if (closedByWriter || closedByReader) { throw new IOException("Pipe closed"); } else if (readSide != null && !readSide.isAlive()) { throw new IOException("Read end dead"); } writeSide = Thread.currentThread(); while (in == out) { if ((readSide != null) && !readSide.isAlive()) { throw new IOException("Pipe broken"); } /* full: kick any waiting readers */ notifyAll(); try { wait(1000); } catch (InterruptedException ex) { throw new java.io.InterruptedIOException(); } } if (in < 0) { in = 0; out = 0; } buffer[in++] = (char) c;//int转为char if (in >= buffer.length) { in = 0; } } receive多个字符代码很简单,前面分析过PipedInputStream是在缓冲区满时等待读取,然后写入直到再次填满缓冲区或者写完所有数据,而PipedReader则是一个个字符存储到缓冲区,每一次写入都有可能发生阻塞等待。 synchronized void receive(char c[], int off, int len) throws IOException { while (--len >= 0) { receive(c[off++]); } } read设计逻辑上没有区别,也是单个字符读取最多等待2个循环也就是2s。多个字符读取会先尝试读取一个字符,后面无阻塞的尽可能读取多的字符来满足要求的长度,返回实际读取的字符个数。 PipedWriter设计和PipedOutputStream逻辑上无区别,就不说了。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册