首页 文章 精选 留言 我的

精选列表

搜索[小微模型],共10000篇文章
优秀的个人博客,低调大师

(编程)10个Python练手小程序

【程序1】 题目:有1、2、3、4个数字,能组成多少个互不相同且无重复数字的三位数?都是多少? 1.程序分析:可填在百位、十位、个位的数字都是1、2、3、4。组成所有的排列后再去 掉不满足条件的排列。 2.程序源代码: for i in range(1,5): for j in range(1,5): for k in range(1,5): if( i != k ) and (i != j) and (j != k): print (i,j,k) 阿里云代金券2000元免费领取地址:https://promotion.aliyun.com/ntms/yunparter/invite.html新老阿里云账户均可领取!可用于购买阿里云服务器ECS、云数据库RDS、虚拟主机、安骑士、DDoS高防IP等100多云计算产品。 代金券自领取之日起,有效期是30天,请及时使用,过30天后还可以重新领取。 【程序2】 题目:企业发放的奖金根据利润提成。利润(I)低于或等于10万元时,奖金可提10%;利润高 于10万元,低于20万元时,低于10万元的部分按10%提成,高于10万元的部分,可可提 成7.5%;20万到40万之间时,高于20万元的部分,可提成5%;40万到60万之间时高于 40万元的部分,可提成3%;60万到100万之间时,高于60万元的部分,可提成1.5%,高于 100万元时,超过100万元的部分按1%提成,从键盘输入当月利润I,求应发放奖金总数? 1.程序分析:请利用数轴来分界,定位。注意定义时需把奖金定义成长整型。 2.程序源代码: bonus1 = 100000 0.1bonus2 = bonus1 + 100000 0.500075bonus4 = bonus2 + 200000 0.5bonus6 = bonus4 + 200000 0.3bonus10 = bonus6 + 400000 * 0.15 i = int(raw_input('input gain:n'))if i <= 100000: bonus = i * 0.1 elif i <= 200000: bonus = bonus1 + (i - 100000) * 0.075 elif i <= 400000: bonus = bonus2 + (i - 200000) * 0.05 elif i <= 600000: bonus = bonus4 + (i - 400000) * 0.03 elif i <= 1000000: bonus = bonus6 + (i - 600000) * 0.015 else: bonus = bonus10 + (i - 1000000) * 0.01 print 'bonus = ',bonus 【程序3】 题目:一个整数,它加上100后是一个完全平方数,再加上168又是一个完全平方数,请问该数是多少? 1.程序分析:在10万以内判断,先将该数加上100后再开方,再将该数加上268后再开方,如果开方后 的结果满足如下条件,即是结果。请看具体分析: 2.程序源代码: include "math.h"main(){long int i,x,y,z;for (i=1;i<100000;i++) { x=sqrt(i+100); /x为加上100后开方后的结果/ y=sqrt(i+268); /y为再加上168后开方后的结果/ if(xx==i+100&&yy==i+268)/如果一个数的平方根的平方等于该数,这说明此数是完全平方数/ printf("n%ldn",i); }} '''import mathfor i in range(10000): #转化为整型值x = int(math.sqrt(i + 100))y = int(math.sqrt(i + 268))if(x x == i + 100) and (y y == i + 268): print i 题目:输入某年某月某日,判断这一天是这一年的第几天? 1.程序分析:以3月5日为例,应该先把前两个月的加起来,然后再加上5天即本年的第几天,特殊 情况,闰年且输入月份大于3时需考虑多加一天。 2.程序源代码: year = int(raw_input('year:n'))month = int(raw_input('month:n'))day = int(raw_input('day:n')) months = (0,31,59,90,120,151,181,212,243,273,304,334)if 0 <= month <= 12: sum = months[month - 1] else: print 'data error' sum += dayleap = 0if (year % 400 == 0) or ((year % 4 == 0) and (year % 100 != 0)): leap = 1 if (leap == 1) and (month > 2): sum += 1 print 'it is the %dth day.' % sum 【程序5】 题目:输入三个整数x,y,z,请把这三个数由小到大输出。 1.程序分析:我们想办法把最小的数放到x上,先将x与y进行比较,如果x>y则将x与y的值进行交换, 然后再用x与z进行比较,如果x>z则将x与z的值进行交换,这样能使x最小。 2.程序源代码: l = []for i in range(3): x = int(raw_input('integer:n'))l.append(x) l.sort()print l 【程序6】 题目:用号输出字母C的图案。 1.程序分析:可先用’’号在纸上写出字母C,再分行输出。 2.程序源代码: print 'Hello Python world!n'print '' 10for i in range(5): print ' ' print '' 10print 'n' 6 【程序7】 题目:输出特殊图案,请在c环境中运行,看一看,Very Beautiful! 1.程序分析:字符共有256个。不同字符,图形不一样。 2.程序源代码: a = 176b = 219print chr(b),chr(a),chr(a),chr(a),chr(b)print chr(a),chr(b),chr(a),chr(b),chr(a)print chr(a),chr(a),chr(b),chr(a),chr(a)print chr(a),chr(b),chr(a),chr(b),chr(a)print chr(b),chr(a),chr(a),chr(a),chr(b) 【程序8】 题目:输出9*9口诀。 1.程序分析:分行与列考虑,共9行9列,i控制行,j控制列。 2.程序源代码: include "stdio.h"main(){ int i,j,result; printf("n"); for (i=1;i<10;i++) { for(j=1;j<10;j++) { result=ij; printf("%d%d=%-3d",i,j,result);/-3d表示左对齐,占3位/ } printf("n");/每一行后换行/ }}for i in range(1,10): for j in range(1,10): result = i * j print '%d * %d = % -3d' % (i,j,result) print '' 【程序9】 题目:要求输出国际象棋棋盘。 1.程序分析:用i控制行,j来控制列,根据i+j的和的变化来控制输出黑方格,还是白方格。 2.程序源代码: include "stdio.h"main(){int i,j;for(i=0;i<8;i++) { for(j=0;j<8;j++) if((i+j)%2==0) printf("%c%c",219,219); else printf(" "); printf("n"); }}import sysfor i in range(8): for j in range(8): if(i + j) % 2 == 0: sys.stdout.write(chr(219)) sys.stdout.write(chr(219)) else: sys.stdout.write(' ') print '' 【程序10】 题目:打印楼梯,同时在楼梯上方打印两个笑脸。 1.程序分析:用i控制行,j来控制列,j根据i的变化来控制输出黑方格的个数。 2.程序源代码: import syssys.stdout.write(chr(1))sys.stdout.write(chr(1))print '' for i in range(1,11): for j in range(1,i): sys.stdout.write(chr(219)) sys.stdout.write(chr(219)) print ''

优秀的个人博客,低调大师

面向对象--小实例---DVD出借管理

usr/bin/python --coding:utf-8-- class DVD: def __init__(self,name,price,status): self.name = name self.price = price self.status = status if name == "__main__": # 0 未借出 1 借出 a = DVD("盗梦空间",10,1) b = DVD("星际穿越",20,0) c = DVD("黑客帝国",30,1) dvds = {a.name:a,b.name:b,c.name:c} print(dvds) while True: print("——————————DVD管理系统————————————") print("1,查询所有DVD") print("2,增加DVD") print("3,借出DVD") print('4,归还DVD') print("5,退出") print("----------------------------------------------------------") i = int(input("请选择您要进行的操作:")) if i == 5: break elif i == 1: print("名称".center(20) + "价格".center(20) + "状态".center(10)) for key in dvds.keys(): print(dvds.get(key).status) if dvds.get(key).status == 0: print(key.center(18) + str(dvds.get(key).price).center(21) + "未借出".center(11)) else: print(key.center(18) + str(dvds.get(key).price).center(21) + "已借出".center(11)) elif i == 2: name = input("\t请输入要添加的DVD的名称:") while name in dvds.keys(): name = input("\t该DVD已经存在,请重新输入:") else: price = input("\t请输入要添加的DVD的价格:") new_dvd = DVD(name,price,0) dvds[name] = new_dvd print("添加成功!!!") elif i == 3: while True: name = input("\t请输入要借出的DVD名称:") if name not in dvds.keys(): print('\t\t没有该DVD,请重新输入!') elif dvds.get(name).status == 1: print('\t\t已经借出,请重新输入!') else: print("{}借出成功!!".format(name)) dvds.get(name).status = 1 break elif i == 4: while True: name = input("\t请输入要归还的DVD名称:") if name not in dvds.keys(): print("\t\t不存在,请重新输入!") elif dvds.get(name).status == 0: print("\t\t该DVD没有被借出,请新输入:") else: days = int(input("\t请输入借出天数:")) print("请扫一扫:",int(dvds.get(name).price) * days,"元") dvds.get(name).status = 0 print("归还成功!!") break

优秀的个人博客,低调大师

centOS安装hadoop、编写wordCount小程序

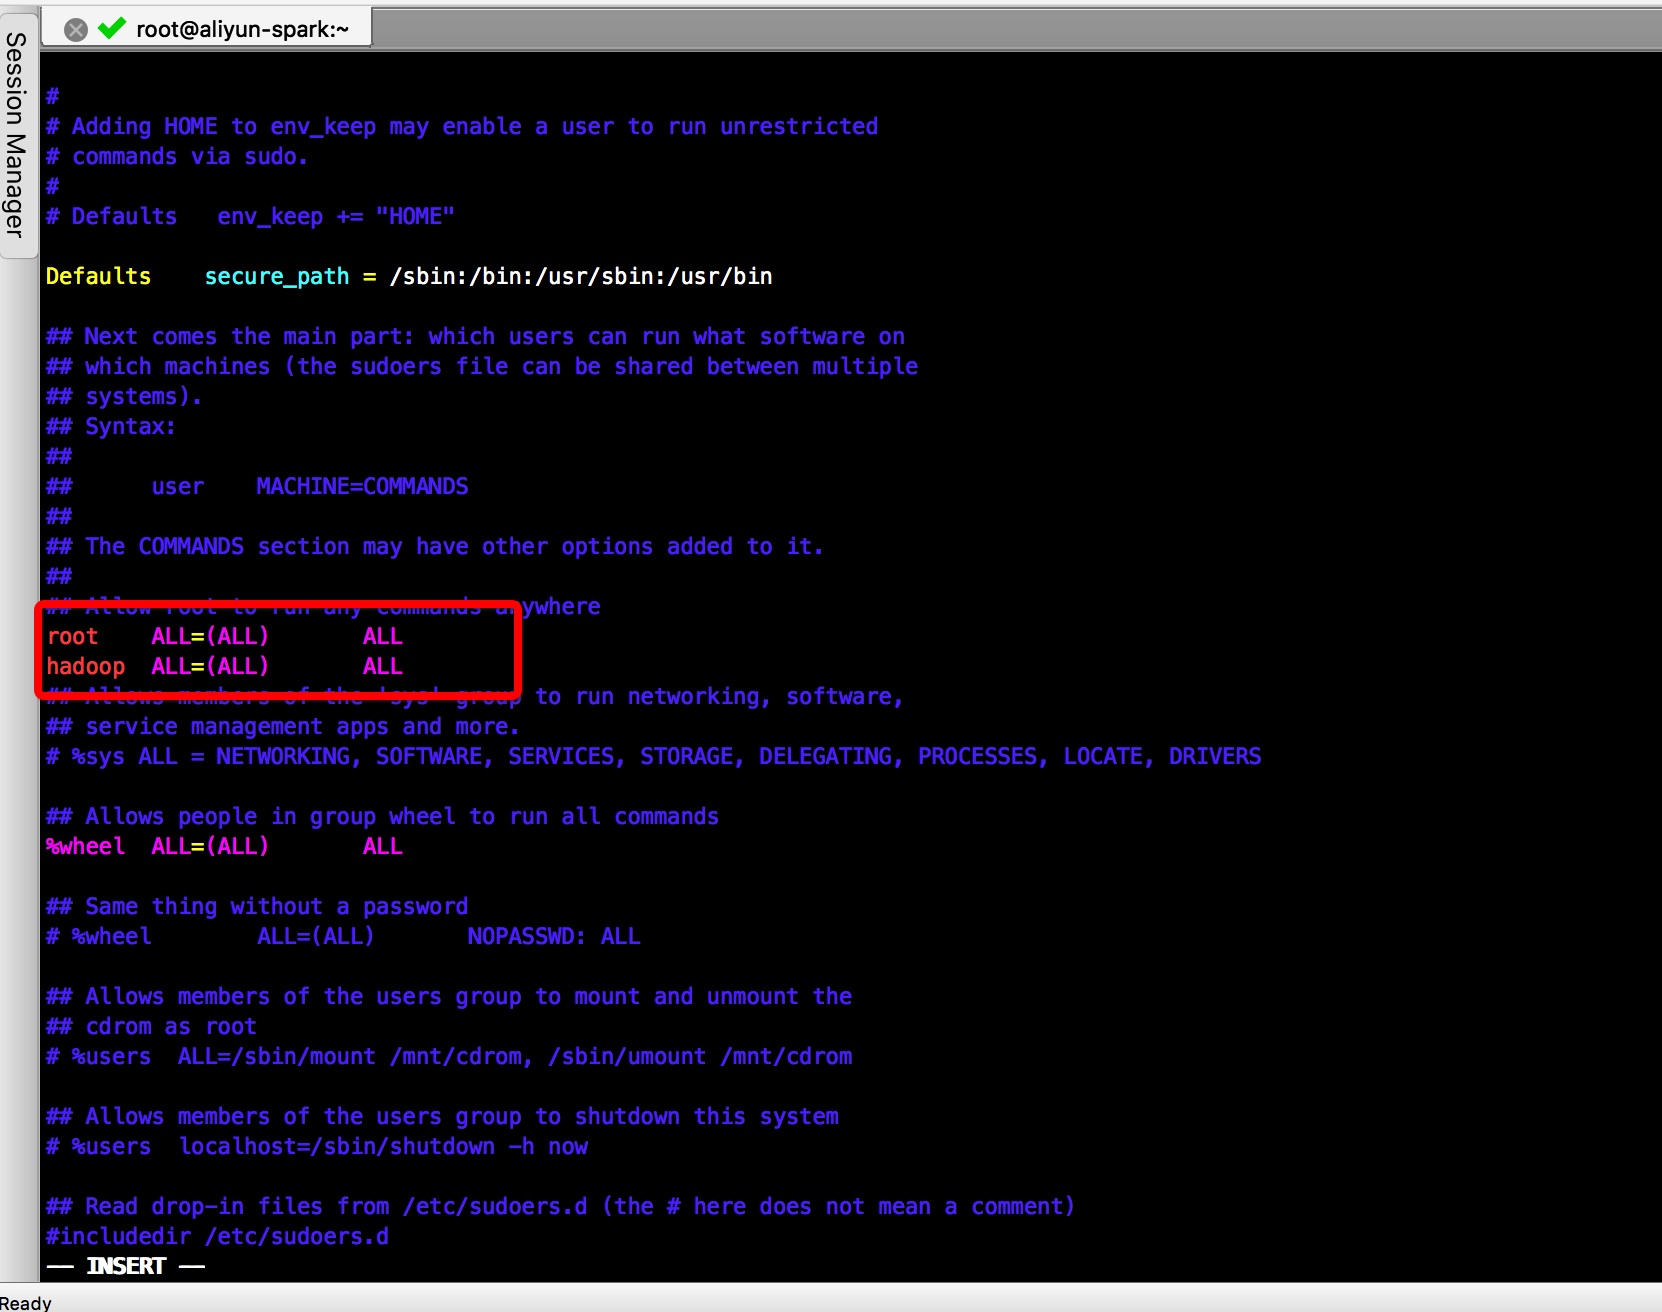
#为了方便后续管理,添加hadoop用户,并设置密码 adduser hadoop passwd hadoop #hadoop用户赋权(加sudo可以执行root的操作) #给sudoers文件读写权 chmod u+w /etc/sudoers #赋权 vim /etc/sudoers #在root ALL = (ALL) ALL 下添加 hadoop ALL=(ALL) ALL 并保存 #为了安全撤销写权限 chmod u-w /etc/sudoers 用户赋权 hadoop依赖1.7+的jdk 如果是3.0+版本的hadoop依赖1.8+的idk,安装jdk #安装jdk 这边我通过ftp把jdk1.8 tar包传到服务器 #进入相应目录解压 cd /usr/local/tools tar -zxvf jdk-8u171-linux-x64.tar.gz #配置环境变量 sudo vim /etc/profile #文件中添加 JAVA_HOME=/usr/local/tools/jdk1.8.0_171 PATH=$JAVA_HOME/bin:$PATH CLASSPATH=$JAVA_HOME/jre/lib/ext:$JAVA_HOME/lib/tools.jar export PATH JAVA_HOME CLASSPATH #保存 source /etc/profile #查看是否安装成功 java -version 配置jdk 配置SSH #进入要安装的目录并获取 cd usr/local/tolls wget https://archive.apache.org/dist/hadoop/common/hadoop-2.7.3/hadoop-2.7.3.tar.gz #解压 tar xzvf hadoop-2.7.3.tar.gz #ssh的配置和认证 #测试是否已经可以免密登录 首次的话需点击yes ssh localhost #不可以的话执行以下步骤 #查看是否已安装ssh 出现sshd字样说明已安装 ps -e | grep ssh #如果没有安装 yum install openssh-server #进入 用户的根目录 生成秘钥 ssh-keygen -t rsa #按三次回车 #传到authorized_keys中 cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys #测试 如果还是不可以更改下权限$ chmod 600 ~/.ssh/authorized_keys ssh localhost #ssh localhost免密且出现Welcome字样说明ssh配置成功 免密登陆 配置haddop环境变量 #类似配置jdk, sudo /etc/profile 添加 并 source /etc/profile 使其立即生效 export HADOOP_HOME=/usr/local/tools/hadoop-2.7.3 export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin #检测是否安装配置成功 hadoop version 配置hadoop环境变量 配置hadoopjdk环境 修改hadoop-env.sh #查看文件 sudo vim /usr/local/tools/hadoop-2.7.3/etc/hadoop/hadoop-env.sh #在最后一行添加 export JAVA_HOME=/usr/local/tools/jdk1.8.0_171 接下来需要配置四个配置文件(1,2为hdfs相关 3,4为yarn相关,注意备份防止配错) 1.core-site.xml 2.hdfs-site.xml 3.mapred-site.xml 4.yarn-site.xml 修改的配置文件 #进入hadoop-2.7.3/etc/hadoop目录 #配置core-site.xml <configuration> <!-- 指定HDFS老大(namenode)的通信地址 --> <property> <name>fs.defaultFS</name> <value>hdfs://localhost:9000</value> </property> <!-- 指定hadoop运行时产生文件的存储路径 --> <property> <name>hadoop.tmp.dir</name> <value>/usr/hadoop/tmp</value> </property> </configuration> #配置hdfs-site.xml <configuration> <property> <name>dfs.name.dir</name> <value>/usr/hadoop/hdfs/name</value> <description>namenode上存储hdfs名字空间元数据 </description> </property> <property> <name>dfs.data.dir</name> <value>/usr/hadoop/hdfs/data</value> <description>datanode上数据块的物理存储位置</description> </property> <!-- 设置hdfs副本数量 --> <property> <name>dfs.replication</name> <value>1</value> </property> </configuration> #配置mapred-site.xml <configuration> <!-- 通知框架MR使用YARN --> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> </configuration> #配置yarn-site.xm <configuration> <!-- reducer取数据的方式是mapreduce_shuffle --> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> </configuration> 详细配置 启动hdfs cd /usr/local/tools/hadoop-2.7.3 #第一次启动hdfs格式化 也可以进入bin目录直接执行hdfs namenode -format #这边初始化的时候报了java.io.IOException: Cannot create directory /usr/hadoop/hdfs/name/current 的错,原因是hdfs设置存储元数据的地址没有写权限(可能因为不是root用户) #解决方案 赋予写权 sudo chmod -R a+w /usr/hadoop/ ./bin/hdfs namenode -format #启动命令 #初次启动的时候报 /usr/local/tools/hadoop-2.7.3/logs/hadoop-hadoop-secondarynamenode-aliyun-spark.out: No such file or directory的错 这个时候mkdir logs 然后 sudo chmod -R a+w /usr/local/tools/hadoop-2.7.3/logs/ 即可 ./sbin/start-dfs.sh #停止 ./sbin/stop-dfs.sh #在网页打开 localhost:50070测试hdfs是否启动 #查看启动的相关进程 jps 出现这个界面说明hdfs启动成功 hdfs界面 启动yarn cd /usr/local/tools/hadoop-2.7.3 #启动yarn ./sbin/start-yarn.sh 【 #启动如果报了hadoop@localhost's password: localhost: Permission denied, please try again.的错 解决方案 #先关闭yarn并修改当前用户密码 sudo passwd hadoop #修改密码后 重新格式化namenode ./bin/hdfs namenode -format #重启ssh之后再启动 sudo service ssh restart 】 #在网页打开 localhost:8088查看yarn是否启动 #关闭yarn ./sbin/stop-yarn.sh 出现这个界面说明yarn启动成功 yarn界面 如果想一次性启动所有 cd /usr/local/tools/hadoop-2.7.3 ./sbin/start-all.sh 本地测试worldcount hadoop安装成功后,先直接使用linux文件系统做测试,不使用hadoop fs相关命令 #在hadoop-2.7.3文件夹中进入 cd share/hadoop/mapreduce/ #查看列表 ls #查看hadoop-mapreduce-examples-2.7.3.jar 中的类 可以看到里面包含worldCount.class jar tvf hadoop-mapreduce-examples-2.7.3.jar #创建准备测试的数据 #在根目录下创建input目录 sudo mkdir -p dataLocal/input/ #赋予写权 sudo chmod -R a+w dataLocal/input/ #进入目录并填充数据 二次填充file2 cd dataLocal/input/ sudo echo "hello world, I am jungle. bye world" > file1.txt sudo echo "hello hadoop. hello jungle. bye hadoop." > file2.txt sudo echo "the great software is hadoop." >> file2.txt #计数file2 #执行前需把input文件传到hdfs #查看hdfs当前文件 hdfs dfs -ls / #创建input文件夹 hadoop fs -mkdir -p /input #本地文件推送到hdfs的input目录下 hdfs dfs -put dataLocal/input/file2.txt /input #如果要计数所有txt文件可 #hdfs dfs -put dataLocal/input/*.txt /input #如果缺省路径默认表示 user/{user_name}下 这边我output缺省默认放在了 /user/hadoop/下 hadoop jar /usr/local/tools/hadoop-2.7.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.3.jar wordcount /input output #如果报了There are 0 datanode(s) running and no node(s) are excluded in this operation.的异常,先jps查看datanode进程是否正在运行 且namenode的9000端口(core-site.xml文件中的fs.default.name节点配置,所有的DataNode都要通过这个端口连接NameNode)是否开启,防火墙是否允许 也有可能是两次格式化hadoop 导致没有datenode 解决方案 找到hdfs-site.xml设置的dfs.name.dir的路径/usr/hadoop/hdfs/name 删除下面的current文件夹 之后重新格式化hadoop namenode -format 重启下hdfs和yarn #jps继续查看datenode是否启动 如果仍未启动 可能是因为datanode的clusterID 和 namenode的clusterID(第一次格式化dfs后,启动并使用了hadoop,后来又重新执行了格式化命令(hdfs namenode -format),这时namenode的clusterID会重新生成,而datanode的clusterID 保持不变) 总之就是得让datanode启动 #查看输出的output hadoop dfs -ls ./output #查看内部输出worldcount MapReduce后的结果 hadoop dfs -cat ./output/* hadoop dfs -cat ./output20180509230557/* #删除hdfs文件 假设删除/inputfile1 hadoop dfs -rmr /inputfile1 #如果想计算dataLocal/input/目录下所有文件的wordcount hdfs dfs -put dataLocal/input/*.txt /input hadoop fs、hadoop dfs、hdfs dfs区别 hadoop fs:使用面最广,可以操作任何文件系统。 hadoop dfs与hdfs dfs:只能操作HDFS文件系统相关(包括与Local FS间的操作),前者已经Deprecated,一般使用后者。 本地测试worldcount hadoop安装成功后,先直接使用linux文件系统做测试,不使用hadoop fs相关命令 #在hadoop-2.7.3文件夹中进入 cd share/hadoop/mapreduce/ #查看列表 ls #查看hadoop-mapreduce-examples-2.7.3.jar 中的类 可以看到里面包含worldCount.class jar tvf hadoop-mapreduce-examples-2.7.3.jar #创建准备测试的数据 #在根目录下创建input目录 sudo mkdir -p dataLocal/input/ #赋予写权 sudo chmod -R a+w dataLocal/input/ #进入目录并填充数据 二次填充file2 cd dataLocal/input/ sudo echo "hello world, I am jungle. bye world" > file1.txt sudo echo "hello hadoop. hello jungle. bye hadoop." > file2.txt sudo echo "the great software is hadoop." >> file2.txt #计数file2 #执行前需把input文件传到hdfs #查看hdfs当前文件 hdfs dfs -ls / #创建input文件夹 hadoop fs -mkdir -p /input #本地文件推送到hdfs的input目录下 hdfs dfs -put dataLocal/input/file2.txt /input #如果要计数所有txt文件可 #hdfs dfs -put dataLocal/input/*.txt /input #如果缺省路径默认表示 user/{user_name}下 这边我output缺省默认放在了 /user/hadoop/下 hadoop jar /usr/local/tools/hadoop-2.7.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.3.jar wordcount /input output #如果报了There are 0 datanode(s) running and no node(s) are excluded in this operation.的异常,先jps查看datanode进程是否正在运行 且namenode的9000端口(core-site.xml文件中的fs.default.name节点配置,所有的DataNode都要通过这个端口连接NameNode)是否开启,防火墙是否允许 也有可能是两次格式化hadoop 导致没有datenode 解决方案 找到hdfs-site.xml设置的dfs.name.dir的路径/usr/hadoop/hdfs/name 删除下面的current文件夹 之后重新格式化hadoop namenode -format 重启下hdfs和yarn #jps继续查看datenode是否启动 如果仍未启动 可能是因为datanode的clusterID 和 namenode的clusterID(第一次格式化dfs后,启动并使用了hadoop,后来又重新执行了格式化命令(hdfs namenode -format),这时namenode的clusterID会重新生成,而datanode的clusterID 保持不变) 总之就是得让datanode启动 #查看输出的output hadoop dfs -ls ./output #查看内部输出worldcount MapReduce后的结果 hadoop dfs -cat ./output/* hadoop dfs -cat ./output20180509230557/* #删除hdfs文件 假设删除/inputfile1 hadoop dfs -rmr /inputfile1 #如果想计算dataLocal/input/目录下所有文件的wordcount hdfs dfs -put dataLocal/input/*.txt /input hadoop fs、hadoop dfs、hdfs dfs区别 hadoop fs:使用面最广,可以操作任何文件系统。 hadoop dfs与hdfs dfs:只能操作HDFS文件系统相关(包括与Local FS间的操作),前者已经Deprecated,一般使用后者。 下面用idea编写wordcount程序 1.mac本地运行wordcount(localohost),前提是本机装有hadoop(mac安装步骤与在linux上大致相同) import java.io.IOException; import java.text.SimpleDateFormat; import java.util.Date; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; /** * Created by LJW on 2018/5/9. * 本地运行wordCount */ public class WordCount { /** * 用户自定义map函数,对以<key, value>为输入的结果文件进行处理 * Map过程需要继承org.apache.hadoop.mapreduce包中Mapper类,并重写其map方法。 * 通过在map方法中添加两句把key值和value值输出到控制台的代码 * ,可以发现map方法中value值存储的是文本文件中的一行(以回车符为行结束标记),而key值为该行的首字母相对于文本文件的首地址的偏移量。 * 然后StringTokenizer类将每一行拆分成为一个个的单词 * ,并将<word,1>作为map方法的结果输出,其余的工作都交有MapReduce框架处理。 每行数据调用一次 Tokenizer:单词分词器 */ public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable>{ private final static IntWritable one = new IntWritable(1); private Text word = new Text(); //由于该例子未用到key的参数,所以该处key的类型就简单指定为Object @Override public void map(Object key, Text value, Context context ) throws IOException, InterruptedException { StringTokenizer itr = new StringTokenizer(value.toString()); while (itr.hasMoreTokens()) { word.set(itr.nextToken()); context.write(word, one); } } } /** * 用户自定义reduce函数,如果有多个热度测,则每个reduce处理自己对应的map结果数据 * Reduce过程需要继承org.apache.hadoop.mapreduce包中Reducer类,并重写其reduce方法。 * Map过程输出<key,values>中key为单个单词,而values是对应单词的计数值所组成的列表,Map的输出就是Reduce的输入, * 所以reduce方法只要遍历values并求和,即可得到某个单词的总次数。 */ public static class IntSumReducer extends Reducer<Text,IntWritable,Text,IntWritable> { private IntWritable result = new IntWritable(); @Override public void reduce(Text key, Iterable<IntWritable> values, Context context ) throws IOException, InterruptedException { int sum = 0; for (IntWritable val : values) { sum += val.get(); } result.set(sum); context.write(key, result); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); try { Job job = Job.getInstance(conf, "word count"); //如果不是本地 使用setJarByClass指定所在class文件 job.setJarByClass(WordCount.class); job.setMapperClass(TokenizerMapper.class); job.setCombinerClass(IntSumReducer.class); job.setReducerClass(IntSumReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(IntWritable.class); //原文件目录 待计算 String path1 = "hdfs://localhost:9000/input"; //正常情况输出路径每次都要删除再通过计算填充 为方便测试每次输出到一个新的路径 String path2 = "hdfs://localhost:9000/output" + new SimpleDateFormat("yyyyMMddHHmmss").format(new Date()); FileInputFormat.addInputPath(job,new Path(path1)); // if(fs.exists(path2)) { // fs.delete(path2, true); // System.out.println("存在此输出路径,已删除!!!"); // } //输出文件目录 计算之后的输出目录 String time = new SimpleDateFormat("yyyyMMddHHmmss").format(new Date()); FileOutputFormat.setOutputPath(job, new Path(path2)); job.waitForCompletion(true) ; System.exit(job.waitForCompletion(true) ? 0 : 1); } catch (Exception e) { e.printStackTrace(); } } } 后续遇到的坑 博主在阿里云hadoop启动了很长一段时间后,发现突然就关闭不了服务了 网上查询可能有以下原因 ①hadoop在stop的时候依据的是datanode上的mapred和dfs进程号。而默认的进程号保存在/tmp下,linux默认会每隔一段时间(一般是一个月或者7天左右)去删除这个目录下的文件。因此删掉hadoop-hadoop-jobtracker.pid和hadoop-hadoop-namenode.pid两个文件后,namenode自然就找不到datanode上的这两个进程(最常见) ②环境变量 $HADOOP_PID_DIR 在你启动hadoop后改变了 ③用另外的用户身份执行stop-all 目测我的是因为第一个原因,解决方案 ①ps -ef | grep java | grep hadoop 查找hadoop的所有相关进程,再次jps查看只剩jps。 ②修改$HADOOP_HOME/conf/hadoop-env.sh里边,去掉export HADOOP_PID_DIR=/var/hadoop/pids的#号,创建/var/hadoop/pids或者你自己指定目录

优秀的个人博客,低调大师

java中对象数组的小例题

/* * 我有5个学生,请把这个5个学生的信息存储到数组中,并遍历学生数组,获取得到每一个学生的信息。 * 学生类:Student * 成员变量:name,age * 构造方法:无参,带参 * 成员方法:getXxx()/setXxx() * 存储学生的数组?自己想想应该是什么样子的? * 分析: * A:创建学生类。 * B:创建学生数组(对象数组)。 * C:创建5个学生对象,并赋值。 * D:把C步骤的元素,放到学生数组中。 * E:遍历学生数组。 */ 示例代码如下: 1 package cn.itcast_01; 2 3 public class Student { 4 // 成员变量 5 private String name; 6 private int age; 7 8 // 构造方法 9 public Student() { 10 super(); 11 } 12 13 public Student(String name, int age) { 14 super(); 15 this.name = name; 16 this.age = age; 17 } 18 19 // 成员方法 20 // getXxx()/setXxx() 21 public String getName() { 22 return name; 23 } 24 25 public void setName(String name) { 26 this.name = name; 27 } 28 29 public int getAge() { 30 return age; 31 } 32 33 public void setAge(int age) { 34 this.age = age; 35 } 36 37 @Override 38 public String toString() { 39 return "Student [name=" + name + ", age=" + age + "]"; 40 } 41 } Student.java 1 package cn.itcast_01; 2 3 /* 4 * 我有5个学生,请把这个5个学生的信息存储到数组中,并遍历学生数组,获取得到每一个学生的信息。 5 * 学生类:Student 6 * 成员变量:name,age 7 * 构造方法:无参,带参 8 * 成员方法:getXxx()/setXxx() 9 * 存储学生的数组?自己想想应该是什么样子的? 10 * 分析: 11 * A:创建学生类。 12 * B:创建学生数组(对象数组)。 13 * C:创建5个学生对象,并赋值。 14 * D:把C步骤的元素,放到学生数组中。 15 * E:遍历学生数组。 16 */ 17 public class ObjectArrayDemo { 18 public static void main(String[] args) { 19 // 创建学生数组(对象数组)。 20 Student[] students = new Student[5]; 21 22 // 遍历新创建的学生数组。 23 for (int x = 0; x < students.length; x++) { 24 System.out.println(students[x]); 25 } 26 System.out.println("---------------------"); 27 28 // 创建5个学生对象,并赋值。 29 Student s1 = new Student("林青霞", 27); 30 Student s2 = new Student("风清扬", 30); 31 Student s3 = new Student("刘意", 30); 32 Student s4 = new Student("赵雅芝", 60); 33 Student s5 = new Student("王力宏", 35); 34 35 // 把C步骤的元素,放到学生数组中。 36 students[0] = s1; 37 students[1] = s2; 38 students[2] = s3; 39 students[3] = s4; 40 students[4] = s5; 41 42 // 看到很相似,就想用循环改,把C步骤的元素,放到学生数组中。 43 // for (int x = 0; x < students.length; x++) { 44 // students[x] = s + "" + (x + 1); // 拼完之后是一个字符串了。 45 // } 46 // 这个是有问题的。 47 48 // 遍历赋值后的学生数组。用重写toString()方法 49 for (int x = 0; x < students.length; x++) { 50 // 重写toString()方法,注意:一个方法写定之后就不要再去改变了。因为改来改去的还不如重新写个方法呢? 51 System.out.println(students[x]); 52 } 53 System.out.println("---------------------"); 54 55 // 遍历赋值后的学生数组,用getXxx()方法 56 for (int x = 0; x < students.length; x++) { 57 // 因为学生数组的每一个元素都是一个学生。 58 Student s = students[x]; 59 System.out.println(s.getName()+"---"+s.getAge()); 60 } 61 } 62 } ObjectArrayDemo.java 1 null 2 null 3 null 4 null 5 null 6 --------------------- 7 Student [name=林青霞, age=27] 8 Student [name=风清扬, age=30] 9 Student [name=刘意, age=30] 10 Student [name=赵雅芝, age=60] 11 Student [name=王力宏, age=35] 12 --------------------- 13 林青霞---27 14 风清扬---30 15 刘意---30 16 赵雅芝---60 17 王力宏---35 输出结果如下: 我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

C#运算符小例子

using System;using System.Collections.Generic;using System.Linq;using System.Text;using System.Threading.Tasks; namespace Demo{ class Program { static void Main(string[] args) { Console.WriteLine("输入一个数字:"); int myInt = Convert.ToInt32(Console.ReadLine()); bool isLessThan10 = myInt < 10; bool isBetween0And5 = (0 <= myInt) && (myInt <= 5); Console.WriteLine("数字小于10? {0}",isLessThan10); Console.WriteLine("数字在0和5之间? {0}", isBetween0And5); Console.ReadKey(); } } } 本文转自TBHacker博客园博客,原文链接:http://www.cnblogs.com/jiqing9006/p/6707627.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

python 实用的30个小技巧

所有的这些技巧都能帮助你压缩代码并且优化运行。此外,你可以在日常工作中很容易地在真实项目中使用他们。 贴士#1. 原地交换两个数字 Python 提供了一个直观的在一行代码中赋值与交换(变量值)的方法,请参见下面的示例: 1 2 3 4 5 6 7 8 x,y = 10 , 20 print (x,y) x,y = y,x print (x,y) #1(10,20) #2(20,10) 赋值的右侧形成了一个新的元组,左侧立即解析(unpack)那个(未被引用的)元组到变量 <a> 和 <b>。 一旦赋值完成,新的元组变成了未被引用状态并且被标记为可被垃圾回收,最终也完成了变量的交换。 贴士#2. 链状比较操作符 比较操作符的聚合是另一个有时很方便的技巧: 1 2 3 4 5 6 7 8 9 10 n = 10 result = 1 <n< 20 print (result) #True result = 1 >n< = 9 print (result) #False 贴士#3. 使用三元操作符来进行条件赋值 三元操作符是 if-else 语句也就是条件操作符的一个快捷方式: [表达式为真的返回值] if [表达式] else [表达式为假的返回值] 这里给出几个你可以用来使代码紧凑简洁的例子。下面的语句是说“如果 y 是 9,给 x 赋值 10,不然赋值为 20”。如果需要的话我们也可以延长这条操作链。 1 x = 10 if (y = = 9 ) else 20 同样地,我们可以对类做这种操作: 1 x = (classA if y = = 1 else classB)(param1,param2) 在上面的例子里 classA 与 classB 是两个类,其中一个类的构造函数会被调用。 下面是另一个多个条件表达式链接起来用以计算最小值的例子: 1 2 3 4 5 6 7 8 9 10 def small(a,b,c): return a if a< = b and a< = c else (b if b< = a and b< = c else c) print (small( 1 , 0 , 1 )) print (small( 1 , 2 , 2 )) print (small( 2 , 2 , 3 )) print (small( 5 , 4 , 3 )) #Output #0#1#2#3 我们甚至可以在列表推导中使用三元运算符: 1 2 3 [m * * 2 if m> 10 else m * * 4 for m in range ( 50 )] #=>[0,1,16,81,256,625,1296,2401,4096,6561,10000,121,144,169,196,225,256,289,324,361,400,441,484,529,576,625,676,729,784,841,900,961,1024,1089,1156,1225,1296,1369,1444,1521,1600,1681,1764,1849,1936,2025,2116,2209,2304,2401] 贴士#4. 多行字符串 基本的方式是使用源于 C 语言的反斜杠: 1 2 3 4 5 multiStr = "select * from multi_row whererow_id< 5 " print (multiStr) #select*frommulti_rowwhererow_id<5 另一个技巧是使用三引号: 1 2 3 4 5 6 multiStr = """select*frommulti_row whererow_id<5""" print (multiStr) #select*frommulti_row #whererow_id<5 上面方法共有的问题是缺少合适的缩进,如果我们尝试缩进会在字符串中插入空格。所以最后的解决方案是将字符串分为多行并且将整个字符串包含在括号中: 1 2 3 4 5 6 multiStr = ( "select*frommulti_row" "whererow_id<5" "orderbyage" ) print (multiStr) #select*frommulti_rowwhererow_id<5orderbyage 贴士#5. 存储列表元素到新的变量中 我们可以使用列表来初始化多个变量,在解析列表时,变量的数目不应该超过列表中的元素个数:【译者注:元素个数与列表长度应该严格相同,不然会报错】 1 2 3 4 5 6 testList = [ 1 , 2 , 3 ] x,y,z = testList print (x,y,z) #->123 贴士#6. 打印引入模块的文件路径 如果你想知道引用到代码中模块的绝对路径,可以使用下面的技巧: 1 2 3 4 5 6 7 8 import threading import socket print (threading) print (socket) #1-<module'threading'from'/usr/lib/python2.7/threading.py'> #2-<module'socket'from'/usr/lib/python2.7/socket.py'> 贴士#7. 交互环境下的 “_” 操作符 这是一个我们大多数人不知道的有用特性,在 Python 控制台,不论何时我们测试一个表达式或者调用一个方法,结果都会分配给一个临时变量: _(一个下划线)。 1 2 3 4 5 6 >>> 2 + 1 3 >>>_ 3 >>> print _ 3 “_” 是上一个执行的表达式的输出。 贴士#8. 字典/集合推导 与我们使用的列表推导相似,我们也可以使用字典/集合推导,它们使用起来简单且有效,下面是一个例子: 1 2 3 4 5 6 7 8 testDict = {i:i * i for i in xrange ( 10 )} testSet = {i * 2 for i in xrange ( 10 )} print (testSet) print (testDict) #set([0,2,4,6,8,10,12,14,16,18]) #{0:0,1:1,2:4,3:9,4:16,5:25,6:36,7:49,8:64,9:81} 注:两个语句中只有一个 <:> 的不同,另,在 Python3 中运行上述代码时,将 <xrange> 改为 <range>。 贴士#9. 调试脚本 我们可以在 <pdb> 模块的帮助下在 Python 脚本中设置断点,下面是一个例子: 1 2 import pdb pdb.set_trace() 我们可以在脚本中任何位置指定 <pdb.set_trace()> 并且在那里设置一个断点,相当简便。 贴士#10. 开启文件分享 Python 允许运行一个 HTTP 服务器来从根路径共享文件,下面是开启服务器的命令: 1 2 3 4 #Python2 python - mSimpleHTTPServer #Python3 python3 - mhttp.server 上面的命令会在默认端口也就是 8000 开启一个服务器,你可以将一个自定义的端口号以最后一个参数的方式传递到上面的命令中。 贴士#11. 检查 Python 中的对象 我们可以通过调用 dir() 方法来检查 Python 中的对象,下面是一个简单的例子: 1 2 3 test = [ 1 , 3 , 5 , 7 ] print ( dir (test)) [ '__add__' , '__class__' , '__contains__' , '__delattr__' , '__delitem__' , '__delslice__' , '__doc__' , '__eq__' , '__format__' , '__ge__' , '__getattribute__' , '__getitem__' , '__getslice__' , '__gt__' , '__hash__' , '__iadd__' , '__imul__' , '__init__' , '__iter__' , '__le__' , '__len__' , '__lt__' , '__mul__' , '__ne__' , '__new__' , '__reduce__' , '__reduce_ex__' , '__repr__' , '__reversed__' , '__rmul__' , '__setattr__' , '__setitem__' , '__setslice__' , '__sizeof__' , '__str__' , '__subclasshook__' , 'append' , 'count' , 'extend' , 'index' , 'insert' , 'pop' , 'remove' , 'reverse' , 'sort' ] 贴士#12. 简化 if 语句 我们可以使用下面的方式来验证多个值: 1 if m in [ 1 , 3 , 5 , 7 ]: 而不是: 1 if m = = 1 or m = = 3 or m = = 5 or m = = 7 : 或者,对于 in 操作符我们也可以使用 '{1,3,5,7}' 而不是 '[1,3,5,7]',因为 set 中取元素是 O(1) 操作。 贴士#13. 运行时检测 Python 版本 当正在运行的 Python 低于支持的版本时,有时我们也许不想运行我们的程序。为达到这个目标,你可以使用下面的代码片段,它也以可读的方式输出当前 Python 版本: 1 2 3 4 5 6 7 8 9 10 import sys #DetectthePythonversioncurrentlyinuse. if not hasattr (sys, "hexversion" ) or sys.hexversion! = 50660080 : print ( "Sorry,youaren'trunningonPython3.5n" ) print ( "Pleaseupgradeto3.5.n" ) sys.exit( 1 ) #PrintPythonversioninareadableformat. print ( "CurrentPythonversion:" ,sys.version) 或者你可以使用 sys.version_info >= (3, 5) 来替换上面代码中的 sys.hexversion != 50660080,这是一个读者的建议。 在 Python 2.7 上运行的结果: Python 2.7.10 (default, Jul 14 2015, 19:46:27) [GCC 4.8.2] on linux Sorry, you aren't running on Python 3.5 Please upgrade to 3.5. 在 Python 3.5 上运行的结果: Python 3.5.1 (default, Dec 2015, 13:05:11) [GCC 4.8.2] on linux Current Python version: 3.5.2 (default, Aug 22 2016, 21:11:05) [GCC 5.3.0] 贴士#14. 组合多个字符串 如果你想拼接列表中的所有记号,比如下面的例子: 1 >>>test = [ 'I' , 'Like' , 'Python' , 'automation' ] 现在,让我们从上面给出的列表元素新建一个字符串: 1 >>> print ''.join(test) 贴士#15. 四种翻转字符串/列表的方式 # 翻转列表本身 1 2 3 4 5 testList = [ 1 , 3 , 5 ] testList.reverse() print (testList) #->[5,3,1] # 在一个循环中翻转并迭代输出 1 2 3 4 5 6 for element in reversed ([ 1 , 3 , 5 ]): print (element) #1->5 #2->3 #3->1 # 一行代码翻转字符串 1 "TestPython" [:: - 1 ] 输出为 “nohtyP tseT” # 使用切片翻转列表 1 [ 1 , 3 , 5 ][:: - 1 ] 上面的命令将会给出输出 [5,3,1]。 贴士#16. 玩转枚举 使用枚举可以在循环中方便地找到(当前的)索引: 1 2 3 4 5 6 7 testlist = [ 10 , 20 , 30 ] for i,value in enumerate (testlist): print (i, ':' ,value) #1->0:10 #2->1:20 #3->2:30 贴士#17. 在 Python 中使用枚举量 我们可以使用下面的方式来定义枚举量: 1 2 3 4 5 6 7 8 9 10 11 12 class Shapes: Circle,Square,Triangle,Quadrangle = range ( 4 ) print (Shapes.Circle) print (Shapes.Square) print (Shapes.Triangle) print (Shapes.Quadrangle) #1->0 #2->1 #3->2 #4->3 贴士#18. 从方法中返回多个值 并没有太多编程语言支持这个特性,然而 Python 中的方法确实(可以)返回多个值,请参见下面的例子来看看这是如何工作的: 1 2 3 4 5 6 7 8 9 10 #functionreturningmultiplevalues. def x(): return 1 , 2 , 3 , 4 #Callingtheabovefunction. a,b,c,d = x() print (a,b,c,d) #->1234 贴士#19. 使用 * 运算符(splat operator)来 unpack 函数参数 * 运算符(splat operator)提供了一个艺术化的方法来 unpack 参数列表,为清楚起见请参见下面的例子: 1 2 3 4 5 6 7 8 9 10 11 12 13 def test(x,y,z): print (x,y,z) testDict = { 'x' : 1 , 'y' : 2 , 'z' : 3 } testList = [ 10 , 20 , 30 ] test( * testDict) test( * * testDict) test( * testList) #1->xyz #2->123 #3->102030 贴士#20. 使用字典来存储选择操作 我们能构造一个字典来存储表达式: 1 2 3 4 5 6 7 8 9 10 stdcalc = { 'sum' : lambda x,y:x + y, 'subtract' : lambda x,y:x - y } print (stdcalc[ 'sum' ]( 9 , 3 )) print (stdcalc[ 'subtract' ]( 9 , 3 )) #1->12 #2->6 贴士#21. 一行代码计算任何数的阶乘 1 2 3 4 5 6 7 8 9 10 11 Python 2.x . result = ( lambda k: reduce ( int .__mul__, range ( 1 ,k + 1 ), 1 ))( 3 ) print (result) #->6 Python 3.x . import functools result = ( lambda k:functools. reduce ( int .__mul__, range ( 1 ,k + 1 ), 1 ))( 3 ) print (result) #->6 贴士#22. 找到列表中出现最频繁的数 1 2 3 4 test = [ 1 , 2 , 3 , 4 , 2 , 2 , 3 , 1 , 4 , 4 , 4 ] print ( max ( set (test),key = test.count)) #->4 贴士#23. 重置递归限制 Python 限制递归次数到 1000,我们可以重置这个值: 1 2 3 4 5 6 7 8 9 10 import sys x = 1001 print (sys.getrecursionlimit()) sys.setrecursionlimit(x) print (sys.getrecursionlimit()) #1->1000 #2->1001 请只在必要的时候采用上面的技巧。 贴士#24. 检查一个对象的内存使用 在 Python 2.7 中,一个 32 比特的整数占用 24 字节,在 Python 3.5 中利用 28 字节。为确定内存使用,我们可以调用 getsizeof 方法: 1 2 3 4 5 6 7 8 9 10 11 12 在Python 2.7 中 import sys x = 1 print (sys.getsizeof(x)) #->24 在Python 3.5 中 import sys x = 1 print (sys.getsizeof(x)) #->28 贴士#25. 使用 __slots__ 来减少内存开支 你是否注意到你的 Python 应用占用许多资源特别是内存?有一个技巧是使用 __slots__ 类变量来在一定程度上减少内存开支。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 import sys class FileSystem( object ): def __init__( self ,files,folders,devices): self .files = files self .folders = folders self .devices = devices print (sys.getsizeof(FileSystem)) class FileSystem1( object ): __slots__ = [ 'files' , 'folders' , 'devices' ] def __init__( self ,files,folders,devices): self .files = files self .folders = folders self .devices = devices print (sys.getsizeof(FileSystem1)) #InPython3.5 #1->1016 #2->888 很明显,你可以从结果中看到确实有内存使用上的节省,但是你只应该在一个类的内存开销不必要得大时才使用 __slots__。只在对应用进行性能分析后才使用它,不然地话,你只是使得代码难以改变而没有真正的益处。 【译者注:在我的 win10 python2.7 中上面的结果是: 1 2 3 #InPython2.7win10 #1->896 #2->1016 所以,这种比较方式是不那么让人信服的,使用 __slots__ 主要是用以限定对象的属性信息,另外,当生成对象很多时花销可能会小一些,具体可以参见 python 官方文档: The slots declaration takes a sequence of instance variables and reserves just enough space in each instance to hold a value for each variable. Space is saved because dict is not created for each instance. 】 贴士#26. 使用 lambda 来模仿输出方法 1 2 3 4 5 import sys lprint = lambda * args:sys.stdout.write( "" .join( map ( str ,args))) lprint( "python" , "tips" , 1000 , 1001 ) #->pythontips10001001 贴士#27. 从两个相关的序列构建一个字典 1 2 3 4 5 6 t1 = ( 1 , 2 , 3 ) t2 = ( 10 , 20 , 30 ) print ( dict ( zip (t1,t2))) #->{1:10,2:20,3:30} 贴士#28. 一行代码搜索字符串的多个前后缀 1 2 3 4 5 print ( "http://www.google.com" .startswith(( "http://" , "https://" ))) print ( "http://www.google.co.uk" .endswith(( ".com" , ".co.uk" ))) #1->True #2->True 贴士#29. 不使用循环构造一个列表 1 2 3 4 5 import itertools test = [[ - 1 , - 2 ],[ 30 , 40 ],[ 25 , 35 ]] print ( list (itertools.chain.from_iterable(test))) #->[-1,-2,30,40,25,35] 贴士#30. 在 Python 中实现一个真正的 switch-case 语句 下面的代码使用一个字典来模拟构造一个 switch-case。 1 2 3 4 5 6 7 8 9 10 def xswitch(x): return xswitch._system_dict.get(x, None ) xswitch._system_dict = { 'files' : 10 , 'folders' : 5 , 'devices' : 2 } print (xswitch( 'default' )) print (xswitch( 'devices' )) #1->None #2->2 本文转自 baby神 51CTO博客,原文链接:http://blog.51cto.com/babyshen/1916211,如需转载请自行联系原作者
优秀的个人博客,低调大师

玩转Android monkey之monkey小实战

环境介绍 l 模拟器里安装手机百度APP l 本机通过monkey命令进行随机测试 l 所有的命令均在cmd命令模式下输入 执行过程 语法:adb shell monkey -p 包名 随机事件次数,如下图 PS:每个人的环境不一样,结果可能会略微有差异 如何查看包名在《手机APP测试系列视频》中讲过(http://edu.51cto.com/topic/498.html),此处不再重复 本文转自 小强测试帮 51CTO博客,原文链接:http://blog.51cto.com/xqtesting/2049603,如需转载请自行联系原作者

优秀的个人博客,低调大师

Citrix小贴纸---Citrix Receiver for BlackBerry 1.0

Citrix Receiver for BlackBerry 1.0 支持BlackBerry手机型号: Stortm2 Tour Bold 9000/9700 Curve 8350i Curve 8350/8900Series 不支持型号:Storm 9530, Curve 8300,8310,8320,8800 安装方式: 1\使用BlackBerry登录到:http://www.citrix.com/blackberryinstall 2\选择并下载一个版本Citrix Receiver for Blackberry 版本有:Citrix Receiver(普通版本,不带屏幕触摸功能所用版本) Citrix Receiver--Touch Device(带屏幕触摸所用版本) 3、在BlackBerry Download文件夹内打到刚刚下载的Citrix Receiver应用程度,启动他。 4、设置Citrix服务器地址,以及自己Citrix账号,点击Save。 5、此时即可连接Citrix. 本文转自zhxhua51CTO博客,原文链接:http://blog.51cto.com/virtualtop/393604,如需转载请自行联系原作者

优秀的个人博客,低调大师

小谈React、React Native、React Web

React有三个东西,React JS 前端Web框架,React Native 移动终端Hybrid框架,React Web是一个源码转换工具(React Native转 Web,并之所以特别提出,是觉得还有些用处)。 React、React Native共同特点 起源 Facebook 的内部项目 理念 Learn once, write anywhere,而不是Write once, run anywhere。简单说就是,让你在Web、Mobile原生的开发套路一样,但你还是需要写两套代码。Web Components的理解与实现。 开发工具 普通文本编辑器、Notepad++等即可 代码写法 支持ES6,组件化,看起来像NodeJS,所有代码是写在js里的,无论是样式还是模板。 组件化 易复用:组件的复用变得非常容易,它们都是独立的。 利解耦:使得组件的实现关注分离,利于解耦,更容易被理解和维护。 规范性:利用到ES6的模块加载和导出,使得代码简单就能按规范的写。也因为规范实现,使得Github上有的,就可以拿来用。 可组合:一个组件易于和其它组件一起使用,或者嵌套在另一个组件内部。如果一个组件内部创建了另一个组件,那么说父组件拥有(own)它创建的子组件,通过这个特性,一个复杂的UI可以拆分成多个简单的UI组件。 React 框架目的 基于组件化的开发,所以最终你的页面应该是由若干个小组件组成的大组件。 浏览器兼容 IE8+ 运行方式 一般需要先一层编译,或者解析 PS:React JS我并没有用过,不过写法是React Native一样。 React Native 框架目的 用js开发出效果接近原生的Android、iOS应用。原因UI组件是原生实现原因,效果是相近原生的。(做得像原生,那就得用原生做) PS:目前Saas Link里面的应用的效果在Android机器还是不大好 开发环境 iOS、Android按照官方文档搭建,大概1个小时。 开发调试 1. 能够在Chrome调试js,debug 2. 由于组件由原生渲染,不能调试View 代码风格 JSX 是一个看起来很像 XML 的 JavaScript 语法扩展。 组件生命周期 http://www.tuicool.com/articles/nu6zInB 提供植入原生应用 它很容易嵌入到一个并非由React Native开发的应用当中。作为应用的一部分。 React js的代码能不能直接转React Native? ReactJs和React Native的原理是相同的,都是由js实现的虚拟dom来驱动界面view层渲染。 只不过ReactJs是驱动html dom渲染; React Native是驱动android/ios原生组件渲染。 真不能转~ 真不能Write once, run anywhere? 淘宝前端团队(FED)把 React Native 的组件做了一个 Web 端的实现,并提供相关打包工具,让你可以直接打包出一份可以跑在 Web 端的代码。——React-Web PS:http://www.jianshu.com/p/b5a91a503e6e PS:我在本地尝试过,没跑起来,不过据说是可以的。 不过即便是能够转换,需要面对几个问题: 1. 这个转换的工具能否及时跟上React Native发展。 PS:要是这个团队不维护了或更新不及时(目前已经存在这种问题),这种依赖挺麻烦。 2. 存在转换不了的React Native原生功能,这部分还需要做兼容。 3. 没有完善的社区论坛,有问题解决不了。(目前只是在Github) 本文为原创文章,转载请保留原出处,方便溯源,如有错误地方,谢谢指正。 本文地址 :http://www.cnblogs.com/lovesong/p/5679734.html 本文转自 海角在眼前 博客园博客,原文链接: http://www.cnblogs.com/lovesong/p/5679734.html,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册