首页 文章 精选 留言 我的

精选列表

搜索[HTAP架构],共10000篇文章
优秀的个人博客,低调大师

Linux集群架构介绍

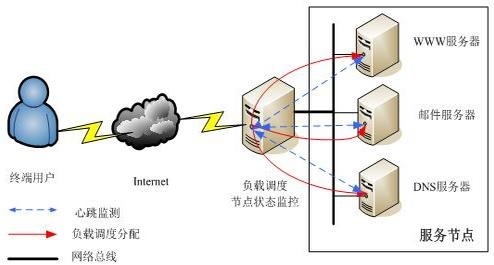
▎根据功能划分为两大类: 高可用 负载均衡 高可用 高可用集群通常为两台服务器,一台工作,另外一台作为冗余,当提供服务的机器宕机,冗余将接替继续提供服务。 实现高可用的开源软件有:heartbeat、keepalived等,其中heartbeat这款软件在CentOs6上面的bug略多,假如主服务器宕机,备用服务器不可以在短时间正常切换提供服务,而且长时间没有更新,所以不建议使用。 负载均衡 负载均衡集群,需要有一台服务器作为分发器,它负责把用户的请求分发给后端的服务器处理,在这个集群里,除了分发器外,就是给用户提供服务的服务器了,这些服务器数量至少为2台。 实现负载均衡的开源软件有LVS、keepalived、haproxy、nginx,商业的有F5、Netscaler,商业的价格比较昂贵,优点:高并发量支持,稳定性不错,如果使用开源的软件去搭建,其稳定性在于设备, keepalived通过VRRP(Virtual Router Redundancy Protocl)来实现高可用。 在这个协议里会将多台功能相同的路由器组成一个小组,这个小组里会有1个master角色和N(N>=1)个backup角色。 master会通过组播的形式向各个backup发送VRRP协议的数据包,当backup收不到master发来的VRRP数据包时,就会认为master宕机了。此时就需要根据各个backup的优先级来决定谁成为新的mater。 Keepalived要有三个模块,分别是core、check和vrrp。其中core模块为keepalived的核心,负责主进程的启动、维护以及全局配置文件的加载和解析,check模块负责健康检查,vrrp模块是来实现VRRP协议的。 本文转自Grodd51CTO博客,原文链接:http://blog.51cto.com/juispan/1963995 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Exchange Server 2010 架构拓扑

前段时间一直忙于测试,发布的都是些配置文档,这次给大家呈现下Exchange邮件系统的规划拓扑。 拓扑说明: 2台CAS和HUB服务器,CAS和HUB角色服务器安装在一起,CAS角色服务器组成一个CAS Array阵列 负载平衡,HUB角色服务器负责Internet邮件和Internal邮件,其中路由传输路由冗余;2台Mailbox服务器挂接SAN(FC)存储设备存放邮箱数据库,并组成一个DAG组,NLB+DAG实现邮件系统高可用; 2台DC负责目录服务;1台MailGateway负责病毒及垃圾邮件过滤。 本文转自liang_simon51CTO博客,原文链接:http://blog.51cto.com/shubao ,如需转载请自行联系原作者

优秀的个人博客,低调大师

mozilla的分层IO架构

mozilla的IO实现是分层的,本质上和BIO是一样的,只是写法不同罢了,最上层,mozilla封装了一个结构体: struct PRFileDesc { const PRIOMethods *methods; //本层的IO函数的实现 PRFilePrivate *secret; PRFileDesc *lower, *higher; //上下两层,如此所有的层次可以三个三个连成链表 void (PR_CALLBACK *dtor)(PRFileDesc *fd); PRDescIdentity identity; //标识 }; 关于mozilla对分层io描述符的实现请参考nsprpub/pr/src/io/prio.c和nsprpub/pr/src/io/prlayer.c,特别值得一提的是最具有代表性的push操作: PR_IMPLEMENT(PRStatus) PR_PushIOLayer(PRFileDesc *stack, PRDescIdentity id, PRFileDesc *fd) { PRFileDesc *insert = PR_GetIdentitiesLayer(stack, id); if (stack == insert) { //插入在当前IO栈的顶端 PRFileDesc copy = *stack; *stack = *fd; *fd = copy; fd->higher = stack; stack->lower = fd; stack->higher = NULL; } else { //插入在当前IO栈的任意位置 fd->lower = insert; fd->higher = insert->higher; insert->higher->lower = fd; insert->higher = fd; } return PR_SUCCESS; } 和OpenSSL的BIO_push是十分类似的,只是BIO_push只能在顶端push,是真正的push,而mozilla的实现命名为insert倒是更好。类似的,PR_CreateIOLayerStub和OpenSSL的BIO_new很类似,都是初始化一个新的“要插入”的io描述符,BIO_next在mozilla中直接通过结构体引用,即fd->lower,BIO中的BIO_METHOD实现了本层的io策略,而mozilla的prio实现中的PRIOMethods起着同样的作用。 通过使用PRFileDesc以及prio所提供的众接口,你可以将一系列的io例程堆积在一起,形成一个io栈,这就是分层的思想。分层的IO可以很方便的加入任何自定义的过滤策略和数据加工策略。突然想到,windows操作系统的drivers目录下有一个叫做tcpip.sys的文件,而unix在/dev目录下亦有一个ip,tcp文件。 本文转自 dog250 51CTO博客,原文链接:http://blog.51cto.com/dog250/1271799

优秀的个人博客,低调大师

可伸缩架构简短系列

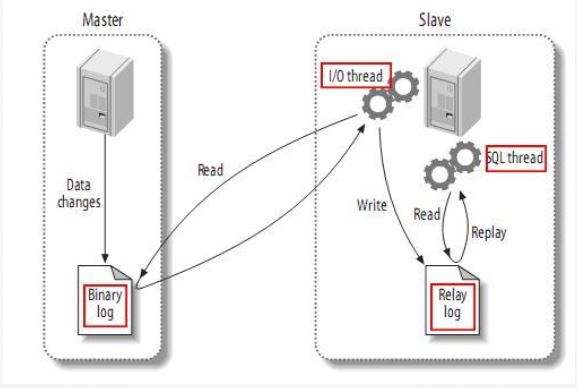
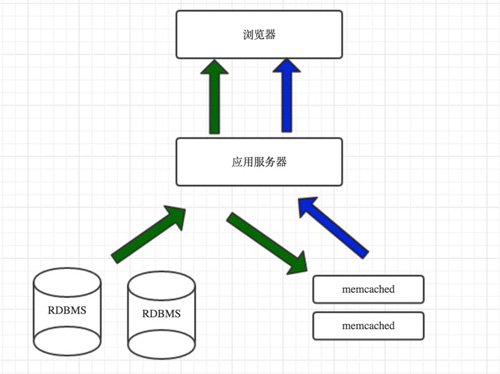
克隆 通常来说,公共服务器上的一个可伸缩的web服务总是隐藏在一个Load Balancer(负载均衡器)之后。这个负载均衡器会将负载(来自用户的请求)均匀的分配到一组服务器或者服务器集群。那意味着什么?举个例子:某个用户访问你的服务,他第一次的请求可能会由第二台服务器提供,第二次请求由第9台服务器提供,第3次请求又再次由第二台服务器提供。 对于该用户而言,他每次得到的结果应该是一样的,不依赖服务到底是哪台服务器提供的。这个正是可伸缩性的第一个黄金法则:每个服务器都包含完全相同的代码库,不在本地磁盘或内存存储任何与用户相关的数据,如session或用户信息。Session需要集中存储,使得每一台服务器都可以访问到它。它可以是一个外部数据库或外部持久缓存,比如Redis。相比外部数据库,在持久化的缓存中存放session将会有更好的性能。这里提到的“外部”指的是数据存储不放置在这些应用服务器上,而是在接近您的应用程序服务器的数据中心。 但是这要怎么部署呢?你如何确定当应用代码发生了改变能够发送到所有的服务器而没有一台服务器依旧使用之前的代码?幸运的是,这个棘手的问题已经被一个很好的工具capistrano解决了,你需要稍微学习了解下。 在解决了session和多台服务器上新版本的同步更新问题之后,你需要做的就是克隆你的机器镜像了,然后将你最新的代码部署上去。可以参考Amazon提供的AMI服务(Amazon Machine Image) 现在你的服务器可以水平扩展,并且处理成千上万的并发请求了。 数据库 但是你发现应用程序变得越来越来最终崩溃。问题的原因:是MySql,不是吗? 现在不是增加更多的机器可以解决的问题了,你有两种办法: 1,坚持使用MySql,并且让它运行良好。做主从复制(从服务器负责读取,主服务器负责写入),并且升级主服务器,不断加入更多的内存。随着不断优化,你会使用数据库分片、反规模化、SQL调优等常用手段。这时,对于数据库的任何一个操作成本都会变得相当昂贵。 2,切换到一个更加容易扩展的NoSQL数据库,比如 MongoDB或CouchDB,连接查询现在需要在应用代码层里去进行了。 现在,你的数据库有了一个可扩展的解决方案了,你再也不用担心存储TB级的数据,世界看起来那么的美好。 缓存 当大量的数据请求发往到数据库,你发现又变慢了,解决办法是增加缓存。 这里说的缓存指的是内存缓存,比如常见的内存数据库Memcached或者Redis,千万不要使用文件缓存,它会让你服务器的克隆和自动伸缩很痛苦。 但是回到内存缓存,缓存是一个简单的键值存储并且应该介于应用程序和数据存储。任何时候当你的应用程序需要去读取数据时,它首先应该尝试从缓存里面获取数据,只有无法从缓存中读取数据时,才会尝试从数据库中读到。为什么要这么做呢?因为缓存快如闪电,它将数据集存放在内存中,并且可以快速的被处理。举个例子:Redis没秒钟可以处理成千上万的读操作。 访问流程:第一次访问绿色,第二次和之后的蓝色: 有两种缓存数据的模式,一种是老的方式,一种是新的方式: 1,缓存数据库查询,这个仍然是最普遍的缓存方式,当你做一次查询时,将数据集进行缓存,通过哈希后查询串作为键。下一次查询时,检查缓存中是否有结果。这种方式存在一些问题,最主要的问题就是过期。当数据表中的一块数据发生变化时,你需要删除所有包含这个数据块的查询串的缓存。 2,缓存对象,我强烈推荐使用这种方式,这也是我经常使用的。 一些适合缓存的对象: 用户Session(永远不存放在数据库中) 完全呈现的博客文章 活动流 用户<- -> 朋友 之类的关系 异步 请想象一下,你想在你最喜欢的面包店买面包,所以你走进面包店,向一个店员询问购买面包,但是面包都卖光了。你被告知2个小时之后你订的面包可以好,这个很恼人,不是吗? 为了避免这种“请等片刻”的场景,需要采取异步。比如什么时候有面包了,店员会将面包派送给你的家里。通常来说,有两种异步的范例: 1,让我们回到普通的买面包的场景,第一种异步处理流程是:“晚上把面包都烹制好,第二天早上卖”,这个对于顾客来说不需要等待。对于一个web应用程序,这意味着提前做耗时的工作,这样就可以在短时间处理完工作。通常这种模式用来将动态的内容转换为静态内容。比如提前渲染好CMS里面的一些网页,并且本地存储这些HTML文件。采用定时任务,可能是通过脚本叫做每小时的计划。这种对通用数据预先计算可以极大的提升网站和web app的可伸缩性和性能。可以通过脚本将这些预先渲染好的HTML页面发布至CDN。你的网站将能做到响应超快并且每小时可以处理成千上万的游客! 2,回到面包店,有的时候顾客可能会有一些特殊的需求,不然在面包上加上“生日快乐”等装饰。面包店并不能提前知道这种顾客类型的需求,所以当顾客来到店里后,必须马上开启一个任务并且告诉他:”你明天再来吧!“ 对于web而言,这意味着异步任务。这里有一个典型的工作流:一个用户来到你的网站,开始一项计算密集型任务,这个任务需要花费几分钟来完成,所以网站前端会往任务队列里面发送一个任务,并且告诉用户你的任务已经在处理中了,你可以继续浏览网页了。一个任务队列会不断的被处理任务的workers 检查处理。如果有一个新任务,work会处理这个任务,过了几分钟之后会发送一个处理完毕的消息信号。前端会不断的检查(比如轮询)这个任务是否已经处理完,一旦处理完则通知用户。如果你想更深入了解,推荐你去看看RabbmitMQ),Rabbit MQ是一个实现了异步消息队列的优秀中间件。你也可以使用ActiveMQ或者一个简单的Redis list,异步消息队列看起来很复杂,但是它值得你花时间去学习和实现。 如果你做一些耗时的操作,试着采用异步。 本文转自xsster51CTO博客,原文链接:http://blog.51cto.com/12945177/1932208,如需转载请自行联系原作者

优秀的个人博客,低调大师

ASP.NET处理架构

Web服务器的消息流动阶段 当装载(hosting) ASP.NET 的 Web 服务器接收到 HTTP 请求时,HTTP 聆听程序 (HTTP Listener) 会将请求转交给 URL 指定的网站应用程序的工作流程 (Worker Process),ASP.NET 的工作流程处理器(aspnet_isapi.dll,若是 IIS 5.0 时则是 aspnet_wp.exe)会解析 URL,并启动位于 System.Web.Hosting 命名空间中的 ISAPIRuntime(视版本)对象,接收 HTTP 请求,并调用HttpRuntime,运行 HttpRuntime.ProcessRequest(),在 ProcessRequest() 中使用 HttpApplicationFactory 创建新的HttpApplication(或是指定的 IHttpHandler 处理器),再分派给 Page 中的 ProcessRequest() 或是 IHttpHandler 的 ProcessRequest() 方法,运行之后,再传回到 ISAPIRuntime,以及 aspnet_isapi.dll,最后交由 HTTP Listener 回传给客户端,因为运行程序有如管线般顺畅的运行,因此称为HTTP Pipeline Mode。 在 ASP.NET 内部的 HTTP 处理器有: ISAPIRuntime:由 aspnet_isapi.dll 调用,初始化 HttpWorkerRequest 对象(会由IIS的版本决定要初始化的版本)。 HttpRuntime:提供请求队列 (Request Queue)、调用 HttpWorkerRequest 中的 ProcessRequest() 方法,以及后续的处理工作。 HttpWorkerRequest:产生 HttpApplication、HttpRequest、HttpResponse 等基础对象的 HTTP 请求对象,并将要求转送到要处理的对象(并调用它的 ProcessRequest() 方法)。 IHttpHandler 与 IHttpAsyncHandler:负责处理 HTTP 请求的单元,由 ProcessRequest() 来分派与运行请求。 ASP.NET网页中的事件程序 当 HttpWorkerRequest 调用ASP.NET 网页(System.Web.UI 命名空间的 Page 类)的 Page.ProcessRequest() 方法时,它会依序的引发 Page 内的各个事件,并同时调用在 Page 中所有控件的相关事件,其引发顺序为: PreInit 事件:运行预先初始化的工作,在ASP.NET 2.0中,若要动态调整主版页面 (Master Page)、主题 (Theme) 时,要在这个事件中调整。 Init 事件:运行初始化工作。 InitCompleted 事件:在完成初始化工作后引发。 Preload 事件:运行预先加载的工作。 Load 事件:运行加载的工作,大多数的网页都拥有 Page_Load 事件处理程序,用户控件 (user control) 中也有 Page_Load 事件例程,都会在此时调用。 控件的 PostBack 变更通知:当网页侦测到是 PostBack 要求时,会引发 PostBack 消息通知的事件。 控件的 PostBack 相关事件:当网页侦测到是 PostBack 要求时,会引发 PostBack 消息指定的控件的事件。 LoadCompleted 事件:运行加载完成后的工作。 PreRender 事件:处理在产生 HTML 结果前的工作。 SaveStateCompleted 事件:处理页面状态(ViewState 与 ControlState)存储完成后的事件。 Render 事件:处理产生 HTML 的工作。 Unload 事件:处理退出网页处理时的工作。 如果 HttpWorkerRequest 调用的是实现 IHttpHandler 接口的HTTP 处理程序时,它只会调用 IHttpHandler.ProcessRequest() 方法,由它来处理程序的输出,不像 Page.ProcessRequest() 会处理事件顺序,因此 HTTP Handler 很适合轻量级的数据处理,像是输出文件数据流或是图片数据流等。 ASP.NET的事件模型 ASP.NET 的原始设计构想,就是要让开发人员能够像 VB 开发工具那样,可以使用事件驱动式程序开发模式 (Event-Driven Programming Model) 的方法来开发网页与应用程序,若要以ASP技术来做到这件事的话,用必须要使用大量的辅助信息,像是查询字符串或是窗体字段数据来识别与判断对象的来源、事件流向以及调用的函数等等,需要撰写的代码量相当的多,但 ASP.NET 很巧妙利用窗体字段和JavaScript脚本把事件的传递模型隐藏起来了。 ASP.NET 的事件模型是由 <form runat="server"></form> 以及数个 Hidden Field 组合而成,基于 HTTP 模型的限制,所有的网页程序在运行结果输出到客户端后,程序就会退出运行,为了维护在 ASP.NET 网页与控件的状态数据,因此在输出 ASP.NET 控件时,ASP.NET 会将部分状态数据存储到网页的 Hidden Field 中,这类型的状态数据称为ViewState(ID 为 __VIEWSTATE),在服务器端即会被解译出状态与事件数据。在大多数的自带 Web 控件中都有使用到这个机制,因此在使用大量 ASP.NET Web 控件的网页中,会有许多的 ViewState 会存放在网页中并随着 HTTP 数据流输出到客户端,ViewState 在输出时,会被加密为一组乱码字符串,其金钥值定义在电脑中,并且每一个对象都会被串行化 (serialize) 成字符串(因此若是自定义对象要放到 ViewState 时,则应要让它支持串行化),再输出到 __VIEWSTATE 字段中,在每次的网页来回时都会被传输,较大的 ViewState 会让网页大小膨胀,不利于快速的网络传输,不过 ASP.NET 本身有提供将 ViewState 关闭的功能,因此如果控件不需要状态保存时,可将它关闭以减少输出的大小。 为确保控件的事件能够确实被引发,让事件驱动能够被运行,因此控件事件引发命令时需要的参数,是交由 JavaScript 脚本在客户端引发时,填入另一个 Hidden Field(ID 为 __EVENTTARGET 以及 __EVENTARGUMENT),并且引发窗体的提交指示 (submit),传送到服务端后,服务端的 HttpApplication 中的工具函数会解析 __EVENTTARGET 和 __EVENTARGUMENT 字段中的信息,并且交由控件所实现的 RaisePostBackEvent() 来引发事件,并由 .NET Framework 内部的事件处理机制接手处理(调用控件设置的事件处理程序)。 ASP.NET的来回模式 在 ASP.NET 运行的时候,经常会有网页的来回动作 (round-trip),在 ASP.NET 中称为PostBack,在传统的 ASP 技术上,判断网页的来回是需要由开发人员自行撰写,到了 ASP.NET 时,开发人员可以用 Page.IsPostBack 机能来判断是否为第一次运行(当 ASP.NET 发现 HTTP POST 要求的数据是空值时),它可以保证 ASP.NET 的控件事件只会运行一次,但是它有个缺点(基于 HTTP POST 本身的缺陷),就是若用户使用浏览器的刷新功能(按 F5 或刷新的按钮)刷新网页时,最后一次运行的事件会再被运行一次,若要避免这个状况,必须要强迫浏览器清空高速缓存才可以。 ASP.NET 2.0 中有新增三个来回模式: Cross Page Postback:允许跨不同的网页运行 PostBack,服务端可使用 Page.IsCrossPostBack 来判断是否是跨网页型的来回。 Async Page Mode:允许网页使用异步的方式运行,服务端可用 Page.IsAsync 来判断。 Callback:ASP.NET 2.0 新增的由网页回呼客户端指令的功能,服务端可用 Page.IsCallback 来判断是否要求是来自 Callback。 来回模式不仅是 ASP.NET 运作时的核心,它也是 ASP.NET 应用程序的一个主要缺点,尤其是在设计复杂度高的页面时,在网页中隐藏的 ViewState 的大小会相当大,而在每次的来回动作中,都会传送 ViewState 在内的窗体信息,大量的 ViewState 会使得传送的时间拉长,而且每次来回动作都会让整个网页被刷新,而出现闪烁的情况(就算在本地端也一样),但在AJAX技术尚未成熟时,只能够忍受这种因底层限制所带来的问题,在ASP.NET AJAX技术发展出来后,通过UpdatePanel成功的缓解了这个问题(但 ViewState 传送的问题仍然未根本的解决,必须要使用像 Page Method 这样的方式才能彻底的解决)。 脚本 ASP.NET 的 Web 控件有时会包装一些客户端脚本 (client-side scripting),在控件被绘制时输出到客户端,这些脚本多数被包装在 DLL 的资源档中,并由 ScriptResource.axd 处理程序来输出,开发人员也可以利用 ClientScriptManager(Page.ClientScript 属性)中的方法来添加脚本到网页程序中,常用的方法有: ClientScriptManager.RegisterClientScriptBlock():注册客户端脚本区块 (script block)。 ClientScriptManager.RegisterStartupScript():注册在起始时运行的脚本。 ClientScriptManager.RegisterOnSubmitStatement():注册在处理窗体发送时要运行的脚本。 ClientScriptManager.RegisterClientScriptInclude():注册由外部文件 (.js) 提供的脚本来源。 基本对象 以往在 ASP 中常被使用的五大基本对象,在 ASP.NET 中仍然持续被支持,但它们都换了一个身份来提供: Application:包装了 HttpApplication 对象,在程序中使用 Application 指令取得的对象,都是来自于 HttpContext.Current.Application 属性回传而得。 Request:包装了 HttpRequest 对象,在程序中使用 Request 指令取得的对象,都是来自于 HttpContext.Current.Request 属性回传而得。 Response:包装了 HttpResponse 对象,在程序中使用 Response 指令取得的对象,都是来自于 HttpContext.Current.Response 属性回传而得。 Session:包装了 HttpSessionState 对象,在程序中使用 Session 指令取得的对象,都是来自于 HttpContext.Current.Session 属性回传而得。 Server:包装了 HttpServerUtility 对象,在程序中使用 Server 指令取得的对象,都是来自于 HttpContext.Current.Server 属性回传而得。 延展性支持 除了 ASP.NET 网页以外,.NET Framework 还提供了两种可以由开发人员自行发展处理模型的模块,一种是HTTP Handler,另一种则是HTTP Module。 HTTP Handler(扩展名为 .ashx)由 System.Web.IHttpHandler 接口定义了必要的方法(可支持异步的 HTTP Handler 称为 HTTP Async Handler,由 System.Web.IHttpAsyncHandler 接口定义),其中最重要的方法是 ProcessRequest() 方法,开发人员必须要实现这个方法,才能够让 HTTP Handler 有作用,它也可以通过 ASP.NET 的组态设置,让 HTTP Handler 可以处理特定的扩展名,它可以被视为 .NET Framework 中的 ISAPI Extensions 实现方法。 HTTP Module 则是由 System.Web.IHttpModule 接口定义,它可以在整个网页生命周期中被调用多次,并实际处理由 HttpApplication 所引发的事件,开发人员需要实现 IHttpModule.Init() 方法,以及处理 HttpApplication 事件需要的代码。它可被视为 .NET Framework 中的 ISAPI Filter 实现方法。 本文转自cnn23711151CTO博客,原文链接:http://blog.51cto.com/cnn237111/591271,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册