首页 文章 精选 留言 我的

精选列表

搜索[高性能rpc框架],共10000篇文章
优秀的个人博客,低调大师

解析内存中的高性能图结构

在进行各种图处理、图计算、图查询的时候,内存或是硬盘中如何存储图结构是一个影响性能的关键因素。本文主要分析了几种常见的内存图结构,及其时间、空间复杂度,希望对你有所启发。 通常来说,对于图结构的几种常见的基础操作: 插入一个点 插入一个边 删除一个边 删除一个点的全部邻边 找到一个点的全部邻边 找到一个点的另一个邻点 全图扫描 获取一个点的入度或者出度 这些图相关的操作,除了要关心时间复杂度之外,需要考虑空间占用的问题。 对于大多数实时读写型的系统,增删改查的性能问题会比较重要,它们比较关注上面 1-6 的操作;对于部分密集计算的系统,对批量读取的性能会比较重视,侧重上面 5-8 的操作。 不过遗憾的是,无论是常规的图查询,还是进阶的图计算,根据 RUM 猜想[1],读快、写快、又省空间这样”既要又要也要”的好事是不存在的。 下面,我们介绍几个数据结构并给出少量的定量分析。 我们先从三个典型的方案(邻接矩阵、压缩稀疏矩阵和邻接表)说起,再介绍几种近几年的研究的变种结构 PCSR、VCSR、CSR++。 邻接矩阵 Adjacency Matrix 用矩阵来表示图结构是大学里数据结构课程中都学过的知识,也是一种非常直观的办法。 点 i 与点 j 之间有一条边,等价对应于矩阵上 $M_{ij}$ 为 1。当然,这里的点 ID 是需要连续排列无空洞。 用矩阵来表示图结构有明显的好处,可以复用大量线性代数的研究成果:比如图上模式匹配类的问题等价于矩阵的相乘。 下面是一个模式匹配问题,它的大体意思是在全图上寻找这样一种图结构: Match (src)-[friend * 2..4]->(fof) WHERE src.age > 30 RETURN fof 对于这样一个问题可以直接对应右边的矩阵操作: 比如,2 跳遍历等价于矩阵 F 自乘;2 - 4 跳遍历分别等价于 F^2、F^3、F^4;取属性等价于乘以一个过滤矩阵。 更进一步,由于矩阵操作是天生可以分块并行加速,这在性能上有极大的优势。 下面,我们对邻接矩阵操作进行一个简单的定量分析 操作 时间复杂度 备注 插入一个点 O(n^2) 对于矩阵来说,增加一个点意味着整个矩阵的维度增加,通常需要另外开辟一块空间 插入一个边 O(1) 增加一个边只是将对应的位置置 1 删除一个边 O(1) 置0 删除一个点的全部邻边 O(n) 对于某个点所有出边的删除对应某一行的置0。入边对应某一列,可以批量操作 找到一个点的全部邻边 O(n) 找到一个点的给定邻点 O(1) 全图扫描 O(n^2) 其中,n=|V|,m=|E|。 优化上,批量操作(CPU Cache/SSD block)可以线性增加性能,例如 O(n) 可以降低到 O(n/B),但不影响定量分析。 由于绝大多数图结构是极其稀疏的,因此简单用邻接矩阵来表示图结构,其内存会有夸张的浪费。更为严重的是,当有多种边类型时,每种边类型各需要一个邻接矩阵。这使得裸用矩阵在实际情况中只能处理很小数据量的场景。当然,对于现代服务器动辄几百 G 的内存,如果只有几亿点边的数据量,像是 twitter2010,这并不会是很严重的问题。但大多数情况下,条件允许的话,大家还是希望找到一些更加经济的结构。 压缩稀疏矩阵 CSR/CSC 压缩稀疏矩阵是一种非常流行和紧凑的图结构表示方式,大多数图计算系统都采用 CSR。 这里简单介绍一下 CSR 的结构: 对于点 IDx,取邻居 ID 就是 F[N[x]] 到 F[N[x+1]-1]。 例如,查找点 ID2 的邻居,对应为 F[N[2]] 到 F[N[2+1]-1],对应到上图也即 1 6 8。查找点 ID7 的邻居,对应为 F[N[7]] 到 F[N[7+1]-1],也就是 2 和 4。 另外,CSR 记录的仅是出边的信息,如果要考虑入边就使用 CSC,其原理是类似的。 操作 时间复杂度 备注 插入一个点 O(1) 在点矢量尾部增加 插入一个边 <u,v> O(m+n) 边矢量,从 u 对应的邻居开始,都向后移动一位;点矢量,从 u 对应位置开始每个值加 1 删除一个边 O(m+n) 插入边的逆过程 删除一个点 v 的全部邻边 O(m+n) 边矢量移动 deg(v) 位,点矢量 u 对应位置置 0 找到一个点的全部邻边 O(deg(v)) 找到一个点的给定邻点 O(log(deg(v))) deg(v) 内的排序查找 全图扫描 O(m+n) CSR 的空间占用是 O(|V|+|E|),在空间节省和顺序查找上是极其高效的。但在大量插入时,压缩稀疏矩阵和邻接矩阵一样,需要重新开辟空间,效率很低。所以,它适合于计算密集场景但不适合增改频繁的场景。 CSR 还有一个显著的优点是可以快速获取每个点的出入度,只要计算 N[x+1]-N[x],这在判断一些点是否为超级节点时很方便。如果不是稀疏矩阵的话,通常会用另外一个单独的结构来记录出入度。 此外,CSR 不容易实现并发修改,其每次插入都需要对两个矢量进行位移,这并不高效。 这里推荐两个相关的开源项目,可以进一步了解下 CSR 的使用: https://github.com/DrTimothyAldenDavis/GraphBLAS https://github.com/GraphBLAS/LAGraph 邻接链表 Adjacency List 和基于矩阵的方式不同,邻接链表 AL 空间上有优势,但对于边的读写上会略微慢一点(指针在内存中不能连续移动)。AL 的做法是把邻边(出边)用 list 或者有序 list 的方式串连起来。由此延伸的一个变种是邻边从 list 改为 array。 操作 时间复杂度 备注 插入一个点 O(1) 尾插入 插入一个边 <u,v> O(log(deg(u))) 有序 list 删除一个边 O(log(deg(u))) 删除一个点 v 的全部邻边 O(1) 找到一个点的全部邻边 O(deg(u)) 找到一个点的给定邻点 O(log(deg(u))) 全图扫描 O(n+m) AL 相比 CSR 通常不能直接获得点的出入度,可以通过可以单独维护一个字段实现该功能。 此外,邻接表并不需要 ID 连续排布,对于频繁增删点的场景特别友好。AL 对于并发修改的支持也更友好,天然在点级别有并行度。当然,对于超级节点,直接用 list 的方式,还是会有些性能的问题要考虑;优化上可能会进一步改造成 Blocked list 的方式,可以带来更好的数据局部性和细颗粒度。 由于 ID 不用严格连续排布,AL 的一个常见变种就是 Tree。 Tree 在这种结构中,一个点和其所有的邻边被建模成了 key-value,key 是点 ID,value 是所有邻边的编码。Key 通过 Tree 的方式组织在一起。这里的树可以是 B-Tree 等各变种 Tree。虽然本文没有讨论图属性,但 value 中也是可以存放 value。 操作 时间复杂度 备注 插入一个点 O(log(n)) 插入一个边 <u,v> O(deg(u) log(n)) 删除一个边 O(deg(u) log(n)) 删除一个点 v 的全部邻边 O(log(n)) 找到一个点的全部邻边 O(deg(u) log(n)) 找到一个点的给定邻点 O(log(n deg(u)) 全图扫描 O(n+m) 为了控制访问颗粒度,每个叶子通常会被限定为固定的大小(页)。这就是在数据库类系统里面最常见的办法 B-tree。为了增改方便,也可以把每页的 in-place update 改成 Copy-On-Write 的方式;一个典型的代表就是 LLAMA[2],但这种多版本的读取通常会需要更多的空间,并且当有大量累积修改时,需要定期的多版本合并以降低跨快照读。某种程度上,它和 LSM-Tree 的思路有些接近。 基于 CSR 的变种 PCSR 和 VCSR 由于 CSR 在空间和读性能上有很大的优势,但在插入时的耗时和空间上都很弱,因此本节几个变种的主要目的都是为了改善其弱项,大体思路都是分块和 buffer。 在 CSR 的边矢量进行增删时可以注意到,主要耗时是在对于矢量的元素位移上。因此,一个直观的思路是预留一些插入空白位,在删除时也不立刻回收这些空白。 而分块思想,是指将一些局部数据放在同一个分块内,例如 Tree 中每个 page 就是一种分块的方式。与此对应的是,buffer 空白之间的连续区域。 PCSR PCSR [3]的基本思想是:对于点矢量,其元素从一个值改为对应边矢量中对应邻边位置的 <起点,终点>。而对于边矢量,在这些分块所对应边界放置哨兵 sentinel,上图中的 S,上图的 “-“ 对应预留插入位置留空。 事实上,原文中,对于边矢量,其本质是实现为一个 B-Tree,本文先简化成一个 Array。 操作 时间复杂度 备注 插入一个点 O(1) 直接在点矢量和边矢量的尾插入 插入一个边 <u,v> O(log(deg(u)) 边矢量对应分片的二分+空位查找 删除一个边 O(log(deg(u)) 删除一个点v的全部邻边 O(1) 边矢量对应分片置空,点矢量对应 ID 位置置空 找到一个点的全部邻边 O(deg(u)) 找到一个点的给定邻点 O(log(deg(u)) 全图扫描 O(n+m) 可以看到,PCSR 的预留位置多少都是需要重平衡,不能过多也不能不足。特别是大批量增删时,对预留位置的处理会是一个较重的操作。 此外,如果把 PMA 的 B-Tree 以及需要 rebalance 的本质考虑进去,其和前述 Tree 方式的区别并不是很大。 VCSR VCSR[4]主要是对 PCSR 的一个改进,其朴素思想是 PCSR 的留空是均匀的,而大多数图结构的出入度,是存在 20-80 这样的幂率特征,而 PCSR 的一个主要痛点是频繁的 rebalance。VCSR 的做法是为每个分块预留空间正比于其分块内的点的数量,即:边矢量中,一个分块内,如果点的数量多,就多预留一些空位。在直觉上,点数量多时,其分块对应的边插入会更多一些,这样可以减少 rebalance 的频率。 此外,VCSR 还有些版本号之类的优化。 CSR++ 事实上,CSR++[5]在设计上其实更接近一种 AL/Tree 的变种,而不是 CSR。它主要有三个方面的优化: 第一,对于 Vertex Array 再分段,将一个大的 Array 拆成多段,这样可以有更细的读写颗粒度。通过 段 ID + 点 ID 来定位每个点和其邻边。 第二,Vertex Array 中每个元素,除了记录点 ID 之外,对于邻边数量很少的点,直接把邻居 ID 也对齐地塞 inline 进去。 对于大多数的点,其邻边就不需要单独的 Edge Array 来存储了。 可以看到这种方式在图比较稀疏的时候,对于 CPU Cache 扫描是很友好的。 第三,对于每个点的邻边,采用copy-on-write、标记删除等常见的优化办法,构建成类似 std::vector 结构。 小结 最后,由于在图查询、图存储和图计算不同场景下,对于图结构的读写扫描和生命周期都有些不同的要求,不同的数据结构也有不同的优劣。 当然,本文只是讨论了图结构可以放在内存中的情况。当不得不把部分数据放在硬盘上时,问题就完全不同了。当然本文也没有讨论不同 CPU 对于不同距离内存的性能差异 NUMA,或者跨进程通信带来的影响。 延伸阅读 最后,我们来了解下在图计算/图算法上的图操作。 图算法中的图操作 在图计算中,存在多种图结构算法,可能会涉及多种基础操作。 中心性 Centrality Algorithms,一种衡量一个节点在整个网络图中所在中心程度的算法,包括:度中心性、接近中心性、介数中心性等,会涉及“找到一个点的全部邻边”、“找到一个点的另一个邻点”、“全图扫描”的操作组合。 度中心性通过节点的度数,即关联的边数来刻画节点的受欢迎程度,这将会要求找到一个点的所有邻边。 接近中心性,通过计算每个节点到全图其他所有节点的路径和来刻画节点与其他所有节点的关系密切程度,这将会要求进行全图扫描,查找点和图中所有点的路径信息。 介数中心性,则用于衡量一个顶点出现在其他任意两个顶点对之间最短路径上的次数,从而来刻画节点的重要性,这将会要求进行全图扫描,找到一个点和它的邻点及路径信息 PageRank,又称网页排名、谷歌左侧排名,是一种由搜索引擎根据网页之间相互的超链接计算的技术作为网页排名的要素之一的排名方法。它以 Google 公司创办人拉里·佩奇 Larry Page 之姓来命名。Google 用它来体现网页的相关性和重要性,在搜索引擎优化操作中是经常被用来评估网页优化的成效因素之一。一般来说,PageRank 的值越高,表示其被很多其他网页链接到,说明它的重要性很高;而如果一个 PageRank 很高的网页链接到其他网页,被链接的网页的 PageRank值也会随之提高。PageRank 的计算过程如下: 假设由 4 个网页组成的集合:A、B、C、D,每个页面的初始 PageRank 值相同,为了满足概率值为 0-1 之间,假设这个值为 0.25。 如果所有页面都只链接至 A,如下图,则 A 点的值将是 B、C、D 的 PageRank 值的和。 倘若是下图这种图结构: B 链接到 C,D 链接到 B 和 C,A 点的值计算的方式如下: 这里的 2、1、3,分别是 B 点对外链接的 2 条边,C 点对外链接的 1 条边,D 点对外链接的 3 条边。 换句话说,算法将根据每个页面连出总数平分该页面的 PR 值,并将其加到其所指向的页面: 最后,所有这些 PR 值被换算成百分比形式再乘上一个修正系数。 由于“没有向外链接的网页”传递出去的 PR 值会是0,这时候如果递归的话,会导致指向它的页面的 PR 值的计算结果同样为零,所以 PageRank 会赋给每个页面一个最小值。 因此,一个页面的 PR 值直接取决于指向它的的页面。如果在最初给每个网页一个随机且非零的 PR 值,经过重复计算,这些页面的 PR 值会趋向于某个定值,也就是处于收敛的状态,即最终结果。 简单来说,大多数迭代图计算模型都是基于“找到一个点的全部邻边”、“找到一个点的另一个邻点”操作。 AIGC 小课堂 在 AIGC 小课堂部分,我们会用 NebulaGraph 接入的 aibot 来讲解下文中的部分概念。你如果对 chatgpt 或者是 aibot 有兴趣,可以来 https://discuss.nebula-graph.com.cn/ 向 aibot 提出你的要求。 参考文献 Athanassoulis, M., Kester, M. S., Maas, L. M., et al. (2016). Designing Access Methods: The RUM Conjecture. In EDBT (pp. 461-466). Macko, P., Marathe, V. J., Margo, D. W., et al. (2015). Llama: Efficient Graph Analytics Using Large Multiversioned Arrays. In 2015 IEEE 31st International Conference on Data Engineering (pp. 363-374). IEEE. Wheatman, B., & Xu, H. (2018). Packed Compressed Sparse Row: A Dynamic Graph Representation. In 2018 IEEE High Performance Extreme Computing Conference (HPEC) (pp. 1-7). IEEE. Islam, A. A. R., Dai, D., & Cheng, D. (2022). VCSR: Mutable CSR Graph Format Using Vertex-Centric Packed Memory Array. In 2022 22nd IEEE International Symposium on Cluster, Cloud and Internet Computing (CCGrid) (pp. 71-80). IEEE. Firmli, S., Trigonakis, V., Lozi, J. P., et al. (2020). CSR++: A Fast, Scalable, Update-Friendly Graph Data Structure. In 24th International Conference on Principles of Distributed Systems (OPODIS'20).

优秀的个人博客,低调大师

高性能链接器 Mold 发布 1.6 版本

Mold 是现有 Unix 链接器的快速替代品,它比 LLVM lld 链接器快几倍。目前 Mold 发布了 1.6 版本,此版本增加了对两个基于 IBM 的平台的支持,主要带来以下更改: 新功能 [ppc64] Mold 现在支持原始的 64 位 big-endian PowerPC ABI(也称为 PPC64 ELFv1 或简称 ppc64),可以使用 Mol d为较旧的 PPC64 系统构建应用程序。请注意,不要与 Mold 已经支持的现代 PPC64 ELFv2 ABI(也称为 ppc64le)相混淆。 [s390x] 现在支持 Linux/s390x,Linux/s390x 是 IBM z/Architecture 大型机上的 Linux 环境。 Mold现在会创建更小的输出文件,这点在具有大页面大小的目标上最为明显,例如 PPC64(其常见页面大小为 64 KiB),但即使在 x86-64 上,它也会为每个输出文件节省几千字节。 错误修复和兼容性改进 [arm64] Mold 现在可以链接带 -static-pie 标志的可执行文件。以前与该标志链接的可执行文件会立即崩溃。 更新公告:https://github.com/rui314/mold/releases/tag/v1.6.0

优秀的个人博客,低调大师

PondPond —— Python 高性能对象池库

PondPond 是一个 Python 中高效的通用对象池,具有性能好、内存占用小、命中率高的特点。基于近似统计的根据频率自动回收的能力,能够自动调整每个对象池的空闲对象数量。 因为目前 Python 目前没有比较好的、测试用例完备、代码注释完备、文档完善的对象池化库,同时目前的主流对象池库也没有比较智能的自动回收机制。Pond 可能是 Python 中第一个社区公开的测试用例完整,覆盖率 90% 以上、代码注释完备、文档完善的对象池化库。 Pond 灵感来自于 Apache Commons Pool、Netty Recycler、HikariCP、Caffeine,集合了多家的优点。其次 Pond 通过使用近似计数的方式以极小的内存空间统计每个对象池的使用频率,并且自动回收。 流量较为随机平均的情况下,默认策略和权重可以降低 48.85% 内存占用,借取命中率 100%。 流量较为符合 2/8 定律的情况下,默认策略和权重可以降低 45.7% 内存占用, 借取命中率 100%。 设计概述 Pond 主要由 FactoryDict、Counter、PooledObjectTree 三部分以及一个单独的回收线程构成。 FactoryDict 使用 Pond 需要实现对象工厂 PooledObjectFactory,PooledObjectFactory 提供对象的创建、初始化、销毁、验证等操作,由 Pond 调用。所以为了让对象池支持存放完全不同的对象,Pond 使用了一个字典来记录每个工厂类的名称和自己实现的工厂类的实例化对象。 每个 PooledObjectFactory 应该具备创建对象、销毁对象、验证对象是否还可用、重置对象四个功能。 比较特别的是 Pond 支持自动重置对象,因为某些场景下可能会存在对象中要先赋值进行传递,传递完又被回收的情况,为了避免污染建议这种场景下无比实现这个功能。 Counter Counter 中保存了一个近似计数器。 PooledObjectTree PooleedObjectTree 是个字典,每个 key 对应着一个先进先出的队列,这些队列都是线程安全的。每个队列中保存着多个 PooleedObject。PooledObejct 保存了创建时间、最后借出的时间以及实际需要的对象。 线程安全 Pond 的借用和回收都是线程安全的。Python 的 queue 模块提供了一个适用于多线程编程的先进先出(FIFO)数据结构。它可以用来安全地在生产者和消费者线程之间传递消息或其他数据。锁是调用者来处理的,所有多个线程能够安全且容易的使用同样的 Queue 实例工作。而 Pond 的借用和回收都是在操作 queue,所以基本可以认为是线程安全的。 借出机制 在使用 Pond 借出一个对象时,会先检查想要借出的对象的种类是否已经在 PooledObjectTree 存在,如果存在会检查这个对象的对象池是否为空,如果为空会创建一个新的。 如果对象池中有多余的对象,会利用 queue 弹出一个对象并验证这个对象是否可用。如果不可用会自动调用所属的 Factory 清理销毁该对象,同时清理它在 Python 中的 GC 计数,让它更快被 GC 回收,不断拿取下一个直至有可用的。 如果这个对象可用,则会直接返回。当然无论是从对象池中取出对象还是新创建了一个对象,都会利用 Counter 增加一个计数。 回收机制 回收一个对象时会判断目标对象池存不存在,如果存在会检查对象池是否已经满了,满了的话会自动销毁要归还的这个对象。 然后会检查这个对象是否已经被借出太长时间,如果超过了配置的最长时间同样会被清理掉。 自动回收 自动回收时每隔一段时间,默认是 300 s,就会执行一次。自动清理不经常使用的对象池中的对象。 使用说明 你可以先安装 Pond 的库并且在你的项目中引用。 pip install pondpond from pond import Pond, PooledObjectFactory, PooledObject 首先你需要声明一个你想要放入的类型的对象的工厂类,比如下面的例子我们希望池化的对象是 Dog,所以我们先声明一个 PooledDogFactory 类,并且实现 PooledObjectFactory。 class Dog: name: str validate_result:bool = True class PooledDogFactory(PooledObjectFactory): def creatInstantce(self) -> PooledObject: dog = Dog() dog.name = "puppy" return PooledObject(dog) def destroy(self, pooled_object: PooledObject): del pooled_object def reset(self, pooled_object: PooledObject) -> PooledObject: pooled_object.keeped_object.name = "puppy" return pooled_object def validate(self, pooled_object: PooledObject) -> bool: return pooled_object.keeped_object.validate_result 接着你需要创建 Pond 的对象: pond = Pond(borrowed_timeout=2, time_between_eviction_runs=-1, thread_daemon=True, eviction_weight=0.8) Pond 可以传递一些参数进去,分别代表: borrowed_timeout:单位为秒,借出对象的最长期限,超过期限的对象归还时会自动销毁不会放入对象池。 time_between_eviction_runs:单位为秒,自动回收的间隔时间。 thread_daemon:守护线程,如果为 True,自动回收的线程会随着主线程关闭而关闭。 eviction_weight:自动回收时权重,会将这个权重与最大使用频次想乘,使用频次小于这个值的对象池中的对象都会进入清理步骤。 实例化工厂类: factory = PooledDogFactory(pooled_maxsize=10, least_one=False) 所有继承了 PooledObjectFactory 都会自带构造函数,可以传递 pooled_maxsize 和 least_one 两个参数。 pooled_maxsize:这个工厂类生成出的对象的对象池的最大能放置的数量。 least_one:如果为 True,在进入自动清理时,这个工厂类生成出的对象的对象池会至少保留一个对象。 向 Pond 注册这个工厂对象,默认会使用 factory 的类名作为 PooledObjectTree 的 key : pond.register(factory) 当然你也可以自定义它的名字,名字会作为 PooledObjectTree 的 key: pond.register(factory, name="PuppyFactory") 注册成功后,Pond 会自动根据 factory 中设置的 pooled_maxsize 自动开始创建对象直至填满这个对象池。 借用和归还对象: pooled_object: PooledObject = pond.borrow(factory) dog: Dog = pooled_object.use() pond.recycle(pooled_object, factory) 当然你可以用名字来进行借用和归还: pooled_object: PooledObject = pond.borrow(name="PuppyFactory") dog: Dog = pooled_object.use() pond.recycle(pooled_object, name="PuppyFactory") 完全清理一个对象池: pond.clear(factory) 通过名字清理一个对象池: pond.clear(name="PuppyFactory") 正常情况下,你只需要使用上面的这些方法,生成对象和回收对象都是全自动的。

优秀的个人博客,低调大师

高性能链接器 Mold 发布 1.4.2 版本

Mold 是现有 Unix 链接器的快速替代品,它比 LLVM lld 链接器快几倍。 目前 Mold 发布了最新版本 1.4.2 ,此版本带来以下新功能和各种错误修复: 新功能和错误修复 [RV32] 修复了 32 位 RISC-V 的几个问题。Mold 现在可以为目标构建复杂的程序,包括它自己。 [ARM32] Mold 获得了范围扩展 thunk,因此它可以链接 .text 大于 16 MiB 的程序。以前 Mold 无法链接这么大的程序。 还修复了 ARM32 的稳定性问题。 创建 Mold 二进制包请注意:请静态链接捆绑的 libtbb(这是默认设置)或使用补丁重建发行版的 libtbb 包,以便 Mold 的链接时间优化(LTO)在重负荷下可靠地工作。 更新公告:https://github.com/rui314/mold/releases/tag/v1.4.2

优秀的个人博客,低调大师

GraphVite —— 通用高性能的图表学习系统

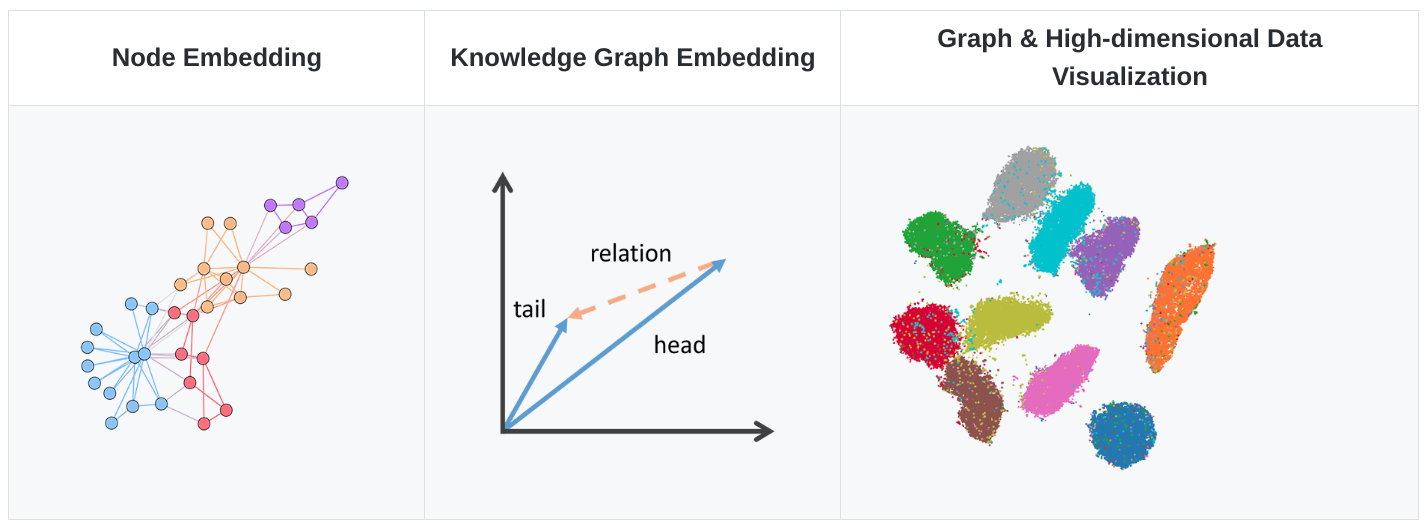
GraphVite 是一个通用图表嵌入引擎,用于在各种应用中进行高速和大规模嵌入式学习。GraphVite 支持多 GPU 并行,在百万节点的图上,只需要一分钟左右的时间学习节点的表示。GraphVite 为 3 类应用提供完整的训练和评估管道:节点嵌入(Node Embedding)、知识图谱嵌入(Knowledge Graph Embedding)和高维数据图表可视化(Graph&High-dimensional data visualization)。 此项目还包括 9 个流行的模型,以及它们在一些标准数据集上的效果。

优秀的个人博客,低调大师

高性能链接器 Mold 发布 1.2.1 版本

Mold 是现有 Unix 链接器的快速替代品,它比 LLVM lld 链接器快几倍。目前 Mold 发布了 1.2.1 版本,带来以下更改 修复 --gdb-index 中的各种错误。 为了与 LLVM lld 兼容,Mold 现在可以识别 --thinlto-cache-dir 和 --thinlto-cache-policy。 (7ebd071) Mold 现在可以处理 TLS 常用符号,GCC 有时会为线程局部变量创建这样的符号。 (cf850f8) 在某些极端情况下,Mold 为同一符号创建了一个非版本化符号和一个版本化符号,即使一个符号被版本化,所有同名符号也必须被版本化。(8298c0a) 修复:Mold 用于将符号的 PLT 地址而不是其地址写入 .symtab。 (e088db7) Mold 现在可以处理超过 219 个符号的输入文件。(f1f2d40) /usr/local/libexec/mold/ld 现在安装为相对符号链接,而不是绝对符号链接。(5803c3c) 更新公告:https://github.com/rui314/mold/releases/tag/v1.2.1

优秀的个人博客,低调大师

BeeCP-3.1.9 发布,高性能 JDBC池

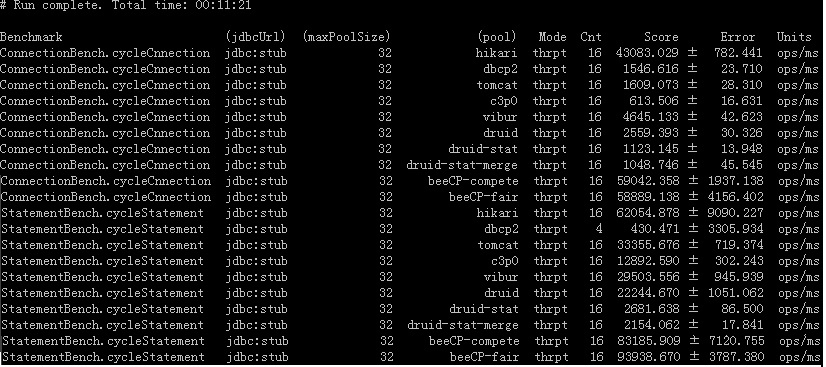
小蜜蜂连接池:一款轻量级JDBC连接池。 1:版本下载(java7) <dependency> <groupId>com.github.chris2018998</groupId> <artifactId>beecp</artifactId> <version>3.1.9</version> </dependency> 2:更新内容 调整配置项名 ‘ connectionTestSQL’ 为‘ connectionTestSql’ 增强连接检查时事务处理 在池化对象上增加onBeforeRemove方法 5:Springboot启动器同步更新 <dependency> <groupId>com.github.chris2018998</groupId> <artifactId>beecp-spring-boot-starter</artifactId> <version>1.5.5</version> </dependency> 6:项目地址 国内地址:https://gitee.com/mirrors/BeeCP 国外地址:https://github.com/Chris2018998/BeeCP

优秀的个人博客,低调大师

高性能异步批量ping的golang实现

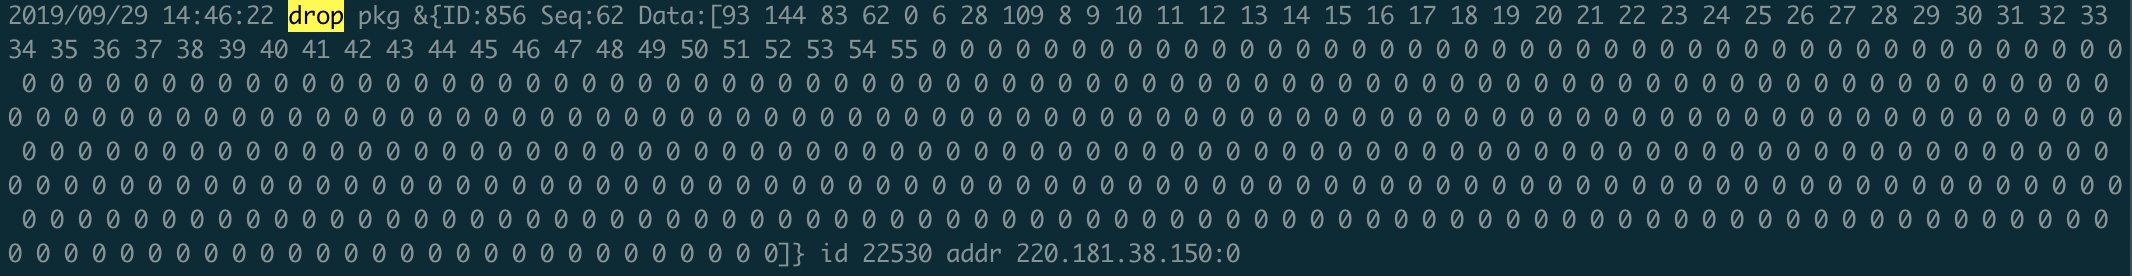
一个监控项目有个需求,会对一批域名全国的边缘节点进行探测,这里包括,丢包率,http 响应时间,探测频率大概时间是2min 一个周期。这里的域名大概有几百个甚至上千。由于是golang 写的调度和agent, 所以,这里探测丢包率是一个有意思的问题。由于目前git 上没有一个好用的支持multi-ping 的库包,或者多ping 有bug,我自己实现了一个。 git 地址:https://github.com/caucy/batch_ping 1,icmp 协议介绍 icmp 的报文头部一共是2+2+4+4+4 个字节。 type ICMP struct { Type uint8 Code uint8 CheckSum uint16 Identifier uint16 SequenceNum uint16 } 这里 type 是icmp 类型,常见有发送报文头 Echo, 回收报文头 Echo Reply 等,更多类型 见 https://tools.ietf.org/html/rfc792 。 Code 进一步划分ICMP的类型,该字段用来查找产生错误的原因;CheckSum 校验码部分,这个字段包含有从ICMP报头和数据部分计算得来的,用于检查错误的数据;而Identifier 通常为进程id,标识具体是哪个进程发送的icmp 包;SequenceNum 标识发送包的顺序id。 icmp 有个特点,listen 能收到其他进程ping 的结果,看下面例子: package main import ( "log" "github.com/caucy/batch_ping" ) func main() { ipSlice := []string{} // ip list should not more than 65535 ipSlice = append(ipSlice, "3g.qq.com") bp, err := ping.NewBatchPinger(ipSlice, false) // true will need to be root if err != nil { log.Fatalf("new batch ping err %v", err) } bp.SetDebug(true) // debug == true will fmt debug log bp.SetCount(100) bp.Run() } 启动上面的进程,会连续ping 3g.qq.com,同时,再启动一个进程ping www.baidu.com , 日志会显示,收到了220.181.38.150 的icmp 包。 2, 如何支持同时支持ping 多个addr 第一种是最简单的,也是大多数探针采用的方式:subprocess 。这个方式有个缺点,就是每个任务会fork 一个进程,非常耗费耗费资源。 第二种方式,我是这样想的,golang 有icmp 包,能够支持send and recive, 我直接起协程 去 收发,每个协程和subprocess 一样,先发后等,这样不就行了?然后起一组协程池,这样并发也能控制。然而,上面例子已经提到了,listen 后的conn 能收到其他进程 ping 的结果,这样实现挺麻烦。 第三种方式,一个协程收,一个协程发。最后选择的是这种方式。 一个协程收,一个协程发,有什么比较麻烦地方?因为icmp 层只能标识seq,所以会出现icmp 包头相同的情况,同时,批量收发,非常容易出现丢包的情况。 3,batch-ping 特性 支持原地址控制 支持ipv6 (操作系统本身支持“ip6:ipv6-icmp”,“udp6” dial ) 支持时间间隔控制 支持发送方式控制 支持多addr 控制 支持 mac, linux 使用示例: package main import ( "log" "github.com/caucy/batch_ping" ) func main() { ipSlice := []string{} // ip list should not more than 65535 ipSlice = append(ipSlice, "2400:da00:2::29") //support ipv6 ipSlice = append(ipSlice, "baidu.com") bp, err := ping.NewBatchPinger(ipSlice, false) // true will need to be root if err != nil { log.Fatalf("new batch ping err %v", err) } bp.SetDebug(true) // debug == true will fmt debug log bp.SetSource("") // if hava multi source ip, can use one isp bp.OnFinish = func(stMap map[string]*ping.Statistics) { for ip, st := range stMap { log.Printf("\n--- %s ping statistics ---\n", st.Addr) log.Printf("ip %s, %d packets transmitted, %d packets received, %v%% packet loss\n", ip, st.PacketsSent, st.PacketsRecv, st.PacketLoss) log.Printf("round-trip min/avg/max/stddev = %v/%v/%v/%v\n", st.MinRtt, st.AvgRtt, st.MaxRtt, st.StdDevRtt) log.Printf("rtts is %v \n", st.Rtts) } } err = bp.Run() if err != nil { log.Printf("run err %v \n", err) } bp.OnFinish(bp.Statistics()) } 4,可能问题 因为icmp 基于udp,时间间隔非常小,发送机器非常多的时候,会出现非常严重丢包,内核参数需要优化。 最后,文章不易,希望大家点个star,试用。 https://github.com/caucy/batch_ping 。

优秀的个人博客,低调大师

HAProxy高性能软负载均衡器

现在公司实现高可用已经成为必不可少的一环,在众多的负载均衡集群方案中,Haproxy是比较有名的一个。它可以实现TCP或Http的负载均衡。优点如下: 免费开源,与硬件负载均衡相比划算很多 最高可以维护40000~50000个并发,作为软件级别的负载均衡来说,实在强大 支持多种负载均衡算法,同时支持session保持 支持虚拟主机 拥有服务器监控页面,可以了解系统的实时运行状态 借用官网的图,图中的HA即为Haproxy软件,下面的PROXY为要代理的服务器,客户端只需要访问HA,相当于在访问PROXY。 image.png 演示 像这种软件的东西,直接动手比说理论有用的多。我还是基于Docker演示,明白其原理主要是配置文件,用虚拟机或容器都是类似的。 拉取Haproxy:1.8镜像 docker pull haproxy:1.8 拉取httpd镜像,并且准备web容器 docker pull httpd:2.4 docker run -it -d --name web1 httpd:2.4 docker run -it -d --name web2 httpd:2.4 docker run -it -d --name web-static httpd:2.4 docker exec -it web1 /bin/bash 进入容器之后分别修改其html页面 image.png 运行Haproxy容器,并且准备其配置文件 Haproxy的配置文件主要分为几部分 global 一些全局配置信息,主要和进程相关,注意如果涉及到目录相关的,要提前创建目录 defaults 默认的配置信息 frontend 前端的配置,暴露给用户的部分 backend 后端的配置,真实的提高服务的部分 在官方的网站中,所有的配置指令都有详细的解释,网址在文末的参考中。 我们的配置如下 image.png global log 127.0.0.1 local2 chroot /var/lib/haproxy pidfile /var/run/haproxy.pid maxconn 4000 user haproxy group haproxy daemon stats socket /var/lib/haproxy/stats defaults mode http log global option httplog option dontlognull option http-server-close option forwardfor except 127.0.0.0/8 option redispatch retries 3 timeout http-request 10s timeout queue 1m timeout connect 10s timeout client 1m timeout server 1m timeout http-keep-alive 10s timeout check 10s maxconn 3000 frontend main acl url_static path_beg -i /static /images /javascript /stylesheets acl url_static path_end -i .jpg .gif .png .css .js use_backend static if url_static default_backend app bind :80 backend static balance roundrobin server static 172.17.0.5:80 check backend app balance roundrobin server app1 172.17.0.3:80 check server app2 172.17.0.4:80 check 结果 在访问同一台服务器,可以看到响应的内容确实转发到后端不同的服务器上面 image.png 最后 纸上得来终觉浅,绝知此事要躬行。Haproxy一直在大脑中停留着,亲自配置一遍才知道其是怎么回事。中间遇到两个问题 Haproxy1.5版本与1.8版本的frontend配置稍有不同,学会参考文档 配置文件中的stats指定的目录在系统中如果不存在,会报错,指定的目录都要存在才行 让配置生效之前先用haproxy -c检查一下配置文件是否正确 参考 Haproxy官方配置参考

优秀的个人博客,低调大师

构建MySQL+DRBD+Keepalived高性能架构

前言*DRBD(DistributedReplicatedBlockDevice)是一个基于块设备级别在远程服务器直接同步和镜像数据的开源软件,类似于RAID1数据镜像,通常配合keepalived、heartbeat等HA软件来实现高可用性。这里简单记录仅供参考。 一、实施环境 1 2 3 4 5 系统版本:CentOS 5.8 DRBD版本:drbd- 8.3 . 15 Keepalived:keepalived- 1.1 . 15 Master: 192.168 . 149.128 Backup: 192.168 . 149.129 二、初始化配置 1) 在128、129两台服务器/etc/hosts里面都添加如下配置: 1 2 192.168 . 149.128 node1 192.168 . 149.129 node2 2) 优化系统kernel参数,直接上sysctl.conf配置如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 net.ipv4.ip_forward= 0 net.ipv4.conf. default .rp_filter= 1 net.ipv4.conf. default .accept_source_route= 0 kernel.sysrq= 0 kernel.core_uses_pid= 1 net.ipv4.tcp_syncookies= 1 kernel.msgmnb= 65536 kernel.msgmax= 65536 kernel.shmmax= 68719476736 kernel.shmall= 4294967296 net.ipv4.tcp_max_tw_buckets= 10000 net.ipv4.tcp_sack= 1 net.ipv4.tcp_window_scaling= 1 net.ipv4.tcp_rmem= 4096 87380 4194304 net.ipv4.tcp_wmem= 4096 16384 4194304 net.core.wmem_default= 8388608 net.core.rmem_default= 8388608 net.core.rmem_max= 16777216 net.core.wmem_max= 16777216 net.core.netdev_max_backlog= 262144 net.core.somaxconn= 262144 net.ipv4.tcp_max_orphans= 3276800 net.ipv4.tcp_max_syn_backlog= 262144 net.ipv4.tcp_timestamps= 0 net.ipv4.tcp_synack_retries= 1 net.ipv4.tcp_syn_retries= 1 net.ipv4.tcp_tw_recycle= 1 net.ipv4.tcp_tw_reuse= 1 net.ipv4.tcp_mem= 94500000 915000000 927000000 net.ipv4.tcp_fin_timeout= 1 net.ipv4.tcp_keepalive_time= 30 net.ipv4.ip_local_port_range= 1024 65530 net.ipv4.icmp_echo_ignore_all= 1 3) 两台服务器分别添加一块设备,用于DRBD主设备存储,我这里为/dev/sdb 30G硬盘; 执行如下命令: 1 mkfs.ext3/dev/sdb;dd if =/dev/zeroof=/dev/sdbbs=1Mcount= 1 ;sync 三、DRBD安装配置 1 yum-yinstalldrbd83*kmod-drbd83;modprobedrbd 安装完成并加载drbd模块后,vi修改/etc/drbd.conf配置文件,本文内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 global{ usage-countyes; } common{ syncer{rate100M;} } resourcer0{ protocolC; startup{ } disk{ on-io-errordetach; #size1G; } net{ } onnode1{ device/dev/drbd0; disk/dev/sdb; address 192.168 . 149.128 : 7898 ; meta-disk internal ; } onnode2{ device/dev/drbd0; disk/dev/sdb; address 192.168 . 149.129 : 7898 ; meta-disk internal ; } } 配置修改完毕后执行如下命令初始化: 1 drbdadmcreate-mdr0;/etc/init.d/drbdrestart;/etc/init.d/status 如下图: 以上步骤,需要在两台服务器都执行,两台都配置完毕后,在node2从上面执行如下命令:/etc/init.d/drbd status 看到如下信息,表示目前两台都为从,我们需要设置node1为master,命令如下: 1 2 3 drbdadm----overwrite-data-of-peerprimaryall mkfs.ext3/dev/drbd0 mkdir/app;mount/dev/drbd0/app 自此,DRBD配置完毕,我们可以往/app目录写入任何东西,当master出现宕机或者其他故障,手动切换到backup,数据没有任何丢失,相当于两台服务器做网络RAID1。 四、Keepalived配置 1 2 3 wgethttp: //www.keepalived.org/software/keepalived-1.1.15.tar.gz;tar-xzvfkeepalived-1.1.15.tar.gz;cdkeepalived-1.1.15;./configure;make;makeinstall DIR=/usr/local/;cp$DIR/etc/rc.d/init.d/keepalived/etc/rc.d/init.d/;cp$DIR/etc/sysconfig/keepalived/etc/sysconfig/; mkdir-p/etc/keepalived;cp$DIR/sbin/keepalived/usr/sbin/ 两台服务器均安装keepalived,并进行配置,首先在node1(master)上配置,keepalived.conf内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 !ConfigurationFile for keepalived global_defs{ router_idLVS_DEVEL } vrrp_scriptcheck_mysql{ script "/data/sh/check_mysql.sh" interval 5 } vrrp_instanceVI_1{ stateMASTER interface eth0 virtual_router_id 52 priority 100 advert_int 1 authentication{ auth_typePASS auth_pass 1111 } virtual_ipaddress{ 192.168 . 149.100 } track_script{ check_mysql } } 然后创建check_mysql.sh检测脚本,内容如下: 1 2 3 4 5 6 7 8 #!/bin/sh A=`ps-Cmysqld--no-header|wc-l` if [$A-eq 0 ];then /bin/umount/app/ drbdadmsecondaryr0 killallkeepalived fi 添加node2(backup)上配置,keepalived.conf内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 !ConfigurationFile for keepalived global_defs{ router_idLVS_DEVEL } vrrp_sync_groupVI{ group{ VI_1 } notify_master/data/sh/master.sh notify_backup/data/sh/backup.sh } vrrp_instanceVI_1{ stateBACKUP interface eth0 virtual_router_id 52 priority 90 advert_int 1 authentication{ auth_typePASS auth_pass 1111 } virtual_ipaddress{ 192.168 . 149.100 } } 创建master.sh检测脚本,内容如下: 1 2 3 4 #!/bin/bash drbdadmprimaryr0 /bin/mount/dev/drbd0/app/ /etc/init.d/mysqldstart 创建backup.sh检测脚本,内容如下: 1 2 3 4 #!/bin/bash /etc/init.d/mysqldstop /bin/umount/dev/drbd0 drbdadmsecondaryr0 发生脑裂恢复步骤如下: 1 2 3 4 5 Master执行命令: drbdadmsecondaryr0 drbdadm----discard-my-dataconnectr0 Backup上执行命令: drbdadmconnectr0 本文转自 wgkgood 51CTO博客,原文链接:http://blog.51cto.com/wgkgood/1408056

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册