首页 文章 精选 留言 我的

精选列表

搜索[超融合软件],共10000篇文章
优秀的个人博客,低调大师

软件测试环境要不要和软件开发环境隔离?

开发环境要不要和测试环境隔离?要就是说,是不是要各用一套数据库等基础设施? 能隔离当然最好,开发人员和测试人员不会互相干扰。但隔离是有代价的,它意味着你要多引一个数据库,如果你的系统是分布式的,你还要多维护一套MQ、RPC中间件等。 依我看,需不需要隔离要看系统是否满足下面的三个条件: 1、两个环境的系统总是要接触到同一份数据 2、数据被一个系统接触后,业务状态会改变;导致这份数据对另一个系统不再可用 3、很难禁止两个系统在同一时刻接触到同一份数据 解释: 条件1.如果两个环境共享数据库,但开发环境只处理北方数据,测试环境只处理南方的,那不用隔离 条件2.即使两个环境都会处理北方数据,但如果这种处理是只读的,也就是开发环境用了,测试环境可以再用,那也无所谓 条件3.即使数据被一个环境处理后,另一个不能用;但如果对数据的接触是人为触发的,也就是说开发环境被人触发数据改动时,不会干扰测试环境的测试,那也无所谓。 具体的场景: 1、纯读的网站不必隔离,它不满足条件2 2、有写、但所有操作都由用户触发的网站也不必隔离,因为它不满足条件3 3、以全局数据为目标的自启应用需要隔离,比如Quartz,Cron,MQ消费者等,因为它们不满足条件1。以MQ应用为例,如果外部发来的某个数据被测试环境消费过了,开发环境就无法再消费了,这时你应该为开发和测试环境各配一个MQ 4、对自启应用,如果实在不想隔离,就要在代码里做一些env-specific的东西,使得不同环境不会访问到相同的数据,比如开发环境只能访问数据库里flag=Dev的记录。不过,这种作法对程序和数据的侵入都很大,不值得提倡。但这种做法可以应用到其他环境的隔离上,比如预发环境和正式环境,它们必须使用相同的数据库。 ====================================分割线================================ 最新内容请见作者的GitHub页:http://qaseven.github.io/

优秀的个人博客,低调大师

今年我国智能算力规模增长将超 40%

从2025中国算力大会上了解到,中国算力平台正加快建设。目前,已有山西、辽宁、上海、江苏等10个省区市的算力分平台正式接入。 中国信息通信研究院副院长魏亮表示:目前,中国算力平台实现了100多个算力服务商入驻,完成1000余家行业用户注册,接入主流基础大模型和垂类模型近百个,为1000多个开发者提供多元的在线调用服务。 工业和信息化部日前印发的《算力互联互通行动计划》提出,到2026年,建立完备的算力互联互通标准、标识和规则体系;到2028年,基本实现全国公共算力标准化互联,形成具备智能感知、实时发现、随需获取能力的算力互联网。 数据显示,近年来,我国算力总规模年增速达到30%左右。在人工智能的快速发展带动下,智能算力需求呈现迅猛增长态势。 中国电信研究院发布的《智算产业发展研究报告(2025)》显示,随着人工智能大模型加速赋能行业应用和智能终端,将进一步助力智能算力产业蓬勃发展。 中国电信研究院战略发展研究所所长饶少阳表示,到2035年,人工智能将为我国的GDP贡献超过11万亿,大概占到GDP的4%到5%。这个可能带动算力的需求是十倍,甚至百倍的增长。 工业和信息化部负责人表示,将引导各地合理布局智能算力设施,逐步提高智能算力供给质量,满足新兴产业和未来产业发展需要。目前,智能算力已经广泛应用于生成式大模型、自动驾驶、具身智能、智慧城市和工业制造等领域。通过算力应用大赛累计征集的创新算力项目已经超过2.3万个,在工业、金融、医疗、能源等领域实现了规模化复制推广。预计2025年,我国智能算力规模增长将超过40%。

优秀的个人博客,低调大师

超好用的国内规则引擎框架

前言 LiteFlow的最新版本2.12.4发布了! 在这个版本里,我们带来了2个大特性和诸多的升级。同时这个版本也是向下兼容2.12.X系列的版本的。 JavaX脚本 LF从很早就开始支持Java脚本,让java代码可以像一种脚本语言那样运作,使用java语言编写可以随时热刷新的代码成为了现实,这个脚本很酷,但是社区里一直诟病的就是LF的java脚本竟然不支持lambda和泛型。 这是因为之前java脚本底层用的是Janino框架,这个框架是个老外写的,这个项目已经很久没更新过了并且作者表示不高兴去支持lambda和泛型了。所以我也是没辙。 这次新的Javax采用Liquor框架的方案,支持了java8到java21中所有的用法,多谢solon作者提供Liquor底层的技术支持,才得以让LF解决了一个困扰多时的问题。使得Java脚本得到了一次大的升级! 如果开发者想要从Java脚本更新到Javax脚本,请看官网的升级指南。 #全新的生命周期体系 在2.12.4版本中,LF提供了生命周期体系。开发者可以很方便的实现一些既定的生命周期接口,从而在特定的生命周期织入自定义逻辑。 LF这次提供了5个大的生命周期阶段的接口,扩展LF,让自己的逻辑变得灵活成为了可能。 具体如何使用请参考官网的生命周期全新章节。 数据库插件支持配置自定义SQL 这也是为开发者提供了更加灵活自由的选择,现在开发者可以忽视掉applicationName,enable等字段,自己去定义SQL来返回系统所需要加载的规则/脚本。 具体如何使用请参考官网文档中的SQL数据库配置源。 其他的更新 另外这个版本,我们还修复了一直以来困扰开发者的异步循环中的并发问题。 提供了域名版本的dtd文件。 完整更新列表 特性 #IASS9Z 新的JavaX脚本插件,支持java8~java17的所有语法特性 https://gitee.com/dromara/liteFlow/issues/IASS9Z 特性 #IAJD9H 期望liteflow 有自己的生命周期扩展 https://gitee.com/dromara/liteFlow/issues/IAJD9H 增强 #IASYI0 提供脚本初始化生命周期的扩展点 https://gitee.com/dromara/liteFlow/issues/IASYI0 增强 #I9H6GY SQL脚本在配置上支持用户自定义的过滤条件 https://gitee.com/dromara/liteFlow/issues/I9H6GY 增强 #IAVH8O 把scanner当中的步骤抽象出来,形成一套小的体系,方便的扩展 https://gitee.com/dromara/liteFlow/issues/IAVH8O 增强 #IANY4U 组件中提供getCmpDataList接口 https://gitee.com/dromara/liteFlow/issues/IANY4U 增强 #I5XB03 提供带域名的dtd文件地址,加强xml的提示 https://gitee.com/dromara/liteFlow/issues/I5XB03 修复 #IASW3I 异步循环迭代组件中迭代对象以及迭代下标存在并发问题 https://gitee.com/dromara/liteFlow/issues/IASW3I

优秀的个人博客,低调大师

鸿蒙程序员平均月薪超 1 万 8

据智联招聘数据显示,春招鸿蒙岗位需求是去年近3倍。 本月初,华为 HarmonyOS 在新年贺词中提到,基于开源鸿蒙开发的 HarmonyOS NEXT 鸿蒙星河版将在今年秋天正式和消费者见面,这也促使大量企业急需鸿蒙人才。 春节后开工第一周,鸿蒙相关职位数同比增长163%,投递人数同比增长349%,同时,鸿蒙开发岗的招聘薪资,达到18191元/月,比总体开发岗的平均薪资(16617元/月)高出9%。 来自:现代快报

优秀的个人博客,低调大师

使用 Svelte 来构建 Web Component (超简单方便)

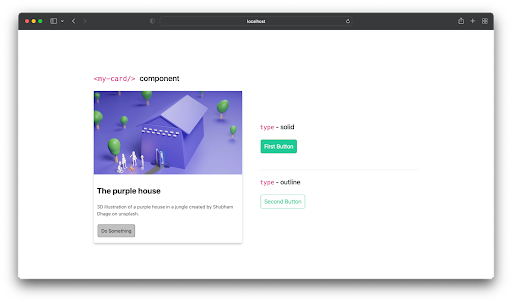
每个开发人员都应该关注代码中的可重用性以及代码的业务隔离,这样可以让业务逻辑与应用架构分离,提升系统的扩展性。而 Web Component 就是这样一个技术,可以让我们创建一个独立的可重用组件。 本文将介绍使用 Svelte 创建通用的 Web Component 的完成过程。『通用』指的是该组件不局限于 Svelte 应用,还可以用于任何 JavaScript 应用程序(如 Vue、React 等),同时还将介绍使用 Svelte 创建 Web Component 的一些局限性。 什么是 Web Component? Web Component 可以让我们创建可重用的、自定义的封装了样式以及功能的 HTML 元素。 例如,我们使用如下代码来创建一个导航条: <style> /* CSS code for our navbar */ </style> <navbar> <!-- Some long code for our navbar --> </navbar> 如果用 Web Component 技术,我们可以定义一个自定义元素(如 <custom-navbar/>),然后你可以在网页任一地方使用该元素显示导航条,同时这个导航条的样式和页面其他元素的样式是完全隔离的,不会相互影响。而这项技术被称之为 Shadow DOM (影子 DOM)。 什么是 Shadow DOM? Shadow DOM 是一个较小的、独立的 DOM,它与主 DOM 分开渲染,允许我们将样式和标记行为隔离到单个组件中。Shadow DOM 本质上允许我们将组件功能进行封装和隔离,我们可以单独对其设置样式、编写功能脚本,而不会干扰应用程序的其余元素。 你大概对 Web Component 有一个基本的认识,下面我们开始用 Svelte 来编写一个简单的组件。 构建 Web Component 准备工作 为了完成本文剩余的内容学习,需要你对掌握以下知识: 对 HTML, CSS 和 JavaScript 有基本的认识 熟悉命令行操作环境 需要一个文本编辑器 最好对 Svelte 有一些基本的了解(可以看看我之前翻译的文章https://my.oschina.net/javayou/blog/5309554) 开始 本文我们将开发两个组件: 第一个组件是一个卡片组件,接收三个属性分别是:卡片标题、卡片描述以及图片,该组件名为<my-card/> 第二个组件是一个带样式的按钮,接收一个type的属性,通过该属性来确定按钮的显示样式,组件名称为<cool-button/> 同时我们将使用两种组件的发布方式,一个是打包到单一文件,另外一个是每个组件发布到一个独立的文件中。 下图显示的是两个组件运行后的外观: 我们从创建一个 Svelte 应用开始,并安装必须的包: npx degit sveltejs/template web-component-tut cd web-component-tut npm install 上述命令执行完毕就可以使用如下命令启动一个测试环境: npm run dev 然后我们打开浏览器访问http://localhost:8080就可以看到一个最基础的 Svelte 应用运行起来后的样子: 开发一个组件 使用 Svelte 生成通用 Web Component 的过程类似于创建常规 Svelte 组件的过程,只是进行了一些修改。 为了创建第一个卡片组件,我们首先创建一个文件src/Card.svelte并定义组件的属性、样式以及 HTML 标签,代码如下: <script> // component props // Camel case not supported for props, see drawback section. export let card_title, card_desc, card_img; </script> <main> <div class="card-container"> <div class="card"> <img src={card_img} alt="My product" /> <div class="card-body"> <div class="row"> <div class="card-title"> <h2>{card_title}</h2> </div> </div> <p> {card_desc} </p> <button>Do Something</button> </div> </div> </div> </main> <style> .card { max-width: 350px; border-radius: 5px; box-shadow: 0 4px 6px 0 #00000033; padding: 0 0 10px 0; } .card img { width: 100%; height: auto; } .card-body { padding: 5px 10px; } .card-body p { color: #575757; margin-bottom: 20px; font-size: 14px; } </style> 你可以在其他组件中使用这个卡片组件,如下所示(这一步可忽略): <script> import Card from "./Card.svelte"; </script> <main> <Card card_title="My Card Title" card_desc="Lorem ipsum dolor…" card_img="path/to/my-image.png" /> </main> 接下来是按钮组件,文件名/src/Button.svelte代码如下: <script> // Component props export let type = "solid"; </script> <button class={type == "solid" ? "btn-solid" : "btn-outline"}> <slot /> </button> <style> button { padding: 10px; color: #fff; font-size: 17px; border-radius: 5px; border: 1px solid #ccc; cursor: pointer; } .btn-solid { background: #20c997; border-color: #4cae4c; } .btn-outline { color: #20c997; background: transparent; border-color: #20c997; } </style> 该组件的使用方法如下(可忽略): import Button from "./Button.svelte"; <Button type="outline">Click me</Button> 将自定义组件转成通用组件 我们需要将自定义 Svelte 组件转成通用的 Web Component ,这样才可以在其他框架中直接使用。 要做这个转换操作,我们需要在 Svelte 配置文件中设置让编译器生成自定义元素。打开rollup.config.js在 plugins 增加一个compilerOptions配置项,在该配置项下增加 customElement: true 配置信息,如下所示: ... plugins: [ svelte({ compilerOptions: { dev: !production, customElement: true, ... 然后我们需要给两个组件分别定义一个元素名称,打开Card.svelte文件,在文件开头第一行插入如下内容: <svelte:options tag="my-card" /> 上述tag属性值代表组件的标签名称。 同样的,打开 Button.svelte 给第二个组件指定一个标签名称: <svelte:options tag="cool-button" /> 最后一步是在main.js中引入这两个组件,打开/src/main.js将里面的内容替换成如下两行: import Button from "./Button.svelte"; import Card from "./Card.svelte"; 这里我们已经完成了两个组件的开发步骤,下一步就是打包组件以便其他的应用可以使用这两个组件,打开命令行窗口进入项目所在目录执行如下命令: npm run build 该命令将生成两个文件,分别是build.js和build.map.js, 文件位于项目下的/build目录。其中build.js是打包的两个组件,而build.map.js是build.js源代码映射文件。 如果上述步骤顺利完成,我们就可以将bundle.js拷贝到一个新目录,然后创建一个index.html文件,内容如下: <!DOCTYPE html> <html> <head> <title>My website</title> <script src="./build.js"></script> </head> <body> <div class="container"> <div class="row"> <div class="col"> <my-card card_title="Red Person" card_desc=" Lorem ipsum dolor sit, amet consectetur.." card_img="https://bit.ly/34B3zHX" > </my-card> <!-- Image credit - Shubham Dhage on unsplash.com --> </div> <div class="col"> <div class="border-bottom py-5"> <cool-button> Solid Cool Button </cool-button> <cool-button type="outline"> Outlined Cool Button </cool-button> </div> </div> </div> </div> </body> </html> 这是一个再简单不过的 HTML 页面了,该页面使用了上述两个组件,在浏览器中显示为如下效果: 组件分割 在某些情况下我们不需要将多个组件打包到同一个 js 文件中,我们希望每个组件有一个独立的 js 文件。要实现这个场景只需在rollup.config.js的input 和 output 中进行配置即可。 在 input 的配置中我们可以指定一个数组,数组的元素就是每个组件的文件路径,而 output 指定为输出的目录即可: export default { input: ["src/Card.svelte", "./src/Button.svelte"], output: { format: "iife", dir: "public/build/", }, ... 修改完成后再次执行npm run build,我们就可以在 build 目录中看到两个文件Button.js和Card.js。 使用方法类似: <script src="Button.js" type="module"></script> <cool-button type="outline">Click Me</cool-button> <!-- another-page.html --> <script src="Card.js" type="module"></script> <my-card card_title="..."></my-card> 主要缺点 到这里我们已经掌握了使用 Svelte 开发 Web Component 的方法,这个过程非常之简单,但是,使用 Svelte 开发 Web 组件会有一些缺点如下: 组件的属性名称不允许使用驼峰命名法,例如你会发现使用形如 cardTitle 这样的属性名就无法正常工作,而驼峰命名法又是 JavaScript 推荐的命名风格。这是一个 Bug,不过如果你使用的是 Vite ,那么有一个workaround plugin可以解决这个问题。 如果不标记Web组件,就无法在Svelte中重用它们 - 不幸的是,您还必须标记要在自定义Web组件中使用的每个Svelte组件 加入你有一个Header.svelte文件需要作为<my-header/>组件输出,但同时这个组件又依赖另外一个Nav.svelte文件,而 Nav.svelte 我们不希望作为 Web 组件输出,这个问题使得我们必须将 Nav.svelte 也作为组件输出,否则程序就会报错。好在这个问题现在也有解了(详情请看 这里),我们可以通过配置来解决这个问题,虽然看起来不是那么的爽,就这样吧,又不是不能用。 浏览器的支持问题 — JavaScriptcustomElementAPI 就是用来创建 Web Component 的底层 API,该 API 目前并没有被所有的浏览器支持,我们需要引入 Polyfill 来解决这个文件,详情请看webcomponents official。 总结 在本文中,我们学习了如何使用 Svelte 创建通用卡片和按钮组件,生成捆绑文件,拆分它们,甚至在单独的 HTML 页面中重用此组件。 动手试试吧? 本文翻译自:Build web components with Svelte - LogRocket Blog

优秀的个人博客,低调大师

超详细 Clickhouse 负载过高问题快速排查思路教程

机器配置 Clickhouse 配置内存大小: 250G Zookeeper 配置内存大小:24G 发现问题 企业相关开发人员通过Grafana监控Clickhouse指标观察到,从12点左右出现了大量的碎片写入,从而引起了相关指标的快速上升。查看云智慧的数字化运维数据平台 DODB (以下简称DODB)概览页也未查看出异常出现源头,而当查看服务器负载情况时,已经上升至900+。 开始排查 检查是否为执行 SQL 太多 当遇到此类问题时,普遍情况下均会猜测是 SQL 执行太多导致。因此,团队开发人员检查了 Clickhouse 的 Process表,以此判断运行中的 SQL 是否过多。与此同时与算法部门的同事进行沟通,最终确认是通过 DODB 写入数据的。随后又查询了一下执行中的 SOL,发现两台机器上运行中的 SOL 不太均衡。 查询 Clickhouse 日志 当查看 Clickhouse 日志时,看到有很多 warn 的日志,但并没有出现有价值的日志。 查询 Zookeeper 日志 当查看 Zookeeper 日志时,发现数据同步有比较大的延迟,超过了1-2s。 排查同步数据延迟是因为需要判断是 load 值上来导致延迟还是因为延迟导致的 load 值上来。可能是一个大查询导致 load 值上来后,引起 Zookeeper 出现问题,从而导致数据无法同步出现数据堆积的情况。因此,在此时查看了监控的读写情况,是由于load值上来后导致写入变慢。 SQL 语句查询 在 Clickhouse 中,所有被执行 Query 均会记录到system.query_log表中。因此可通过该表监控集群的查询情况。以下列举几种用于监控的常用SQL。 最近查询 SELECT event_time, user, query_id AS query, read_rows, read_bytes, result_rows, result_bytes, memory_usage, exception FROM clusterAllReplicas('cluster_name', system, query_log) WHERE (event_date = today()) AND (event_time >= (now() - 60)) AND (is_initial_query = 1) AND (query NOT LIKE 'INSERT INTO%') ORDER BY event_time DESC LIMIT 100 慢查询 SELECT event_time, user, query_id AS query, read_rows, read_bytes, result_rows, result_bytes, memory_usage, exception FROM clusterAllReplicas('cluster_name', system, query_log) WHERE (event_date = yesterday()) AND query_duration_ms > 30000 AND (is_initial_query = 1) AND (query NOT LIKE 'INSERT INTO%') ORDER BY query_duration_ms desc LIMIT 100 Top10大表 SELECT database, table, sum(bytes_on_disk) AS bytes_on_disk FROM clusterAllReplicas('cluster_name', system, parts) WHERE active AND (database != 'system') GROUP BY database, table ORDER BY bytes_on_disk DESC LIMIT 10 Top10查询用户 SELECT user, count(1) AS query_times, sum(read_bytes) AS query_bytes, sum(read_rows) AS query_rows FROM clusterAllReplicas('cluster_name', system, query_log) WHERE (event_date = yesterday()) AND (is_initial_query = 1) AND (query NOT LIKE 'INSERT INTO%') GROUP BY user ORDER BY query_times DESC LIMIT 10 使用慢查询的 SQL 查询 查询结果出来,查看所执行 SQL 具体情况,发现很多都是“异常容器”的。 下图为作战地图所查大屏表,且为 left JOIN 表。由于 life 的 JOIN 在网络及其他因素条件有要求,因此比刚才查询更消耗资源。随后通过时间段查询判断出现异常时间是否匹配,对比发现时间上有些差异。 查询 SQL 查询次数,判断哪次查询 时间 最长以及查询的平均时长。 select left(query, 100) as sql, count() as queryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime("2022-09-23 12:00:00") and event_time < toDateTime("2022-09-23 17:00:00") group by sql order by queryNum desc limit 10 通过该 SQL 查询,发现 5 个小时 SQL 查询了将近 4 万次,且同类型查询执行次数均较高,平均执行时间也比较长。此外,也有许多 5 个小时执行两三千次的 SQL 查询,该类查询平均每次耗时均在二三十秒。 查询不包含insert into语句的5个小时查询次数超过1000次的 SQL select * from (select LEFT(query, 100) as sql, count() as quneryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query not like '%INSERT INTO%' group by sql order by avgTime desc) where queryNum > 1000 limit 50 由于上述 SQL 均做了截取,故需根据所查询 SQL 进一步匹配 SQL。 select query from system.query_log where event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query like '%需要匹配的sql查询%' limit 5; 使用第三条 SQL 用 queryNum 排序,查询出执行次数多且平均耗时比较大的 SQL,随后定位 SQL。以第二条记录为例:5个小时查询了 38000+次,耗时12s,每分钟查 120+次。 使用第三条 SQL ,将 时间 范围改到上午8点到上午12查询。 查询结果对比发现,执行耗时在上午时均很短,但到中午12点以后就变的非常慢了。 由于之前查询发现有部分 left JOIN 的查询,故查询了“异常容器”的left JOIN 的查询,,随后将读取条数为0的排除掉。 select * from (select LEFT(query, 100) as sql, count() as quneryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where sql like '%异常容器%' and read_rows != 0 and event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query not like '%INSERT INTO%' group by sql order by queryNum desc) 根据小时 聚合 每个小时/分钟段查询次数耗时 --按照每小时聚合 select toHour(event_time) as t, count() as queryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime('2022-09-23 08:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query not like '%INSERT INTO%' and query like '%异常容器%' and read_rows != 0 group by t limit 50 --按照每分钟聚合 select toMinute(event_time) as t, count() as queryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 13:00:00') and query not like '%INSERT INTO%' and query like '%异常容器%' and read_rows != 0 group by t limit 50 查询结果如下:10点开始有,12 点查询响应时间翻了10倍。 从32s开始,响应时间变为24s多,后面的时间也逐渐变长。 查询 left JOIN 的查询个数。 select * from (select LEFT(query, 100) as sql, count() as quneryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where query like '% JOIN%' and read_rows != 0 and event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 21:00:00') and query not like '%INSERT INTO%' group by sql order by queryNum desc) 发现有问题的表时,查询该表结构。 show create table "shard_2"."cw_db_zabbix_metric_data01_replica" 经查询发现该表创建的比较差,order by 仅有一个 UUID。且该表 JOIN 的 SQL 也比较多,每次查询的读取的条数也特别大。 停掉 SQL ,观察结果 通过观察,发现有不少类似的 JOIN 的 SQL。当停掉一个异常容器指标的 SQL 时会发现 load 值有些许变化,偶尔会降到700多。由于指标管理都是通过 gatewayAPI 调用,停掉 SQL 最快的方法便是直接将 gatewayAPI 停掉,这样只会影响指标 SQL 调,不会影响其他功能使用。将 gatewayAPI 停掉后就不会出现指标调用 SQL 也全部停掉,此时发现 load 值已降低 总结 遇到此类问题可先查看日志,首先在(Clickhouse 日志 Zookeeper 日志)日志中看能否找到有用的信息,例如直接报错信息等,如果在日志中找不到太多有用的信息的话,可以从下面入手。 一般遇到 load 值比较高的情况时,基本上都是发生在查询上面。当遇到这种问题时可先查询带有JOIN 的 SQL 语句是不是很多。随后通过 query_log 表中的一些字段去查询重要信息,通过对字段使用一些函数来获取有用的信息,如获取查询的 SQL,SQL 执行次数、执行时间等。 本次排查过程主要使用query_log表,下面为重要字段: event_time — 查询开始时间. query_duration_ms — 查询消耗的时间(毫秒). read_rows— 从参与了查询的所有表和表函数读取的总行数. query — 查询语句. Clickhouse query_log 表中所有字段 type (Enum8) — 执行查询时的事件类型. 值: 'QueryStart' = 1 — 查询成功启动. 'QueryFinish' = 2 — 查询成功完成. 'ExceptionBeforeStart' = 3 — 查询执行前有异常. 'ExceptionWhileProcessing' = 4 — 查询执行期间有异常. event_date (Date) — 查询开始日期. event_time (DateTime) — 查询开始时间. event_time_microseconds (DateTime64) — 查询开始时间(毫秒精度). query_start_time (DateTime) — 查询执行的开始时间. query_start_time_microseconds (DateTime64) — 查询执行的开始时间(毫秒精度). query_duration_ms (UInt64) — 查询消耗的时间(毫秒). read_rows (UInt64) — 从参与了查询的所有表和表函数读取的总行数. 包括:普通的子查询, IN 和 **JOIN**的子查询. 对于分布式查询 read_rows 包括在所有副本上读取的行总数。 每个副本发送它的 read_rows 值,并且查询的服务器-发起方汇总所有接收到的和本地的值。 缓存卷不会影响此值。 read_bytes (UInt64) — 从参与了查询的所有表和表函数读取的总字节数. 包括:普通的子查询, IN 和 **JOIN**的子查询. 对于分布式查询 read_bytes 包括在所有副本上读取的字节总数。 每个副本发送它的 read_bytes 值,并且查询的服务器-发起方汇总所有接收到的和本地的值。 缓存卷不会影响此值。 written_rows (UInt64) — 对于 INSERT 查询,为写入的行数。 对于其他查询,值为0。 written_bytes (UInt64) — 对于 INSERT 查询时,为写入的字节数。 对于其他查询,值为0。 result_rows (UInt64) — SELECT 查询结果的行数,或**INSERT** 的行数。 result_bytes (UInt64) — 存储查询结果的RAM量. memory_usage (UInt64) — 查询使用的内存. query (String) — 查询语句. exception (String) — 异常信息. exception_code (Int32) — 异常码. stack_trace (String) — Stack Trace. 如果查询成功完成,则为空字符串。 is_initial_query (UInt8) — 查询类型. 可能的值: 1 — 客户端发起的查询. 0 — 由另一个查询发起的,作为分布式查询的一部分. user (String) — 发起查询的用户. query_id (String) — 查询ID. address (IPv6) — 发起查询的客户端IP地址. port (UInt16) — 发起查询的客户端端口. initial_user (String) — 初始查询的用户名(用于分布式查询执行). initial_query_id (String) — 运行初始查询的ID(用于分布式查询执行). initial_address (IPv6) — 运行父查询的IP地址. initial_port (UInt16) — 发起父查询的客户端端口. interface (UInt8) — 发起查询的接口. 可能的值: 1 — TCP. 2 — HTTP. os_user (String) — 运行 clickhouse-client的操作系统用户名. client_hostname (String) — 运行clickhouse-client 或其他TCP客户端的机器的主机名。 client_name (String) — clickhouse-client 或其他TCP客户端的名称。 client_revision (UInt32) — clickhouse-client 或其他TCP客户端的Revision。 client_version_major (UInt32) — clickhouse-client 或其他TCP客户端的Major version。 client_version_minor (UInt32) — clickhouse-client 或其他TCP客户端的Minor version。 client_version_patch (UInt32) — clickhouse-client 或其他TCP客户端的Patch component。 http_method (UInt8) — 发起查询的HTTP方法. 可能值: 0 — TCP接口的查询. 1 — GET 2 — POST http_user_agent (String) — The UserAgent The UserAgent header passed in the HTTP request。 quota_key (String) — 在quotas 配置里设置的“quota key” (见 keyed). revision (UInt32) — ClickHouse revision. ProfileEvents (Map(String, UInt64))) — Counters that measure different metrics. The description of them could be found in the table 系统。活动 Settings (Map(String, String)) — Names of settings that were changed when the client ran the query. To enable logging changes to settings, set the log_query_settings 参数为1。 thread_ids (Array(UInt64)) — 参与查询的线程数. Settings.Names (Array(String)) — 客户端运行查询时更改的设置的名称。 要启用对设置的日志记录更改,请将log_query_settings参数设置为1。 Settings.Values (Array(String)) — Settings.Names 列中列出的设置的值 开源项目推荐 云智慧已开源数据可视化编排平台 FlyFish 。通过配置数据模型为用户提供上百种可视化图形组件,零编码即可实现符合自己业务需求的炫酷可视化大屏。 同时,飞鱼也提供了灵活的拓展能力,支持组件开发、自定义函数与全局事件等配置, 面向复杂需求场景能够保证高效开发与交付。 如果喜欢我们的项目,请不要忘记点击下方代码仓库地址,在 GitHub / Gitee 仓库上点个 Star,我们需要您的鼓励与支持。此外,即刻参与 FlyFish 项目贡献成为 FlyFish Contributor 的同时更有万元现金等你来拿。 GitHub 地址: https://github.com/CloudWise-OpenSource/FlyFish Gitee 地址: https://gitee.com/CloudWise/fly-fish 微信扫描识别下方二维码,备注【飞鱼】加入AIOps社区飞鱼开发者交流群,与 FlyFish 项目 PMC 面对面交流~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册