首页 文章 精选 留言 我的

精选列表

搜索[智博会],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 被“误解”的 Java AIO

为什么说 AIO 受”误解“,虽然这个”误解“被打上了双引号,但还是不得不承认它的发展状况并不好。AIO 是 Java 7 开始提供的新特性,而这个”新特性“到如今都成了陈年老酒还鲜有人去品味它。要知道 Java 7 可是在 2011年7月份发布的,市面上基于 AIO 实现的通信框架竟然寥寥无几,关于这项技术的介绍文章也普遍比较粗略。通过阅读那些介绍 AIO 的文章,似乎从学术层面大家就不怎么待见这项技术。 作为 AIO 的学习者、受益者,我觉得有必要先对网上的一些 ”偏见“ 表达一下自己的观点。如果能有幸在认知上搭成共识,之后的学习交流会更加顺畅一点。通常偏见源于比较,AIO 与 BIO、NIO 的对比明细如表所示。 BIO NIO AIO 客户端 : I/O 线程数 1 : 1 N : 1 N : 0 I/O类型 同步阻塞 同步非阻塞 异步非阻塞 API使用难度 简单 复杂 一般 调试难度 简单 复杂 一般 可靠性 差 高 高 吞吐量 低 高 高 适用场景 适用于连接数量不多,并发量不高的场景。充分发挥易编程的优势。 适用于对连接数量以及稳定性、实时性有较高要求的场景,采用 NIO 或 AIO 能有效缓解网络 I/O 造成的机器负载。 同NIO 误解一 通过上表的比较可以看出 AIO 的性价比应该是优于 NIO 的,而实际情况却是大多数人更偏爱与 NIO,准确的说应该是偏爱 NIO 通信框架:Netty。这本无可厚非,Netty 确实是一款非常优秀的项目,可是很多人错误的解读了 Netty 在 Github 上关于不支持 AIO 的理由,这更加遏制了 AIO 的发展。 Not faster than NIO (epoll) on unix systems (which is true) 这句话表达的本意应该是:NIO 和 AIO 在 unix 系统上使用的都是 epoll 模式,本质都是一样的。但Not faster than NIO在一定程度上会让人误解为 AIO 没 NIO 快。 这里可以采用假设的方式来论证这个观点是不成立的。 假设: epoll 表现的性能为 x=100; 通信框架因为要解决并发调度与资源分配问题,对 epoll 进行封装后会存在一定的性能损耗,以 y 表示。 最终性能表现结果应该是 r=x-y。 论证: 某款 NIO 框架基于 epoll 封装后的性能损耗值:y=5,则它所发挥的最终性能为:x-y=95。 如果有一款 AIO 框架能将性能损耗值控制在:y=(0,5) ,那最终性能便高于 NIO 框架。如 y>5,则性能低于 NIO 框架。 结论: 以底层模型是 kqueue、epoll、select 还是 IOCP 来比较 NIO 和 AIO 的性能是不严谨的,决定权在于框架实现能挖掘出多少基础能力。否则同样采用 NIO 技术,为什么不同的框架还是会有高低之分。 误解二 Linux 系统的 AIO 还不成熟。如果是这个原因的话,不妨先看下:http://lse.sourceforge.net/io/aio.html,其中核心的一句话:Support for kernel AIO has been included in the 2.6 Linux kernel.请注意,Linux 内核自 2.6 版本起已支持AIO模式。 这是个很奇怪的现象,似乎曾经不支持 AIO 就觉得永远不支持,曾经出现的 bug 就永远存在。正如 JAVA NIO 的空轮训 bug ,如今都已经发展到 Java 13 了,依旧还有人坚信这个 bug 一直在。坦白的讲,我没有去验证过 Java AIO 在 Linux 环境下是否是真正意义的 AIO,也没有复现出 NIO 的空轮训 bug。但如果因为某种原因放弃持续学习,那对于事物的认知和见识就只能停留在过去。 所以”Linux 系统的 AIO 还不成熟“也不会成为我抛弃 AIO 的理由。 误解三 需要为每一个连接预先分配读缓存。这个确实是客观存在的情况,AIO 的使用方式是调用读写接口将ByteBuffer对象注册进去,当事件完成后以回调的形式触发CompletionHandler,所以必须要事先分配好缓存空间。 但是有一个细节可能会被大家忽略掉,即便采用 NIO,当遇到半包/粘包的的情况,还是需要有一个缓存对象来暂存这份不完整的数据。尤其在高并发场景下,半包/粘包现象很容易加剧,此时 NIO 需要分配的缓存并不比 AIO 节省多少。 即使假设理想状态下并不存在半包/粘包问题,AIO 通信的预分配形式又能额外消耗多少内存。为每个连接分配 1024 字节的读缓存,在1万个并发连接的条件下也才消耗不到 10MB 内存,试问现实场景下一台 Java 应用服务器需要同时支撑多少个并发,1万?5万?10万?。 目前已知的通信框架通常会配备内存池,在这种前提下 AIO 也只是将内存池中的资源提前利用起来而已。在同等的内存池配置,相同的并发压力下,如果 AIO 暴露出内存方面的问题,我们再来做 AIO 和 NIO 的选择。 总结 本文并不是要将 NIO 和 AIO 对立起来,这两项技术都非常吸引人,喜欢技术的朋友可以在这方面钻研很久。个人推荐纯粹出于学习优先考虑 NIO,因为难度更高,更具挑战性,将要面临和需要解决的问题更多。在学习的过程中如果遇到困惑,可以再去翻一下 AIO 的源码,里面有很多值得借鉴的设计。

优秀的个人博客,低调大师

每日一博 | 你知道字节序吗?

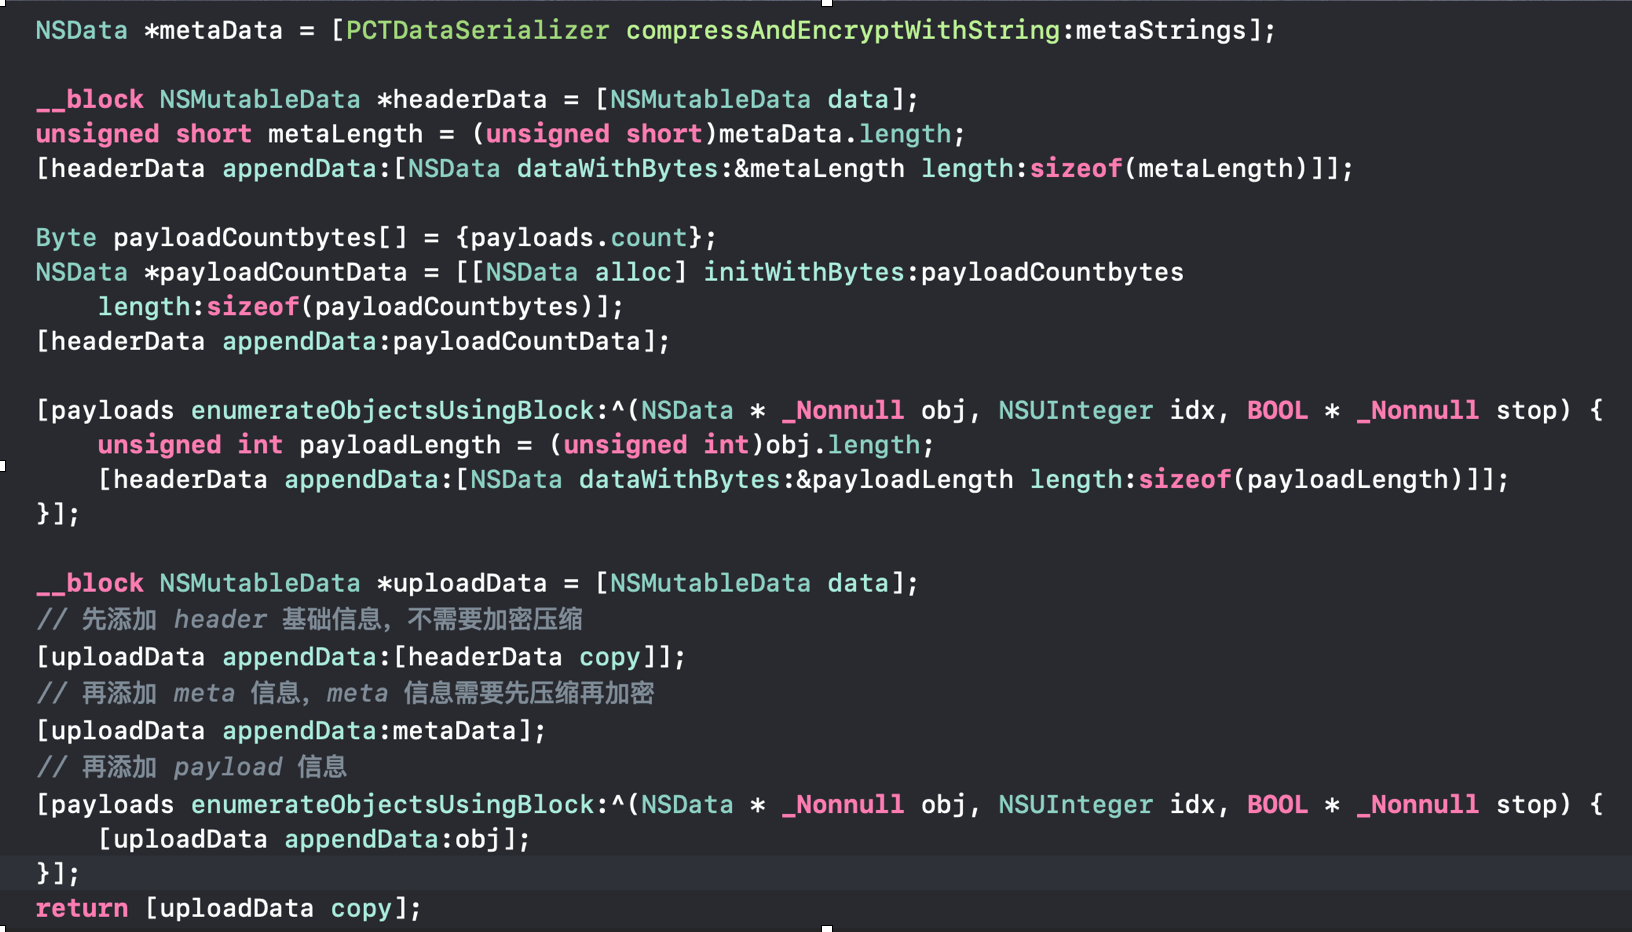
最近在调一个自定义报文的接口时,本来以为挺简单的,发现踩了好几个坑,其中一个比较“刻骨铭心”的问题就是数据的字节序问题。 背景 自定义报文,调用接口,服务端报文解析失败 iOS 小端序 查看 iOS 设备使用的端序 if (NSHostByteOrder() == NS_LittleEndian) { NSLog(@"NS_LittleEndian"); } if (NSHostByteOrder() == NS_BigEndian) { NSLog(@"NS_BigEndian"); } else { NSLog(@"Unknown"); } 概念 字节序,字节顺序,又称端序或尾序(Endianness),在计算机科学领域中,指「存储器」中或者「数字通信链路」中,组成多字节的字的字节排列顺序。 在几乎所有的机器上,多字节对象都被存储为连续的字节序列。例如在 C 语言中,一个 int 类型的变量 x 地址为 0x100,那么其对应的地址表达式 &x 的值为 0x100,且 x 的4个字节将被存储在存储器的 0x100,0x101,0x102,0x103 位置。 字节的排列方式有2个通用规则。例如一个多位整数,按照存储地址从低到高排序的字节中,如果该整数的最低有效字节(类似于最低有效位)排在最高有效字节前面,则成为**“小端序“;反之成为”大端序“**。在计算机网络中,字节序是一个必须要考虑的因素,因为不同类型的机器可能采用不同标准的字节序,所以均需要按照网络标准进行转化。 假设一个类型为 int 的变量 x,位于地址 0x100 处,它的值为 0x01234567,地址范围为 0x100~0x103字节,其内部的排列顺序由机器决定,也就是和 CPU 有关,和操作系统无关。 大端序(Big Endian):也叫大尾序。高字节存储在内存的低地址 | 地址增长方向 |内存地址序号|16进制| |:- |:-|:-| |↓ |0x100| 01| |↓ |0x101| 23| |↓ |0x102| 45| |↓|0x103| 67| 小端序(Little Endian):也叫小尾序。低字节存储在内存的低地址 | 地址增长方向 |内存地址序号|16进制| |:- |:-|:-| |↓ |0x100| 67| |↓ |0x101| 45| |↓ |0x102| 23| |↓|0x103| 01| 缘起 “endian”一词来源于十八世紀愛爾蘭作家乔纳森·斯威夫特(Jonathan Swift)的小说《格列佛游记》(Gulliver's Travels)。小说中,小人国为水煮蛋该从大的一端(Big-End)剥开还是小的一端(Little-End)剥开而争论,争论的双方分别被称为“大端派”和“小端派”。以下是1726年关于大小端之争历史的描述: “我下面要告诉你的是,Lilliput和Blefuscu这两大强国在过去36个月里一直在苦战。战争开始是由于以下的原因:我们大家都认为,吃鸡蛋前,原始的方法是打破鸡蛋较大的一端,可是当今皇帝的祖父小时候吃鸡蛋,一次按古法打鸡蛋时碰巧将一个手指弄破了。因此他的父亲,当时的皇帝,就下了一道敕令,命令全体臣民吃鸡蛋时打破鸡蛋较小的一端,违令者重罚。老百姓们对这项命令极其反感。历史告诉我们,由此曾经发生过6次叛乱,其中一个皇帝送了命,另一个丢了王位。这些叛乱大多都是由Blefuscu的国王大臣们煽动起来的。叛乱平息后,流亡的人总是逃到那个帝国去寻求避难。据估计,先后几次有11000人情愿受死也不肯去打破鸡蛋较小的一端。关于这一争端,曾出版过几百本大部著作,不过大端派的书一直是受禁的,法律也规定该派任何人不得做官。” —— 《格列夫游记》 第一卷第4章 蒋剑锋(译) 1980年,丹尼·科恩(Danny Cohen),一位网络协议的早期开发者,在其著名的论文"On Holy Wars and a Plea for Peace"中,为平息一场关于字节该以什么样的顺序传送的争论,而第一次引用了该词。 字节顺序 对于单一的字节(a byte),大部分处理器以相同的顺序处理位元(bit),因此单字节的存放方法和传输方式一般相同。 对于多字节数据,如整数(32位机中一般占4字节),在不同的处理器的存放方式主要有两种:大、小端序。 拓展 以内存中0x0A0B0C0D的存放方式为例,分别有以下几种方式: 注:0x 前缀代表十六进制。 大端序 数据以8bit为单位: 地址增长方向 → ... 0x0A 0x0B 0x0C 0x0D ... 示例中,最高位字节是0x0A 存储在最低的内存地址处。下一个字节0x0B存在后面的地址处。正类似于十六进制字节从左到右的阅读顺序。 数据以16bit为单位: 地址增长方向 → ... 0x0A0B 0x0C0D ... 最高的16bit单元0x0A0B存储在低位。 小端序 数据以8bit为单位: 地址增长方向 → ... 0x0D 0x0C 0x0B 0x0A ... 最低位字节是0x0D 存储在最低的内存地址处。后面字节依次存在后面的地址处。 数据以16bit为单位: 地址增长方向 → ... 0x0C0D 0x0A0B ... 最低的16bit单元0x0C0D存储在低位。 更改地址的增长方向: 当更改地址的增长方向,使之由右至左时,表格更具有可阅读性。 ← 地址增长方向 ... 0x0A 0x0B 0x0C 0x0D ... 最低有效位(LSB)是0x0D 存储在最低的内存地址处。后面字节依次存在后面的地址处。 ← 地址增长方向 ... 0x0A0B 0x0C0D ... 最低的16bit单元0x0C0D存储在低位。 混合序(英:middle-endian)具有更复杂的顺序。以 PDP-11 为例,0x0A0B0C0D 被存储为: 32bit在PDP-11的存储方式 地址增长方向 → ... 0x0B 0x0A 0x0D 0x0C ... 可以看作高16bit和低16bit以大端序存储,但16bit内部以小端存储。 处理器体系 x86、MOS Technology 6502、Z80、VAX、PDP-11等处理器为小端序; Motorola 6800、Motorola 68000、PowerPC 970、System/370、SPARC(除V9外)等处理器为大端序; ARM、PowerPC(除PowerPC 970外)、DEC Alpha、SPARC V9、MIPS、PA-RISC及IA64的字节序是可配置的。 网络字节顺序(NBO) 通常我们认为,在网络传输的字节顺序即为网络字节序为标准顺序,考虑到与协议的一致以及与其他平台产品的互通,在程序发送数据包的时候,将主机字节序转换为网络字节序,收数据包处将网络字节序转换为主机字节序。 NBO(Network Byte Order):按照从高到低的顺序存储,在网络上使用统一的网络字节顺序,可以避免兼容性问题。TCP/IP中规定好的一种数据表示格式,与具体的 CPU 类型、操作系统等无关。从而保证数据在不同主机之间传输时能够被正确解释。网络字节序采用大端序。 主机字节顺序 HBO 主机字节顺序(HBO:Host Byte Order):不同机器 HBO 不相同,与 CPU 有关。计算机存储数据有两种字节优先顺序:Big Endian 和 Little Endian。Internet 以 Big Endian 顺序在网络上传输,所以对于在内部是以 Little Endian 方式存储数据的机器,在网络通信时就需要进行转换。 如何转换 由于 Internet 和 Intel 处理器的字节顺序不同,所以开发者需要使用 Sockets API 提供的标准转换函数。 BSD Socket 提供了转换函数 htons() : unsigned short 从主机序转换到网络序 htonl(): unsigned long 从主机序转换到网络序 ntohs():unsigned short 从网络序转换到主机序 ntohl():unsigned long 从网络序转换到主机序 之前的代码采用端序转换 - (NSData *)handlePayloadData:(NSArray *)rawArray { if (rawArray.count == 0) { return 0; } // 2. 加密压缩处理:(meta 整体先加密再压缩,payload一条条先加密再压缩) __block NSMutableString *metaStrings = [NSMutableString string]; __block NSMutableArray<NSData *> *payloads = [NSMutableArray array]; // 2.1. 遍历拼接model,取出 meta,用 \n 拼接 [rawArray enumerateObjectsUsingBlock:^(id _Nonnull obj, NSUInteger idx, BOOL * _Nonnull stop) { if (PCT_IS_CLASS(obj, PCTLogPayloadModel)) { PCTLogPayloadModel *payloadModel = (PCTLogPayloadModel *)obj; BOOL shouldAppendLineBreakSymbol = idx < (rawArray.count - 1); [metaStrings appendString:[NSString stringWithFormat:@"%@%@", payloadModel.meta, shouldAppendLineBreakSymbol ? @"\n" : @""]]; // 2.2 判断是否需要上传 payload 信息。如果需要则将 payload 取出。(Payload 可能为空) if ([self needUploadPayload:payloadModel]) { if (payloadModel.payload) { NSData *payloadData = [PCTDataSerializer compressAndEncryptWithData:payloadModel.payload]; [payloads addObject:payloadData]; } } } }]; if (metaStrings.length == 0) { return nil; } NSData *metaData = [PCTDataSerializer compressAndEncryptWithString:metaStrings]; __block NSMutableData *headerData = [NSMutableData data]; unsigned short metaLength = (unsigned short)metaData.length; HTONS(metaLength); // 处理2字节的大端序 [headerData appendData:[NSData dataWithBytes:&metaLength length:sizeof(metaLength)]]; Byte payloadCountbytes[] = {payloads.count}; NSData *payloadCountData = [[NSData alloc] initWithBytes:payloadCountbytes length:sizeof(payloadCountbytes)]; [headerData appendData:payloadCountData]; [payloads enumerateObjectsUsingBlock:^(NSData * _Nonnull obj, NSUInteger idx, BOOL * _Nonnull stop) { unsigned int payloadLength = (unsigned int)obj.length; HTONL(payloadLength); // 处理4字节的大端序 [headerData appendData:[NSData dataWithBytes:&payloadLength length:sizeof(payloadLength)]]; }]; __block NSMutableData *uploadData = [NSMutableData data]; // 先添加 header 基础信息,不需要加密压缩 [uploadData appendData:[headerData copy]]; // 再添加 meta 信息,meta 信息需要先压缩再加密 [uploadData appendData:metaData]; // 再添加 payload 信息 [payloads enumerateObjectsUsingBlock:^(NSData * _Nonnull obj, NSUInteger idx, BOOL * _Nonnull stop) { [uploadData appendData:obj]; }]; return [uploadData copy]; } 参考资料 维基百科:字节序

优秀的个人博客,低调大师

每日一博 | 测试驱动开发(TDD)入门

测试驱动开发(TDD)入门 测试驱动开发,英文全称 Test-Driven Development(简称 TDD),是由Kent Beck 先生在极限编程(XP)中倡导的开发方法。以其倡导先写测试程序,然后编码实现其功能得名。 本文不打算扯过多的理论,而是通过操练的方式,带着大家去操练一下,让同学们切身感受一下 TDD,究竟是怎么玩的。开始之前先说一下 TDD 的基本步骤。 TDD 的步骤 写一个失败的测试 写一个刚好让测试通过的代码 重构上面的代码 简单设计原则 重构可以遵循简单设计原则: 简单设计原则,优先级从上至下降低,也就是说 「通过测试」的优先级最高,其次是代码能够「揭示意图」和「没有重复」,「最少元素」则是让我们使用最少的代码完成这个功能。 操练 Balanced Parentheses 是我在 cyber-dojo 上最喜欢的一道练习题之一,非常适合作为 TDD 入门练习。 先来看一下题目: Write a program to determine if the the parentheses (), the brackets [], and the braces {}, in a string are balanced. For example: {{)(}} is not balanced because ) comes before ( ({)} is not balanced because ) is not balanced between {} and similarly the { is not balanced between () [({})] is balanced {}([]) is balanced {()}[[{}]] is balanced 我来翻译一下: 写一段程序来判断字符串中的小括号 () ,中括号 [] 和大括号 {} 是否是平衡的(正确闭合)。 例如: {{)(}} 是没有闭合的,因为 ) 在 ( 之前。 ({)} 是没有闭合的,因为 ) 在 {} 之间没有正确闭合,同样 { 在 () 中间没有正确闭合。 [({})] 是平衡的。 {}([]) 是平衡的。 {()}[[{}]] 是平衡的。 需求清楚了,按照一个普通程序员的思维需要先思考一下,把需求理解透彻而且思路要完整,在没思路的情况下完全不能动手。 而使用 TDD 首先要将需求拆分成很小的任务,每个任务足够简单、独立,通过完成一个个小任务,最终交付一个完整的功能。 这个题目起码有两种技术方案,我们先来尝试第一种。 先来拆分第一步: 输入一个空字符串,期望是平衡的,所以返回 true 。 我们来先写测试: import assert from 'assert'; describe('Parentheses', function() { it('如果 输入字符串为 "" ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute(''), true); }); }); 此时运行测试: Parentheses 如果 输入字符串为 "" ,当调用 Parentheses.execute(),则结果返回 true: ReferenceError: Parentheses is not defined at Context.Parentheses (test/parentheses.spec.js:5:18) 接下来写这个 case 的实现: export default { execute(str) { if (str === '') { return true; } } }; 运行: Parentheses ✓ 如果 输入字符串为 "" ,当调用 Parentheses.execute(),则结果返回 true 1 passing (1ms) 第二步: 输入符串为 (),期望的结果是 true 。 先写测试: it('如果 输入字符串为 () ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('()'), true); }); 运行、失败!因为篇幅原因这里就不再贴报错结果。 然后继续写实现: export default { execute(str) { if (str === '') { return true; } if (str === '()') { return true; } return false; } }; 这个实现虽然有点傻,但的确是通过了测试,回顾一下 “简单设计原则” ,以上两步代码都过于简单,没有值得重构的地方。 第三步: 输入符串为 ()(),期望的结果是 true 。 测试: it('如果 输入字符串为 ()() ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('()()'), true); }); 运行、失败! 实现: export default { execute(str) { if (str === '') { return true; } if (str === '()') { return true; } if (str === '()()') { return true; } return false; } }; 这个实现更傻,傻到我都不好意思往上贴,回顾一下 TDD 的步骤「通过测试」,可以重构了。 其中 if (str === '()') 与 if (str === '()()') 看起来有些重复,来看看是否可以这样重构一下: export default { execute(str) { if (str === '') { return true; } const replacedResult = str.replace(/\(\)/gi, ''); if (replacedResult === '') { return true; } return false; } }; 将字符串中的 () 全部替换掉,如果替换后的字符串结果等于 '' 则是正确闭合的。 运行,通过! 我们再来增加一个case : it('如果 输入字符串为 ()()( ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('()()('), false); }); 运行,通过! 第四步 输入符串为 [],期望的结果是 true 。 测试: it('如果 输入字符串为 [] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('[]'), true); }); 运行、失败! 实现: export default { execute(str) { if (str === '') { return true; } let replacedResult = str.replace(/\(\)/gi, ''); replacedResult = replacedResult.replace(/\[\]/gi, ''); if (replacedResult === '') { return true; } return false; } }; 运行,通过! 正则表达式可以将两条语句合并成一条,但是合并成一条语句的可读性较差,所以这里写成了两句。 第五步: 输入符串为 {},期望的结果是 true 。 测试: it('如果 输入字符串为 {} ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{}'), true); }); 实现: export default { execute(str) { if (str === '') { return true; } let replacedResult = str.replace(/\(\)/gi, ''); replacedResult = replacedResult.replace(/\[\]/gi, ''); replacedResult = replacedResult.replace(/\{\}/gi, ''); if (replacedResult === '') { return true; } return false; } }; 运行、通过! 第六步: 输入符串为 [({})],期望的结果是 true 。 写测试: it('如果 输入字符串为 [({})] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('[({})]'), true); }); 运行、失败! 原因是我们的替换逻辑是有顺序的,当替换完成的结果有值,如果等于输入值则返回 false,如果不等于输入值则继续替换, 这里用到了递归。 来修改一下实现代码: export default { execute(str) { if (str === '') { return true; } let replacedResult = str.replace(/\(\)/gi, ''); replacedResult = replacedResult.replace(/\[\]/gi, ''); replacedResult = replacedResult.replace(/\{\}/gi, ''); if (replacedResult === '') { return true; } if (replacedResult === str) { return false; } return this.execute(replacedResult); } }; 运行、通过! 再添加一些测试用例: it('如果 输入字符串为 {}([]) ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{}([])'), true); }); it('如果 输入字符串为 {()}[[{}]] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{()}[[{}]]'), true); }); it('如果 输入字符串为 {{)(}} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('{{)(}}'), false); }); it('如果 输入字符串为 ({)} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('({)}'), false); }); 运行、通过! 这个功能我们就这样简单的实现了,需求如此,所以这个方案有些简陋,甚至我们都没有做错误处理。在这里我们不花太多时间进行重构,直接进入方案二。 方案二 我们将需求扩展一下: 输入字符串为: const fn = () => { const arr = [1, 2, 3]; if (arr.length) { alert('success!'); } }; 判断这个字符串的括号是否正确闭合。 通过刚刚 git 提交的记录找到第二步重新拉出一个分支: git log git checkout <第二步的版本号> -b plan-b 运行、通过! 测试已经有了,我们直接修改实现: export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === '(') { pipe.push(chart); } if (char === ')') { pipe.pop(); } } if (!pipe.length) return true; return false; } }; 这个括号的闭合规则是先进后出的,使用数组就 ok。 运行、通过! 第三步: 上面的实现满足这个任务,但是有一个明显的漏洞,当输入只有一个 ) 时,期望得到返回 false ,我们增加一个 case: it('如果 输入字符串为 ) ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute(')'), false); }); 运行、失败! 再修改实现: export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === '(') { pipe.push(char); } if (char === ')') { if (pipe.pop() !== '(') return false; } } if (!pipe.length) return true; return false; } }; 运行、通过!如果 pop() 的结果不是我们放进去管道里的值,则认为没有正确闭合。 重构一下,if 语句嵌套的没有意义: export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === '(') { pipe.push(char); } if (char === ')' && pipe.pop() !== '(') { return false; } } if (!pipe.length) return true; return false; } }; ( ) 在程序中应该是一组常量,不应当写成字符串,所以继续重构: const PARENTHESES = { OPEN: '(', CLOSE: ')' }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === PARENTHESES.OPEN) { pipe.push(char); } if (char === PARENTHESES.CLOSE && pipe.pop() !== PARENTHESES.OPEN) { return false; } } if (!pipe.length) return true; return false; } }; 运行、通过! 再增加几个case: it('如果 输入字符串为 ()() ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('()()'), true); }); it('如果 输入字符串为 ()()( ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('()()('), false); }); 第四步: 如果输入字符串为 ] ,这结果返回 false 测试: it('如果 输入字符串为 ] ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute(']'), false); }); 运行、失败! 这个逻辑很简单,只要复制上面的逻辑就ok。 实现: const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (char === PARENTHESES.OPEN) { pipe.push(char); } if (char === PARENTHESES.CLOSE && pipe.pop() !== PARENTHESES.OPEN) { return false; } if (char === BRACKETS.OPEN) { pipe.push(char); } if (char === BRACKETS.CLOSE && pipe.pop() !== BRACKETS.OPEN) { return false; } } if (!pipe.length) return true; return false; } }; 运行、通过! 接下来我们开始重构,这两段代码完全重复,只是判断条件不同,如果后面增加 } 逻辑也是相同,所以这里我们将重复的代码抽成函数。 const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; const holderMap = { '(': PARENTHESES, ')': PARENTHESES, '[': BRACKETS, ']': BRACKETS, }; const compare = (char, pipe) => { const holder = holderMap[char]; if (char === holder.OPEN) { pipe.push(char); } if (char === holder.CLOSE && pipe.pop() !== holder.OPEN) { return false; } return true; }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (!compare(char, pipe)) { return false; } } if (!pipe.length) return true; return false; } }; 运行、通过! 第五步 输入符串为 },期望的结果是 false 。 测试: it('如果 输入字符串为 } ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('}'), false); }); 运行、失败! Parentheses 如果 输入字符串为 } ,当调用 Parentheses.execute(),则结果返回 false: TypeError: Cannot read property 'OPEN' of undefined at compare (src/parentheses.js:22:4) at Object.execute (src/parentheses.js:45:12) at Context.it (test/parentheses.spec.js:29:48) 报错信息和我们期望的不符,原来是 } 字符串没有找到对应的 holder 会报错,来修复一下: const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; const holderMap = { '(': PARENTHESES, ')': PARENTHESES, '[': BRACKETS, ']': BRACKETS, }; const compare = (char, pipe) => { const holder = holderMap[char]; if (!holder) return true; if (char === holder.OPEN) { pipe.push(char); } if (char === holder.CLOSE && pipe.pop() !== holder.OPEN) { return false; } return true; }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (!compare(char, pipe)) { return false; } } if (!pipe.length) return true; return false; } }; 运行、失败!这次失败的结果与我们期望是相同的,然后再修改逻辑。 const PARENTHESES = { OPEN: '(', CLOSE: ')' }; const BRACKETS = { OPEN: '[', CLOSE: ']' }; const BRACES = { OPEN: '{', CLOSE: '}' }; const holderMap = { '(': PARENTHESES, ')': PARENTHESES, '[': BRACKETS, ']': BRACKETS, '{': BRACES, '}': BRACES }; const compare = (char, pipe) => { const holder = holderMap[char]; if (!holder) return true; if (char === holder.OPEN) { pipe.push(char); } if (char === holder.CLOSE && pipe.pop() !== holder.OPEN) { return false; } return true; }; export default { execute(str) { if (str === '') { return true; } const pipe = []; for (let char of str) { if (!compare(char, pipe)) { return false; } } if (!pipe.length) return true; return false; } }; 因为前面的重构,增加 {} 的支持只是增加一些常量的配置。 运行、通过! 再增加些 case: it('如果 输入字符串为 [({})] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('[({})]'), true); }); it('如果 输入字符串为 {}([]) ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{}([])'), true); }); it('如果 输入字符串为 {()}[[{}]] ,当调用 Parentheses.execute(),则结果返回 true', () => { assert.equal(Parentheses.execute('{()}[[{}]]'), true); }); it('如果 输入字符串为 {{)(}} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('{{)(}}'), false); }); it('如果 输入字符串为 ({)} ,当调用 Parentheses.execute(),则结果返回 false', () => { assert.equal(Parentheses.execute('({)}'), false); }); 运行、通过! 再加最后一个 case: const inputStr = ` const fn = () => { const arr = [1, 2, 3]; if (arr.length) { alert('success!'); } }; `; it(`如果 输入字符串为 ${inputStr} ,当调用 Parentheses.execute(),则结果返回 false`, () => { assert.equal(Parentheses.execute(inputStr), true); }); 完成! 总结 通过上面的练习,相信大家应该能够感受到 TDD 的威力,有兴趣的同学可以不使用 TDD 将上面的功能重新实现一遍,对比一下两次实现的时间和质量就知道要不要学习 TDD 这项技能。 资料 https://martinfowler.com/bliki/BeckDesignRules.html 《测试驱动开发的艺术》 本文代码

优秀的个人博客,低调大师

每日一博 | JDK 13 新特性详解

JDK8 新特性详解,2014-03-18正式发布 JDK9 新特性详解,2017-09-21正式发布 JDK10新特性详解,2018-03-20正式发布 JDK11新特性详解,2018-09-25正式发布 JDK12新特性详解,2019-03-19正式发布 JDK13新特性详解,2019-09-17正式发布 1、switch优化更新 JDK11以及之前的版本: switch (day) { case MONDAY: case FRIDAY: case SUNDAY: System.out.println(6); break; case TUESDAY: System.out.println(7); break; case THURSDAY: case SATURDAY: System.out.println(8); break; case WEDNESDAY: System.out.println(9); break; } JDK12版本 switch (day) { case MONDAY, FRIDAY, SUNDAY -> System.out.println(6); case TUESDAY -> System.out.println(7); case THURSDAY, SATURDAY -> System.out.println(8); case WEDNESDAY -> System.out.println(9); } JDK13版本 static void howMany(int k) { System.out.println( switch (k) { case 1 -> "one" case 2 -> "two" default -> "many" } );} 2、文本块升级 2.1、html例子 JDK13之前 String html = "<html>\n" + " <body>\n" + " <p>Hello, world</p>\n" + " </body>\n" + "</html>\n"; JDK13优化的: String html = """ <html> <body> <p>Hello, world</p> </body> </html> """; 2.2、SQL变化 JDK13之前 String query = "SELECT `EMP_ID`, `LAST_NAME` FROM `EMPLOYEE_TB`\n" + "WHERE `CITY` = 'INDIANAPOLIS'\n" + "ORDER BY `EMP_ID`, `LAST_NAME`;\n"; JDK13 String query = """ SELECT `EMP_ID`, `LAST_NAME` FROM `EMPLOYEE_TB` WHERE `CITY` = 'INDIANAPOLIS' ORDER BY `EMP_ID`, `LAST_NAME`; """; 2.3、解释 文本块 """ line 1 line 2 line 3 """ 相当于字符串文字: "line 1\nline 2\nline 3\n" 3、动态CDS档案 目标: 提高应用程序类 - 数据共享(AppCDS)的可用性。消除了用户进行试运行以创建每个应用程序的类列表的需要。-Xshare:dump使用类列表由该选项启用的静态归档应继续工作。这包括内置类加载器和用户定义的类加载器的类。 4、取消使用未使用的内存 摘要: 增强ZGC以将未使用的堆内存返回给操作系统。 动机: ZGC目前没有取消提交并将内存返回给操作系统,即使该内存长时间未使用。对于所有类型的应用程序和环境,此行为并非最佳, 尤其是那些需要关注内存占用的应用程序和环境 例如:通过使用支付资源的容器环境。应用程序可能长时间处于空闲状态并与许多其 他应用程序共享或竞争资源的环境。应用程序在执行期间可能具有非常不同的堆空间要求。 例如,启动期间所需的堆可能大于稳态执行期间稍后所需的堆。HotSpot中的其他垃圾收集器,如G1和Shenandoah,今天提供 了这种功能,某些类别的用户发现它非常有用。将此功能添加到ZGC将受到同一组用户的欢迎。 5、重新实现旧版套接字API 摘要: 使用更简单,更现代的实现替换java.net.Socket和java.net.ServerSocketAPI 使用的底层实现,易于维护和调试。新的实 现很容易适应用户模式线程,也就是光纤,目前正在Project Loom中进行探索。 动机: 在java.net.Socket和java.net.ServerSocketAPI,以及它们的底层实现,可以追溯到JDK 1.0。实现是遗留Java和C代 码的混合,维护和调试很痛苦。该实现使用线程堆栈作为I/O缓冲区,这种方法需要多次增加默认线程堆栈大小。该实现使用本机数据 结构来支持异步关闭,这是多年来微妙可靠性和移植问题的根源。该实现还有几个并发问题,需要进行大修才能正确解决。在未来的光 纤世界环境中,而不是在本机方法中阻塞线程,当前的实现不适用于目的。 6、FileSystems.newFileSystem新方法 核心库/ java.nio中添加了FileSystems.newFileSystem(Path,Map <String,?>)方法 添加了三种新方法java.nio.file.FileSystems,以便更轻松地使用将文件内容视为文件系统的文件系统提供程序。 1、newFileSystem(Path) 2、newFileSystem(Path, Map<String, ?>) 3、newFileSystem(Path, Map<String, ?>, ClassLoader)添加为newFileSystem(Path, Map<String, ?>) 已使用现有2-arg newFileSystem(Path, ClassLoader)并指定类加载器 的代码创建源(但不是二进制)兼容性问题。null.例如,由于引用newFileSystem不明确,因此无法编译以下内容:FileSystem fs = FileSystems.newFileSystem(path, null);为了避免模糊引用,需要修改此代码以将第二个参数强制转换为java.lang.ClassLoader。 7、nio新方法 核心库/ java.nio中新的java.nio.ByteBuffer批量获取/放置方法转移字节而不考虑缓冲区位置。 java.nio.ByteBufferjava.nio现在,其他缓冲区类型定义绝对批量get和put传输连续字节序列的方法,而不考虑或影响缓冲 区位置。 8、核心库/ java.time 新日本时代名称Reiwa,此更新中添加了代表新Reiwa时代的实例。与其他时代不同,这个时代没有公共领域。它可以通过调用 JapaneseEra.of(3)或获得JapaneseEra.valueOf("Reiwa")。JDK13及更高版本将有一个新的公共领域来代表这个时代。 NewEra从2019年5月1日开始的日本时代的占位符名称“ ”已被新的官方名称取代。依赖占位符名称(请参阅JDK-8202088)获 取新时代单例(JapaneseEra.valueOf("NewEra"))的应用程序将不再起作用。请参阅JDK-8205432 9、核心库/ java.util中:I18N 支持Unicode 12.1,此版本将Unicode支持升级到12.1,其中包括以下内容: java.lang.Character支持12.1级的Unicode字符数据库,其中12.0从11.0开始增加554个字符,总共137,928个 字符。这些新增内容包括4个新脚本,总共150个脚本,以及61个新的表情符号字符。U+32FF SQUARE ERA NAME REIWA从 12.0开始,12.1只添加一个字符。java.text.Bidi和java.text.Normalizer类分别支持12.0级的Unicode标准附件, #9和#15。java.util.regexpackage支持基于12.0级Unicode标准附件#29的扩展字形集群。 10、热点/ GC 10.1 JEP 351 ZGC取消提交未使用的存储器 10.2 添加了-XXSoftMaxHeapSize标志 10.3 ZGC支持的最大堆大小从4TB增加到16TB 11、安全库/ java.security 11.1 该com.sun.security.crl.readtimeout系统属性设置为CRL检索的最大读取超时,单位为秒。如果尚未设置该属性, 或者其值为负,则将其设置为默认值15秒。值0表示无限超时。 11.2 新的keytool -showinfo -tls用于显示TLS配置信息的命令keytool -showinfo -tls添加了一个显示TLS配置信 息的新命令。 11.3 SunMSCAPI提供程序现在支持以下一代加密(CNG)格式读取私钥。这意味着CNG格式的RSA和EC密钥可从Windows密钥 库加载,例如“Windows-MY”。与EC(签名算法SHA1withECDSA,SHA256withECDSA等等)也支持。 12、删除功能 删除的部分功能: 12.1 核心库/java.net中,不再支持Pre-JDK 1.4 SocketImpl实现java.net.SocketImpl此版本已删除对为 JavaSE1.3及更早版本编译的自定义实现的支持。此更改对SocketImpl为Java SE 1.4(2002年发布)或更新版本编译 的实现没有影响。 12.2 核心库/java.lang中,删除运行时跟踪方法,过时的方法traceInstructions(boolean),并 traceMethodCalls(boolean)已经从删除java.lang.Runtime类。这些方法对许多版本都不起作用,它们 的预期功能由Java虚拟机工具接口(JVMTI)提供。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册