首页 文章 精选 留言 我的

精选列表

搜索[快直播],共10000篇文章
优秀的个人博客,低调大师

历经十年,Windows 7 生命周期将结束,微软:快换 Windows 10

距离 Microsoft终止对 Windows 7 的支持只剩半年,到 2020 年 1 月 14 日,这款经典的操作系统就要和大家 say goodbye 了。 2009 年 7 月 4 日,Windows 7 正式开发完成,到现在已经整整 10 岁。它在 Vista 前辈的基础上发展而来,界面友好,功能强大,使用高效,因此成了继 Windows XP 之后的又一棵“常青树”,也成了 Windows 10 普及之路上最大的“绊脚石”。 其实在 2015 年 1 月 13 日,Microsoft 就终止了对Windows7 SP1 的主流技术支持,此后仅发放安全补丁和紧急修复补丁,并宣布在 2020 年 1 月 14 日彻底结束拓展支持,不再提供任何补丁。 但即便到了今天,Intel、AMD 新平台都不再支持的情况下,Windows 7 也依然拥有大量拥趸和广阔市场。 NetMarketShare 数据显示,Windows 7 目前仍旧占据多达 35.38% 的桌面系统市场份额,Windows 10 虽然早就成了第一大系统,但也不超过 45.79%,还没有过半。 StatCounter 的数据显示,Windows 10 在微软系统家族中目前已达 58.21%,Windows 7 则仍然有 31.96%。 Windows 7 支持生命周期 Microsoft 承诺为 Windows 7 提供自其 2009 年 10 月 22 日发布以来为期 10 年的产品支持。在为期 10 年的期限结束后,Microsoft 将停止为 Windows 7 提供支持,以便将精力专注于支持较新的技术和出色的新体验。 对 Windows 7 的终止支持具体日期将是 2020 年 1 月 14 日。此后,Microsoft 将不再为该产品提供技术帮助和 Windows 更新中有助于保护电脑的软件更新。Microsoft 强烈建议你在 2020 年 1 月之前的某个时间升级到 Windows 10,以避免无法获得所需的服务或支持。 停止支持意味着什么? Microsoft 将于 2020 年 1 月 14 日对 Windows 7 终止支持,您的电脑还可以继续工作,但是将不再提供以下内容: 任何问题的技术支持 软件更新 安全更新或修复 用户仍可以继续使用运行 Windows 7 的电脑,但如果没有持续软件和安全更新,电脑遭受病毒和恶意软件攻击的风险会更大。 Microsoft 表示,从目前开始,保持安全的最好方式是采用 Windows 10。而使用新电脑是体验 Windows 10 的最好方式。虽然可以在旧设备上安装 Windows 10,但这不是建议做法。 参考:cnBeta

优秀的个人博客,低调大师

数据江湖唯快不破 云数据库RDS存储能力进化解析

导读 数据库是企业IT系统的核心,其性能表现会直接影响整体业务系统的性能表现,而影响数据库性能因素包括系统架构设计、应用程序业务SQL语句、数据库参数优化配置、数据库运行的资源能力。 系统架构设计和应用程序业务SQL语句都属于数据库外围,需要从整体业务上去设计优化;数据库的参数配置,核心是要根据数据库上的业务和硬件特点细调参数,丰富的DBA经验对此项影响很大,归属于软件配置内容且随时可调整。 数据库的硬件资源,在传统企业中属于一项固定资产投资,前期投资成本高,后期更换成本更高,云时代虽然能够随时扩容硬件资源和更换,但亦受到数据迁移、业务停服等影响,因此好的硬件资源选择非常重要。 影响性能的硬件包括CPU、内存、磁盘、网络: CPU:计算能力核心,其表现会直接影响数据库的逻辑运算能力,比方说查询计算、数据聚合、存储过程效率等。 内存:对性能非常关键,其核心是缓存频繁使用数据避免系统频繁与磁盘交互,性能表现一般都在纳秒级延迟,一般OLTP数据库建议内存和数据空间比例至少要保持在20%。 磁盘:相比前两者性能最差,因此磁盘性能表现直接影响数据库整体表现。云数据库目前提供两种磁盘,包括本地盘和云盘,本地盘性能高(微秒级延迟)但存储容量有限,云盘更大存储容量但性能受限(毫秒级延迟)。 网络:网络影响主要在于带宽,因此大查询或者大事务,对网络的要求就很高。 重点分析磁盘性能对业务有影响的因素包括: 延迟:延迟越低,系统响应越实时,如对于交易型系统,延迟会影响到每次用户操作是否卡顿。 吞吐量:带宽越高,并发能力越好,多用户同时操作时可以并发处理更多需求,避免排队。 IOPS:是磁盘并发能力的直接指标,定义是在特定数据块(如4K)大小下每秒可处理的IO请求数。 上面提到本地盘的性能要好于云盘,那么为什么云数据库RDS的发展要往云盘方向走呢?主要原因除了性能以外,云盘还有诸多企业特性满足各类业务需求,如三副本数据存储可保证业务数据可靠性达到9个9,存储与计算分离,可支持容量更大同时扩容相对更简单等。 而ESSD云盘相对SSD云盘,企业特性有非常大的加强,同时重点性能表现大大提升,达到本地盘能力甚至超越。下面我将重点分析企业级高性能存储ESSD的核心能力。 极致性能极致稳定 ESSD最大实现单实例单盘100万IOPS,并且读写时延降低70%+,最快达到200us,核心能力的技术保障是ESSD首次采用面向未来的架构设计。 首先ESSD云盘采用RDMA网卡,在硬件上保障了网络吞吐能力达到了50Gbps。 其次在软件层面阿里云研发了新一代的底层存储系统,存储引擎2.0,性能表现极致同时坚如磐石,是稳定性能表现的关键,高IOPS场景下响应时间几乎无抖动。最后软件架构层面实现了全用户态协议栈,降低了70%时延。 阿里云自研的存储引擎2.0新架构是性能提升关键,实现了用户态文件系统(FusionEngine)、高性能网络库(OptimizedTCP RDMA)、极致的软件栈优化(实现无锁、无上下文切换、零拷贝),多流映射(吞吐量提升三倍),实现动态切换(99.9%分位延迟降为1/10)等核心技术。 RDS率先支持ESSD存储,第一时间为客户提供高性能的数据库服务,经过实际客户业务测试,MySQL数据库在云盘容量减少60%的前提下,较SSD云盘,ESSD云盘TPS提升200%以上,时延降低60%以上。 在线扩容业务永续 磁盘容量规划是非常重要的数据库设计内容,云时代客户可以先购买够用的小空间容量,之后根据业务发展弹性扩容空间。 在此之前,云数据库云盘的扩容都会涉及到业务闪断,比如说MySQL5.7高可用版、SQLServer 2016 标准高可用版,用户发起磁盘扩容需求后,RDS管控系统会先在后端扩容备库磁盘空间,然后做主备切换(涉及业务连接闪断),最后再原主库扩容磁盘空间,扩容期间具体的实例主机都会涉及重启,整个过程约花费半小时(但业务影响只有闪断),有时也很难解决燃眉之急。 ESSD云盘支持在线扩容,此特性确保在数据库接到扩容需求后,立即执行磁盘空间动作,无需主备切换,无需重启数据库实例机器,简单且方便的保障业务连续访问。 快照备份有备无患 ESSD云盘集成快照特性,最多可支持64个快照,支持跨可用区多副本的数据保护能力。该特性特别适用于数据库的备份需求。 云数据库RDS针对ESSD的急速快照能力,研发了全新一代数据库备份系统,支持利用快照能力备份整个实例,并且支持全量和增量快照能力,备份和恢复速度都大大提升。由于备份效率的提升,RDS可以提供更大容量,满足有大空间需求的用户。 极致安全自助可控 云数据库RDS通过ESSD的安全加密能力,实现落盘加密功能,并且支持客户自带秘钥,满足全部行业的最严安全合规要求,诸如金融、保险、证券等行业。 另外结合RDS数据链路加密和SQL审计功能,为应用系统运行期间的链路、存储、审计三个维度提供严格的安全保护。 如何购买RDS ESSD版实例 购买RDS高性能存储ESSD版实例过程及其简单,申请开通权限后,用户在购买RDS实例的时候,存储类型就可以选择ESSD后,即可点击购买完成实例生产。 云数据库RDS存储类型从支持本地盘,到支持SSD云盘,再到支持ESSD云盘,技术路径演进方向明确,存储与计算分离、更高数据可靠性、更强数据安全性、更快性能、更易用企业特性,功能和能力范围不断增强,基于ECS和ESSD的新架构能够充分利用硬件红利,为企业客户提供最好的数据库服务。 原文发布时间为:2019-04-03本文作者:胜通本文来自云栖社区合作伙伴“ 阿里巴巴数据库技术”,了解相关信息可以关注“ 阿里巴巴数据库技术”。

优秀的个人博客,低调大师

《快学 Go 语言》第 11 课 —— 千军万马跑协程

协程和通道是 Go 语言作为并发编程语言最为重要的特色之一,初学者可以完全将协程理解为线程,但是用起来比线程更加简单,占用的资源也更少。通常在一个进程里启动上万个线程就已经不堪重负,但是 Go 语言允许你启动百万协程也可以轻松应付。如果把协程比喻成小岛,那通道就是岛屿之间的交流桥梁,数据搭乘通道从一个协程流转到另一个协程。通道是并发安全的数据结构,它类似于内存消息队列,允许很多的协程并发对通道进行读写。 图片 Go 语言里面的协程称之为 goroutine,通道称之为 channel。 协程的启动 Go 语言里创建一个协程非常简单,使用 go 关键词加上一个函数调用就可以了。Go 语言会启动一个新的协程,函数调用将成为这个协程的入口。 package mainimport "fmt"import "time"func main() { fmt.Println("run in main goroutine")go func() { fmt.Println("run in child goroutine")go func() { fmt.Println("run in grand child goroutine")go func() { fmt.Println("run in grand grand child goroutine") }() }() }() time.Sleep(time.Second) fmt.Println("main goroutine will quit") } ------- run in main goroutine run in child goroutine run in grand child goroutine run in grand grand child goroutine main goroutine will quit main 函数运行在主协程(main goroutine)里面,上面的例子中我们在主协程里面启动了一个子协程,子协程又启动了一个孙子协程,孙子协程又启动了一个曾孙子协程。这些协程之间似乎形成了父子、子孙、关系,但是实际上协程之间并不存在这么多的层级关系,在 Go 语言里只有一个主协程,其它都是它的子协程,子协程之间是平行关系。 值得注意的是这里的 go 关键字语法和前面的 defer 关键字语法是一样的,它后面跟了一个匿名函数,然后还要带上一对(),表示对匿名函数的调用。 上面的代码中主协程睡眠了 1s,等待子协程们执行完毕。如果将睡眠的这行代码去掉,将会看不到子协程运行的痕迹 ------------- run in main goroutine main goroutine will quit 这是因为主协程运行结束,其它协程就会立即消亡,不管它们是否已经开始运行。 子协程异常退出 在使用子协程时一定要特别注意保护好每个子协程,确保它们正常安全的运行。因为子协程的异常退出会将异常传播到主协程,直接会导致主协程也跟着挂掉,然后整个程序就崩溃了。 package mainimport "fmt"import "time"func main() { fmt.Println("run in main goroutine")go func() { fmt.Println("run in child goroutine")go func() { fmt.Println("run in grand child goroutine")go func() { fmt.Println("run in grand grand child goroutine")panic("wtf") }() }() }() time.Sleep(time.Second) fmt.Println("main goroutine will quit") } --------- run in main goroutine run in child goroutine run in grand child goroutine run in grand grand child goroutinepanic: wtf goroutine 34 [running]: main.main.func1.1.1() /Users/qianwp/go/src/github.com/pyloque/practice/main.go:14 +0x79 created by main.main.func1.1 /Users/qianwp/go/src/github.com/pyloque/practice/main.go:12 +0x75 exit status 2 我们看到主协程最后一句打印语句没能运行就挂掉了,主协程在异常退出时会打印堆栈信息。从堆栈信息中可以了解到是哪行代码引发了程序崩溃。 为了保护子协程的安全,通常我们会在协程的入口函数开头增加 recover() 语句来恢复协程内部发生的异常,阻断它传播到主协程导致程序崩溃。 go func() {if err := recover(); err != nil {// log error }// do something }() 启动百万协程 Go 语言能同时管理上百万的协程,这不是吹牛,下面我们就来编写代码跑一跑这百万协程,读者们请想象一下这百万大军同时奔跑的感觉。 package mainimport "fmt"import "time"func main() { fmt.Println("run in main goroutine") i := 1for {go func() {for { time.Sleep(time.Second) } }()if i % 10000 == 0 { fmt.Printf("%d goroutine started\n", i) } i++ } } 上面的代码将会无休止地创建协程,每个协程都在睡眠,为了确保它们都是活的,协程会 1s 钟醒过来一次。在我的个人电脑上,这个程序瞬间创建了 200w 个协程,观察发现内存占用在 4G 多,这意味着每个协程的内存占用大概 2000 多字节。协程还在继续创建,电脑开始变的卡顿,应该是程序开始使用交换分区,CPU 占用率持续走高。再继续压榨下去已经没有了意义。 协程死循环 前面我们通过 recover() 函数可以防止个别协程的崩溃波及整体进程。但是如果有个别协程死循环了会导致其它协程饥饿得到不运行么?下面我们来做一个实验 package mainimport "fmt"import "time"func main() { fmt.Println("run in main goroutine") n := 3for i:=0; i<n; i++ {go func() { fmt.Println("dead loop goroutine start")for {} // 死循环 }() }for { time.Sleep(time.Second) fmt.Println("main goroutine running") } } 通过调整上面代码中的变量 n 的值可以发现一个有趣的现象,当 n 值大于 3 时,主协程将没有机会得到运行,而如果 n 值为 3、2、1,主协程依然可以每秒输出一次。要解释这个现象就必须深入了解协程的运行原理 协程的本质 一个进程内部可以运行多个线程,而每个线程又可以运行很多协程。线程要负责对协程进行调度,保证每个协程都有机会得到执行。当一个协程睡眠时,它要将线程的运行权让给其它的协程来运行,而不能持续霸占这个线程。同一个线程内部最多只会有一个协程正在运行。 图片 线程的调度是由操作系统负责的,调度算法运行在内核态,而协程的调用是由 Go 语言的运行时负责的,调度算法运行在用户态。 协程可以简化为三个状态,运行态、就绪态和休眠态。同一个线程中最多只会存在一个处于运行态的协程,就绪态的协程是指那些具备了运行能力但是还没有得到运行机会的协程,它们随时会被调度到运行态,休眠态的协程还不具备运行能力,它们是在等待某些条件的发生,比如 IO 操作的完成、睡眠时间的结束等。 图片 操作系统对线程的调度是抢占式的,也就是说单个线程的死循环不会影响其它线程的执行,每个线程的连续运行受到时间片的限制。 Go 语言运行时对协程的调度并不是抢占式的。如果单个协程通过死循环霸占了线程的执行权,那这个线程就没有机会去运行其它协程了,你可以说这个线程假死了。不过一个进程内部往往有多个线程,假死了一个线程没事,全部假死了才会导致整个进程卡死。 每个线程都会包含多个就绪态的协程形成了一个就绪队列,如果这个线程因为某个别协程死循环导致假死,那这个队列上所有的就绪态协程是不是就没有机会得到运行了呢?Go 语言运行时调度器采用了 work-stealing 算法,当某个线程空闲时,也就是该线程上所有的协程都在休眠(或者一个协程都没有),它就会去其它线程的就绪队列上去偷一些协程来运行。也就是说这些线程会主动找活干,在正常情况下,运行时会尽量平均分配工作任务。 设置线程数 默认情况下,Go 运行时会将线程数会被设置为机器 CPU 逻辑核心数。同时它内置的 runtime 包提供了 GOMAXPROCS(n int) 函数允许我们动态调整线程数,注意这个函数名字是全大写,Go 语言的设计者就是这么任性,该函数会返回修改前的线程数,如果参数 n <=0 ,就不会产生修改效果,等价于读操作。 package mainimport "fmt"import "runtime"func main() {// 读取默认的线程数 fmt.Println(runtime.GOMAXPROCS(0))// 设置线程数为 10 runtime.GOMAXPROCS(10)// 读取当前的线程数 fmt.Println(runtime.GOMAXPROCS(0)) } --------410 获取当前的协程数量可以使用 runtime 包提供的 NumGoroutine() 方法 package mainimport "fmt"import "time"import "runtime"func main() { fmt.Println(runtime.NumGoroutine())for i:=0;i<10;i++ {go func(){for { time.Sleep(time.Second) } }() } fmt.Println(runtime.NumGoroutine()) } ------111 协程的应用 在日常互联网应用中,Go 语言的协程主要应用在HTTP API 应用、消息推送系统、聊天系统等。 在 HTTP API 应用中,每一个 HTTP 请求,服务器都会单独开辟一个协程来处理。在这个请求处理过程中,要进行很多 IO 调用,比如访问数据库、访问缓存、调用外部系统等,协程会休眠,IO 处理完成后协程又会再次被调度运行。待请求的响应回复完毕后,链接断开,这个协程的寿命也就到此结束。 在消息推送系统中,客户端的链接寿命很长,大部分时间这个链接都是空闲状态,客户端会每隔几十秒周期性使用心跳来告知服务器你不要断开我。在服务器端,每一个来自客户端链接的维持都需要单独一个协程。因为消息推送系统维持的链接普遍很闲,单台服务器往往可以轻松撑起百万链接,这些维持链接的协程只有在推送消息或者心跳消息到来时才会变成就绪态被调度运行。 聊天系统也是长链接系统,它内部来往的消息要比消息推送系统频繁很多,限于 CPU 和 网卡的压力,它能撑住的连接数要比推送系统少很多。不过原理是类似的,都是一个链接由一个协程长期维持,连接断开协程也就消亡。 在后面的高级内容部分,我将会教读者使用协程来实现上面这三个系统。下一章节我们开讲通道,因为通道的使用比较复杂,知识点较多,所以需要单独一节来讲。 原文发布时间为: 2018-12-03 本文作者:老钱 本文来自云栖社区合作伙伴“ 码洞”,了解相关信息可以关注“码洞”。

优秀的个人博客,低调大师

《快学 Go 语言》第 8 课 —— 程序大厦是如何构建起来的

本节我们要开讲 Go 语言在数据结构上最重要的概念 —— 结构体。如果说 Go 语言的基础类型是原子,那么结构体就是分子。分子是原子的组合,让形式有限的基础类型变化出丰富多样的形态结构。结构体里面装的是基础类型、切片、字典、数组以及其它类型的结构体等等。 因为结构体的存在,Go 语言的变量才有了更加丰富多彩的形式,Go 语言程序的高楼大厦正是通过结构体一层层组装起来的。 结构体类型的定义 结构体和其它高级语言里的「类」比较类似。下面我们使用结构体语法来定义一个「圆」型 type Circle struct { x int y int Radius int } Circle 结构体内部有三个变量,分别是圆心的坐标以及半径。特别需要注意是结构体内部变量的大小写,首字母大写是公开变量,首字母小写是内部变量,分别相当于类成员变量的 Public 和 Private 类别。内部变量只有属于同一个 package(简单理解就是同一个目录)的代码才能直接访问。 结构体变量的创建 创建一个结构体变量有多种形式,我们先看结构体变量最常见的创建形式 package mainimport "fmt"type Circle struct { x int y int Radius int }func main() {var c Circle = Circle { x: 100, y: 100, Radius: 50, // 注意这里的逗号不能少 } fmt.Printf("%+v\n", c) } ---------- {x:100 y:100 Radius:50} 通过显示指定结构体内部字段的名称和初始值来初始化结构体,可以只指定部分字段的初值,甚至可以一个字段都不指定,那些没有指定初值的字段会自动初始化为相应类型的「零值」。这种形式我们称之为 「KV 形式」。 package mainimport "fmt"type Circle struct { x int y int Radius int }func main() {var c1 Circle = Circle { Radius: 50, }var c2 Circle = Circle {} fmt.Printf("%+v\n", c1) fmt.Printf("%+v\n", c2) } ---------- {x:0 y:0 Radius:50} {x:0 y:0 Radius:0} 结构体的第二种创建形式是不指定字段名称来顺序字段初始化,需要显示提供所有字段的初值,一个都不能少。这种形式称之为「顺序形式」。 package mainimport "fmt"type Circle struct { x int y int Radius int }func main() {var c Circle = Circle {100, 100, 50} fmt.Printf("%+v\n", c) } ------- {x:100 y:100 Radius:50} 结构体变量和普通变量都有指针形式,使用取地址符就可以得到结构体的指针类型 package mainimport "fmt"type Circle struct { x int y int Radius int }func main() {var c *Circle = &Circle {100, 100, 50} fmt.Printf("%+v\n", c) } ----------- &{x:100 y:100 Radius:50} 注意上面的输出,指针形式多了一个地址符 &,表示打印的对象是一个指针类型。介绍完了结构体变量的指针形式,下面就可以引入结构体变量创建的第三种形式,使用全局的 new() 函数来创建一个「零值」结构体,所有的字段都被初始化为相应类型的零值。 package mainimport "fmt"type Circle struct { x int y int Radius int }func main() {var c *Circle = new(Circle) fmt.Printf("%+v\n", c) } ---------- &{x:0 y:0 Radius:0} 注意 new() 函数返回的是指针类型。下面再引入结构体变量的第四种创建形式,这种形式也是零值初始化,就数它看起来最不雅观。 package mainimport "fmt"type Circle struct { x int y int Radius int }func main() {var c Circle fmt.Printf("%+v\n", c) } 最后我们再将三种零值初始化形式放到一起对比观察一下 var c1 Circle = Circle{}var c2 Circlevar c3 *Circle = new(Circle) 零值结构体和 nil 结构体 nil 结构体是指结构体指针变量没有指向一个实际存在的内存。这样的指针变量只会占用 1 个指针的存储空间,也就是一个机器字的内存大小。 var c *Circle = nil 而零值结构体是会实实在在占用内存空间的,只不过每个字段都是零值。如果结构体里面字段非常多,那么这个内存空间占用肯定也会很大。 结构体的内存大小 Go 语言的 unsafe 包提供了获取结构体内存占用的函数 Sizeof() package mainimport "fmt"import "unsafe"type Circle struct { x int y int Radius int }func main() {var c Circle = Circle {Radius: 50} fmt.Println(unsafe.Sizeof(c)) } -------24 Circle 结构体在我的 64位机器上占用了 24 个字节,因为每个 int 类型都是 8 字节。在 32 位机器上,Circle 结构体只会占用 12 个字节。 结构体的拷贝 结构体之间可以相互赋值,它在本质上是一次浅拷贝操作,拷贝了结构体内部的所有字段。结构体指针之间也可以相互赋值,它在本质上也是一次浅拷贝操作,不过它拷贝的仅仅是指针地址值,结构体的内容是共享的。 package mainimport "fmt"type Circle struct { x int y int Radius int }func main() {var c1 Circle = Circle {Radius: 50}var c2 Circle = c1 fmt.Printf("%+v\n", c1) fmt.Printf("%+v\n", c2) c1.Radius = 100 fmt.Printf("%+v\n", c1) fmt.Printf("%+v\n", c2)var c3 *Circle = &Circle {Radius: 50}var c4 *Circle = c3 fmt.Printf("%+v\n", c3) fmt.Printf("%+v\n", c4) c1.Radius = 100 fmt.Printf("%+v\n", c3) fmt.Printf("%+v\n", c4) } --------------- {x:0 y:0 Radius:50} {x:0 y:0 Radius:50} {x:0 y:0 Radius:100} {x:0 y:0 Radius:50} &{x:0 y:0 Radius:50} &{x:0 y:0 Radius:50} &{x:0 y:0 Radius:50} &{x:0 y:0 Radius:50} 试试解释一下上面的输出结果 无处不在的结构体 通过观察 Go 语言的底层源码,可以发现所有的 Go 语言内置的高级数据结构都是由结构体来完成的。 切片头的结构体形式如下,它在 64 位机器上将会占用 24 个字节 type slice struct { array unsafe.Pointer // 底层数组的地址len int // 长度cap int // 容量 } 字符串头的结构体形式,它在 64 位机器上将会占用 16 个字节 type string struct {array unsafe.Pointer // 底层数组的地址 len int } 字典头的结构体形式 type hmap struct { count int ... buckets unsafe.Pointer // hash桶地址 ... } 结构体中的数组和切片 在数组与切片章节,我们自习分析了数组与切片在内存形式上的区别。数组只有「体」,切片除了「体」之外,还有「头」部。切片的头部和内容体是分离的,使用指针关联起来。请读者尝试解释一下下面代码的输出结果 package mainimport "fmt"import "unsafe"type ArrayStruct struct { value [10]int }type SliceStruct struct { value []int }func main() {var as = ArrayStruct{[...]int{0, 1, 2, 3, 4, 5, 6, 7, 8, 9}}var ss = SliceStruct{[]int{0, 1, 2, 3, 4, 5, 6, 7, 8, 9}} fmt.Println(unsafe.Sizeof(as), unsafe.Sizeof(ss)) } -------------80 24 注意代码中的数组初始化使用了 […] 语法糖,表示让编译器自动推导数组的长度。 结构体的参数传递 函数调用时参数传递结构体变量,Go 语言支持值传递,也支持指针传递。值传递涉及到结构体字段的浅拷贝,指针传递会共享结构体内容,只会拷贝指针地址,规则上和赋值是等价的。下面我们使用两种传参方式来编写扩大圆半径的函数。 package mainimport "fmt"type Circle struct { x int y int Radius int }func expandByValue(c Circle) { c.Radius *= 2 }func expandByPointer(c *Circle) { c.Radius *= 2 }func main() {var c = Circle {Radius: 50} expandByValue(c) fmt.Println(c) expandByPointer(&c) fmt.Println(c) } --------- {0 0 50} {0 0 100} 从上面的输出中可以看到通过值传递,在函数里面修改结构体的状态不会影响到原有结构体的状态,函数内部的逻辑并没有产生任何效果。通过指针传递就不一样。 结构体方法 Go 语言不是面向对象的语言,它里面不存在类的概念,结构体正是类的替代品。类可以附加很多成员方法,结构体也可以。 package mainimport "fmt"import "math"type Circle struct { x int y int Radius int }// 面积func (c Circle) Area() float64 {return math.Pi * float64(c.Radius) * float64(c.Radius) }// 周长func (c Circle) Circumference() float64 {return 2 * math.Pi * float64(c.Radius) }func main() {var c = Circle {Radius: 50} fmt.Println(c.Area(), c.Circumference())// 指针变量调用方法形式上是一样的var pc = &c fmt.Println(pc.Area(), pc.Circumference()) } -----------7853.981633974483 314.15926535897937853.981633974483 314.1592653589793 Go 语言不喜欢类型的隐式转换,所以需要将整形显示转换成浮点型,不是很好看,不过这就是 Go 语言的基本规则,显式的代码可能不够简洁,但是易于理解。 Go 语言的结构体方法里面没有 self 和 this 这样的关键字来指代当前的对象,它是用户自己定义的变量名称,通常我们都使用单个字母来表示。 Go 语言的方法名称也分首字母大小写,它的权限规则和字段一样,首字母大写就是公开方法,首字母小写就是内部方法,只能归属于同一个包的代码才可以访问内部方法。 结构体的值类型和指针类型访问内部字段和方法在形式上是一样的。这点不同于 C++ 语言,在 C++ 语言里,值访问使用句点 . 操作符,而指针访问需要使用箭头 -> 操作符。 结构体的指针方法 如果使用上面的方法形式给 Circle 增加一个扩大半径的方法,你会发现半径扩大不了。 func (c Circle) expand() { c.Radius *= 2 } 这是因为上面的方法和前面的 expandByValue 函数是等价的,只不过是把函数的第一个参数挪了位置而已,参数传递时会复制了一份结构体内容,起不到扩大半径的效果。这时候就必须要使用结构体的指针方法 func (c *Circle) expand() { c.Radius *= 2 } 结构体指针方法和值方法在调用时形式上是没有区别的,只不过一个可以改变结构体内部状态,而另一个不会。指针方法使用结构体值变量可以调用,值方法使用结构体指针变量也可以调用。 通过指针访问内部的字段需要 2 次内存读取操作,第一步是取得指针地址,第二部是读取地址的内容,它比值访问要慢。但是在方法调用时,指针传递可以避免结构体的拷贝操作,结构体比较大时,这种性能的差距就会比较明显。 还有一些特殊的结构体它不允许被复制,比如结构体内部包含有锁时,这时就必须使用它的指针形式来定义方法,否则会发生一些莫名其妙的问题。 内嵌结构体 结构体作为一种变量它可以放进另外一个结构体作为一个字段来使用,这种内嵌结构体的形式在 Go 语言里称之为「组合」。下面我们来看看内嵌结构体的基本使用方法 package mainimport "fmt"type Point struct { x int y int }func (p Point) show() { fmt.Println(p.x, p.y) }type Circle struct { loc Point Radius int }func main() {var c = Circle { loc: Point { x: 100, y: 100, }, Radius: 50, } fmt.Printf("%+v\n", c) fmt.Printf("%+v\n", c.loc) fmt.Printf("%d %d\n", c.loc.x, c.loc.y) c.loc.show() } ---------------- {loc:{x:100 y:100} Radius:50} {x:100 y:100}100 100100 100 匿名内嵌结构体 还有一种特殊的内嵌结构体形式,内嵌的结构体不提供名称。这时外面的结构体将直接继承内嵌结构体所有的内部字段和方法,就好像把子结构体的一切全部都揉进了父结构体一样。匿名的结构体字段将会自动获得以结构体类型的名字命名的字段名称 package mainimport "fmt"type Point struct { x int y int }func (p Point) show() { fmt.Println(p.x, p.y) }type Circle struct { Point // 匿名内嵌结构体 Radius int }func main() {var c = Circle { Point: Point { x: 100, y: 100, }, Radius: 50, } fmt.Printf("%+v\n", c) fmt.Printf("%+v\n", c.Point) fmt.Printf("%d %d\n", c.x, c.y) // 继承了字段 fmt.Printf("%d %d\n", c.Point.x, c.Point.y) c.show() // 继承了方法 c.Point.show() } ------- {Point:{x:100 y:100} Radius:50} {x:100 y:100}100 100100 100100 100100 100 这里的继承仅仅是形式上的语法糖,c.show() 被转换成二进制代码后和 c.Point.show() 是等价的,c.x 和 c.Point.x 也是等价的。 Go 语言的结构体没有多态性 Go 语言不是面向对象语言在于它的结构体不支持多态,它不能算是一个严格的面向对象语言。多态是指父类定义的方法可以调用子类实现的方法,不同的子类有不同的实现,从而给父类的方法带来了多样的不同行为。下面的例子呈现了 Java 类的多态性。 class Fruit {public void eat() { System.out.println("eat fruit"); }public void enjoy() { System.out.println("smell first"); eat(); System.out.println("clean finally"); } }class Apple extends Fruit {public void eat() { System.out.println("eat apple"); } }class Banana extends Fruit {public void eat() { System.out.println("eat banana"); } }public class Main {public static void main(String[] args) { Apple apple = new Apple(); Banana banana = new Banana(); apple.enjoy(); banana.enjoy(); } } ---------------- smell first eat apple clean finally smell first eat banana clean finally 父类 Fruit 定义的 enjoy 方法调用了子类实现的 eat 方法,子类的方法可以对父类定义的方法进行覆盖,父类的 eat 方法被隐藏起来了。 Go 语言的结构体明确不支持这种形式的多态,外结构体的方法不能覆盖内部结构体的方法。比如我们用 Go 语言来改写上面的水果例子观察一下输出结果。 package mainimport "fmt"type Fruit struct {}func (f Fruit) eat() { fmt.Println("eat fruit") }func (f Fruit) enjoy() { fmt.Println("smell first") f.eat() fmt.Println("clean finally") }type Apple struct { Fruit }func (a Apple) eat() { fmt.Println("eat apple") }type Banana struct { Fruit }func (b Banana) eat() { fmt.Println("eat banana") }func main() {var apple = Apple {}var banana = Banana {} apple.enjoy() banana.enjoy() } ---------- smell first eat fruit clean finally smell first eat fruit clean finally enjoy 方法调用的 eat 方法还是 Fruit 自己的 eat 方法,它没能被外面的结构体方法覆盖掉。这意味着面向对象的代码习惯不能直接用到 Go 语言里了,我们需要转变思维。 面向对象的多态性需要通过 Go 语言的接口特性来模拟,这就是下一节我们要讲的主题。 原文发布时间为: 2018-11-23 本文作者: 码洞 本文来自云栖社区合作伙伴“ 码洞”,了解相关信息可以关注“ 码洞”。

优秀的个人博客,低调大师

区块链开发公司发展速度快 区块链技术的未来何去何从

区块链的概念最早源自比T币,已经存在近10年之久了。随着区块链近年来市场热度持续升温,越来越多的行业及企业开始关注区块链技术领域。 为什么说区块链是这么 火热?为什么说区块链是未来? 让我们来看看区块链未来发展趋势与可以应用在哪些行业 区块链行业是一个高科技行业,如今,随着区块链行业开始深入到各个细分行业,技术逐渐变成了一种手段,人们已经不能严格区分出怎样才是真正的区块链技术。 如果说“互联网+”的推进让更多的行业触网,那么区块链分享经济则为这些行业打开了一扇大门,让他们可以通过区块链更加迅速地变革传统的商业模式,聚品优优正是抓住这一关键点,实现全新的发展。 现在的区块链已经被应用于各行各业,被广大人名群众认识并认可,区块链技术的性质使人们就相信区块链是值得信任的,区块链在金融、医疗、政府、生活、社会、等等都可以用到,可谓是是一个全能的系统软件,也正因为如此,它的发展不仅仅智能局限在这些中,他依旧在突破,区块链技术的作用就是这样,服务于各个行业。 当前,区块链技术已经被世界认可,成为一种必然的发展趋势,各国都在抓紧布局以争夺高位。伴随而来的,是全世界的目光,马云说:“未来30年,是新技术融合到传统行业的方方面面,是人类社会天翻地覆的30年,不管你是什么人,不管你身处哪里,我们所有每个人都会是这场大变革的一部分。” 其实只要大家有关注过币圈消息,就能发现一个奇怪的现象,国内外对数字货币和区块链是两种截然不同的态度:国内鼓励区块链技术发展,禁止数字货币市场炒币; 但是区块链技术已经被认可,区块链在未来的发展中定会有不可估量的作用,无论是在哪个方面,区块链的作用都是不可限量的。

优秀的个人博客,低调大师

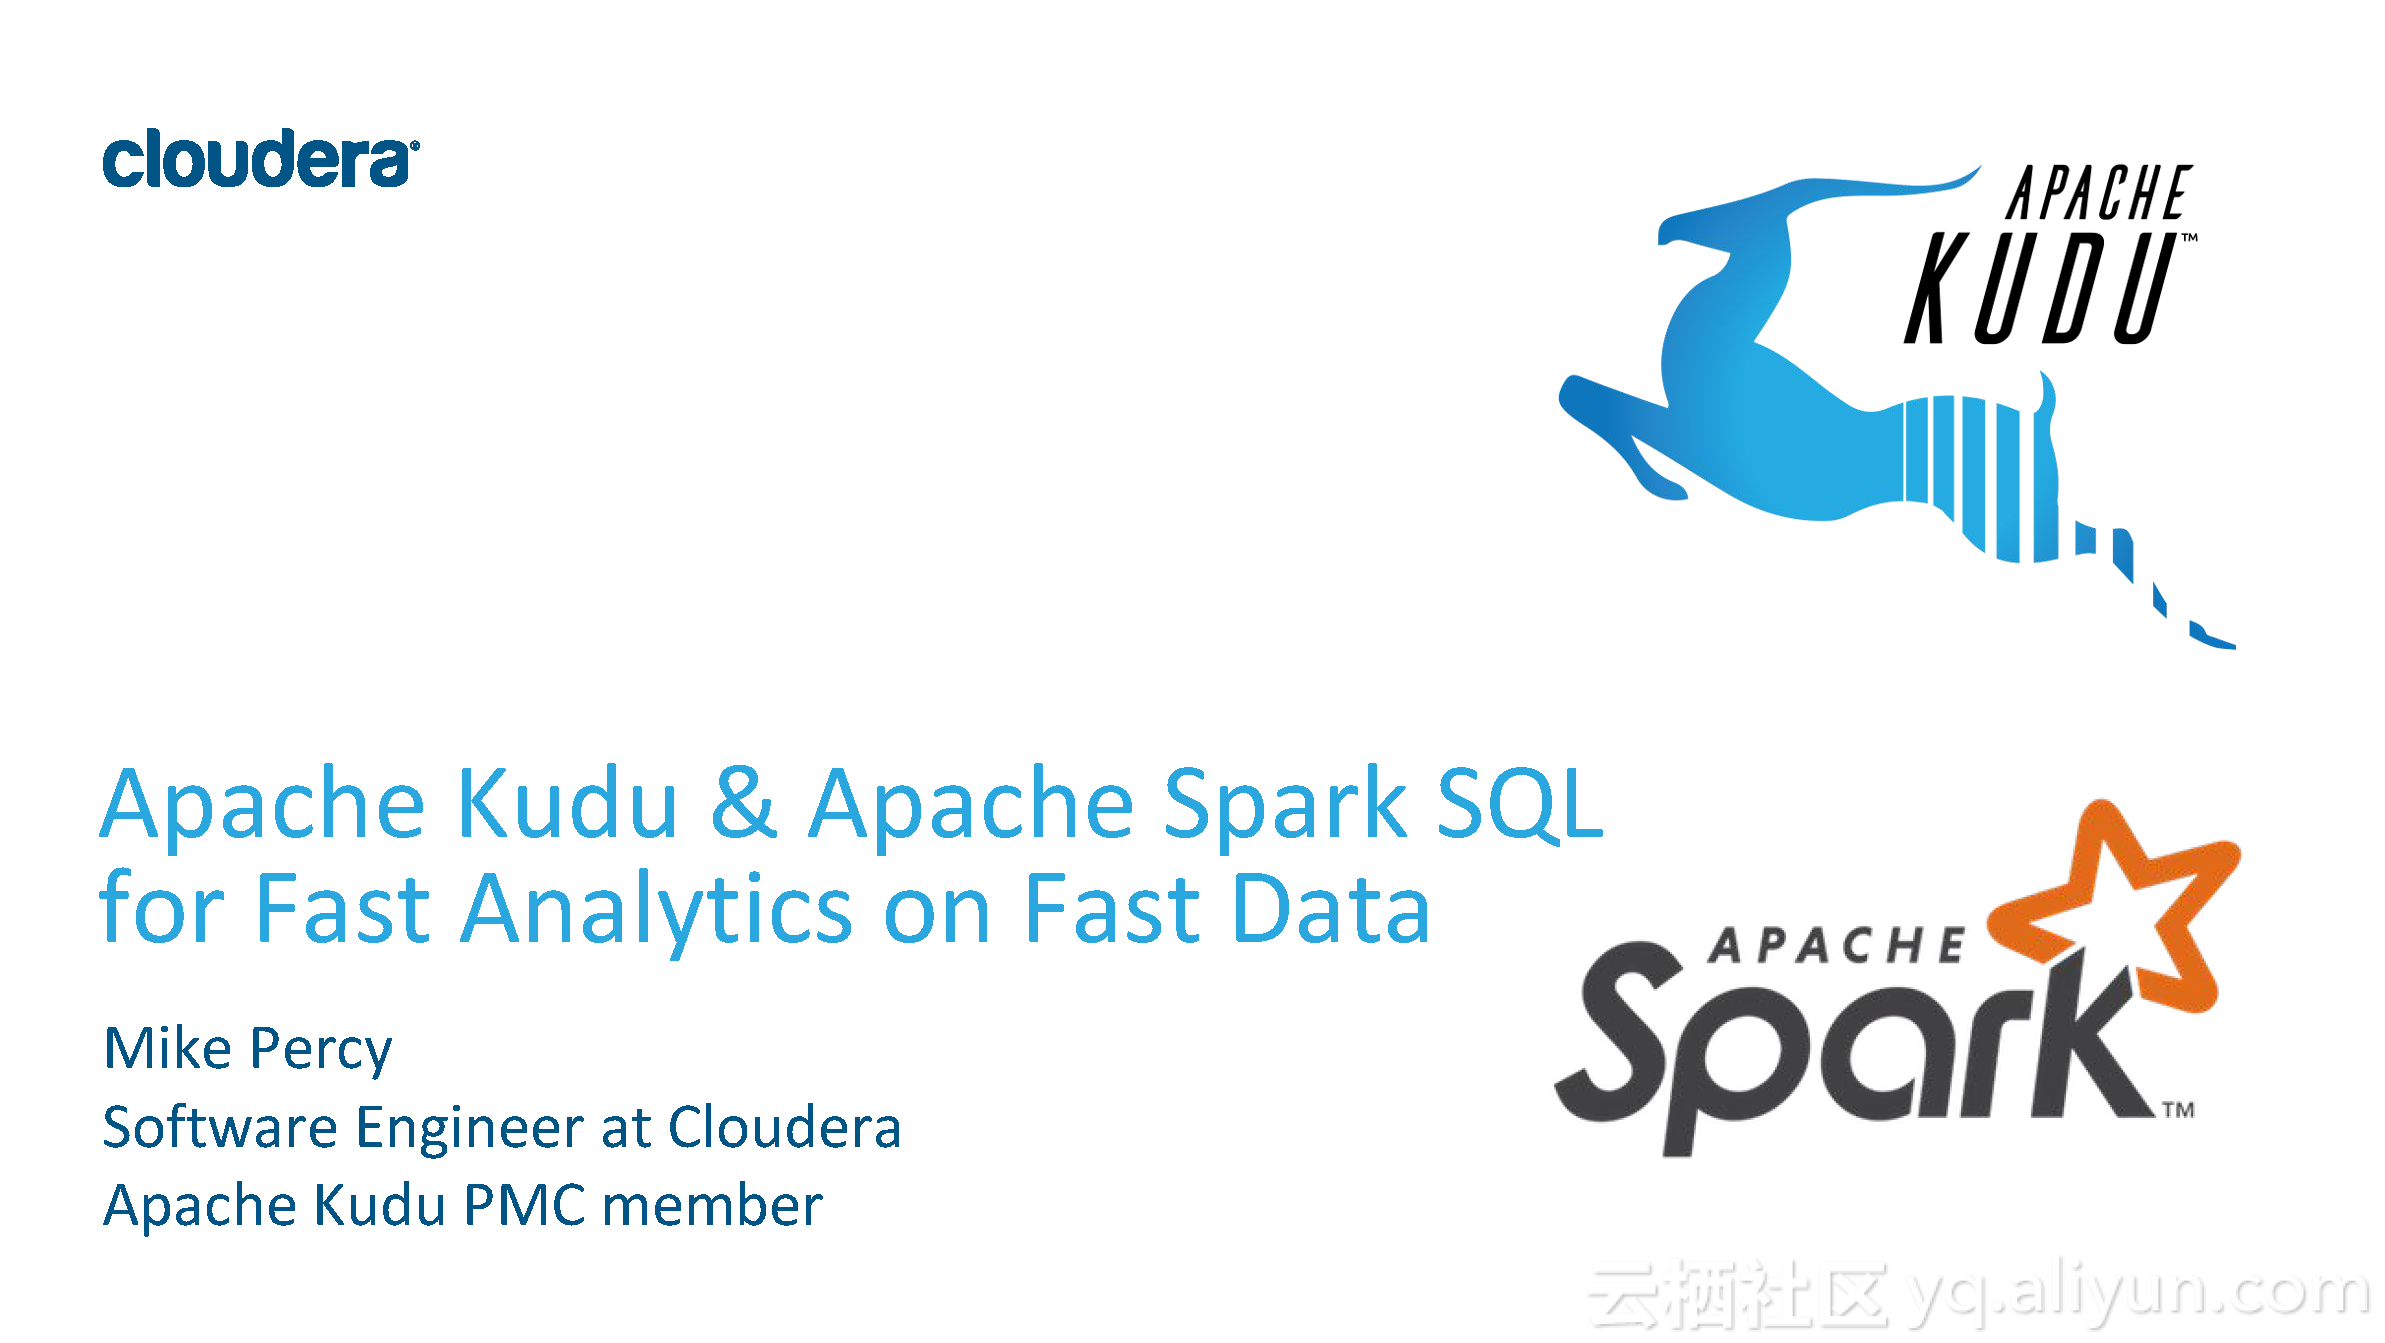
【Spark Summit EU 2016】Apache Kudu&Spark SQL:对快数据进行快速分析

更多精彩内容参见云栖社区大数据频道https://yq.aliyun.com/big-data;此外,通过Maxcompute及其配套产品,低廉的大数据分析仅需几步,详情访问https://www.aliyun.com/product/odps。 本讲义出自 Mike Percy在Spark Summit EU上的演讲,主要介绍了Cloudera开发的大型开源储存引擎 Kudu,该引擎用于储存和服务大量不同类型的非结构化数据,并且介绍了使用Kudu+Spark SQL对于数据进行快速分析的方法,并分享了多个使用Kudu+Spark SQL进行数据分析的实际案例。

优秀的个人博客,低调大师

运算速度快3个数量级

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 据《麻省理工技术评论》杂志网站近日报道,美国普林斯顿大学的科研团队日前研制出全球首枚光子神经形态芯片,并证明其能以超快速度计算。该芯片有望开启一个全新的光子计算产业。 普林斯顿大学亚力山大·泰特团队的新成果是利用光子解决了神经网络电路速度受限这一难题。神经网络电路已在计算领域掀起风暴。科学家希望制造出更强大的神经网络电路,其关键在于制造出能像神经元那样工作的电路,或称神经形态芯片,但此类电路的主要问题是要提高速度。光子计算是计算科学领域的“明日之星”。与电子相比,光子拥有更多带宽,能快速处理更多数据。但光子数据处理系统制造成本较高,因此一直未被广泛采用。 团队研制出的光子神经网络的核心是一种光学设备——其中的每个节点拥有神经元一样的响应特征。这些节点采用微型圆形波导的形式,被蚀刻进一个光可在其中循环的硅基座内。当光被输入,接着会调节在阈值处工作的激光器的输出,在此区域中,入射光的微小变化都会对该激光的输出产生巨大影响。 该光学设备的原理在于:系统中的每个节点都使用一定波长的光,这一技术被称为波分复用。来自各个节点的光会被送入该激光器,而且激光输出会被反馈回节点,创造出一个拥有非线性特征的反馈电路。关于这种非线性能模拟神经行为的程度,研究表明其输出在数学上等效于一种被称为“连续时间递归神经网络(CTRNN)”的设备,这说明CTRNN的编程工具可以应用于更大的硅光子神经网络。 泰特团队用一个拥有49个节点的硅光子神经网络来模拟某种微分方程的数学问题,并将其与普通的中央处理单元进行比较。结果表明,在此项任务中,光子神经网络的速度提升了3个数量级。 研究人员表示,这将开启一个全新的光子计算产业。泰特说:“硅光子神经网络可能会成为更庞大的、可扩展信息处理的硅光子系统家族的‘排头兵’”。 【责任编辑: 云中子 TEL:(010)68476606】 点赞 0

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册