首页 文章 精选 留言 我的

精选列表

搜索[内核任意读写],共10000篇文章
优秀的个人博客,低调大师

PgSQL · 应用案例 · HDB for PG特性(数据排盘与任意列高效率过滤)

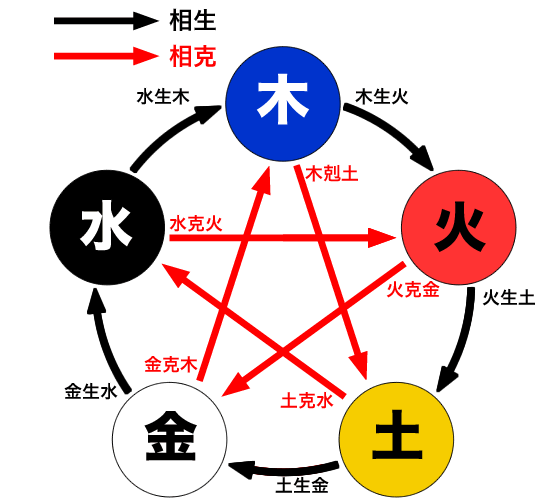
背景 数据也有生辰八字,你信吗?列与列之间,行与行之间,元素与元素之间如何相生相克?查询慢?不要信什么这都是上天注定的,如何给数据改运?看完本文,你也可以做到。 一份天赋,九份努力。缘分天注定。命由天定。又有说我命由我不由天的。看样子中国古人对先天注定的东西研究还挺透彻,看的还挺开,但是也有通过后天努力,或者后天改运等等手段来弥补先天不足的。 实际上在准备写本文时,我发现数据库的数据编排,数据存放和中国的命理相关的传统文化还很相似,也存在先天因素和后天补救的说法。 怎么回事呢?且听我细细道来。 为了加速数据的检索效率,我们通常需要对数据创建索引,提高数据定位的精准性。例如查询某人某个月的通话流水数据,没有索引的话,我们需要搜索所有的数据,逐条匹配。通过索引,可以直接定位到需要查询的记录。 特别是在存储和计算分离时,如果搜索量越大,网络中传输的

优秀的个人博客,低调大师

解密上帝之手 - 阿里云HDB for PG特性(数据改命与任意列高效过滤)

标签 PostgreSQL , metascan , 块级过滤 , 块级统计信息 , BATCH级统计信息 , brin , 区间索引 , 块级索引 , batch级索引 , 数据编排 , 存储计算分离 , 混合编排 , 分段编排 背景 数据也有生辰八字,你信吗?列与列之间,行与行之间,元素与元素之间如何相生相克?查询慢?不要信什么这都是上天注定的,如何给数据改运?看完本文,你也可以做到。 一份天赋,九份努力。缘分天注定。命由天定。又有说我命由我不由天的。看样子中国古人对先天注定的东西研究还挺透彻,看的还挺开,但是也有通过后天努力,或者后天改运等等手段来弥补先天不足的。 实际上在准备写本文时,我发现数据库的数据编排,数据存放和中国的命理相关的传统文化还很相似,也存在先天因素和后天补救的说法。 怎么回事呢?且听我细细道来。 为了加速数据的检索效率

优秀的个人博客,低调大师

MaxScale2.0.1结合Java Druid连接池实现读写分离注意事项

现象: 程序会不定时的出现连接错误,问题bug的异常信息如下: The last packet successfully received from the server was 116 milliseconds ago. The last packet sent successfully to the server was 115 milliseconds ago. java.sql.SQLException: No database selected 但通过客户端sqlyog/navicat连接均为正常。 ---------------------------------------------------------------------- 另:maxscale1.4.3有时还会出现挂起现象,4006端口直接关闭。后我们用了watch命令后台跑监控。 watch -d /bin/bash /root/sh/restart_maxsacle.sh #!/bin/bash netstat-ntlp|grepmaxscale|grep4006>/dev/null2>&1 if[$?-eq1];then /etc/init.d/maxscalestart fi 解决:5.6以下可以直接在url上配置:autoReconnect=true 对于5.6以上的只能在jdbc的链接池里设置: 第一个设置成ture,超时自动链接,对于mysql要把第二个设置成false,不启用缓存。 以上是开发需要注意的都是一些基本的配置。 其目的为:每次归还连接时执行select 'x'检测连接是否有效。

优秀的个人博客,低调大师

Apache Cloudberry 内核探究|Runtime Filter 技术深度解析

Apache Cloudberry™ (Incubating) 是 Apache 软件基金会孵化项目,由 Greenplum 和 PostgreSQL 衍生而来,作为领先的开源 MPP 数据库,可用于建设企业级数据仓库,并适用于大规模分析和 AI/ML 工作负载。 GitHub: https://github.com/apache/cloudberry 文章作者:张玥,酷克数据研发工程师;整理:酷克数据 在优化分布式数据库查询性能时,有一个长期被开发者忽视却真实存在的成本:在 Join 前没有及时过滤无效数据,导致 CPU、内存和网络被浪费在处理这些永远不可能匹配的行上。 在 Apache Cloudberry 的用户社区中,我们经常遇到这样的提问:“同样的数据量,为什么这个 Join 查询在我们的集群上跑得并不快?”当我们排查执行计划时,往往会发现问题的根源在于 Join 的 probe 端(大表侧)始终在无差别扫描所有行,即使这些行根本不可能匹配到小表上的 Join Key。 这是很多数据库系统都曾经历的“成长烦恼”,也是为什么我们在 Cloudberry 中坚定地实现并落地 Runtime Filter(动态过滤器)。 为什么传统 Hash Join 在大表上会成为性能瓶颈? 传统 Hash Join 的执行流程非常简单直接:先在小表上构建哈希表,然后扫描大表,对每一行都做一次哈希匹配。对用户来说,这种实现是“透明”的,因为它在任何场景下都能正确返回结果,但问题在于,当大表体量非常大时,这种“扫描一切再判断”的策略就成了资源黑洞。 具体来说: CPU 被无效使用。 大表扫描过程中,每一行都要经过哈希探测,即便它们不可能匹配,也在消耗 CPU。 内存负载高。 无效行被加载、缓存、参与后续算子处理,挤占了真正有效数据的内存空间。 网络带宽浪费。 在分布式执行时,大表中这些无效行可能被传输到其他节点参与分布式 Join,白白浪费带宽。 如果 Join 能在真正开始之前就知道哪些行必然不会命中,那么这些 CPU、内存和网络资源完全可以节省下来,用于处理真正有价值的数据。 这就是 Runtime Filter 存在的意义。 所谓 Runtime Filter,本质上是 在查询执行时根据小表 Join Key 动态生成的过滤器,将其“提前”下推到大表扫描节点,对大表行做快速预过滤,让那些不可能匹配的行直接在扫描时就被丢弃。 它并不复杂: 在小表构建哈希表时,同时根据 Join Key 创建 Bloom Filter(或 Range Filter)。 将这个过滤器下推到大表扫描(SeqScan)阶段。 在大表扫描时,Join Key 会先经过过滤器检查,如果不可能命中,直接丢弃。 结果是,大表参与 Join 的行数锐减,执行时间随之下降,用户感觉就是:“查询快了不少。” 值得一提的是,Runtime Filter 并不是 Cloudberry 独有的优化,Spark SQL、Trino(Presto)、Apache Doris 等主流系统都早已在生产环境使用这一技术。 在 TPC-H、TPC-DS 等标准测试中,Runtime Filter 可以帮助部分 Join-heavy 的查询实现 2-10 倍的加速,且这些加速并不依赖于复杂调优参数,而是来源于最朴素的道理:“能不处理的行就不要处理。” Cloudberry 是如何实现 Runtime Filter 的? 在实现 Runtime Filter 的过程中,我们遵循了 Cloudberry 的整体理念:简洁、高效、易扩展。 首先,我们使用 Bloom Filter 作为主要过滤器类型。原因很简单:Bloom Filter 是一种概率型过滤器,占用空间极小(通常几个 MB),通过多个哈希函数判断某个值是否可能存在,即便存在假阳性(放行无效行),也不会出现假阴性(误过滤正确行),这保证了最终结果的一致性。 其次,对于数值型 Join Key(如时间戳、整型 ID 等),我们也支持 Range Filter。它只记录 Join Key 的最小值和最大值,用于直接排除范围外的数据,更加简单高效。 我们在实现层面选择了 LOCAL 模式(进程内下推): Bloom Filter 和 Range Filter 的构建与下推都在同一进程内完成,无需跨进程或跨节点通信。 下推到大表 SeqScan 节点后,过滤器直接作用于扫描过程,几乎没有额外延迟。 这种模式实现简单,效果立竿见影,避免了引入不必要的分布式复杂性,同时带来显著的执行性能提升。 实际效果怎么样? 在 Cloudberry 的性能基准测试中,我们使用了 TPC-DS 10GB 和 100GB 数据集进行了对比: 在 10GB 测试集上,开启 Runtime Filter 后,查询总耗时从 939 秒降低到 779 秒,缩短了约 17%。 在 100GB 测试集上,从 5270 秒降低到 4365 秒,提升同样在 17% 左右。 需要注意的是,这种性能提升并非源于魔法,而是因为 Runtime Filter 在 Join 前就过滤掉了大量无用数据,使得 Join 的输入更“干净”,从而减少了计算、内存和网络负担。 在实际用户环境中,这种加速效果往往更明显,特别是在 Join Key 基数较小、过滤效果明显的场景中,Runtime Filter 能让长时间跑不完的分析报表大幅缩短执行时间。 Runtime Filter 实现 在执行 Hash Join 构建哈希表时,Cloudberry 会在内部同步生成 Bloom Filter 或 Range Filter: Bloom Filter 通过哈希函数将小表的 Join Key 值映射到位数组,实现快速的概率过滤。内存消耗极小(通常仅需几 MB),但可能存在假阳性。 Range Filter 则记录 Join Key 的最小值和最大值,对于数值范围连续的数据(如时间戳、整型 ID)过滤效果更好。 这些过滤器在小表扫描时被无感知地构建,完全不需要额外扫描,也不需要二次计算,真正做到“顺手”完成。 下推至大表扫描节点 过滤器构建完成后,最关键的步骤是将它下推到大表的 SeqScan 节点,让过滤器在扫描时生效。 在 Cloudberry 中,Join 构建和大表扫描通常位于同一执行进程内,因此过滤器可以以内存指针的方式直接传递给大表扫描节点,避免了序列化和网络通信的额外成本。 在大表执行扫描时,每当拉取下一行数据时,系统会先将该行数据的 Join Key 列送入过滤器检查: 如果不在 Range Filter 范围内,直接丢弃。 如果 Bloom Filter 判断“不存在”,直接丢弃。 只有通过过滤的行,才会继续进入 Hash Join 参与探测。 这种在扫描时“预过滤”的模式,与 Cloudberry 的执行流水线完美适配,不会破坏流水线调度,也不会引入额外锁和同步延迟。 LOCAL 模式下推 业界的一些引擎会选择在跨节点环境中通过 GLOBAL 模式下推过滤器,将过滤器同步到所有数据节点,实现更大范围的预过滤。 在 Cloudberry 的第一阶段,我们刻意选择了 LOCAL 模式(进程内下推): 因为大部分 Broadcast Join 的场景,过滤器在进程内就足够高效; 避免了跨节点网络传输和序列化带来的延迟; 让过滤器的构建和应用零延迟生效,让收益最大化且稳定。 这种实现方式使 Runtime Filter 成为了 Cloudberry 查询链路中“真正无感知但持续生效”的能力。 在执行计划中可观测,让加速“看得见” Runtime Filter 不仅仅是默默执行的幕后加速器,它在执行计划中是可被用户清晰感知的。当用户执行 EXPLAIN ANALYZE 时,可以看到类似如下输出: Rows Removed by Pushdown Runtime Filter: 4,328,191 意味着有 430 万行在扫描时就被 Runtime Filter 丢弃了,不再进入 Hash Join 的计算管道。 这种“可见可观测”的设计对 DBA、性能调优工程师非常友好: 便于判断 Runtime Filter 是否生效; 能验证过滤效果是否达到预期; 为后续优化 SQL 提供直观依据。 代码中的“真实细节” 在 Cloudberry 的执行器中,Runtime Filter 并非独立流程,而是通过核心结构 AttrFilter 与 Hash Join 和 SeqScan 深度集成。 AttrFilter 在执行时记录: Join 键范围(min/max)用于 Range Filter; Bloom Filter 实例用于概率过滤; Join 键位置映射(rattno/lattno)确保列正确匹配; 关联到目标 SeqScan 节点的 PlanState 指针,用于精确下推。 构建过程完全与 Hash Join 的 MultiExecPrivateHash 流程同步: 在小表哈希表构建时调用 AddTupleValuesIntoRF 将值写入 Bloom Filter 或更新范围; 构建完成后调用 PushdownRuntimeFilter 下推过滤器到目标扫描节点; 在查询结束时自动调用 FreeRuntimeFilter 回收内存,保证系统稳定性和内存安全。 这种嵌入式实现方式,使 Runtime Filter 成为了 Cloudberry 查询执行过程中“天然存在”的优化能力。 结语 在 Cloudberry,我们希望大部分优化能力都能做到“对用户无感,对系统有益”,Runtime Filter 正是这样一种能力。 它不需要用户额外学习参数,不需要写复杂 SQL Hint,也不需要在执行前进行特别配置,但只要你的查询包含 Join,它就会自动工作,为你节省时间与资源。 Runtime Filter 的使命非常纯粹: 在 Join 前,让不可能命中的行在最便宜的阶段被提前过滤掉,让资源只用于真正有价值的计算。 未来,我们将继续扩展 Runtime Filter: 在合适的场景中引入 GLOBAL 模式支持,跨节点做全局预过滤; 支持 IndexScan / BitmapScan 下推; 提供更加智能的过滤器精度控制; 实现与自适应并行度、管道执行更深度融合。 但无论演化到何种程度,这项能力的本质始终不变: 用最简单的方法,让 Cloudberry 更快、更稳、更省。 如果你想了解更多 Cloudberry 在执行链路中的底层优化实践,欢迎继续关注,我们会持续发布更多底层设计与优化实战分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册