首页 文章 精选 留言 我的

精选列表

搜索[融合分析],共10000篇文章
优秀的个人博客,低调大师

别再 mybatis 了,融合 JPA 和超强查询的 sqltoy-orm 5.6.16 发版

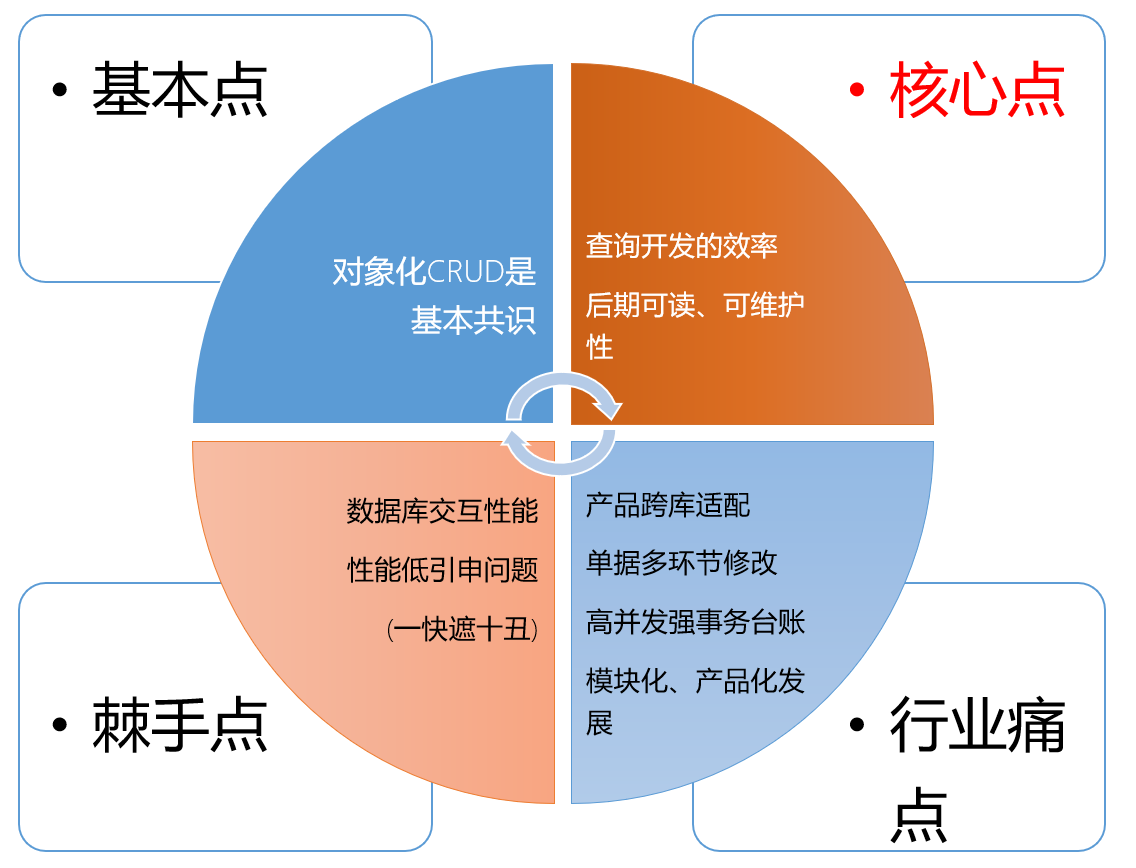
开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/imyuyu/sqltoy-idea-plugin sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、强化级联加载功能,可以通设置onlyCascade,只加载子表 /* * 演示批量级联加载,忽略主表查询,用于主表事先查询出集合的场景 */ @Test public void testLoadAllOnlyCascade() { List entites = new ArrayList(); entites.add(new ComplexpkHeadVO(LocalDateTime.parse("2020-09-08T12:11:20"), "S0001")); entites.add(new ComplexpkHeadVO(LocalDateTime.parse("2020-09-08T12:11:20"), "S0002")); List<ComplexpkHeadVO> heads = lightDao.load().onlyCascade().many(entites); // 打印级联加载的子表数据 for (ComplexpkHeadVO item : heads) { System.err.println(JSON.toJSONString(item)); } } 2、增加兼容历史主键类包路径,便于从4.x版本升级 JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 支持通过 POJO 生成 DDL 以及直接向数据库创建表 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

别再 mybatis 了,融合 JPA 和超强查询的 sqltoy-orm 5.6.14 发版

开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/imyuyu/sqltoy-idea-plugin sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、优化mogdb数据库支持(由sqltoy用户自行扩展,信创场景)2、在lightdao中增加generateBizId灵活通过redis产生业务主键 JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 支持通过 POJO 生成 DDL 以及直接向数据库创建表 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

OSSChat 上线:融合 CVP,试用通道已开放

还在纠结于反复查找开源项目的技术文档? 团队常因频繁搜索开源项目主页导致效率低下? 每天都要问一遍【开源项目中那些“小白问题”究竟有没有更快的解决方法?】 对此,只想对你说:赶紧试试 OSSChat!赶紧试试 OSSChat!赶紧试试 OSSChat! (👉链接在此:https://osschat.io/) OSSChat 究竟是谁? 介绍一下,这是我们最近做的一个很有意思的开源工具。它的主要目的是把一个开源社区所有沉淀下来的知识性内容打造成知识库,并通过 ChatGPT 的能力包装成问答机器人。后续,我们也打算为各个开源社区提供免费的 embedded chatbot 的能力,解决主页内容搜索和用户 QA 这样的关键问题。 简言之,有了 OSSChat,你就可以通过对话的方式直接与一个开源社区的所有知识直接交流,大幅提升开源社区信息流通效率。 在首发尝鲜版本中,OSSChat 提供了基于 Hugging Face、Pytorch、Milvus 等开源项目的深度问答服务,后续将陆续覆盖更多受欢迎的开源项目。如果 OSSChat 上面还没有你的项目,请直接联系我们申请入驻! 01. OSSChat:自带“精准”基因 用过 ChatGPT 的小伙伴可能都遇到过类似的问题:当你向它询问专业垂域知识或实时信息时,由于受限于模型本身的训练数据集边界,ChatGPT 会生成看似正确但与事实不符的内容,这也是 ChatGPT 被业界广为诟病的一个重要缺陷。为了解决这一问题,Zilliz 推出了崭新的 CVP 技术栈——即 ChatGPT + 向量数据库(vector database)+ prompt-as-code。 毋庸置疑,ChatGPT 在自然语言问答方面的能力十分出色,如果通过向量数据库为 ChatGPT 提供一个大规模可靠的知识库,并使用 prompt 将用户问题与相应的知识库文本对应起来,ChatGPT 便可以扬长避短,很大程度上避免 ChatGPT “捏造答案”。 可以说,OSSChat 完美展现了 CVP 技术栈的工作模式。具体来看,OSSChat 将各个开源项目的 GitHub 仓库(repo)及相关文档页面作为数据源(source of truth),这些数据被转换为 embedding 并存储在 Zilliz 向量数据库中,其他相关内容则存储在单独的数据存储器中。用户与 OSSChat 提问交互时,会在 Zilliz 向量数据库中触发相似性检索,随后检索结果会被发送给 ChatGPT 作为输入问题,最终生成精准答案。 02. 关于避免 ChatGPT 捏造事实这件事 接下来可以通过几组典型的例子,展示 CVP Stack 帮助 ChatGPT 给出精准答案的能力。我们对比了相同问题下 ChatGPT 与 OSSChat 的答案(*注:以下问答均翻译自英文,英文原文请移步 Zilliz Blog 查看): Q1:Hugging Face 是否支持 OpenAI Whisper? ChatGPT 回答:据我所知,截至 2021 年 9 月,Hugging Face 尚未宣布支持 OpenAI Whisper。但是,他们将来可能会添加支持。OpenAI Whisper 是 OpenAI 的新语言模型,其他公司和开发人员将其整合到其平台和产品中可能需要一些时间。 OSSChat 回答:是的,Hugging Face 支持 OpenAI Whisper。 FlaxWhisperModel 类在 transformers 库中可用,这是 OpenAI Whisper 模型的包装器。您可以使用此类加载预训练的 OpenAI Whisper 模型,并将其用于各种自然语言处理任务,例如文本分类、问题回答和文本生成。 【对于这个问题,ChatGPT 受到知识库限制,它的回答帮助并不大。但是 OSSChat 的回答却十分准确,因为这个答案直接来自 Hugging Face 文档网站。】 Q2:torch.compile 这个 API 可以用来做什么? ChatGPT 回答:截至 2021 年 9 月我的知识截止日期,PyTorch 中没有torch.compile API,这是由 Facebook AI Research 开发的流行的开源机器学习库。但是,PyTorch 提供了与编译和优化神经网络模型相关的各种 API,例如 torch.nn.Module,它是 PyTorch 中所有神经网络模块的基类。torch.nn.Module 提供各种用于定义和优化神经网络模型的方法和钩子。 此外,PyTorch 提供了与 Just-In-Time (JIT)编译器(例如 TorchScript JIT 编译器)集成的接口,可以用于在各种硬件平台上优化和编译 PyTorch 模型。JIT 编译器可以将 PyTorch 模型转换为独立的、序列化的表示形式,可以在其他环境或语言中加载和执行。总之,虽然 PyTorch 没有 torch.compile API,但它提供了各种用于优化和编译神经网络模型的 API 和工具。 OSSChat 回答:torch.compile API 的目的是通过预先编译来加速 PyTorch 代码。它可以处理任意 Python 代码,对现有代码的更改最小,并可以处理数据相关的控制流。它还可以处理非 PyTorch 函数调用,TorchScript 追踪将其视为常量并可能导致不正确的结果。 【ChatGPT 长篇大论解释了 PyTorch API 是什么,并宣称 PyTorch API 中没有torch.compile。但实际上,我们并没有提问 PyTorch API 是什么,且 PyTorch 中存在 torch.compile 这个 API。】 Q3:Milvus 中的 TTL 是什么,如何设置? ChatGPT 回答:在 Milvus 中,TTL(Time To Live)是一项功能,允许您为数据设置到期时间。当您为 Milvus 中的集合或分区设置 TTL 时,Milvus 将自动删除任何已超过指定 TTL 的数据。要在 Milvus 中为集合或分区设置 TTL,您可以分别使用 set_collection_ttl 或 set\_partition\_ttl API。 以下是示例: 在此示例中,我们在 Milvus 中创建了一个集合和一个分区。然后,我们使用 set\_collection\_ttl 和 set\_partition\_ttl API 分别为集合和分区设置了 7 天的 TTL。TTL 指定为 Unix 时间戳,它是自 1970 年 1 月 1 日以来的秒数。我们使用 datetime 模块将 TTL 添加到当前时间以计算到期时间。 请注意,您需要在启动 Milvus 时启用 TTL 功能。这可以通过在 Milvus 配置文件中设置 TTL\_CHECK\_INTERVAL 参数来完成。默认值为 60 秒。 OSSChat 回答:TTL 在 Milvus 中代表“Time to Live”,它是一项功能,可以为集合中的数据设置到期时间。当集合中的数据过期时,它将被自动清理,并且不会参与搜索或查询。 要在 Milvus 中为集合设置 TTL 值,您可以使用 Python 中的 collection.set_properties() 方法。例如,要将 TTL 值设置为 1800 秒(30 分钟),您可以使用以下代码: collection.set_properties(properties={"collection.ttl.seconds": 1800}) 您还可以在创建集合时通过在集合的属性中指定 collection.ttl.seconds 属性来设置 TTL 值。该值应以秒为单位指定,应为 0 或更大。值为 0 表示 TTL 已禁用。 【对于这个问题,ChatGPT 给我们提供了一个看似合理的答案,甚至还包含了代码片段。但实际上,这并不是正确答案,而是 ChatGPT 捏造出来的答案。相较之下,OSSChat 则给出了正确回答—— Milvus 中的 TTL 是在集合设置中的一种属性,它的值以秒为单位。】 03. OSSChat 试用通道已开放 目前,我们已经开放了 OSSChat 试用通道,所有用户均可免费使用。未来我们在不断完善其功能的同时,也将公布更多关于 OSSChat 搭建过程的细节。如果希望 OSSChat 聊天机器人能够出现你所开发的开源项目,也欢迎复制链接填写申请:https://docs.google.com/forms/d/e/1FAIpQLSdXHXCyzs11u7lh2hWkAtWusHtn8fVEZjfrFXTvR7yHhXZDgQ/viewform 当然,如果你对 OSSChat 的功能或者开源项目方面有更多的建议,也欢迎告诉我们!话不多说,OSSChat 等你!

优秀的个人博客,低调大师

开发者解读:为什么蚂蚁要用融合计算这种新计算模式?

导读:如今大部分人工智能应用是基于监督学习范式开发的,即模型在线下进行训练,然后部署到服务器上进行线上预测,这样的开发方式在实时响应上存在较大的局限。随着计算和 AI 体系逐步成熟,我们希望机器学习应用能更多地在动态环境下运行、实时响应环境中的变化,这推动了机器学习从传统离线学习逐渐向在线学习演进。相比于传统的离线机器学习,在线学习可以带来更快的模型迭代速度,让模型预测效果更贴真实情况,对于线上的波动更加敏锐。 最近两年,国内各一线互联网厂商分别推出自己的在线学习技术体系及相关架构。蚂蚁金服从 2018 年 7 月开始,基于最新的 Ray 分布式引擎自研了金融级的在线学习系统,与传统在线学习框架相比,在端到端延迟、稳定性、研发效率等方面都有不同程度的提高。 Ray 是伯克利大学 AMPLab 在 2017 年 12 月开源的高性能分布

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册