首页 文章 精选 留言 我的

精选列表

搜索[本地大模型],共10000篇文章
优秀的个人博客,低调大师

gout v0.2.1版本更新,go http RESTful 客户端和 benchmark lib

项目地址 https://gitee.com/guonaihong/gout https://github.com/guonaihong/gout 本次更新 在gout.NewWithOpt接口里面新增WithTimeout接口 修改value为空为, 不忽略key 完整文档 gout gout 是go写的http 客户端,为提高工作效率而开发 构架 feature 支持设置 GET/PUT/DELETE/PATH/HEAD/OPTIONS 支持设置请求 http header(可传 struct,map,array,slice 等类型) 支持设置 URL query(可传 struct,map,array,slice,string 等类型) 支持设置 json 编码到请求 body 里面(可传struct, map, string, []byte 等类型) 支持设置 xml 编码到请求 body 里面(可传struct, string, []byte 等类型) 支持设置 yaml 编码到请求 body 里面(可传struct, map, string, []byte 等类型) 支持设置 protobuf 编码到请求 body里面(可传struct) 支持设置 form-data(可传 struct, map, array, slice 等类型) 支持设置 x-www-form-urlencoded(可传 struct,map,array,slice 等类型) 支持设置 io.Reader,uint/uint8/uint16...int/int8...string...[]byte...float32,float64 至请求 body 里面 支持解析响应body里面的json,xml,yaml至结构体里(BindJSON/BindXML/BindYAML) 支持解析响应body的内容至io.Writer, uint/uint8...int/int8...string...[]byte...float32,float64 支持解析响应header至结构体里 支持接口性能benchmark,可控制压测一定次数还是时间,可控制压测频率 支持retry-backoff,可以指定重试条件 支持发送裸http数据包 支持导出curl命令 传入自定义*http.Client 支持请求中间件(https://github.com/antlabs/gout-middleware) 支持设置chunked数据格式发送 等等更多 演示 内容 Installation example quick start API Examples GET POST PUT DELETE PATH HEAD OPTIONS Query Parameters http header Set request header Parsing the response header http body body Set the data to the http request body Parse the response body into a variable json Serialize json to request body Parsed http response body in json format yaml xml form-data x-www-form-urlencoded protobuf callback Set request timeout proxy socks5 cookie basic auth context Cancel a sending request unix socket http2 doc debug mode Turn on debug mode Turn off color highlighting in debug mode Custom debug mode trace info benchmark benchmarking a certain number of times benchmarking for a certain time benchmarking at a fixed frequency Custom benchmark functions retry backoff Specify the retry conditions, when equal to a certain http code Specify retry conditions. The default URL cannot be accessed. Use the backup URL import send raw http request export generate curl command Incoming custom * http.Client Using chunked data format NewWithOpt Insecure skip verify Turn off 3xx status code automatic jump NewWithOpt set timeout Global configuration set timeout Unique features forward gin data FAQ Installation go get github.com/guonaihong/gout example examples目录下面的例子,都是可以直接跑的。如果觉得运行例子还是不明白用法,可以把你迷惑的地方写出来,然后提issue 运行命令如下 cd _example # GOPROXY 是打开go module代理,可以更快下载模块 # 第一次运行需要加GOPROXY下载模块,模块已安装的直接 go run 01-color-json.go 即可 env GOPROXY=https://goproxy.cn go run 01-color-json.go quick start package main import ( "fmt" "github.com/guonaihong/gout" "time" ) // 用于解析 服务端 返回的http body type RspBody struct { ErrMsg string `json:"errmsg"` ErrCode int `json:"errcode"` Data string `json:"data"` } // 用于解析 服务端 返回的http header type RspHeader struct { Sid string `header:"sid"` Time int `header:"time"` } func main() { rsp := RspBody{} header := RspHeader{} //code := 0 err := gout. // POST请求 POST("127.0.0.1:8080"). // 打开debug模式 Debug(true). // 设置查询字符串 SetQuery(gout.H{"page": 10, "size": 10}). // 设置http header SetHeader(gout.H{"X-IP": "127.0.0.1", "sid": fmt.Sprintf("%x", time.Now().UnixNano())}). // SetJSON设置http body为json // 同类函数有SetBody, SetYAML, SetXML, SetForm, SetWWWForm SetJSON(gout.H{"text": "gout"}). // BindJSON解析返回的body内容 // 同类函数有BindBody, BindYAML, BindXML BindJSON(&rsp). // 解析返回的http header BindHeader(&header). // http code // Code(&code). // 结束函数 Do() // 判断错误 if err != nil { fmt.Printf("send fail:%s\n", err) } } /* > POST /?page=10&size=10 HTTP/1.1 > Sid: 15d9b742ef32c130 > X-Ip: 127.0.0.1 > Content-Type: application/json > { "text": "gout" } */ API examples GET POST PUT DELETE PATH HEAD OPTIONS package main import ( "github.com/guonaihong/gout" ) func main() { url := "https://github.com" // 发送GET方法 gout.GET(url).Do() // 发送POST方法 gout.POST(url).Do() // 发送PUT方法 gout.PUT(url).Do() // 发送DELETE方法 gout.DELETE(url).Do() // 发送PATH方法 gout.PATCH(url).Do() // 发送HEAD方法 gout.HEAD(url).Do() // 发送OPTIONS gout.OPTIONS(url).Do() } Query Parameters SetQuery package main import ( "fmt" "github.com/guonaihong/gout" "time" ) func main() { err := gout. //设置GET请求和url,:8080/test.query是127.0.0.1:8080/test.query的简写 GET(":8080/test.query"). //打开debug模式 Debug(true). //设置查询字符串 SetQuery(gout.H{ "q1": "v1", "q2": 2, "q3": float32(3.14), "q4": 4.56, "q5": time.Now().Unix(), "q6": time.Now().UnixNano(), "q7": time.Now().Format("2006-01-02")}). //结束函数 Do() if err != nil { fmt.Printf("%s\n", err) return } } /* > GET /test.query?q1=v1&q2=2&q3=3.14&q4=4.56&q5=1574081600&q6=1574081600258009213&q7=2019-11-18 HTTP/1.1 > < HTTP/1.1 200 OK < Content-Length: 0 */ SetQuery支持的更多数据类型 http header Set request header package main import ( "fmt" "github.com/guonaihong/gout" "time" ) func main() { err := gout. //设置GET请求和url,:8080/test.header是127.0.0.1:8080/test.header的简写 GET(":8080/test.header"). //设置debug模式 Debug(true). //设置请求http header SetHeader(gout.H{ "h1": "v1", "h2": 2, "h3": float32(3.14), "h4": 4.56, "h5": time.Now().Unix(), "h6": time.Now().UnixNano(), "h7": time.Now().Format("2006-01-02")}). Do() if err != nil { fmt.Printf("%s\n", err) return } } /* > GET /test.header HTTP/1.1 > H2: 2 > H3: 3.14 > H4: 4.56 > H5: 1574081686 > H6: 1574081686471347098 > H7: 2019-11-18 > H1: v1 > < HTTP/1.1 200 OK < Content-Length: 0 */ Parsing the response header package main import ( "fmt" "github.com/guonaihong/gout" "time" ) // 和解析json类似,如要解析http header需设置header tag type rspHeader struct { Total int `header:"total"` Sid string `header:"sid"` Time time.Time `header:"time" time_format:"2006-01-02"` } func main() { rsp := rspHeader{} err := gout. // :8080/test.header是 http://127.0.0.1:8080/test.header的简写 GET(":8080/test.header"). //打开debug模式 Debug(true). //解析请求header至结构体中 BindHeader(&rsp). //结束函数 Do() if err != nil { fmt.Printf("%s\n", err) return } fmt.Printf("rsp header:\n%#v \nTime:%s\n", rsp, rsp.Time) } /* > GET /test.header HTTP/1.1 > < HTTP/1.1 200 OK < Content-Length: 0 < Sid: 1234 < Time: 2019-11-18 < Total: 2048 */ SetHeader和BindHeader支持的更多类型 http body body Set the data to the http request body // SetBody 设置string, []byte等类型数据到http body里面 // SetBody支持的更多数据类型可看下面 package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { err := gout. // 设置POST方法和url POST(":8080/req/body"). //打开debug模式 Debug(true). // 设置非结构化数据到http body里面 // 设置json需使用SetJSON SetBody("send string"). //结束函数 Do() if err != nil { fmt.Printf("%s\n", err) return } } /* > POST /req/body HTTP/1.1 > send string < HTTP/1.1 200 OK < Content-Type: text/plain; charset=utf-8 < Content-Length: 2 */ Parse the response body into a variable // BindBody bind body到string, []byte等类型变量里面 package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { s := "" err := gout. // 设置GET 方法及url GET("www.baidu.com"). // 绑定返回值 BindBody(&s). // 结束函数 Do() if err != nil { fmt.Printf("%s\n", err) return } fmt.Printf("html size = %d\n", len(s)) } 支持的类型有 io.Reader(SetBody 支持) io.Writer(BindBody 支持) int, int8, int16, int32, int64 uint, uint8, uint16, uint32, uint64 string []byte float32, float64 明确不支持的类型有 struct array, slice json Serialize json to request body 更多支持数据类型及用法 package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { err := gout.POST(":8080/colorjson"). //打开debug模式 Debug(true). //设置json到请求body SetJSON( gout.H{ "str": "foo", "num": 100, "bool": false, "null": nil, "array": gout.A{"foo", "bar", "baz"}, "obj": gout.H{"a": 1, "b": 2}, }, ). Do() if err != nil { fmt.Printf("err = %v\n", err) } } /* > POST /colorjson HTTP/1.1 > Content-Type: application/json > { "array": [ "foo", "bar", "baz" ], "bool": false, "null": null, "num": 100, "obj": { "a": 1, "b": 2 }, "str": "foo" } */ Parsed http response body in json format package main import ( "fmt" "github.com/guonaihong/gout" ) type rsp struct { ErrMsg string `json:"errmsg"` ErrCode int `json:"errcode"` } func main() { rsp := rsp{} err := gout. GET(":8080/colorjson"). //打开debug模式 Debug(true). //绑定响应json数据到结构体 BindJSON(&rsp). //结束函数 Do() if err != nil { fmt.Printf("err = %v\n", err) } } yaml SetYAML() 设置请求http body为yaml BindYAML() 解析响应http body里面的yaml到结构体里面 发送yaml到服务端,然后把服务端返回的yaml结果解析到结构体里面 type data struct { Id int `yaml:"id"` Data string `yaml:"data"` } var d1, d2 data var httpCode int err := gout.POST(":8080/test.yaml").SetYAML(&d1).BindYAML(&d2).Code(&httpCode).Do() if err != nil || httpCode != 200{ fmt.Printf("send fail:%s\n", err) } xml SetXML() 设置请求http body为xml BindXML() 解析响应http body里面的xml到结构体里面 发送xml到服务端,然后把服务端返回的xml结果解析到结构体里面 type data struct { Id int `xml:"id"` Data string `xml:"data"` } var d1, d2 data var httpCode int err := gout.POST(":8080/test.xml").SetXML(&d1).BindXML(&d2).Code(&httpCode).Do() if err != nil || httpCode != 200{ fmt.Printf("send fail:%s\n", err) } form-data SetForm() 设置http body 为multipart/form-data格式数据 客户端发送multipart/form-data到服务端,curl用法等同go代码 curl -F mode=A -F text="good" -F voice=@./test.pcm -f voice2=@./test2.pcm url 使用gout.H package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { code := 0 err := gout. POST(":8080/test"). // 打开debug模式 Debug(true). SetForm( gout.H{ "mode": "A", "text": "good", // 从文件里面打开 "voice": gout.FormFile("test.pcm"), "voice2": gout.FormMem("pcm"), }, ). //解析http code,如不关心可以不设置 Code(&code). Do() if err != nil { fmt.Printf("%s\n", err) } if code != 200 { } } /* > POST /test HTTP/1.1 > Content-Type: multipart/form-data; boundary=2b0685e5b98e540f80b247d5e7c1283807aa07e62b827543859a6db765a8 > --2b0685e5b98e540f80b247d5e7c1283807aa07e62b827543859a6db765a8 Content-Disposition: form-data; name="mode" A --2b0685e5b98e540f80b247d5e7c1283807aa07e62b827543859a6db765a8 Content-Disposition: form-data; name="text" good --2b0685e5b98e540f80b247d5e7c1283807aa07e62b827543859a6db765a8 Content-Disposition: form-data; name="voice"; filename="voice" Content-Type: application/octet-stream pcm pcm pcm --2b0685e5b98e540f80b247d5e7c1283807aa07e62b827543859a6db765a8 Content-Disposition: form-data; name="voice2"; filename="voice2" Content-Type: application/octet-stream pcm --2b0685e5b98e540f80b247d5e7c1283807aa07e62b827543859a6db765a8-- < HTTP/1.1 200 OK < Server: gurl-server < Content-Length: 0 */ 使用结构体 type testForm struct { Mode string `form:"mode"` Text string `form:"text"` Voice string `form:"voice" form-file:"true"` //从文件中读取 Voice2 []byte `form:"voice2" form-file:"mem"` //从内存中构造 } type rsp struct{ ErrMsg string `json:"errmsg"` ErrCode int `json:"errcode"` } t := testForm{} r := rsp{} code := 0 err := gout.POST(url).SetForm(&t).ShoudBindJSON(&r).Code(&code).Do() if err != nil { } x-www-form-urlencoded 使用SetWWWForm函数实现发送x-www-form-urlencoded类型数据 package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { code := 0 err := gout. POST(":8080/post"). // 打开debug模式 Debug(true). // 设置x-www-form-urlencoded数据 SetWWWForm( gout.H{ "int": 3, "float64": 3.14, "string": "test-www-Form", }, ). // 关心http code 返回值设置 Code(&code). Do() if err != nil { fmt.Printf("%s\n", err) return } if code != 200 { } } /* > POST /post HTTP/1.1 > Content-Type: application/x-www-form-urlencoded > float64=3.14&int=3&string=test-www-Form < HTTP/1.1 200 OK < Content-Length: 0 < Server: gurl-server */ protobuf SetProtoBuf支持,protobuf序列化后的[]byte,或者生成的protobuf结构体指针 package main import ( "github.com/guonaihong/gout" ) func main() { httpCode := 0 err := GET(":8080/echo"). SetProtoBuf( /* protobuf 生成的结构体,必须传指针类型*/ ). Code(&httpCode). Do() } callback callback主要用在,服务端会返回多种格式body的场景, 比如404返回的是html, 200返回json。 这时候要用Callback挂载多种处理函数,处理不同的数据结构 func main() { r, str404 := Result{}, "" code := 0 err := gout.GET(":8080").Callback(func(c *gout.Context) (err error) { switch c.Code { case 200: //http code为200时,服务端返回的是json 结构 c.BindJSON(&r) case 404: //http code为404时,服务端返回是html 字符串 c.BindBody(&str404) } code = c.Code return nil }).Do() if err != nil { fmt.Printf("err = %s\n", err) return } fmt.Printf("http code = %d, str404(%s) or json result(%v)\n", code, str404, r) } Set request timeout setimeout是request级别的超时方案。相比http.Client级别,更灵活。 package main import ( "fmt" "github.com/guonaihong/gout" "time" ) func main() { err := gout.GET(":8080"). SetTimeout(2 * time.Second). Do() if err != nil { fmt.Printf("err = %v\n", err) } } proxy SetProxy 设置代理服务地址 package main import ( "fmt" "github.com/guonaihong/gout" "log" ) func main() { c := &http.Client{} s := "" err := gout. New(c). GET("www.qq.com"). // 设置proxy服务地址 SetProxy("http://127.0.0.1:7000"). // 绑定返回数据到s里面 BindBody(&s). Do() if err != nil { log.Println(err) return } fmt.Println(s) } socks5 SetSOCKS5 设置socks5地址 package main import ( "fmt" "github.com/guonaihong/gout" "log" "net/http" ) func main() { c := &http.Client{} s := "" err := gout. New(c). GET("www.qq.com"). // 设置proxy服务地址 SetSOCKS5("127.0.0.1:7000"). // 绑定返回数据到s里面 BindBody(&s). Do() if err != nil { log.Println(err) return } fmt.Println(s) } cookie SetCookies设置cookie, 可以设置一个或者多个cookie package main import ( "fmt" "github.com/guonaihong/gout" "net/http" ) func main() { // === 发送多个cookie ==== err := gout. // :8080/cookie是http://127.0.0.1:8080/cookie的简写 GET(":8080/cookie"). //设置debug模式 Debug(true). SetCookies( //设置cookie1 &http.Cookie{ Name: "test1", Value: "test1", }, //设置cookie2 &http.Cookie{ Name: "test2", Value: "test2", }, ). Do() if err != nil { fmt.Println(err) return } // === 发送一个cookie === err = gout. // :8080/cookie/one是http://127.0.0.1:8080/cookie/one的简写 GET(":8080/cookie/one"). //设置debug模式 Debug(true). SetCookies( //设置cookie1 &http.Cookie{ Name: "test3", Value: "test3", }, ). Do() fmt.Println(err) } basic auth 使用SetBasicAuth接口 func main() { err := gout.POST(":8080/colorjson"). SetBasicAuth("userName", "password"). SetJSON(gout.H{"str": "foo", "num": 100, "bool": false, "null": nil, "array": gout.A{"foo", "bar", "baz"}, "obj": gout.H{"a": 1, "b": 2}, }).Do() if err != nil { fmt.Printf("err = %v\n", err) } } context WithContext设置context,可以取消http请求 Cancel a sending request package main import ( "context" "github.com/guonaihong/gout" "time" ) func main() { // 声明一个context ctx, cancel := context.WithCancel(context.Background()) //调用cancel可取消http请求 go func() { time.Sleep(time.Second) cancel() }() err := gout. GET("127.0.0.1:8080/cancel"). //设置GET请求以及需要访问的url WithContext(ctx). //设置context, 外层调用cancel函数就可取消这个http请求 Do() if err != nil { } } unix socket UnixSocket可以把http底层通信链路由tcp修改为unix domain socket 下面的例子,会通过domain socket发送http GET请求,http body的内容是hello world package main import ( "fmt" "github.com/guonaihong/gout" "net/http" ) func main() { c := http.Client{} g := gout. New(&c). UnixSocket("/tmp/test.socket") //设置unixsocket文件位置 err := g. GET("http://a/test"). //设置GET请求 SetBody("hello world"). //设置body内容 Do() fmt.Println(err) } http2 doc go 使用https访问http2的服务会自动启用http2协议,这里不需要任何特殊处理 https://http2.golang.org/(bradfitz建的http2测试网址,里面大约有十来个测试地址,下面的例子选了一个) package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { s := "" err := gout. GET("https://http2.golang.org/reqinfo"). //设置GET请求和请求url Debug(true). //打开debug模式,可以看到请求数据和响应数据 SetBody("hello, ###########"). //设置请求body的内容,如果你的请求内容是json格式,需要使用SetJSON函数 BindBody(&s). //解析响应body内容 Do() //结束函数 if err != nil { fmt.Printf("send fail:%s\n", err) } _ = s } debug mode Turn on debug mode 该模式主要方便调试用的,默认开启颜色高亮(如果要关闭颜色高亮,请往下看) func main() { err := gout.POST(":8080/colorjson"). Debug(true). //打开debug模式 SetJSON(gout.H{"str": "foo", "num": 100, "bool": false, "null": nil, "array": gout.A{"foo", "bar", "baz"}, "obj": gout.H{"a": 1, "b": 2}, }).Do() if err != nil { fmt.Printf("err = %v\n", err) } } Turn off color highlighting in debug mode 使用gout.NoColor()传入Debug函数关闭颜色高亮 func main() { err := gout.POST(":8080/colorjson"). Debug(gout.NoColor()). SetJSON(gout.H{"str": "foo", "num": 100, "bool": false, "null": nil, "array": gout.A{"foo", "bar", "baz"}, "obj": gout.H{"a": 1, "b": 2}, }).Do() if err != nil { fmt.Printf("err = %v\n", err) } } Custom debug mode debug 自定义模式,可传递函数。下面演示用环境变量开启debug模式(只有传递IOS_DEBUG环境变量才输出日志) package main import ( "fmt" "github.com/guonaihong/gout" "os" ) func IOSDebug() gout.DebugOpt { return gout.DebugFunc(func(o *gout.DebugOption) { if len(os.Getenv("IOS_DEBUG")) > 0 { o.Debug = true } }) } func main() { s := "" err := gout. GET("127.0.0.1:8080"). // Debug可以支持自定义方法 // 可以实现设置某个环境变量才输出debug信息 // 或者debug信息保存到文件里面,可以看下_example/15-debug-save-file.go Debug(IOSDebug()). SetBody("test hello"). BindBody(&s). Do() fmt.Printf("err = %v\n", err) } // env IOS_DEBUG=true go run customize.go trace info gout.Trace()可输出http各个阶段的耗时,比如dns lookup时间,tcp连接时间等等。可以很方便的做些性能调优。 package main import ( "fmt" "github.com/guonaihong/gout" ) func openDebugTrace() { err := gout.POST(":8080/colorjson"). Debug(gout.Trace()). SetJSON(gout.H{"str": "foo", "num": 100, "bool": false, "null": nil, "array": gout.A{"foo", "bar", "baz"}, "obj": gout.H{"a": 1, "b": 2}, }).Do() if err != nil { fmt.Printf("err = %v\n", err) } } output =================== Trace Info(S): =================== DnsDuration : 0s ConnDuration : 868.623µs TLSDuration : 0s RequestDuration : 376.712µs WaitResponeDuration : 717.008µs ResponseDuration : 76.158µs TotalDuration : 2.13921ms =================== Trace Info(E): =================== benchmark benchmarking a certain number of times 下面的例子,起了20并发。对:8080端口的服务,发送3000次请求进行压测,内容为json结构 package main import ( "fmt" "github.com/guonaihong/gout" ) const ( benchNumber = 30000 benchConcurrent = 20 ) func main() { err := gout. POST(":8080"). //压测本地8080端口 SetJSON(gout.H{"hello": "world"}). //设置请求body内容 Filter(). //打开过滤器 Bench(). //选择bench功能 Concurrent(benchConcurrent). //并发数 Number(benchNumber). //压测次数 Do() if err != nil { fmt.Printf("%v\n", err) } } benchmark-duration 下面的例子,起了20并发。对:8080端口的服务,压测持续时间为10s,内容为json结构 package main import ( "fmt" "github.com/guonaihong/gout" "time" ) const ( benchTime = 10 * time.Second benchConcurrent = 30 ) func main() { err := gout. POST(":8080"). //压测本机8080端口 SetJSON(gout.H{"hello": "world"}). //设置请求body内容 Filter(). //打开过滤器 Bench(). //选择bench功能 Concurrent(benchConcurrent). //并发数 Durations(benchTime). //压测时间 Do() if err != nil { fmt.Printf("%v\n", err) } } benchmark-rate 下面的例子,起了20并发。对:8080端口的服务,压测总次数为3000次,其中每秒发送1000次。内容为json结构 package main import ( "fmt" "github.com/guonaihong/gout" ) const ( benchNumber = 3000 benchConcurrent = 20 ) func main() { err := gout. POST(":8080"). //压测本机8080端口 SetJSON(gout.H{"hello": "world"}). //设置请求body内容 Filter(). //打开过滤器 Bench(). //选择bench功能 Rate(1000). //每秒发1000请求 Concurrent(benchConcurrent). //并发数 Number(benchNumber). //压测次数 Do() if err != nil { fmt.Printf("%v\n", err) } } Custom benchmark functions 自定义压测函数,构造每次不一样的http request数据 package main import ( "fmt" "github.com/google/uuid" "github.com/guonaihong/gout" "github.com/guonaihong/gout/filter" "sync/atomic" ) func main() { i := int32(0) err := filter.NewBench(). Concurrent(30). //开30个go程 Number(30000). //压测30000次 Loop(func(c *gout.Context) error { // 下面的代码,每次生成不一样的http body 用于压测 uid := uuid.New() //生成uuid id := atomic.AddInt32(&i, 1) //生成id, 可以理解为++i,线程安全版本 c.POST(":1234").SetJSON(gout.H{"sid": uid.String(), "appkey": fmt.Sprintf("ak:%d", id), "text": fmt.Sprintf("test text :%d", id)}) return nil }).Do() if err != nil { fmt.Printf("err = %v\n", err) } } retry-backoff retry 功能使用带抖动功能和指数回退的算法实现backoff package main import ( "fmt" "github.com/guonaihong/gout" "time" ) func main() { err := gout.HEAD("127.0.0.1:8080"). Debug(true). //打开debug模式 Filter(). //打开过滤器 Retry(). //打开重试模式 Attempt(5). //最多重试5次 WaitTime(500 * time.Millisecond). //基本等待时间 MaxWaitTime(3 * time.Second). //最长等待时间 Do() if err != nil { fmt.Printf("err = %v\n", err) } } retry conditions httpcode 指定重试条件,这里面的例子是服务端返回的状态码是209进行重试完整代码 package main import ( "fmt" "github.com/guonaihong/gout" "github.com/guonaihong/gout/filter" "time" ) func useRetryFuncCode() { s := "" err := gout.GET(":8080/code").Debug(true).BindBody(&s).F(). Retry().Attempt(3).WaitTime(time.Millisecond * 10).MaxWaitTime(time.Millisecond * 50). Func(func(c *gout.Context) error { if c.Error != nil || c.Code == 209 { return filter.ErrRetry } return nil }).Do() fmt.Printf("err = %v\n", err) } retry conditions backupurl 指定条件进行重试,这里的例子是默认url不能访问,使用backup url进行访问完整代码 package main import ( "fmt" "github.com/guonaihong/gout" "github.com/guonaihong/gout/core" "github.com/guonaihong/gout/filter" "time" ) func useRetryFunc() { // 获取一个没有服务绑定的端口 port := core.GetNoPortExists() s := "" err := gout.GET(":" + port).Debug(true).BindBody(&s).F(). Retry().Attempt(3).WaitTime(time.Millisecond * 10).MaxWaitTime(time.Millisecond * 50). Func(func(c *gout.Context) error { if c.Error != nil { c.SetHost(":1234") //必须是存在的端口 return filter.ErrRetry } return nil }).Do() fmt.Printf("err = %v\n", err) } import send raw http request package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { s := `POST /colorjson HTTP/1.1 Host: 127.0.0.1:8080 User-Agent: Go-http-client/1.1 Content-Length: 97 Content-Type: application/json Accept-Encoding: gzip {"array":["foo","bar","baz"],"bool":false,"null":null,"num":100,"obj":{"a":1,"b":2},"str":"foo"} ` err := gout.NewImport().RawText(s).Debug(true).SetHost(":1234").Do() if err != nil { fmt.Printf("err = %s\n", err) return } } export generate curl command package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { // 1.formdata err := gout.GET(":1234"). SetForm(gout.A{"text", "good", "mode", "A", "voice", gout.FormFile("./t8.go")}). Export().Curl().Do() // output: // curl -X GET -F "text=good" -F "mode=A" -F "voice=@./voice" "http://127.0.0.1:1234" // 2.json body err = gout.GET(":1234"). SetJSON(gout.H{"key1": "val1", "key2": "val2"}). Export().Curl().Do() // output: // curl -X GET -H "Content-Type:application/json" -d "{\"key1\":\"val1\",\"key2\":\"val2\"}" "http://127.0.0.1:1234" fmt.Printf("%v\n", err) } Incoming custom *http.Client 使用New接口即可使用自己的http.Client对象 package main import ( "fmt" "net/http" "github.com/guonaihong/gout" ) func main() { c := &http.Client{} //http.Client里面有fd连接池,如果对这块优化不是太了解,只使用一个实例就行 err := gout.New(c). // New接口可传入http.Client对象 GET("www.qq.com"). Debug(true). Do() if err != nil { fmt.Printf("err = %s\n", err) return } } Using chunked data format 使用Chunked接口, 设置为"Transfer-Encoding: chunked"的数据编码方式 package main import ( "fmt" "github.com/guonaihong/gout" ) func main() { err := gout.POST(":8080"). Chunked(). SetBody("11111111111"). Do() if err != nil { fmt.Printf("err :%v\n", err) } } // 使用nc 起一个tcp服务, 使用上面的代码发起数据观察下结果 // nc -l 8080 NewWithOpt 这里记录全局配置的方法, 后面所有的全局配置都推荐使用gout.NewWithOpt接口的实现 insecure skip verify 忽略ssl验证, 使用gout.WithInsecureSkipVerify()接口配置该功能, 传入gout.NewWithOpt接口即可生效. import ( "github.com/guonaihong/gout" ) func main() { // globalWithOpt里面包含连接池, 这是一个全局可复用的对象 globalWithOpt := gout.NewWithOpt(gout.WithInsecureSkipVerify()) err := globalWithOpt.GET("url").Do() if err != nil { fmt.Printf("err = %v\n" ,err) return } } Turn off 3xx status code automatic jump golang client库默认遇到301的状态码会自动跳转重新发起新请求, 你希望关闭这种默认形为, 那就使用下面的功能 import ( "github.com/guonaihong/gout" ) func main() { // globalWithOpt里面包含连接池, 这是一个全局可复用的对象, 一个进程里面可能只需创建1个 globalWithOpt := gout.NewWithOpt(gout.WithClose3xxJump()) err := globalWithOpt.GET("url").Do() if err != nil { fmt.Printf("err = %v\n" ,err) return } } NewWithOpt set timeout gout.WithTimeout为了让大家少用gout.SetTimeout而设计 import ( "github.com/guonaihong/gout" ) func main() { // globalWithOpt里面包含连接池, 这是一个全局可复用的对象, 一个进程里面可能只需创建1个 globalWithOpt := gout.NewWithOpt(gout.WithTimeout()) err := globalWithOpt.GET("url").Do() if err != nil { fmt.Printf("err = %v\n" ,err) return } } Global configuration set timeout 设置全局超时时间。可以简化一些代码。在使用全局配置默认你已经了解它会带来的一些弊端. package main import ( "fmt" "github.com/guonaihong/gout" "time" ) func main() { gout.SetTimeout(time.Second * 1) err := gout.GET("www.baidu.com").Do() if err != nil { fmt.Printf("err is:%v\n") } } Unique features forward gin data gout 设计之初就考虑到要和gin协同工作的可能性,下面展示如何方便地使用gout转发gin绑定的数据。 package main import ( "github.com/gin-gonic/gin" "github.com/guonaihong/gout" ) type testQuery struct { Size int `query:"size" form:"size"` // query tag是gout设置查询字符串需要的 Page int `query:"page" form:"page"` Ak string `query:"ak" form:"ak"` } //下一个服务节点 func nextSever() { r := gin.Default() r.GET("/query", func(c *gin.Context) { q := testQuery{} err := c.ShouldBindQuery(&q) if err != nil { return } c.JSON(200, q) }) r.Run(":1234") } func main() { go nextSever() r := gin.Default() // 演示把gin绑定到的查询字符串转发到nextServer节点 r.GET("/query", func(c *gin.Context) { q := testQuery{} // 绑定查询字符串 err := c.ShouldBindQuery(&q) if err != nil { return } // 开发转发, 复用gin所用结构体变量q code := 0 // http code err := gout. //发起GET请求 GET("127.0.0.1:1234/query"). //设置查询字符串 SetQuery(q). //关心http server返回的状态码 设置该函数 Code(&code). Do() if err != nil || code != 200 { /* todo Need to handle errors here */ } c.JSON(200, q) }) r.Run() } // http client // curl '127.0.0.1:8080/query?size=10&page=20&ak=test' FAQ
优秀的个人博客,低调大师

【Java技术探索】「ConcurrentHashMap」深入浅出的源码分析(JDK1.7版本)

## 前提概要 - **ConcurrentHashMap是Java并发包中提供的一个线程安全且高效的HashMap实现,以及被广泛使用,经典的开源框架Spring的底层数据结构就是使用ConcurrentHashMap实现的**。 - **ConcurrentHashMap在并发编程的场景中使用频率非常之高,本文就来分析下ConcurrentHashMap的实现原理,并对其实现原理进行分析(JDK1.7)**。 - **与同是线程安全的老大哥HashTable相比,它已经更胜一筹,因此它的锁更加细化,而不是像HashTable一样为几乎每个方法都添加了synchronized锁,这样的锁无疑会影响到性能。** ## 实现原理 > **众所周知,哈希表是中非常高效,复杂度为O(1)的数据结构,在Java开发中,我们最常见到最频繁使用的就是HashMap和HashTable,但是在线程竞争激烈的并发场景中使用都不够合理**。 - **HashMap:先说HashMap,HashMap是线程不安全的,在并发环境下,可能会形成环状链表(扩容时可能造成),导致get操作时,cpu空转,所以,在并发环境中使用HashMap是非常危险的**。 - **HashTable:HashTable和HashMap的实现原理几乎一样,差别: 1. **HashTable不允许key和value为null**; 2. **HashTable是线程安全的**。 - **HashTable线程安全的策略实现代价却太大了,简单粗暴,get/put所有相关操作都是synchronized的**,**这相当于给整个哈希表加了一把大锁,多线程访问时候,只要有一个线程访问或操作该对象,那其他线程只能阻塞,相当于将所有的操作串行化,在竞争激烈的并发场景中性能就会非常差**。 ![](https://oscimg.oschina.net/oscnet/up-7109c45e6c385d4955c6a83e7d388cd1c29.png) > HashTable性能差主要是由于所有操作需要竞争同一把锁,而如果容器中有多把锁,每一把锁锁一段数据,这样在多线程访问时不同段的数据时,就不会存在锁竞争了,这样便可以有效地提高并发效率。**这就是ConcurrentHashMap所采用的"分段锁"思想**。 ![](https://oscimg.oschina.net/oscnet/up-9547fd89b675851827e66d2d0333b0c13d1.png) ## **ConcurrentHashMap的主干是个Segment数组**。 ```java final Segment [] segments; ``` - **Segment继承ReentrantLock,所以它就是一种可重入锁ReentrantLock**。 - ConcurrentHashMap,一个Segment就是一个子哈希表,Segment里维护了一个HashEntry数组,并发环境下,对于不同Segment的数据进行操作是不用考虑锁竞争的。 就按默认的ConcurrentLevel为16来讲,理论上就允许16个线程并发执行,有木有很酷 **对于同一个Segment的操作才需考虑线程同步,不同的Segment则无需考虑。** > **Segment类似于HashMap,一个Segment维护着一个HashEntry数组** ```java transient volatile HashEntry [] table; ``` HashEntry是目前我们提到的最小的逻辑处理单元了。 **一个ConcurrentHashMap维护一个Segment数组,一个Segment维护一个HashEntry数组。** ```java static final class HashEntry { final int hash; final K key; volatile V value; volatile HashEntry next; //其他省略 } ``` **Segment类似哈希表(HashTable),那么一些属性就跟我们之前提到的HashMap差不离,比如负载因子loadFactor,比如阈值threshold等等,看下Segment的构造方法** ```java public Segment(float lf, int threshold, HashEntry [] tab) { this.loadFactor = lf;//负载因子 this.threshold = threshold;//阈值 this.table = tab;//主干数组即HashEntry数组 } ``` 我们来看下ConcurrentHashMap的构造方法 ```java public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { if (!(loadFactor > 0) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); //MAX_SEGMENTS 为1<<16=65536,也就是最大并发数为65536 if (concurrencyLevel > MAX_SEGMENTS) concurrencyLevel = MAX_SEGMENTS; //2的sshif次方等于ssize,例:ssize=16,sshift=4;ssize=32,sshif=5 int sshift = 0; //ssize 为segments数组长度,根据concurrentLevel计算得出 int ssize = 1; while (ssize < concurrencyLevel) { ++sshift; ssize <<= 1; } //segmentShift和segmentMask这两个变量在 //定位segment时会用到,后面会详细讲 this.segmentShift = 32 - sshift; this.segmentMask = ssize - 1; if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; // 计算cap的大小,即Segment中HashEntry的数组长度, // cap也一定为2的n次方. int c = initialCapacity / ssize; if (c * ssize < initialCapacity) ++c; int cap = MIN_SEGMENT_TABLE_CAPACITY; while (cap < c) cap <<= 1; // 创建segments数组并初始化第一个Segment, // 其余的Segment延迟初始化 Segment s0 = new Segment (loadFactor, (int)(cap * loadFactor), (HashEntry [])new HashEntry[cap]); Segment [] ss = (Segment [])new Segment[ssize]; UNSAFE.putOrderedObject(ss, SBASE, s0); this.segments = ss; } ``` > 初始化方法有三个参数,如果用户不指定则会使用默认值,initialCapacity为16,loadFactor为0.75(负载因子,扩容时需要参考),concurrentLevel为16。 **Segment数组的大小ssize是由concurrentLevel来决定的,但是却不一定等于concurrentLevel,ssize一定是大于或等于concurrentLevel的最小的2的次幂**。 > **比如:默认情况下concurrentLevel是16,则ssize为16;若concurrentLevel为14,ssize为16;若concurrentLevel为17,则ssize为32**。 **为什么Segment的数组大小一定是2的次幂?其实主要是便于通过按位与的散列算法来定位Segment的index。** ## 重要的属性 首先来看几个重要的属性,与HashMap相同的就不再介绍了,这里重点解释一下sizeCtl这个属性。可以说它是ConcurrentHashMap中出镜率很高的一个属性,因为它是一个控制标识符,在不同的地方有不同用途,而且它的取值不同,也代表不同的含义。 负数代表正在进行初始化或扩容操作 -1 代表正在初始化 -N 表示有N-1个线程正在进行扩容操作 正数或0代表hash表还没有被初始化,这个数值表示初始化或下一次进行扩容的大小,这一点类似于扩容阈值的概念。还后面可以看到,它的值始终是当前ConcurrentHashMap容量的0.75倍,这与loadfactor是对应的。 接下来,我们来看看put方法 ```java public V put(K key, V value) { Segment s; //concurrentHashMap不允许key/value为空 if (value == null) throw new NullPointerException(); //hash函数对key的hashCode重新散列,避免差劲的不合理的hashcode,保证散列均匀 int hash = hash(key); //返回的hash值无符号右移segmentShift位与段掩码进行位运算, // 定位segment int j = (hash >>> segmentShift) & segmentMask; if ((s = (Segment ) // nonvolatile; recheck UNSAFE.getObject(segments, (j << SSHIFT) + SBASE)) == null) // in ensureSegment s = ensureSegment(j); return s.put(key, hash, value, false); } ``` ### put的主要逻辑也就两步: 1. **定位segment并确保定位的Segment已初始化** 2. **调用Segment的put方法。** > 关于segmentShift和segmentMask > **segmentShift和segmentMask这两个全局变量的主要作用是用来定位Segment**,**int j =(hash >>> segmentShift) & segmentMask**。 - segmentMask:**段掩码,假如segments数组长度为16,则段掩码为16-1=15;segments长度为32,段掩码为32-1=31。这样得到的所有bit位都为1,可以更好地保证散列的均匀性** - segmentShift:**2的sshift次方等于ssize,segmentShift=32-sshift。若segments长度为16,segmentShift=32-4=28;若segments长度为32,segmentShift=32-5=27。而计算得出的hash值最大为32位,无符号右移segmentShift,则意味着只保留高几位(其余位是没用的),然后与段掩码segmentMask位运算来定位Segment**。 ### get/put方法 #### get方法 ```java public V get(Object key) { Segment s; HashEntry [] tab; int h = hash(key); long u = (((h >>> segmentShift) & segmentMask) << SSHIFT) + SBASE; //先定位Segment,再定位HashEntry if ((s = (Segment ) UNSAFE.getObjectVolatile(segments, u)) != null && (tab = s.table) != null) { for (HashEntry e = (HashEntry ) UNSAFE.getObjectVolatile (tab, ((long)(((tab.length - 1) & h)) << TSHIFT) + TBASE); e != null; e = e.next) { K k; if ((k = e.key) == key || (e.hash == h && key.equals(k))) return e.value; } } return null; } ``` get方法无需加锁,由于其中涉及到的共享变量都使用volatile修饰,volatile可以保证内存可见性,所以不会读取到过期数据。 来看下concurrentHashMap代理到Segment上的put方法,Segment中的put方法是要加锁的。只不过是锁粒度细了而已。 ```java final V put(K key, int hash, V value, boolean onlyIfAbsent) { HashEntry node = tryLock() ? null : scanAndLockForPut(key, hash, value); //tryLock不成功时会遍历定位到的HashEnry位置的链表(遍历主要是为了使CPU缓存链表),若找不到,则创建HashEntry。 // tryLock一定次数后(MAX_SCAN_RETRIES变量决定),则lock。若遍历过程中,由于其他线程的操作导致链表头结点变化,则需要重新遍历。 V oldValue; try { HashEntry [] tab = table; int index = (tab.length - 1) & hash; //定位HashEntry,可以看到, //这个hash值在定位Segment时和在Segmen //t中定位HashEntry都会用到, //只不过定位Segment时只用到高几位。 HashEntry first = entryAt(tab, index); for (HashEntry e = first;;) { if (e != null) { K k; if ((k = e.key) == key || (e.hash == hash && key.equals(k))) { oldValue = e.value; if (!onlyIfAbsent) { e.value = value; ++modCount; } break; } e = e.next; } else { if (node != null) node.setNext(first); else node = new HashEntry (hash, key, value, first); int c = count + 1; //若c超出阈值threshold,需要扩容并rehash。扩容后的容量是当前容量的2倍。这样可以最大程度避免之前散列好的entry重新散列,具体在另一篇文章中有详细分析,不赘述。扩容并rehash的这个过程是比较消耗资源的。 if (c > threshold && tab.length < MAXIMUM_CAPACITY) rehash(node); else setEntryAt(tab, index, node); ++modCount; count = c; oldValue = null; break; } } } finally { unlock(); } return oldValue; } ``` ## 总结 > **ConcurrentHashMap作为一种线程安全且高效的哈希表的解决方案,尤其其中的"分段锁"的方案,相比HashTable的全表锁在性能上的提升非常之大。**

优秀的个人博客,低调大师

【Java技术探索】HashMap深入浅出的源码分析(JDK1.7版本)

每日一句 有望得到的要努力,无望得到的不介意,则无论输赢姿态都会好看。 概念回顾 HashMap由数组+链表组成的,数组是HashMap的主体,链表则是主要为了解决哈希冲突而存在的,如果定位到的数组位置不含链表(当前entry的next指向null),那么对于查找,添加等操作很快,仅需一次寻址即可; 如果定位到的数组包含链表,对于添加操作,其时间复杂度依然为O(1),因为最新的Entry会插入链表头部,急需要简单改变引用链即可,而对于查找操作来讲,此时就需要遍历链表,然后通过key对象的equals方法逐一比对查找。 所以,性能考虑,HashMap中的链表出现越少,性能才会越好。 不同JVM版本HashMap的展现形式 本章内容主要为介绍JDK7的版本文章学习。 JDK7 HashMap的数据结构为:数组 + 链表 JDK8 可以查看相关对应的另外一篇【JDK8的HashMap源码分析】 HashMap的数据结构为:数组 + 链表 + 红黑树 基本简介 哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技术(比如memcached)的核心其实就是在内存中维护一张大的哈希表,而HashMap的实现原理就是基于此。 数据结构的分析 针对于多种数据结构进行分析为什么会选择Hash表的方式进行存储和查询。 数组 采用一段连续的存储单元来存储数据。 查询操作场景 对于指定下标的查找,时间复杂度为O(1); 通过给定值进行查找,需要遍历数组,逐一比对给定关键字和数组元素,时间复杂度为O(n)。 对于有序数组,则可采用二分查找,插值查找,斐波那契查找等方式,可将查找复杂度提高为O(logn); 插入删除场景 对于一般的插入删除操作,涉及到数组元素的移动,其平均复杂度也为O(n)。 对应到集合类是ArrayList。 线性链表 查询操作场景 查找操作需要遍历链表逐一进行比对,复杂度为O(n)。 插入删除场景 链表的新增,删除等操作(在找到指定操作位置后),仅需处理结点间的引用即可,时间复杂度为O(1)。 对应的集合类是LinkedList。 二叉树 对一棵相对平衡的有序二叉树。 对其进行插入,查找,删除等操作,平均复杂度均为O(logn)。 对应的集合类有TreeSet和TreeMap。 哈希表 相比上述几种数据结构,在哈希表中进行添加,删除,查找等操作,性能十分之高,不考虑哈希冲突的情况下,仅需一次定位即可完成,时间复杂度为O(1)。 对应的集合类就是HashMap。 哈希表的主干就是数组。我们要新增或查找某个元素,我们通过把当前元素的关键字 通过某个函数映射到数组中的某个位置,通过数组下标一次定位就可完成操作。 即:存储位置 = hash(关键字) 其中,这个函数hash一般称为哈希函数,这个函数的设计好坏会直接影响到哈希表的优劣。这会涉及到哈希冲突。 哈希函数的设计至关重要,好的哈希函数会尽可能地保证计算简单和散列地址分布均匀。 Hash冲突机制 当我们对某个元素进行哈希运算,得到一个存储地址,然后要进行插入的时候,发现已经被其他元素占用了,其实这就是所谓的哈希冲突,也叫哈希碰撞。 数组是一块连续的固定长度的内存空间,再好的哈希函数也不能保证得到的存储地址绝对不发生冲突。那么哈希冲突如何解决呢? 哈希冲突的解决方案有多种:开放定址法(发生冲突,继续寻找下一块未被占用的存储地址)、再散列函数法、链地址法。 而HashMap即是采用了链地址法,也就是数组+链表的方式。 HashMap的源码实现 存储结构 Hash桶(bucket) 当实例化一个HashMap时,系统会创建一个长度为Capacity的Entry数组,这个长度被称为容量(Capacity),在这个数组中可以存放元素的位置我们称之为“桶”(bucket),每个bucket都有自己的索引,系统可以根据索引快速的查找bucket中的元素。 每个bucket中存储一个元素,即一个Entry对象,但每一个Entry对象可以带一个引用变量,用于指向下一个元素,因此,在一个桶中,就有可能生成一个Entry链。 Entry HashMap的基本组成单元,每一个Entry包含一个key-value键值对。 Entry是HashMap中的一个静态内部类。代码如下: static class Entry<K,V> implements Map.Entry<K,V> { final K key; V value; //存储指向下一个Entry的引用,单链表结构 Entry<K,V> next; //对key的hashcode值进行hash运算后得到的值,存储在Entry,避免重复计算 int hash; /** * Creates new entry. */ Entry(int h, K k, V v, Entry<K,V> n) { value = v; next = n; key = k; hash = h; } 经过以上分析,HashMap的存储结构图如下: 一个长度为16的数组中,每个元素存储的是一个链表的头结点。那么这些元素是按照什么样的规则存储到数组中呢。 一般情况是通过hash(key)%len获得,也就是元素的key的哈希值对数组长度取模得到。 比如上述哈希表中,12%16=12,28%16=12,108%16=12,140%16=12。所以12、28、108以及140都存储在数组下标为12的位置。 在存储一对值时(Key ->Value对),实际上是存储在一个Entry的对象e中,程序通过key计算出Entry对象的存储位置。 Key->Value的对应关系是通过key—-Entry—-value这个过程实现的,所以就有我们表面上知道的key存在哪里,value就存在哪里。 重要属性 先看HashMap中的几个重要属性: //默认初始化化容量,即16 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; //最大容量,即2的30次方 static final int MAXIMUM_CAPACITY = 1 << 30; //默认装载因子 static final float DEFAULT_LOAD_FACTOR = 0.75f; //HashMap内部的存储结构是一个数组,此处数组为空,即没有初始化之前的状态 static final Entry<?,?>[] EMPTY_TABLE = {}; //空的存储实体 transient Entry<K,V>[] table = (Entry<K,V>[]) EMPTY_TABLE; //实际存储的key-value键值对的个数 transient int size; //阈值,当table == {}时,该值为初始容量(初始容量默认为16);当table被填充了,也就是为table分配内存空间后,threshold一般为 capacity*loadFactory。HashMap在进行扩容时需要参考threshold int threshold; //负载因子,代表了table的填充度有多少,默认是0.75 final float loadFactor; //用于快速失败,由于HashMap非线程安全,在对HashMap进行迭代时,如果期间其他线程的参与导致HashMap的结构发生变化了(比如put,remove等操作),需要抛出异常ConcurrentModificationException transient int modCount; //默认的threshold值 static final int ALTERNATIVE_HASHING_THRESHOLD_DEFAULT = Integer.MAX_VALUE; //计算Hash值时的key种子值 transient int hashSeed = 0; 构造方法 HashMap有4个构造器,其他构造器如果用户没有传入initialCapacity 和loadFactor这两个参数,会使用默认值。initialCapacity默认为16,loadFactory默认为0.75。 //通过初始容量和状态因子构造HashMap public HashMap(int initialCapacity, float loadFactor) { if (initialCapacity < 0)//参数有效性检查 throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY)//参数有效性检查 initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor))//参数有效性检查 throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; threshold = initialCapacity; // init方法在HashMap中没有实际实现,不过在其子类如 // linkedHashMap中就会有对应实现 init(); } //通过扩容因子构造HashMap,容量去默认值,即16 public HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } //装载因子取0.75,容量取16,构造HashMap public HashMap() { this(DEFAULT_INITIAL_CAPACITY, DEFAULT_LOAD_FACTOR); } //通过其他Map来初始化HashMap, // 容量通过其他Map的size来计算,装载因子取0.75 public HashMap(Map<? extends K, ? extends V> m) { this(Math.max((int) (m.size() / DEFAULT_LOAD_FACTOR) + 1, DEFAULT_INITIAL_CAPACITY), DEFAULT_LOAD_FACTOR); inflateTable(threshold);//初始化HashMap底层的数组结构 putAllForCreate(m);//添加m中的元素 } 从上面这段代码我们可以看出,在常规构造器中,并没有马上为数组table分配内存空间(有一个入参为指定Map的构造器例外),事实上是在执行第一次put操作的时候才真正构建table数组。 put操作 如果两个key通过hash%Entry[].length得到的index相同,为了解决这个问题,HashMap里面用到链式数据结构的一个概念。 上面我们提到过Entry类里面有一个next属性,作用是指向下一个Entry。打个比方, 第一个键值对A进来,通过计算其key的hash得到的index=0,记做:Entry[0] = A。 一会后又进来一个键值对B,通过计算其index也等于0,HashMap会这样做:B.next = A,Entry[0] = B,如果又进来C,index也等于0,那么C.next = B,Entry[0] = C; 这样我们发现index=0的地方其实存取了A,B,C三个键值对,他们通过next这个属性链接在一起。 也就是说数组中存储的是最后插入的元素。到这里为止,HashMap的大致实现,我们应该已经清楚了。 public V put(K key, V value) { //如果table数组为空数组{},进行数组填充(为table分配实际内存空间),入参为threshold,此时threshold为initialCapacity 默认是1<<4(=16) if (table == EMPTY_TABLE) { inflateTable(threshold);//分配数组空间 } //如果key为null,存储位置为table[0]或table[0]的冲突链上 if (key == null) return putForNullKey(value); int hash = hash(key); //对key的hashcode进一步计算,确保散列均匀 int i = indexFor(hash, table.length);//获取在table中的实际位置 for (Entry<K,V> e = table[i]; e != null; e = e.next) { //如果该对应数据已存在,执行覆盖操作。用新value替换旧value,并返回旧value Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this);//调用value的回调函数,其实这个函数也为空实现 return oldValue; } } modCount++;//保证并发访问时,若HashMap内部结构发生变化,快速响应失败 addEntry(hash, key, value, i);//新增一个entry return null; } putForNullKey 方法 key为null的时候,只会放在hashMap的0位置(即key的hashCode为0,对数组长度取余后的下标也是0),不会有链表 在HashMap源码中对put方法对null做了处理,key为null的判断后进入putForNullKey(V value)这个方法,里面for循环是在talbe[0]链表中查找key为null的元素,如果找到,则将value重新赋值给这个元素的value,并返回原来的value。如果没找到则将这个元素添加到talbe[0]链表的表头 /** * Offloaded version of put for null keys */ private V putForNullKey(V value) { // for循环处理key为空的情况 for (Entry<K,V> e = table[0]; e != null; e = e.next) { if (e.key == null) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(0, null, value, 0); return null; } inflateTable的源码如下: private void inflateTable(int toSize) { //capacity一定是2的次幂 int capacity = roundUpToPowerOf2(toSize); //此处为threshold赋值,取capacity*loadFactor和 MAXIMUM_CAPACITY+1的最小值,capaticy一定不会超过MAXIMUM_CAPACITY,除非loadFactor大于1 threshold = (int) Math.min(capacity * loadFactor, MAXIMUM_CAPACITY + 1); //分配空间 table = new Entry[capacity]; //选择合适的Hash因子 initHashSeedAsNeeded(capacity); } inflateTable这个方法用于为主干数组table在内存中分配存储空间,通过roundUpToPowerOf2(toSize)可以确保capacity为大于或等于toSize的最接近toSize的二次幂,比如toSize=13,则capacity=16;to_size=16,capacity=16;to_size=17,capacity=32。 二次幂其实现如下: private static int roundUpToPowerOf2(int number) { // assert number >= 0 : "number must be non-negative"; return number >= MAXIMUM_CAPACITY ? MAXIMUM_CAPACITY : (number > 1) ? Integer.highestOneBit((number - 1) << 1) : 1; } roundUpToPowerOf2中的这段处理使得数组长度一定为2的次幂,Integer.highestOneBit是用来获取最左边的bit(其他bit位为0)所代表的数值。 在对数组进行空间分配后,会根据hash函数计算散列值,其实现如下: //用了很多的异或,移位等运算,对key的hashcode进一步进行计算以及二进制位的调整等来保证最终获取的存储位置尽量分布均匀 final int hash(Object k) { int h = hashSeed; //这里针对String优化了Hash函数,是否使用新的Hash函数和Hash // 因子有关 if (0 != h && k instanceof String) { return sun.misc.Hashing.stringHash32((String) k); } h ^= k.hashCode(); h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 从上面的操作看以看出,影响HashMap元素的存储位置的只有key的值,与value值无关。 通过hash函数得到散列值后,再通过indexFor进一步处理来获取实际的存储位置 其实现如下: //返回数组下标 static int indexFor(int h, int length) { return h & (length-1); } h &(length-1)保证获取的index一定在数组范围内,举个例子,默认容量16,length-1=15,h=18,转换成二进制计算为 最终计算出的index=2。有些版本的对于此处的计算会使用取模运算,也能保证index一定在数组范围内,不过位运算对计算机来说,性能更高一些(HashMap中有大量位运算)。 通过以上分析,我们看到,要得到一个元素的存储位置,需要如下几步: 获取该元素的key值 通过hash方法得到key的散列值,其中需要用到key的hashcode值。 通过indexFor计算得到存储的下标位置。 最后,得到存储的下标位置后,我们就可以将元素放入HashMap中,具体通过addEntry实现: void addEntry(int hash, K key, V value, int bucketIndex) { //当size超过临界阈值threshold,并且即将发生哈希冲突时进行扩容,新容量为旧容量的2倍 if ((size >= threshold) && (null != table[bucketIndex])) { resize(2 * table.length); hash = (null != key) ? hash(key) : 0; //扩容后重新计算插入的位置下标 bucketIndex = indexFor(hash, table.length); } //把元素放入HashMap的桶的对应位置 createEntry(hash, key, value, bucketIndex); } //创建元素 void createEntry(int hash, K key, V value, int bucketIndex) { //获取待插入位置元素 Entry<K,V> e = table[bucketIndex]; //这里执行链接操作,使得新插入的元素指向原有元素。 table[bucketIndex] = new Entry<>(hash, key, value, e); //这保证了新插入的元素总是在链表的头 //元素个数+1 size++; } 通过以上代码能够得知,当发生哈希冲突并且size大于阈值的时候并且对应的key对应的table桶的首地址元素不为null的情况下:需要进行数组扩容 扩容时,需要新建一个长度为之前数组2倍的新的数组,然后将当前的Entry数组中的元素全部传输过去,扩容后的新数组长度为之前的2倍,所以扩容相对来说是个耗资源的操作。 扩容操作 扩容操作通过resize操作实现: //按新的容量扩容Hash表 void resize(int newCapacity) { Entry[] oldTable = table;//老的数据 int oldCapacity = oldTable.length;//获取老的容量值 //老的容量值已经到了最大容量值 if (oldCapacity == MAXIMUM_CAPACITY) { //修改扩容阀值 threshold = Integer.MAX_VALUE; return; } //新的结构 Entry[] newTable = new Entry[newCapacity]; //将老的表中的数据拷贝到新的结构中 transfer(newTable, initHashSeedAsNeeded(newCapacity)); //修改HashMap的底层数组 table = newTable; //修改阀值 threshold = (int)Math.min(newCapacity * loadFactor, MAXIMUM_CAPACITY + 1); } 如果数组进行扩容,数组长度发生变化,而存储位置 index = h&(length-1),index也可能会发生变化,需要重新计算index,我们先来看看transfer这个方法。 //将老的表中的数据拷贝到新的结构中 void transfer(Entry[] newTable, boolean rehash) { int newCapacity = newTable.length;//容量 for (Entry<K,V> e : table) { //遍历所有桶 while(null != e) { //遍历桶中所有元素(是一个链表) Entry<K,V> next = e.next; //如果是重新Hash,则需要重新计算hash值. if (rehash) { e.hash = null == e.key ? 0 : hash(e.key); } //定位Hash桶 int i = indexFor(e.hash, newCapacity); //元素连接到桶中,这里相当于单链表的插入,总是插入在最前面 e.next = newTable[i]; //newTable[i]的值总是最新插入的值 newTable[i] = e; e = next;//继续下一个元素 } } } 这个方法将老数组中的数据逐个链表地遍历,重新计算后放入新的扩容后的数组中,我们的数组索引位置的计算是通过对key值的hashcode进行hash扰乱运算后,再通过和 length-1进行位运算得到最终数组索引位置。 注意:HashMap数组元素长度的设计 通过源码可以发现,hashMap的数组长度一定保持2的次幂,这样做有什么好处呢? //根据Hash值和Hash表的大小选择合适的Hash桶 static int indexFor(int h, int length) { return h & (length-1); } 如果length为2的次幂,其二进制表示就是100….0000;则length-1 转化为二进制必定是0111….11的形式,在于h的二进制与操作效率会非常的快,而且空间不浪费;如果length不是2的次幂,比如length为15,则length-1为14,对应的二进制为1110,再于h与操作。 最后一位都为0,所以0001,0011,0101,1001,1011,0111,1101这几个位置永远都不会存放元素了,空间浪费相当大,更糟的是这种情况中,数组可以使用的位置比数组长度小了很多,这意味着进一步增加了碰撞的几率,减慢了查询的效率!这样就会造成空间的浪费。 get操作 //获取key值为key的元素值 public V get(Object key) { if (key == null)//如果Key值为空,则获取对应的值,这里也可以看到,HashMap允许null的key,其内部针对null的key有特殊的逻辑 return getForNullKey(); Entry<K,V> entry = getEntry(key);//获取实体 return null == entry ? null : entry.getValue();//判断是否为空,不为空,则获取对应的值 } //获取key为null的实体 private V getForNullKey() { if (size == 0) {//如果元素个数为0,则直接返回null return null; } //key为null的元素存储在table的第0个位置 for (Entry<K,V> e = table[0]; e != null; e = e.next) { if (e.key == null)//判断是否为null return e.value;//返回其值 } return null; } get方法通过key值返回对应value,如果key为null,直接去table[0]处检索。我们再看一下getEntry这个方法: //获取键值为key的元素 final Entry<K,V> getEntry(Object key) { if (size == 0) {//元素个数为0 return null;//直接返回null } int hash = (key == null) ? 0 : hash(key);//获取key的Hash值 for (Entry<K,V> e = table[indexFor(hash, table.length)];//根据key和表的长度,定位到Hash桶 e != null; e = e.next) {//进行遍历 Object k; if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k))))//判断Hash值和对应的key,合适则返回值 return e; } return null; } get方法的实现相对简单,key(hashcode)–>hash–>indexFor–>最终索引位置,找到对应位置table[i],再查看是否有链表,遍历链表,通过key的equals方法比对查找对应的记录。 在定位到数组位置之后然后遍历链表的时候,e.hash == hash这个判断没必要,仅通过equals判断就可以。 HashMap中的hashcode怎么生成 调用对象key的hashCode方法,再对这个hashcode方法进行一些右移以及异或运算(使的hashCode的高位和低位都参与到运算中);通过右移和异或运算可以使hashMap的散列化更强,提高hashMap的get方法的效率 为什么使用HashCode HashCode的存在主要是为了查找的快捷性,HashCode是用来在散列存储结构中确定对象的存储地址的 ( 用hashcode来代表对象在hash表中的位置 ) , hashCode存在的重要的原因之一就是在HashMap(HashSet其实就是HashMap)中使用(其实Object类的hashCode方法注释已经说明了)。 equals方法和hashcode的关系 若重写了equals(Object obj)方法,则有必要重写hashCode()方法 若两个对象equals(Object obj)返回true,则hashCode()有必要也返回相同的int数 若两个对象equals(Object obj)返回false,则hashCode()不一定返回不同的int数 若两个对象hashCode()返回相同int数,则equals(Object obj)不一定返回true 若两个对象hashCode()返回不同int数,则equals(Object obj)一定返回false 同一对象在执行期间若已经存储在集合中,则不能修改影响hashCode值的相关信息,否则会导致内存泄露问题 总结 HashMap之所以速度快,因为他使用的是散列表,根据key的hashcode值生成数组下标(通过内存地址直接查找,不需要判断,但是需要多出很多内存,相当于以空间换时间)

优秀的个人博客,低调大师

【Java技术探索】HashMap深入浅出的源码分析(JDK1.8版本)

【每日一句】 一个人最大的挑战,是如何去克服自己的缺点。 【基本原理】 HashMap是一个基于map接口实现的散列表,存储内容是键值对 (key-value) 映射,并且键和值都可以使用null,因为key不允许重复,因此只能有一个键为null。 HashMap使用 hash 算法进行数据的存储和查询。 HashMap的实现用的是数组+链表+红黑树的结构,也叫哈希桶。在jdk 1.8之前都是数组+链表的结构,因为在链表的查询操作都是O(N)的时间复杂度,如果当节点数量多,转换为红黑树结构,那么将会提高很大的效率,因为红黑树结构中,增删改查都是O(log n)。 【基本特性】 HashMap的散列表是懒加载机制,在第一次put的时候才会创建 它根据键的 hashCode 值存储数据,大多数情况下可以直接定位到它的值,因而具有很快的访问速度,但遍历顺序却是不确定的。 HashMap 最多只允许一条记录的键(Key)为 null,允许多条记录的值为 null。 HashMap是无序不重复的,而且HashMap是线程不安全的。 HashMap 默认情况下使用一个Entry表示键值对 key-value,用Entry的数组保存所有键值对,Entry通过链表的方式链接后续的节点 (1.8 后会根据链表长度决定是否转换成一棵树类似TreeMap来节省查询时间,Node节点会采用LinkedHashMapEntry的属性),Entry通过计算 key 的 hash 值来决定映射到具体的哪个数组(也叫 Bucket) 中。 HashMap 非线程安全,即任一时刻可以有多个线程同时写 HashMap,可能会导致数据的不一致。 如果需要满足线程安全,可以用 Collections 的 synchronizedMap 方法使 HashMap 具有线程安全的能力,或者使用 ConcurrentHashMap。 【优化点】 链表改为红黑树:时间复杂度(O(N) —> O(log(N))) 【原理简述】 【put方法】 输入参数 key值,value值 运作流程 首先针对于传入的对Key求hash值,然后再计算下标。 如果没有碰撞,直接放入桶中(碰撞的意思是计算得到的hash值相同,需要放到同一个bucket中,代表着属于链表)。 如果hash值发生碰撞后,以链表的方式链接到后面。 如果链表长度超过阀值( TREEIFY THRESHOLD==8),就把链表转成红黑树,链表长度低于6,就把红黑树转回链表。 如果key的hashcode相同且value也相同的情况下,就替换旧值 如果桶到达阈值(Threshold)后(初始化容量(16)以及加载因子(0.75)),就需要 resize(扩容2倍后并且进行重排(重新hash和重新排版)) 数据结构图 HashMap属性代码 首先,需要记住的是,JCF的一个传统模式,就是集成AbstractXXX抽象类和实现所有的基础接口XXX,XXX(Map,List,Set,Collection等),并且可以实现序列化和克隆。 属性默认值 public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable { //序列号,序列化的时候使用 private static final long serialVersionUID = 362498820763181265L; //默认容量,为2的4次方,即为16, 必须为 2 的 n 次方 (一定是合数) static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; //最大容量,为2的30次方。 static final int MAXIMUM_CAPACITY = 1 << 30; //加载因子,用于扩容使用。 static final float DEFAULT_LOAD_FACTOR = 0.75f; //链表转成红黑树的阈值。即在哈希表扩容时,当链表的长度(桶中元素个数)超过这个值的时候,进行链表到红黑树的转变 static final int TREEIFY_THRESHOLD = 8; //红黑树转为链表的阈值。即在哈希表扩容时,如果发现链表长度(桶中元素个数)小于 6,则会由红黑树重新退化为链表 static final int UNTREEIFY_THRESHOLD = 6; //当整个hashMap中元素数量大于64时,也会进行转为红黑树结构。 //HashMap 的最小树形化容量。这个值的意义是:位桶(bin)处的数 //据要采用红黑树结构进行存储时,整个Table的最小容量(存储方式由 //链表转成红黑树的容量的最小阈值) 当哈希表中的容量大于这个值 //时,表中的桶才能进行树形化,否则桶内元素太多时会扩容,而不是 // 树形化为了避免进行扩容、树形化选择的冲突,这个值不能小于 4 * // TREEIFY_THRESHOLD static final int MIN_TREEIFY_CAPACITY = 64; } 属性参数 public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable { transient Node<K,V>[] table; //将数据转换成set的另一种存储形式,这个变量主要用于迭代功能。 transient Set<Map.Entry<K,V>> entrySet; //元素数量 transient int size; //统计该map修改的次数,用来记录 HashMap 内部结构发生变化的次数,主要用于迭代的快速失败机制 transient int modCount; //HashMap 的门限阀值/扩容阈值,所能容纳的 key-value 键值对极 // // 限,当size>=threshold时,就会扩容,计算方法:容量capacity * 负 // 载因子load factor 。 int threshold; //加载因子 final float loadFactor; } Node[] table:的初始化长度 length(默认值是 16),loadFactor 为负载因子 (默认值 DEFAULT_LOAD_FACTOR 是 0.75),threshold 是 HashMap 所能容纳的最大数据量的 Node(键值对) 个数。 *threshold = length loadFactor。也就是说,在数组定义好长度之后,负载因子越大,所能容纳的键值对个数越多。** *这里我们需要加载因子 (load_factor),加载因子默认为 0.75,当 HashMap 中存储的元素的数量大于 (容量 × 加载因子),也就是默认大于 160.75=12 时,HashMap 会进行扩容的操作 **。 size:这个字段其实很好理解,就是HashMap中实际存在的键值对数量。注意和 table 的长度 length、容纳最大键值对数量 threshold 的区别。 modCount:字段主要用来记录HashMap内部结构发生变化的次数,主要用于迭代的快速失败。强调一点,内部结构发生变化指的是结构发生变化。 put新键值对,某个key对应的value值被覆盖不属于结构变化。 HashMap的内部功能实现很多,本文主要从根据key获取哈希桶数组索引位置、put方法的详细执行、扩容过程等具有代表性的点深入展开讲解。 构造函数 第一个默认初始化+默认加载因子,第二个设置初始容量+初始化默认加载因子,第三个设置初始容量和加载因子。 // 默认初始化容量+默认负载因子 public HashMap() { this.loadFactor = DEFAULT_LOAD_FACTOR; } // 自定义初始化容量+默认负载因子 public HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } // 自定义初始化容量以及负载因子 public HashMap(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; this.threshold = tableSizeFor(initialCapacity); } public HashMap(Map<? extends K, ? extends V> m) { this.loadFactor = DEFAULT_LOAD_FACTOR; putMapEntries(m, false); } final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) { //获取该map的实际长度 int s = m.size(); if (s > 0) { //判断table是否初始化,如果没有初始化 if (table == null) { // pre-size /**求出需要的容量,因为实际使用的长度=容量*0.75得来的,+1是因为小数相除,基本都不会是整数,容量大小不能为小数的,后面转换为int,多余的小数就要被丢掉,所以+1,例如,map实际长度22,22/0.75=29.3,所需要的容量肯定为30,有人会问如果刚刚好除得整数呢,除得整数的话,容量大小多1也没什么影响**/ float ft = ((float)s / loadFactor) + 1.0F; //判断该容量大小是否超出上限。 int t = ((ft < (float)MAXIMUM_CAPACITY) ? (int)ft : MAXIMUM_CAPACITY); /**对临界值进行初始化,tableSizeFor(t)这个方法会返回大于t值的,且离其最近的2次幂,例如t为29,则返回的值是32**/ if (t > threshold) threshold = tableSizeFor(t); } //如果table已经初始化,则进行扩容操作,resize()就是扩容。 else if (s > threshold) resize(); //遍历,把map中的数据转到hashMap中。 for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) { K key = e.getKey(); V value = e.getValue(); putVal(hash(key), key, value, false, evict); } } } 节点对象 HashMap内部类TreeNode,该类是一个红黑树结构。 static final class TreeNode<K,V> extends LinkedHashMap.LinkedHashMapEntry<K,V> { // red-black tree links TreeNode<K,V> parent; TreeNode<K,V> left; TreeNode<K,V> right; // needed to unlink next upon deletion TreeNode<K,V> prev; boolean red; TreeNode(int hash, K key, V val, Node<K,V> next) { super(hash, key, val, next); } } HashMap内部类Node, 结构为单向链表。 static class Node<K,V> implements Map.Entry<K,V> { final int hash; final K key; V value; Node<K,V> next; Node(int hash, K key, V value, Node<K,V> next) { this.hash = hash; this.key = key; this.value = value; this.next = next; } public final K getKey() { return key; } public final V getValue() { return value; } public final String toString() { return key + "=" + value; } public final int hashCode() { return Objects.hashCode(key) ^ Objects.hashCode(value); } public final V setValue(V newValue) { V oldValue = value; value = newValue; return oldValue; } public final boolean equals(Object o) { if (o == this) return true; if (o instanceof Map.Entry) { Map.Entry<?,?> e = (Map.Entry<?,?>)o; if (Objects.equals(key, e.getKey()) && Objects.equals(value, e.getValue())) return true; } return false; } } 哈希方法 解决Hash 的的冲突的hash()方法,HashMap的hash计算时先计算 hashCode(), 然后进行二次hash。 // 计算二次Hash int hash = hash(key.hashCode()); // 通过Hash找数组索引 int i = hash & (tab.length-1); static final int hash(Object key) { int h; // 先获取到key的hashCode,然后进行移位再进行异或运算,为什么这 //么复杂,不用想肯定是为了减少hash冲突 return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } 这个方法非常巧妙,它总是通过 h &(table.length -1) 来得到该对象的保存位置,而 HashMap 底层数组的长度总是 2 的 n 次方。当 length 总是 2 的倍数时,h & (length-1) 将是一个非常巧妙的设计: 假设 h=5,length=16, 那么 h & length - 1 将得到 5; 假设 h=6,length=16, 那么 h & length - 1 将得到 6 假设 h=15,length=16, 那么 h & length - 1 将得到 15; 但是当 h=16 时 , length=16 时,那么 h & length - 1 将得到 0 了;当 h=17 时 , length=16 时,那么 h & length - 1 将得到 1 了。这样保证计算得到的索引值总是位于 table 数组的索引之内。 添加元素 public V put(K key, V value) { // 对key的hashCode()做hash return putVal(hash(key), key, value, false, true); } /** * Implements Map.put and related methods * * @param hash hash for key * @param key the key * @param value the value to put * @param onlyIfAbsent if true, don't change existing value * @param evict if false, the table is in creation mode. * @return previous value, or null if none */ final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; // table为空或者length=0时,以默认大小扩容,n为table的长度 if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; // 计算index,并对null做处理,table[i]==null if ((p = tab[i = (n - 1) & hash]) == null) // (n-1)&hash 与Java7中indexFor方法的实现相同,若i位置上的值为空,则新建一个Node,table[i]指向该Node。 // 直接插入 tab[i] = newNode(hash, key, value, null); else { // 若i位置上的值不为空,判断当前位置上的Node p 是否与要插入的key的hash和key相同 Node<K,V> e; K k; // 若节点key存在,直接覆盖value if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) e = p; // 判断table[i]该链是否是红黑树,如果是红黑树,则直接在树中插入键值对 else if (p instanceof TreeNode) // 不同,且当前位置上的的node p已经是TreeNode的实例,则再该树上插入新的node e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); // table[i]该链是普通链表,进行链表的插入操作 else { // 在i位置上的链表中找到p.next为null的位置,binCount计算出当前链表的长度,如果继续将冲突的节点插入到该链表中,会使链表的长度大于tree化的阈值,则将链表转换成tree。 for (int binCount = 0; ; ++binCount) { // 如果遍历到了最后一个节点,说明没有匹配的key,则创建一个新的节点并添加到最后 if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); // 链表长度大于8转换为红黑树进行处理 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } // 遍历过程中若发现 key 已经存在直接覆盖 value 并跳出循环即可 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } // 已经存在该key的情况时,将对应的节点的value设置为新的value if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } } ++modCount; // 插入成功后,判断实际存在的键值对数量 size 是否超多了最大容量 threshold,如果超过,进行扩容 if (++size > threshold) resize(); afterNodeInsertion(evict); return null; } 红黑树结构的putVal方法 final TreeNode<K,V> putTreeVal(HashMap<K,V> map, Node<K,V>[] tab,int h, K k, V v) { Class<?> kc = null; boolean searched = false; TreeNode<K,V> root = (parent != null) ? root() : this; for (TreeNode<K,V> p = root;;) { int dir, ph; K pk; if ((ph = p.hash) > h) dir = -1; else if (ph < h) dir = 1; else if ((pk = p.key) == k || (k != null && k.equals(pk))) return p; else if ((kc == null && (kc = comparableClassFor(k)) == null) || (dir = compareComparables(kc, k, pk)) == 0) { if (!searched) { TreeNode<K,V> q, ch; searched = true; if (((ch = p.left) != null && (q = ch.find(h, k, kc)) != null) || ((ch = p.right) != null && (q = ch.find(h, k, kc)) != null)) return q; } dir = tieBreakOrder(k, pk); } TreeNode<K,V> xp = p; if ((p = (dir <= 0) ? p.left : p.right) == null) { Node<K,V> xpn = xp.next; TreeNode<K,V> x = map.newTreeNode(h, k, v, xpn); if (dir <= 0) xp.left = x; else xp.right = x; xp.next = x; x.parent = x.prev = xp; if (xpn != null) ((TreeNode<K,V>)xpn).prev = x; moveRootToFront(tab, balanceInsertion(root, x)); return null; } } } 总结 put()方法大致的思路为: 对key的hashCode()做hash,然后再计算 index; 如果没碰撞直接放到 bucket里; 如果碰撞了,以链表的形式存在 buckets 后; 如果碰撞导致链表过长 (大于等于 TREEIFY_THRESHOLD=8),就把链表转换成红黑树; 如果节点已经存在就替换 old value(保证 key 的唯一性) *如果 bucket 满了 (超过 load factorcurrent capacity),就要 resize**。 具体步骤为 如果 table 没有使用过的情况(tab=table)==null || (n=tab.length) == 0,则以默认大小进行一次 resize。 计算key的hash值,然后获取底层 table 数组的第 (n-1) & hash 的位置的数组索引tab[i] 处的数据,即hash对n取模的位置,依赖的是n 为2的次方这一条件 先检查该 bucket 第一个元素是否是和插入的 key 相等 (如果是同一个对象则肯定 equals) 如果不相等并且是 TreeNode 的情况,调用TreeNode 的 put 方法否则循环遍历树节点, 如果找到相等的key跳出循环否则达到最后一个节点时将新的节点添加到链表最后, 当前面找到了相同的 key 的情况下替换这个节点的 value 为新的 value。 最后如果新增了 key-value 对,则增加 size 并且判断是否超过了 threshold, 如果超过则需要进行 resize 扩容 扩容尺寸 扩容 (resize) 就是重新计算容量,向HashMap对象里不停的添加元素,而HashMap对象内部的数组无法装载更多的元素时,对象就需要扩大数组的长度,以便能装入更多的元素。 当然Java里的数组是无法自动扩容的,方法是使用一个新的数组代替已有的容量小的数组,就像我们用一个小桶装水,如果想装更多的水,就得换大水桶。 由于需要考虑hash冲突解决时采用的可能是链表也可能是红黑树的方式,因此resize方法相比JDK7 中复杂了一些。 rehashing触发的条件: *超过默认容量 加载因子**; 加载因子不靠谱,比如远大于 1。 在HashMap进行扩容时,会进行2倍扩容,而且会将哈希碰撞处的数据再次分散开来,一部分依照新的 hash 索引值呆在 “原处”,另一部分加上偏移量移动到新的地方。 具体步骤为: 首先计算 resize() 后的新的 capacity 和 threshold 值。 如果原有的 capacity 大于零则将 capacity 增加一倍,否则设置成默认的 capacity。 创建新的数组,大小是新的capacity 将旧数组的元素放置到新数组中 final Node<K,V>[] resize() { // 将字段引用copy到局部变量表,这样在之后的使用时可以减少getField指令的调用 Node<K,V>[] oldTab = table; // oldCap为原数组的大小或当空时为0 int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; if (oldCap > 0) { if (oldCap >= MAXIMUM_CAPACITY) { // 如果超过最大容量1>>30,无法再扩充table,只能改变阈值 threshold = Integer.MAX_VALUE; return oldTab; } // 新的数组的大小是旧数组的两倍 else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) // 当旧的的数组大小大于等于默认大小时,threshold也扩大一倍 newThr = oldThr << 1; } else if (oldThr > 0) // initial capacity was placed in threshold newCap = oldThr; else { // zero initial threshold signifies using defaults // 初始化操作 newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } if (newThr == 0) { float ft = (float)newCap * loadFactor; newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE); } threshold = newThr; @SuppressWarnings({"rawtypes","unchecked"}) // 创建容量为newCap的newTab,并将oldTab中的Node迁移过来,这里需要考虑链表和tree两种情况。 Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; table = newTab; // 将原数组中的数组复制到新数组中 if (oldTab != null) { for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) // 如果e是该bucket唯一的一个元素,则直接赋值到新数组中 newTab[e.hash & (newCap - 1)] = e; else if (e instanceof TreeNode) // split方法会将树分割为lower 和upper tree两个树,如果子树的节点数小于了UNTREEIFY_THRESHOLD阈值,则将树untreeify,将节点都存放在newTab中。 // TreeNode的情况则使用TreeNode中的split方法将这个树分成两个小树 ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); else { // preserve order 保持顺序 // 否则则创建两个链表用来存放要放的数据,hash值&oldCap为0的(即oldCap的1的位置的和hash值的同样的位置都是1,同样是基于capacity是2的次方这一前提)为low链表,反之为high链表, 通过这种方式将旧的数据分到两个链表中再放到各自对应余数的位置 Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; // 按照e.hash值区分放在loTail后还是hiTail后 if ((e.hash & oldCap) == 0) { // 运算结果为0的元素,用lo记录并连接成新的链表 if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { // 运算结果不为0的数据,用li记录 if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); // 处理完之后放到新数组中 if (loTail != null) { loTail.next = null; // lo仍然放在“原处”,这个“原处”是根据新的hash值算出来的 newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; // li放在j+oldCap位置 newTab[j + oldCap] = hiHead; } } } } } return newTab; } 获取元素 get(key) 方法时获取 key 的 hash 值,计算 hash & (n-1) 得到在链表数组中的位置 first=tab[hash&(n-1)],先判断first的key是否与参数 key相等,不等就遍历后面的链表找到相同的key值返回对应的Value值即可。 public V get(Object key) { Node<K,V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } /** * Implements Map.get and related methods * @param hash hash for key * @param key the key * @return the node, or null if none */ final Node<K,V> getNode(int hash, Object key) { Node<K,V>[] tab; Node<K,V> first, e; int n; K k; if ((tab = table) != null && (n = tab.length) > 0 && (first = tab[(n - 1) & hash]) != null) { //如果是头结点,则直接返回头结点 if (first.hash == hash && // always check first node ((k = first.key) == key || (key != null && key.equals(k)))) return first; if ((e = first.next) != null) { //判断是否是红黑树结构 if (first instanceof TreeNode) //如果是红黑树,那就去红黑树中找,然后返回 return ((TreeNode<K,V>)first).getTreeNode(hash, key); do { //否则就是链表节点,遍历链表,找到该节点并返回 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) return e; } while ((e = e.next) != null); } } return null; } 红黑树结构 static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> { TreeNode<K,V> parent; // red-black tree links 父节点 TreeNode<K,V> left; // 左子树 TreeNode<K,V> right; // 右子树 TreeNode<K,V> prev; // needed to unlink next upon deletion boolean red; // 颜色属性 TreeNode(int hash, K key, V val, Node<K,V> next) { super(hash, key, val, next); } } 树形化操作 根据哈希表中元素个数确定是扩容还是树形化,如果是树形化遍历桶中的元素,创建相同个数的树形节点,复制内容,建立起联系,然后让桶第一个元素指向新建的树头结点,替换桶的链表内容为树形内容// MIN_TREEIFY_CAPACITY 的值为64,若当前table的length不够,则resize() // 将桶内所有的 链表节点 替换成 红黑树节点 final void treeifyBin(Node<K,V>[] tab, int hash) { int n, index; Node<K,V> e; // 如果当前哈希表为空,或者哈希表中元素的个数小于树形化阈值(默认为 64),就去新建(扩容) if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY) resize(); // 如果哈希表中的元素个数超过了树形化阈值,则进行树形化 // e 是哈希表中指定位置桶里的链表节点,从第一个开始 else if ((e = tab[index = (n - 1) & hash]) != null) { // 红黑树的头、尾节点 TreeNode<K,V> hd = null, tl = null; do { // 新建一个树形节点,内容和当前链表节点 e 一致 TreeNode<K,V> p = replacementTreeNode(e, null); // 确定树头节点 if (tl == null) hd = p; else { p.prev = tl; tl.next = p; } tl = p; } while ((e = e.next) != null); // 让桶的第一个元素指向新建的红黑树头结点,以后这个桶里的元素就是红黑树而不是链表了 if ((tab[index] = hd) != null) hd.treeify(tab); } } TreeNode<K,V> replacementTreeNode(Node<K,V> p, Node<K,V> next){ return new TreeNode<>(p.hash, p.key, p.value, next); } 删除元素 下面再来看看删除方法remove。 public V remove(Object key) { //临时变量 Node<K,V> e; /**调用removeNode(hash(key), key, null, false, true)进行删除,第三个value为null,表示,把key的节点直接都删除了,不需要用到值,如果设为值,则还需要去进行查找操作**/ return (e = removeNode(hash(key), key, null, false, true)) == null ? null : e.value; } /**第一参数为哈希值,第二个为key,第三个value,第四个为是为true的话,则表示删除它key对应的value,不删除key,第四个如果为false,则表示删除后,不移动节点**/ final Node<K,V> removeNode(int hash, Object key, Object value, boolean matchValue, boolean movable) { //tab 哈希数组,p 数组下标的节点,n 长度,index 当前数组下标 Node<K,V>[] tab; Node<K,V> p; int n, index; //哈希数组不为null,且长度大于0,然后获得到要删除key的节点所在是数组下标位置 if ((tab = table) != null && (n = tab.length) > 0 && (p = tab[index = (n - 1) & hash]) != null) { //nodee 存储要删除的节点,e 临时变量,k 当前节点的key,v 当前节点的value Node<K,V> node = null, e; K k; V v; //如果数组下标的节点正好是要删除的节点,把值赋给临时变量node if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) node = p; //也就是要删除的节点,在链表或者红黑树上,先判断是否为红黑树的节点 else if ((e = p.next) != null) { if (p instanceof TreeNode) //遍历红黑树,找到该节点并返回 node = ((TreeNode<K,V>)p).getTreeNode(hash, key); else { //表示为链表节点,一样的遍历找到该节点 do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) { node = e; break; } /**注意,如果进入了链表中的遍历,那么此处的p不再是数组下标的节点,而是要删除结点的上一个结点**/ p = e; } while ((e = e.next) != null); } } //找到要删除的节点后,判断!matchValue,我们正常的remove删除,!matchValue都为true if (node != null && (!matchValue || (v = node.value) == value || (value != null && value.equals(v)))) { //如果删除的节点是红黑树结构,则去红黑树中删除 if (node instanceof TreeNode) ((TreeNode<K,V>)node).removeTreeNode(this, tab, movable); //如果是链表结构,且删除的节点为数组下标节点,也就是头结点,直接让下一个作为头 else if (node == p) tab[index] = node.next; else /**为链表结构,删除的节点在链表中,把要删除的下一个结点设为上一个结点的下一个节点**/ p.next = node.next; //修改计数器 ++modCount; //长度减一 --size; /**此方法在hashMap中是为了让子类去实现,主要是对删除结点后的链表关系进行处理**/ afterNodeRemoval(node); //返回删除的节点 return node; } } //返回null则表示没有该节点,删除失败 return null; } 删除还有clear方法,把所有的数组下标元素都置位null。 size()方法 HashMap 的大小很简单,不是实时计算的,而是每次新增加 Entry 的时候,size 就递增。删除的时候就递减。空间换时间的做法。因为它不是线程安全的。完全可以这么做,效率高。

优秀的个人博客,低调大师

Knife4jAggregationDesktop 独立渲染 OpenAPI 规范文档-v1.0版本发布

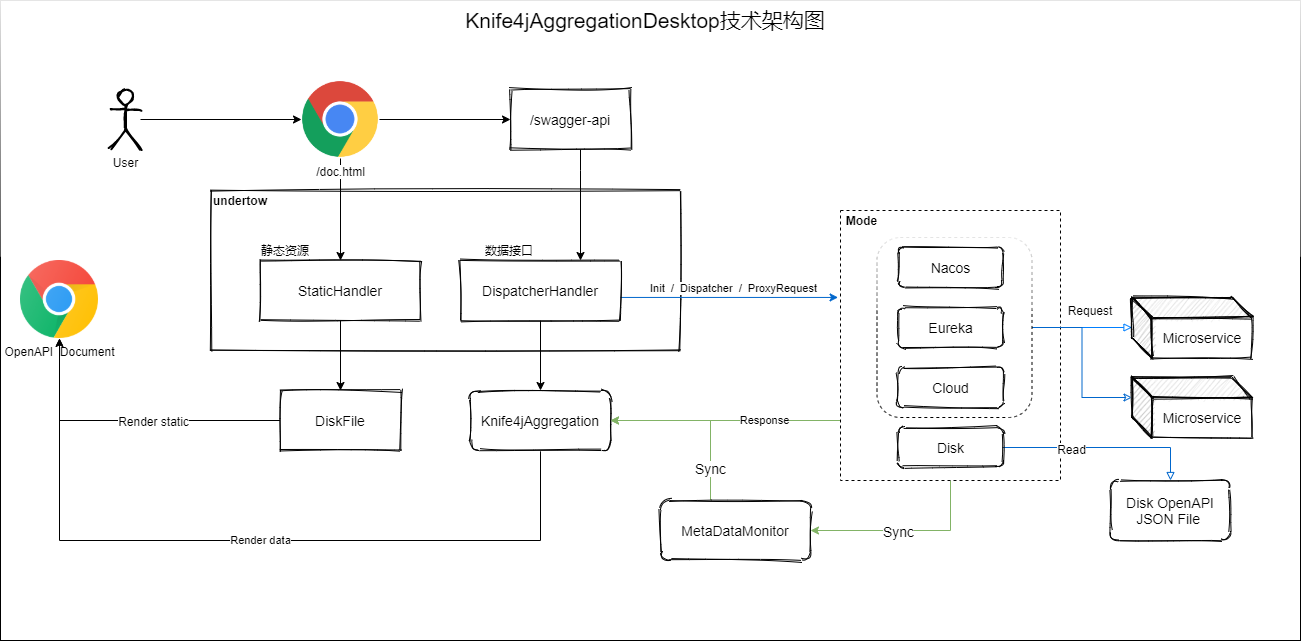
Knife4jAggregationDesktop是一款基于聚合组件Knife4jAggregation特性的独立部署的聚合OpenAPI文档软件,脱离Spring、Spring Boot技术架构体系,开发者下载后独立部署启动。 主要功能作用: 独立部署(依赖Java JDK8环境) 专注聚合OpenAPI文档,在线预览和调试均可,拥有Knife4j的全部特性 继承Knife4jAggregation的全部特性,支持Disk、Cloud、Eureka、Nacos四种模式的OpenAPI文档聚合显示 基于动态文件配置方式,无需重启服务,简单方便 支持多个项目动态配置 可以为单个服务配置Basic权限,保证OpenAPI文档的安全 OpenAPI接口文档与应用彻底分离,可以作为OpenAPI文档中心的角色进行使用 脱离Spring、Spring Boot体系,应用占用资源小 为别的语言使用Knife4j来展示OpenAPI规范的文档提供方便 技术架构图如下: 文档介绍:https://doc.xiaominfo.com/knife4j/resources/desktop-introduction.html 安装说明:https://doc.xiaominfo.com/knife4j/resources/desktop-install.html 测试场景:https://doc.xiaominfo.com/knife4j/resources/desktop-test.html

优秀的个人博客,低调大师

Golang 实现的命令行解析器 clop v0.0.4版本发布

项目地址 https://gitee.com/guonaihong/clop https://github.com/guonaihong/clop changlog 可以控制选项只能被设置一次 package main import ( "github.com/guonaihong/clop" ) type Once struct { Debug bool `clop:"-d; --debug; once" usage:"debug mode"` } func main() { o := Once{} clop.Bind(&o) } /* ./once -debug -debug error: The argument '-d' was provided more than once, but cannot be used multiple times For more information try --help */ #35-h; --help选项可以被重载

优秀的个人博客,低调大师

CAT 密码算法调用工具包首个版本(V0.0.1版本)发布

CAT,全称Cryptographic Algorithm Tool,是一款小巧的Java加密与解密算法调用工具包,根据之前一网友建议,当前首个版本集成了国家密码局公布的国密sm3和国密sm4算法的加解密调用。 CAT 的V0.0.1版本主要整合了以下加密算法的调用: 1.AES 2.MD5 3.RSA 4.国密SM3 5.国密SM4 其他算法敬请期待后续版本更新。 其中,国密SM3和国密SM4的详细算法及原理可参考国家密码局发布的相关文档和说明。 CAT下载地址:https://gitee.com/bat/cat PS:哪位大神有国密SM3的js版本,请贡献一下,不胜感激!

优秀的个人博客,低调大师

让企业零成本拥有自己独立的企业网站不再是问题

一、互联网助力企业行业发展背景 互联网从发展至今已经历了20年之久,而现如今社会发展那么快,技术更新迭代如此频繁。互联网形态也从原来的“PC端”转向“移动端”再到“万物互联时代”,而内容形态从原来的个人站长、各大自媒体平台上、独立APP、微信公众号、微信小程序、百度小程序、支付宝小程序、支付宝生活号等服务雨后春笋的袭来,企业可以借助大平台大流量把内容展现出去;现在很多企业已经都入驻了微信公众号、微信小程序、百度小程序、支付宝小程序、支付宝生活号等服务平台,而你是否考虑也入驻呢?如果现实的你还没入驻,那赶紧先搞一个企业网站吧! 现如今社会一个企业或一个自媒体人,如果说没有自己的网站都不好意思出去递名片,有没有觉得瞬间场合比较尴尬呢?没有什么拿得出手的名片和企业网站对吧,首先我们来谈谈建一个企业网站的作用是什么? 我认为有以下几点: 其一、对企业的全方位介绍: 可以把自己企业的简介、企业的动态、联系方式、地址、产品介绍等信息已另类的方式展示给自己的客户,而客户可以很轻松的通过访问自己企业网站的网址了解贵公司的最新动态、联系方式等信息;同样也可以和自己的微信号名片上增加自己的企业网址、产品包装上增加自己的网址、公众号增加企业的宣传网址;多渠道展示自己企业的实力,从而可以扩大市场规模;把企业做大做强; 其二、对企业业务的开展更方便: 可以将自己的产品放在自己企业网站上,供客户选择,下单;收集客户资料从此全自动进行;并不需要耗费太多人力去维护客户资源; 其三、对企业名片的丰富性扩展: 对企业名称的丰富性是至关重要的,从此你可以很自信的把自己的网址印刷在自己的微信名片、或纸质名片上;很自信的递出每一张名片给自己的客户;在自己的商品包装上印刷网址或将网址换成二维码帖在包装上,让自己的客户很便捷的就知道自己公司的动态、新品情况; 其四、独立的网站,不受制于他人服务: 其实现在市面上也有很多托管型的自助建站服务(如米拓、凡科等),但这样的服务有很多功能的限制;如三方服务,觉得你企业的信息不符合他们的规范,说给你关掉就关掉了。当然你有独立的网站,就可以不受三方服务的威胁,想怎么做就怎么做,当然你还是要符合国家的法律法规哈! 以上大概是我想描述的几大企业自主建立企业网站的好处吧,更多好处自己去体会吧! 二、提供自助建站服务 这里向大家隆重推荐互联网巨头阿里云推出来的自主建站服务,阿里云自助建站有如下几个好处: 1、阿里云专家为您定制网站双12钜惠 ,无需技术,零基础也可建网站; 2、1对1网站策划及设计,个性化高端定制解决方案; 3、可视化管理后台便捷维护,集成41种控件随意搭配,千套模板,随意挑选,PC、移动端全支持; 3、标配阿里云服务器,全面应用阿里云计算,开箱即用; 4、不满意全额退款 三、我们还能提供的服务 1、APP、小程序、网站建设前咨询:提供建站、APP、小程序、物联网产品等开发前免费技术咨询服务及建议; 2、域名提供:免费为企业挑选心意的域名,当然你也可以自己提供; 3、域名代备案:免费为企业提供快捷的备案通道; 4、网站安全运维:免费7*24小时安全呵护您的网站,监控和漏洞修复等服务; 5、提供服务器:提供建站、APP、小程序、微信端的服务器; 6、提供网站SEO优化及建议: 7、活动运营策划 8、大型系统调优 9、软著、企业资质等代办 更多服务欢迎来电咨询: Tel:13881768349 夏先生 QQ:296299741 微信:eyaboo 网址:www.52it.club

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册