首页 文章 精选 留言 我的

精选列表

搜索[流程编排],共10000篇文章
优秀的个人博客,低调大师

云存储网关管理缓存的操作流程

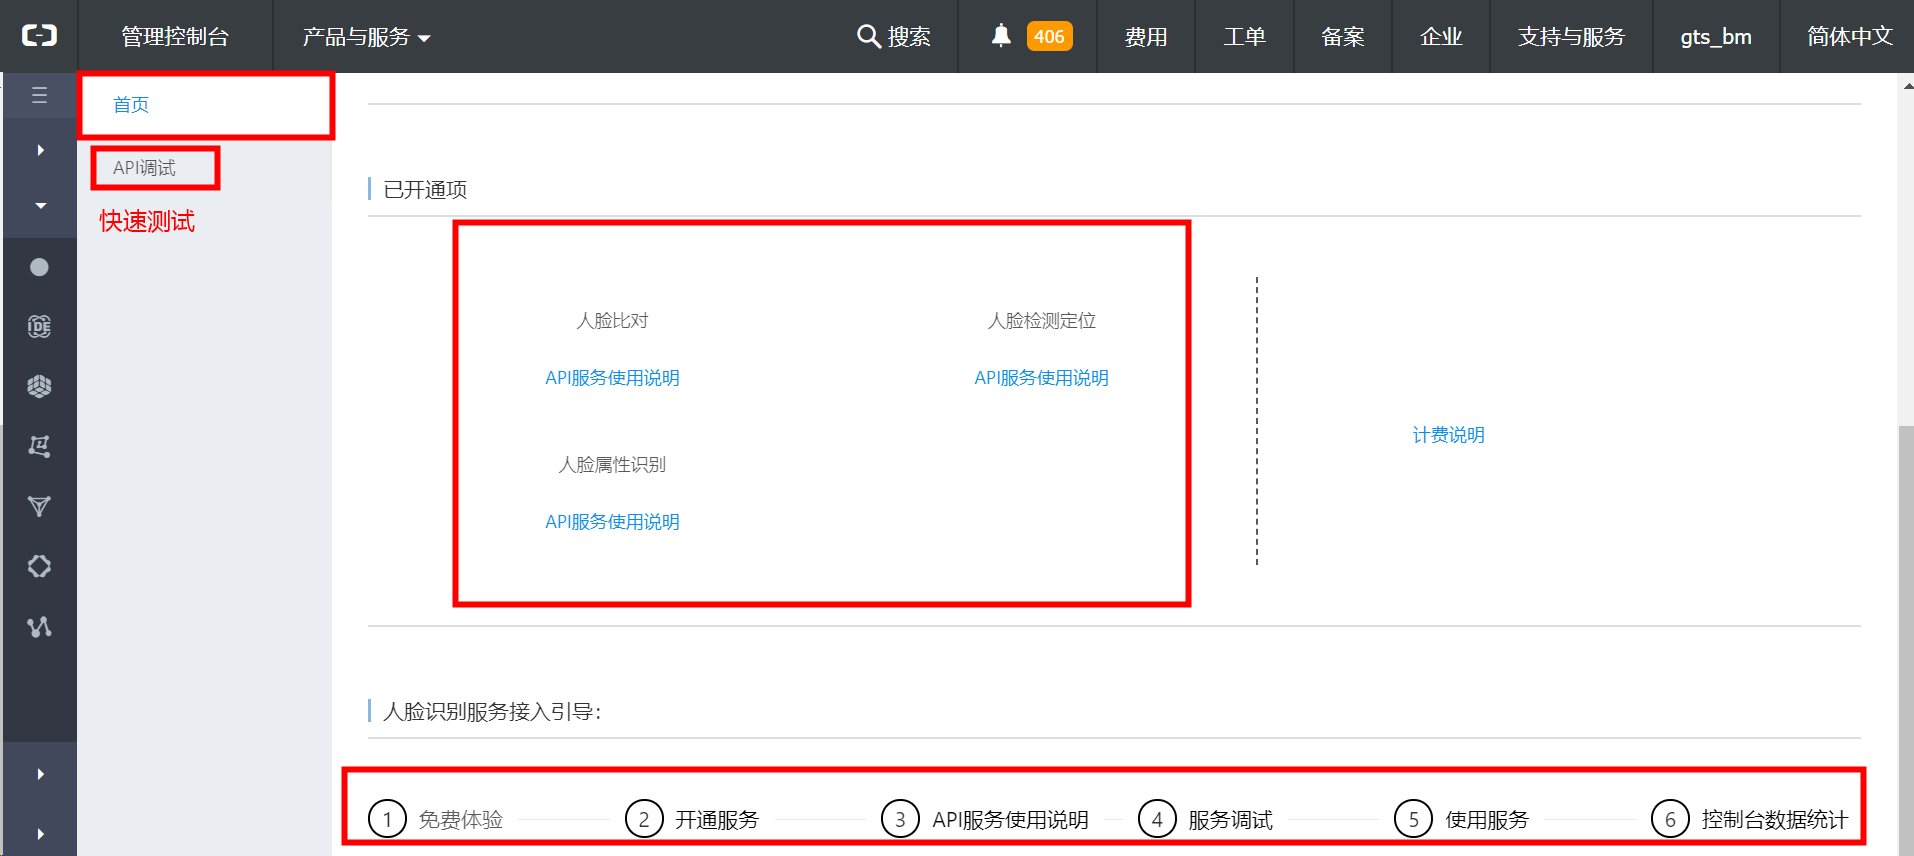
云栖号快速入门:【点击查看更多云产品快速入门】不知道怎么入门?这里分分钟解决新手入门等基础问题,可快速完成产品配置操作! 云存储网关为每个共享路径提供一个缓存盘,本文介绍如何通过本地文件网关控制台管理缓存,包括添加缓存、删除缓存,缓存盘测速等操作。 前提条件 1.已部署本地文件网关客户端,详情请参见部署本地网关控制台。2.已添加磁盘,详情请参见添加磁盘。 背景信息 本地文件网关的每个共享目录都对应唯一一个缓存盘,创建多个共享目录则需要创建多个缓存盘。您可以将共享目录下的数据通过缓存盘传至阿里云OSS,也可以通过缓存盘将阿里云OSS数据同步到本地。 添加缓存 1.在浏览器中,输入访问本地文件网关控制台。2.输入用户名和密码,单击确认。3.选择缓存设置页面,单击创建。4.在创建缓存对话框中,完成如下配置。 硬盘:单击选择,选择可用的硬盘。在部署平台添加磁盘后,此处才有可用的硬盘,详情请参见添加磁盘。 文件系统:可选。勾选此选项,可重用该缓存盘中的数据。如果您误删共享后,可重建共享并使用缓存盘的数据重用功能进行数据恢复。5.单击确认,完成添加。 相关操作 在缓存设置页面,您还可以进行如下配置。 后续步骤 创建NFS共享 创建SMB共享 本文来自 阿里云文档中心 生活物联网平台 概述 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK

优秀的个人博客,低调大师

OkHttp3源码详解(二) 整体流程

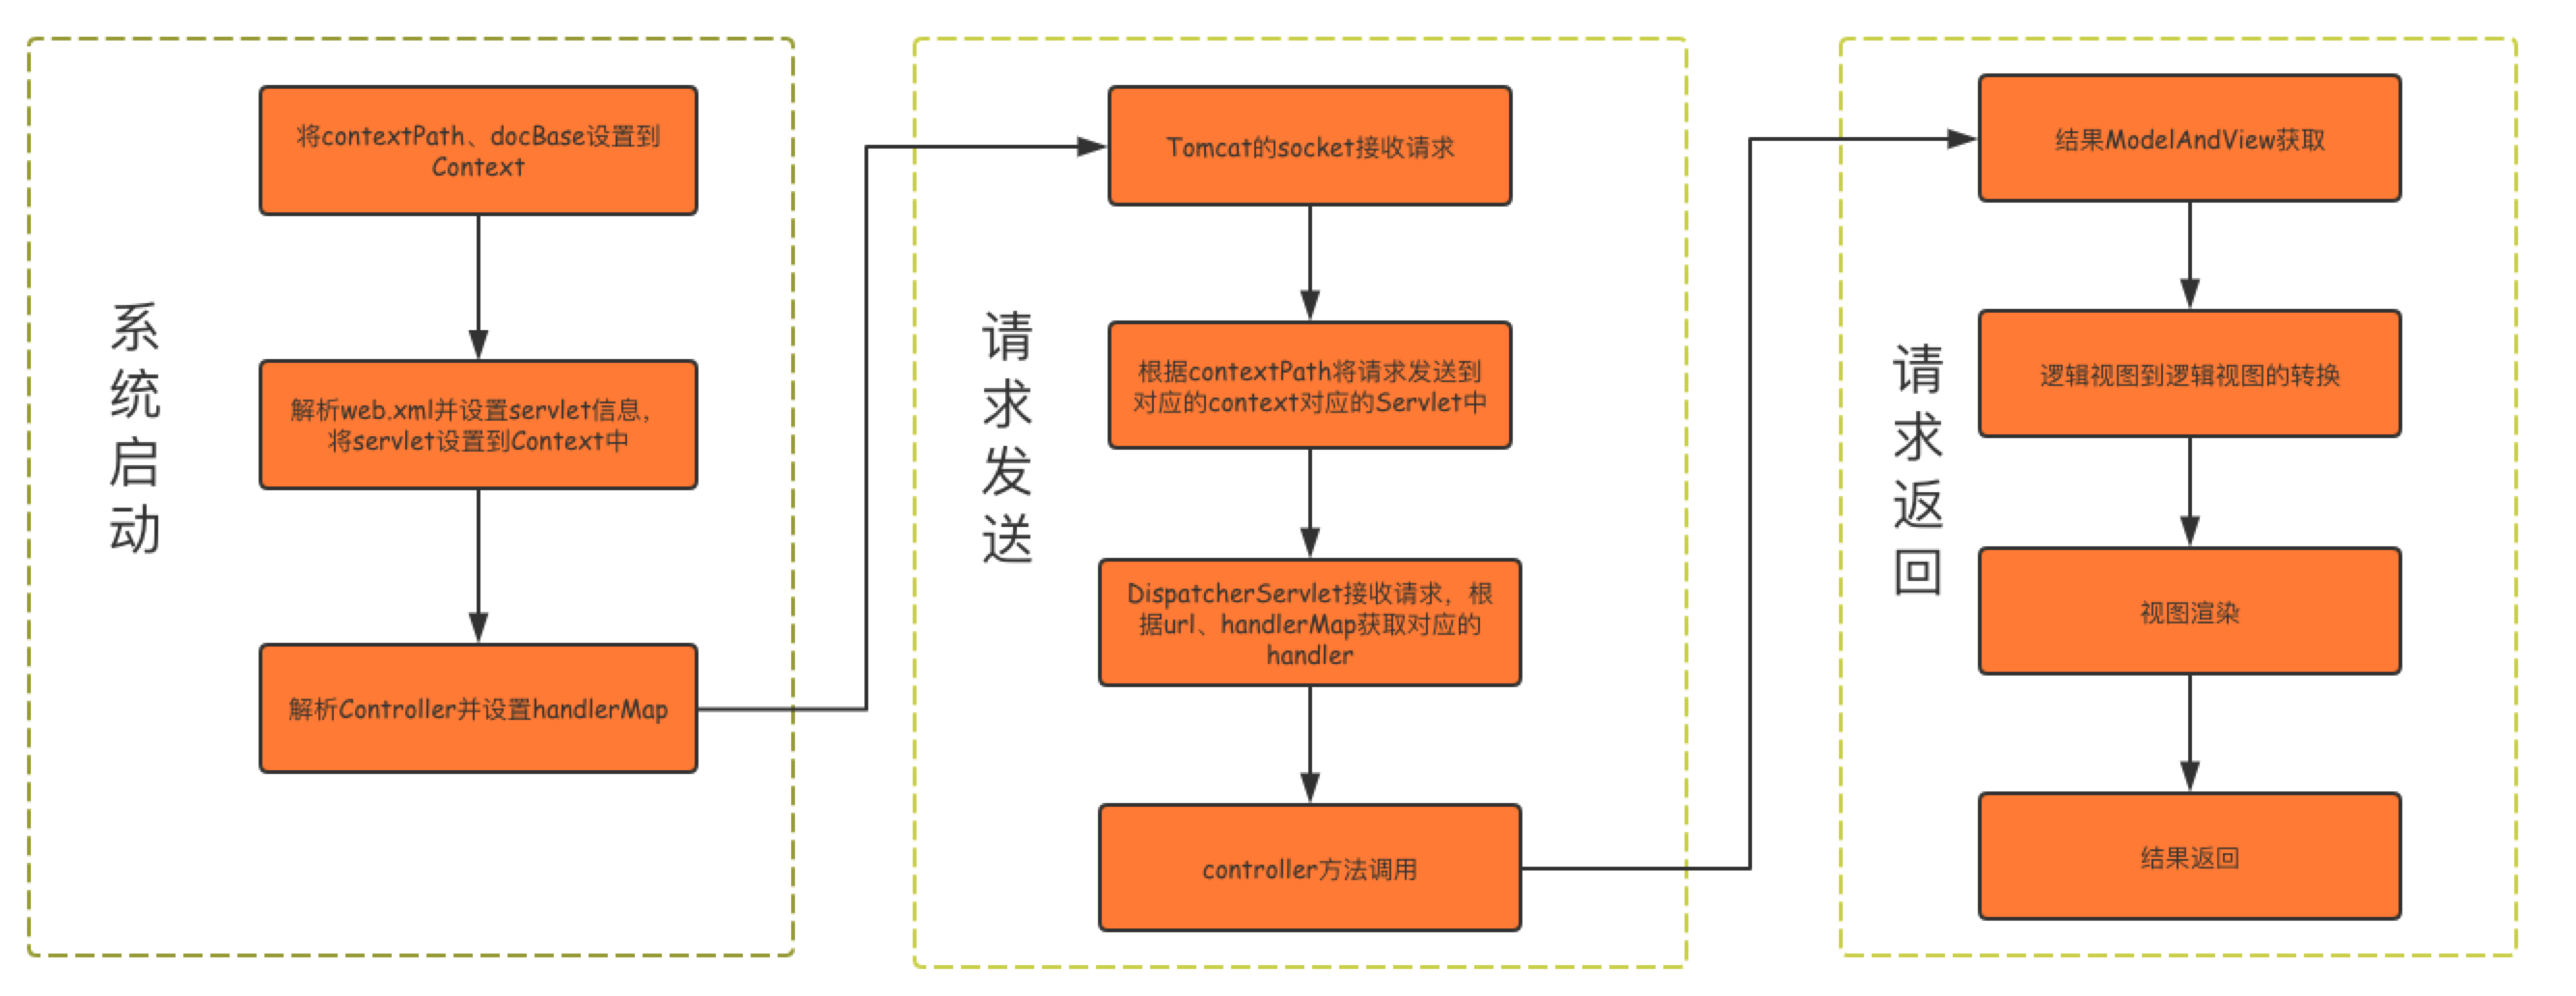
1.简单使用 同步: @Override public Response execute() throws IOException { synchronized (this) { if (executed) throw new IllegalStateException("Already Executed"); executed = true; } try { client.dispatcher().executed(this); Response result = getResponseWithInterceptorChain(false); if (result == null) throw new IOException("Canceled"); return result; } finally { client.dispatcher().finished(this); } } 首先加锁置标志位,接着使用分配器的executed方法将call加入到同步队列中,然后调用getResponseWithInterceptorChain方法(稍后分析)执行http请求,最后调用finishied方法将call从同步队列中删除 异步: 1. void enqueue(Callback responseCallback, boolean forWebSocket) { 2. synchronized (this) { 3. if (executed) throw new IllegalStateException("Already Executed"); 4. executed = true; 5. } 6. client.dispatcher().enqueue(new AsyncCall(responseCallback, forWebSocket)); 7. } 同样先置标志位,然后将封装的一个执行体放到异步执行队列中。这里面引入了一个新的类AsyncCall,这个类继承于NamedRunnable,实现了Runnable接口。NamedRunnable可以给当前的线程设置名字,并且用模板方法将线程的执行体放到了execute方法中 2.总体架构 上图是OkHttp的总体架构,大致可以分为以下几层: Interface——接口层:接受网络访问请求 Protocol——协议层:处理协议逻辑 Connection——连接层:管理网络连接,发送新的请求,接收服务器访问 Cache——缓存层:管理本地缓存 I/O——I/O层:实际数据读写实现 Inteceptor——拦截器层:拦截网络访问,插入拦截逻辑 ①Interface——接口层: 接口层接收用户的网络访问请求(同步请求/异步请求),发起实际的网络访问。OkHttpClient是OkHttp框架的客户端,更确切的说是一个用户面板。用户使用OkHttp进行各种设置,发起各种网络请求都是通过OkHttpClient完成的。每个OkHttpClient内部都维护了属于自己的任务队列,连接池,Cache,拦截器等,所以在使用OkHttp作为网络框架时应该全局共享一个OkHttpClient实例。 Call描述一个实际的访问请求,用户的每一个网络请求都是一个Call实例。Call本身只是一个接口,定义了Call的接口方法,实际执行过程中,OkHttp会为每一个请求创建一个RealCall,每一个RealCall内部有一个AsyncCall,AsyncCall继承的NamedRunnable继承自Runnable接口。 所以每一个Call就是一个线程,而执行Call的过程就是执行其execute方法的过程。 Dispatcher是OkHttp的任务队列,其内部维护了一个线程池,当有接收到一个Call时,Dispatcher负责在线程池中找到空闲的线程并执行其execute方法。这部分将会单独拿一篇博客进行介绍,详细内容可参考本系列接下来的文章。 ②.Protocol——协议层:处理协议逻辑 Protocol层负责处理协议逻辑,OkHttp支持Http1/Http2/WebSocket协议,并在3.7版本中放弃了对Spdy协议,鼓励开发者使用Http/2。 ③.Connection——连接层:管理网络连接,发送新的请求,接收服务器访问 连接层顾名思义就是负责网络连接。在连接层中有一个连接池,统一管理所有的Socket连接,当用户新发起一个网络请求时,OkHttp会首先从连接池中查找是否有符合要求的连接,如果有则直接通过该连接发送网络请求;否则新创建一个网络连接。 RealConnection描述一个物理Socket连接,连接池中维护多个RealConnection实例。由于Http/2支持多路复用,一个RealConnection可以支持多个网络访问请求,所以OkHttp又引入了StreamAllocation来描述一个实际的网络请求开销(从逻辑上一个Stream对应一个Call,但在实际网络请求过程中一个Call常常涉及到多次请求。如重定向,Authenticate等场景。所以准确地说,一个Stream对应一次请求,而一个Call对应一组有逻辑关联的Stream),一个RealConnection对应一个或多个StreamAllocation,所以StreamAllocation可以看做是RealConenction的计数器,当RealConnection的引用计数变为0,且长时间没有被其他请求重新占用就将被释放。 连接层是OkHttp的核心部分,这部分当然也会单独拿一篇博客详细讲解,详细内容可参考本专题相关文章。 ④.Cache——缓存层:管理本地缓存 Cache层负责维护请求缓存,当用户的网络请求在本地已有符合要求的缓存时,OkHttp会直接从缓存中返回结果,从而节省网络开销。这部分内容也会单独拿一篇博客进行介绍,详细内容可参考本专题相关文章。 ⑤.I/O——I/O层:实际数据读写实现 I/O层负责实际的数据读写。OkHttp的另一大有点就是其高效的I/O操作,这归因于其高效的I/O库okio 这部分内容笔者也打算另开一个专题进行介绍。详细内容可以参考本博客相关内容。 ⑥Inteceptor——拦截器层:拦截网络访问,插入拦截逻辑 拦截器层提供了一个类AOP接口,方便用户可以切入到各个层面对网络访问进行拦截并执行相关逻辑。原文链接:https://www.bbsmax.com/A/kPzOg9lQzx/

优秀的个人博客,低调大师

阿里云APP备案操作相关的流程

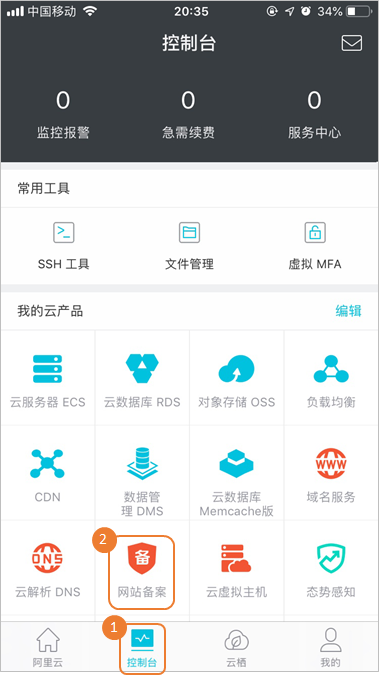
阿里云APP端申请备案是现在比较流行的备案方法,方便快捷,适合新手使用。 阿里云2000券免费领取(阿里云券的作用:购买阿里云产品,最后支付结算的时候,阿里云券可抵扣一部分费用。 要注意的是,目前支持首次备案和新增网站(原备案不在阿里云)两种备案场景。暂时不支持新增网站(原备案在阿里云)、接入备案、变更备案等其他备案场景,其他的备案场景都可在PC端操作。 使用阿里云APP端申请备案时,备案申请操作步骤如下: 1、登录阿里云APP,进入APP备案操作入口。 如果在APP端备案时,系统提示前往PC端进行操作,那么你当前的场景就只能在PC端操作了。 2、填写信息及备案接入产品验证备案类型 填写主办单位信息和网站等信息,根据备案类型上传主办单位的证件材料,并进行真实性核验。 3、选择买好的服务器,进行产品验证。 阿里云2000券免费领取(阿里云券的作用:购买阿里云产品,最后支付结算的时候,阿里云券可抵扣一部分费用。 说明:如果无法选择服务器实例,可能是因为无可用备案服务号,建议更换有可用备案服务号的服务器。更多可能无法选择实例的可能原因及 系统会根据填写信息自动判定要办理的备案类型。 4、填写主体信息和网站信息 填写网站信息以及办理备案的个人或者单位的真实信息。上传主体负责人和网站负责人的证件,并进行网站负责人的真实性核验。 5、上传资料 上传证件照片或证件彩色扫描件。 6、信息核验 在提交备案申请订单前,请您在此步骤中仔细确认您的主体、网站、接入等备案信息是否正确,确认无误后提交备案订单。 说明:如果使用PC端进行备案申请,在移动端完成资料上传和真实性核验后,您可在移动端继续信息核验。如果您的登录账号无法登录阿里云APP,就要去PC端继续操作信息核验。 7、备案初审 提交备案申请后,阿里云备案审核专员会对备案信息初步审核。 8、管局审核初审完成后,阿里云备案审核专员会将备案申请转交至对应管局处做最终的管局审核。管局审核通过后您的备案即已完成,审核结果会发送至短信、邮箱。 9、不管阿里审核,还是管局审核期间,在工作时间内都要保持手机有人接听状态,老魏就是因为审核专员多次打电话无人接听,延误了备案时间。 阿里云2000券免费领取(阿里云券的作用:购买阿里云产品,最后支付结算的时候,阿里云券可抵扣一部分费用。

优秀的个人博客,低调大师

阿里云怎么用APP备案操作流程

阿里云APP端申请备案是现在比较流行的备案方法,方便快捷,适合新手使用。 要注意的是,目前支持首次备案和新增网站(原备案不在阿里云)两种备案场景。暂时不支持新增网站(原备案在阿里云)、接入备案、变更备案等其他备案场景,其他的备案场景都可在PC端操作。 使用阿里云APP端申请备案时,备案申请操作步骤如下: 1、登录阿里云APP,进入APP备案操作入口。 如果在APP端备案时,系统提示前往PC端进行操作,那么你当前的场景就只能在PC端操作了。 2、填写信息及备案接入产品验证备案类型 填写主办单位信息和网站等信息,根据备案类型上传主办单位的证件材料,并进行真实性核验。 3、选择买好的服务器,进行产品验证。 说明:如果无法选择服务器实例,可能是因为无可用备案服务号,建议更换有可用备案服务号的服务器。更多可能无法选择实例的可能原因及 系统会根据填写信息自动判定要办理的备案类型。 4、填写主体信息和网站信息 填写网站信息以及办理备案的个人或者单位的真实信息。上传主体负责人和网站负责人的证件,并进行网站负责人的真实性核验。 5、上传资料 上传证件照片或证件彩色扫描件。 6、信息核验 在提交备案申请订单前,请您在此步骤中仔细确认您的主体、网站、接入等备案信息是否正确,确认无误后提交备案订单。 说明:如果使用PC端进行备案申请,在移动端完成资料上传和真实性核验后,您可在移动端继续信息核验。如果您的登录账号无法登录阿里云APP,就要去PC端继续操作信息核验。 7、备案初审 提交备案申请后,阿里云备案审核专员会对备案信息初步审核。 8、管局审核初审完成后,阿里云备案审核专员会将备案申请转交至对应管局处做最终的管局审核。管局审核通过后您的备案即已完成,审核结果会发送至短信、邮箱。 9、不管阿里审核,还是管局审核期间,在工作时间内都要保持手机有人接听状态,老魏就是因为审核专员多次打电话无人接听,延误了备案时间。

优秀的个人博客,低调大师

HanLP代码与词典分离方案与流程

之前在spark环境中一直用的是portable版本,词条数量不是很够,且有心想把jieba,swcs词典加进来, 其他像ik,ansi-seg等分词词典由于没有词性并没有加进来. 本次修改主要是采用jar包方包将词典目录 data与hanlp.properties合成一个data.jar文件. 1. pom.xml 过滤资源文件的配置 <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-jar-plugin</artifactId> <version>${maven-jar-plugin.version}</version> <configuration> <excludes> <exclude>**/*.properties</exclude> </excludes> </configuration> </plugin> 这里把properties文件从jar包文件中去掉,因而结果文件是没有properties文件的. 可根据需要来确定是否把properties加入jar包中.由于我打算把hanlp.properties与词典目录写在一起 这里是要过滤掉hanlp.properties文件 2. 修改hanlp.properties文件 root= #将根目录置为空,或者注释掉root CustomDictionaryPath=data/dictionary/custom/CustomDictionary.txt; scws.txt; jieba.txt; 现代汉语补充词库.txt; 全国地名大全.txt ns; 人名词典.txt; 机构名词典.txt; 上海地名.txt ns;data/dictionary/person/nrf.txt nrf; #增加更多的配置文件,这里增加了结巴分词,scws分词 #IOAdapter=com.hankcs.hanlp.corpus.io.FileIOAdapter IOAdapter=com.hankcs.hanlp.corpus.io.JarIOAdapter #修改IOAdapter,以便使用jar包形式加载词典 3. 修改HanLP.java if ( root.length() != 0 && !root.endsWith("/")) root += "/"; 当root的长度为0时,不用在root字符串后面添加'/' 4. 增加处理词典jar包的代码文件: JarIOAdapter.java package com.hankcs.hanlp.corpus.io; import java.io.*; /** * 基于普通文件系统的IO适配器 * * @author hankcs */ public class JarIOAdapter implements IIOAdapter { @Override public InputStream open(String path) throws FileNotFoundException { /* 采用第一行的方式加载资料会在分布式环境报错 改用第二行的方式 */ //return ClassLoader.getSystemClassLoader().getResourceAsStream(path); return JarIOAdapter.class.getClassLoader().getResourceAsStream(path); } @Override public OutputStream create(String path) throws FileNotFoundException { return new FileOutputStream(path); } } 在跑DemoStopWord时,发现 java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoStopWord 报错,原因是接口不统一导致. 修改 DMAG.java如下: public MDAG(File dataFile) throws IOException { BufferedReader dataFileBufferedReader = new BufferedReader(new InputStreamReader(IOAdapter == null ? new FileInputStream(dataFile) : //IOAdapter.open(dataFile.getAbsolutePath()) IOAdapter.open(dataFile.getPath()) , "UTF-8")); 即可. 5. 如何将词典与配置文件打成一个jar包 最好是把txt格式的文件做成bin或dat格式的文件,然后做成jar包,否则打包运行后无法再写成bin或dat格式文件. 简单的办法是跑一下示例,即可生成相应的bin或dat格式文件. java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoAtFirstSight java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoChineseNameRecognition java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoJapaneseNameRecognition java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoPinyin java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoPlaceRecognition java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoOrganizationRecognition java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoTokenizerConfig #命名实体识别,包括上面的人名,地名等 java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoTraditionalChinese2SimplifiedChinese java -cp .:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoStopWord 或者用以下shell脚本完成 :>a;while read cl; do echo $cl; echo "=========="$cl"=======" >>a;java -cp .:test.jar:hanlp-1.3.2.jar $cl 1>> a 2>&1;done < <(jar tvf test.jar | awk '$(NF)~"Demo"{print $(NF)}' | sed 's/.class$//;s/\//./g') 我们把data目录与hanlp.properties文件放在一个目录,比如xxx目录 cd xxx jar cvf data.jar . 即可生成data.jar包 6. 如何运行 [dxp@Flyme-SearchTag-32-220 makeNewDict]$ ls data.jar hanlp-1.3.2.jar README.md test test.jar [dxp@Flyme-SearchTag-32-220 makeNewDict]$ java -cp data.jar:hanlp-1.3.2.jar:test.jar com.hankcs.demo.DemoAtFirstSight 7. 在spark中应用 IDE如(intellij idea)中maven项目 引入以下依赖: <dependency> <groupId>com.hankcs</groupId> <artifactId>hanlp</artifactId> <version>1.3.2</version> <scope>system</scope> <systemPath>${LocalPath}/hanlp-1.3.2.jar</systemPath> </dependency> spark-submit提交任务时增加 --jar hanlp-1.3.2.jar,data.jar 转载自cicido的个人空间

优秀的个人博客,低调大师

Hadoop和Spark集群搭建的大致流程

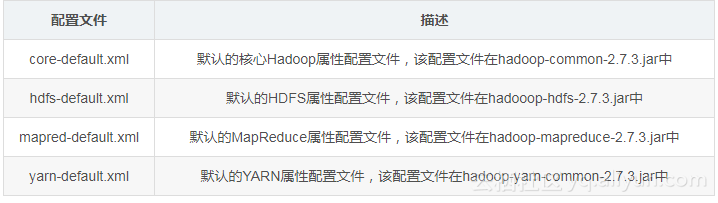
【Hadoop】 1.首先,准备好Hadoop安装包和JDK的安装与配置2.建立各个机器之间的ssh信任关系,即互信3.修改hadoop配置文件【core、hdfs、yarn、mapred】默认配置文件:core-default.xml、hdfs-default.xml、mapred-default.xml、yarn-default.xml特定配置文件:core-site.xml、hdfs-site.xml、mapred-site.xml、yarn-site.xml特定配置文件会覆盖默认的配置项【core-site.xml】是整个Hadoop通用的配置,集群的每个主机都存在。分布式文件系统名字、临时目录以及其他与网络配置相关的参数【hdfs-site.xml】配置HDFS系统的运行时属性和各个数据节点上文件的物理存储相关的属性主-辅节点存放元数据文件表(fsimage文件)的目录主-辅节点存储元数据事务处理文件(edits文件)的目录默认数据块大小数据块备份数量名称节点和数据节点通信的服务器线程数,默认为10【mapred-site.xml】保护了与CPU、内存、磁盘I/O和网络相关的参数任务是本地作业执行器还是提交到yarn集群运行Map或Reduce任务的JVM堆大小运行Map和Reduce任务的容器的内存大小存储中间数据文件的本地目录作业跟踪器(YARN)的服务器进程数量任务重试的最大次数【yarn-site.xml】配置由YARN框架提供的通用服务守护进程的属性,比如资源管理器和节点管理器运行资源管理器的主机名以及端口号启动容器的最大最小内存量和虚拟CPU内核数 【Spark】 在有JDK和Hadoop的基础上,安装Scala修改配置文件【spark属性、环境变量、日志配置】属性可以直接在sparkconf上配置给sparkcontextspark shell和spark-submit工具支持两种方式动态加载配置,第一种是命令行选项,第二种运行./bin/spark-submit实现当然spark-submit也会在conf/spark-defaults.conf中读取配置选项driver程序运行时需要的cpu内核数和内存数每个executor进程使用的内存数

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册