首页 文章 精选 留言 我的

精选列表

搜索[氛围编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程的艺术(五)——中断

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612424 什么是中断? 在Java中没有办法立即停止一条线程,然而停止线程却显得尤为重要,如取消一个耗时操作。因此,Java提供了一种用于停止线程的机制——中断。 中断只是一种协作机制,Java没有给中断增加任何语法,中断的过程完全需要程序员自己实现。若要中断一个线程,你需要手动调用该线程的interrupted方法,该方法也仅仅是将线程对象的中断标识设成true;接着你需要自己写代码不断地检测当前线程的标识位;如果为true,表示别的线程要求这条线程中断,此时究竟该做什么需要你自己写代码实现。 每个线程对象中都有一个标识,用于表示线程是否被中断;该标识位为true表示中断,为false表示未中断; 通过调用线程对象的interrupt方法将该线程的标识位设为true;可以在别的线程中调用,也可以在自己的线程中调用。 中断的相关方法 public void interrupt()将调用者线程的中断状态设为true。 public boolean isInterrupted()判断调用者线程的中断状态。 public static boolean interrupted只能通过Thread.interrupted()调用。它会做两步操作: 返回当前线程的中断状态; 将当前线程的中断状态设为false; 暂停、继续、停止线程(已过时) 以下三个方法都是通过线程对象去调用。 suspend()暂停调用者线程,只释放CPU执行权,不释放锁。由于在不释放资源的情况下进入睡眠状态,容易产生死锁。因此已过时! resume()恢复调用者线程,让他处于就绪状态。 stop()调用stop后,并不会保证资源被正确地释放,它会使程序处于不正确的状态下。 PS:stop和interrupt的区别? 中断的使用 要使用中断,首先需要在可能会发生中断的线程中不断监听中断状态,一旦发生中断,就执行相应的中断处理代码。当需要中断线程时,调用该线程对象的interrupt函数即可。 设置中断监听 Thread t1 = new Thread( new Runnable(){ public void run(){ // 若未发生中断,就正常执行任务 while(!Thread.currentThread.isInterrupted()){ // 正常任务代码…… } // 中断的处理代码…… doSomething(); } } ).start(); 1 2 3 4 5 6 7 8 9 10 11 正常的任务代码被封装在while循环中,每次执行完一遍任务代码就检查一下中断状态;一旦发生中断,则跳过while循环,直接执行后面的中断处理代码。 触发中断 t1.interrupt(); 1 上述代码执行后会将t1对象的中断状态设为true,此时t1线程的正常任务代码执行完成后,进入下一次while循环前Thread.currentThread.isInterrupted()的结果为true,此时退出循环,执行循环后面的中断处理代码。 安全地停止线程 stop函数停止线程过于暴力,它会立即停止线程,不给任何资源释放的余地,下面介绍两种安全停止线程的方法。 循环标记变量 自定义一个共享的boolean类型变量,表示当前线程是否需要中断。 中断标识 volatile boolean interrupted = false; 1 任务执行函数 Thread t1 = new Thread( new Runnable(){ public void run(){ while(!interrupted){ // 正常任务代码…… } // 中断处理代码…… // 可以在这里进行资源的释放等操作…… } } ); 1 2 3 4 5 6 7 8 9 中断函数 Thread t2 = new Thread( new Runnable(){ public void run(){ interrupted = true; } } ); 1 2 3 4 5 循环中断状态 中断标识由线程对象提供,无需自己定义。 任务执行函数 Thread t1 = new Thread( new Runnable(){ public void run(){ while(!Thread.currentThread.isInterrupted()){ // 正常任务代码…… } // 中断处理代码…… // 可以在这里进行资源的释放等操作…… } } ); 1 2 3 4 5 6 7 8 9 中断函数 t1.interrupt(); 1 总结 上述两种方法本质一样,都是通过循环查看一个共享标记为来判断线程是否需要中断,他们的区别在于:第一种方法的标识位是我们自己设定的,而第二种方法的标识位是Java提供的。除此之外,他们的实现方法是一样的。 上述两种方法之所以较为安全,是因为一条线程发出终止信号后,接收线程并不会立即停止,而是将本次循环的任务执行完,再跳出循环停止线程。此外,程序员又可以在跳出循环后添加额外的代码进行收尾工作。 处理中断 上文都在介绍如何获取中断状态,那么当我们捕获到中断状态后,究竟如何处理呢? Java类库中提供的一些可能会发生阻塞的方法都会抛InterruptedException异常,如:BlockingQueue#put、BlockingQueue#take、Object#wait、Thread#sleep。 当你在某一条线程中调用这些方法时,这个方法可能会被阻塞很长时间,你可以在别的线程中调用当前线程对象的interrupt方法触发这些函数抛出InterruptedException异常。 当一个函数抛出InterruptedException异常时,表示这个方法阻塞的时间太久了,别人不想等它执行结束了。 当你的捕获到一个InterruptedException异常后,亦可以处理它,或者向上抛出。 抛出时要注意???:当你捕获到InterruptedException异常后,当前线程的中断状态已经被修改为false(表示线程未被中断);此时你若能够处理中断,则不用理会该值;但如果你继续向上抛InterruptedException异常,你需要再次调用interrupt方法,将当前线程的中断状态设为true。 注意:绝对不能“吞掉中断”!即捕获了InterruptedException而不作任何处理。这样违背了中断机制的规则,别人想让你线程中断,然而你自己不处理,也不将中断请求告诉调用者,调用者一直以为没有中断请求。 QA 为什么catch InterruptedException后会自动清除中断状态?

优秀的个人博客,低调大师

java面试-Java并发编程(五)——中断

什么是中断? 在Java中没有办法立即停止一条线程,然而停止线程却显得尤为重要,如取消一个耗时操作。因此,Java提供了一种用于停止线程的机制——中断。 中断只是一种协作机制,Java没有给中断增加任何语法,中断的过程完全需要程序员自己实现。若要中断一个线程,你需要手动调用该线程的interrupted方法,该方法也仅仅是将线程对象的中断标识设成true;接着你需要自己写代码不断地检测当前线程的标识位;如果为true,表示别的线程要求这条线程中断,此时究竟该做什么需要你自己写代码实现。 每个线程对象中都有一个标识,用于表示线程是否被中断;该标识位为true表示中断,为false表示未中断; 通过调用线程对象的interrupt方法将该线程的标识位设为true;可以在别的线程中调用,也可以在自己的线程中调用。 中断的相关方法 public void interrupt()将调用者线程的中断状态设为true。 public boolean isInterrupted()判断调用者线程的中断状态。 public static boolean interrupted只能通过Thread.interrupted()调用。它会做两步操作: 返回当前线程的中断状态; 将当前线程的中断状态设为false; 暂停、继续、停止线程(已过时) 以下三个方法都是通过线程对象去调用。 suspend()暂停调用者线程,只释放CPU执行权,不释放锁。由于在不释放资源的情况下进入睡眠状态,容易产生死锁。因此已过时! resume()恢复调用者线程,让他处于就绪状态。 stop()调用stop后,并不会保证资源被正确地释放,它会使程序处于不正确的状态下。 PS:stop和interrupt的区别? 中断的使用 要使用中断,首先需要在可能会发生中断的线程中不断监听中断状态,一旦发生中断,就执行相应的中断处理代码。当需要中断线程时,调用该线程对象的interrupt函数即可。 设置中断监听 Thread t1 = new Thread( new Runnable(){ public void run(){ // 若未发生中断,就正常执行任务 while(!Thread.currentThread.isInterrupted()){ // 正常任务代码…… } // 中断的处理代码…… doSomething(); } } ).start(); 1 2 3 4 5 6 7 8 9 10 11 正常的任务代码被封装在while循环中,每次执行完一遍任务代码就检查一下中断状态;一旦发生中断,则跳过while循环,直接执行后面的中断处理代码。 触发中断 t1.interrupt(); 1 上述代码执行后会将t1对象的中断状态设为true,此时t1线程的正常任务代码执行完成后,进入下一次while循环前Thread.currentThread.isInterrupted()的结果为true,此时退出循环,执行循环后面的中断处理代码。 安全地停止线程 stop函数停止线程过于暴力,它会立即停止线程,不给任何资源释放的余地,下面介绍两种安全停止线程的方法。 循环标记变量 自定义一个共享的boolean类型变量,表示当前线程是否需要中断。 中断标识 volatile boolean interrupted = false; 1 任务执行函数 Thread t1 = new Thread( new Runnable(){ public void run(){ while(!interrupted){ // 正常任务代码…… } // 中断处理代码…… // 可以在这里进行资源的释放等操作…… } } ); 1 2 3 4 5 6 7 8 9 中断函数 Thread t2 = new Thread( new Runnable(){ public void run(){ interrupted = true; } } ); 1 2 3 4 5 循环中断状态 中断标识由线程对象提供,无需自己定义。 任务执行函数 Thread t1 = new Thread( new Runnable(){ public void run(){ while(!Thread.currentThread.isInterrupted()){ // 正常任务代码…… } // 中断处理代码…… // 可以在这里进行资源的释放等操作…… } } ); 1 2 3 4 5 6 7 8 9 中断函数 t1.interrupt(); 1 总结 上述两种方法本质一样,都是通过循环查看一个共享标记为来判断线程是否需要中断,他们的区别在于:第一种方法的标识位是我们自己设定的,而第二种方法的标识位是Java提供的。除此之外,他们的实现方法是一样的。 上述两种方法之所以较为安全,是因为一条线程发出终止信号后,接收线程并不会立即停止,而是将本次循环的任务执行完,再跳出循环停止线程。此外,程序员又可以在跳出循环后添加额外的代码进行收尾工作。 处理中断 上文都在介绍如何获取中断状态,那么当我们捕获到中断状态后,究竟如何处理呢? Java类库中提供的一些可能会发生阻塞的方法都会抛InterruptedException异常,如:BlockingQueue#put、BlockingQueue#take、Object#wait、Thread#sleep。 当你在某一条线程中调用这些方法时,这个方法可能会被阻塞很长时间,你可以在别的线程中调用当前线程对象的interrupt方法触发这些函数抛出InterruptedException异常。 当一个函数抛出InterruptedException异常时,表示这个方法阻塞的时间太久了,别人不想等它执行结束了。 当你的捕获到一个InterruptedException异常后,亦可以处理它,或者向上抛出。 抛出时要注意???:当你捕获到InterruptedException异常后,当前线程的中断状态已经被修改为false(表示线程未被中断);此时你若能够处理中断,则不用理会该值;但如果你继续向上抛InterruptedException异常,你需要再次调用interrupt方法,将当前线程的中断状态设为true。 注意:绝对不能“吞掉中断”!即捕获了InterruptedException而不作任何处理。这样违背了中断机制的规则,别人想让你线程中断,然而你自己不处理,也不将中断请求告诉调用者,调用者一直以为没有中断请求。 QA 为什么catch InterruptedException后会自动清除中断状态?

优秀的个人博客,低调大师

python函数式编程之迭代器

什么是迭代器 顾名思义,就是更新换代的意思 python中的迭代器就是根据上一个结果生成下一个结果,一直循环往复不断重复的过程 迭代器有两个特点: 1.不断重复同一个过程 2.根据上一个结果生成下一个结果 迭代器的定义 先来看两个例子 代码一: while True: cmd = input("input your command: ").strip() print(cmd) 代码二: l1 = ["a", "b", "c", "d"] count = 0 while count < len(l1): print(l1[count]) count += 1 在代码一中,让用户不断输入命令,然后打印用户输入的命令,这是一个不断重复的过程,但是后一个结果跟前一个结果没有什么联系,所以代码一不是迭代器 在代码二中,先定义一个列表l1和count,在count的值小于列表l1的长度中,打印列表中count索引的值,然后count的值加1,这几行代码符合迭代器的定义 代码二的执行过程: 首先,打印列表l1中count索引的值,这是一个不断重复的过程 然后,每循环一次,count的值就在以前的基础上增加1,直到count的值等于列表l1的长度时,循环中止 所以代码一不是迭代器,代码二才是符后迭代器的定义标准 迭代器的作用 python中常见的数据类型包括字符串,列表,元组,字典,集合,文件 我们知道,python中的数据类型又分为有序和无序 对于有序数据类型,可以如上面的代码二所示,使用索引遍历有序数据类型中的元素 而对于无序数据类型,就不可以使用索引来遍历其中的元素了,此时可以使用for循环来遍历其中的元素 现在来看看for循环到底做了哪些事,可以取出无序数据类型中的元素 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } for k in dic1: print(k) 执行上面的程序,可以打印出字典dic1中所有的键 实际上,python为了提供一种不依赖于索引的迭代方式,python会为一些对象内置__iter__方法 在python中,如果一个对象有__iter__方法,那么这个对象就是可迭代对象 执行obj.__iter__()方法得到的结果就是迭代器 所以python中的迭代器,都会有__iter__方法和__next__方法 以上面定义的dic1为例 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } i = dic1.__iter__() # dic1.__iter__方法执行结果得到一个迭代器i print(i) # 打印迭代器,得到结果:<dict_keyiterator object at 0x0000000002DBD278> print(i.__next__()) # 执行迭代器i中的__next__方法,得到dic1中的一个元素,然后打印迭代出的元素 print(i.__next__()) # 再次执行迭代器的__next__方法,得到dic1的第二个元素,然后打印出来 print(i.__next__()) # 第三次执行迭代器的__next__方法,得到dic1的第三个元素,然后打印出来 由于python的字典是无序的数据类型,所以每次得到的dic1中的元素可能是不相同的 执行三次__next__方法,得到的结果如下 a b c 上面dic1的长度为4,如果执行5次__next__方法,会出错什么结果 dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } i = dic1.__iter__() print(i.__next__()) print(i.__next__()) print(i.__next__()) print(i.__next__()) print(i.__next__()) 程序执行结果 a File "D:\python3\lib\unittest\loader.py", line 153, in loadTestsFromName b module = __import__(module_name) c File "E:\python_learn\py_code\test.py", line 21, in <module> d print(i.__next__()) StopIteration 可以看到,python解释器在执行第五次__next__方法时,抛出了StopIteration的错误,这说明如果执行__next__方法的次数超出迭代器的长度时,python解释会抛出异常 迭代器的优缺点 迭代器的优点 1.提供一种不依赖于索引的取值方式 2.提供惰性计算,每执行一次__next__方法,只会从迭代器中取出一个值,不管这个数据长度有多大,使用迭代器取值时,每取出一个值,占用的内存空间都一个元素的大小,非常节省内存空间 迭代器的缺点 1.取值比较麻烦。如果想用迭代器的方式取出列表中的第三个值,必须调用三次__next__方法,才能取出第三个值,而前两次取出的值实际上是没有作用的 2.一次性的,只能向后迭代,不能回退。如果运行两次__next__方法后,就不可能回退再去了迭代器的第一个值 3.不能获取到迭代器的长度,只能不停执行__next__方法,直到出现StopIteration的提示,此时才能知道迭代器的长度 for循环的执行过程 定义一个列表,使用for循环遍历取出列表中的值 l1 = ['a', 'b', 'c', 'd'] for i in l1: print(i) 在for循环的执行过程中,实际上for循环是把in后面的对象执行__iter__方法,得到一个迭代器对象,然后不停执行迭代器对象中的__next__方法,得到元素,然后把迭代出来的元素赋值给i,再调用print方法打印元素i,直到for循环捕捉到StopIteration异常,结束循环,程序停止 类似于下面的代码 l1 = ['a', 'b', 'c', 'd'] obj = l1.__iter__() while True: try: i = obj.__next__() print(i) except StopIteration: break 判断一个对象是迭代器对象还是可迭代对象 只要一个对象有__iter__方法,这个对象就是可迭代对象 一个可迭代对象有__next__方法,这个对象就是迭代器对象 判断python中的字符串,列表,元组,字典和文件对象是否是可迭代对象和迭代器对象 示例代码 from collections import Iterable, Iterator s1 = "hello" l1 = ['a', 'b', 'c', 'd'] t1 = ('a', 'b', 'c', 'd') set1 = {'a', 'b', 'c', 'd'} dic1 = {"a": 1, "b": 2, "c": 3, "d": 4, } f1 = open("db.txt", "w", encoding="utf-8") print(isinstance(s1, Iterable)) print(isinstance(l1, Iterable)) print(isinstance(t1, Iterable)) print(isinstance(set1, Iterable)) print(isinstance(dic1, Iterable)) print(isinstance(f1, Iterable)) print("*" * 30) print(isinstance(s1, Iterator)) print(isinstance(l1, Iterator)) print(isinstance(t1, Iterator)) print(isinstance(set1, Iterator)) print(isinstance(dic1, Iterator)) print(isinstance(f1, Iterator)) 执行结果: True True True True True True ****************************** False False False False False True 从上面的例子,可以看出,字符串,列表,元组,集合,字典和文件都是可迭代对象,其中只有文件是迭代器对象 在上面,我们知道,使用for遍历对象中的值时,是把in后面的对象的变为可迭代对象,然后调用__next__方法取出对象中的元素 既然文件本身就是迭代器对象,那使用for循环获取文件的内容时,又是怎么做的呢 先打开一个文件,打印出这个文件对象,再调用文件对象的__iter__方法得到迭代器对象,判断两个对象是否是同一个对象 f1 = open("db.txt", encoding="utf-8") print(f1) obj = f1.__iter__() print(obj) print(obj is f1) 执行结果 <_io.TextIOWrapper name='db.txt' mode='r' encoding='utf-8'> <_io.TextIOWrapper name='db.txt' mode='r' encoding='utf-8'> True 得到结论: 如果一个对象可以被for循环迭代,则这个对象一定是可迭代对象 文件对象被执行__iter__方法,得到的结果仍然是一个迭代器对象

优秀的个人博客,低调大师

《Java并发程编程艺术》重点总结

synchronized修饰的代码块同步执行,不在synchronized块中的代码会异步执行,因此推荐用同步代码块,而非同步整个方法。 synchronized修饰同步方法和代码块,一定是排队运行的(线程独占)。 多线程访问“共享变量”,才需要加同步。 同步不能继承。 当一个线程执行的代码出现异常,其持有的锁会自动释放。 synchronized加到static方法上是给Class类上锁。 synchronized加到实例方法上,是给对象上锁。 String常量池缓存,synchronized代码块加锁一般不使用String。 synchronized代码块具有volatile同步变量到主内存的功能。 wait()和notify()都是在同步方法、代码块中使用。 执行notify()后不会立即释放对象锁,等执行完synchronized代码块才释放,然后其他wait状态的线程才可以获得该对象锁。 线程间通信,可使用管道字节流、管道字符流;建立通信的管道两端,都是阻塞的,即写端无写入时,读端将会阻塞。类似于 Linux进程通信的pipe。 PipeInputStream/PipeOutputStream PipeReader/PipeWriter ReentrantReadWriteLock 具有读和写两个锁;读读共享锁、写写排他锁、读写排他锁(有写 就互斥)。

优秀的个人博客,低调大师

面向对象高级编程:定制类

看到类似__slots__这种形如__xxx__的变量或者函数名就要注意,这些在Python中是有特殊用途的。 __slots__我们已经知道怎么用了,__len__()方法我们也知道是为了能让class作用于len()函数。 除此之外,Python的class中还有许多这样有特殊用途的函数,可以帮助我们定制类。 __str__ 我们先定义一个Student类,打印一个实例: >>> class Student(object): ... def __init__(self, name): ... self.name = name ... >>> print(Student('Michael')) <__main__.Student object at 0x109afb190> 打印出一堆<__main__.Student object at 0x109afb190>,不好看。 怎么才能打印得好看呢?只需要定义好__str__()方法,返回一个好看的字符串就可以了: >>> class Student(object): ... def __init__(self, name): ... self.name = name ... def __str__(self): ... return 'Student object (name: %s)' % self.name ... >>> print(Student('Michael')) Student object (name: Michael) 这样打印出来的实例,不但好看,而且容易看出实例内部重要的数据。 但是细心的朋友会发现直接敲变量不用print,打印出来的实例还是不好看: >>> s = Student('Michael') >>> s <__main__.Student object at 0x109afb310> 这是因为直接显示变量调用的不是__str__(),而是__repr__(),两者的区别是__str__()返回用户看到的字符串,而__repr__()返回程序开发者看到的字符串,也就是说,__repr__()是为调试服务的。 解决办法是再定义一个__repr__()。但是通常__str__()和__repr__()代码都是一样的,所以,有个偷懒的写法: class Student(object): def __init__(self, name): self.name = name def __str__(self): return 'Student object (name=%s)' % self.name __repr__ = __str__ __iter__ 如果一个类想被用于for ... in循环,类似list或tuple那样,就必须实现一个__iter__()方法,该方法返回一个迭代对象,然后,Python的for循环就会不断调用该迭代对象的__next__()方法拿到循环的下一个值,直到遇到StopIteration错误时退出循环。 我们以斐波那契数列为例,写一个Fib类,可以作用于for循环: class Fib(object): def __init__(self): self.a, self.b = 0, 1 # 初始化两个计数器a,b def __iter__(self): return self # 实例本身就是迭代对象,故返回自己 def __next__(self): self.a, self.b = self.b, self.a + self.b # 计算下一个值 if self.a > 100000: # 退出循环的条件 raise StopIteration() return self.a # 返回下一个值 现在,试试把Fib实例作用于for循环: >>> for n in Fib(): ... print(n) ... 1 1 2 3 5 ... 46368 75025 __getitem__ Fib实例虽然能作用于for循环,看起来和list有点像,但是,把它当成list来使用还是不行,比如,取第5个元素: >>> Fib()[5] Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: 'Fib' object does not support indexing 要表现得像list那样按照下标取出元素,需要实现__getitem__()方法: class Fib(object): def __getitem__(self, n): a, b = 1, 1 for x in range(n): a, b = b, a + b return a 现在,就可以按下标访问数列的任意一项了: >>> f = Fib() >>> f[0] 1 >>> f[1] 1 >>> f[2] 2 >>> f[3] 3 >>> f[10] 89 >>> f[100] 573147844013817084101 但是list有个神奇的切片方法: >>> list(range(100))[5:10] [5, 6, 7, 8, 9] 对于Fib却报错。原因是__getitem__()传入的参数可能是一个int,也可能是一个切片对象slice,所以要做判断: class Fib(object): def __getitem__(self, n): if isinstance(n, int): # n是索引 a, b = 1, 1 for x in range(n): a, b = b, a + b return a if isinstance(n, slice): # n是切片 start = n.start stop = n.stop if start is None: start = 0 a, b = 1, 1 L = [] for x in range(stop): if x >= start: L.append(a) a, b = b, a + b return L 现在试试Fib的切片: >>> f = Fib() >>> f[0:5] [1, 1, 2, 3, 5] >>> f[:10] [1, 1, 2, 3, 5, 8, 13, 21, 34, 55] 但是没有对step参数作处理: >>> f[:10:2] [1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89] 也没有对负数作处理,所以,要正确实现一个__getitem__()还是有很多工作要做的。 此外,如果把对象看成dict,__getitem__()的参数也可能是一个可以作key的object,例如str。 与之对应的是__setitem__()方法,把对象视作list或dict来对集合赋值。最后,还有一个__delitem__()方法,用于删除某个元素。 总之,通过上面的方法,我们自己定义的类表现得和Python自带的list、tuple、dict没什么区别,这完全归功于动态语言的“鸭子类型”,不需要强制继承某个接口。 __getattr__ 正常情况下,当我们调用类的方法或属性时,如果不存在,就会报错。比如定义Student类: class Student(object): def __init__(self): self.name = 'Michael' 调用name属性,没问题,但是,调用不存在的score属性,就有问题了: >>> s = Student() >>> print(s.name) Michael >>> print(s.score) Traceback (most recent call last): ... AttributeError: 'Student' object has no attribute 'score' 错误信息很清楚地告诉我们,没有找到score这个attribute。 要避免这个错误,除了可以加上一个score属性外,Python还有另一个机制,那就是写一个__getattr__()方法,动态返回一个属性。修改如下: class Student(object): def __init__(self): self.name = 'Michael' def __getattr__(self, attr): if attr=='score': return 99 当调用不存在的属性时,比如score,Python解释器会试图调用__getattr__(self, 'score')来尝试获得属性,这样,我们就有机会返回score的值: >>> s = Student() >>> s.name 'Michael' >>> s.score 99 返回函数也是完全可以的: class Student(object): def __getattr__(self, attr): if attr=='age': return lambda: 25 只是调用方式要变为: >>> s.age() 25 注意,只有在没有找到属性的情况下,才调用__getattr__,已有的属性,比如name,不会在__getattr__中查找。 此外,注意到任意调用如s.abc都会返回None,这是因为我们定义的__getattr__默认返回就是None。要让class只响应特定的几个属性,我们就要按照约定,抛出AttributeError的错误: class Student(object): def __getattr__(self, attr): if attr=='age': return lambda: 25 raise AttributeError('\'Student\' object has no attribute \'%s\'' % attr) 这实际上可以把一个类的所有属性和方法调用全部动态化处理了,不需要任何特殊手段。 这种完全动态调用的特性有什么实际作用呢?作用就是,可以针对完全动态的情况作调用。 举个例子: 现在很多网站都搞REST API,比如新浪微博、豆瓣啥的,调用API的URL类似: http://api.server/user/friends http://api.server/user/timeline/list 如果要写SDK,给每个URL对应的API都写一个方法,那得累死,而且,API一旦改动,SDK也要改。 利用完全动态的__getattr__,我们可以写出一个链式调用: class Chain(object): def __init__(self, path=''): self._path = path def __getattr__(self, path): return Chain('%s/%s' % (self._path, path)) def __str__(self): return self._path __repr__ = __str__ 试试: >>> Chain().status.user.timeline.list '/status/user/timeline/list' 这样,无论API怎么变,SDK都可以根据URL实现完全动态的调用,而且,不随API的增加而改变! 还有些REST API会把参数放到URL中,比如GitHub的API: GET /users/:user/repos 调用时,需要把:user替换为实际用户名。如果我们能写出这样的链式调用: Chain().users('michael').repos 就可以非常方便地调用API了。有兴趣的童鞋可以试试写出来。 __call__ 一个对象实例可以有自己的属性和方法,当我们调用实例方法时,我们用instance.method()来调用。能不能直接在实例本身上调用呢?在Python中,答案是肯定的。 任何类,只需要定义一个__call__()方法,就可以直接对实例进行调用。请看示例: class Student(object): def __init__(self, name): self.name = name def __call__(self): print('My name is %s.' % self.name) 调用方式如下: >>> s = Student('Michael') >>> s() # self参数不要传入 My name is Michael. __call__()还可以定义参数。对实例进行直接调用就好比对一个函数进行调用一样,所以你完全可以把对象看成函数,把函数看成对象,因为这两者之间本来就没啥根本的区别。 如果你把对象看成函数,那么函数本身其实也可以在运行期动态创建出来,因为类的实例都是运行期创建出来的,这么一来,我们就模糊了对象和函数的界限。 那么,怎么判断一个变量是对象还是函数呢?其实,更多的时候,我们需要判断一个对象是否能被调用,能被调用的对象就是一个Callable对象,比如函数和我们上面定义的带有__call__()的类实例: >>> callable(Student()) True >>> callable(max) True >>> callable([1, 2, 3]) False >>> callable(None) False >>> callable('str') False 通过callable()函数,我们就可以判断一个对象是否是“可调用”对象。 小结 Python的class允许定义许多定制方法,可以让我们非常方便地生成特定的类。 转载。原文:https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000/0014319098638265527beb24f7840aa97de564ccc7f20f6000


优秀的个人博客,低调大师

面向对象高级编程:使用@property

在绑定属性时,如果我们直接把属性暴露出去,虽然写起来很简单,但是,没办法检查参数,导致可以把成绩随便改: s = Student() s.score = 9999 这显然不合逻辑。为了限制score的范围,可以通过一个set_score()方法来设置成绩,再通过一个get_score()来获取成绩,这样,在set_score()方法里,就可以检查参数: class Student(object): def get_score(self): return self._score def set_score(self, value): if not isinstance(value, int): raise ValueError('score must be an integer!') if value < 0 or value > 100: raise ValueError('score must between 0 ~ 100!') self._score = value 现在,对任意的Student实例进行操作,就不能随心所欲地设置score了: >>> s = Student() >>> s.set_score(60) # ok! >>> s.get_score() 60 >>> s.set_score(9999) Traceback (most recent call last): ... ValueError: score must between 0 ~ 100! 但是,上面的调用方法又略显复杂,没有直接用属性这么直接简单。 有没有既能检查参数,又可以用类似属性这样简单的方式来访问类的变量呢?对于追求完美的Python程序员来说,这是必须要做到的! 还记得装饰器(decorator)可以给函数动态加上功能吗?对于类的方法,装饰器一样起作用。Python内置的@property装饰器就是负责把一个方法变成属性调用的: class Student(object): @property def score(self): return self._score @score.setter def score(self, value): if not isinstance(value, int): raise ValueError('score must be an integer!') if value < 0 or value > 100: raise ValueError('score must between 0 ~ 100!') self._score = value @property的实现比较复杂,我们先考察如何使用。把一个getter方法变成属性,只需要加上@property就可以了,此时,@property本身又创建了另一个装饰器@score.setter,负责把一个setter方法变成属性赋值,于是,我们就拥有一个可控的属性操作: >>> s = Student() >>> s.score = 60 # OK,实际转化为s.set_score(60) >>> s.score # OK,实际转化为s.get_score() 60 >>> s.score = 9999 Traceback (most recent call last): ... ValueError: score must between 0 ~ 100! 注意到这个神奇的@property,我们在对实例属性操作的时候,就知道该属性很可能不是直接暴露的,而是通过getter和setter方法来实现的。 还可以定义只读属性,只定义getter方法,不定义setter方法就是一个只读属性: class Student(object): @property def birth(self): return self._birth @birth.setter def birth(self, value): self._birth = value @property def age(self): return 2015 - self._birth 上面的birth是可读写属性,而age就是一个只读属性,因为age可以根据birth和当前时间计算出来。 小结 @property广泛应用在类的定义中,可以让调用者写出简短的代码,同时保证对参数进行必要的检查,这样,程序运行时就减少了出错的可能性。 转载。原文:https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000/00143186781871161bc8d6497004764b398401a401d4cce000

优秀的个人博客,低调大师

《Java编程思想》读书笔记(6)

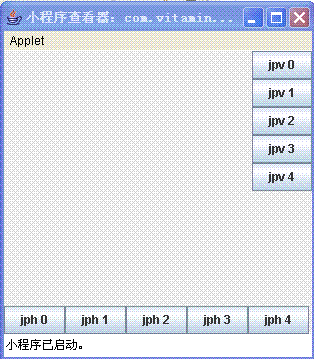
JButton这一章,Brucke只给出了一个简单的例子,代码如下: import java.applet.Applet; import java.awt.*; import javax.swing.*; public class Test extends JApplet { private JButton btn1; private JButton btn2; /** * @param args */ public void init() { this.btn1 = new JButton("确定"); this.btn2 = new JButton("重置"); Container con = this.getContentPane(); con.setLayout(new FlowLayout()); con.add(btn1); con.add(btn2); } public static void main(String[] args) { Test t1 = new Test(); Console.run(t1,300,300); } } 这一节没有过多的东西可以思考,但布局管理器的知识值得去深究。 Java语言中提供的布局管理器种类有:边界式布局、卡片式布局、流式布局和网格式布局等,各有不同的特点,可根据实际 需要选用;但有最大自由设计空间的是“无布局管理器”——即不使用任何布局格式,而通过手工方式添加组件到页面布局的绝对位置上。因此我采用“无布局管理器”将他的代码改写如下: import java.applet.Applet; import java.awt.*; import javax.swing.*; public class Test extends JApplet { private JButton btn1; private JButton btn2; /** * @param args */ public void init() { this.btn1 = new JButton("确定"); this.btn2 = new JButton("重置"); Container con = this.getContentPane(); //con.setLayout(new FlowLayout()); con.setLayout(null); btn1.reshape(30,30,100,100); btn2.reshape(150,150,100,100); con.add(btn1); con.add(btn2); } public static void main(String[] args) { Test t1 = new Test(); Console.run(t1,600,600); } } 1. GridLayout GridLayout类是布局管理器之一,它将容器中的组件在放置在一个矩形网格中。容器被划分为相同大小的矩形,而每个组件就放置在一个单独的矩形中。 import java.awt.*; import javax.swing.*; public class GridForm extends JFrame { /** * @param args */ public static void main(String[] args) { // TODO Auto-generated method stub GridForm gf = new GridForm(); gf.setLayout(new GridLayout(3,2)); Container con = gf.getContentPane(); con.setComponentOrientation(ComponentOrientation.LEFT_TO_RIGHT); con.add(new JButton("1")); con.add(new JButton("2")); con.add(new JButton("3")); con.add(new JButton("4")); con.add(new JButton("5")); con.add(new JButton("6")); gf.setTitle("GridLayout例子"); gf.setDefaultCloseOperation(JFrame.EXIT_ON_CLOSE); gf.setSize(200,200); gf.setVisible(true); } } 如果容器的ComponentOrientation属性是水平的并且从左到右,上面例子产生如下图1: 如果容器的ComponentOrientation属性是horizontal 和 right-to-left,结果就如下图2: 当行数和列数都被设置为非零值(不管是通过构造函数或者通过setRows和setColumns方法来设置),指定的列数就会被忽略掉。例如说,如果指定是3行3列,而将布局中放置9个组件,它们就会显示为3行3列。 2.BorderLayout 边界布局会把容器看成五个:部分:north, south, east, west,和 center。每个区域最多包含一个组件,重要的五个常量:NORTH, SOUTH, EAST, WEST和 CENTER; Panel p = new Panel(); p.setLayout(new BorderLayout()); p.add(new Button("Okay"), BorderLayout.SOUTH); ================================================== ================================================== Panel p2 = new Panel(); p2.setLayout(new BorderLayout()); p2.add(new TextArea()); // Same as p.add(new TextArea(), BorderLayout.CENTER); <!--[endif]--> BorderLayout 支持相对定位常量, PAGE_START, PAGE_END, LINE_START, and LINE_END. 在一个容器中,如果它的 ComponentOrientation 被设置为ComponentOrientation.LEFT_TO_RIGHT,这些常量就分别映射为 NORTH, SOUTH, WEST, and EAST 为了与以前兼容,BorderLayout也好汉相对定位常量 BEFORE_FIRST_LINE, AFTER_LAST_LINE, BEFORE_LINE_BEGINS and AFTER_LINE_ENDS. 他们分别和PAGE_START, PAGE_END, LINE_START and LINE_END等价. 如果同时使用绝对定位和相对定位,就会产生不可预测的结果。例如,如果你在容器中同时使 NORTH 和 PAGE_START 常量 来添加组件,而容器的 方向是 LEFT_TO_RIGHT, 那么就只有PAGE_START被会布局。 import java.awt.*; import javax.swing.*; public class GridForm extends JFrame { /** * @param args */ public static void main(String[] args) { // TODO Auto-generated method stub GridForm gf = new GridForm(); gf.setLayout(new BorderLayout()); Container con = gf.getContentPane(); con.setComponentOrientation(ComponentOrientation.LEFT_TO_RIGHT); con.add(new JButton("North"),BorderLayout.NORTH); con.add(new JButton("SOUTH"),BorderLayout.SOUTH); con.add(new JButton("EAST"),BorderLayout.EAST); con.add(new JButton("WEST"),BorderLayout.WEST); con.add(new JButton("CENTER"),BorderLayout.CENTER); gf.setTitle("BorderLayout例子"); gf.setDefaultCloseOperation(JFrame.EXIT_ON_CLOSE); gf.setSize(200,200); gf.setVisible(true); } } 3. FlowLayout FlowLayout会将组件从左到右进排列,就象文章中的文本行一样。流布局一般用在面板中的按纽的放置。它将会将按纽以从左至右的方式排放,直到在同一行中再也放不下更多的按纽了。 import java.awt.*; import javax.swing.*; public class GridForm extends JFrame { /** * @param args */ public static void main(String[] args) { // TODO Auto-generated method stub GridForm gf = new GridForm(); //gf.setLayout(new BorderLayout()); gf.setLayout(new FlowLayout()); Container con = gf.getContentPane(); con.setComponentOrientation(ComponentOrientation.LEFT_TO_RIGHT); con.add(new JButton("North")); con.add(new JButton("SOUTH")); con.add(new JButton("EAST")); con.add(new JButton("WEST")); con.add(new JButton("CENTER")); gf.setTitle("FlowLayout例子"); gf.setDefaultCloseOperation(JFrame.EXIT_ON_CLOSE); gf.setSize(200,200); gf.setVisible(true); } } 4.BoxLayout BoxLayout能让你在垂直和水平两个方向上控制组件的摆放,它用一些被称为支柱(struts)和胶水(glue)的东西来控制组件间的距离。 package com.vitamin.UI; import javax.swing.*; import java.awt.*; import com.vitamin.*; import com.vitamin.Console.console; public class BoxLayout1 extends JApplet { public void init() { JPanel jpv = new JPanel(); jpv.setLayout(new BoxLayout(jpv, BoxLayout.Y_AXIS)); for(int i = 0; i < 5; i++) jpv.add(new JButton("jpv " + i)); JPanel jph = new JPanel(); jph.setLayout(new BoxLayout(jph, BoxLayout.X_AXIS)); for(int i = 0; i < 5; i++) jph.add(new JButton("jph " + i)); Container cp = getContentPane(); cp.add(BorderLayout.EAST, jpv); cp.add(BorderLayout.SOUTH, jph); } public static void main(String[] args) { console.run(new BoxLayout1(), 450, 200); } } 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2006/06/01/415342.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册