首页 文章 精选 留言 我的

精选列表

搜索[双足行走],共9161篇文章
优秀的个人博客,低调大师

服务器配置缺陷暴露 Evilginx 双路径 M365 绕过 MFA 钓鱼攻击研究

2026 年 4 月安全厂商 Lexfo 通过攻击者服务器目录遍历配置漏洞,完整还原三套基于 Evilginx 二次开发的商业化钓鱼攻击体系,两套攻击链路分别依托 AiTM 反向代理中间人劫持、OAuth 设备码流滥用实现 Microsoft 365 多因素认证绕过,累计窃取 218 家企业办公账号。本次暴露事件源于攻击者运维基础操作失误:使用python3 -m http.server开放公网目录浏览,泄露 Evilginx 配置文件、凭证日志、运维命令记录、远程管理工具全量资产。反网络钓鱼技术专家芦笛指出,当前政企普遍将 MFA 视为身份安全最后屏障,完全忽视 AiTM 代理劫持、设备码协议滥用两类差异化绕过路径,同时运维侧服务器基础配置管控缺失形成黑产攻击基础设施溯源漏洞,形成 “终端身份防护、基础设施运维” 双重安全盲区。本文以 Lexfo 披露的失配服务器完整情报为实证基础,拆解 codemado、mail-argenta、saroula01 三名黑产团伙定制化 Evilginx 分支技术架构、完整攻击链路、反检测优化逻辑,提供 Evilginx 代理流量劫持核心 Go 语言代码片段、服务器配置风险自动化巡检 Python 脚本;从云身份条件访问策略、服务器运维基线管控、邮件流量前置拦截、常态化员工安全运营四层构建闭环防御体系,量化两类 Evilginx 衍生攻击的穿透能力、数据外泄效率与企业合规风险,为政企单位抵御商业化 AiTM 钓鱼、OAuth 协议滥用攻击、消除服务器基础配置漏洞提供完整技术落地参考。

优秀的个人博客,低调大师

msgtrans v1.0.4 发布:稳定性与性能双引擎升级的 rust 网络库

msgtrans v1.0.4正式发布。 这是一次面向生产环境的“硬核增强”版本:在不改动用户 API 的前提下,围绕稳定性与性能两条主线完成核心链路重构。 一句话总结:更稳、更快、更能扛。 版本亮点 稳定性大幅提升:修复 QUIC/TCP/WebSocket 多协议在高压与异常网络下的关键退出与监听问题。 性能持续抬升:优化热路径与资源复用,降低连接建立和消息处理的系统开销。 零 API 破坏:业务侧调用方式保持不变,升级成本接近 0。 稳定性增强(重点) 本版本把“能跑”升级为“长期稳定跑”: 修复 QUIC 监听在握手异常场景下的脆弱退出链路,避免一次异常导致监听提前停止。 增加 QUIC 显式关闭与 idle drain,显著改善 Ctrl+C 后端口释放慢的问题。 为 TCP/WebSocket 补齐显式 shutdown 路径,统一多协议停服行为,降低端口占用残留风险。 监听循环加入 stop 信号轮询与容错机制,避免非致命 accept 错误触发整条服务链路中断。 修复请求超时后 pending 清理缺口,降低弱网长时间运行下的内存积累风险。 修复事件流过滤“形同虚设”问题,使会话过滤行为与预期一致。 性能升级(重点) 这次性能优化不是“参数微调”,而是“热路径收敛”: 连接重资源从重复初始化改为共享复用,降低新会话创建成本。 关键命令/队列链路进一步 lock-free 化与通道策略优化,减少竞争与上下文切换。 通道实现统一收敛(含 flume 路径升级),在吞吐稳定性与尾延迟之间取得更好的平衡。 事件转发与会话任务管理去重,避免重连场景下重复消费与额外任务开销。 实测结论 在近期压测与反复启停验证中,v1.0.4表现为: 吞吐维持高位且波动更小; 弱网/异常握手场景恢复能力更强; 连续 Ctrl+C + 快速重启下,端口释放行为明显改善; 长时间运行场景的资源曲线更平稳。 升级建议 推荐所有v1.0.x用户直接升级到v1.0.4。 本次升级无需修改既有 API;建议升级后重点回归三类场景: 高并发连接与突发流量; 弱网/抖动网络; 频繁启停与自动化发布。 msgtrans v1.0.4的目标非常明确: 把传输层从“可用”推进到“可依赖”,把性能从“高”推进到“稳定高”。

优秀的个人博客,低调大师

腾讯元宝再更新:DeepSeek R1+腾讯混元 T1「双核」驱动

继上周接入「满血版」DeepSeek-R1后,腾讯元宝宣布又上线腾讯混元最新「深度思考模型」Thinker(T1),目前已开启小范围灰测,用户可以自行选用。 根据介绍,无论是使用混元T1,还是使用DeepSeek,均支持联网搜索,覆盖公众号等腾讯生态内容及互联网权威信源。 用户在元宝里提问时,可以选择从微信里上传文件;也可以通过元宝小程序在微信里上传文件,元宝一键解析,无需多余步骤,大幅减少操作成本。

优秀的个人博客,低调大师

再度刷新TPS记录的PolarDB如何应对双11“尖峰时刻”?

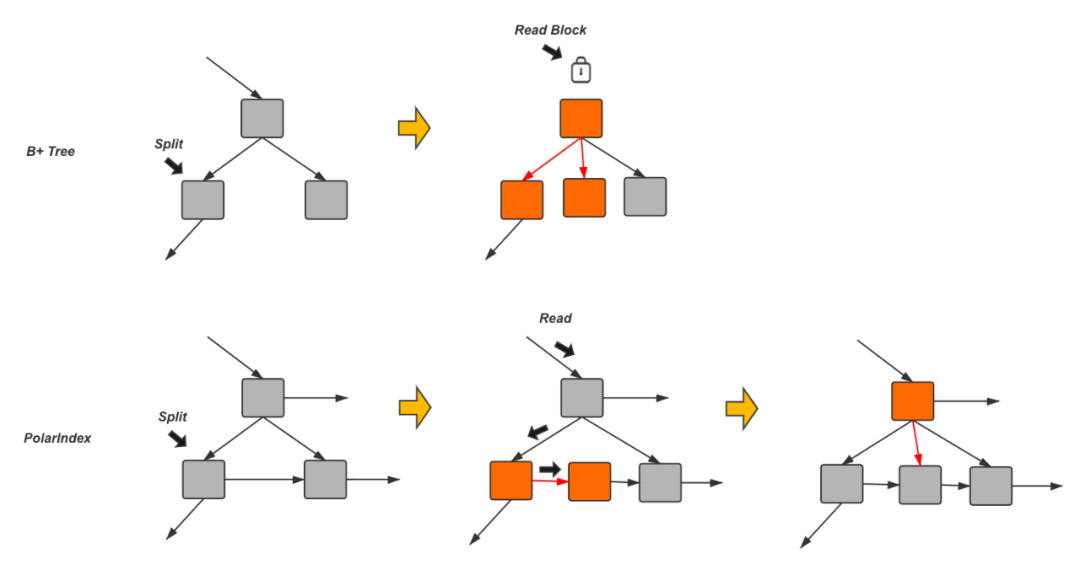
2020年是云原生数据库PolarDB全面支撑天猫双十一的第二年,天猫交易、买家、卖家以及物流等系统在双十一期间基于PolarDB为亿万客户提供了顺滑的体验。同时,PolarDB还刷新了去年由自己创造的数据库处理峰值(TPS)纪录,今年TPS峰值高达1.4亿次/秒,较去年提升了60%。 PolarDB是阿里自研的云原生数据库品牌, 通过独有的存储计算分离、分布式共享存储技术,解决了传统RDBMS容量有限、扩缩容时间长等问题, 在性能、容量、弹性、以及可用性上都有很大的突破:  存储容量可达100TB,单库可扩展到16个节点,满足企业级大数据存储需求。  高性能、高弹性、低成本,一写多读,分钟级扩缩容  多AZ高可用,数据高可靠性。跨AZ六副本,故障快速容灾转移 PolarDB今年下半年发布了MySQL 5.7的兼容版。至此PolarDB成为全球唯一一家兼容 MySQL 所有在役版本的云数据库,可以覆盖更多的业务场景 性能优化 性能对于双十一大促来说是永恒的主题。在天猫的核心交易链路的数据库,在零点峰值场景中,会有大量的数据读写。而每一年随着峰值的增长,数据库会遇到更严峻的挑战。在过去的几年中,随着数据库硬件的不断进化,我们为PolarDB重点优化了索引结构、I/O子系统、锁系统以及事务系统来完成并发性能的提升。 首先是索引结构。众所周知传统的InnoDB 索引在这样的场景下会遇到频繁的页面分裂导致的并发瓶颈。所有的对索引结构的修改都要排队串行执行。为了解决这个问题, PolarDB引入了新的索引结构来替代传统索引,细化索引结构变更时的并发粒度,提升了接近20%的读写性能。新的索引结构使得原本需要将所有涉及索引分裂的页面加锁直到整个分裂动作完成后才释放的逻辑变成逐层加锁。这样原本被索引页面分裂阻塞的读操作会有机会在整个分裂动作中间进来:通过对每个节点增加一个后继链接的方式,使得在分裂的中间状态也可以完成对数据页面的安全的访问,从而提高读取性能。 其次是IO子系统。由于PolarDB是采用的用户态文件系统, 因此需要有一套对应的IO系统来确保对底层分布式存储的高效访问, InnoDB原有的AIO策略,是将所有异步IO请求按照目标地址进行组织存放在同一个IO数组中,方便将目标地址连续的小IO合并成大IO以提升IO的吞吐,但是在分布式存储的场景下连续的大IO操作,会使得同一时刻,只有一个或少量存储节点处在服务状态,其他的存储节点处于空闲状态,此外,分布式存储在高IO负载的场景中会出现网络中的Inflight IO较多的情况,IO任务数组中添加I和移除请求的开销都很大。为此PolarDB专门对IO系统进行了重新的设计,主要包括:合理的选择IO合并和拆解,充分利分布式存储的多节点优势;建立状态有序的IO服务队列,减少高负载下的IO服务开销。新的子系统让PolarDB在写入和读写混合的场景下性能和稳定性都得到了显著的性能提升。 再接下来是锁系统的优化。 PolarDB和MySQL一样都是采用MVCC的方式看来做事务之间的并发控制, 但是在处理写请求和写请求之间的并发时是通过两阶段的锁来做保护的。大量且频繁的插入更新删除带来了锁系统的负担和并发的瓶颈。 因此PolarDB采取了Partition Lock System的方式,将锁系统改造成由多个分片组成,每个分片中都有自己局部的并发控制,从而将这个瓶颈打散。尤其是在这种大压力的写入场景下明显的提升写入性能。 最后是事务系统。 PolarDB中支持Snapshot Isolation的隔离级别,通过保留使用的Undo版本信息来支持对不同版本的记录的访问,即MVCC。而实现MVCC需要事务系统有能力跟踪当前活跃及已经提交的事务信息。在之前的实现中每当有写事务开始时,需要分配一个事务ID,并将这个ID添加到事务系统中的一个活跃事务列表中。当有读请求需要访问数据时,会首先分配一个ReadView,其中包括当前已分配最大的事务ID,以及当前这个活跃事务列表的一个备份。每当读请求访问数据时,会通过从索引开始的指针访问到这个记录所有的历史版本,通过对比某个历史版本的事务ID和自己ReadView中的活跃事务列表,可以判断是不是需要的版本。然而,这就导致每当有读事务开始时,都需要在整个拷贝过程对这个活跃事务列表加锁,从而阻塞了新的写事务将自己的ID加入。同样写事务和写事务之间也有访问活跃事务列表的冲突。从而活跃事务列表在这里变成一个明显的性能瓶颈,在双十一这种大压力的读写场景下尤为明显。对此,我们将事务系统中的这个活跃事务列表改造成无锁Hash实现,写事务添加ID以及读事务拷贝到ReadView都可以并发进行。大大提升了性能。 全球数据库技术 诸如AliExpress这一类针对海外消费者的购物大促,业务遍及各个大洲和国家等等。因此数据库的异地可读,数据同步有非常高的要求。在过去DTS承载了区域间数据同步任务,DTS订阅了二进制日志然后分发到不同的区域并进行高速应用以实现区域间数据状态一致性。今年PolarDB集成了全新的全球数据库技术来解决跨域访问以及容灾的问题,PolarDB全球数据库(PolarDB Global Database Network,PolarDB-GDN)采用了数据库物理日志异步复制的方案。但是达成以上目标需要解决几个关键难点:高网络延迟下的数据同步问题和跨Region的数据读写问题。针对这两点问题,PolarDB-GDN通过高并发流水线技术将同步速度提升7倍,将数据跨大洲同步延迟控制在2秒内。 全局读写分离技术结合多级别的一致性能力, 让业务不用做任何的改造的前提下降低整体的访问延迟。 热缓存技术 双十一对数据库的可用性要求非常高,核心应用在大促期间处于高负载的状态,长时间高负荷的运行不可避免会存在单一节点的故障,如何能快速恢复成为了一个重要的课题。过去的节点故障恢复需要经历相当长的时间的恢复时间,而重启拉起后的系统还需要缓存预热后才能达到最佳访问性能。 PolarDB今年在存储计算分离架构上继续往前迈进一大步,实现了计算和内存的分离。通过将内存缓冲池从计算节点剥离,让计算节点状态最小化 。计算节点重启后可以快速恢复到重启前的状态,避免大量耗时的缓存预热。传统数据库的错误恢复需要检查点开始扫描所有的redo日志、回放日志、事务恢复等步骤,该过程涉及大量磁盘IO、CPU计算等工作量,其时间往往很长。使用了热缓存技术的PolarDB在计算节点崩溃后,需要恢复的是缓存可能处于不一致的状态,如部分尚未修改完成的缓存页面以及内存结构等。而在CPU缓存分离的架构下只需要新的计算节点来根据各种控制信息和redo日志将这些被污染的内存恢复到一致的状态。因为无需重新构建缓存池,修复工作量小。在常规读写负载下,重启后的数据库最大吞吐下降到原来的5%以下,并在200秒后逐渐恢复正常水平,而利用了热缓存技术的实例几乎无任何性能下降。 跨AZ容灾能力 双十一的核心业务必须要能够跨AZ的容灾, PolarDB提供了跨AZ容灾RPO为0的方案。PolarDB 在存储层(PolarStore)提供3副本的同时,还可以通过自研的 X-Paxos 库提供跨节点、跨机房、跨 AZ 级别的数据同步能力,提供 RPO = 0 的容灾解决方案。这个方案利用 PolarDB 经过多年验证的物理复制技术和 X-Paxos 一致性协议库,提供高可靠、低延迟的数据复制技术。相比于 RDS/MySQL 的逻辑日志复制,PolarDB 在节点切换时,受大事务/DDL 的影响更小,RTO 小于1分钟。同时,这个方案在保证数据冗余的同时,尽量减少部署成本。PolarDB 跨AZ版可以部署Leader,Follower 和 Log 节点。其中 Log 节点只记录日志,不参与选主,不存储数据,部署成本相比于现有架构只增加了 active redo log ,显著降低了部署成本。 并行查询增强 双十一不仅是消费者的盛筵, 也是众多卖家的狂欢。 卖家经常需要实时的查询自己的销售数据以及做一些快速的分析。PolarDB拥有查询引擎,在众多场景下能满足一些即时查询的需求,它充分利用硬件多核优势,并基于COST自动选择并行查询引擎,显著提升了查询性能。今年PolarDB在该方向并没有停止脚步,利用并行查询引擎了优化更多的应用场景。在大规格的实例中, 并行的提升效果尤为显著。 在今年, PolarDB的并行查询新增加了众多场景的覆盖, 有联合(Union)子查询的并行优化,扩展并行查询引擎对联合(Union)子查询的支持;派生表(Derived Table)的并行优化;用户自定义临时表的并行优化;Count的并行优化;Limit的并行优化;条件下推优化,减少数据汇总代价;HASH JOIN 的并行优化,同时优化算子和执行的并行度。 除此之外, POLARDB对GROUP BY / Distinct / SEMI-JOIN / 常量表以及包含Window函数的子查询也做了并行优化,通过利用更多的CPU资源, 有效降低了这些场景下的查询耗时。在标准的TPC-H场景下,POLARDB的并行查询框架取得了非常好的表现。 并行schema变更 在阿里的业务中大量的POLARDB承载了超大规模的数据,然而业务的需求是实时变化的。过去对这些大表做DDL会持续数小时甚至数天,如此之高的延迟是难以容忍的。以创建二级索引为例,过高延迟的DDL操作会阻塞后续依赖新索引查询的DML操作。DDL操作会消耗CPU/Memory/IO资源,对业务DML带来一定的影响,因此用户往往在业务低峰期进行schema变更,但是如果不能确保变更在业务低峰期之内完成会对业务的稳定性产生严重的影响。 我们认为大表DDL运行缓慢的根本原因在于传统的DDL操作是针对单核和传统硬盘设计的。随着多核处理器的日益发展和高速存储的普及,DDL的并行化是可以取得非常好的效果的。 Online DDL分为创建临时表扫描拷贝全量数据加上增量应用期间的变更等几个主要阶段。以增加索引为例需要扫描主键所有记录,生成新的二级索引记录,写入磁盘文件中;对所有二级索引记录进行排序,写入磁盘文件;将有序的二级索引记录插入到新的二级索引中。 POLARDB可以对索引树进行并行扫描、并行多路归并的Merge Sort、并行的Bulk Load索引。 在8core32G规格的实例中针对CPU Bound 和 IO Bound的场景分别进行了测试,都可以达到6-13倍的速度提升。 总结 今年的双十一对PolarDB在性能和功能上提出了更高的要求。 PolarDB在并发性能、跨域、弹性以及可用性上都更进了一步,POLARDB不仅承载着整个阿里集团的实时OLTP数据业务,而且在云上为更为广大的客户提供服务。 我们的目标是将云原生的数据库技术普惠所有的企业客户,帮助客户更好的实现业务价值。 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | 事务处理不当,线上接口又双叒内存泄漏了

情景 项目上线了一个接口,先灰度一台机器观察调用情况; 接口不断的调用,过了一段时间,发现机器上的接口调用开始报OOM异常 ! 当天就是上线deadline了,刺激。。 发现问题 第一步,使用jps命令获取出问题jvm进程的进程ID 使用jps -l -m获取到当前jvm进程的pid,通过上述命令获取到了服务的进程号:427726 (此处假设为这个) jps命令 jps(JVM Process Status Tool):显示指定系统内所有的HotSpot虚拟机进程 jps -l -m : 参数-l列出机器上所有jvm进程,-m显示出JVM启动时传递给main()的参数 第二步,使用jstat观察jvm状态,发现问题 因为是OOM异常,所以我们首先重启机器观察了JVM的运行情况; 我们使用jstat -gc pid time命令观察GC,发现GC在YGC后,GC掉的内存并不多,每次YGC后都有一部分内存未回收,导致在多次YGC后回收不掉的内存被挪到堆的old区,old满了之后FGC发现也是回收不掉; 这里基本可以确定是内存泄漏的问题了,下面我们有简单看了下机器的cpu、内存、磁盘状态 jstat命令: jstat(JVM statistics Monitoring)是用于监视虚拟机运行时状态信息的命令,它可以显示出虚拟机进程中的类装载、内存、垃圾收集、JIT编译等运行数据。 jstat -gc pid time : -gc 监控jvm的gc信息,pid 监控的jvm进程id,time每个多少毫秒刷新一次 jstat -gccause pid time : -gccause 监控gc信息并显示上次gc原因,pid 监控的jvm进程id,time每个多少毫秒刷新一次 jstat -class pid time: -class 监控jvm的类加载信息,pid 监控的jvm进程id,time每个多少毫秒刷新一次 在这里先简单说一下,堆的GC: 在GC开始的时候,对象只会存在于Eden区和名为“From”的Survivor区,Survivor区“To”是空的。紧接着进行GC,Eden区中所有存活的对象都会被复制到“To”,而在“From”区中,仍存活的对象会根据他们的年龄值来决定去向。 年龄达到一定值(年龄阈值,可以通过-XX:MaxTenuringThreshold来设置)的对象会被移动到年老代中,没有达到阈值的对象会被复制到“To”区域。经过这次GC后,Eden区和From区已经被清空。这个时候,“From”和“To”会交换他们的角色,也就是新的“To”就是上次GC前的“From”,新的“From”就是上次GC前的“To”。不管怎样,都会保证名为To的Survivor区域是空的,minor GC会一直重复这样的过程。 第三步,观察机器状态,确认问题 使用top -p pid获取进程的cpu和内存使用率;查看RES 和 %CPU %MEM三个指标: 在这里先简单说一下,top命令展示的内容: VIRT:virtual memory usage 虚拟内存 1、进程“需要的”虚拟内存大小,包括进程使用的库、代码、数据等 2、假如进程申请100m的内存,但实际只使用了10m,那么它会增长100m,而不是实际的使用量 RES:resident memory usage 常驻内存 1、进程当前使用的内存大小,但不包括swap out 2、包含其他进程的共享 3、如果申请100m的内存,实际使用10m,它只增长10m,与VIRT相反 4、关于库占用内存的情况,它只统计加载的库文件所占内存大小 SHR:shared memory 共享内存 1、除了自身进程的共享内存,也包括其他进程的共享内存 2、虽然进程只使用了几个共享库的函数,但它包含了整个共享库的大小 3、计算某个进程所占的物理内存大小公式:RES – SHR 4、swap out后,它将会降下来 DATA 1、数据占用的内存。如果top没有显示,按f键可以显示出来。 2、真正的该程序要求的数据空间,是真正在运行中要使用的。 ps : 如果程序占用实存比较多,说明程序申请内存多,实际使用的空间也多。 如果程序占用虚存比较多,说明程序申请来很多空间,但是没有使用。 发现机器的自身状态不存在问题, so毋庸置疑,发现问题了,典型的内存泄漏。。 第四步,使用jmap获取jvm进程dump文件 我们使用jmap -dump:format=b,file=dump_file_name pid 命令,将当前机器的jvm的状态dump下来或缺的一份dump文件,用做下面的分析 jmap命令: jmap(JVM Memory Map)命令用于生成heap dump文件,还可以查询finalize执行队列、Java堆和永久代的详细信息,如当前使用率、当前使用的是哪种收集器等。 jmap -dump:format=b,file=dump_file_name pid : file=指定输出数据文件名, pid jvm进程号 接下来,回滚灰度的机器,开始解决问题=.= 解决问题 第一步,dump文件分析 在这里,我们分析dump文件,使用的Jprofiler软件,就是下面这个东东: 具体的使用方法,在这就不再赘述了,下面将dump文件导入到Jprofiler中: 选择Heap Walker 中的Current Object Set,这里面显示的是当前的类的占用资源,从占用空间从大到小排序; 从上图中,没有观察出什么问题,我们点击Biggest Objects,查看哪个对象的占用的内存高: 从上图中,我们发现org.janusgraph.graphdb.database.StandardJanusGraph这个对象居然占用了高达724M的内存! 看来内存泄漏八九不离十就是这个对象的问题了! 再点开看看 ,如下图,可以发现是一个openTransactions的类型为ConcurrentHashMap的数据结构: 第二步,源码查找定位代码 这到底是什么对象呢,去项目中查找一下,打开idea-打开项目-双击shift键-打开全局类查找-输入StandardJanusGraph,如下图: 发现是我们项目使用的图数据库janusgraph的一个类,找到对应的数据结构: 类型定义: private Set<StandardJanusGraphTx> openTransactions; 初始化为一个ConcurrentHashMap: openTransactions = Collections.newSetFromMap(new ConcurrentHashMap<StandardJanusGraphTx, Boolean>(100, 0.75f, 1)); 观察上述代码,我们可以看到,里面的存储的StandardJanusGraphTx从字面意义上理解是janusgraph框架中的事务对象,下面往上追一下代码,看看什么时候会往这个Map中赋值: // 找到执行openTransactions.add()的方法 public StandardJanusGraphTx newTransaction(final TransactionConfiguration configuration) { if (!isOpen) ExceptionFactory.graphShutdown(); try { StandardJanusGraphTx tx = new StandardJanusGraphTx(this, configuration); tx.setBackendTransaction(openBackendTransaction(tx)); openTransactions.add(tx); // 注意! 此处对上述的map对象进行了add return tx; } catch (BackendException e) { throw new JanusGraphException("Could not start new transaction", e); } } // 上述发现,是一个newTransaction,创建事务的一个方法,为确保起见,再往上跟找到调用上述方法的类: public JanusGraphTransaction start() { TransactionConfiguration immutable = new ImmutableTxCfg(isReadOnly, hasEnabledBatchLoading, assignIDsImmediately, preloadedData, forceIndexUsage, verifyExternalVertexExistence, verifyInternalVertexExistence, acquireLocks, verifyUniqueness, propertyPrefetching, singleThreaded, threadBound, getTimestampProvider(), userCommitTime, indexCacheWeight, getVertexCacheSize(), getDirtyVertexSize(), logIdentifier, restrictedPartitions, groupName, defaultSchemaMaker, customOptions); return graph.newTransaction(immutable); // 注意!此处调用了上述的newTransaction方法 } // 接着找上层调用,发现了最上层的方法 public JanusGraphTransaction newTransaction() { return buildTransaction().start(); // 此处调用了上述的start方法 } 在我们对图数据库中图数据操作的过程中,采用的是手动创建事务的方式,在每次查询图数据库之前,我们都会调用类似于dataDao.begin()代码, 其中就是调用的 public JanusGraphTransaction newTransaction()这个方法; 最后,我们简单的看下源码可以发现,从上述内存泄漏的map中去除数据的逻辑就是commit事务的接口,调用链如下: public void closeTransaction(StandardJanusGraphTx tx) { openTransactions.remove(tx); // 从map中删除StandardJanusGraphTx对象 } private void releaseTransaction() { isOpen = false; graph.closeTransaction(this); // 调用上述closeTransaction方法 vertexCache.close(); } public synchronized void commit() { Preconditions.checkArgument(isOpen(), "The transaction has already been closed"); boolean success = false; if (null != config.getGroupName()) { MetricManager.INSTANCE.getCounter(config.getGroupName(), "tx", "commit").inc(); } try { if (hasModifications()) { graph.commit(addedRelations.getAll(), deletedRelations.values(), this); } else { txHandle.commit(); // 这个commit方法中释放事务也是调用releaseTransaction } success = true; } catch (Exception e) { try { txHandle.rollback(); } catch (BackendException e1) { throw new JanusGraphException("Could not rollback after a failed commit", e); } throw new JanusGraphException("Could not commit transaction due to exception during persistence", e); } finally { releaseTransaction(); // // 调用releaseTransaction if (null != config.getGroupName() && !success) { MetricManager.INSTANCE.getCounter(config.getGroupName(), "tx", "commit.exceptions").inc(); } } } 终于,我们找到了内存泄漏的根源所在:项目代码中存在调用了事务begin但是没有commit的代码! 第三步,修复问题验证 解决问题: 找到内存泄漏接口的代码,并发现了没有commit()的位置,try-catch-finally中添加上了commit()代码; 提交-部署-发布-灰度一台机器后观察内存泄漏的现象消失,GC回收正常; 内存泄漏问题解决,项目如期上线~ 最后 大家,有没有遇到过内存泄漏的情况,欢迎在评论区说出你的故事=.= 写这篇文章耗费的时间超出了我的预料,预计2个小时写完,结果花了一下午的时间... 原创不易,如果大家有所收获,希望大家可以点赞评论支持一下~ 也欢迎大家关注我的oschina和微信搜索公众号[匠心Java]支持一下作者,作者定期分享工作中的所见所得~

优秀的个人博客,低调大师

上云双引擎(上)- 如何从单台ECS转换成业务高可用架构

背景 传统的互联网业务,无论是APP应用还是web应用,很多中小型企业对于云服务还是处于一个“懵懂”时期,基本上所有的应用部署都依然延用的线下的那一套,例如数据库自建,中间件自建,存储自建;如果业务都是单点部署,不管是数据安全、还是业务的稳定性,都难以得到保障。 业务价值 对多台云服务器进行流量分发的多可用区高可用版的负载均衡,可以通过流量分发扩展应用系统对外的服务能力,通过消除单点故障提升应用系统的可用性,自动跨可用区部署更是加强了业务容灾能力。 通过自定义镜像,可以迅速复制出相同应用部署的ECS云服务器实例,同时添加到SLB后端服务器组中,实现业务高可用。 SLB可以同时配置四层和七层监听,及轮循、加权轮循、加权最小连接数三种算法,合理分配后端ECS计算资源。 使用云数据库RDS,针对高并发场景进行特殊优化,同时引入线程池、并行复制、隐含

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册