首页 文章 精选 留言 我的

精选列表

搜索[AI驱动],共10000篇文章
优秀的个人博客,低调大师

赋能工业物联网 | 数据驱动,加速智能制造

行业背景 工业物联网场景下,随着智能设备及物联网技术的广泛应用,数据是最重要的资源之一,企业需要对各种机器、设备和传感器产生的时序数据进行采集、存储与分析。 因此,何为行之有效的数据库解决方案?企业普遍更为关注如何处理并分析由众多设备采集而来的数据进而优化生产流程、提升管理效能,进而实现“智能制造”。与此同时,这些方向也为带来了诸如数据安全、数据质量、数据管理等在内的新挑战。 痛点与挑战 1. 数据存储和管理难 面临多种类型的数据、协议和系统,难以实现统一的数据采集和存储管理,导致数据汇总和存储困难。 2.数据实时分析要求高 原有系统仅将数据进行存储而未进行有效利用,导致数据利用率低,无法及时辅助管理人员做出决策。传统工业物联网场景数据需极高实时处理和分析,以实现设备调度、预警系统等功能。 3. 多库应用和运维成本高 多库应用要求开发者需掌握多种数据库模型和技术实践的挑战,DBA 也需承担不同数据库的运维规则,导致高昂的开发运维成本。此外,多库间数据传输和转换涉及多副本管理,易出错且难以保证性能和数据一致性。 4. 人员和产线工作统计困难 生产环节不透明导致产能下降,产线工人虚报工时,设备运行情况需要人工统计,缺乏数据支持的排程往往通过主观臆断规定产品交期,进而导致设备利用率和工作饱和度降低。 解决方案 1.实时数据处理和分析 通过建设多协议集成的数据平台,实现多源异构数据接入,同时利用 KaiwuDB+KDP 的就地计算和实时分析技术,实现生产数据的高速存储和实时分析,有效提高数据利用率,并支持管理层制定即时决策。 2.数据汇入与分析同步进行 通过实时分析技术,将数据存储和分析同时进行,解决原有系统仅存储数据而未进行有效利用的问题,提高数据利用率,并使数据展示更加及时。 3.KaiwuDB 多引擎+弹性扩展 利用 KaiwuDB 的多引擎特性,实现一库多用,降低多库应用的运维成本。同时,支持弹性扩展,满足数据增长需求,解决性能扩展受限的问题。 4.产线运行数据接入分析 将操作台运行数据入库统计并分析,实现对一线工人的工时和产线运行状况的综合研判,解决虚报工时和产线不透明的问题,提高产能和效率。 方案价值 1. 数据平滑迁移和统一管理 将原系统的大量历史数据统一迁移至 KaiwuDB,实现一库多用,减少数据存储成本,并提供统一的数据管理平台,便于数据的维护和查询。 2. 高效数据接入和入库性能提升 通过 KaiwuDB 多协议集成方案,实现各类设备接入并高效汇入数据,保证大规模数据的高速入库,提高数据采集效率和实时性。 3. 数据全面采集和协同管理 实现工厂各作业环境的数据全面采集,将生产数据与运营管理数据进行关联,实现数据的协同分析和管理,提高生产效率和响应速度。 4. 高效数据分析和性能提升 系统支持复杂场景数据聚合分析和海量数据实时分析,通过 KaiwuDB+KDP 的技术,提升查询和分析性能。减少了异常停机,提高了设备利用率,从而提升数据可用性和服务能力。 https://www.bilibili.com/video/BV1HH4y1X79Y/?spm_id_from=333.999.0.0

优秀的个人博客,低调大师

“数据驱动”时代,企业为什么需要实时湖仓?

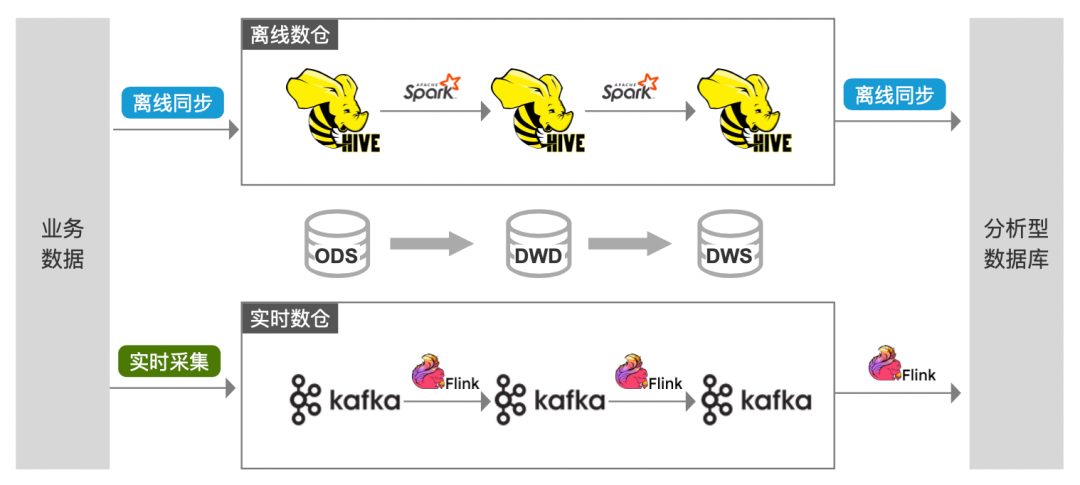
当谈到数据湖的时候,大家都在说,可以把所有数据(结构化/半结构化/非结构化)一股脑都丢进去,进行统一的元数据管理。然后上层计算对接,进行流批计算/OLAP 分析/算法分析。 这个没问题,数据湖确实能承接底层的这部分能力,但是同时出现的问题也是不容忽视的。 本文将关注讨论,利用湖仓架构,统一结构化/半结构化数据的流批计算,和大家聊聊为什么企业需要实时湖仓。非结构化的视频/图片/文本等数据的存储和计算不在本文的讨论范围内。 当前的企业困境 下图是一个经典的 Lambda 架构,虽然这套架构的优点很明显:技术方案成熟、应用实践广泛,适用于企业发展过程中各阶段、各场景下的大数据开发需求。 但是,随着业务对数据时效性要求的提高,许多企业的实时任务体量,正在逐步接近存量离线任务。在数据开发和运维资源有限的情况下,这套架构的问题正在逐渐暴露出来: · 离线开发链路中的数据更新问题,在当前技术环境下显得越来越难以容忍 · 实时开发链路中的数据不落地问题,无法支持历史数据回溯、查询分析等场景 · 多种计算引擎,造成数据开发学习成本和运维管理成本的居高不下 · 多种存储介质,造成数据存储冗余、批/流数据不一致 · …… 解决之道:实时湖仓 下图是一种实时湖仓解决方案,利用湖存储的特性和 Flink 的流批计算能力,统一存储和计算,解决 Lambda 架构的问题。 本文以 Paimon 为例,Paimon 是 Flink 内部基于 Flink Tablestore 孵化的一款湖存储产品。和 Hudi/Iceberg 相比,Paimon 和 Flink 引擎有着更完整的兼容能力。 下面将就袋鼠云的实践经验,展开说说如何使用“Flink+数据湖”三步构建实时湖仓。 ● Step1:搭建实时 ODS 层 不管是通过 Flink 消费 Kafka,还是通过 FlinkCDC 采集日志,都可以将源库数据实时同步至 Paimon 中。 这样,无论上层是要做批计算还是流计算,都有份统一的实时 ODS 数据做基础,避免了数据不一致和存储冗余的问题。 ● Step2:加工湖仓中间层 关于实时湖仓的层级设计,可以参考成熟的离线数仓划分方案。 从上面的架构图中可以看出,Paimon 存储将文件分为 DataFile 和 LogFile: · DataFile 用于存量数据的批计算 · LogFile 用于增量数据的流计算,但毕竟是一种文件存储格式,其实时性只能做到分钟级别。如果业务场景对实时性有秒级/毫秒级要求,Paimon 也支持将 Kafka 外挂为 LogFile 使用,同时对上层应用暴露的,仍然只有一张 Paimon 表。 基于上面的特性,如何在实际应用体现出流/批一体能力,可以参考如下几种开发场景: 01 流、批独立任务 根据实际业务场景需要,使用 Flink+Paimon 的统一技术栈,进行离线任务和实时任务的独立开发。 02 批流一体任务 在很多实时统计类的数据开发场景下,往往需要在完成存量数据统计的基础上,再衔接实时增量计算。传统的 Lambda 架构要完成这种场景,实现上相对比较复杂,而使用 Flink+Paimon,一个任务即可满足。 03 流批一体任务 传统的 Lambda 架构中,为了保障 Flink+Kafka 实时计算的准确性,往往需要将 Kafka 数据双写一份到离线存储中,然后通过离线定时任务对实时计算结果做一次覆盖修正。而使用 Flink+Paimon,一个任务即可满足。 ● Step3:湖仓分析应用层 这层有两种不同的落地方案,可以根据企业技术栈自由选型: · ADS 层数据也在数据湖加工落地,然后使用 OLAP 引擎如 Trino、StarRocks 直接对接数据湖,向上层提供数据分析能力。这样做可以实现存储的完全统一,但是在查询分析性能上会有一定的牺牲。 · 将 DWS 层数据加工后打入 StarRocks 或者 ClickHouse 这类存储+分析的统一引擎。该方案可以充分利用这类引擎的查询加速能力,对于 OLAP 场景有较高要求的企业,是个比较合适的方案。 企业的其他选择? 目前业内比较热门的探索实践,不依赖 Hadoop 体系,仅利用 StarRocks/Doris 构建实时数仓的方式,大致的架构图如下: 理论上,该方案确实可行。StarRocks/Doris 本身作为计算+存储一体的引擎,具备向量化、MPP 架构、CBO、智能物化视图、可实时更新等能力,在一定程度上可以满足构建实时数仓的要求。 但是,在我们接触过的一些金融客户的实际应用中发现,当数据体量较大、视图逻辑较复杂时,该方案存在明显的性能瓶颈。 而根据 StarRocks/Doris 官网对自己高性能分析型数仓的定位,将它作为企业 OLAP 的选型,完全没有问题,但是寄希望于它承担全链路的大数据计算,目前来看还有很长的路要走。 所以,将实时湖仓部分层级的计算,前移至“Flink+数据湖”的架构中,仍然是当前技术方案中最优的选择。 本文根据《实时湖仓实践五讲第一期》直播内容总结而来,感兴趣的朋友们可免费获取直播课件: 直播课件: https://www.dtstack.com/resources/1050?src=szsm 《数栈产品白皮书》:https://www.dtstack.com/resources/1004?src=szsm 《数据治理行业实践白皮书》下载地址:https://www.dtstack.com/resources/1001?src=szsm 想了解或咨询更多有关袋鼠云大数据产品、行业解决方案、客户案例的朋友,浏览袋鼠云官网:https://www.dtstack.com/?src=szkyzg 同时,欢迎对大数据开源项目有兴趣的同学加入「袋鼠云开源框架钉钉技术qun」,交流最新开源技术信息,qun号码:30537511,项目地址:https://github.com/DTStack

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册