首页 文章 精选 留言 我的

精选列表

搜索[禅道],共6189篇文章
优秀的个人博客,低调大师

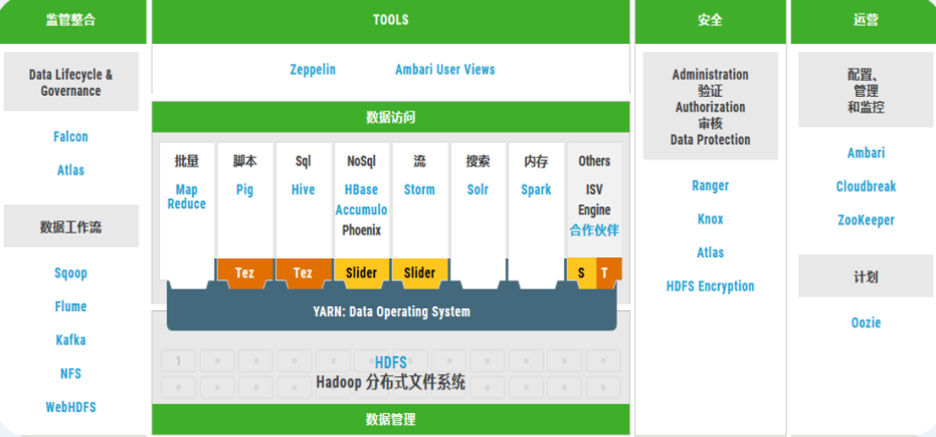
提前突击了这近200道大数据面试题,果然头条、京东都给了Offer

面试题包括Java、大数据开发、大数据运维、大数据分析、大数据架构等等 Q1:老师线上 6000+规模集群,抛开一些其它组件集群,仅讨论 HDFS 数据存储集群,保守理应也在有 3000 节点左右,想知道这些存储节点只是单集群NameNode 集群来维护吗?还是多集群独立维护的,如果是多集群存储数据,它们之间数据是如何打通进行关联的?如果仅是一个集群的话,我想知道这个集群的 NameNode 上的配置,是如何 Hold 住这些数据 DataNode的? 夏天老师: 我们的集群也是用的 Cloudera 公司的,我们付了费用, Cloudera 没有保障说 CM 能够纳管 1000 节点以上的集群,再加上我们的机房有容量限制,所以我们是建了多套集群,最大集群有 800+节点,最小集群也有 300+节点;800+datanode 下, namenode 是可以支撑的,像一些互联网大厂,字节跳动、京东等他们的单集群规模有上万节点,此时就需要对 hdfs 进行深度定制了,他们改了很多源码,而且有 200+高级技术维护人员; 多集群建设要考虑业务情况,比如我们公司有 10 个以上业务, 5 大核心集群,按业务相关情况划分集群,不过也难免有跨集群的作业,目前公司内部自研发了大数据采集交换平台,你也可以使用 distcp 进行数据对拷,目前我们也正在准备自研发多集群并行混算平台。 Q2:集群线上扩容如何达到自动化?线上扩容,规模正常都以 10+以上,如果都以课堂所示,人肉操作,时间投入与产出比不匹配,人力造成很大的不必要浪费,想学习老师线上集群实际扩容的方案。 夏天老师: 课堂所示兼顾了小白同学,所以是手把手纯人肉搭建,产线环境扩容数量少则几十多则上百,人肉肯定不行,我们公司的运维分为 IAAS 运维、大数据运维、应用运维,大数据运维工程师在扩容集群时,需要向 IAAS 运维工程师以工单的方式申请服务器并提出自己的需求, IAAS 运维工程师在提供服务器时不管是新采购服务器还是其他集群退役的服务器都需要重装系统,重装系统的镜像是针对大数据定制的,镜像包含了大数据运维工程师的通用需求以及安装操作系统后的网络、磁盘以及其他设置,比如关闭防火墙、时钟同步、同构磁盘挂载、关闭大透明页、关闭 SWAP、公用 YUM 源、禁用 SELinux 等模式化操作,大数据运维工程师收到服务器后准备工作基本准备完毕了,进行少量准备工作就可以直接进入了 CM 可视化批量安装模式,比如脚本批量设置hostname、脚本同步/etc/hosts 文件等; 当然如上所说的 IAAS 操作,如关闭防火墙、时钟同步、同构磁盘挂载、关闭大透明页、关闭 SWAP、公用YUM 源、禁用 SELinux 都可以脚本化,无非就是使用 SSH 通讯方式设置,这就需要大数据运维同学熟练使用 shell 了。 Q3:已知一个 HDFS 的目录,想知道此目录下的文件数,而且存储于哪些DataNode 节点上。 夏天老师: 1.查看文件数使用 count 命令,如下查看/ops 目录,目录数为 9606,文件数为 1353 万+,总文件大小为 9.7P 2.查看/ops/test 目录下的文件存储的位置hdfs fsck /ops/test -files -blocks -locations -racks Q4:DataNode 单节点,存储容量大小与当前节点上的 CPU,内存硬件之间有什么样的关系,磁盘扩容很容易,但这不意味着单节点上数据盘就可以无限地扩容,因此在这方面,有什么实际线上的经验分享,即这三者间可以遵循怎样合适的关系 夏天老师: 从我们内部实践来说没有发现三者之间的规律,因为大数据业务每个公司都不一样,有的计算是 CPU 密集型的,有的计算是内存密集型的、有的计算是IO 密集型的;我们的服务器都是中高配置,每个服务器的磁盘是 4Tx10、 CPU24core、128G 内存 Q5: HDFS 存储节点上的数据,存储压缩格式是如何选取的,默认采用哪种文件存储类型与存储格式,冷热数据如何界定的? 夏天老师: 我们产线环境用了 gz 和 snappy 压缩格式, gz 用于不常用的冷数据,snappy 用于热数据;冷热数据是跟业务相关的,后续集群治理的课程中也有冷热数据的区分。 Q6:课堂上看到 HDFS 集群的 DataNode 与 HBASE 是集成在一起部署的,我好奇, HBase 面向的都是高频率读写的业务,老师确定部署一起后,线上业务没有出现过问题吗? 夏天老师: 你应该是理解错了, HBase 不能跟 YARN 在一起部署; HBase 需要跟HDFS 部署在一起的,这样可以利用数据本地性提升 IO 性能,并且可以降低网络延迟,降低带宽负载。 Q7: Yarn 集群计算层,目前集群面向用户使用群体少,故白天仅是数据写入,集群 CPU 资源都较为存在大量冗余状态,但对于凌晨执行集中高频提交跑批作业计算任务时,集群的 CPU 资源明显不够,甚至引起节点 CPU 负载过高导致节点的宕机,从而造成集群雪崩。简单来说,白天集群资源使用率在5%,凌晨执行高频跑批作业任务时,资源使用率上到 100%,引起集群宕机。在不增加资源的前提下,资源老师会如何划分队列? 夏天老师: 这个划分队列无法解决根本问题,建议将业务划分优先级,错开时间执行。 Q8.某一台 CDH 物理机 12 块 RAID0 硬盘,如果其中有 4 块 RAID0 硬盘同时损坏,请问接下来大数据运维人员的详细处理流程是什么? 夏天老师: HDFS 有个参数 dfs.datanode.failed.volumes.tolerated,值为 0 的时候表示当有任何盘损坏后 datanode 则停止服务,如果 4 快盘同时损坏了,此时datanode 进程已经停止了,你可以修改 hdfs-site.xml 配置文件将损坏的磁盘路径去掉,重启 datanode 即可,然后进入磁盘报修流程,待磁盘更换后,停止 datanode,在 hdfs-site.xml 配置文件中假如新的磁盘,启动 datanode 即可。 Q9.CDH 如果为开发人员提供 HIVESERVER2 服务,可以让开发人员通过beeline 命令访问? 夏天老师: 是的, beeline 使用 JDBC 协议来连接 HIVESERVER2 Q10.在晚高峰期 HDFS 集群会出现某些 datanode 不稳定的情况,频繁有datanode 脱离节点,该如何处理呢? 夏天老师: 需要找到 datanode 的具体原因, datanode 相对来说还是比较稳定的,需要看下是否是 GC 问题,如果是的话适当调大内存,再看下最大的打开文件数或进程数的限制是否太小 Q11.CDH 集群扩容 10 台机器后,新加入的 Datanode 角色数据相对较少,如何处理 HDFS 的数据分布不均衡的现象呢? 夏天老师: 在内存占用较低的节点上启动 balancer 脚本,将 HDFS 中所有节点的存储值中的最低值和平均值的差值设置为 5%。命令: ./start-balancer.sh -threshold 5 Q12.CDH 监控项从某种角度来说并不是很细粒度,老师课上可能时间有限等原因只是稍微提了一下监控思路,请问您线上是如何监控的呢,能将详细步骤给我们刨析一下吗? 夏天老师: 目前我们产线环境还是以 CDH 监控为主, CDH 的指标还是挺多的,只不过保留的周期不长,对于排障来说基本够用了,当然我们会推进一些监控工具,不过在课堂不会展开细讲,后续有 Flink 监控方面的实战。 Q13.如何基于 CDH 集群监控大量的小文件的呢?衡量小文件标准,以及出现大量小文件在生产环境该如何解决呢? 夏天老师: CM 解决不了大量小文件的监控,需要额外做其他工作,这块在集群治理里面我们会详细讲;对于怎么衡量小文件的标准,你可以简单认为小于 blocksize 的文件就是小文件,但是在企业真实情况下小文件问题可能更加严重,比如大量 10M、几十 M 以下的文件,单纯技术无法解决问题,需要组织协同,这个在集群治理里面我们会详细讲。 Q14.之前上课只是大致提了一下 YARN 资源调度,生产环境使用 CDH 如何配置 YARN 资源队列调度,在咱们后续的课程还会讲吗? 夏天老师: 这个会讲解的,也会讲解我们产线环境是如何划分队列的。 Q15.CDH 如何对 HDFS 各级目录做权限管理,目录的配额(即使用 HDFS 的容量限制)限制呢? 夏天老师: HDFS 可通过 ACL 精细控制目标权限,除了 ACL 后续我们也会讲sentry;目前我们产线环境没有做容量配额限制,怕影响生产,我们通过集群治理来解决容量问题,集群治理是我们的课程内容之一,后续会讲解 Q16.Hdfs,Yarn,MapReduce,Hive,Spark,Storm,Kafka,Flink 这些组件您在生产环境的调优参数是如何配置的,后续会为我们分享一些调优参数及说明么?我们也方便对照自己的集群作为参考适当调整。 夏天老师: 这个是会的,我们会讲组件的运维、巡检、监控、参数配置、故障排查等课程内容。 Q17.后期的大数据组件监控项目是针对课上所有的组件进行监控的么?还是只是分享监控思路,代码能给我们学员吗? 夏天老师: 大数据组件监控主要在 CM 上进行监控,后续有集群治理案例实战,实战代码可以给学员的。 未完待续………

优秀的个人博客,低调大师

AI无间道!清华AI团队推出AI安全平台,欺骗顶尖人脸算法后又强势修复漏洞

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 随着人工智能技术的发展,人工智能在很多场景里正逐渐替代或协作着人类的各种劳动,它们可以成为人类的眼睛、耳朵、手臂甚至大脑。其中,机器视觉作为AI时代的基础技术,其背后的AI算法一直是各科技巨头和创业公司共同追逐的热点。然而,这些主流应用场景的背后,往往也藏着由技术性缺陷导致的算法安全风险。 例如,在一些训练数据无法覆盖到的极端场景中,自动驾驶汽车可能出现匪夷所思的决策,导致乘车人安全风险。从2016年至今,Tesla、Uber等企业的辅助驾驶和自动驾驶系统就都曾出现过类似致人死亡的严重事故。并且这类极端情形也可能被恶意制造并利用,发起“对抗样本攻击”,去年7月,百度等研究机构就曾经通过3D打印,能让自动驾驶“无视”的障碍物,使车辆有发生撞击的风险,同样威胁行驶安全。 之所以能攻击成功,主要是机器视觉和人类视觉有着很大的差异。因此可以通过在图像、物体等输入信息上添加微小的扰动改变(即上述故意干扰的“对抗样本”),就能导致很大的算法误差。此外,随着AI的进一步发展,将算法模型运用于更多类似金融决策、医疗诊断等关键核心场景,这类AI“漏洞”的威胁将愈发凸显出来。 近几年来,包括清华大学人工智能研究院院长张钹院士、前微软全球执行副总裁沈向洋等均提倡要发展安全、可靠、可信的人工智能以及负责任的人工智能,其中AI的安全应用均是重点方向。 然而AI安全作为一个新兴领域,尽管对抗样本等攻击手段日益变得复杂,在开源社区、工具包的加持下,高级攻击方法快速增长,相关防御手段的普及和推广却难以跟上。在AI算法研发和应用的过程中,对抗样本等算法漏洞检测存在较高的技术壁垒,目前市面上缺乏自动化检测工具,而大部分企业与组织不具备该领域的专业技能来妥善应对日益增长的恶意攻击。 一、从安全评测到防御升级,RealSafe让AI更加安全可控 为了解决以上痛点,近日,清华大学AI研究院孵化企业RealAI(瑞莱智慧)正式推出首个针对AI在极端和对抗环境下的算法安全性检测与加固的工具平台——RealSafe人工智能安全平台。 据了解,该平台内置领先的AI对抗攻防算法,提供从安全测评到防御加固整体解决方案,目前可用于发现包括人脸比对等在内的常用AI算法可能出错的极端情形,也能预防潜在的对抗攻击。 RealAI表示,就如网络安全时代,网络攻击的大规模渗透诞生出杀毒软件,发现计算机潜在病毒威胁,提供一键系统优化、清理垃圾跟漏洞修复等功能,RealSafe研发团队希望通过RealSafe平台打造出人工智能时代的“杀毒软件”,为构建人工智能系统防火墙提供支持,帮助企业有效应对人工智能时代下算法漏洞孕育出的“新型病毒”。 RealSafe平台目前主要支持两大功能模块:模型安全测评、防御解决方案。 其中,模型安全评测主要为用户提供AI模型安全性评测服务。用户只需接入所需测评模型的SDK或API接口,选择平台内置或者自行上传的数据集,平台将基于多种算法生成对抗样本模拟攻击,并综合在不同算法、迭代次数、扰动量大小的攻击下模型效果的变化,给出模型安全评分及详细的测评报告(如下图)。目前已支持黑盒查询攻击方法与黑盒迁移攻击方法。 防御解决方案则是为用户提供模型安全性升级服务,目前RealSafe平台支持五种去除对抗噪声的通用防御方法,可实现对输入数据的自动去噪处理,破坏攻击者恶意添加的对抗噪声。根据上述的模型安全评测结果,用户可自行选择合适的防御方案,一键提升模型安全性。另外防御效果上,根据实测来看,部分第三方的人脸比对API通过使用RealSafe平台的防御方案加固后,安全性可提高40%以上。 随着模型攻击手段在不断复杂扩张的情况下,RealSafe平台还持续提供广泛且深入的AI防御手段,帮助用户获得实时且自动化的漏洞检测和修复能力。 二、“对抗样本”成“AI病毒”,国外主流人脸识别算法相继被“攻破” 站在人脸识别终端前,通过人脸识别摄像头完成身份校验,类似的人脸识别身份认证已经覆盖到刷脸支付、酒店入住登记、考试身份核验、人证比对等等生活场景中。 考虑到公众对于对抗样本这一概念可能比较模糊,RealSafe平台选取了公众最为熟知的人脸比对场景(人脸比对被广泛用于上述的身份认证场景中)提供在线体验。并且,为了深入研究“对抗样本”对人脸比对系统识别效果的影响,RealAI 团队基于此功能在国外主流 AI 平台的演示服务上进行了测试。 选取一组不同的人脸图片(如下图),通过RealSafe平台对其中一张图片生成对抗样本,但不影响肉眼判断,添加“对抗样本”前后分别输入到第三方人脸比对平台中查看相似度。 最终结果显示,添加“噪声”前,两张图片被 Azure 判定为不属于同一个人,但添加“噪声”后,以上两个平台的演示服务均给出了错误的结果,认为两张图片属于同一个人,甚至 Azure 平台的演示服务在添加“噪声”前后相似度变化的幅度高达70%以上。 为了探究结果的普适性,RealAI团队又选取了国内三家主流人脸比对平台进行测试,结果同样显示,添加扰动之后,原本判定为“不同人脸”的图片均被错误识别为“相同人脸”,前后相似度的变化幅度可达到20%以上。而通过RealSafe防火墙“去噪”过滤后,这几个人脸比对平台的识别“误差”获得不同程度的纠正,识别效果得到稳定提升。 RealAI团队已经将这种潜在风险以及相关防御方法反馈给上述企业,以帮助降低风险。 实测证明,“对抗样本”可以极大的干扰人脸比对系统的识别结果,据介绍,目前市面上很多中小型企业在落地人脸识别应用时大多会选择采用上文测试的这几家互联网公司开放的人脸比对SDK或者API接口,如果他们人脸比对技术存在明显的安全漏洞,意味着更广泛的应用场景将存在安全隐患。 除了人脸比对外,对抗样本攻击还可能出现在目标检测的应用场景中,延伸来看,这可能会危害到工业、安防等领域的安全风险检测。比如某电网的输电塔的监控系统,由于输电塔的高安全性防护要求,防止吊车、塔吊、烟火破坏输电线路,需要对输电塔内外进行全天候的实时监控,而这实时监控系统背后就是基于目标检测的AI算法来提供保障。 而RealAI研究团队发现,只要通过RealSafe对其中的目标检测算法进行一定的对抗样本攻击,就会造成监控系统失效,导致其无法识别非常明显的烟火情形,类似情形如果真实发生,将可能带来难以估计的损失。 事实上,像以上提到的这些AI安全风险由于都是AI底层算法存在技术缺陷而导致,往往比较隐蔽,但牵一发动全身,这些“难以预见”的风险漏洞最有可能成为被攻破的薄弱环节,而RealSafe平台同步推出的防御解决方案则可以有效增强各应用领域中AI算法的安全性。 三、“零编码”+“可量化”,两大优势高效应对算法威胁 据介绍,RealAI此次推出的算法模型安全检测平台,除了可以帮助企业高效应对算法威胁还具备以下两大优势: 组件化、零编码的在线测评:相较于ART、Foolbox等开源工具需要自行部署、编写代码,RealSafe平台采用组件化、零编码的功能设置,免去了重复造轮子的精力与时间消耗,用户只需提供相应的数据即可在线完成评估,极大降低了算法评测的技术难度,学习成本低,无需拥有专业算法能力也可以上手操作。比如上文中针对微软、亚马逊等第三方平台的测试,整个流程按照步骤提示完成,只需几分钟就可以查看到测评结果。 可视化、可量化的评测结果:为了帮助用户提高对模型安全性的概念,RealSafe平台采用可量化的形式对安全评测结果进行展示,根据模型在对抗样本攻击下的表现进行评分,评分越高则模型安全性越高。此外,RealSafe平台提供安全性变化展示,经过防御处理后的安全评分变化以及模型效果变化一目了然。 四、落地安全周边产品,为更多场景保驾护航 其实对抗样本原本是机器学习模型的一个有趣现象,但经过不断的升级演化,“对抗样本”已经演变成一种新型攻击手段,并从数字世界蔓延到物理世界:在路面上粘贴对抗样本贴纸模仿合并条带误导自动驾驶汽车拐进逆行车道、胸前张贴一张对抗样本贴纸在监控设备下实现隐身…… 所以,除了针对数字世界的算法模型推出安全评测平台,RealAI团队也联合清华大学AI研究院围绕多年来积累的领先世界的研究成果落地了一系列AI攻防安全产品,旨在满足更多场景的AI安全需求。 比如,攻击技术方面,RealAI团队实现了世界首个通过“对抗样本”技术实现破解商用手机刷脸解锁,让手机将佩戴“特制眼镜”的黑客误识为机主。 △ 图:世界唯一通过AI对抗样本技术攻破商用手机人脸解锁案例 通过在目标人服装上张贴特制花纹使AI监控无法检测到该人物,实现“隐身”,以及通过在车辆上涂装特殊花纹,躲避AI对车辆的检测。 △ 图:通过AI对抗样本图案躲避AI车辆检测 在发现以上各种新型漏洞的同时,RealAI也推出相应的防御技术,支持对主流AI算法中的安全漏洞进行检测,并提供AI安全防火墙对攻击AI模型的行为进行有效拦截。 人工智能的大潮滚滚而来,随之而来的安全风险也将越来越多样化,尤其近年来因AI技术不成熟导致的侵害风险也频频发生,可以说,算法漏洞已逐渐成为继网络安全、数据安全后又一大安全难题。 所幸的是,以RealAI为代表的这些顶尖AI团队早已开始了AI安全领域的征程,并开始以标准化的产品助力行业降低应对安全风险的门槛与成本。此次上线RealSafe人工智能安全平台是RealAI的一小步尝试,但对于整个行业而言,这将是人工智能产业迈向健康可控发展之路的一大步。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-07本文作者:允中本文来自:“量子位公众号”,了解相关信息可以关注“公众号 QbitAI”

优秀的个人博客,低调大师

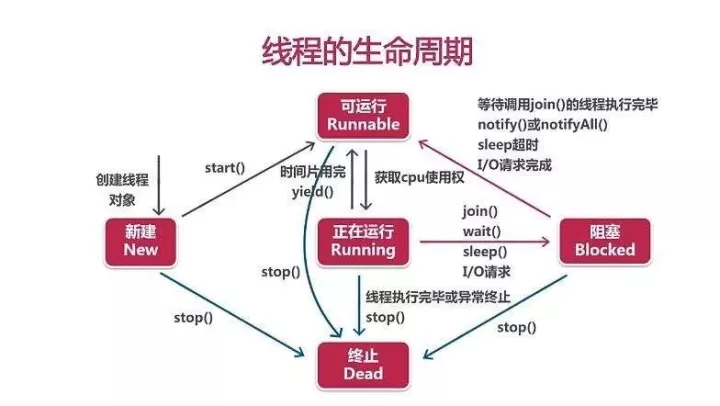
一线大厂面试官最喜欢问的15道Java多线程面试题

前言 在任何Java面试当中多线程和并发方面的问题都是必不可少的一部分。如果你想获得更多职位,那么你应该准备很多关于多线程的问题。他们会问面试者很多令人混淆的Java线程问题。面试官只是想确信面试者有足够的Java线程与并发方面的知识,因为候选人中有很多只浮于表面。现在引用Java5并发包关于并发工具和并发集合的问题正在增多。那些问题中ThreadLocal、Blocking Queue、Counting Semaphore和ConcurrentHashMap比较流行。 Java多线程面试题及回答 1.现在有T1、T2、T3三个线程,你怎样保证T2在T1执行完后执行,T3在T2执行完后执行?这个线程问题通常会在第一轮或电话面试阶段被问到,目的是检测你对”join”方法是否熟悉。这个多线程问题比较简单,可以用join方法实现。 2. 在Java中Lock接口比synchronized块的优势是什么?你需要实现一个高效的缓存,它允许多个用户读,但只允许一个用户写,以此来保持它的完整性,你会怎样去实现它?lock接口在多线程和并发编程中最大的优势是它们为读和写分别提供了锁,它能满足你写像ConcurrentHashMap这样的高性能数据结构和有条件的阻塞。Java线程面试的问题越来越会根据面试者的回答来提问。我强烈建议在你去参加多线程的面试之前认真读一下Locks,因为当前其大量用于构建电子交易终统的客户端缓存和交易连接空间。 3.在java中wait和sleep方法的不同?通常会在电话面试中经常被问到的Java线程面试问题。最大的不同是在等待时wait会释放锁,而sleep一直持有锁。Wait通常被用于线程间交互,sleep通常被用于暂停执行。 4.用Java实现阻塞队列。这是一个相对艰难的多线程面试问题,它能达到很多的目的。第一,它可以检测侯选者是否能实际的用Java线程写程序;第二,可以检测侯选者对并发场景的理解,并且你可以根据这个问很多问题。如果他用wait()和notify()方法来实现阻塞队列,你可以要求他用最新的Java 5中的并发类来再写一次。 5.用Java写代码来解决生产者——消费者问题。与上面的问题很类似,但这个问题更经典,有些时候面试都会问下面的问题。在Java中怎么解决生产者——消费者问题,当然有很多解决方法,我已经分享了一种用阻塞队列实现的方法。有些时候他们甚至会问怎么实现哲学家进餐问题。 6.用Java编程一个会导致死锁的程序,你将怎么解决?这是我最喜欢的Java线程面试问题,因为即使死锁问题在写多线程并发程序时非常普遍,但是很多侯选者并不能写deadlock free code(无死锁代码?),他们很挣扎。只要告诉他们,你有N个资源和N个线程,并且你需要所有的资源来完成一个操作。为了简单这里的n可以替换为2,越大的数据会使问题看起来更复杂。通过避免Java中的死锁来得到关于死锁的更多信息。 7.什么是原子操作,Java中的原子操作是什么?非常简单的java线程面试问题,接下来的问题是你需要同步一个原子操作。 8.Java中的volatile关键是什么作用?怎样使用它?在Java中它跟synchronized方法有什么不同?自从Java 5和Java内存模型改变以后,基于volatile关键字的线程问题越来越流行。应该准备好回答关于volatile变量怎样在并发环境中确保可见性、顺序性和一致性。 9.什么是竞争条件?你怎样发现和解决竞争?这是一道出现在多线程面试的高级阶段的问题。大多数的面试官会问最近你遇到的竞争条件,以及你是怎么解决的。有些时间他们会写简单的代码,然后让你检测出代码的竞争条件。可以参考我之前发布的关于Java竞争条件的文章。在我看来这是最好的java线程面试问题之一,它可以确切的检测候选者解决竞争条件的经验,or writing code which is free of data race or any other race condition。关于这方面最好的书是《Concurrency practices in Java》。欢迎关注我的公中浩【程序员追风】,文章都会在里面更新,整理的资料也都会放在里面。 10.你将如何使用thread dump?你将如何分析Thread dump?在UNIX中你可以使用kill -3,然后thread dump将会打印日志,在windows中你可以使用”CTRL+Break”。非常简单和专业的线程面试问题,但是如果他问你怎样分析它,就会很棘手。 11.为什么我们调用start()方法时会执行run()方法,为什么我们不能直接调用run()方法?这是另一个非常经典的java多线程面试问题。这也是我刚开始写线程程序时候的困惑。现在这个问题通常在电话面试或者是在初中级Java面试的第一轮被问到。这个问题的回答应该是这样的,当你调用start()方法时你将创建新的线程,并且执行在run()方法里的代码。但是如果你直接调用run()方法,它不会创建新的线程也不会执行调用线程的代码。 12.Java中你怎样唤醒一个阻塞的线程?这是个关于线程和阻塞的棘手的问题,它有很多解决方法。如果线程遇到了IO阻塞,我并且不认为有一种方法可以中止线程。如果线程因为调用wait()、sleep()、或者join()方法而导致的阻塞,你可以中断线程,并且通过抛出InterruptedException来唤醒它。我之前写的《How to deal with blocking methods in java》有很多关于处理线程阻塞的信息。 13.在Java中CycliBarriar和CountdownLatch有什么区别?这个线程问题主要用来检测你是否熟悉JDK5中的并发包。这两个的区别是CyclicBarrier可以重复使用已经通过的障碍,而CountdownLatch不能重复使用。 14.什么是不可变对象,它对写并发应用有什么帮助?另一个多线程经典面试问题,并不直接跟线程有关,但间接帮助很多。这个java面试问题可以变的非常棘手,如果他要求你写一个不可变对象,或者问你为什么String是不可变的。 15.你在多线程环境中遇到的共同的问题是什么?你是怎么解决它的?多线程和并发程序中常遇到的有Memory-interface、竞争条件、死锁、活锁和饥饿。问题是没有止境的,如果你弄错了,将很难发现和调试。这是大多数基于面试的,而不是基于实际应用的Java线程问题。 最后欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

20道BAT面试官最喜欢问的JVM+MySQL面试题(含答案解析)

1. 内存模型以及分区,需要详细到每个区放什么。JVM 分为堆区和栈区,还有方法区,初始化的对象放在堆里面,引用放在栈里面,class 类信息常量池(static 常量和 static 变量)等放在方法区new: 方法区:主要是存储类信息,常量池(static 常量和 static 变量),编译后的代码(字节码)等数据 堆:初始化的对象,成员变量 (那种非 static 的变量),所有的对象实例和数组都要在堆上分配 栈:栈的结构是栈帧组成的,调用一个方法就压入一帧,帧上面存储局部变量表,操作数栈,方法出口等信息,局部变量表存放的是 8 大基础类型加上一个应用类型,所以还是一个指向地址的指针 本地方法栈:主要为 Native 方法服务 程序计数器:记录当前线程执行的行号 2. 堆里面的分区:Eden,survival (from+ to),老年代,各自的特点。堆里面分为新生代和老生代(java8 取消了永久代,采用了 Metaspace),新生代包含 Eden+Survivor 区,survivor 区里面分为 from 和 to 区,内存回收时,如果用的是复制算法,从 from 复制到 to,当经过一次或者多次 GC 之后,存活下来的对象会被移动到老年区,当 JVM 内存不够用的时候,会触发 Full GC,清理 JVM 老年区当新生区满了之后会触发 YGC,先把存活的对象放到其中一个 Survice区,然后进行垃圾清理。因为如果仅仅清理需要删除的对象,这样会导致内存碎片,因此一般会把 Eden 进行完全的清理,然后整理内存。那么下次 GC 的时候,就会使用下一个 Survive,这样循环使用。如果有特别大的对象,新生代放不下,就会使用老年代的担保,直接放到老年代里面。因为 JVM 认为,一般大对象的存活时间一般比较久远。 3. 对象创建方法,对象的内存分配,对象的访问定位。new 一个对象 4. GC 的两种判定方法:引用计数法:指的是如果某个地方引用了这个对象就+1,如果失效了就-1,当为 0 就会回收但是 JVM 没有用这种方式,因为无法判定相互循环引用(A 引用 B,B 引用 A)的情况引用链法: 通过一种 GC ROOT 的对象(方法区中静态变量引用的对象等-static 变量)来判断,如果有一条链能够到达 GC ROOT 就说明,不能到达 GC ROOT 就说明可以回收 5. SafePoint 是什么比如 GC 的时候必须要等到 Java 线程都进入到 safepoint 的时候 VMThread 才能开始执行 GC, 循环的末尾 (防止大循环的时候一直不进入 safepoint,而其他线程在等待它进入safepoint) 方法返回前 调用方法的 call 之后 抛出异常的位置 **6. GC 的三种收集方法:标记清除、标记整理、复制算法的原理与特点,分别用在什么地方,如果让你优化收集方法,有什么思路?**先标记,标记完毕之后再清除,效率不高,会产生碎片复制算法:分为 8:1 的 Eden 区和 survivor 区,就是上面谈到的 YGC标记整理:标记完毕之后,让所有存活的对象向一端移动 7. GC 收集器有哪些?CMS 收集器与 G1 收集器的特点。并行收集器:串行收集器使用一个单独的线程进行收集,GC 时服务有停顿时间串行收集器:次要回收中使用多线程来执行CMS 收集器是基于“ 标记— 清除”算法实现的,经过多次标记才会被清除G1 从 整体来看是基于“ 标记— 整理”算法实现的收集器,从 局部(两个 Region 之间)上来看是基于“ 复制”算法实现的 8. Minor GC 与 Full GC 分别在什么时候发生?新生代内存不够用时候发生 MGC 也叫 YGC,JVM 内存不够的时候发生 FGC 9. 几种常用的内存调试工具:jmap、jstack、jconsole、jhatjstack 可以看当前栈的情况,jmap 查看内存,jhat 进行 dump 堆的信息mat(eclipse 的也要了解一下) 10. 类加载的几个过程:加载、验证、准备、解析、初始化。然后是使用和卸载了通过全限定名来加载生成 class 对象到内存中,然后进行验证这个 class 文件,包括文件格式校验、元数据验证,字节码校验等。准备是对这个对象分配内存。解析是将符号引用转化为直接引用(指针引用),初始化就是开始执行构造器的代码 1. 数据库三范式是什么? 第一范式(1NF):字段具有原子性,不可再分。(所有关系型数据库系统都满足第一范式数据库表中的字段都是单一属性的,不可再分) 第二范式(2NF)是在第一范式(1NF)的基础上建立起来的,即满足第二范式(2NF)必须先满足第一范式(1NF)。要求数据库表中的每 个实例或行必须可以被惟一地区分。通常需要为表加上一个列,以存储各个实例的惟一标识。这个惟一属性列被称为主关键字或主键。 满足第三范式(3NF)必须先满足第二范式(2NF)。简而言之,第三范式(3NF)要求一个数据库表中不包含已在其它表中已包含的非主关 键字信息。 >所以第三范式具有如下特征: >>1. 每一列只有一个值 >>2. 每一行都能区分。 >>3. 每一个表都不包含其他表已经包含的非主关键字信息。 2. 有哪些数据库优化方面的经验? 用 PreparedStatement, 一般来说比 Statement 性能高:一个 sql发给服务器去执行,涉及步骤:语法检查、语义分析, 编译,缓存。 有外键约束会影响插入和删除性能,如果程序能够保证数据的完整性,那在设计数据库时就去掉外键。 表中允许适当冗余,譬如,主题帖的回复数量和最后回复时间等 UNION ALL 要比 UNION 快很多,所以,如果可以确认合并的两个结果集中不包含重复数据且不需要排序时的话,那么就使用 UNION ALL。 >>UNION 和 UNION ALL 关键字都是将两个结果集合并为一个,但这两者从使用和效率上来说都有所不同。 >1. 对重复结果的处理:UNION 在进行表链接后会筛选掉重复的记录,Union All 不会去除重复记录。 >2. 对排序的处理:Union 将会按照字段的顺序进行排序;UNION ALL 只是简单的将两个结果合并后就返回。 3. 请简述常用的索引有哪些种类? 普通索引: 即针对数据库表创建索引 唯一索引: 与普通索引类似,不同的就是:MySQL 数据库索引列的值必须唯一,但允许有空值 主键索引: 它是一种特殊的唯一索引,不允许有空值。一般是在建表的时候同时创建主键索引 组合索引: 为了进一步榨取 MySQL 的效率,就要考虑建立组合索引。即将数据库表中的多个字段联合起来作为一个组合索引。 4. 以及在 mysql 数据库中索引的工作机制是什么?数据库索引,是数据库管理系统中一个排序的数据结构,以协助快速查询、更新数据库表中数据。索引的实现通常使用 B 树及其变种 B+树 5.MySQL 的基础操作命令: MySQL 是否处于运行状态:Debian 上运行命令 service mysqlstatus,在 RedHat 上运行命令 service mysqld status 开启或停止 MySQL 服务 :运行命令 service mysqld start 开启服务;运行命令 service mysqld stop 停止服务 Shell 登入 MySQL: 运行命令 mysql -u root -p 列出所有数据库:运行命令 show databases; 切换到某个数据库并在上面工作:运行命令 use databasename; 进入名为 databasename 的数据库 列出某个数据库内所有表: show tables; 获取表内所有 Field 对象的名称和类型 :describe table_name; 6.mysql 的复制原理以及流程。Mysql 内建的复制功能是构建大型,高性能应用程序的基础。将 Mysql 的数据分布到多个系统上去,这种分布的机制,是通过将 Mysql 的某一台主机的数据复制到其它主机(slaves)上,并重新执行一遍来实现的。 * 复制过程中一个服务器充当主服务器,而一个或多个其它服务器充当从服务器。主服务器将更新写入二进制日志文件,并维护文件的一个索引以跟踪日志循环。这些日志可以记录发送到从服务器的更新。 当一个从服务器连接主服务器时,它通知主服务器在日志中读取的最后一次成功更新的位置。从服务器接收从那时起发生的任何更新,然后封锁并等待主服务器通知新的更新。 过程如下 1. 主服务器把更新记录到二进制日志文件中。 2. 从服务器把主服务器的二进制日志拷贝到自己的中继日志(replay log)中。 3. 从服务器重做中继日志中的时间,把更新应用到自己的数据库上。 7.mysql 支持的复制类型? 基于语句的复制: 在主服务器上执行的 SQL 语句,在从服务器上执行同样的语句。MySQL 默认采用基于语句的复制,效率比较高。 一旦发 现没法精确复制时,会自动选着基于行的复制。 基于行的复制:把改变的内容复制过去,而不是把命令在从服务器上执行一遍. 从 mysql5.0 开始支持 混合类型的复制: 默认采用基于语句的复制,一旦发现基于语句的无法精确的复制时,就会采用基于行的复制。 **8.mysql 中 中 varchar 与 与 char 的区别以及 varchar(50) 中的 50 代表的涵义?** varchar 与 char 的区别: char 是一种固定长度的类型,varchar 则是一种可变长度的类型. varchar(50)中 50 的涵义 : 最多存放 50 个字节 int(20)中 20 的涵义: int(M)中的 M indicates the maximum width (最大显示宽度)for integer types. The maximum legal display width is 255. **9. 表中有大字段 X (例如:text 类型),且字段 X 不会经常更新,以读为为主,将该字段拆成子表好处是什么?**如果字段里面有大字段(text,blob)类型的,而且这些字段的访问并不多,这时候放在一起就变成缺点了。 MYSQL 数据库的记录存储是按行存储的,数据块大小又是固定的(16K),每条记录越小,相同的块存储的记录就越多。此时应该把大字段拆走,这样应付大部分小字段的查询时,就能提高效率。当需要查询大字段时,此时的关联查询是不可避免的,但也是值得的。拆分开后,对字段的 UPDAE 就要 UPDATE 多个表了 **10.MySQL 中 中 InnoDB 引擎的行锁是通过加在什么上完成(或称实现)的?**InnoDB 行锁是通过给索引上的索引项加锁来实现的,这一点 MySQL 与Oracle 不同,后者是通过在数据块中对相应数据行加锁来实现的。InnoDB 这种行锁实现特点意味着:只有通过索引条件检索数据,InnoDB 才使用行级锁,否则,InnoDB 将使用表锁! 欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

测试一下25道Spring经典面试题你会几道?循环依赖面试详解

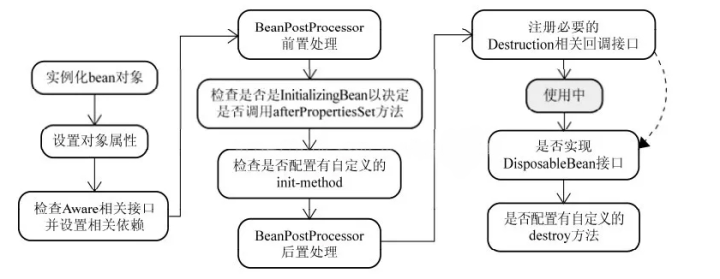
前言 先看看什么是循环依赖当一个ClassA依赖于ClassB,然后ClassB又反过来依赖ClassA,这就形成了一个循环依赖:ClassA -> ClassB -> ClassA循环依赖-->2个或以上bean 互相持有对方,最终形成闭环.Spring中循环依赖的场景:1、构造器的循环依赖。(spring也无能为力)2、setter循环依赖:field属性的循环依赖【setter方式 单例,默认方式-->通过递归方法找出当前Bean所依赖的Bean,然后提前缓存【会放入Cach中】起来。通过提前暴露 -->暴露一个exposedObject用于返回提前暴露的Bean。】Spring是先将Bean对象实例化【依赖无参构造函数】--->再设置对象属性的Spring先用构造器实例化Bean对象----->将实例化结束的对象放到一个Map中,并且Spring提供获取这个未设置属性的实例化对象的引用方法。结合我们的实例来看,,当Spring实例化了A、B、C后,紧接着会去设置对象的属性,此时A依赖B,就会去Map中取出存在里面的单例B对象,以此类推,不会出来循环的问题喽。 下面说一下Spring是如果解决循环依赖的 第一种:构造器参数循环依赖Spring容器会将每一个正在创建的Bean 标识符放在一个“当前创建Bean池”中,Bean标识符在创建过程中将一直保持在这个池中。因此如果在创建Bean过程中发现自己已经在“当前创建Bean池”里时将抛出BeanCurrentlyInCreationException异常表示循环依赖;而对于创建完毕的Bean将从“当前创建Bean池”中清除掉。首先我们先初始化三个Bean。public class StudentA { private StudentB studentB ; public void setStudentB(StudentB studentB) { this.studentB = studentB; } public StudentA() { } public StudentA(StudentB studentB) { this.studentB = studentB; } } public class StudentB { private StudentC studentC ; public void setStudentC(StudentC studentC) { this.studentC = studentC; } public StudentB() { } public StudentB(StudentC studentC) { this.studentC = studentC; } } public class StudentC { private StudentA studentA ; public void setStudentA(StudentA studentA) { this.studentA = studentA; } public StudentC() { } public StudentC(StudentA studentA) { this.studentA = studentA; } } OK,上面是很基本的3个类,,StudentA有参构造是StudentB。StudentB的有参构造是StudentC,StudentC的有参构造是StudentA ,这样就产生了一个循环依赖的情况,我们都把这三个Bean交给Spring管理,并用有参构造实例化。 <constructor-arg index="0" ref="b"></constructor-arg> </bean> <bean id="b" class="com.zfx.student.StudentB"> <constructor-arg index="0" ref="c"></constructor-arg> </bean> <bean id="c" class="com.zfx.student.StudentC"> <constructor-arg index="0" ref="a"></constructor-arg> </bean> 下面是测试类:public class Test { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("com/zfx/student/applicationContext.xml"); //System.out.println(context.getBean("a", StudentA.class)); } } 执行结果报错信息为:Caused by: org.springframework.beans.factory.BeanCurrentlyInCreationException: Error creating bean with name 'a': Requested bean is currently in creation: Is there an unresolvable circular reference? 如果大家理解开头那句话的话,这个报错应该不惊讶,Spring容器先创建单例StudentA,StudentA依赖StudentB,然后将A放在“当前创建Bean池”中,此时创建StudentB,StudentB依赖StudentC ,然后将B放在“当前创建Bean池”中,此时创建StudentC,StudentC又依赖StudentA, 但是,此时Student已经在池中,所以会报错,,因为在池中的Bean都是未初始化完的,所以会依赖错误 ,(初始化完的Bean会从池中移除)第二种:setter方式单例,默认方式如果要说setter方式注入的话,我们最好先看一张Spring中Bean实例化的图 如图中前两步骤得知:Spring是先将Bean对象实例化之后再设置对象属性的 修改配置文件为set方式注入 <!--scope="singleton"(默认就是单例方式) --> <bean id="a" class="com.zfx.student.StudentA" scope="singleton"> <property name="studentB" ref="b"></property> </bean> <bean id="b" class="com.zfx.student.StudentB" scope="singleton"> <property name="studentC" ref="c"></property> </bean> <bean id="c" class="com.zfx.student.StudentC" scope="singleton"> <property name="studentA" ref="a"></property> </bean> 下面是测试类:public class Test { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("com/zfx/student/applicationContext.xml"); System.out.println(context.getBean("a", StudentA.class)); } } 打印结果为:com.zfx.student.StudentA@1fbfd6 为什么用set方式就不报错了呢 ?我们结合上面那张图看,Spring先是用构造实例化Bean对象 ,此时Spring会将这个实例化结束的对象放到一个Map中,并且Spring提供了获取这个未设置属性的实例化对象引用的方法。 结合我们的实例来看,,当Spring实例化了StudentA、StudentB、StudentC后,紧接着会去设置对象的属性,此时StudentA依赖StudentB,就会去Map中取出存在里面的单例StudentB对象,以此类推,不会出来循环的问题喽、下面是Spring源码中的实现方法。以下的源码在Spring的Bean包中的DefaultSingletonBeanRegistry.java类中/* Cache of singleton objects: bean name --> bean instance(缓存单例实例化对象的Map集合) / private final Map<String, Object> singletonObjects = new ConcurrentHashMap<String, Object>(64); /** Cache of singleton factories: bean name --> ObjectFactory(单例的工厂Bean缓存集合) */ private final Map<String, ObjectFactory> singletonFactories = new HashMap<String, ObjectFactory>(16); /** Cache of early singleton objects: bean name --> bean instance(早期的单身对象缓存集合) */ private final Map<String, Object> earlySingletonObjects = new HashMap<String, Object>(16); /** Set of registered singletons, containing the bean names in registration order(单例的实例化对象名称集合) */ private final Set<String> registeredSingletons = new LinkedHashSet<String>(64); /** * 添加单例实例 * 解决循环引用的问题 * Add the given singleton factory for building the specified singleton * if necessary. * <p>To be called for eager registration of singletons, e.g. to be able to * resolve circular references. * @param beanName the name of the bean * @param singletonFactory the factory for the singleton object */ protected void addSingletonFactory(String beanName, ObjectFactory singletonFactory) { Assert.notNull(singletonFactory, "Singleton factory must not be null"); synchronized (this.singletonObjects) { if (!this.singletonObjects.containsKey(beanName)) { this.singletonFactories.put(beanName, singletonFactory); this.earlySingletonObjects.remove(beanName); this.registeredSingletons.add(beanName); } } } 第三种:setter方式原型,prototype修改配置文件为: <property name="studentB" ref="b"></property> </bean> <bean id="b" class="com.zfx.student.StudentB" scope="prototype"> <property name="studentC" ref="c"></property> </bean> <bean id="c" class="com.zfx.student.StudentC" scope="prototype"> <property name="studentA" ref="a"></property> </bean> scope="prototype" 意思是 每次请求都会创建一个实例对象。两者的区别是:有状态的bean都使用Prototype作用域,无状态的一般都使用singleton单例作用域。测试用例:public class Test { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("com/zfx/student/applicationContext.xml"); //此时必须要获取Spring管理的实例,因为现在scope="prototype" 只有请求获取的时候才会实例化对象 System.out.println(context.getBean("a", StudentA.class)); } } 打印结果:Caused by: org.springframework.beans.factory.BeanCurrentlyInCreationException: Error creating bean with name 'a': Requested bean is currently in creation: Is there an unresolvable circular reference? 为什么原型模式就报错了呢?对于“prototype”作用域Bean,Spring容器无法完成依赖注入,因为“prototype”作用域的Bean,Spring容器不进行缓存,因此无法提前暴露一个创建中的Bean。 大家可以再回过头来看看以下Spring面试题,你自己能答对几道呢? 1 、什么是 Spring 框架?Spring 框架有哪些主要模块?2 、使用 Spring 框架能带来哪些好处?3 、什么是控制反转(IOC) ?什么是依赖注入?4 、请解释下 Spring 框架中的 IoC ?5 、BeanFactory 和 和 ApplicationContext 有什么区别?6 、Spring 有几种配置方式?7 、如何用基于 XML 配置的方式配置 Spring ?8 、如何用基于 Java 配置的方式配置 Spring ?9 、怎样用注解的方式配置 Spring ?10 、请解释 Spring Bean 的生命周期?11 、Spring Bean 的作用域之间有什么区别?12 、什么是 Spring inner beans ?13 、Spring 框架中的单例 Beans 是线程安全的么?14 、请举例说明如何在 Spring 中注入一个 Java Collection ?15 、如何向 Spring Bean 中注入一个 Java.util.Properties 16 、请解释 Spring Bean 的自动装配?17 、请解释自动装配模式的区别?18 、如何开启基于注解的自动装配?19 、请举例解释@Required 注解?20 、请举例解释@Autowired 注解?21 、请举例说明@Qualifier 注解?22 、构造方法注入和设值注入有什么区别?23 、Spring 框架中有哪些不同类型的事件?24 、FileSystemResource 和 和 ClassPathResource 有何区别?25 、Spring 框架中都用到了哪些设计模式? 欢迎大家一起交流,喜欢文章记得点个赞,感谢支持!

优秀的个人博客,低调大师

2018互联网企业最新面试大纲180+道Java面试题目!含答案解析!

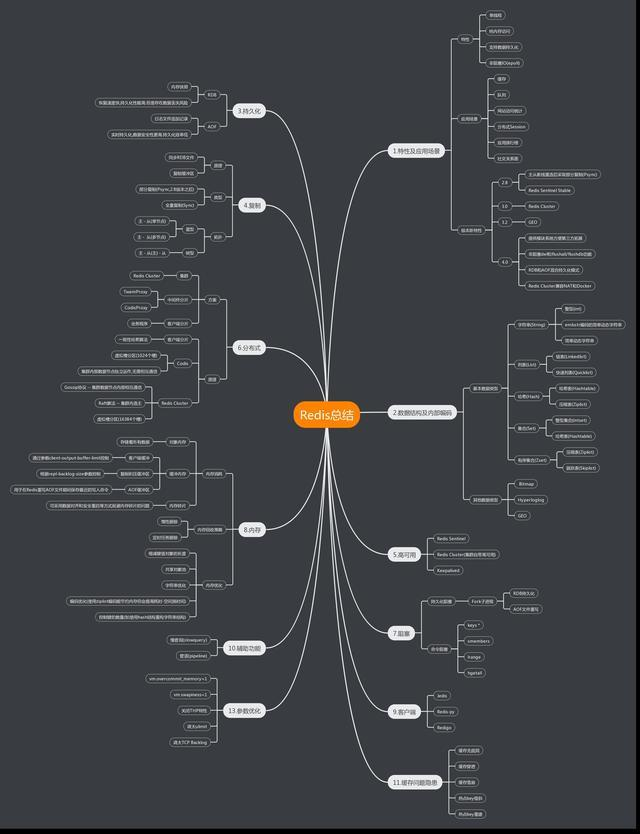
在进入正文之前,顺便给大家推荐一个Java架构方面的交流学习群:878249276,里面会分享一些资深架构师录制的视频录像:有Spring,MyBatis,Netty源码分析,高并发、高性能、分布式、微服务架构的原理,JVM性能优化这些成为架构师必备的知识体系。相信对于已经工作和遇到技术瓶颈的同学,在这个群里会有你需要的内容。有需要的同学请抓紧时间加入进来。 大厂常见问题 写视频点播网站文件下载接口 基础变量/数组写出模拟maven导入包过程 写出新变脸内存分配,模拟垃圾回收过程 50个白球50个红球,两个盒子,怎么放让人随机在一个盒子里抽到红球概率最高 n个数里取两个和为s的数 java数据结构 HashMap原理 自定义类型可以作为Key么? java内存模型 知道的排序算法 快排的优化 Java多线程实现方式 Java线程与进程区别 JVM内存模型+垃圾回收算法 hashmap和treemap的区别 操作系统同步方式、通信方式 计算机网络三次握手四次分手以及wait_time三种差别 http post和get差别 美赛的建模 k-means 算法 数据库的三范式 路由器和交换机有什么区别 抽象类和接口有什么区别 HashMap 和 HashTable 有什么区别 多线程下有什么同步措施 JVM GC、CMS 和 多线程 Java 64 位的指针压缩 Java 中的锁是怎么实现的、有什么锁 Spark 和 Hadoop 区别 Spark 分布式数据的容错机制 Spark 的 shuffle read 和 shuffle write 的实现 docker(namespace cgroups) docker文件系统 http协议 java线程池达到提交上限的具体情况 Java无锁原理 rehash过程 java如何定位内存泄漏 对中间件的认识 数组中Arrays.sort的排序方法是什么? 快速排序和堆排序的优缺点 GC中可达性分析法,和引用计数法有什么不同?引用计数法有什么问题? JVM类加载机制 链表中如何判断有环路 数据结构中的链表 算法二分查找 时间复杂度分析 操作系统cpu调度算法 通用问题 Java 面试随着时间的改变而改变。在过去的日子里,当你知道 String 和 StringBuilder 的区别(String 类型和 StringBuffer 类型的主要性能区别其实在于 String 是不可变的对象。因此在每次对 String 类型进行改变的时候其实都等同于生成了一个新的 String 对象,然后将指针指向新的 String 对象,所以经常改变内容的字符串最好不要用 String ,因为每次生成对象都会对系统性能产生影响,特别当内存中无引用对象多了以后,JVM 的 GC 就会开始工作,影响性能,可以考虑使用可变字符序列StringBuilder)就能让你直接进入第二轮面试,但是现在问题变得越来越高级,面试官问的问题也更深入。 在我初入职场的时候,类似于 Vector 与 Array 的区别、HashMap 与 Hashtable 的区别是最流行的问题,只需要记住它们,就能在面试中获得更好的机会,但这种情形已经不复存在。如今,你将会被问到许多 Java 程序员都没有看过的领域,如 NIO,设计模式,成熟的单元测试,或者那些很难掌握的知识,如并发、算法、数据结构及编码。 由于我喜欢研究面试题,因此我已经收集了许多的面试问题,包括许多许多不同的主题。我已经为这众多的问题准备一段时间了,现在我将它们分享给你们。这里面不但包含经典的面试问题,如线程、集合、equals 和 hashcode、socket,而且还包含了 NIO、数组、字符串、Java 8 等主题。 该列表包含了入门级 Java 程序员和多年经验的高级开发者的问题。无论你是 1、2、3、4、5、6、7、8、9 还是 10 年经验的开发者,你都能在其中找到一些有趣的问题。这里包含了一些超级容易回答的问题,同时包含经验丰富的 Java 程序员也会棘手的问题。 当然你们也是非常幸运的,当今有许多好的书来帮助你准备 Java 面试,其中有一本我觉得特别有用和有趣的是 Markham 的 Java 程序面试揭秘(Java Programming Interview Exposed)。 这本书会告诉你一些 Java 和 JEE 面试中最重要的主题,即使你不是准备 Java 面试,也值得一读。 该问题列表特别长,我们有各个地方的问题,所以,答案必须要短小、简洁、干脆,不拖泥带水。因此,除了这一个段落,你只会听到问题与答案,再无其他内容,没有反馈,也没有评价。为此,我已经写好了一些博文,在这些文章中你可以找到我对某些问题的观点,如我为什么喜欢这个问题,这个问题的挑战是什么?期望从面试者那获取到什么样的答案? 这个列表有一点不同,我鼓励你采用类似的方式去分享问题和答案,这样容易温习。我希望这个列表对面试官和候选人都有很好的用处,面试官可以对这些问题上做一些改变以获取新奇和令人惊奇的元素,这对一次好的面试来说非常重要。而候选者,可以扩展和测试 Java 程序语言和平台关键领域的知识。2015 年,会更多的关注并发概念,JVM 内部,32 位 JVM 和 64 JVM的区别,单元测试及整洁的代码。我确信,如果你读过这个庞大的 Java 面试问题列表,无论是电话面试还是面对面的面试,你都能有很好的表现。 Java 面试中的重要话题 除了你看到的惊人的问题数量,我也尽量保证质量。我不止一次分享各个重要主题中的问题,也确保包含所谓的高级话题,这些话题很多程序员不喜欢准备或者直接放弃,因为他们的工作不会涉及到这些。Java NIO 和 JVM 底层就是最好的例子。你也可以将设计模式划分到这一类中,但是越来越多有经验的程序员了解 GOF 设计模式并应用这些模式。我也尽量在这个列表中包含 2015 年最新的面试问题,这些问题可能是来年关注的核心。为了给你一个大致的了解,下面列出这份 Java 面试问题列表包含的主题: 多线程,并发及线程基础 数据类型转换的基本原则 垃圾回收(GC) Java 集合框架 数组 字符串** GOF 设计模式 SOLID (单一功能、开闭原则、里氏替换、接口隔离以及依赖反转)设计原则 抽象类与接口 Java 基础,如 equals 和 hashcode 泛型与枚举 Java IO 与 NIO 常用网络协议 Java 中的数据结构和算法 正则表达式 JVM 底层 Java 最佳实践 JDBC Date, Time 与 Calendar Java 处理 XML JUnit 编程 120 大 Java 面试题及答案 现在是时候给你展示我近 5 年从各种面试中收集来的 120 个问题了。我确定你在自己的面试中见过很多这些问题,很多问题你也能正确回答。 多线程、并发及线程的基础问题 1)Java 中能创建 volatile 数组吗? 能,Java 中可以创建 volatile 类型数组,不过只是一个指向数组的引用,而不是整个数组。我的意思是,如果改变引用指向的数组,将会受到 volatile 的保护,但是如果多个线程同时改变数组的元素,volatile 标示符就不能起到之前的保护作用了。 2)volatile 能使得一个非原子操作变成原子操作吗? 一个典型的例子是在类中有一个 long 类型的成员变量。如果你知道该成员变量会被多个线程访问,如计数器、价格等,你最好是将其设置为 volatile。为什么?因为 Java 中读取 long 类型变量不是原子的,需要分成两步,如果一个线程正在修改该 long 变量的值,另一个线程可能只能看到该值的一半(前 32 位)。但是对一个 volatile 型的 long 或 double 变量的读写是原子。 3)volatile 修饰符的有过什么实践? 一种实践是用 volatile 修饰 long 和 double 变量,使其能按原子类型来读写。double 和 long 都是64位宽,因此对这两种类型的读是分为两部分的,第一次读取第一个 32 位,然后再读剩下的 32 位,这个过程不是原子的,但 Java 中 volatile 型的 long 或 double 变量的读写是原子的。volatile 修复符的另一个作用是提供内存屏障(memory barrier),例如在分布式框架中的应用。简单的说,就是当你写一个 volatile 变量之前,Java 内存模型会插入一个写屏障(write barrier),读一个 volatile 变量之前,会插入一个读屏障(read barrier)。意思就是说,在你写一个 volatile 域时,能保证任何线程都能看到你写的值,同时,在写之前,也能保证任何数值的更新对所有线程是可见的,因为内存屏障会将其他所有写的值更新到缓存。 4)volatile 类型变量提供什么保证? volatile 变量提供顺序和可见性保证,例如,JVM 或者 JIT为了获得更好的性能会对语句重排序,但是 volatile 类型变量即使在没有同步块的情况下赋值也不会与其他语句重排序。 volatile 提供 happens-before 的保证,确保一个线程的修改能对其他线程是可见的。某些情况下,volatile 还能提供原子性,如读 64 位数据类型,像 long 和 double 都不是原子的,但 volatile 类型的 double 和 long 就是原子的。 5) 10 个线程和 2 个线程的同步代码,哪个更容易写? 从写代码的角度来说,两者的复杂度是相同的,因为同步代码与线程数量是相互独立的。但是同步策略的选择依赖于线程的数量,因为越多的线程意味着更大的竞争,所以你需要利用同步技术,如锁分离,这要求更复杂的代码和专业知识。 6)你是如何调用 wait()方法的?使用 if 块还是循环?为什么? wait() 方法应该在循环调用,因为当线程获取到 CPU 开始执行的时候,其他条件可能还没有满足,所以在处理前,循环检测条件是否满足会更好。 下面是一段标准的使用 wait 和 notify 方法的代码: // The standard idiom for using the wait method synchronized (obj) { while (condition does not hold) obj.wait(); // (Releases lock, and reacquires on wakeup) ... // Perform action appropriate to condition } 参见 Effective Java 第 69 条,获取更多关于为什么应该在循环中来调用 wait 方法的内容。 7)什么是多线程环境下的伪共享(false sharing)? 伪共享是多线程系统(每个处理器有自己的局部缓存)中一个众所周知的性能问题。伪共享发生在不同处理器的上的线程对变量的修改依赖于相同的缓存行,伪共享问题很难被发现,因为线程可能访问完全不同的全局变量,内存中却碰巧在很相近的位置上。如其他诸多的并发问题,避免伪共享的最基本方式是仔细审查代码,根据缓存行来调整你的数据结构。 有经验程序员的 Java 面试题 8)什么是 Busy spin?我们为什么要使用它? Busy spin 是一种在不释放 CPU 的基础上等待事件的技术。它经常用于避免丢失 CPU 缓存中的数据(如果线程先暂停,之后在其他CPU上运行就会丢失)。所以,如果你的工作要求低延迟,并且你的线程目前没有任何顺序,这样你就可以通过循环检测队列中的新消息来代替调用 sleep() 或 wait() 方法。它唯一的好处就是你只需等待很短的时间,如几微秒或几纳秒。LMAX 分布式框架是一个高性能线程间通信的库,该库有一个 BusySpinWaitStrategy 类就是基于这个概念实现的,使用 busy spin 循环 EventProcessors 等待屏障。 9)Java 中怎么获取一份线程 dump 文件? 在 Linux 下,你可以通过命令 kill -3 PID (Java 进程的进程 ID)来获取 Java 应用的 dump 文件。在 Windows 下,你可以按下 Ctrl + Break 来获取。这样 JVM 就会将线程的 dump 文件打印到标准输出或错误文件中,它可能打印在控制台或者日志文件中,具体位置依赖应用的配置。如果你使用Tomcat。 10)Swing 是线程安全的? 不是,Swing 不是线程安全的。你不能通过任何线程来更新 Swing 组件,如 JTable、JList 或 JPanel,事实上,它们只能通过 GUI 或 AWT 线程来更新。这就是为什么 Swing 提供 invokeAndWait() 和 invokeLater() 方法来获取其他线程的 GUI 更新请求。这些方法将更新请求放入 AWT 的线程队列中,可以一直等待,也可以通过异步更新直接返回结果。你也可以在参考答案中查看和学习到更详细的内容。 11)什么是线程局部变量? 当使用ThreadLocal维护变量时,ThreadLocal为每个使用该变量的线程提供独立的变量副本,每个线程都可以独立地改变自己的副本,而不会影响其它线程所对应的副本,是线程隔离的。线程隔离的秘密在于ThreadLocalMap类(ThreadLocal的静态内部类) 线程局部变量是局限于线程内部的变量,属于线程自身所有,不在多个线程间共享。Java 提供 ThreadLocal 类来支持线程局部变量,是一种实现线程安全的方式。但是在管理环境下(如 web 服务器)使用线程局部变量的时候要特别小心,在这种情况下,工作线程的生命周期比任何应用变量的生命周期都要长。任何线程局部变量一旦在工作完成后没有释放,Java 应用就存在内存泄露的风险。 ThreadLocal的方法:void set(T value)、T get()以及T initialValue()。 ThreadLocal是如何为每个线程创建变量的副本的: 首先,在每个线程Thread内部有一个ThreadLocal.ThreadLocalMap类型的成员变量threadLocals,这个threadLocals就是用来存储实际的变量副本的,键值为当前ThreadLocal变量,value为变量副本(即T类型的变量)。初始时,在Thread里面,threadLocals为空,当通过ThreadLocal变量调用get()方法或者set()方法,就会对Thread类中的threadLocals进行初始化,并且以当前ThreadLocal变量为键值,以ThreadLocal要保存的副本变量为value,存到threadLocals。然后在当前线程里面,如果要使用副本变量,就可以通过get方法在threadLocals里面查找。 总结: a、实际的通过ThreadLocal创建的副本是存储在每个线程自己的threadLocals中的 b、为何threadLocals的类型ThreadLocalMap的键值为ThreadLocal对象,因为每个线程中可有多个threadLocal变量,就像上面代码中的longLocal和stringLocal; c、在进行get之前,必须先set,否则会报空指针异常;如果想在get之前不需要调用set就能正常访问的话,必须重写initialValue()方法 12)用 wait-notify 写一段代码来解决生产者-消费者问题? 请参考答案中的示例代码。只要记住在同步块中调用 wait() 和 notify()方法,如果阻塞,通过循环来测试等待条件。 13) 用 Java 写一个线程安全的单例模式(Singleton)? 请参考答案中的示例代码,这里面一步一步教你创建一个线程安全的 Java 单例类。当我们说线程安全时,意思是即使初始化是在多线程环境中,仍然能保证单个实例。Java 中,使用枚举作为单例类是最简单的方式来创建线程安全单例模式的方式。 14)Java 中 sleep 方法和 wait 方法的区别? 虽然两者都是用来暂停当前运行的线程,但是 sleep() 实际上只是短暂停顿,因为它不会释放锁,而 wait() 意味着条件等待,这就是为什么该方法要释放锁,因为只有这样,其他等待的线程才能在满足条件时获取到该锁。 15)什么是不可变对象(immutable object)?Java 中怎么创建一个不可变对象? 不可变对象指对象一旦被创建,状态就不能再改变。任何修改都会创建一个新的对象,如 String、Integer及其它包装类。详情参见答案,一步一步指导你在 Java 中创建一个不可变的类。 16)我们能创建一个包含可变对象的不可变对象吗? 是的,我们是可以创建一个包含可变对象的不可变对象的,你只需要谨慎一点,不要共享可变对象的引用就可以了,如果需要变化时,就返回原对象的一个拷贝。最常见的例子就是对象中包含一个日期对象的引用。 数据类型和 Java 基础面试问题 17)Java 中应该使用什么数据类型来代表价格? 如果不是特别关心内存和性能的话,使用BigDecimal,否则使用预定义精度的 double 类型。 18)怎么将 byte 转换为 String? 可以使用 String 接收 byte[] 参数的构造器来进行转换,需要注意的点是要使用的正确的编码,否则会使用平台默认编码,这个编码可能跟原来的编码相同,也可能不同。 19)Java 中怎样将 bytes 转换为 long 类型? String接收bytes的构造器转成String,再Long.parseLong 20)我们能将 int 强制转换为 byte 类型的变量吗?如果该值大于 byte 类型的范围,将会出现什么现象? 是的,我们可以做强制转换,但是 Java 中 int 是 32 位的,而 byte 是 8 位的,所以,如果强制转化是,int 类型的高 24 位将会被丢弃,byte 类型的范围是从 -128 到 127。 21)存在两个类,B 继承 A,C 继承 B,我们能将 B 转换为 C 么?如 C = (C) B; 可以,向下转型。但是不建议使用,容易出现类型转型异常. 22)哪个类包含 clone 方法?是 Cloneable 还是 Object? java.lang.Cloneable 是一个标示性接口,不包含任何方法,clone 方法在 object 类中定义。并且需要知道 clone() 方法是一个本地方法,这意味着它是由 c 或 c++ 或 其他本地语言实现的。 23)Java 中 ++ 操作符是线程安全的吗? 不是线程安全的操作。它涉及到多个指令,如读取变量值,增加,然后存储回内存,这个过程可能会出现多个线程交差。 24)a = a + b 与 a += b 的区别 += 隐式的将加操作的结果类型强制转换为持有结果的类型。如果两这个整型相加,如 byte、short 或者 int,首先会将它们提升到 int 类型,然后在执行加法操作。 byte a = 127; byte b = 127; b = a + b; // error : cannot convert from int to byte b += a; // ok (因为 a+b 操作会将 a、b 提升为 int 类型,所以将 int 类型赋值给 byte 就会编译出错) 25)我能在不进行强制转换的情况下将一个 double 值赋值给 long 类型的变量吗? 不行,你不能在没有强制类型转换的前提下将一个 double 值赋值给 long 类型的变量,因为 double 类型的范围比 long 类型更广,所以必须要进行强制转换。 26)3*0.1 == 0.3 将会返回什么?true 还是 false? false,因为有些浮点数不能完全精确的表示出来。 27)int 和 Integer 哪个会占用更多的内存? Integer 对象会占用更多的内存。Integer 是一个对象,需要存储对象的元数据。但是 int 是一个原始类型的数据,所以占用的空间更少。 28)为什么 Java 中的 String 是不可变的(Immutable)? Java 中的 String 不可变是因为 Java 的设计者认为字符串使用非常频繁,将字符串设置为不可变可以允许多个客户端之间共享相同的字符串。更详细的内容参见答案。 29)我们能在 Switch 中使用 String 吗? 从 Java 7 开始,我们可以在 switch case 中使用字符串,但这仅仅是一个语法糖。内部实现在 switch 中使用字符串的 hash code。 30)Java 中的构造器链是什么? 当你从一个构造器中调用另一个构造器,就是Java 中的构造器链。这种情况只在重载了类的构造器的时候才会出现。 JVM 底层 与 GC(Garbage Collection) 的面试问题 31)64 位 JVM 中,int 的长度是多数? Java 中,int 类型变量的长度是一个固定值,与平台无关,都是 32 位。意思就是说,在 32 位 和 64 位 的Java 虚拟机中,int 类型的长度是相同的。 32)Serial 与 Parallel GC之间的不同之处? Serial 与 Parallel 在GC执行的时候都会引起 stop-the-world。它们之间主要不同 serial 收集器是默认的复制收集器,执行 GC 的时候只有一个线程,而 parallel 收集器使用多个 GC 线程来执行。 33)32 位和 64 位的 JVM,int 类型变量的长度是多数? 32 位和 64 位的 JVM 中,int 类型变量的长度是相同的,都是 32 位或者 4 个字节。 34)Java 中 WeakReference 与 SoftReference的区别? Java中一共有四种类型的引用。StrongReference、 SoftReference、 WeakReference 以及 PhantomReference。 StrongReference 是 Java 的默认引用实现, 它会尽可能长时间的存活于 JVM 内,当没有任何对象指向它时将会被GC回收 WeakReference,顾名思义, 是一个弱引用, 当所引用的对象在 JVM 内不再有强引用时, 将被GC回收 虽然 WeakReference 与 SoftReference 都有利于提高 GC 和 内存的效率,但是 WeakReference ,一旦失去最后一个强引用,就会被 GC 回收,而 SoftReference 会尽可能长的保留引用直到 JVM 内存不足时才会被回收(虚拟机保证), 这一特性使得 SoftReference 非常适合缓存应用 35)WeakHashMap 是怎么工作的? WeakHashMap 的工作与正常的 HashMap 类似,但是使用弱引用作为 key,意思就是当 key 对象没有任何引用时,key/value 将会被回收。 36)JVM 选项 -XX:+UseCompressedOops 有什么作用?为什么要使用? 当你将你的应用从 32 位的 JVM 迁移到 64 位的 JVM 时,由于对象的指针从 32 位增加到了 64 位,因此堆内存会突然增加,差不多要翻倍。这也会对 CPU 缓存(容量比内存小很多)的数据产生不利的影响。因为,迁移到 64 位的 JVM 主要动机在于可以指定最大堆大小,通过压缩 OOP 可以节省一定的内存。通过 -XX:+UseCompressedOops 选项,JVM 会使用 32 位的 OOP,而不是 64 位的 OOP。 37)怎样通过 Java 程序来判断 JVM 是 32 位 还是 64 位? 你可以检查某些系统属性如 sun.arch.data.model 或 os.arch 来获取该信息。 38)32 位 JVM 和 64 位 JVM 的最大堆内存分别是多数? 理论上说上 32 位的 JVM 堆内存可以到达 2^32,即 4GB,但实际上会比这个小很多。不同操作系统之间不同,如 Windows 系统大约 1.5 GB,Solaris 大约 3GB。64 位 JVM允许指定最大的堆内存,理论上可以达到 2^64,这是一个非常大的数字,实际上你可以指定堆内存大小到 100GB。甚至有的 JVM,如 Azul,堆内存到 1000G 都是可能的。 39)JRE、JDK、JVM 及 JIT 之间有什么不同? JRE 代表 Java 运行时(Java run-time),是运行 Java 应用所必须的。JDK 代表 Java 开发工具(Java development kit),是 Java 程序的开发工具,如 Java 编译器,它也包含 JRE。JVM 代表 Java 虚拟机(Java virtual machine),它的责任是运行 Java 应用。JIT 代表即时编译(Just In Time compilation),当代码执行的次数超过一定的阈值时,会将 Java 字节码转换为本地代码,如,主要的热点代码会被准换为本地代码,这样有利大幅度提高 Java 应用的性能。 下面分享一些我整理的最新面试题和技术干货的讲解视频资料需要的进群:878249276 3 年工作经验的 Java 面试题 40)解释 Java 堆空间及 GC? 当通过 Java 命令启动 Java 进程的时候,会为它分配内存。内存的一部分用于创建堆空间,当程序中创建对象的时候,就从对空间中分配内存。GC 是 JVM 内部的一个进程,回收无效对象的内存用于将来的分配。 JVM 底层面试题及答案 41)你能保证 GC 执行吗? 不能,虽然你可以调用 System.gc() 或者 Runtime.getRuntime().gc(),但是没有办法保证 GC 的执行。 42)怎么获取 Java 程序使用的内存?堆使用的百分比? 可以通过 java.lang.Runtime 类中与内存相关方法来获取剩余的内存,总内存及最大堆内存。通过这些方法你也可以获取到堆使用的百分比及堆内存的剩余空间。Runtime.freeMemory() 方法返回剩余空间的字节数,Runtime.totalMemory() 方法总内存的字节数,Runtime.maxMemory() 返回最大内存的字节数。 43)Java 中堆和栈有什么区别? JVM 中堆和栈属于不同的内存区域,使用目的也不同。栈常用于保存方法帧和局部变量,而对象总是在堆上分配。栈通常都比堆小,也不会在多个线程之间共享,而堆被整个 JVM 的所有线程共享。 Difference between stack and heap memory in Java Java 基本概念面试题 44)“a==b”和”a.equals(b)”有什么区别? 如果 a 和 b 都是对象,则 a==b 是比较两个对象的引用,只有当 a 和 b 指向的是堆中的同一个对象才会返回 true,而 a.equals(b) 是进行逻辑比较,所以通常需要重写该方法来提供逻辑一致性的比较。例如,String 类重写 equals() 方法,所以可以用于两个不同对象,但是包含的字母相同的比较。 45)a.hashCode() 有什么用?与 a.equals(b) 有什么关系? hashCode() 方法是相应对象整型的 hash 值。它常用于基于 hash 的集合类,如 Hashtable、HashMap、LinkedHashMap等等。它与 equals() 方法关系特别紧密。根据 Java 规范,两个使用 equal() 方法来判断相等的对象,必须具有相同的 hash code。 46)final、finalize 和 finally 的不同之处? final 是一个修饰符,可以修饰变量、方法和类。如果 final 修饰变量,意味着该变量的值在初始化后不能被改变。Java 技术允许使用 finalize() 方法在垃圾收集器将对象从内存中清除出去之前做必要的清理工作。这个方法是由垃圾收集器在确定这个对象没有被引用时对这个对象调用的,但是什么时候调用 finalize 没有保证。finally 是一个关键字,与 try 和 catch 一起用于异常的处理。finally 块一定会被执行,无论在 try 块中是否有发生异常。 47)Java 中的编译期常量是什么?使用它又什么风险? 公共静态不可变(public static final )变量也就是我们所说的编译期常量,这里的 public 可选的。实际上这些变量在编译时会被替换掉,因为编译器知道这些变量的值,并且知道这些变量在运行时不能改变。这种方式存在的一个问题是你使用了一个内部的或第三方库中的公有编译时常量,但是这个值后面被其他人改变了,但是你的客户端仍然在使用老的值,甚至你已经部署了一个新的jar。为了避免这种情况,当你在更新依赖 JAR 文件时,确保重新编译你的程序。 Java 集合框架的面试题 这部分也包含数据结构、算法及数组的面试问题 48) List、Set、Map 和 Queue 之间的区别 List 是一个有序集合,允许元素重复。它的某些实现可以提供基于下标值的常量访问时间,但是这不是 List 接口保证的。Set 是一个无序集合。 49)poll() 方法和 remove() 方法的区别? poll() 和 remove() 都是从队列中取出一个元素,但是 poll() 在获取元素失败的时候会返回空,但是 remove() 失败的时候会抛出异常。 50)Java 中 LinkedHashMap 和 PriorityQueue 的区别是什么? PriorityQueue 保证最高或者最低优先级的的元素总是在队列头部,但是 LinkedHashMap 维持的顺序是元素插入的顺序。当遍历一个 PriorityQueue 时,没有任何顺序保证,但是 LinkedHashMap 课保证遍历顺序是元素插入的顺序。 51)ArrayList 与 LinkedList 的不区别? 最明显的区别是 ArrrayList 底层的数据结构是数组,支持随机访问,而 LinkedList 的底层数据结构书链表,不支持随机访问。使用下标访问一个元素,ArrayList 的时间复杂度是 O(1),而 LinkedList 是 O(n)。更多细节的讨论参见答案。 52)用哪两种方式来实现集合的排序? 你可以使用有序集合,如 TreeSet 或 TreeMap,你也可以使用有顺序的的集合,如 list,然后通过 Collections.sort() 来排序。 53)Java 中怎么打印数组? 你可以使用 Arrays.toString() 和 Arrays.deepToString() 方法来打印数组。由于数组没有实现 toString() 方法,所以如果将数组传递给 System.out.println() 方法,将无法打印出数组的内容,但是 Arrays.toString() 可以打印每个元素。 54)Java 中的 LinkedList 是单向链表还是双向链表? 是双向链表,你可以检查 JDK 的源码。在 Eclipse,你可以使用快捷键 Ctrl + T,直接在编辑器中打开该类。 55)Java 中的 TreeMap 是采用什么树实现的? Java 中的 TreeMap 是使用红黑树实现的。 56) Hashtable 与 HashMap 有什么不同之处? 这两个类有许多不同的地方,下面列出了一部分: a) Hashtable 是 JDK 1 遗留下来的类,而 HashMap 是后来增加的。 b)Hashtable 是同步的,比较慢,但 HashMap 没有同步策略,所以会更快。 c)Hashtable 不允许有个空的 key,但是 HashMap 允许出现一个 null key。 更多的不同之处参见答案。 57)Java 中的 HashSet,内部是如何工作的?(answer答案) HashSet 的内部采用 HashMap来实现。由于 Map 需要 key 和 value,所以所有 key 的都有一个默认 value。类似于 HashMap,HashSet 不允许重复的 key,只允许有一个null key,意思就是 HashSet 中只允许存储一个 null 对象。 58)写一段代码在遍历 ArrayList 时移除一个元素?(答案) 该问题的关键在于面试者使用的是 ArrayList 的 remove() 还是 Iterator 的 remove()方法。这有一段示例代码,是使用正确的方式来实现在遍历的过程中移除元素,而不会出现 ConcurrentModificationException 异常的示例代码。 59)我们能自己写一个容器类,然后使用 for-each 循环吗? 可以,你可以写一个自己的容器类。如果你想使用 Java 中增强的循环来遍历,你只需要实现 Iterable 接口。如果你实现 Collection 接口,默认就具有该属性。 60)ArrayList 和 HashMap 的默认大小是多数?(答案) 在 Java 7 中,ArrayList 的默认大小是 10 个元素,HashMap 的默认大小是16个元素(必须是2的幂)。这就是 Java 7 中 ArrayList 和 HashMap 类的代码片段: // from ArrayList.java JDK 1.7 private static final int DEFAULT_CAPACITY = 10; //from HashMap.java JDK 7 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16 61)有没有可能两个不相等的对象有有相同的 hashcode? 有可能,两个不相等的对象可能会有相同的 hashcode 值,这就是为什么在 hashmap 中会有冲突。相等 hashcode 值的规定只是说如果两个对象相等,必须有相同的hashcode 值,但是没有关于不相等对象的任何规定。 62)两个相同的对象会有不同的的 hash code 吗? 不能,根据 hash code 的规定,这是不可能的。 63)我们可以在 hashcode() 中使用随机数字吗?(答案) 不行,因为对象的 hashcode 值必须是相同的。参见答案获取更多关于 Java 中重写 hashCode() 方法的知识。 64)Java 中,Comparator 与 Comparable 有什么不同?(答案) Comparable 接口用于定义对象的自然顺序,而 comparator 通常用于定义用户定制的顺序。Comparable 总是只有一个,但是可以有多个 comparator 来定义对象的顺序。 65)为什么在重写 equals 方法的时候需要重写 hashCode 方法?(答案) 因为有强制的规范指定需要同时重写 hashcode 与 equal 是方法,许多容器类,如 HashMap、HashSet 都依赖于 hashcode 与 equals 的规定。 Java IO 和 NIO 的面试题 IO 是 Java 面试中一个非常重要的点。你应该很好掌握 Java IO,NIO,NIO2 以及与操作系统,磁盘 IO 相关的基础知识。下面是 Java IO 中经常问的问题。 66)在我 Java 程序中,我有三个 socket,我需要多少个线程来处理? 67)Java 中怎么创建 ByteBuffer? 68)Java 中,怎么读写 ByteBuffer ? 69)Java 采用的是大端还是小端? 70)ByteBuffer 中的字节序是什么? 71)Java 中,直接缓冲区与非直接缓冲器有什么区别? 72)Java 中的内存映射缓存区是什么? 73)socket 选项 TCP NO DELAY 是指什么? 74)TCP 协议与 UDP 协议有什么区别? 75)Java 中,ByteBuffer 与 StringBuffer有什么区别? Java 最佳实践的面试问题 包含 Java 中各个部分的最佳实践,如集合,字符串,IO,多线程,错误和异常处理,设计模式等等。 76)Java 中,编写多线程程序的时候你会遵循哪些最佳实践?(答案) 这是我在写Java 并发程序的时候遵循的一些最佳实践: a)给线程命名,这样可以帮助调试。 c)如果可以,更偏向于使用 volatile 而不是 synchronized。 e)优先使用并发集合,而不是对集合进行同步。并发集合提供更好的可扩展性。 77)说出几点 Java 中使用 Collections 的最佳实践(答案) 这是我在使用 Java 中 Collection 类的一些最佳实践: a)使用正确的集合类,例如,如果不需要同步列表,使用 ArrayList 而不是 Vector。 b)优先使用并发集合,而不是对集合进行同步。并发集合提供更好的可扩展性。 c)使用接口代表和访问集合,如使用List存储 ArrayList,使用 Map 存储 HashMap 等等。 d)使用迭代器来循环集合。 e)使用集合的时候使用泛型。 78)说出至少 5 点在 Java 中使用线程的最佳实践。(答案) 这个问题与之前的问题类似,你可以使用上面的答案。对线程来说,你应该: a)对线程命名 b)将线程和任务分离,使用线程池执行器来执行 Runnable 或 Callable。 c)使用线程池 79)说出 5 条 IO 的最佳实践(答案) IO 对 Java 应用的性能非常重要。理想情况下,你不应该在你应用的关键路径上避免 IO 操作。下面是一些你应该遵循的 Java IO 最佳实践: a)使用有缓冲区的 IO 类,而不要单独读取字节或字符。 b)使用 NIO 和 NIO2 c)在 finally 块中关闭流,或者使用 try-with-resource(Java7) 语句。 d)使用内存映射文件获取更快的 IO。 80)列出 5 个应该遵循的 JDBC 最佳实践(答案) 有很多的最佳实践,你可以根据你的喜好来例举。下面是一些更通用的原则: a)使用批量的操作来插入和更新数据 c)使用数据库连接池 d)通过列名来获取结果集,不要使用列的下标来获取。 81)说出几条 Java 中方法重载的最佳实践?(答案) a)不要重载这样的方法:一个方法接收 int 参数,而另个方法接收 Integer 参数。 c)如果重载的方法参数个数多于 5 个,采用可变参数。 Date、Time 及 Calendar 的面试题 82)在多线程环境下,SimpleDateFormat 是线程安全的吗?(答案) 不是,非常不幸,DateFormat 的所有实现,包括 SimpleDateFormat 都不是线程安全的,因此你不应该在多线程序中使用,除非是在对外线程安全的环境中使用,如 将 SimpleDateFormat 限制在 ThreadLocal 中。如果你不这么做,在解析或者格式化日期的时候,可能会获取到一个不正确的结果。因此,从日期、时间处理的所有实践来说,我强力推荐 joda-time 库。 83)Java 中如何格式化一个日期?如格式化为 ddMMyyyy 的形式?(答案) Java 中,可以使用 SimpleDateFormat 类或者 joda-time 库来格式日期。DateFormat 类允许你使用多种流行的格式来格式化日期。参见答案中的示例代码,代码中演示了将日期格式化成不同的格式,如 dd-MM-yyyy 或 ddMMyyyy。 84)Java 中,怎么在格式化的日期中显示时区? pattern中加z yyyy-MM-dd HH:mm:ss.SSS Z 85)Java 中 java.util.Date 与 java.sql.Date 有什么区别? java.sql.Date是针对SQL语句使用的,它只包含日期而没有时间部分,它们都有getTime方法返回毫秒数,自然就可以直接构建。java.util.Date 是 java.sql.Date 的父类,前者是常用的表示时间的类,我们通常格式化或者得到当前时间都是用他,后者之后在读写数据库的时候用他,因为PreparedStament的setDate()的第2参数和ResultSet的getDate()方法的第2个参数都是java.sql.Date。 86)Java 中,如何计算两个日期之间的差距? public static int dateDiff(Date d1, Date d2) throws Exception { long n1 = d1.getTime(); long n2 = d2.getTime(); long diff = Math.abs(n1 - n2); diff /= 3600100024; return diff; } 87)Java 中,如何将字符串 YYYYMMDD 转换为日期? SimpleDateFormat的parse方法 单元测试 JUnit 面试题 89)如何测试静态方法? 可以使用 PowerMock 库来测试静态方法。 90)怎么利用 JUnit 来测试一个方法的异常? 91)你使用过哪个单元测试库来测试你的 Java 程序? 92)@Before 和 @BeforeClass 有什么区别? 编程和代码相关的面试题 93)怎么检查一个字符串只包含数字? 94)Java 中如何利用泛型写一个 LRU 缓存? 95)写一段 Java 程序将 byte 转换为 long? 96)在不使用 StringBuffer 的前提下,怎么反转一个字符串? 97)Java 中,怎么获取一个文件中单词出现的最高频率? 98)如何检查出两个给定的字符串是反序的? 99)Java 中,怎么打印出一个字符串的所有排列? 100)Java 中,怎样才能打印出数组中的重复元素? 101)Java 中如何将字符串转换为整数? 102)在没有使用临时变量的情况如何交换两个整数变量的值? 关于 OOP 和设计模式的面试题 这部分包含 Java 面试过程中关于 SOLID 的设计原则,OOP 基础,如类,对象,接口,继承,多态,封装,抽象以及更高级的一些概念,如组合、聚合及关联。也包含了 GOF 设计模式的问题。 103)接口是什么?为什么要使用接口而不是直接使用具体类? 接口用于定义 API。它定义了类必须得遵循的规则。同时,它提供了一种抽象,因为客户端只使用接口,这样可以有多重实现,如 List 接口,你可以使用可随机访问的 ArrayList,也可以使用方便插入和删除的 LinkedList。接口中不允许写代码,以此来保证抽象,但是 Java 8 中你可以在接口声明静态的默认方法,这种方法是具体的。 104)Java 中,抽象类与接口之间有什么不同?(答案) Java 中,抽象类和接口有很多不同之处,但是最重要的一个是 Java 中限制一个类只能继承一个类,但是可以实现多个接口。抽象类可以很好的定义一个家族类的默认行为,而接口能更好的定义类型,有助于后面实现多态机制。关于这个问题的讨论请查看答案。 105)除了单例模式,你在生产环境中还用过什么设计模式? 这需要根据你的经验来回答。一般情况下,你可以说依赖注入,工厂模式,装饰模式或者观察者模式,随意选择你使用过的一种即可。不过你要准备回答接下的基于你选择的模式的问题。 106)你能解释一下里氏替换原则吗? 107) 什么情况下会违反迪米特法则?为什么会有这个问题?(答案) 迪米特法则建议“只和朋友说话,不要陌生人说话”,以此来减少类之间的耦合。 108)适配器模式是什么?什么时候使用? 适配器模式提供对接口的转换。如果你的客户端使用某些接口,但是你有另外一些接口,你就可以写一个适配去来连接这些接口。 109)什么是“依赖注入”和“控制反转”?为什么有人使用? 110)抽象类是什么?它与接口有什么区别?你为什么要使用过抽象类?(答案) 111)构造器注入和 setter 依赖注入,那种方式更好?(答案) 每种方式都有它的缺点和优点。构造器注入保证所有的注入都被初始化,但是 setter 注入提供更好的灵活性来设置可选依赖。如果使用 XML 来描述依赖,Setter 注入的可读写会更强。经验法则是强制依赖使用构造器注入,可选依赖使用 setter 注入。 112)依赖注入和工厂模式之间有什么不同?(答案) 虽然两种模式都是将对象的创建从应用的逻辑中分离,但是依赖注入比工程模式更清晰。通过依赖注入,你的类就是 POJO,它只知道依赖而不关心它们怎么获取。使用工厂模式,你的类需要通过工厂来获取依赖。因此,使用 DI 会比使用工厂模式更容易测试。关于这个话题的更详细讨论请参见答案。 113)适配器模式和装饰器模式有什么区别?(答案) 虽然适配器模式和装饰器模式的结构类似,但是每种模式的出现意图不同。适配器模式被用于桥接两个接口,而装饰模式的目的是在不修改类的情况下给类增加新的功能。 114)适配器模式和代理模式之前有什么不同?(答案) 这个问题与前面的类似,适配器模式和代理模式的区别在于他们的意图不同。由于适配器模式和代理模式都是封装真正执行动作的类,因此结构是一致的,但是适配器模式用于接口之间的转换,而代理模式则是增加一个额外的中间层,以便支持分配、控制或智能访问。 115)什么是模板方法模式?(答案) 模板方法提供算法的框架,你可以自己去配置或定义步骤。例如,你可以将排序算法看做是一个模板。它定义了排序的步骤,但是具体的比较,可以使用 Comparable 或者其语言中类似东西,具体策略由你去配置。列出算法概要的方法就是众所周知的模板方法。 116)什么时候使用访问者模式?(答案) 访问者模式用于解决在类的继承层次上增加操作,但是不直接与之关联。这种模式采用双派发的形式来增加中间层。 117)什么时候使用组合模式?(答案) 组合模式使用树结构来展示部分与整体继承关系。它允许客户端采用统一的形式来对待单个对象和对象容器。当你想要展示对象这种部分与整体的继承关系时采用组合模式。 118)继承和组合之间有什么不同?(答案) 虽然两种都可以实现代码复用,但是组合比继承共灵活,因为组合允许你在运行时选择不同的实现。用组合实现的代码也比继承测试起来更加简单。 119)描述 Java 中的重载和重写?(答案) 重载和重写都允许你用相同的名称来实现不同的功能,但是重载是编译时活动,而重写是运行时活动。你可以在同一个类中重载方法,但是只能在子类中重写方法。重写必须要有继承。 120)Java 中,嵌套公共静态类与顶级类有什么不同?(答案) 类的内部可以有多个嵌套公共静态类,但是一个 Java 源文件只能有一个顶级公共类,并且顶级公共类的名称与源文件名称必须一致。 121) OOP 中的 组合、聚合和关联有什么区别?(答案) 如果两个对象彼此有关系,就说他们是彼此相关联的。组合和聚合是面向对象中的两种形式的关联。组合是一种比聚合更强力的关联。组合中,一个对象是另一个的拥有者,而聚合则是指一个对象使用另一个对象。如果对象 A 是由对象 B 组合的,则 A 不存在的话,B一定不存在,但是如果 A 对象聚合了一个对象 B,则即使 A 不存在了,B 也可以单独存在。 122)给我一个符合开闭原则的设计模式的例子?(答案) 开闭原则要求你的代码对扩展开放,对修改关闭。这个意思就是说,如果你想增加一个新的功能,你可以很容易的在不改变已测试过的代码的前提下增加新的代码。有好几个设计模式是基于开闭原则的,如策略模式,如果你需要一个新的策略,只需要实现接口,增加配置,不需要改变核心逻辑。一个正在工作的例子是 Collections.sort() 方法,这就是基于策略模式,遵循开闭原则的,你不需为新的对象修改 sort() 方法,你需要做的仅仅是实现你自己的 Comparator 接口。 123)抽象工厂模式和原型模式之间的区别? 124)什么时候使用享元模式? 享元模式通过共享对象来避免创建太多的对象。为了使用享元模式,你需要确保你的对象是不可变的,这样你才能安全的共享。JDK 中 String 池、Integer 池以及 Long 池都是很好的使用了享元模式的例子。 Java 面试中其他各式各样的问题 这部分包含 Java 中关于 XML 的面试题,JDBC 面试题,正则表达式面试题,Java 错误和异常及序列化面试题 125)嵌套静态类与顶级类有什么区别?(答案) 一个公共的顶级类的源文件名称与类名相同,而嵌套静态类没有这个要求。一个嵌套类位于顶级类内部,需要使用顶级类的名称来引用嵌套静态类,如 HashMap.Entry 是一个嵌套静态类,HashMap 是一个顶级类,Entry是一个嵌套静态类。 126)你能写出一个正则表达式来判断一个字符串是否是一个数字吗?(解决方案) 一个数字字符串,只能包含数字,如 0 到 9 以及 +、- 开头,通过这个信息,你可以下一个如下的正则表达式来判断给定的字符串是不是数字。 127)Java 中,受检查异常 和 不受检查异常的区别?(答案) 受检查异常编译器在编译期间检查。对于这种异常,方法强制处理或者通过 throws 子句声明。其中一种情况是 Exception 的子类但不是 RuntimeException 的子类。非受检查是 RuntimeException 的子类,在编译阶段不受编译器的检查。 128)Java 中,throw 和 throws 有什么区别?(答案) throw 用于抛出 java.lang.Throwable 类的一个实例化对象,意思是说你可以通过关键字 throw 抛出一个 Error 或者 一个Exception,如: throw new IllegalArgumentException(“size must be multiple of 2″) 而throws 的作用是作为方法声明和签名的一部分,方法被抛出相应的异常以便调用者能处理。Java 中,任何未处理的受检查异常强制在 throws 子句中声明。 129)Java 中,Serializable 与 Externalizable 的区别?(答案) Serializable 接口是一个序列化 Java 类的接口,以便于它们可以在网络上传输或者可以将它们的状态保存在磁盘上,是 JVM 内嵌的默认序列化方式,成本高、脆弱而且不安全。Externalizable 允许你控制整个序列化过程,指定特定的二进制格式,增加安全机制。 130)Java 中,DOM 和 SAX 解析器有什么不同?(答案) DOM 解析器将整个 XML 文档加载到内存来创建一棵 DOM 模型树,这样可以更快的查找节点和修改 XML 结构,而 SAX 解析器是一个基于事件的解析器,不会将整个 XML 文档加载到内存。由于这个原因,DOM 比 SAX 更快,也要求更多的内存,不适合于解析大 XML 文件。 131)说出 JDK 1.7 中的三个新特性?(答案) 虽然 JDK 1.7 不像 JDK 5 和 8 一样的大版本,但是,还是有很多新的特性, (1)如 try-with-resource 语句,这样你在使用流或者资源的时候,就不需要手动关闭,Java 会自动关闭。 (2)Fork-Join 池某种程度上实现 Java 版的 Map-reduce。允许 Switch 中有 String 变量和文本。菱形操作符(<>)用于类型推断,不再需要在变量声明的右边申明泛型,因此可以写出可读写更强、更简洁的代码。另一个值得一提的特性是改善异常处理,如允许在同一个 catch 块中捕获多个异常。 132)说出 5 个 JDK 1.8 引入的新特性?(答案) Java 8 在 Java 历史上是一个开创新的版本,下面 JDK 8 中 5 个主要的特性: (1) Lambda 表达式,允许像对象一样传递匿名函数 Stream API, (2)充分利用现代多核 CPU, (3)可以写出很简洁的代码 Date 与 Time API,最终,有一个稳定、简单的日期和时间库可供你使用 扩展方法, (4)接口中可以有静态、默认方法。 重复注解,现在你可以将相同的注解在同一类型上使用多次。 133)Java 中,Maven 和 ANT 有什么区别?(答案) 虽然两者都是构建工具,都用于创建 Java 应用,但是 Maven 做的事情更多,在基于“约定优于配置”的概念下,提供标准的Java 项目结构,同时能为应用自动管理依赖(应用中所依赖的 JAR 文件),Maven 与 ANT 工具更多的不同之处请参见答案。 这就是所有的面试题,如此之多,是不是?我可以保证,如果你能回答列表中的所有问题,你就可以很轻松的应付任何核心 Java 或者高级 Java 面试。虽然,这里没有涵盖 Servlet、JSP、JSF、JPA,JMS,EJB 及其它 Java EE 技术,也没有包含主流的框架如 Spring MVC,Struts 2.0,Hibernate,也没有包含 SOAP 和 RESTful web service,但是这份列表对做 Java 开发的、准备应聘 Java web 开发职位的人还是同样有用的,因为所有的 Java 面试,开始的问题都是 Java 基础和 JDK API 相关的。如果你认为我这里有任何应该在这份列表中而被我遗漏了的 Java 流行的问题,你可以自由的给我建议。我的目的是从最近的面试中创建一份最新的、最优的 Java 面试问题列表。 说了这么多,想记住是不容易的,下面分享一些整理出来的导图,方便记忆。获取完整导图请加群:878249276 思维导图

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册