首页 文章 精选 留言 我的

精选列表

搜索[禅道],共6181篇文章
优秀的个人博客,低调大师

Java 程序员必须掌握的 8 道数据结构面试题,你会几道?

瑞士计算机科学家Niklaus Wirth在1976年写了一本书,名为《算法+数据结构=编程》。 40多年后,这个等式仍被奉为真理。这就是为什么在面试过程中,需要考察软件工程师对数据结构的理解。 几乎所有的问题都需要面试者对数据结构有深刻的理解。无论你是初入职场的新兵(刚从大学或者编程培训班毕业),还是拥有几十年经验的职场老鸟。 有些面试题会明确提及某种数据结构,例如,“给定一个二叉树。”而另一些则隐含在面试题中,例如,“我们希望记录每个作者相关的书籍数量。” 即便是对于一些非常基础的工作来说,学习数据结构也是必须的。那么,就让我们先从一些基本概念开始入手。 说到这里,也给大家推荐一个架构交流学习群:835544715,里面会分享一些资深架构师录制的视频录像:有Spring,MyBatis,Netty源码分析,高并发、高性能、分布式、微服务架构的原理,JVM性能优化这些成为架构师必备的知识体系。还能领取免费的学习资源,相信对于已经工作和遇到技术瓶颈的码友,在这个群里会有你需要的内容。 什么是数据结构? 简单地说,数据结构是以某种特定的布局方式存储数据的容器。这种“布局方式”决定了数据结构对于某些操作是高效的,而对于其他操作则是低效的。首先我们需要理解各种数据结构,才能在处理实际问题时选取最合适的数据结构。 为什么我们需要数据结构? 数据是计算机科学当中最关键的实体,而数据结构则可以将数据以某种组织形式存储,因此,数据结构的价值不言而喻。 无论你以何种方式解决何种问题,你都需要处理数据——无论是涉及员工薪水、股票价格、购物清单,还是只是简单的电话簿问题。 数据需要根据不同的场景,按照特定的格式进行存储。有很多数据结构能够满足以不同格式存储数据的需求。 常见的数据结构 首先列出一些最常见的数据结构,我们将逐一说明: 数组 栈 队列 链表 树 图 字典树(这是一种高效的树形结构,但值得单独说明) 散列表(哈希表) 数组 数组是最简单、也是使用最广泛的数据结构。栈、队列等其他数据结构均由数组演变而来。下图是一个包含元素(1,2,3和4)的简单数组,数组长度为4。 每个数据元素都关联一个正数值,我们称之为索引,它表明数组中每个元素所在的位置。大部分语言将初始索引定义为零。关注Java技术栈微信公众号,回复"面试"获取更多博主精心整理的面试题。 以下是数组的两种类型: 一维数组(如上所示) 多维数组(数组的数组) 数组的基本操作 Insert——在指定索引位置插入一个元素 Get——返回指定索引位置的元素 Delete——删除指定索引位置的元素 Size——得到数组所有元素的数量 面试中关于数组的常见问题 寻找数组中第二小的元素 找到数组中第一个不重复出现的整数 合并两个有序数组 重新排列数组中的正值和负值 栈 著名的撤销操作几乎遍布任意一个应用。但你有没有思考过它是如何工作的呢?这个问题的解决思路是按照将最后的状态排列在先的顺序,在内存中存储历史工作状态(当然,它会受限于一定的数量)。这没办法用数组实现。但有了栈,这就变得非常方便了。 可以把栈想象成一列垂直堆放的书。为了拿到中间的书,你需要移除放置在这上面的所有书。这就是LIFO(后进先出)的工作原理。 下图是包含三个数据元素(1,2和3)的栈,其中顶部的3将被最先移除: 栈的基本操作 Push——在顶部插入一个元素 Pop——返回并移除栈顶元素 isEmpty——如果栈为空,则返回true Top——返回顶部元素,但并不移除它 面试中关于栈的常见问题 使用栈计算后缀表达式 对栈的元素进行排序 判断表达式是否括号平衡 队列 与栈相似,队列是另一种顺序存储元素的线性数据结构。栈与队列的最大差别在于栈是LIFO(后进先出),而队列是FIFO,即先进先出。 一个完美的队列现实例子:售票亭排队队伍。如果有新人加入,他需要到队尾去排队,而非队首——排在前面的人会先拿到票,然后离开队伍。 下图是包含四个元素(1,2,3和4)的队列,其中在顶部的1将被最先移除: 移除先入队的元素、插入新元素 队列的基本操作 Enqueue() —— 在队列尾部插入元素 Dequeue() ——移除队列头部的元素 isEmpty()——如果队列为空,则返回true Top() ——返回队列的第一个元素 面试中关于队列的常见问题 使用队列表示栈 对队列的前k个元素倒序 使用队列生成从1到n的二进制数 链表 链表是另一个重要的线性数据结构,乍一看可能有点像数组,但在内存分配、内部结构以及数据插入和删除的基本操作方面均有所不同。关注Java技术栈微信公众号,回复"面试"获取更多博主精心整理的面试题。 链表就像一个节点链,其中每个节点包含着数据和指向后续节点的指针。 链表还包含一个头指针,它指向链表的第一个元素,但当列表为空时,它指向null或无具体内容。 链表一般用于实现文件系统、哈希表和邻接表。 这是链表内部结构的展示: 链表包括以下类型: 单链表(单向) 双向链表(双向) 链表的基本操作: InsertAtEnd - 在链表的末尾插入指定元素 InsertAtHead - 在链接列表的开头/头部插入指定元素 Delete - 从链接列表中删除指定元素 DeleteAtHead - 删除链接列表的第一个元素 Search - 从链表中返回指定元素 isEmpty - 如果链表为空,则返回true 面试中关于链表的常见问题 反转链表 检测链表中的循环 返回链表倒数第N个节点 删除链表中的重复项 图 图是一组以网络形式相互连接的节点。节点也称为顶点。 一对节点(x,y)称为边(edge),表示顶点x连接到顶点y。边可以包含权重/成本,显示从顶点x到y所需的成本。 图的类型 无向图 有向图 在程序语言中,图可以用两种形式表示: 邻接矩阵 邻接表 常见图遍历算法 广度优先搜索 深度优先搜索 面试中关于图的常见问题 实现广度和深度优先搜索 检查图是否为树 计算图的边数 找到两个顶点之间的最短路径 树 树形结构是一种层级式的数据结构,由顶点(节点)和连接它们的边组成。 树类似于图,但区分树和图的重要特征是树中不存在环路。 树形结构被广泛应用于人工智能和复杂算法,它可以提供解决问题的有效存储机制。 这是一个简单树的示意图,以及树数据结构中使用的基本术语: Root - 根节点 Parent - 父节点 Child - 子节点 Leaf - 叶子节点 Sibling - 兄弟节点 想要学习Java高架构、分布式架构、高可扩展、高性能、高并发、性能优化、Spring boot、Redis、ActiveMQ、Nginx、Mycat、Netty、Jvm大型分布式项目实战学习架构师视频免费获取 架构群:835544715 点击链接加入群聊【JAVA高级架构】:https://jq.qq.com/?_wv=1027&k=5dbERkY 以下是树形结构的主要类型: N元树 平衡树 二叉树 二叉搜索树 AVL树 红黑树 2-3树 其中,二叉树和二叉搜索树是最常用的树。 面试中关于树结构的常见问题: 求二叉树的高度 在二叉搜索树中查找第k个最大值 查找与根节点距离k的节点 在二叉树中查找给定节点的祖先节点 字典树(Trie) 字典树,也称为“前缀树”,是一种特殊的树状数据结构,对于解决字符串相关问题非常有效。它能够提供快速检索,主要用于搜索字典中的单词,在搜索引擎中自动提供建议,甚至被用于IP的路由。 以下是在字典树中存储三个单词“top”,“so”和“their”的例子: 这些单词以顶部到底部的方式存储,其中绿色节点“p”,“s”和“r”分别表示“top”,“thus”和“theirs”的底部。 面试中关于字典树的常见问题 计算字典树中的总单词数 打印存储在字典树中的所有单词 使用字典树对数组的元素进行排序 使用字典树从字典中形成单词 构建T9字典(字典树+ DFS ) 哈希表 哈希法(Hashing)是一个用于唯一标识对象并将每个对象存储在一些预先计算的唯一索引(称为“键(key)”)中的过程。因此,对象以键值对的形式存储,这些键值对的集合被称为“字典”。可以使用键搜索每个对象。基于哈希法有很多不同的数据结构,但最常用的数据结构是哈希表。 哈希表通常使用数组实现。 散列数据结构的性能取决于以下三个因素: 哈希函数 哈希表的大小 碰撞处理方法 下图为如何在数组中映射哈希键值对的说明。该数组的索引是通过哈希函数计算的。 面试中关于哈希结构的常见问题: 在数组中查找对称键值对 追踪遍历的完整路径 查找数组是否是另一个数组的子集 检查给定的数组是否不相交 想要学习Java高架构、分布式架构、高可扩展、高性能、高并发、性能优化、Spring boot、Redis、ActiveMQ、Nginx、Mycat、Netty、Jvm大型分布式项目实战学习架构师视频免费获取 架构群:835544715 点击链接加入群聊【JAVA高级架构】:https://jq.qq.com/?_wv=1027&k=5dbERkY

优秀的个人博客,低调大师

javascript基础修炼(1)——一道十面埋伏的原型链面试题

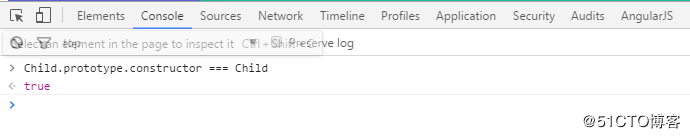
在基础面前,一切技巧都是浮云。 题目是这样的 要求写出控制台的输出. function Parent() { this.a = 1; this.b = [1, 2, this.a]; this.c = { demo: 5 }; this.show = function () { console.log(this.a , this.b , this.c.demo ); } } function Child() { this.a = 2; this.change = function () { this.b.push(this.a); this.a = this.b.length; this.c.demo = this.a++; } } Child.prototype = new Parent(); var parent = new Parent(); var child1 = new Child(); var child2 = new Child(); child1.a = 11; child2.a = 12; parent.show(); child1.show(); child2.show(); child1.change(); child2.change(); parent.show(); child1.show(); child2.show(); 题目涉及的知识点 this的指向 原型机原型链 类的继承 原始类型和引用类型的区别 每一个知识点都可以拿出来做单独的专题研究。 解题需要的知识点细节 1.构造函数,都有一个prototype属性,指向构造函数的原型对象,实例会共享同一个原型对象; 2.实例生成时,会在内存中产生一块新的堆内存,对实例的一般操作将不影响其他实例,因为在堆内存里占据不同空间,互不影响; 3.每一个实例都有一个隐式原型__proto__指向构造函数的原型对象; 4.this的指向问题,常见的情况包含如下几种: 4.1 作为对象方法时,谁调用就指向谁(本题中主要涉及这一条) 4.2 作为函数调用时,指向全局顶层变量window 4.3 作为构造函数调用时,即new操作符生成实例时,构造函数中的this指向实例 4.4 call和apply方法中,显示指定this的绑定为指定上下文 5.字面量的方式(也有资料将literal翻译为直接量,个人认为后一种翻译其实更直观更形象)进行对象和数组赋值(数组本质也是对象)时,都是引用,即在堆内存生成资源,在栈内存生成变量,然后变量指向资源的地址。 6.原型链的查找规则遵循最短路径原则,即先查找实例属性,然后顺着原型链去查找指定的属性,直至原型链末端的Object.prototype和null,如果实例自身及整个原型链都不存在所查找的属性则返回undefined 7.赋值语句对于原始值赋值和引用类型赋值时的细节区别. 开始剖题 1.parent.show() 基本没什么可解释的。 直接取值就能得出答案1 [1,2,1] 5; 2.child1.show() Child的构造函数原本是指向Child的 题目中显式将Child类的原型对象指向了Parent类的一个实例,这是javascript面向对象编程中常见的继承方式之一。此处需要注意Child.prototype指向的是Parent的实例parent,而不是指向Parent这个类 直接在控制台操作输出答案可得11 [1,2,1] 5 此处令人迷惑的是this.b指向的数组最后一列为什么是1而不是11? 先来看一下child1的样子: 当执行child1.show()这个方法时,由于child1作为Child的实例,是拥有a这个属性的,所以show()方法中的this.a会直接指向这个属性的值,也就是11,而不会继续沿原型链取到__proto__所指的对象上的a属性; 接着寻找this.b,由于child1是没有b这个属性的,所以会沿原型链取到parent上的b属性,其值是一个数组,前2项是常量没什么好说的,数组的最后一项是一个引用,而此处的指针并不是一个动态指向,因为在new Parent()这一步的时候它已经被执行过一次,确定指向了parent.a所指向的资源,也就是child1.__proto__中的a属性所指向的资源,即数值1。 延伸思考 需要注意的是: 1.从代码上看,child1.__proto__.b数组的第三项是指向child1.__proto__.a的,那我们此时修改child1.__proto__.a的值,是否会影响child1.show()的结果呢: 答案是木有影响,为什么看起来指向同一个地址的属性却出现值不一样的情形?因为parent实例生成的时候,this.a指向了一个原始值2,所以this.b中的第三项实际上是被赋值了一个原始值,故此处乍看起来像是引用类型的赋值,实则不是。原始值赋值会开辟新的存储空间,使得this.a和this.b[2]的值相等,但是却指向了堆内存里的不同地址。更多详细解释可以参见【扩展阅读】中推荐的博文。 2.那怎样让child1.__proto__.b数组的第三项也输出11呢? 实例化后修改 由于在Parent类定义中,b属性数组的第三项是指向a属性的值的,意味着在Parent实例化之前这个引用是动态指向的,所以只要在Parent实例化之前改变类定义中this.a的值,就可以达到想要的效果,如果在Parent已经实例化,则只能显式修改*.b[2]这个属性的值。 get/set方法同步 另一种方式是通过为a属性设置get/set方法,是的每当a属性的值发生变化时,同步修改b[2]的值,代码和运行结果如下所示: 3.child2.show() 如果理解了上面的解释,那么此处同理即可得出答案:12 [1,2,1] 5 接着代码执行了: child1.change(); child2.change(); 4.parent.show() parent是一个Parent类的实例,Child.prorotype指向的是Parent类的另一个实例,两者在堆内存中是两份资源,互不影响,所以上述操作不影响parent实例, 输出结果保持不变:1 [1,2,1] 5; 5.child1.show(),child2.show() child1执行了change()方法后,发生了怎样的变化呢? this.b.push(this.a) 由于this的动态指向特性,this.b会指向Child.prototype上的b数组,this.a会指向child1的a属性,所以Child.prototype.b变成了[1,2,1,11]; this.a = this.b.length 这条语句中this.a和this.b的指向与上一句一致,故结果为child1.a变为4; this.c.demo = this.a++ 由于child1自身属性并没有c这个属性,所以此处的this.c会指向Child.prototype.c,this.a值为4,为原始类型,故赋值操作时会直接赋值,Child.prototype.c.demo的结果为4,而this.a随后自增为5(4 + 1 = 5). 接着,child2执行了change()方法, 而child2和child1均是Child类的实例,所以他们的原型链指向同一个原型对象Child.prototype,也就是同一个parent实例,所以child2.change()中所有影响到原型对象的语句都会影响child1的最终输出结果 this.b.push(this.a) 由于this的动态指向特性,this.b会指向Child.prototype上的b数组,this.a会指向child2的a属性,所以Child.prototype.b变成了[1,2,1,11,12]; this.a = this.b.length 这条语句中this.a和this.b的指向与上一句一致,故结果为child2.a变为5; this.c.demo = this.a++ 由于child2自身属性并没有c这个属性,所以此处的this.c会指向Child.prototype.c,故执行结果为Child.prototype.c.demo的值变为child2.a的值5,而child2.a最终自增为6(5 + 1 = 6). 接下来执行输出命令,最终结果将输出:child1.show():5 [1,2,1,11,12] 5child2.show():6 [1,2,1,11,12] 5 延伸思考 自己在解题时,在this.c.demo = this.a++出错,本以为这里会传引用,但实际是传了值,分析后明白因为this.a指向的是一个原始值,故此处相当于将原始值赋值给对象属性,所以赋值后child.c.demo的值不会再受到child.a的变化的影响。如果child.a是一个引用类型,那么结果会变成什么样子呢? 我们对源码做一些修改,将child.a指向一个对象(即引用类型): 然后运行后就会发现,Child.prototype.c的值会随着child1.a的变化而变化,因为此时child1.a的值是一个引用类型,赋值过程会使得Child.prototype.c和child1.a指向同一份资源的内存空间地址。对于原始类型和引用类型更详细的解说,可以参考篇尾扩展阅读中的博客。 收获和反思 1.基础知识本来就是零散的细节,必须本着死磕到底的心态进行学习。 2.基础知识是最枯燥的,也是真正拉开人和人之间差距的东西,也是你想进入大厂必须要跨过的门槛,重要却不紧急。同样是菜鸟,有的人3-5年后成为了前端架构师,有的人3-5年后还在用层出不穷的新框架给按钮绑事件,想成为怎样的人,就要付出怎样的努力,大多数时候都是没毛病的。基础很重要!很重要!很重要! 3.基础这个东西是要不断看的,像红宝书(javascript高级程序设计)和犀牛书(javascript权威指南)这种书,最好多过几遍,一些难以理解的现象,往往是由于对底层原理理解不到位造成的,买来新书直接用来垫高显示器你不心疼的吗?喜马拉雅上有一个免费的陪你读书系列节目,30多期的音频通篇讲解了红宝书的内容,对不喜欢看书的童鞋绝对是一大福音。 扩展阅读 JavaScript数据操作--原始值和引用值的操作本质 [javascript高级程序设计]第4章

优秀的个人博客,低调大师

Gartner:在中国大行其道的公有云服务为咨询与实施带来良机

Gartner 2016年首席信息官调查结果(参见图一)显示,云服务位列首席信息官选择及投资的中国前5大技术领域。由于中国政府的积极参与,公有云服务(IaaS)在中国的采纳度明显有别于其他国家。另一个不同之处在于,各个垂直行业的采购行为或需求相去甚远。为了更好的定位基础架构即服务的咨询与实施服务,技术业务部的领导者们必须深入了解中国政府与各企业的政策和最新计划。基于以下优先选择项目,我们预计到2020年,公有云服务将为服务提供商贡献至少15%的咨询与实施收入。 图一、2016年中国首要的技术优先领域 资料来源:Gartner(2016年12月) 受政府监管的中国公有云服务(IaaS) 中国监管机构不允许国外公有云提供商自行提供公共通信服务。这些提供商在构建数据中心与网络基础架构以及实施日常运营与交付服务方面均须严格遵守相关法规。国外公有云服务提供商侧重于交付技术与平台;而中国公有云服务合作伙伴则一般负责基础架构的日常运营与本地客户支持。 另一个监管重点与数据的本地处理及存储要求相关。此类法规目前适用于银行与金融企业,而今后将延伸至其他行业。近期全球趋势显示,对于敏感数据跨境流动的关注正日益增加。 采用中国公有云的客户只能通过中国证书登录,而无法利用同一证书登录其全球云基础架构,反之亦然。此外,本地公有云提供商可以构建自身的独立数据中心,但仍需要遵守其他数据安全相关政策。 公有云服务商通过合作伙伴提供基于公有云的企业级咨询与实施服务是最可行的方式 各种合作伙伴关系构成了公有云服务的应用生态系统。中国的公有云服务提供商面临多种选择;我们将其分为全球从业者、中国本土互联网公司、通信服务提供商(CSP)以及一些在特定领域拥有优势的服务供应商。根据企业机构的技术与业务需求来挑选适合的服务,对于企业首席信息官而言将至关重要。 虽然有些人可能认为公有云服务是一种商品,而且价格是唯一重要的考虑因素,Gartner认为市场内领先提供商之间的服务特性与配置也差别很大,因此价格不应是制定采购决策的唯一考虑因素。 咨询服务提供商生态系统可帮助企业评估不同公有云服务提供商的服务产品,洽谈合同并展开总拥有成本分析。 大部分中国公共云服务提供商一般先构建基准产品与服务,然后在其中添加更多功能特性时再考虑具体使用案例。它们通常不为客户提供定制化服务。 咨询与实施服务提供商应从合同的视角深入了解各种公有云服务提供商的产品与服务,以帮助客户躲避陷阱。此外,它们还必须具体了解定价模式、保障服务水平协议的方式、数据保护与存储等详细信息。 咨询和服务供应商应该了解各垂直行业对于公有云的应用程度度各不相同 公有云服务成熟度在不同垂直行业不尽相同,如:完善冗余系统或交付新服务。最近,许多中国企业对运行在公有云上的数字商务应用很感兴趣。然而,公有云服务提供商的产品与服务往往非常复杂,且功能繁多,因此需要专业技能才能实现最佳应用。许多IT企业机构并未充分理解关于原生云架构以及这些平台DevOps运营的最佳实践,而专业的咨询与实施服务可以有助于弥合技术缺口。 此外,各垂直行业可能已制定了行业指南,借以充分利用与中国“十三五”规划相关的新兴技术。例如,中国银监会于2016年7月15日发布了《中国银行业信息科技“十三五”发展规划监管指导意见》。而且,所有银行均须协作建立行业性公有云平台。 一般而言,公有云服务提供商将提供云基础架构与支持服务,支持各企业通过云平台运行其应用,从而赋予客户可扩展性与敏捷性优势。公有云服务商不会提供以下服务,而这为咨询服务提供商带来了大好机会: 公有云服务供应商的选择与评估 关于公有云服务的合约谈判 各垂直行业的最佳实践与经验教训 在利用公有云或私有云服务时确立云部署战略 定义从传统IT基础架构到公有云或从私有云到公有云的迁移战略 通过公有云服务提供数据安全、风险评估、IT治理解决方案的咨询 定制服务水平协议。例如,公有云服务商不提供99.999%的服务保证,而咨询服务提供商可在此方面协助客户 本地与全球云平台的无缝对接 原文发布时间为:2017年7月6日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网

优秀的个人博客,低调大师

为什么大模型总会“胡说八道“?一文彻底搞懂 RAG 知识库原理!

随着大模型技术的发展,越来越多的企业开始尝试将大语言模型应用到实际业务场景中,例如企业知识问答、客服机器人、技术文档助手等。然而在实际落地过程中,人们很快发现一个问题:大模型虽然"知识丰富",但在面对专业领域问题时,经常出现回答不准确、编造信息(幻觉)或无法访问企业内部数据的情况。

优秀的个人博客,低调大师

最新整理的运维工程师面试真的太给力了,整整50道,速度收藏!

1、请简述OSI七层网络模型有哪些层及各自的含义? 物理层:底层数据传输,比如网线、网卡标准 数据链路层:定义数据的基本格式,如何传输,如何标识。比如网卡MAC地址 网络层:定义IP编码,定义路由功能,比如不同设备的数据转发 传输层:端到端传输数据的基本功能,比如TCP、UDP 会话层:控制应用程序之间会话能力,比如不同软件数据分发给不停软件 表示层:数据格式标识,基本压缩加密功能。 应用层:各种应用软件,包括 Web 应用。 2、在Linux的LVM分区格式下,请简述给根分区磁盘扩容的步骤? 这个分3种 第一种方法: growpart/dev/vda1 resize2fs/dev/vda1 第二种方法: partpeobe/dev/sda resize2fs/dev/vda1 第三种方法: fdisk/dev/sdb#np11回车回车t8ew pvcreate/dev/sdb1 vgextenddatavg/dev/sdb1 lvextend-r-L+100%free/dev/mapper/datavg-lv01 3、讲述一下Tomcat8005、8009、8080三个端口的含义? 8005 关闭时使用 8009为AJP端口,即容器使用,如Apache能通过AJP协议访问Tomcat的8009端口来实现功能 8080 一般应用使用 4、简述DNS进行域名解析的过程? 迭代查询(返回最优结果)、递归查询(本地找DNS)用户要访问 www.baidu.com,会先找本机的host文件,再找本地设置的DNS服务器,如果也没有找到,就去网络中找根服务器,根服务器反馈结果,说只能提供一级域名服务器.cn,就去找一级域名服务器,一级域名服务器说只能提供二级域名服务器.com.cn,就去找二级域名服务器,二级域服务器只能提供三级域名服务器.baidu.com.cn,就去找三级域名服务器,三级域名服务器正好有这个网站www.baidu.com,然后发给请求的服务器,保存一份之后,再发给客户端。 5、讲一下Keepalived的工作原理? 在一个虚拟路由器中,只有作为MASTER的VRRP(虚拟路由冗余协议)路由器会一直发送VRRP通告信息,BACKUP不会抢占MASTER,除非它的优先级更高。当MASTER不可用时(BACKUP收不到通告信息)多台BACKUP中优先级最高的这台会被抢占为MASTER。这种抢占是非常快速的(<1s),以保证服务的连续性由于安全性考虑,VRRP包使用了加密协议进行加密。BACKUP不会发送通告信息,只会接收通告信息。 6、LVS、Nginx、HAproxy有什么区别?工作中你怎么选择? LVS: 抗负载能力强、工作在第4层仅作分发之用,没有流量的产生,这个特点也决定了它在负载均衡软件里的性能最强的;无流量,同时保证了均衡器IO的性能不会受到大流量的影响; 工作稳定,自身有完整的双机热备方案,如LVS+Keepalived和LVS+Heartbeat; 应用范围比较广,可以对所有应用做负载均衡; 配置简单,因为没有可太多配置的东西,所以并不需要太多接触,大大减少了人为出错的几率; LVS的缺点: 软件本身不支持正则处理,不能做动静分离,这就凸显了Nginx/HAProxy+Keepalived的优势。 如果网站应用比较庞大,LVS/DR+Keepalived就比较复杂了,特别是后面有Windows Server应用的机器,实施及配置还有维护过程就比较麻烦,相对而言,Nginx/HAProxy+Keepalived就简单多了。 Nginx: 工作在第7层,应用层,可以针对http应用做一些分流的策略。比如针对域名、目录结构。它的正则比HAProxy更为强大和灵活; Nginx对网络的依赖非常小,理论上能ping通就就能进行负载功能 Nginx安装和配置简单 可以承担高的负载压力且稳定,一般能支撑超过几万次的并发量; Nginx不仅仅是一款优秀的负载均衡器/反向代理软件,它同时也是功能强大的Web应用服务器。Nginx在处理静态页面、特别是抗高并发方面相对apache有优势; Nginx作为Web反向代理加速缓存越来越成熟,速度比传统的Squid服务器更快 Nginx的缺点: Nginx不支持url来检测。 Nginx仅能支持http、https和Email协议 Nginx的Session的保持,Cookie的引导能力相对欠缺。 HAProxy: HAProxy是支持虚拟主机的,可以工作在4、7层(支持多网段); 能够补充Nginx的一些缺点比如Session的保持,Cookie的引导等工作; 支持url检测后端的服务器; 它跟LVS一样,本身仅仅就只是一款负载均衡软件;单纯从效率上来讲HAProxy更会比Nginx有更出色的负载均衡速度,在并发处理上也是优于Nginx的; HAProxy可以对Mysql读进行负载均衡,对后端的MySQL节点进行检测和负载均衡,不过在后端的MySQL slaves数量超过10台时性能不如LVS; HAProxy的算法较多,达到8种; 工作选择: HAproxy和Nginx由于可以做七层的转发,所以URL和目录的转发都可以做在很大并发量的时候我们就要选择LVS,像中小型公司的话并发量没那么大选择HAproxy或者Nginx足已,由于HAproxy由是专业的代理服务器配置简单,所以中小型企业推荐使用HAproxy。 7、docker的工作原理是什么,讲一下 docker是一个Client-Server结构的系统,docker守护进程运行在宿主机上,守护进程从客户端接受命令并管理运行在主机上的容器,容器是一个运行时环境,这就是我们说的集装箱。 8、docker的组成包含哪几大部分 一个完整的docker有以下几个部分组成: docker client,客户端,为用户提供一系列可执行命令,用户用这些命令实现跟 docker daemon 交互; docker daemon,守护进程,一般在宿主主机后台运行,等待接收来自客户端的请求消息; docker image,镜像,镜像run之后就生成为docker容器; docker container,容器,一个系统级别的服务,拥有自己的ip和系统目录结构;运行容器前需要本地存在对应的镜像,如果本地不存在该镜像则就去镜像仓库下载。 docker 使用客户端-服务器 (C/S) 架构模式,使用远程api来管理和创建docker容器。docker 容器通过 docker 镜像来创建。容器与镜像的关系类似于面向对象编程中的对象与类。 9、docker与传统虚拟机的区别什么? 传统虚拟机是需要安装整个操作系统的,然后再在上面安装业务应用,启动应用,通常需要几分钟去启动应用,而docker是直接使用镜像来运行业务容器的,其容器启动属于秒级别; Docker需要的资源更少,Docker在操作系统级别进行虚拟化,Docker容器和内核交互,几乎没有性能损耗,而虚拟机运行着整个操作系统,占用物理机的资源就比较多; Docker更轻量,Docker的架构可以共用一个内核与共享应用程序库,所占内存极小;同样的硬件环境,Docker运行的镜像数远多于虚拟机数量,对系统的利用率非常高; 与虚拟机相比,Docker隔离性更弱,Docker属于进程之间的隔离,虚拟机可实现系统级别隔离; Docker的安全性也更弱,Docker的租户root和宿主机root相同,一旦容器内的用户从普通用户权限提升为root权限,它就直接具备了宿主机的root权限,进而可进行无限制的操作。虚拟机租户root权限和宿主机的root虚拟机权限是分离的,并且虚拟机利用如Intel的VT-d和VT-x的ring-1硬件隔离技术,这种技术可以防止虚拟机突破和彼此交互,而容器至今还没有任何形式的硬件隔离; Docker的集中化管理工具还不算成熟,各种虚拟化技术都有成熟的管理工具,比如:VMware vCenter提供完备的虚拟机管理能力; Docker对业务的高可用支持是通过快速重新部署实现的,虚拟化具备负载均衡,高可用、容错、迁移和数据保护等经过生产实践检验的成熟保障机制,Vmware可承诺虚拟机99.999%高可用,保证业务连续性; 虚拟化创建是分钟级别的,Docker容器创建是秒级别的,Docker的快速迭代性,决定了无论是开发、测试、部署都可以节省大量时间; 虚拟机可以通过镜像实现环境交付的一致性,但镜像分发无法体系化,Docker在Dockerfile中记录了容器构建过程,可在集群中实现快速分发和快速部署。from wljslmz 10、docker技术的三大核心概念是什么? 镜像:镜像是一种轻量级、可执行的独立软件包,它包含运行某个软件所需的所有内容,我们把应用程序和配置依赖打包好形成一个可交付的运行环境(包括代码、运行时需要的库、环境变量和配置文件等),这个打包好的运行环境就是image镜像文件。 容器:容器是基于镜像创建的,是镜像运行起来之后的一个实例,容器才是真正运行业务程序的地方。如果把镜像比作程序里面的类,那么容器就是对象。 镜像仓库:存放镜像的地方,研发工程师打包好镜像之后需要把镜像上传到镜像仓库中去,然后就可以运行有仓库权限的人拉取镜像来运行容器了。 11、centos镜像几个G,但是docker centos镜像才几百兆,这是为什么? 一个完整的Linux操作系统包含Linux内核和rootfs根文件系统,即我们熟悉的/dev、/proc/、/bin等目录。我们平时看到的centOS除了rootfs,还会选装很多软件,服务,图形桌面等,所以centOS镜像有好几个G也不足为奇。 而对于容器镜像而言,所有容器都是共享宿主机的Linux 内核的,而对于docker镜像而言,docker镜像只需要提供一个很小的rootfs即可,只需要包含最基本的命令,工具,程序库即可,所有docker镜像才会这么小。 12、讲一下镜像的分层结构以及为什么要使用镜像的分层结构? 一个新的镜像其实是从 base 镜像一层一层叠加生成的。每安装一个软件,dockerfile中使用RUM命令,就会在现有镜像的基础上增加一层,这样一层一层的叠加最后构成整个镜像。所以我们docker pull拉取一个镜像的时候会看到docker是一层层拉去的。 分层机构最大的一个好处就是 :共享资源。比如:有多个镜像都从相同的 base 镜像构建而来,那么 Docker Host 只需在磁盘上保存一份 base 镜像;同时内存中也只需加载一份 base 镜像,就可以为所有容器服务了。而且镜像的每一层都可以被共享。 13、讲一下容器的copy-on-write特性,修改容器里面的内容会修改镜像吗? 我们知道,镜像是分层的,镜像的每一层都可以被共享,同时,镜像是只读的。当一个容器启动时,一个新的可写层被加载到镜像的顶部,这一层通常被称作“容器层”,“容器层”之下的都叫“镜像层”。 所有对容器的改动 - 无论添加、删除、还是修改文件,都只会发生在容器层中,因为只有容器层是可写的,容器层下面的所有镜像层都是只读的。镜像层数量可能会很多,所有镜像层会联合在一起组成一个统一的文件系统。如果不同层中有一个相同路径的文件,比如 /a,上层的 /a 会覆盖下层的 /a,也就是说用户只能访问到上层中的文件 /a。在容器层中,用户看到的是一个叠加之后的文件系统。 添加文件:在容器中创建文件时,新文件被添加到容器层中。 读取文件:在容器中读取某个文件时,Docker 会从上往下依次在各镜像层中查找此文件。一旦找到,立即将其复制到容器层,然后打开并读入内存。 修改文件:在容器中修改已存在的文件时,Docker 会从上往下依次在各镜像层中查找此文件。一旦找到,立即将其复制到容器层,然后修改之。 删除文件:在容器中删除文件时,Docker 也是从上往下依次在镜像层中查找此文件。找到后,会在容器层中记录下此删除操作。 只有当需要修改时才复制一份数据,这种特性被称作 Copy-on-Write。可见,容器层保存的是镜像变化的部分,不会对镜像本身进行任何修改。 14、简单描述一下Dockerfile的整个构建镜像过程 首先,创建一个目录用于存放应用程序以及构建过程中使用到的各个文件等; 然后,在这个目录下创建一个Dockerfile文件,一般建议Dockerfile的文件名就是Dockerfile; 编写Dockerfile文件,编写指令,如,使用FORM指令指定基础镜像,COPY指令复制文件,RUN指令指定要运行的命令,ENV设置环境变量,EXPOSE指定容器要暴露的端口,WORKDIR设置当前工作目录,CMD容器启动时运行命令,等等指令构建镜像; Dockerfile编写完成就可以构建镜像了,使用docker build -t 镜像名:tag . 命令来构建镜像,最后一个点是表示当前目录,docker会默认寻找当前目录下的Dockerfile文件来构建镜像,如果不使用默认,可以使用-f参数来指定dockerfile文件,如:docker build -t 镜像名:tag -f /xx/xxx/Dockerfile ; 使用docker build命令构建之后,docker就会将当前目录下所有的文件发送给docker daemon,顺序执行Dockerfile文件里的指令,在这过程中会生成临时容器,在临时容器里面安装RUN指定的命令,安装成功后,docker底层会使用类似于docker commit命令来将容器保存为镜像,然后删除临时容器,以此类推,一层层的构建镜像,运行临时容器安装软件,直到最后的镜像构建成功。 15、Dockerfile构建镜像出现异常,如何排查? 首先,Dockerfile是一层一层的构建镜像,期间会产生一个或多个临时容器,构建过程中其实就是在临时容器里面安装应用,如果因为临时容器安装应用出现异常导致镜像构建失败,这时容器虽然被清理掉了,但是期间构建的中间镜像还在,那么我们可以根据异常时上一层已经构建好的临时镜像,将临时镜像运行为容器,然后在容器里面运行安装命令来定位具体的异常。 16、Dockerfile的基本指令有哪些? FROM指定基础镜像(必须为第一个指令,因为需要指定使用哪个基础镜像来构建镜像); MAINTAINER设置镜像作者相关信息,如作者名字,日期,邮件,联系方式等; COPY复制文件到镜像; ADD复制文件到镜像(ADD与COPY的区别在于,ADD会自动解压tar、zip、tgz、xz等归档文件,而COPY不会,同时ADD指令还可以接一个url下载文件地址,一般建议使用COPY复制文件即可,文件在宿主机上是什么样子复制到镜像里面就是什么样子这样比较好); ENV设置环境变量; EXPOSE暴露容器进程的端口,仅仅是提示别人容器使用的哪个端口,没有过多作用; VOLUME数据卷持久化,挂载一个目录; WORKDIR设置工作目录,如果目录不在,则会自动创建目录; RUN在容器中运行命令,RUN指令会创建新的镜像层,RUN指令经常被用于安装软件包; CMD指定容器启动时默认运行哪些命令,如果有多个CMD,则只有最后一个生效,另外,CMD指令可以被docker run之后的参数替换; ENTRYOINT指定容器启动时运行哪些命令,如果有多个ENTRYOINT,则只有最后一个生效,另外,如果Dockerfile中同时存在CMD和ENTRYOINT,那么CMD或docker run之后的参数将被当做参数传递给ENTRYOINT; 17、如何进入容器?使用哪个命令 进入容器有两种方法:docker attach、docker exec。 18、什么是k8s?说出你的理解 K8s是kubernetes的简称,其本质是一个开源的容器编排系统,主要用于管理容器化的应用,其目标是让部署容器化的应用简单并且高效(powerful),Kubernetes提供了应用部署,规划,更新,维护的一种机制。 说简单点:k8s就是一个编排容器的系统,一个可以管理容器应用全生命周期的工具,从创建应用,应用的部署,应用提供服务,扩容缩容应用,应用更新,都非常的方便,而且还可以做到故障自愈,所以,k8s是一个非常强大的容器编排系统。 19、k8s的组件有哪些,作用分别是什么? k8s主要由master节点和node节点构成。master节点负责管理集群,node节点是容器应用真正运行的地方。 master节点包含的组件有:kube-api-server、kube-controller-manager、kube-scheduler、etcd。 node节点包含的组件有:kubelet、kube-proxy、container-runtime。 kube-api-server:以下简称api-server,api-server是k8s最重要的核心组件之一,它是k8s集群管理的统一访问入口,提供了RESTful API接口, 实现了认证、授权和准入控制等安全功能;api-server还是其他组件之间的数据交互和通信的枢纽,其他组件彼此之间并不会直接通信,其他组件对资源对象的增、删、改、查和监听操作都是交由api-server处理后,api-server再提交给etcd数据库做持久化存储,只有api-server才能直接操作etcd数据库,其他组件都不能直接操作etcd数据库,其他组件都是通过api-server间接的读取,写入数据到etcd。 kube-controller-manager:以下简称controller-manager,controller-manager是k8s中各种控制器的的管理者,是k8s集群内部的管理控制中心,也是k8s自动化功能的核心;controller-manager内部包含replication controller、node controller、deployment controller、endpoint controller等各种资源对象的控制器,每种控制器都负责一种特定资源的控制流程,而controller-manager正是这些controller的核心管理者。 kube-scheduler:以下简称scheduler,scheduler负责集群资源调度,其作用是将待调度的pod通过一系列复杂的调度算法计算出最合适的node节点,然后将pod绑定到目标节点上。shceduler会根据pod的信息(关注微信公众号:网络技术联盟站),全部节点信息列表,过滤掉不符合要求的节点,过滤出一批候选节点,然后给候选节点打分,选分最高的就是最佳节点,scheduler就会把目标pod安置到该节点。 Etcd:etcd是一个分布式的键值对存储数据库,主要是用于保存k8s集群状态数据,比如,pod,service等资源对象的信息;etcd可以是单个也可以有多个,多个就是etcd数据库集群,etcd通常部署奇数个实例,在大规模集群中,etcd有5个或7个节点就足够了;另外说明一点,etcd本质上可以不与master节点部署在一起,只要master节点能通过网络连接etcd数据库即可。 kubelet:每个node节点上都有一个kubelet服务进程,kubelet作为连接master和各node之间的桥梁,负责维护pod和容器的生命周期,当监听到master下发到本节点的任务时,比如创建、更新、终止pod等任务,kubelet 即通过控制docker来创建、更新、销毁容器;每个kubelet进程都会在api-server上注册本节点自身的信息,用于定期向master汇报本节点资源的使用情况。 kube-proxy:kube-proxy运行在node节点上,在Node节点上实现Pod网络代理,维护网络规则和四层负载均衡工作,kube-proxy会监听api-server中从而获取service和endpoint的变化情况,创建并维护路由规则以提供服务IP和负载均衡功能。简单理解此进程是Service的透明代理兼负载均衡器,其核心功能是将到某个Service的访问请求转发到后端的多个Pod实例上。 container-runtime:容器运行时环境,即运行容器所需要的一系列程序,目前k8s支持的容器运行时有很多,如docker、rkt或其他,比较受欢迎的是docker,但是新版的k8s已经宣布弃用docker。 20、kubelet的功能、作用是什么?(重点,经常会问) kubelet部署在每个node节点上的,它主要有4个功能: 节点管理。kubelet启动时会向api-server进行注册,然后会定时的向api-server汇报本节点信息状态,资源使用状态等,这样master就能够知道node节点的资源剩余,节点是否失联等等相关的信息了。master知道了整个集群所有节点的资源情况,这对于 pod 的调度和正常运行至关重要。 pod管理。kubelet负责维护node节点上pod的生命周期,当kubelet监听到master的下发到自己节点的任务时,比如要创建、更新、删除一个pod,kubelet 就会通过CRI(容器运行时接口)插件来调用不同的容器运行时来创建、更新、删除容器;常见的容器运行时有docker、containerd、rkt等等这些容器运行时,我们最熟悉的就是docker了,但在新版本的k8s已经弃用docker了,k8s1.24版本中已经使用containerd作为容器运行时了。 容器健康检查。pod中可以定义启动探针、存活探针、就绪探针等3种,我们最常用的就是存活探针、就绪探针,kubelet 会定期调用容器中的探针来检测容器是否存活,是否就绪,如果是存活探针,则会根据探测结果对检查失败的容器进行相应的重启策略; Metrics Server资源监控。在node节点上部署Metrics Server用于监控node节点、pod的CPU、内存、文件系统、网络使用等资源使用情况,而kubelet则通过Metrics Server获取所在节点及容器的上的数据。 21、kube-api-server的端口是多少?各个pod是如何访问kube-api-server的? kube-api-server的端口是8080和6443,前者是http的端口,后者是https的端口,以我本机使用kubeadm安装的k8s为例: 在命名空间的kube-system命名空间里,有一个名称为kube-api-master的pod,这个pod就是运行着kube-api-server进程,它绑定了master主机的ip地址和6443端口,但是在default命名空间下,存在一个叫kubernetes的服务,该服务对外暴露端口为443,目标端口6443,这个服务的ip地址是clusterip地址池里面的第一个地址,同时这个服务的yaml定义里面并没有指定标签选择器,也就是说这个kubernetes服务所对应的endpoint是手动创建的,该endpoint也是名称叫做kubernetes,该endpoint的yaml定义里面代理到master节点的6443端口,也就是kube-api-server的IP和端口。这样一来,其他pod访问kube-api-server的整个流程就是:pod创建后嵌入了环境变量,pod获取到了kubernetes这个服务的ip和443端口,请求到kubernetes这个服务其实就是转发到了master节点上的6443端口的kube-api-server这个pod里面。 22、k8s中命名空间的作用是什么? amespace是kubernetes系统中的一种非常重要的资源,namespace的主要作用是用来实现多套环境的资源隔离,或者说是多租户的资源隔离。 k8s通过将集群内部的资源分配到不同的namespace中,可以形成逻辑上的隔离,以方便不同的资源进行隔离使用和管理。不同的命名空间可以存在同名的资源,命名空间为资源提供了一个作用域。 可以通过k8s的授权机制,将不同的namespace交给不同的租户进行管理,这样就实现了多租户的资源隔离,还可以结合k8s的资源配额机制,限定不同的租户能占用的资源,例如CPU使用量、内存使用量等等来实现租户可用资源的管理。 23、pod资源控制器类型有哪些? Deployments:Deployment为Pod和ReplicaSet提供声明式的更新能力。 ReplicaSet:ReplicaSet的目的是维护一组在任何时候都处于运行状态的Pod副本的稳定集合。因此,它通常用来保证给定数量的、完全相同的Pod的可用性。 StatefulSets:和Deployment类似,StatefulSet管理基于相同容器规约的一组Pod。但和Deployment不同的是,StatefulSet为它们的每个Pod维护了一个有粘性的ID。这些Pod是基于相同的规约来创建的,但是不能相互替换:无论怎么调度,每个Pod都有一个永久不变的ID。 DaemonSet:DaemonSet确保全部(或者某些)节点上运行一个Pod的副本。当有节点加入集群时,也会为他们新增一个Pod。当有节点从集群移除时,这些Pod也会被回收。删除DaemonSet将会删除它创建的所有Pod。 Jobs:Job会创建一个或者多个Pod,并将继续重试Pod的执行,直到指定数量的Pod成功终止。随着Pod成功结束,Job跟踪记录成功完成的Pod个数。当数量达到指定的成功个数阈值时,任务(即Job)结束。删除Job的操作会清除所创建的全部Pod。挂起Job的操作会删除Job的所有活跃Pod,直到Job被再次恢复执行。 Automatic Clean-up for Finished Jobs:TTL-after-finished控制器提供了一种TTL机制来限制已完成执行的资源对象的生命周期。TTL控制器目前只处理Job。 CronJob:一个CronJob对象就像crontab(crontable)文件中的一行。它用Cron格式进行编写,并周期性地在给定的调度时间执行Job。 ReplicationController:ReplicationController确保在任何时候都有特定数量的Pod副本处于运行状态。换句话说,ReplicationController确保一个Pod或一组同类的Pod总是可用的。 24、nginx算法策略 轮询(默认) 加权轮询(轮询+weight) ip_hash 每一个请求的访问IP,都会映射成一个hash,再通过hash算法(hash值%node_count),分配到不同的后端服务器,访问ip相同的请求会固定访问同一个后端服务器,这样可以做到会话保持,解决session同步问题。 least_conn(最少连接) 使用最少连接的负载平衡,nginx将尝试不会使繁忙的应用程序服务器超载请求过多,而是将新请求分发给不太繁忙的服务器。 25、nignx常用模块 upstream rewrite location proxy_pass 26、如何查看并且杀死僵尸进程? top —> task (line)—> zombie. 把父进程杀掉,父进程死后,过继给1号进程init,init 始终负责清理僵尸进程,它产生的所有僵尸进程跟着消失;如果你使用kill ,一般都不能杀掉 defunct进程.。用了kill -15,kill -9以后 之后反而会多出更多的僵尸进程。 27、搜索某个用户运行的进程 pgrep-auneteagle 28、查看某个端口正在被哪个进程使用 lsof-i:[port] 29、端口转发 iptables-tnat-APREROUTING-d10.0.0.8-ptcp--dport80-jREDIRECT--to-ports8080 30、查看http的并发请求数与其TCP连接状态 etstat-n|awk'/^tcp/{++b[$NF]}END{for(ainb)printa,b[a]}' 31、查看/var/log目录下文件数 ls/var/log/-lR|grep"^-"|wc-l 32、linux系统启动流程 第一步:开机自检,加载BIOS 第二步:读取MBR 第三步:Boot Loader grub引导菜单 第四步:加载kernel内核 第五步:init进程依据inittab文件夹来设定运行级别 第六步:init进程执行rc.sysinit 第七步:启动内核模块 第八步:执行不同运行级别的脚本程序 第九步:执行/etc/rc.d/rc.lo 33、Linux文件类型 -:常规文件,即file d:目录文件 b:block device 即块设备文件,如硬盘;支持以block为单位进行随机访问 c:character device 即字符设备文件,如键盘支持以character为单位进行线性访问 l:symbolic link 即符号链接文件(关注微信公众号:网络技术联盟站),又称软链接文件 p:pipe 即命名管道文件 s:socket 即套接字文件,用于实现两个进程进行通信 34、简述lvm,如何给使用lvm的/分区扩容? 功能:可以对磁盘进行动态管理。动态按需调整大小 概念: PV 物理卷:物理卷在逻辑卷管理中处于最底层,它可以是实际物理硬盘上的分区,也可以是整个物理硬盘,也可以是raid设备。 VG 卷组:卷组建立在物理卷之上,一个卷组中至少要包括一个物理卷,在卷组建立之后可动态添加物理卷到卷组中。一个逻辑卷管理系统工程中可以只有一个卷组,也可以拥有多个卷组。 LV 逻辑卷:逻辑卷建立在卷组之上,卷组中的未分配空间可以用于建立新的逻辑卷,逻辑卷建立后可以动态地扩展和缩小空间。系统中的多个逻辑卷可以属于同一个卷组,也可以属于不同的多个卷组。 给/分区扩容步骤: 添加磁盘 使用fdisk命令对新增加的磁盘进行分区 分区完成后修改分区类型为lvm 使用pvcreate创建物理卷 使用vgextend命令将新增加的分区加入到根目录分区中 使用lvextend命令进行扩容 使用xfs_growfs调整卷分区大小 35、如何在文本里面进行复制、粘贴,删除行,删除全部,按行查找和按字母查找。 以下操作全部在vi/vim命令行状态操作,不要在编辑状态操作: 在文本里 移动到想要复制的行按yy想复制到哪就移动到哪,然后按P就黏贴了 删除行 移动到改行 按dd 删除全部dG这里注意G一定要大写 按行查找 :90 这样就是找到第90行 按字母查找 /path 这样就是找到path这个单词所在的位置,文本里可能存在多个,多次查找会显示在不同的位置。 36、符号链接与硬链接的区别 我们可以把符号链接,也就是软连接 当做是 windows系统里的 快捷方式。 硬链接 就好像是 又复制了一份. ln 3.txt 4.txt 这是硬链接,相当于复制,不可以跨分区,但修改3,4会跟着变,若删除3,4不受任何影响。 ln -s 3.txt 4.txt 这是软连接,相当于快捷方式。修改4,3也会跟着变,若删除3,4就坏掉了。不可以用了。 37、什么是正向代理? 一个位于客户端和原始服务器(origin server)之间的服务器,为了从原始服务器取得内容,客户端向代理发送一个请求并指定目标(原始服务器),然后代理向原始服务器转交请求并将获得的内容返回给客户端。 客户端才能使用正向代理。正向代理总结就一句话:代理端代理的是客户端。例如说:我们使用的OpenVPN 等等。 38、什么是反向代理? 反向代理(Reverse Proxy)方式,是指以代理服务器来接受 Internet上的连接请求,然后将请求,发给内部网络上的服务器并将从服务器上得到的结果返回给 Internet 上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。 反向代理总结就一句话:代理端代理的是服务端。 39、什么是动态资源、静态资源分离? 动态资源、静态资源分离,是让动态网站里的动态网页根据一定规则把不变的资源和经常变的资源区分开来,动静资源做好了拆分以后我们就可以根据静态资源的特点将其做缓存操作,这就是网站静态化处理的核心思路。 动态资源、静态资源分离简单的概括是:动态文件与静态文件的分离。 在我们的软件开发中,有些请求是需要后台处理的(如:.jsp,.do 等等),有些请求是不需要经过后台处理的(如:css、html、jpg、js 等等文件),这些不需要经过后台处理的文件称为静态文件,否则动态文件。 因此我们后台处理忽略静态文件。这会有人又说那我后台忽略静态文件不就完了吗?当然这是可以的,但是这样后台的请求次数就明显增多了。在我们对资源的响应速度有要求的时候,我们应该使用这种动静分离的策略去解决动、静分离将网站静态资源(HTML,JavaScript,CSS,img等文件)与后台应用分开部署,提高用户访问静态代码的速度,降低对后台应用访问 这里我们将静态资源放到 Nginx 中,动态资源转发到 Tomcat 服务器中去。 当然,因为现在七牛、阿里云等 CDN 服务已经很成熟,主流的做法,是把静态资源缓存到 CDN 服务中,从而提升访问速度。 相比本地的 Nginx 来说,CDN 服务器由于在国内有更多的节点,可以实现用户的就近访问。并且,CDN 服务可以提供更大的带宽,不像我们自己的应用服务,提供的带宽是有限的。 40、网站登陆缓慢是什么原因? 网络带宽,这是一个很常见的瓶颈。 cpu、硬盘、内存配置过低,服务器负载不起来。 网站的开发代码不够完善,例如mysql语句没有进行优化,导致数据库的读写相当耗费时间。 数据库的瓶颈。当我们的数据库的数据变得越来越多的时候,那么对于数据库的读写压力肯定会变大。 41、a与b服务器不在同一网段怎么设置?设置完还ping不通怎么排查? AB服务器不在同一个网段 首先把不同IP段的服务器划分给不同的vlan 在通过通过三层交换机添加虚拟IP路由实在不同网段的vlan的连接 42、在AB两台服务器之间通过一个服务器c做软路由使用给路由器c配置两块网卡并开启自身的路由功能 vi/etc/sysconfig/network-scripts/ifcfg-eth0 查看网卡状况IP -a -s 网卡的名字 A服务器设置相关网卡信息 子网掩码:255.255.255.0 IP=10.0.0.1 网关=10.0.0.254 重启网卡生效 查看路由信息 route-n 添加对应路由 routeadd-net10.0.1.0/24gw10.0.0.11 B服务器的设置相关信息 IP=10.0.1.10 网关10.0.1.254 重启网卡生效 route-n 添加对应的路由 routeadd-net10.0.0.0/24gw10.0.1.11 C服务器的两块网卡 网卡1 IP=10.0.0.11 网关=10.0.0.254 网卡2 IP=10.0.1.11 网关=10.0.1.254 重启网卡生效 route-n vi/etc/sysctl.conf net.ipv4.ip_forword=1 43、如果PING不通怎么排查 首先先看看是不是网路接口故障水晶头或是网卡接口接触不良造成,其次检查交换机和路由等网络设备是有故障 是否关闭了防火墙和selinux机制 然后查看网卡和路由和网关是否配置正确 44、docker容器ping不通是什么原因? ifconfig 查看一下docker0网桥,ping一下网桥看看是否通,有可能是网桥配置问题 weave路由器端口6783 安装docker容器的服务器没有关闭防火墙(访问一下安装docker物理机的,是否能访问,如果不能访问就变不能访问docker) docker在创建镜像的时候没有做端口映射(出现这种情况能访问物理机不能访问docker)使用dockers ps 查看镜像的端口映射情况 端口映射不正确 查看网络配置ping网桥看是否能ping通,有可能是网桥的原因 45、如果一台办公室内主机无法上网(打不开网站),请给出你的排查步骤? 首先确定物理链路是否联通正常。 查看本机IP,路由,DNS的设置情况是否达标。 telnet检查服务器的WEB有没有开启以及防火墙是否阻拦。 ping一下网关,进行最基础的检查,通了,表示能够到达服务器。 测试到网关或路由器的通常情况,先测网关,然后再测路由器一级一级的测试。 测试ping公网ip的通常情况(记住几个外部IP), 测试DNS的通畅。ping出对应IP。 通过以上检查后,还在网管的路由器上进行检查。 46、如果我们的网站打开速度慢请说下您的排查思路? 判断原因 首先我要以用户的身份登录我们的网站,判断问题出现在我们自身原因,还是用户那边的原因。 如果是用户问题有以下几个原因: 用户那边的带宽 用户的浏览器器版本低,安装插件太多 中毒和电脑里的垃圾文件过多 用户主机的主机的性能和操作系统 如果是我们的网站自身问题有以下几个原因 网络带宽 服务器的cpu、硬盘、内存过低服务器负载不起来也就是说服务器自身的性能方面 网站代码不够完善。如mysql语句没有进行优化导致数据库读写耗时 服务器未开启图片压缩 网页下死连接过多插件使用及js文件调用频繁网站服务器的速度或是租用空间所在的服务器速度 解决思路 1、检测服务器速度的快慢 ping命令查看连接到服务器的时间和丢包情况(ping 测试网址的) 查看丢包率(1000个包没有丢一个是最理想的、一般一个速度好的机房丢包率不超过1%) ping值要小同城电信adsl ping平均值绝对不能超过20,一般都在10,跨省的平均值20-40属于正常 ping值要均匀最小值和最大值相差太大说明路由不稳定的表现 2、查看服务器自身性能 查看cpu的使用率uptime 查看内存情况free -m 查看I/O读写iostat 磁盘I/O读写等看看是那个进程大量占用系统资源导致我的服务器变慢 3、看看访问最多的URL和IP有什么特征,如果是恶意URL和IP就把他屏蔽掉如果是善意的就限流有可能是CDN回源量大造成网站无法访问 4、查看同台服务器上其他网站的打开速度,可以通过查询工具查看和自己在同一台服务器上的网站个数和网址可以看他们打开快慢 5、电信和联通互访的问题 如果是空间打开时快时慢,有时打不开那就是空间不稳定找空间商解决或是换空间伤,如果是有的地方快有的地方慢应该是网络线路问题,比如电信用户访问放在联通服务器上的网站,联通用户访问放在电信服务器上的网站,解决办吧是:使用双线空间或是多线空间 6、从网站自身的原因 网站的程序设计结构是否合理是否由于幻灯片代码影响网站打开速度(找程序设计相关人士解决) 网页的设计结构和代码错误(请专业人士进行修改) 网页的内容如:大尺寸图片、大尺寸flash、过多的引用其他网站内容,如果被引用内容的网站速度慢,也影响自身网站把。譬如友情连接可以把对方 的图片放到自己网站上 解决办法 优化图片,限制图片大小尺寸,降低图片质量,减少图片数量 限定图片的格式:jpg,png,gif 减少http的请求数(当打开网页时浏览器会发出很多对象请求,每个对象的加载都会有所延时,如果网页上的对象很多就会花费大量的时间,去除不必要的对象,将临近的图片合成一张,合并css文件) f r o m :w l j s l m z 46、如何查看二进制文件的内容 我们一般通过 hexdump 命令 来查看二进制文件的内容。 hexdump -C XXX(文件名) -C 是参数 不同的参数有不同的意义 -C 是比较规范的 十六进制和 ASCII 码显示 -c 是单字节字符显示 -b 单字节八进制显示 -o 是双字节八进制显示 -d 是双字节十进制显示 -x 是双字节十六进制显示 等等等等 47、你是怎么备份数据的,包括数据库备份? 在生产环境下,不管是应用数据、还是数据库数据首先在部署的时候就会有主从架构、或者集群,这本身就是属于数据的热备份;其实考虑冷备份,用专门一台服务器做为备份服务器,比如可以用rsync+inotify配合计划任务来实现数据的冷备份,如果是发版的包备份,正常情况下有台发布服务器,每次发版都会保存好发版的包。 48、zabbix常用术语你知道几个? 主机(host):要监控的网络设备,可由IP或DNS名称指定; 主机组(hostgroup):主机的逻辑容器,可以包含主机和模板,但同一个组织内的主机和模板不能互相链接;主机组通常在给用户或用户组指派监控权限时使用; 监控项(item):一个特定监控指标的相关的数据;这些数据来自于被监控对象;item是zabbix进行数据收集的核心,相对某个监控对象,每个item都由"key"标识; 触发器(trigger):一个表达式,用于评估某监控对象的特定item内接收到的数据是否在合理范围内,也就是阈值;接收的数据量大于阈值时,触发器状态将从"OK"转变为"Problem",当数据再次恢复到合理范围,又转变为"OK"; 事件(event):触发一个值得关注的事情,比如触发器状态转变,新的agent或重新上线的agent的自动注册等; 动作(action):指对于特定事件事先定义的处理方法,如发送通知,何时执行操作; 报警升级(escalation):发送警报或者执行远程命令的自定义方案,如每隔5分钟发送一次警报,共发送5次等; 媒介(media):发送通知的手段或者通道,如Email、Jabber或者SMS等; 通知(notification):通过选定的媒介向用户发送的有关某事件的信息;远程命令(remote command):预定义的命令,可在被监控主机处于某特定条件下时自动执行; 模板(template):用于快速定义被监控主机的预设条目集合,通常包含了item、trigger、graph、screen、application以及low-level discovery rule;模板可以直接链接至某个主机;应用(application):一组item的集合; web场景(webscennario):用于检测web站点可用性的一个活多个HTTP请求;前端(frontend):Zabbix的web接口; 49、虚拟化技术有哪些表现形式 完全拟化技术:通过软件实现对操作系统的资源再分配,比较成熟,完全虚拟化代表技术:KVM、ESXI、Hyper-V。 半虚拟化技术:通过代码修改已有的系统,形成一种新的可虚拟化的系统,调用硬件资源去安装多个系统,整体速度上相对高一点,半虚拟化代表技术:Xen。 轻量级虚拟化:介于完全虚拟化、半虚拟化之间,轻量级虚拟化代表技术:Docker。 50、修改线上业务配置文件流程 先告知运维经理和业务相关开发人员 在测试环境测试,并备份之前的配置文件 测试无误后修改生产环境配置 观察生产环境是否正常,是否有报警 完成配置文件更改 可关注小编,发布更多精彩内容。 文章转自:网络技术联盟站(版权归原作者所有,侵删)

优秀的个人博客,低调大师

爆肝30天,肝出来史上最透彻Spring原理和27道高频面试题总结

在阅读面试题之前,小伙伴们可以先看看我之前发布的系列文章,Spring核心原理包括源码分析和用30个类手写。面试刷题固然很重要,但是知其然知其所以然更重要。 1 Spring环境预热篇 标题 备注 Tom弹架构:Spring 5系统架构 2021/12/01已更新 Tom弹架构:Spring版本命名规则 2021/12/02已更新 Tom弹架构:基于Gradle的Spring源码下载及构建技巧 2021/12/03已更新 2 30个类手写实战篇 标题 备注 Tom弹架构:用300行代码手写1个Spring框架,麻雀虽小五脏俱全 2021/12/04已更新 Tom弹架构:30个类手写Spring核心原理之环境准备(1) 2021/12/09已更新 Tom弹架构:30个类手写Spring核心原理之Ioc顶层架构设计(2) 2021/12/10已更新 Tom弹架构:30个类手写Spring核心原理之依赖注入功能(3) 2021/12/12已更新 Tom弹架构:30个类手写Spring核心原理之MVC映射功能(4) 2021/12/13已更新 Tom弹架构:30个类手写Spring核心原理之AOP代码织入(5) 2021/12/14已更新 Tom弹架构:30个类手写Spring核心原理之自定义ORM(上)(6) 2021/12/16已更新 Tom弹架构:30个类手写Spring核心原理之自定义ORM(下)(7) 2021/12/17已更新 Tom弹架构:30个类手写Spring核心原理之动态数据源切换(8) 2021/12/21已更新 3 Spring核心原理篇 标题 备注 Tom弹架构:Spring核心原理分析之MVC九大组件(1) 2021/12/22已更新 Tom弹架构:Spring核心原理之IoC容器初体验(2) 2021/12/05已更新 Tom弹架构:Spring核心原理之 IoC容器中那些鲜为人知的细节(3) 2021/12/25已更新 Tom弹架构:大厂高频面试题Spring Bean生命周期最详解 2021/12/06已更新 Tom弹架构:一张图彻底搞懂Spring循环依赖 2021/12/07已更新 4 经典高频面试题 4.1 什么是Spring框架,Spring框架有哪些主要模块 Spring框架是一个为Java应用程序开发提供综合、广泛的基础性支持的Java平台。Spring帮助开发者解决了开发中基础性的问题,使得开发人员可以专注于应用程序的开发。Spring框架本身也是按照设计模式精心打造的,这使得我们可以在开发环境中安心地集成Spring框架,不必担心Spring是如何在后台工作的。主要模块内容介绍可以参考之前章节的介绍。 4.2 使用Spring框架能带来哪些好处 下面列举了一些使用Spring框架带来的主要好处。 (1)Dependency Injection(DI)使得构造器和JavaBean properties文件中的依赖关系一目了然。 (2)与EJB容器相比较,IoC容器更加趋向于轻量级。这样一来使用IoC容器在有限的内存和CPU资源的情况下进行应用程序的开发和发布就变得十分有利。 (3)Spring并没有闭门造车,Spring利用了已有的技术,比如ORM框架、logging框架、J2EE、Quartz和JDK Timer,以及其他视图技术。 (4)Spring框架是按照模块的形式来组织的。由包和类的编号就可以看出其所属的模块,开发者只需选用需要的模块即可。 (5)要测试一个用Spring开发的应用程序十分简单,因为测试相关的环境代码都已经囊括在框架中了。更加简单的是,利用JavaBean形式的POJO类,可以很方便地利用依赖注入来写入测试数据。 (6)Spring的Web框架也是一个精心设计的Web MVC框架,为开发者在Web框架的选择上提供了一个除主流框架(比如Struts)和过度设计的、不流行Web框架以外的选择。 (7)Spring提供了一个便捷的事务管理接口,适用于小型的本地事务处理(比如在单DB的环境下)和复杂的共同事务处理(比如利用JTA的复杂DB环境)。 4.3 什么是控制反转(IoC),什么是依赖注入 (1)控制反转是应用于软件工程领域的,在运行时被装配器对象用来绑定耦合对象的一种编程技巧,对象之间的耦合关系在编译时通常是未知的。在传统的编程方式中,业务逻辑的流程是由应用程序中早已被设定好关联关系的对象来决定的。在使用控制反转的情况下,业务逻辑的流程是由对象关系图来决定的,该对象关系图由装配器负责实例化,这种实现方式还可以将对象之间的关联关系的定义抽象化。绑定的过程是通过“依赖注入”实现的。 (2)控制反转是一种以给予应用程序中目标组件更多控制为目的设计范式,并在实际工作中起到了有效的作用。 (3)依赖注入是在编译阶段尚未知所需的功能是来自哪个的类的情况下,将其他对象所依赖的功能对象实例化的模式。这就需要一种机制来激活相应的组件以提供特定的功能,所以依赖注入是控制反转的基础。否则如果在组件不受框架控制的情况下,框架又怎么知道要创建哪个组件呢? 4.4 在Java中依赖注入有哪些方式 (1)构造器注入。 (2)Setter方法注入。 (3)接口注入。 4.5 BeanFactory和ApplicationContext有什么区别 BeanFactory 可以理解为含有Bean集合的工厂类。BeanFactory 包含了Bean的定义,以便在接收到客户端请求时将对应的Bean实例化。 BeanFactory还能在实例化对象时生成协作类之间的关系。此举将Bean自身从Bean客户端的配置中解放出来。BeanFactory还包含Bean生命周期的控制,调用客户端的初始化方法(Initialization Method)和销毁方法(Destruction Method)。 从表面上看,ApplicationContext如同BeanFactory一样具有Bean定义、Bean关联关系的设置及根据请求分发Bean的功能。但ApplicationContext在此基础上还提供了其他功能。 (1)提供了支持国际化的文本消息。 (2)统一的资源文件读取方式。 (3)已在监听器中注册的Bean的事件。 以下是三种较常见的 ApplicationContext 实现方式。 (1)ClassPathXmlApplicationContext:从ClassPath的XML配置文件中读取上下文,并生成上下文定义。应用程序上下文从程序环境变量中取得。 ApplicationContext context = new ClassPathXmlApplicationContext(“application.xml”); (2)FileSystemXmlApplicationContext :由文件系统中的XML配置文件读取上下文。 ApplicationContext context = new FileSystemXmlApplicationContext(“application.xml”); (3)XmlWebApplicationContext:由Web应用的XML文件读取上下文。 4.6 Spring提供几种配置方式来设置元数据 Spring提供以下三种配置方式来设置元数据: (1)基于XML的配置。 (2)基于注解的配置。 (3)基于Java的配置。 4.7 如何使用XML配置方式配置Spring 在Spring框架中,依赖和服务需要专门的配置文件实现,一般用XML格式的配置文件。这些配置文件的格式采用公共的模板,由一系列的Bean定义和专门的应用配置选项组成。 Spring XML配置的主要目的是使所有的Spring组件都可以用XML文件的形式来进行配置。这意味着不会出现其他的Spring配置类型(比如声明配置方式或基于Java Class的配置方式)。 Spring的XML配置方式是使用被Spring命名空间所支持的一系列的XML标签来实现的。Spring主要的命名空间有context、beans、jdbc、tx、aop、mvc和aso。例如: <beans> <!-- JSON Support --> <bean name="viewResolver" class="org.springframework.web.servlet.view.BeanNameViewResolver"/> <bean name="jsonTemplate" class="org.springframework.web.servlet.view.json.MappingJackson2JsonView"/> <bean id="restTemplate" class="org.springframework.web.client.RestTemplate"/> </beans> 下面这个web.xml仅配置了DispatcherServlet,最简单的配置便能满足应用程序配置运行时组件的需求。 <web-app> <display-name>Archetype Created Web Application</display-name> <servlet> <servlet-name>spring</servlet-name> <servlet-class> org.springframework.web.servlet.DispatcherServlet </servlet-class> <load-on-startup>1</load-on-startup> </servlet> <servlet-mapping> <servlet-name>spring</servlet-name> <url-pattern>/</url-pattern> </servlet-mapping> </web-app> 4.8 Spring提供哪些配置形式 Spring对Java配置的支持是由@Configuration注解和@Bean注解来实现的。由@Bean注解的方法将会实例化、配置和初始化一个新对象,这个对象将由Spring的IoC容器来管理。@Bean声明所起到的作用与元素类似。被@Configuration所注解的类则表示这个类的主要目的是作为Bean定义的资源。被@Configuration声明的类可以通过在同一个类内部调用@bean方法来设置嵌入Bean的依赖关系。 最简单的@Configuration 声明类请参考下面的代码: @Configuration public class AppConfig{ @Bean public MyService myService() { return new MyServiceImpl(); } } 与上面的@Beans配置文件相同的XML配置文件如下: <beans> <bean id="myService" class="com.gupaoedu.services.MyServiceImpl"/> </beans> 上述配置方式的实例化方式如下: public static void main(String[] args) { ApplicationContext ctx = new AnnotationConfigApplicationContext(AppConfig.class); MyService myService = ctx.getBean(MyService.class); myService.doStuff(); } 要使用组件扫描,仅需用@Configuration进行注解即可: @Configuration @ComponentScan(basePackages = "com.gupaoedu") public class AppConfig { } 在上面的例子中,com.gupaoedu包首先会被扫描到,然后在容器内查找被@Component 声明的类,找到后将这些类按照Spring Bean定义进行注册。 如果你要在Web应用开发中选用上述配置方式,需要用AnnotationConfigWebApplicationContext类来读取配置文件,可以用来配置Spring的Servlet监听器ContrextLoaderListener或者Spring MVC的DispatcherServlet。 例如: <web-app> <context-param> <param-name>contextClass</param-name> <param-value> org.springframework.web.context.support.AnnotationConfigWebApplicationContext </param-value> </context-param> <context-param> <param-name>contextConfigLocation</param-name> <param-value>com.gupaoedu.AppConfig</param-value> </context-param> <listener> <listener-class>org.springframework.web.context.ContextLoaderListener</listener-class> </listener> <servlet> <servlet-name>dispatcher</servlet-name> <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class> <init-param> <param-name>contextClass</param-name> <param-value> org.springframework.web.context.support.AnnotationConfigWebApplicationContext </param-value> </init-param> <init-param> <param-name>contextConfigLocation</param-name> <param-value>com.gupaoedu.web.MVCConfig</param-value> </init-param> </servlet> <servlet-mapping> <servlet-name>dispatcher</servlet-name> <url-pattern>/web/*</url-pattern> </servlet-mapping> </web-app> 4.9 怎样用注解的方式配置Spring Spring在2.5版本以后开始支持用注解的方式配置依赖注入。可以用注解的方式来替代XML方式的Bean描述,可以将Bean描述转移到组件类的内部,只需要在相关类上、方法上或者字段声明上使用注解即可。注解注入将会被容器在XML注入之前处理,所以后者会覆盖前者对于同一个属性的处理结果。 注解装配在Spring中是默认关闭的,需要在Spring文件中进行配置才能使用基于注解的装配模式。如果你想要在应用程序中使用注解的方式,请参考如下配置: <beans> <context:annotation-config/> </beans> 配置完成以后,就可以用注解的方式在Spring中向属性、方法和构造方法中自动装配变量。 下面是几种比较重要的注解类型。 (1)@Required:该注解应用于设值方法。 (2)@Autowired:该注解应用于设值方法、非设值方法、构造方法和变量。 (3)@Qualifier:该注解和@Autowired注解搭配使用,用于消除特定Bean自动装配的歧义。 (4)JSR-250 Annotations:Spring支持基于JSR-250 注解的注解,即@Resource、@PostConstruct和@PreDestroy。 4.10 请解释Spring Bean的生命周期 Spring Bean的生命周期简单易懂。在一个Bean实例被初始化时,需要执行一系列初始化操作以使其达到可用的状态。同样,当一个Bean不再被调用时需要进行相关的析构操作,并从Bean容器中移除。 Spring Bean Factory 负责管理在Spring容器中被创建的Bean的生命周期。Bean的生命周期由两组回调方法组成。 (1)初始化之后调用的回调方法。 (2)销毁之前调用的回调方法。 Spring提供了以下4种方式来管理Bean的生命周期事件: (1)InitializingBean和DisposableBean回调接口。 (2)针对特殊行为的其他Aware接口。 (3)Bean配置文件中的customInit()方法和customDestroy()方法。 (4)@PostConstruct和@PreDestroy注解方式。 使用customInit()和 customDestroy()方法管理Bean生命周期的代码样例如下: <beans> <bean id="demoBean" class="com.gupaoedu.task.DemoBean" init-Method="customInit" destroy-Method="customDestroy"> </bean> </beans> 4.11 Spring Bean作用域的区别是什么 Spring容器中的Bean可以分为5个作用域。所有作用域的名称都是自说明的,但是为了避免混淆,还是让我们来解释一下。 (1)singleton:这种Bean作用域是默认的,这种作用域确保不管接收到多少个请求,每个容器中只有一个Bean实例,单例模式由Bean Factory自身来维护。 (2)prototype:prototype作用域与singleton作用域相反,为每一个Bean请求提供一个实例。 (3)request:在请求Bean作用域内为每一个来自客户端的网络请求创建一个实例,在请求完成以后,Bean会失效并被垃圾回收器回收。 (4)Session:与request作用域类似,确保每个Session中有一个Bean实例,在Session过期后,Bean会随之失效。 (5)global-session:global-session和Portlet应用相关。当应用部署在Portlet容器中时,它包含很多Portlet。如果想让所有的Portlet共用全局存储变量,那么这个全局存储变量需要存储在global-session中。全局作用域与Servlet中的Session作用域效果相同。 4.12 什么是Spring Inner Bean 在Spring中,无论何时,当Bean仅被调用了一个属性时,一个明智的做法是将这个Bean声明为内部Bean。内部Bean可以用setter注入“属性”和用构造方法注入“构造参数”的方式来实现。 比如,在应用程序中一个Customer类引用了一个Person类,我们要创建一个Person类的实例,然后在Customer内部使用。 public class Customer{ private Person person; } public class Person{ private String name; private String address; private int age; } 内部Bean的声明方式如下: <bean id="CustomerBean" class="com.gupaoedu.common.Customer"> <property name="person"> <bean class="com.gupaoedu.common.Person"> <property name="name" value="lokesh" /> <property name="address" value="India" /> <property name="age" value="34" /> </bean> </property> </bean> 4.13 Spring中的单例Bean是线程安全的吗 Spring并没有对单例Bean进行任何多线程的封装处理。关于单例Bean的线程安全和并发问题需要开发者自行解决。但实际上,大部分Spring Bean并没有可变的状态(比如Serview类和DAO类),所以在某种程度上,Spring的单例Bean是线程安全的。如果你的Bean有多种状态(比如View Model对象),就需要自行保证线程安全。 最容易的解决办法就是将多态Bean的作用域由“singleton”变更为“prototype”。 4.14 请举例说明如何在Spring中注入一个Java集合 Spring提供了以下4种集合类的配置元素: (1)<list>标签用来装配可重复的list值。 (2)<set>标签用来装配没有重复的set值。 (3)<map>标签用来注入键和值,可以为任何类型的键值对。 (4)<props>标签支持注入键和值都是字符串类型的键值对。 下面看一个具体的例子: <beans> <bean id="javaCollection" class="com.gupaoedu.JavaCollection"> <property name="customList"> <list> <value>INDIA</value> <value>Pakistan</value> <value>USA</value> <value>UK</value> </list> </property> <property name="customSet"> <set> <value>INDIA</value> <value>Pakistan</value> <value>USA</value> <value>UK</value> </set> </property> <property name="customMap"> <map> <entry key="1" value="INDIA"/> <entry key="2" value="Pakistan"/> <entry key="3" value="USA"/> <entry key="4" value="UK"/> </map> </property> <property name="customProperies"> <props> <prop key="admin">admin@gupaoedu.com</prop> <prop key="support">support@gupaoedu.com</prop> </props> </property> </bean> </beans> 4.15 如何向Spring Bean中注入java.util.Properties 第一种方法是使用如下代码所示的标签: <bean id="adminUser" class="com.gupaoedu.common.Customer"> <property name="emails"> <props> <prop key="admin">admin@gupaoedu.com</prop> <prop key="support">support@gupaoedu.com</prop> </props> </property> </bean> 也可用“util:”命名空间从Properties文件中创建一个Properties Bean,然后利用setter方法注入Bean的引用。 4.16 请解释Spring Bean的自动装配 在Spring框架中,在配置文件中设定Bean的依赖关系是一个很好的机制,Spring容器还可以自动装配合作关系Bean之间的关联关系。这意味着Spring可以通过向BeanFactory中注入的方式自动搞定Bean之间的依赖关系。自动装配可以设置在每个Bean上,也可以设置在特定的Bean上。 下面的XML配置文件表明了如何根据名称将一个Bean设置为自动装配模式: <bean id="employeeDAO" class="com.gupaoedu.EmployeeDAOImpl" autowire="byName" /> 除了Bean配置文件中提供的自动装配模式,还可以使用@Autowired注解来自动装配指定的Bean。在使用@Autowired注解之前需要按照如下的配置方式在Spring配置文件中进行配置: <context:annotation-config /> 也可以通过在配置文件中配置AutowiredAnnotationBeanPostProcessor 达到相同的效果: <bean class ="org.springframework.beans.factory.annotation.AutowiredAnnotationBeanPostProcessor"/> 配置好以后就可以使用@Autowired来标注了: @Autowired public EmployeeDAOImpl ( EmployeeManager manager ) { this.manager = manager; } 4.17 自动装配有哪些局限性 自动装配有如下局限性。 重写:你仍然需要使用< property>设置指明依赖,这意味着总要重写自动装配。 原生数据类型:你不能自动装配简单的属性,如原生类型、字符串和类。 模糊特性:自动装配总是没有自定义装配精确,因此如果可能尽量使用自定义装配。 4.18 请解释各种自动装配模式的区别 在Spring中一共有5种自动装配模式,让我们逐一分析。 (1)no:这是Spring的默认设置,在该设置下自动装配是关闭的,开发者需要自行在Bean定义中用标签明确地设置依赖关系。 (2)byName:该模式可以根据Bean名称设置依赖关系。当向一个Bean中自动装配一个属性时,容器将根据Bean的名称自动在配置文件中查询一个匹配的Bean。如果找到就装配这个属性,如果没找到就报错。 (3)byType:该模式可以根据Bean类型设置依赖关系。当向一个Bean中自动装配一个属性时,容器将根据Bean的类型自动在配置文件中查询一个匹配的Bean。如果找到就装配这个属性,如果没找到就报错。 (4)constructor:和byType模式类似,但是仅适用于有与构造器相同参数类型的Bean,如果在容器中没有找到与构造器参数类型一致的Bean,那么将会抛出异常。 (5)autodetect:该模式自动探测使用constructor自动装配或者byType自动装配。首先会尝试找合适的带参数的构造器,如果找到就是用构造器自动装配,如果在Bean内部没有找到相应的构造器或者构造器是无参构造器,容器就会自动选择byType模式。 4.19 请举例解释@Required注解 在产品级别的应用中,IoC容器可能声明了数十万个Bean,Bean与Bean之间有着复杂的依赖关系。设值注解方法的短板之一就是验证所有的属性是否被注解是一项十分困难的操作。可以通过设置“dependency-check”来解决这个问题。 在应用程序的生命周期中,你可能不大愿意花时间验证所有Bean的属性是否按照上下文文件正确配置,或者你宁可验证某个Bean的特定属性是否被正确设置。即使用“dependency-check”属性也不能很好地解决这个问题,在这种情况下需要使用@Required 注解。 可用如下的方式来标明Bean的设值方法: public class EmployeeFactoryBean extends AbstractFactoryBean<Object> { private String designation; public String getDesignation() { return designation; } @Required public void setDesignation(String designation) { this.designation = designation; } } RequiredAnnotationBeanPostProcessor是Spring中的后置处理器,用来验证被@Required 注解的Bean属性是否被正确设置了。在使用RequiredAnnotationBeanPostProcesso验证Bean属性之前,要在IoC容器中对其进行注册: <bean class="org.springframework.beans.factory.annotation.RequiredAnnotationBeanPostProcessor" /> 但是如果没有属性被用@Required注解过,后置处理器会抛出一个BeanInitializationException异常。 4.20 请举例说明@Qualifier注解 @Qualifier注解意味着可以在被标注Bean的字段上自动装配。@Qualifier注解可以用来取消Spring不能取消的Bean应用。 4.21 构造方法注入和设值注入有什么区别 请注意以下明显的区别: (1)设值注入支持大部分依赖注入,如果我们仅需要注入int、string和long型的变量,不要用设值方法注入。对于基本类型,如果没有注入,可以为基本类型设置默认值。构造方法注入不支持大部分依赖注入,因为在调用构造方法时必须传入正确的构造参数,否则会报错。 (2)设值注入不会重写构造方法的值。如果我们对同一个变量同时使用了构造方法注入和设值注入,那么构造方法将不能覆盖设值注入的值。很明显,因为构造方法只在对象被创建时被调用。 (3)在使用设值注入时还不能保证某种依赖是否已经被注入,也就是说,这时对象的依赖关系有可能是不完整的。而在另一种情况下,构造器注入则不允许生成依赖关系不完整的对象。 (4)在设值注入时如果对象A和对象B互相依赖,在创建对象A时Spring会抛出ObjectCurrentlyInCreationException异常,因为在对象B被创建之前对象A是不能被创建的,反之亦然。Spring用设值注入解决了循环依赖问题,因为对象的设值方法是在对象被创建之前被调用的。 4.22 Spring中有哪些不同类型的事件 Spring的ApplicationContext 提供了支持事件和代码中监听器的功能。 我们可以创建Bean来监听在ApplicationContext 中发布的事件。对于ApplicationEvent类和在ApplicationContext接口中处理的事件,如果一个Bean实现了ApplicationListener接口,当一个ApplicationEvent 被发布以后,Bean会自动被通知。 public class AllApplicationEventListener implements ApplicationListener<ApplicationEvent> { @Override public void onApplicationEvent(ApplicationEvent applicationEvent) { //process event } } Spring 提供了以下5种标准的事件。 (1)上下文更新事件(ContextRefreshedEvent):该事件会在ApplicationContext被初始化或者更新时发布。也可以在调用ConfigurableApplicationContext 接口中的refresh()方法时被触发。 (2)上下文开始事件(ContextStartedEvent):当容器调用ConfigurableApplicationContext的Start()方法开始或重新开始容器时触发该事件。 (3)上下文停止事件(ContextStoppedEvent):当容器调用ConfigurableApplicationContext的Stop()方法停止容器时触发该事件。 (4)上下文关闭事件(ContextClosedEvent):当ApplicationContext被关闭时触发该事件。容器被关闭时,其管理的所有单例Bean都被销毁。 (5)请求处理事件(RequestHandledEvent):在Web应用中,当一个HTTP请求(Request)结束时触发该事件。 除了上面介绍的事件,还可以通过扩展ApplicationEvent类来自定义事件: public class CustomApplicationEvent extends ApplicationEvent { public CustomApplicationEvent ( Object source, final String msg ){ super(source); System.out.println("Created a Custom event"); } } 为了监听这个事件,还需要创建一个监听器: public class CustomEventListener implements ApplicationListener < CustomApplicationEvent >{ @Override public void onApplicationEvent(CustomApplicationEvent applicationEvent) { } } 之后通过ApplicationContext接口的publishEvent()方法来发布自定义事件: CustomApplicationEvent customEvent = new CustomApplicationEvent(applicationContext, “Test message”); applicationContext.publishEvent(customEvent); 4.23 FileSystemResource和ClassPathResource有什么区别 在FileSystemResource 中需要给出spring-config.xml文件在项目中的相对路径或者绝对路径。在ClassPathResource中Spring会在ClassPath中自动搜寻配置文件,所以要把ClassPathResource 文件放在ClassPath下。 如果将spring-config.xml保存在了src目录下,只需给出配置文件的名称即可,因为src是默认的路径。 简而言之,ClassPathResource在环境变量中读取配置文件,FileSystemResource在配置文件中读取配置文件。 4.24 Spring中用到了哪些设计模式 Spring中使用了大量的设计模式,下面列举了一些比较有代表性的设计模式。 (1)代理模式:在AOP和remoting中被用得比较多。 (2)单例模式:在Spring配置文件中定义的Bean默认为单例模式。 (3)模板模式:用来解决代码重复问题,比如RestTemplate、JmsTemplate、JpaTemplate。 (4)委派模式:Spring提供了DispatcherServlet来对请求进行分发。 (5)工厂模式:BeanFactory用来创建对象的实例,贯穿于BeanFactory和ApplicationContext接口。 (6)代理模式:代理模式AOP思想的底层实现技术,Spring中采用JDK Proxy和CGLib类库。 4.25 在Spring中如何更有效地使用JDBC 使用Spring JDBC可以使得资源管理及错误处理的代价减小。开发人员只需通过statements和queries语句从数据库中存取数据。Spring通过模板类能更有效地使用JDBC,也就是所谓的JdbcTemplate。 4.26 请解释Spring中的IoC容器 Spring中的org.springframework.beans包和org.springframework.context包构成了Spring IoC容器的基础。 BeanFactory接口提供了一个先进的配置机制,使得任何类型的对象的配置都成为可能。ApplicationContex接口对BeanFactory(是一个子接口)进行了扩展,在BeanFactory的基础上添加了其他功能,比如与Spring的AOP更容易集成,也提供了处理Message Resource的机制(用于国际化),以及事件传播及应用层的特别配置,比如针对Web应用的WebApplicationContext。 4.27 在Spring中可以注入null或空字符串吗 完全可以。 关注微信公众号『 Tom弹架构 』回复“Spring”可获取完整源码。 本文为“Tom弹架构”原创,转载请注明出处。技术在于分享,我分享我快乐!如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。关注微信公众号『 Tom弹架构 』可获取更多技术干货! 原创不易,坚持很酷,都看到这里了,小伙伴记得点赞、收藏、在看,一键三连加关注!如果你觉得内容太干,可以分享转发给朋友滋润滋润!

优秀的个人博客,低调大师

提前突击了这近200道大数据面试题,果然头条、京东都给了Offer

面试题包括Java、大数据开发、大数据运维、大数据分析、大数据架构等等 Q1:老师线上 6000+规模集群,抛开一些其它组件集群,仅讨论 HDFS 数据存储集群,保守理应也在有 3000 节点左右,想知道这些存储节点只是单集群NameNode 集群来维护吗?还是多集群独立维护的,如果是多集群存储数据,它们之间数据是如何打通进行关联的?如果仅是一个集群的话,我想知道这个集群的 NameNode 上的配置,是如何 Hold 住这些数据 DataNode的? 夏天老师: 我们的集群也是用的 Cloudera 公司的,我们付了费用, Cloudera 没有保障说 CM 能够纳管 1000 节点以上的集群,再加上我们的机房有容量限制,所以我们是建了多套集群,最大集群有 800+节点,最小集群也有 300+节点;800+datanode 下, namenode 是可以支撑的,像一些互联网大厂,字节跳动、京东等他们的单集群规模有上万节点,此时就需要对 hdfs 进行深度定制了,他们改了很多源码,而且有 200+高级技术维护人员; 多集群建设要考虑业务情况,比如我们公司有 10 个以上业务, 5 大核心集群,按业务相关情况划分集群,不过也难免有跨集群的作业,目前公司内部自研发了大数据采集交换平台,你也可以使用 distcp 进行数据对拷,目前我们也正在准备自研发多集群并行混算平台。 Q2:集群线上扩容如何达到自动化?线上扩容,规模正常都以 10+以上,如果都以课堂所示,人肉操作,时间投入与产出比不匹配,人力造成很大的不必要浪费,想学习老师线上集群实际扩容的方案。 夏天老师: 课堂所示兼顾了小白同学,所以是手把手纯人肉搭建,产线环境扩容数量少则几十多则上百,人肉肯定不行,我们公司的运维分为 IAAS 运维、大数据运维、应用运维,大数据运维工程师在扩容集群时,需要向 IAAS 运维工程师以工单的方式申请服务器并提出自己的需求, IAAS 运维工程师在提供服务器时不管是新采购服务器还是其他集群退役的服务器都需要重装系统,重装系统的镜像是针对大数据定制的,镜像包含了大数据运维工程师的通用需求以及安装操作系统后的网络、磁盘以及其他设置,比如关闭防火墙、时钟同步、同构磁盘挂载、关闭大透明页、关闭 SWAP、公用 YUM 源、禁用 SELinux 等模式化操作,大数据运维工程师收到服务器后准备工作基本准备完毕了,进行少量准备工作就可以直接进入了 CM 可视化批量安装模式,比如脚本批量设置hostname、脚本同步/etc/hosts 文件等; 当然如上所说的 IAAS 操作,如关闭防火墙、时钟同步、同构磁盘挂载、关闭大透明页、关闭 SWAP、公用YUM 源、禁用 SELinux 都可以脚本化,无非就是使用 SSH 通讯方式设置,这就需要大数据运维同学熟练使用 shell 了。 Q3:已知一个 HDFS 的目录,想知道此目录下的文件数,而且存储于哪些DataNode 节点上。 夏天老师: 1.查看文件数使用 count 命令,如下查看/ops 目录,目录数为 9606,文件数为 1353 万+,总文件大小为 9.7P 2.查看/ops/test 目录下的文件存储的位置hdfs fsck /ops/test -files -blocks -locations -racks Q4:DataNode 单节点,存储容量大小与当前节点上的 CPU,内存硬件之间有什么样的关系,磁盘扩容很容易,但这不意味着单节点上数据盘就可以无限地扩容,因此在这方面,有什么实际线上的经验分享,即这三者间可以遵循怎样合适的关系 夏天老师: 从我们内部实践来说没有发现三者之间的规律,因为大数据业务每个公司都不一样,有的计算是 CPU 密集型的,有的计算是内存密集型的、有的计算是IO 密集型的;我们的服务器都是中高配置,每个服务器的磁盘是 4Tx10、 CPU24core、128G 内存 Q5: HDFS 存储节点上的数据,存储压缩格式是如何选取的,默认采用哪种文件存储类型与存储格式,冷热数据如何界定的? 夏天老师: 我们产线环境用了 gz 和 snappy 压缩格式, gz 用于不常用的冷数据,snappy 用于热数据;冷热数据是跟业务相关的,后续集群治理的课程中也有冷热数据的区分。 Q6:课堂上看到 HDFS 集群的 DataNode 与 HBASE 是集成在一起部署的,我好奇, HBase 面向的都是高频率读写的业务,老师确定部署一起后,线上业务没有出现过问题吗? 夏天老师: 你应该是理解错了, HBase 不能跟 YARN 在一起部署; HBase 需要跟HDFS 部署在一起的,这样可以利用数据本地性提升 IO 性能,并且可以降低网络延迟,降低带宽负载。 Q7: Yarn 集群计算层,目前集群面向用户使用群体少,故白天仅是数据写入,集群 CPU 资源都较为存在大量冗余状态,但对于凌晨执行集中高频提交跑批作业计算任务时,集群的 CPU 资源明显不够,甚至引起节点 CPU 负载过高导致节点的宕机,从而造成集群雪崩。简单来说,白天集群资源使用率在5%,凌晨执行高频跑批作业任务时,资源使用率上到 100%,引起集群宕机。在不增加资源的前提下,资源老师会如何划分队列? 夏天老师: 这个划分队列无法解决根本问题,建议将业务划分优先级,错开时间执行。 Q8.某一台 CDH 物理机 12 块 RAID0 硬盘,如果其中有 4 块 RAID0 硬盘同时损坏,请问接下来大数据运维人员的详细处理流程是什么? 夏天老师: HDFS 有个参数 dfs.datanode.failed.volumes.tolerated,值为 0 的时候表示当有任何盘损坏后 datanode 则停止服务,如果 4 快盘同时损坏了,此时datanode 进程已经停止了,你可以修改 hdfs-site.xml 配置文件将损坏的磁盘路径去掉,重启 datanode 即可,然后进入磁盘报修流程,待磁盘更换后,停止 datanode,在 hdfs-site.xml 配置文件中假如新的磁盘,启动 datanode 即可。 Q9.CDH 如果为开发人员提供 HIVESERVER2 服务,可以让开发人员通过beeline 命令访问? 夏天老师: 是的, beeline 使用 JDBC 协议来连接 HIVESERVER2 Q10.在晚高峰期 HDFS 集群会出现某些 datanode 不稳定的情况,频繁有datanode 脱离节点,该如何处理呢? 夏天老师: 需要找到 datanode 的具体原因, datanode 相对来说还是比较稳定的,需要看下是否是 GC 问题,如果是的话适当调大内存,再看下最大的打开文件数或进程数的限制是否太小 Q11.CDH 集群扩容 10 台机器后,新加入的 Datanode 角色数据相对较少,如何处理 HDFS 的数据分布不均衡的现象呢? 夏天老师: 在内存占用较低的节点上启动 balancer 脚本,将 HDFS 中所有节点的存储值中的最低值和平均值的差值设置为 5%。命令: ./start-balancer.sh -threshold 5 Q12.CDH 监控项从某种角度来说并不是很细粒度,老师课上可能时间有限等原因只是稍微提了一下监控思路,请问您线上是如何监控的呢,能将详细步骤给我们刨析一下吗? 夏天老师: 目前我们产线环境还是以 CDH 监控为主, CDH 的指标还是挺多的,只不过保留的周期不长,对于排障来说基本够用了,当然我们会推进一些监控工具,不过在课堂不会展开细讲,后续有 Flink 监控方面的实战。 Q13.如何基于 CDH 集群监控大量的小文件的呢?衡量小文件标准,以及出现大量小文件在生产环境该如何解决呢? 夏天老师: CM 解决不了大量小文件的监控,需要额外做其他工作,这块在集群治理里面我们会详细讲;对于怎么衡量小文件的标准,你可以简单认为小于 blocksize 的文件就是小文件,但是在企业真实情况下小文件问题可能更加严重,比如大量 10M、几十 M 以下的文件,单纯技术无法解决问题,需要组织协同,这个在集群治理里面我们会详细讲。 Q14.之前上课只是大致提了一下 YARN 资源调度,生产环境使用 CDH 如何配置 YARN 资源队列调度,在咱们后续的课程还会讲吗? 夏天老师: 这个会讲解的,也会讲解我们产线环境是如何划分队列的。 Q15.CDH 如何对 HDFS 各级目录做权限管理,目录的配额(即使用 HDFS 的容量限制)限制呢? 夏天老师: HDFS 可通过 ACL 精细控制目标权限,除了 ACL 后续我们也会讲sentry;目前我们产线环境没有做容量配额限制,怕影响生产,我们通过集群治理来解决容量问题,集群治理是我们的课程内容之一,后续会讲解 Q16.Hdfs,Yarn,MapReduce,Hive,Spark,Storm,Kafka,Flink 这些组件您在生产环境的调优参数是如何配置的,后续会为我们分享一些调优参数及说明么?我们也方便对照自己的集群作为参考适当调整。 夏天老师: 这个是会的,我们会讲组件的运维、巡检、监控、参数配置、故障排查等课程内容。 Q17.后期的大数据组件监控项目是针对课上所有的组件进行监控的么?还是只是分享监控思路,代码能给我们学员吗? 夏天老师: 大数据组件监控主要在 CM 上进行监控,后续有集群治理案例实战,实战代码可以给学员的。 未完待续………

优秀的个人博客,低调大师

AI无间道!清华AI团队推出AI安全平台,欺骗顶尖人脸算法后又强势修复漏洞

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 随着人工智能技术的发展,人工智能在很多场景里正逐渐替代或协作着人类的各种劳动,它们可以成为人类的眼睛、耳朵、手臂甚至大脑。其中,机器视觉作为AI时代的基础技术,其背后的AI算法一直是各科技巨头和创业公司共同追逐的热点。然而,这些主流应用场景的背后,往往也藏着由技术性缺陷导致的算法安全风险。 例如,在一些训练数据无法覆盖到的极端场景中,自动驾驶汽车可能出现匪夷所思的决策,导致乘车人安全风险。从2016年至今,Tesla、Uber等企业的辅助驾驶和自动驾驶系统就都曾出现过类似致人死亡的严重事故。并且这类极端情形也可能被恶意制造并利用,发起“对抗样本攻击”,去年7月,百度等研究机构就曾经通过3D打印,能让自动驾驶“无视”的障碍物,使车辆有发生撞击的风险,同样威胁行驶安全。 之所以能攻击成功,主要是机器视觉和人类视觉有着很大的差异。因此可以通过在图像、物体等输入信息上添加微小的扰动改变(即上述故意干扰的“对抗样本”),就能导致很大的算法误差。此外,随着AI的进一步发展,将算法模型运用于更多类似金融决策、医疗诊断等关键核心场景,这类AI“漏洞”的威胁将愈发凸显出来。 近几年来,包括清华大学人工智能研究院院长张钹院士、前微软全球执行副总裁沈向洋等均提倡要发展安全、可靠、可信的人工智能以及负责任的人工智能,其中AI的安全应用均是重点方向。 然而AI安全作为一个新兴领域,尽管对抗样本等攻击手段日益变得复杂,在开源社区、工具包的加持下,高级攻击方法快速增长,相关防御手段的普及和推广却难以跟上。在AI算法研发和应用的过程中,对抗样本等算法漏洞检测存在较高的技术壁垒,目前市面上缺乏自动化检测工具,而大部分企业与组织不具备该领域的专业技能来妥善应对日益增长的恶意攻击。 一、从安全评测到防御升级,RealSafe让AI更加安全可控 为了解决以上痛点,近日,清华大学AI研究院孵化企业RealAI(瑞莱智慧)正式推出首个针对AI在极端和对抗环境下的算法安全性检测与加固的工具平台——RealSafe人工智能安全平台。 据了解,该平台内置领先的AI对抗攻防算法,提供从安全测评到防御加固整体解决方案,目前可用于发现包括人脸比对等在内的常用AI算法可能出错的极端情形,也能预防潜在的对抗攻击。 RealAI表示,就如网络安全时代,网络攻击的大规模渗透诞生出杀毒软件,发现计算机潜在病毒威胁,提供一键系统优化、清理垃圾跟漏洞修复等功能,RealSafe研发团队希望通过RealSafe平台打造出人工智能时代的“杀毒软件”,为构建人工智能系统防火墙提供支持,帮助企业有效应对人工智能时代下算法漏洞孕育出的“新型病毒”。 RealSafe平台目前主要支持两大功能模块:模型安全测评、防御解决方案。 其中,模型安全评测主要为用户提供AI模型安全性评测服务。用户只需接入所需测评模型的SDK或API接口,选择平台内置或者自行上传的数据集,平台将基于多种算法生成对抗样本模拟攻击,并综合在不同算法、迭代次数、扰动量大小的攻击下模型效果的变化,给出模型安全评分及详细的测评报告(如下图)。目前已支持黑盒查询攻击方法与黑盒迁移攻击方法。 防御解决方案则是为用户提供模型安全性升级服务,目前RealSafe平台支持五种去除对抗噪声的通用防御方法,可实现对输入数据的自动去噪处理,破坏攻击者恶意添加的对抗噪声。根据上述的模型安全评测结果,用户可自行选择合适的防御方案,一键提升模型安全性。另外防御效果上,根据实测来看,部分第三方的人脸比对API通过使用RealSafe平台的防御方案加固后,安全性可提高40%以上。 随着模型攻击手段在不断复杂扩张的情况下,RealSafe平台还持续提供广泛且深入的AI防御手段,帮助用户获得实时且自动化的漏洞检测和修复能力。 二、“对抗样本”成“AI病毒”,国外主流人脸识别算法相继被“攻破” 站在人脸识别终端前,通过人脸识别摄像头完成身份校验,类似的人脸识别身份认证已经覆盖到刷脸支付、酒店入住登记、考试身份核验、人证比对等等生活场景中。 考虑到公众对于对抗样本这一概念可能比较模糊,RealSafe平台选取了公众最为熟知的人脸比对场景(人脸比对被广泛用于上述的身份认证场景中)提供在线体验。并且,为了深入研究“对抗样本”对人脸比对系统识别效果的影响,RealAI 团队基于此功能在国外主流 AI 平台的演示服务上进行了测试。 选取一组不同的人脸图片(如下图),通过RealSafe平台对其中一张图片生成对抗样本,但不影响肉眼判断,添加“对抗样本”前后分别输入到第三方人脸比对平台中查看相似度。 最终结果显示,添加“噪声”前,两张图片被 Azure 判定为不属于同一个人,但添加“噪声”后,以上两个平台的演示服务均给出了错误的结果,认为两张图片属于同一个人,甚至 Azure 平台的演示服务在添加“噪声”前后相似度变化的幅度高达70%以上。 为了探究结果的普适性,RealAI团队又选取了国内三家主流人脸比对平台进行测试,结果同样显示,添加扰动之后,原本判定为“不同人脸”的图片均被错误识别为“相同人脸”,前后相似度的变化幅度可达到20%以上。而通过RealSafe防火墙“去噪”过滤后,这几个人脸比对平台的识别“误差”获得不同程度的纠正,识别效果得到稳定提升。 RealAI团队已经将这种潜在风险以及相关防御方法反馈给上述企业,以帮助降低风险。 实测证明,“对抗样本”可以极大的干扰人脸比对系统的识别结果,据介绍,目前市面上很多中小型企业在落地人脸识别应用时大多会选择采用上文测试的这几家互联网公司开放的人脸比对SDK或者API接口,如果他们人脸比对技术存在明显的安全漏洞,意味着更广泛的应用场景将存在安全隐患。 除了人脸比对外,对抗样本攻击还可能出现在目标检测的应用场景中,延伸来看,这可能会危害到工业、安防等领域的安全风险检测。比如某电网的输电塔的监控系统,由于输电塔的高安全性防护要求,防止吊车、塔吊、烟火破坏输电线路,需要对输电塔内外进行全天候的实时监控,而这实时监控系统背后就是基于目标检测的AI算法来提供保障。 而RealAI研究团队发现,只要通过RealSafe对其中的目标检测算法进行一定的对抗样本攻击,就会造成监控系统失效,导致其无法识别非常明显的烟火情形,类似情形如果真实发生,将可能带来难以估计的损失。 事实上,像以上提到的这些AI安全风险由于都是AI底层算法存在技术缺陷而导致,往往比较隐蔽,但牵一发动全身,这些“难以预见”的风险漏洞最有可能成为被攻破的薄弱环节,而RealSafe平台同步推出的防御解决方案则可以有效增强各应用领域中AI算法的安全性。 三、“零编码”+“可量化”,两大优势高效应对算法威胁 据介绍,RealAI此次推出的算法模型安全检测平台,除了可以帮助企业高效应对算法威胁还具备以下两大优势: 组件化、零编码的在线测评:相较于ART、Foolbox等开源工具需要自行部署、编写代码,RealSafe平台采用组件化、零编码的功能设置,免去了重复造轮子的精力与时间消耗,用户只需提供相应的数据即可在线完成评估,极大降低了算法评测的技术难度,学习成本低,无需拥有专业算法能力也可以上手操作。比如上文中针对微软、亚马逊等第三方平台的测试,整个流程按照步骤提示完成,只需几分钟就可以查看到测评结果。 可视化、可量化的评测结果:为了帮助用户提高对模型安全性的概念,RealSafe平台采用可量化的形式对安全评测结果进行展示,根据模型在对抗样本攻击下的表现进行评分,评分越高则模型安全性越高。此外,RealSafe平台提供安全性变化展示,经过防御处理后的安全评分变化以及模型效果变化一目了然。 四、落地安全周边产品,为更多场景保驾护航 其实对抗样本原本是机器学习模型的一个有趣现象,但经过不断的升级演化,“对抗样本”已经演变成一种新型攻击手段,并从数字世界蔓延到物理世界:在路面上粘贴对抗样本贴纸模仿合并条带误导自动驾驶汽车拐进逆行车道、胸前张贴一张对抗样本贴纸在监控设备下实现隐身…… 所以,除了针对数字世界的算法模型推出安全评测平台,RealAI团队也联合清华大学AI研究院围绕多年来积累的领先世界的研究成果落地了一系列AI攻防安全产品,旨在满足更多场景的AI安全需求。 比如,攻击技术方面,RealAI团队实现了世界首个通过“对抗样本”技术实现破解商用手机刷脸解锁,让手机将佩戴“特制眼镜”的黑客误识为机主。 △ 图:世界唯一通过AI对抗样本技术攻破商用手机人脸解锁案例 通过在目标人服装上张贴特制花纹使AI监控无法检测到该人物,实现“隐身”,以及通过在车辆上涂装特殊花纹,躲避AI对车辆的检测。 △ 图:通过AI对抗样本图案躲避AI车辆检测 在发现以上各种新型漏洞的同时,RealAI也推出相应的防御技术,支持对主流AI算法中的安全漏洞进行检测,并提供AI安全防火墙对攻击AI模型的行为进行有效拦截。 人工智能的大潮滚滚而来,随之而来的安全风险也将越来越多样化,尤其近年来因AI技术不成熟导致的侵害风险也频频发生,可以说,算法漏洞已逐渐成为继网络安全、数据安全后又一大安全难题。 所幸的是,以RealAI为代表的这些顶尖AI团队早已开始了AI安全领域的征程,并开始以标准化的产品助力行业降低应对安全风险的门槛与成本。此次上线RealSafe人工智能安全平台是RealAI的一小步尝试,但对于整个行业而言,这将是人工智能产业迈向健康可控发展之路的一大步。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-07本文作者:允中本文来自:“量子位公众号”,了解相关信息可以关注“公众号 QbitAI”

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册