首页 文章 精选 留言 我的

精选列表

搜索[数据库知识开放麦],共10000篇文章
优秀的个人博客,低调大师

每日一博 | JVM 的入门知识

前言:巴拉巴拉,今天给大家分享一点java三剑客(jre,jvm,jdk)中的jvm,纯理论教科书篇。 非原创,里面摘取了多个博客里面的内容 1JDK、 JRE、JVM 的关系是什么? 我们学习JVM的之前,简单科普一下他们三者有啥关系 JVM JAVA 虚拟机(Java Virtual Machine)。它只识别 .class 类型文件,它能够将 class 文件中的字节码指令进行识别并调用操作系统向上的 API 完成动作 JRE Java 运行时环境(Java Runtime Environment)。它主要包含两个部分:JVM 的标准实现和 Java 的一些基本类库。相对于JVM 来说,JRE多出了一部分 Java 类库 JDK Java 开发工具包(Java Development Kit)。JDK 是整个 Java 开发的核心,它集成了 JRE 和一些好用的小工具 常用工具 jar.exe jar文件管理工具,打包压缩解压jar文件 java.exe java运行工具,运行.class字节码文件或 .jar文件 javac.exe java编译工具,用来编译.java源代码文件 javap.exe java反编译工具,根据java字节码文件反汇编成java源代码文件 jvisualvm.exe jvm监控,分析工具 这三者的关系:JDK > JRE > JVM 由于Oracle jdk 从jdk 8u211以后商业用途需要收费,提供一下免费JDK 阿里dragonwell8 https://github.com/alibaba/dragonwell8/releases 亚马逊Corretto https://docs.aws.amazon.com/corretto/latest/corretto-8-ug/downloads-list.html adoptopenjdk https://adoptopenjdk.net openjdk http://openjdk.java.net/install 2 JVM的核心 JVM(Java Virtual Machine)是用来运行Java字节码的虚拟机,包括字节码指令集、程序寄存器、栈、堆、方法区和垃圾回收器。 JVM运行在操作系统之上,不与硬件设备直接交互。 Java源文件在通过编译器之后被编译成相应的.Class文件(字节码文件),.Class文件又被JVM中的解释器编译成机器码在不同的操作系统(Windows、Linux、Mac)上运行。 每种操作系统的解释器都是不同的,但基于解释器实现的虚拟机是相同的,这也是Java能够跨平台的原因。 在一个Java进程开始运行后,虚拟机就开始实例化了,有多个进程启动就会实例化多个虚拟机实例。进程退出或者关闭,则虚拟机实例消亡,在多个虚拟机实例之间不能共享数据。 Java程序的具体运行过程如下。 (1)Java源文件被编译器编译成字节码文件。 (2)JVM将字节码文件编译成相应操作系统的机器码。 (3)机器码调用相应操作系统的本地方法库执行相应的方法。 Java虚拟机包括一个类加载器子系统(Class Loader SubSystem)、运行时数据区(Runtime Data Area)、执行引擎和本地接口库(Native InterfaceLibrary)。 本地接口库通过调用本地方法库(Native Method Library)与操作系统交互。 JVM核心图 ◎ 类加载器子系统用于将编译好的.Class文件加载到JVM中; ◎ 运行时数据区用于存储在JVM运行过程中产生的数据,包括程序计数器、方法区、本地方法区、虚拟机栈和虚拟机堆; ◎ 执行引擎包括即时编译器和垃圾回收器,即时编译器用于将Java字节码编译成具体的机器码,垃圾回收器用于回收在运行过程中不再使用的对象; ◎ 本地接口库用于调用操作系统的本地方法库完成具体的指令操作。 3 JVM的内存区域 JVM的内存区域分为线程私有区域(程序计数器、栈、本地方法区)、线程共享区域(堆、方法区)和直接内存。 3.1 线程私有区域 生命周期与线程相同,随线程的启动而创建,随线程的结束而销毁。在JVM内,每个线程都与操作系统的本地线程直接映射,因此这部分内存区域的存在与否和本地线程的启动和销毁对应。 3.1.1程序计数器 程序计数器是一块很小的内存空间,用于存储当前运行的线程所执行的字节码的行号指示器。每个运行中的线程都有一个独立的程序计数器,在方法正在执行时,该方法的程序计数器记录的是实时虚拟机字节码指令的地址;如果该方法执行的是Native方法,则程序计数器的值为空(Undefined)。程序计数器属于“线程私有”的内存区域,它是唯一没有Out Of Memory(内存溢出)的区域。 3.1.2虚拟机栈 虚拟机栈是描述Java方法的执行过程的内存模型,它在当前栈帧(Stack Frame)中存储了局部变量表、操作数栈、动态链接、方法出口等信息。同时,栈帧用来存储部分运行时数据及其数据结构,处理动态链接(Dynamic Linking)方法的返回值和异常分派(Dispatch Exception)。栈帧用来记录方法的执行过程,在方法被执行时虚拟机会为其创建一个与之对应的栈帧,方法的执行和返回对应栈帧在虚拟机栈中的入栈和出栈。无论方法是正常运行完成还是异常完成(抛出了在方法内未被捕获的异常),都视为方法运行结束。 上图展示了线程运行图。 线程1在CPU1上运行,线程2在CPU2上运行,在CPU资源不够时其他线程将处于等待状态,等待获取CPU时间片。 而在线程内部,每个方法的执行和返回都对应一个栈帧的入栈和出栈,每个运行中的线程当前只有一个栈帧处于活动状态。 jvm参数: -Xss128k:每个线程栈的大小,合理的减少可以使剩余的系统内存支持更多的线程。 3.1.3 本地方法区 本地方法区和虚拟机栈的作用类似,区别是虚拟机栈为执行Java方法服务,本地方法栈为Native方法服务。 3.2线程共享区域 随虚拟机的启动而创建,随虚拟机的关闭而销毁。 3.2.1 堆 也叫作运行时数据区,在JVM运行过程中创建的对象和产生的数据都被存储在堆中,堆是被线程共享的内存区域,也是垃圾收集器进行垃圾回收的最主要的内存区域。由于现代JVM采用分代收集算法,因此Java堆从GC(Garbage Collection,垃圾回收)的角度还可以细分为:新生代、老年代和永久代。 jvm参数: -Xms4G : JVM启动时整个堆(包括年轻代,年老代)的初始化大小 (一般将和最大保持一致,可以避免堆内存频繁震荡,导致系统性能下降,jvm会尽可能维持在最小空间运行,这样很有可能发生频繁GC)。 -Xmx4G : JVM启动时整个堆的最大值。 -Xmn2G:年轻代的空间大小,剩下的是年老代的空间。 3.2.2 方法区 方法区也被称为永久代,用于存储常量、静态变量、类信息、即时编译器编译后的机器码、运行时常量池等数据 JVM把GC分代收集扩展到了方法区,这样JVM的垃圾收集器就可以像管理Java堆一样管理这部分内存。 永久代的内存回收主要针对常量池的回收和类的卸载,可回收的对象很少。 3.3 直接内存 也叫堆外内存,就是把内存对象分配在Java虚拟机的堆以外的内存 ,它并不是JVM运行时数据区的一部分,直接受操作系统管理(而不是虚拟机),这样做的结果就是能够在一定程度上减少垃圾回收对应用程序造成的影响。 JDK的NIO模块提供的基于Channel与Buffer的I/O操作方式就是基于堆外内存实现的,NIO模块通过调用Native函数库直接在操作系统上分配堆外内存,然后使用java.nio.DirectByteBuffer对象作为这块内存的引用 对内存进行操作。 这样可以加快复制速度,因为堆内数据刷新到远程时,会先复制到直接内存,然后再发送,可以减少堆内存和直接内存的来回复制影响性能,因此堆外内存在高并发应用场景下被广泛使用( Ehcache,Netty、Flink、HBase、Hadoop都有用到堆外内存)。 4 JVM的运行时内存(堆) JVM的运行时内存也叫作JVM堆,从GC的角度可以将JVM堆分为新生代、老年代和永久代。其中新生代默认占1/3堆空间,老年代默认占2/3堆空间,永久代占非常少的堆空间。新生代又分为Eden区、ServivorFrom区和ServivorTo区,Eden区默认占8/10新生代空间,ServivorFrom区和ServivorTo区默认分别占1/10新生代空间。 4.1 新生代 JVM新创建的对象(除了大对象外)会被存放在新生代,默认占1/3堆内存空间。由于JVM会频繁创建对象,所以新生代会频繁触发MinorGC进行垃圾回收。 新生代又分为Eden区、ServivorTo区和ServivorFrom区 ◎Eden区:Java新创建的对象首先会被存放在Eden区,如果新创建的对象属于大对象,则直接将其分配到老年代。大对象的定义和具体的JVM版本、堆大小和垃圾回收策略有关,一般为2KB~128KB,可通过XX:PretenureSizeThreshold设置其大小。在Eden区的内存空间不足时会触发GC。 ◎ServivorTo区:保留上一次GC时的幸存者。 ◎ServivorFrom区: 上一次GC的幸存者,作为这一次GC的被扫描者。 新生代的GC过程叫作MinorGC,采用复制算法实现,具体过程如下。 (1)Eden区内存空间不足会触发GC (2)扫描Eden区和ServivorFrom区进行GC回收 (3)将存活的对象复制到ServivorTo区(如果某对象的年龄达到老年代的标准(对象晋升老年代的标准由XX:MaxTenuringThreshold设置,默认为15),则将其复制到老年代。如果ServivorTo区的内存空间不够,则也直接将其复制到老年代;如果对象属于大对象(大小为2KB~128KB的对象属于大对象,例如通过XX:PretenureSizeThreshold=2097152设置大对象为2MB,1024×1024×2),则也直接将其复制到老年代) (4)将现有ServivorTo区的存活的对象年龄加1 (5)清空Eden区和ServivorFrom区中的对象 (6)将ServivorTo区和ServivorFrom区互换(原来的ServivorTo区成为下一次GC时的ServivorFrom区) 4.2 老年代 老年代主要存放有长生命周期的对象和大对象。老年代的GC过程叫作MajorGC。在老年代,对象比较稳定,MajorGC不会被频繁触发。在进行MajorGC前,JVM会进行一次MinorGC,在MinorGC过后仍然出现老年代空间不足或无法找到足够大的连续空间分配给新创建的大对象时,会触发MajorGC进行垃圾回收,释放JVM的内存空间。MajorGC采用标记清除算法,该算法首先会扫描所有对象并标记存活的对象,然后回收未被标记的对象,并释放内存空间。因为要先扫描老年代的所有对象再回收,所以MajorGC的耗时较长。MajorGC的标记清除算法容易产生内存碎片。在老年代没有内存空间可分配时,会抛出Out Of Memory异常。 报错误的原因是因为执行垃圾收集的时间比例太大, 有效的运算量太小。默认情况下, 如果GC花费的时间超过 98%, 并且GC回收的内存少于 2%, JVM就会抛出这个错误。 4.3 永久代 永久代指内存的永久保存区域,主要存放Class和Meta(元数据)的信息。Class在类加载时被放入永久代。永久代和老年代、新生代不同,GC不会在程序运行期间对永久代的内存进行清理,这也导致了永久代的内存会随着加载的Class文件的增加而增加,在加载的Class文件过多时会抛出Out OfMemory异常,比如Tomcat引用Jar文件过多导致JVM内存不足而无法启动。需要注意的是,在Java 8中永久代已经被元数据区(也叫作元空间)取代。元数据区的作用和永久代类似,二者最大的区别在于:元数据区并没有使用虚拟机的内存,而是直接使用操作系统的本地内存。因此,元空间的大小不受JVM内存的限制,只和操作系统的内存有关。在Java 8中,JVM将类的元数据放入本地内存(Native Memory)中,将常量池和类的静态变量放入Java堆中,这样JVM能够加载多少元数据信息就不再由JVM的最大可用内存(MaxPermSize)空间决定,而由操作系统的实际可用内存空间决定。 5.垃圾回收与算法 5.1 如何确定是垃圾? Java采用引用计数法和可达性分析来确定对象是否应该被回收,其中,引用计数法容易产生循环引用的问题,可达性分析通过根搜索算法(GC RootsTracing)来实现。根搜索算法以一系列GC Roots的点作为起点向下搜索,在一个对象到任何GCRoots都没有引用链相连时,说明其已经死亡。根搜索算法主要针对栈中的引用、方法区中的静态引用和JNI中的引用展开分析,如图1-6所示。 5.1.1 引用计数法 在Java中如果要操作对象,就必须先获取该对象的引用,因此可以通过引用计数法来判断一个对象是否可以被回收。在为对象添加一个引用时,引用计数加1;在为对象删除一个引用时,引进计数减1;如果一个对象的引用计数为0,则表示此刻该对象没有被引用,可以被回收。引用计数法容易产生循环引用问题。循环引用指两个对象相互引用,导致它们的引用一直存在,而不能被回收。 Object1与Object2互为引用,如果采用引用计数法,则Object1和Object2由于互为引用,其引用计数一直为1,因而无法被回收。 5.1.2 可达性分析 为了解决引用计数法的循环引用问题,Java还采用了可达性分析来判断对象是否可以被回收。具体做法是首先定义一些GC Roots对象,然后以这些GCRoots对象作为起点向下搜索,如果在GC roots和一个对象之间没有可达路径,则称该对象是不可达的。不可达对象要经过至少两次标记才能判定其是否可以被回收,如果在两次标记后该对象仍然是不可达的,则将被垃圾收集器回收。 5.2 常用的垃圾回收算法 Java中常用的垃圾回收算法有标记清除(Mark-Sweep)、复制(Copying)、标记整理(Mark-Compact)和分代收集(GenerationalCollecting)这4种垃圾回收算法。 5.2.1标记清除算法、 标记清除算法是基础的垃圾回收算法,其过程分为标记和清除两个阶段。在标记阶段标记所有需要回收的对象,在清除阶段清除可回收的对象并释放其所占用的内存空间 由于标记清除算法在清理对象所占用的内存空间后并没有重新整理可用的内存空间,因此如果内存中可被回收的小对象居多,则会引起内存碎片化的问题,继而引起大对象无法获得连续可用空间的问题。 5.2.2 复制算法 复制算法是为了解决标记清除算法内存碎片化的问题而设计的。复制算法首先将内存划分为两块大小相等的内存区域,即区域1和区域2,新生成的对象都被存放在区域1中,在区域1内的对象存储满后会对区域1进行一次标记,并将标记后仍然存活的对象全部复制到区域2中,这时区域1将不存在任何存活的对象,直接清理整个区域1的内存即可。 复制算法的内存清理效率高且易于实现,但由于同一时刻只有一个内存区域可用,即可用的内存空间被压缩到原来的一半,因此存在大量的内存浪费。同时,在系统中有大量长时间存活的对象时,这些对象将在内存区域1和内存区域2之间来回复制而影响系统的运行效率。因此,该算法只在对象为“朝生夕死”状态时运行效率较高。 5.2.3标记整理算法 标记整理算法结合了标记清除算法和复制算法的优点,其标记阶段和标记清除算法的标记阶段相同,在标记完成后将存活的对象移到内存的另一端,然后清除该端的对象并释放内存。 5.2.4分代收集算法 无论是标记清除算法、复制算法还是标记整理算法,都无法对所有类型(长生命周期、短生命周期、大对象、小对象)的对象都进行垃圾回收。因此,针对不同的对象类型,JVM采用了不同的垃圾回收算法,该算法被称为分代收集算法。分代收集算法根据对象的不同类型将内存划分为不同的区域,JVM将堆划分为新生代和老年代。新生代主要存放新生成的对象,其特点是对象数量多但是生命周期短,在每次进行垃圾回收时都有大量的对象被回收;老年代主要存放大对象和生命周期长的对象,因此可回收的对象相对较少。因此,JVM根据不同的区域对象的特点选择了不同的算法。目前,大部分JVM在新生代都采用了复制算法,因为在新生代中每次进行垃圾回收时都有大量的对象被回收,需要复制的对象(存活的对象)较少,不存在大量的对象在内存中被来回复制的问题,因此采用复制算法能安全、高效地回收新生代大量的短生命周期的对象并释放内存。JVM将新生代进一步划分为一块较大的Eden区和两块较小的Servivor区,Servivor区又分为ServivorFrom区和ServivorTo区。JVM在运行过程中主要使用Eden区和ServivorFrom区,进行垃圾回收时会将在Eden区和ServivorFrom区中存活的对象复制到ServivorTo区,然后清理Eden区和ServivorFrom区的内存空间。 老年代主要存放生命周期较长的对象和大对象,因而每次只有少量非存活的对象被回收,因而在老年代采用标记清除算法。在JVM中还有一个区域,即方法区的永久代,永久代用来存储Class类、常量、方法描述等。在永久代主要回收废弃的常量和无用的类。JVM内存中的对象主要被分配到新生代的Eden区和ServivorFrom区,在少数情况下会被直接分配到老年代。在新生代的Eden区和ServivorFrom区的内存空间不足时会触发一次GC,该过程被称为MinorGC。在MinorGC后,在Eden区和ServivorFrom区中存活的对象会被复制到ServivorTo区,然后Eden区和ServivorFrom区被清理。如果此时在ServivorTo区无法找到连续的内存空间存储某个对象,则将这个对象直接存储到老年代。若Servivor区的对象经过一次GC后仍然存活,则其年龄加1。在默认情况下,对象在年龄达到15时,将被移到老年代。 5.2.5分区收集算法 分区算法将整个堆空间划分为连续的大小不同的小区域,对每个小区域都单独进行内存使用和垃圾回收,这样做的好处是可以根据每个小区域内存的大小灵活使用和释放内存。分区收集算法可以根据系统可接受的停顿时间,每次都快速回收若干个小区域的内存,以缩短垃圾回收时系统停顿的时间,最后以多次并行累加的方式逐步完成整个内存区域的垃圾回收。如果垃圾回收机制一次回收整个堆内存,则需要更长的系统停顿时间,长时间的系统停顿将影响系统运行的稳定性。 5.3 java中垃圾收集器 Java堆内存分为新生代和老年代:新生代主要存储短生命周期的对象,适合使用复制算法进行垃圾回收;老年代主要存储长生命周期的对象,适合使用标记整理算法进行垃圾回收。因此,JVM针对新生代和老年代分别提供了多种不同的垃圾收集器,针对新生代提供的垃圾收集器有Serial、ParNew、Parallel Scavenge,针对老年代提供的垃圾收集器有Serial Old、Parallel Old、CMS,还有针对不同区域的G1,ZGC分区收集算法。 1. Serial (新生代单线程复制算法) 针对新生代的垃圾回收器,它是单线程执行的,是一款串行的垃圾回收器,采用的是复制算法。它的单线程并不仅仅指它在进行垃圾回收时是单线程或者单处理器执行,更深的含义是它在垃圾回收时,需要暂停其他所有的线程,造成 STW。 当 JVM 处于客户端模式下时,Serial 是默认的垃圾回收器,它的优点是简单高效。在内存资源受限的环境下,Serial 垃圾回收器相比其他垃圾回收器,它所占用的内存更小。对于单处理器的场景,Serial 处理器由于是单线程的,它省去了线程之间的资源竞争,因此会更加高效。 当使用参数 「-XX:+UseSerialGC」时,在开启使用Serial垃圾回收器同时,老年代的垃圾回收器为Serial Old。 2.Serial Old(老年代单线程标记整理算法) 和 Serial 一样,Serial Old 也是单线程执行的,是一款串行的垃圾回收器,不同的是 Serail Old 回收的是老年代区域,采用的算法是标记-压缩(整理)算法。在进行垃圾回收时,同样也会造成 STW 的现象。 3.ParNew(新生代多线程复制算法) 针对新生代区域的垃圾回收器,它是 Serial 垃圾收集器的多线程版本,即它是一款并行的垃圾回收器,支持多个垃圾回收线程同时并行回收垃圾,使用的也是复制算法。ParNew 的大部分参数配置和 Serial 收集器一样,但额外多了部分参数,如:可以通过参数 「-XX:ParallelGCThreads」 来指定并行的垃圾回收的线程个数,默认情况下,垃圾回收线程的个数与处理器的个数相等。在单处理器的系统中,ParNew 的性能并不一定比 Serial 好,因为线程的切换需要额外耗费 CPU 资源。 可以使用参数 「-XX:+UseParNewGC」 来开启使用 ParNew 进行垃圾回收。 ParNew 可以和 Serial Old 或者 CMS 搭配使用,然而从 JDK9 开始,官方已经移除了 ParNew 和 Serial Old 的组合使用方式,同时 JDK9 中将 CMS 标记为 Deprecated 状态,在 JDK14 中彻底移除 CMS,这就导致了 ParNew 将处于一个十分尴尬的地位,在高版本中既不能和 Serial Old 搭配使用,也将在未来无法和 CMS 搭配使用,这就导致了 ParNew 这款垃圾回收器必然消失在历史的舞台。 4.Parallel Scavenge (新生代多线程复制算法) 针对新生代的并行的垃圾回收器,它和 ParNew 虽然都是并行、针对新生代,但是它们的区别很大,Parallel Scavenge 是一款「吞吐量优先」的垃圾回收器。适用于那些期望尽可能的利用 CPU 资源、尽快完成程序的运算任务以及不太注重用户交互行为的场景。 Parallel Scavenge 提供了两个参数来精准地控制吞吐量,分别是 「MaxGCPauseMillis」 和 「GCTimeRatio」。 MaxGCPauseMillis 表示的是每次进行 GC 时,系统的最大停顿时间,如果配置了该参数,那么 JVM 在每次进行垃圾回收时,它会尽可能的将停顿时间控制在 MaxGCPauseMillis 之内。该参数并不是配置的越小越好,如果配置得很小,那么 JVM 可能会为了达到停顿时间控制在 MaxGCPauseMillis 之内的目的,选择以减小新生代区域的大小为代价,毕竟每次回收 300M 的空间所花的时间肯定比 500M 的短。「而 JVM 将新生代的内存区域调小后,带来的后果就是垃圾回收进行得更加频繁了,最后会导致系统的吞吐量下降」。通常情况下,我们无法精准地把控每次垃圾回收需要停顿的时间,所以该参数需要慎用,一不小心,配置的不合理,可能适得其反。 GCTimeRatio 表示的是每次 GC 的时间占用的比率是多少(具体计算方是:GCTimeRatio = 用户线程运行时间/ GC 线程运行时间),例如:如果 GCTimeRatio 参数的值配置的 19,那么 GC 运行的时间占总时间的 5%(1/(1+19))。JVM 通过这个参数来达到控制系统吞吐量的目的。 另外 JVM 还提供了一个参数,叫做「UseAdpativeSizePolicy」,它表示的是让 JVM「根据系统的运行情况来动态调整」新生代(Eden、S0、S1)、老年代的大小,我们只需要设置好最基本的内存参数以及 MaxGCPauseMillis(最大停顿时间)或者 GCTimeRatio(目标吞吐量)即可,不需要设置-XX:Xmn(新生代的内存大小)、-XX:SurvivorRatio (Surivivior区域的比例)等参数了,JVM 会根据系统运行时监控到相关信息,来动态进行调整。Parallel Scavenge 支持动态调整策略,这也算是它和 ParNew 收集器的另一大不同之处了。 5.Parallel Old (老年代多线程标记整理算法) 收集器的老年代版本,也是支持多线程的并行执行,它底层是基于标记-压缩(整理)算法来实现的。在 JDK6 中才开始提供,在 Parallel Old 出现之前,Parallel Scavenge 收集器只能配合着 Serial Old 使用,无法与 CMS 垃圾回收器配合使用,这是因为 Parallel Scavenge 与 CMS、Serial、ParNew 这些收集器的底层框架不一样,无法兼容导致的。而 Serial Old 又是单线程的垃圾收集器,在多处理器的场景下,性能不高,白白浪费了 Parallel Scavenge 并行的优点,好车配劣马,所以在 Parallel Old 出现之前,Parallel Scavenge 一直处于比较鸡肋的地位。目前,Parallel Scavenge 和 Parallel Old 的组合,其垃圾回收效果不错,是 JDK8 中默认的垃圾回收组合方式。 6.CMS(老年代多线程标记清除算法) CMS 的全称是 Concurrent-Mark-Sweep 的缩写,翻译过来就是并发标记清除,它是一款「以低停顿时间为目标」的垃圾回收器,特点是低延时。 CMS 的工作原理大致分为四个步骤:初始标记、并发标记、重新标记、并发清除。 使用参数:「-XX:+UseConcMarkSweepGC」 即可开启使用 CMS 垃圾回收器。 「初始标记」指的是仅仅只标记出和 GC Roots 直接关联的对象,这个过程需要暂停所有的用户线程,因此会产生 STW。由于这一步仅仅标记和 GC Roots 直接关联的对象,因此这一步耗费的时间会很短,造成的停顿时间会很短。 「并发标记」。这一步是从和 GC Roots 直接关联的对象出发,开始遍历整个对象图引用链,这个过程是 GC 线程和用户线程并发执行的,因此不会造成 STW。这一步因为需要遍历所有对象的引用链,所以耗费时间较长,由于不会造成 STW,即使耗时较长,也没有关系。 「重新标记」。在并发标记阶段,用户线程仍然在运行,因此会改变对象之间的引用关系,那么在重新标记阶段,就是对并发标记的结果进行修正。把那些怀疑是垃圾,而实际不是垃圾的对象重新标记为存活对象。这一步需要暂停所有的用户线程,因此会造成 STW 的现象,这一步的耗时会比初始标记阶段长一些,但是远小于并发标记阶段的耗时。 「并发清除」。这一阶段是垃圾回收线程和用户线程一起并发执行,垃圾回收线程进行垃圾对象的清除,这一步耗时较长,但不会造成 STW。 整体上来看,CMS 垃圾回收器只有在初始标记阶段和重新标记阶段会造成用户线程的停顿,但是这两步都耗时较短,因此整体上,CMS 进行垃圾回收时,是低延时的。 7.G1(新生代和老年代多线程分区标记整理算法) G1是一个并行回收器,它把堆内存分割为很多不相关的区域(Region)(物理上不连续的)。使用不同的 Region来表示Eden、S0区,S1区,Old区等。 独立使用这些区域的内存资源并且跟踪这些区域的垃圾收集进度,同时在后台维护一个优先级列表,在垃圾回收过程中根据系统允许的最长垃圾收集时间,优先回收垃圾最多的区域。 在JDK1.7正式启用,是JDK9以后默认的垃圾回收器,被Oracle官方称为“全功能的垃圾收集器” 优点: 1. 并行与并发 并行性:G1在回收期间,可以有多个GC线程同时工作(不再是一个GC线程),有效利用多核计算能力,此时用户线程处于STW 并发性:G1拥有与应用程序交替执行的能力,部分工作可以和应用程序同时执行,因此,一般来说,不会在整个回收阶段发生完全阻塞应用程序的情况 2. 分区收集,支持新老代 同时兼顾年轻代和老年代。将堆空间分为若干个小区域(Region),这些区域中包含了逻辑上的年轻代和老年代。 3.可预测的停顿时间模型 回收时间可预测性,每次根据允许的时间优先回收价值最大的Region,尽可能提高收集效率 配置参数 -XX:+UseG1GC:手动指定使用G1收集器执行内存回收任务。 -XX:G1HeapRegionSize:设置每个Region的大小,大小区间只能是1M、2M、4M、8M、16M和32M , 如果G1HeapRegionSize为默认值,则在堆初始化时计算Region的实践大小 。 -XX:MaxGCPauseMillis:设置期望达到的最大GC停顿时间指标(JVM会尽力实现,但不保证达到),默认值是200ms -XX:ParallelGCThread:设置STW工作线程数的值,最多设置为8 -XX:ConcGCThreads:设置并发标记的线程数。 -XX:InitiatingHeapoccupancyPercent:设置触发并发GC周期的Java堆占用率阙值。超过此值,就触发GC。默认值是45。 文章:https://mp.weixin.qq.com/s/7CWbARimO5rFBHq4NtAt5Q 8.最前沿的低延时垃圾回收技术——ZGC,Shenandoah ZGC 全称为 Z Garbage Collector,一款在保证吞吐量的情况下,追求低延时的垃圾回收器。 ZGC 是目前垃圾回收器中最前沿的技术,可惜的是目前 ZGC 还没有被正式使用,一直处于实验状态(Experiment)。从 JDK11 开始,被加入到了 OpenJDK 中,到目前 2020 年 4 月份发布的最新 Oracle JDK14 中,ZGC 依旧处于实验状态。 可以通过添加 JVM 参数:-XX:+UnlockExperimentalVMOptions 进行解锁实验状态。 Shenandoah 的目标是将垃圾回收的停顿时间控制在 10ms 以内,这意味着 Shenandoah 不仅需要在并发标记阶段实现并发,还需要在标记清除阶段实现并发。 Shenandoah 垃圾回收器是 RedHat 公司发明的,非 Oracle 公司官方实现,不是 Oracle 的亲儿子,因此在一定程度上遭到了“排挤”,只在开源的 OpenJDK12 中开始出现,而在商业版的 Oracle JDK12 中则没有。 ZGC文章:https://mp.weixin.qq.com/s/FkG0iweym0q8gGDx2b8iMg Shenandoah文章:https://mp.weixin.qq.com/s/J9lOoihkfUKvJpt-7GSxXw 9.总结 随着JDK的不断更新,垃圾回收器的效率也越来越高,每一次JDK大版本的更新,必然会对垃圾回收器更新,截止到目前,JDK14可以使用的最新的垃圾回收器ZGC,在 JDK9 中,取消了 ParNew 与 Serial Old、Serial 与 CMS 的搭配组合,并且 CMS 被标记 Deprecated,在 JDK14 中被彻底移除。 评估GC性能的重要指标: 吞吐量:运行用户代码的时间占总运行时间的比例 暂停时间[STW]:执行GC线程时,用户线程被暂停的时间 内存占用:Java堆区所占的内存大小 吞吐量 吞吐量就是CPU运行用户代码的时间与CPU总消耗时间的比值,即: 吞吐量 = 运行用户代码时间 /(运行用户代码时间 + 垃圾收集时间) 吞吐量高是降低了内存回收的执行频率 比如:虚拟机总共运行了100分钟,其中垃圾收集花掉1分钟,那吞量就是99% 暂停时间 暂停时间是指一个时间段内应用程序线程暂停,让GC线程执行的状态,例如: GC期间100毫秒的暂停时间,意味着在这100毫秒期间内没有应用程序线程是活动的 暂停时间短,但是频繁的执行内存回收 这两个指标本质上是互斥的,我们只能在最大吞吐量优先的情况下,降低停顿时间。 想知道自己的GC算法,可以使用 java -XX:+PrintCommandLineFlags -version 查看 我的14默认的是G1 6 JVM的类加载机制 6.1 JVM的类加载阶段 JVM的类加载分为5个阶段:加载、验证、准备、解析、初始化。在类初始化完成后就可以使用该类的信息,在一个类不再被需要时可以从JVM中卸载。 1.加载 指JVM读取Class文件,并且根据Class文件描述创建java.lang.Class对象的过程。类加载过程主要包含将Class文件读取到运行时区域的方法区内,在堆中创建java.lang.Class对象,并封装类在方法区的数据结构的过程,在读取Class文件时既可以通过文件的形式读取,也可以通过jar包、war包读取,还可以通过代理自动生成Class或其他方式读取。 2.验证 主要用于确保Class文件符合当前虚拟机的要求,保障虚拟机自身的安全,只有通过验证的Class文件才能被JVM加载。 3.准备 主要工作是在方法区中为类的变量分配内存空间并设置不同数据类型的静态变量的默认值。 4.解析 JVM会将常量池中的符号引用替换为直接引用。 5.初始化 初始化阶段,执行类构造器<clinit>()方法的过程 <clinit>()方法是由编译器自动收集类中的所有类变量的赋值动作和静态语句块(static{}块)中的语句合并产生的。 JVM规定,只有在父类的<client>方法都执行成功后,子类中的<client>方法才可以被执行。 在一个类中既没有静态变量赋值操作也没有静态语句块时,编译器不会为该类生成<client>方法。 哪些情况会进行类的初始化?主动引用 1.创建类的实例 2.访问类的静态变量 3.访问类的静态方法 4.反射(Class.forName) 5.子类初始化会先对父类初始化 6.虚拟机启动时,定义了main()方法的会先初始化 哪些情况不会进行类初始化?被动引用 1. 子类调用父类的静态变量,子类不会被初始化。只有父类被初始化。对于静态字段,只有直接定义这个字段的类才会被初始化. 2. 通过数组定义来引用类,不会触发类的初始化 3. 访问类的常量,不会初始化类 对于类的初始化我们搞点小demo瞧瞧,上东西~~ 6.2 类加载器 JVM提供了3种类加载器,分别是启动类加载器、扩展类加载器和应用程序类加载器。 (1)启动类加载器:负责加载JAVA_HOME/lib目录中的类库,或通过-Xbootclasspath参数指定路径中被虚拟机认可的类库。 (2)扩展类加载器:负责加载JAVA_HOME/lib/ext目录中的类库,或通过java.ext.dirs系统变量加载指定路径中的类库。 (3)应用程序类加载器:负责加载用户路径(classpath)上的类库。 除了上述3种类加载器,我们也可以通过继承java.lang.ClassLoader实现自定义的类加载器。 6.3 双亲委派机制 JVM通过双亲委派机制对类进行加载。双亲委派机制指一个类在收到类加载请求后不会尝试自己加载这个类,而是把该类加载请求向上委派给其父类去完成,其父类在接收到该类加载请求后又会将其委派给自己的父类,以此类推,这样所有的类加载请求都被向上委派到启动类加载器中。若父类加载器在接收到类加载请求后发现自己也无法加载该类(通常原因是该类的Class文件在父类的类加载路径中不存在),则父类会将该信息反馈给子类并向下委派子类加载器加载该类,直到该类被成功加载,若找不到该类,则JVM会抛出ClassNotFoud异常。双亲委派类加载机制的类加载流程如下。 (1)将自定义加载器挂载到应用程序类加载器。 (2)应用程序类加载器将类加载请求委托给扩展类加载器。 (3)扩展类加载器将类加载请求委托给启动类加载器。 (4)启动类加载器在加载路径下查找并加载Class文件,如果未找到目标Class文件,则交由扩展类加载器加载。 (5)扩展类加载器在加载路径下查找并加载Class文件,如果未找到目标Class文件,则交由应用程序类加载器加载。 (6)应用程序类加载器在加载路径下查找并加载Class文件,如果未找到目标Class文件,则交由自定义加载器加载。 (7)在自定义加载器下查找并加载用户指定目录下的Class文件,如果在自定义加载路径下未找到目标Class文件,则抛出ClassNotFoud异常。双亲委派机制的核心是保障类的唯一性和安全性。例如在加载rt.jar包中的java.lang.Object类时,无论是哪个类加载器加载这个类,最终都将类加载请求委托给启动类加载器加载,这样就保证了类加载的唯一性。如果在JVM中存在包名和类名相同的两个类,则该类将无法被加载,JVM也无法完成类加载流程。

优秀的个人博客,低调大师

知识卡片 回归性能度量 Log Loss

对数损失 Log Loss 又称交叉熵损失 cross-entropy loss,两者名称不同,其实是等价的 ,常用于评价逻辑回归和神经网络。 什么是逻辑回归 Logistics Regression? 与线性回归估计出Y的是一个连续型的计量数值不同,逻辑回归其实是一个分类方法。在二元逻辑回归中应变量Y是0和1,Y属于分类数据,估计结果是一个概率,自变量是可以包含多个对因变量有影响的因素,可以是连续也可是分类数据;通过逻辑回归,得出每个自变量的权重以及一个事件发生的概率。 二类分类问题的Log Loss: 注:pr 是按照回归模型得出的概率 举例说明: 假设有四个测试样本,y_true 列表是样本的真实值,y_pred 列表中有四个元素,每个样本元素有两个数值,分别表示不同类标签(0和1)的预测概率,其和为1。y_pred中的第一样本的两个元素[.9, .1] 表示样本1有90%的概率属于标签y=0, 10%的概率属于标签y=1;依次计算每个样本的逻辑损失,以e为底数算对数值,样本求平均得出Log Loss。 多类分类的交叉熵(cross-entropy loss)损失: 交叉熵公式中,N为测试样本总数,Yi,k 表示第 i 个样本中的第 k 个标签的真实值。pi,k 表示预测值。 举例说明: 好文章,我在看❤ 本文分享自微信公众号 - DataScience(DataScienceTeam)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

知识卡片 循环神经网络 RNN

前言:本文简要介绍了循环神经网络RNN以及其变体长短时记忆LSTM和双向循环网络。 循环神经网络 RNN-RecurrentNeural Network 序列数据 RNN建模的适合于序列数据,例如根据股票价格随时间的走势预测未来;视频中的每一帧属于帧序列,可以预测下一帧的内容,进行动作补偿。 自然语言处理中,如大话西游的台词,这里的括号填什么呢?不可能填写我没有去北京,上海,因为需要上下文的词序列来进行预判,输入法打字也是同样的原理;此外,在机器翻译中,将源语言和目标语言中,也存在着上下文衔接的词序列,因而RNN也可以被用在机器翻译中。 什么是循环神经网络? 传统的神经网络模型,层与层之间是全连接,但是隐藏层内的节点没有连接。序列信息中,节点存在被前一刻记忆的影响,隐藏层中的节点接收上一个节点的信息。RNN被称为循环神经网络是其对一组序列的输入进行循环,重复同样的操作。 RNN序列处理 RNN处理序列的类型根据输入和输出的数量,有四种类型。绿色是输入,蓝色是输出,灰色是隐藏层,可捕捉序列前后的信息;并不是每一步都需要输入或者输出,但是隐藏层是不可少的。 同步序列中,Many to many 多对多,输入和输出的数量相同,可用在词性标注,输入一个句子,输出句中每个词的词性;Many to one 多对一,文本的情感分析,输入一句话,输出这句话表达的情绪是积极还是消极。 非同步序列中,Many to many 多对多,可被用作机器翻译,即输入一种语言的文字,输出另外一种语言的文字;One to many,一对多,输入一张图片,输出对于图片内容的描述。 最基本的RNN结构 从左往右看,中间的圆圈是隐藏单元为S,x和O是输入和输出,通过折叠S神经单元,旁边加上一个顺时针的箭头,可以简化表示为S循环。 基本RNN的计算过程 以第二个神经元单元为例,xt 是向量,表示t时刻的输入,St是t时刻的记忆单元,St = f(U*xt + W*St-1),f是非线性的激活函数 tanh 双曲线正切函数,作用是将输入的数据规范化,取值在[-1,1],U和W是矩阵,对应 t时和 t-1时(左边单元)的权重参数,Ot是t时的输出,用softmax 函数归一化指数函数对矩阵V和向量st压缩并输出结果。 Softmax函数是逻辑函数Sigmoid的任意推广,将含有任意实数的k维的向量压缩至另外一个k维向量中,使得向量中的每个元素的范围都在[0,1],并且所有元素的和为1,满足概率的性质。 RNN的参数共享 RNN神经网络图中,每一条边都代表一个参数,不同于传统的神经网络,RNN在计算中共享U、V、W参数,即输出值Ot-1,Ot,Ot+1所用的U、V、W参数,这也是循环神经网络的特点,减少了需要学习的参数的数量,并提高了对数据进行训练的效率。 长短时记忆网络 LSTM-LongShort-TermMemory LSTM是RNN的一种变体,可以有效应对长期依赖的问题。 标准RNN难以应对长期依赖 在文本预测中,空歌词距离先关信息“clouds”的间隔不长,可以填上“sky”。 预测文本中,我出生在法国,我说“”,可填“法语”,但在文本中因为上下文的距离较长,上文对下文的影响消失或削弱,导致RNN不能预测远处的内容。 LSTM 的基本思路 标准的RNN其隐藏层只有一个h,可以对短期的内容保持敏感,难以捕捉长期的上下文;LSTM在隐藏层的基础上增加一个长时状态c, 也叫 cell state 单元或细胞状态用于保存长期状态,无论是c还是h都是一个向量。 Ct 是当前输入对应的长期状态,由上一时刻的长期状态Ct-1和当前时刻的即时状态C't组成。然而,不能将所有的上一时刻的长期状态都保留,需要选择性的接收,使用一个忘记门,有选择地忘记一些长期信息。 此外,当前时刻的长期状态还需要更新,因此通过输入门输入当前时刻的即时状态来更新。最后还有一个输出门,来控制如何使用当前时刻的长期状态来更新当前时刻的隐藏状态ht,此时ht中保存了一些长期的信息并和标准的RNN兼容;输出Ot时,还是使用当前时刻的ht来计算。 神经网络中的门 输入和输出都是尺寸相同的矩阵,对于其中的每个元素进行逐点操作。 LSTM 的整体框架图 LSTM的难点是如何计算Ct,红色的水平线表示了长期信息的计算。 LSTM的计算过程 σ是sigmoid函数,对应[0,1],选择忘记还是记忆;语言模型中,Germany是距离远的长期信息,尝试忘记。 语言模型中,应将当前词 France,更新到Ct中。 得到输出的结果ht,经过复制后去往上方和下方,上方为通过后续的softmax函数计算,输出结果Ot;下方的ht可以被送入下一个单元进行计算。 LSTM的变体-1 变体将Ct-1放入了ft,it和Ot中,使得门层接收长期状态的输入。 LSTM的变体-2 将遗忘的记忆(1-ft)和新记忆C't进行耦合,将只有新元素来填充的元素遗忘。 LSTM的变体-3 简单的理解,GRU通过重置门R和更新门U,将隐藏状态(ht-1 上一个时刻的ht)与长期状态~ht进行混合得到新的隐藏状态ht。 双向循环神经网络和注意力机制 Bidirectional RNNandAttentionMechanism 双向RNN(Bidirectional RNNs) 在文本中,一个词的预测不仅与上文有关,也与下文有关,因此采用双向的RNN来进行预测更为准确,图中Wt由正反向的两个向量拼接组成拼接向量concatenated vector,再经过softmax函数进行归一化,输出结果。 深层双向RNN(Deep Bidirectional RNNs) 深层双向RNN与RNN类似,增加了更多的隐藏层,具有更强大的学习和表达能力,同时也需要更多的数据来进行训练。 注意力模型(Attention model) 注意力机制的简单描述,人类会将注意力集中在有特点的位置,下次遇到类似的场景会注意相同特点的位置。 注意力模型基本原理 上图左边部分以文本分类为例,输入用W表示为一个语句连续的若干个词。总体上来看,采用的是双向RNN,不同点在于对每个词都加入一个权重α,在获取语义编码C的时候,不同的词的权重不同。αt的取值由Uw决定,可以看做哪一个词是关键词的抽象表示。在训练过程中随机初始化,逐渐更新。 具体的更新形式,参考上图右边的公式: (1)将拼接层的隐藏节点通过双曲拼接层的变化得到θt (2)将θt与uw点乘,得到归一化的αt,即不同词的注意力概率分布。 (3)αt和ht点乘求和,得到带注意分布的语义编码。 带有注意力机制的文本分词的好处是可以直观地看到每个词对分类的重要性。 案例推荐: https://blog.csdn.net/qq_33431368/article/details/85288590 此文讲解RNN和LSTM的原理,可阅读加深对其理解,并用LSTM模型进行实战训练PTB(Penn Treebank Dataset)宾州数据数据集。 好文章,我在看❤ 本文分享自微信公众号 - DataScience(DataScienceTeam)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

javaIO总结,最全面的IO知识

一、概览 二、磁盘操作 三、字节操作 实现文件复制 装饰者模式 四、字符操作 编码与解码 String 的编码方式 Reader 与 Writer 实现逐行输出文本文件的内容 五、对象操作 序列化 Serializable transient 六、网络操作 InetAddress URL Sockets Datagram 七、NIO 流与块 通道与缓冲区 缓冲区状态变量 文件 NIO 实例 选择器 套接字 NIO 实例 内存映射文件 对比 八、参考资料 一、概览 Java 的 I/O 大概可以分成以下几类: 磁盘操作:File 字节操作:InputStream 和 OutputStream 字符操作:Reader 和 Writer 对象操作:Serializable 网络操作:Socket 新的输入/输出:NIO 二、磁盘操作 File 类可以用于表示文件和目录的信息,但是它不表示文件的内容。 递归地列出一个目录下所有文件: public static void listAllFiles(File dir) { if (dir == null || !dir.exists()) { return; } if (dir.isFile()) { System.out.println(dir.getName()); return; } for (File file : dir.listFiles()) { listAllFiles(file); } } 从 Java7 开始,可以使用 Paths 和 Files 代替 File。 三、字节操作 实现文件复制 public static void copyFile(String src, String dist) throws IOException { FileInputStream in = new FileInputStream(src); FileOutputStream out = new FileOutputStream(dist); byte[] buffer = new byte[20 * 1024]; int cnt; // read() 最多读取 buffer.length 个字节 // 返回的是实际读取的个数 // 返回 -1 的时候表示读到 eof,即文件尾 while ((cnt = in.read(buffer, 0, buffer.length)) != -1) { out.write(buffer, 0, cnt); } in.close(); out.close(); } 装饰者模式 Java I/O 使用了装饰者模式来实现。以 InputStream 为例, InputStream 是抽象组件; FileInputStream 是 InputStream 的子类,属于具体组件,提供了字节流的输入操作; FilterInputStream 属于抽象装饰者,装饰者用于装饰组件,为组件提供额外的功能。例如 BufferedInputStream 为 FileInputStream 提供缓存的功能。 实例化一个具有缓存功能的字节流对象时,只需要在 FileInputStream 对象上再套一层 BufferedInputStream 对象即可。 FileInputStream fileInputStream = new FileInputStream(filePath); BufferedInputStream bufferedInputStream = new BufferedInputStream(fileInputStream); DataInputStream 装饰者提供了对更多数据类型进行输入的操作,比如 int、double 等基本类型。 四、字符操作 编码与解码 编码就是把字符转换为字节,而解码是把字节重新组合成字符。 如果编码和解码过程使用不同的编码方式那么就出现了乱码。 GBK 编码中,中文字符占 2 个字节,英文字符占 1 个字节; UTF-8 编码中,中文字符占 3 个字节,英文字符占 1 个字节; UTF-16be 编码中,中文字符和英文字符都占 2 个字节。 UTF-16be 中的 be 指的是 Big Endian,也就是大端。相应地也有 UTF-16le,le 指的是 Little Endian,也就是小端。 Java 的内存编码使用双字节编码 UTF-16be,这不是指 Java 只支持这一种编码方式,而是说 char 这种类型使用 UTF-16be 进行编码。char 类型占 16 位,也就是两个字节,Java 使用这种双字节编码是为了让一个中文或者一个英文都能使用一个 char 来存储。 String 的编码方式 String 可以看成一个字符序列,可以指定一个编码方式将它编码为字节序列,也可以指定一个编码方式将一个字节序列解码为 String。 String str1 = "中文"; byte[] bytes = str1.getBytes("UTF-8"); String str2 = new String(bytes, "UTF-8"); System.out.println(str2); 在调用无参数 getBytes() 方法时,默认的编码方式不是 UTF-16be。双字节编码的好处是可以使用一个 char 存储中文和英文,而将 String 转为 bytes[] 字节数组就不再需要这个好处,因此也就不再需要双字节编码。getBytes() 的默认编码方式与平台有关,一般为 UTF-8。 byte[] bytes = str1.getBytes(); Reader 与 Writer 不管是磁盘还是网络传输,最小的存储单元都是字节,而不是字符。但是在程序中操作的通常是字符形式的数据,因此需要提供对字符进行操作的方法。 InputStreamReader 实现从字节流解码成字符流; OutputStreamWriter 实现字符流编码成为字节流。 实现逐行输出文本文件的内容 public static void readFileContent(String filePath) throws IOException { FileReader fileReader = new FileReader(filePath); BufferedReader bufferedReader = new BufferedReader(fileReader); String line; while ((line = bufferedReader.readLine()) != null) { System.out.println(line); } // 装饰者模式使得 BufferedReader 组合了一个 Reader 对象 // 在调用 BufferedReader 的 close() 方法时会去调用 Reader 的 close() 方法 // 因此只要一个 close() 调用即可 bufferedReader.close(); } 五、对象操作 序列化 序列化就是将一个对象转换成字节序列,方便存储和传输。 序列化:ObjectOutputStream.writeObject() 反序列化:ObjectInputStream.readObject() 不会对静态变量进行序列化,因为序列化只是保存对象的状态,静态变量属于类的状态。 Serializable 序列化的类需要实现 Serializable 接口,它只是一个标准,没有任何方法需要实现,但是如果不去实现它的话而进行序列化,会抛出异常。 public static void main(String[] args) throws IOException, ClassNotFoundException { A a1 = new A(123, "abc"); String objectFile = "file/a1"; ObjectOutputStream objectOutputStream = new ObjectOutputStream(new FileOutputStream(objectFile)); objectOutputStream.writeObject(a1); objectOutputStream.close(); ObjectInputStream objectInputStream = new ObjectInputStream(new FileInputStream(objectFile)); A a2 = (A) objectInputStream.readObject(); objectInputStream.close(); System.out.println(a2); } private static class A implements Serializable { private int x; private String y; A(int x, String y) { this.x = x; this.y = y; } @Override public String toString() { return "x = " + x + " " + "y = " + y; } } transient transient 关键字可以使一些属性不会被序列化。 ArrayList 中存储数据的数组 elementData 是用 transient 修饰的,因为这个数组是动态扩展的,并不是所有的空间都被使用,因此就不需要所有的内容都被序列化。通过重写序列化和反序列化方法,使得可以只序列化数组中有内容的那部分数据。 private transient Object[] elementData; 六、网络操作 Java 中的网络支持: InetAddress:用于表示网络上的硬件资源,即 IP 地址; URL:统一资源定位符; Sockets:使用 TCP 协议实现网络通信; Datagram:使用 UDP 协议实现网络通信。 InetAddress 没有公有的构造函数,只能通过静态方法来创建实例。 InetAddress.getByName(String host); InetAddress.getByAddress(byte[] address); URL 可以直接从 URL 中读取字节流数据。 public static void main(String[] args) throws IOException { URL url = new URL("http://www.baidu.com"); /* 字节流 */ InputStream is = url.openStream(); /* 字符流 */ InputStreamReader isr = new InputStreamReader(is, "utf-8"); /* 提供缓存功能 */ BufferedReader br = new BufferedReader(isr); String line; while ((line = br.readLine()) != null) { System.out.println(line); } br.close(); } Sockets ServerSocket:服务器端类 Socket:客户端类 服务器和客户端通过 InputStream 和 OutputStream 进行输入输出。 Datagram DatagramSocket:通信类 DatagramPacket:数据包类 七、NIO 新的输入/输出 (NIO) 库是在 JDK 1.4 中引入的,弥补了原来的 I/O 的不足,提供了高速的、面向块的 I/O。 流与块 I/O 与 NIO 最重要的区别是数据打包和传输的方式,I/O 以流的方式处理数据,而 NIO 以块的方式处理数据。 面向流的 I/O 一次处理一个字节数据:一个输入流产生一个字节数据,一个输出流消费一个字节数据。为流式数据创建过滤器非常容易,链接几个过滤器,以便每个过滤器只负责复杂处理机制的一部分。不利的一面是,面向流的 I/O 通常相当慢。 面向块的 I/O 一次处理一个数据块,按块处理数据比按流处理数据要快得多。但是面向块的 I/O 缺少一些面向流的 I/O 所具有的优雅性和简单性。 I/O 包和 NIO 已经很好地集成了,java.io.* 已经以 NIO 为基础重新实现了,所以现在它可以利用 NIO 的一些特性。例如,java.io.* 包中的一些类包含以块的形式读写数据的方法,这使得即使在面向流的系统中,处理速度也会更快。 通道与缓冲区 1. 通道 通道 Channel 是对原 I/O 包中的流的模拟,可以通过它读取和写入数据。 通道与流的不同之处在于,流只能在一个方向上移动(一个流必须是 InputStream 或者 OutputStream 的子类),而通道是双向的,可以用于读、写或者同时用于读写。 通道包括以下类型: FileChannel:从文件中读写数据; DatagramChannel:通过 UDP 读写网络中数据; SocketChannel:通过 TCP 读写网络中数据; ServerSocketChannel:可以监听新进来的 TCP 连接,对每一个新进来的连接都会创建一个 SocketChannel。 2. 缓冲区 发送给一个通道的所有数据都必须首先放到缓冲区中,同样地,从通道中读取的任何数据都要先读到缓冲区中。也就是说,不会直接对通道进行读写数据,而是要先经过缓冲区。 缓冲区实质上是一个数组,但它不仅仅是一个数组。缓冲区提供了对数据的结构化访问,而且还可以跟踪系统的读/写进程。 缓冲区包括以下类型: ByteBuffer CharBuffer ShortBuffer IntBuffer LongBuffer FloatBuffer DoubleBuffer 缓冲区状态变量 capacity:最大容量; position:当前已经读写的字节数; limit:还可以读写的字节数。 状态变量的改变过程举例: ① 新建一个大小为 8 个字节的缓冲区,此时 position 为 0,而 limit = capacity = 8。capacity 变量不会改变,下面的讨论会忽略它。 ② 从输入通道中读取 5 个字节数据写入缓冲区中,此时 position 为 5,limit 保持不变。 ③ 在将缓冲区的数据写到输出通道之前,需要先调用 flip() 方法,这个方法将 limit 设置为当前 position,并将 position 设置为 0。 ④ 从缓冲区中取 4 个字节到输出缓冲中,此时 position 设为 4。 ⑤ 最后需要调用 clear() 方法来清空缓冲区,此时 position 和 limit 都被设置为最初位置。 文件 NIO 实例 以下展示了使用 NIO 快速复制文件的实例: public static void fastCopy(String src, String dist) throws IOException { /* 获得源文件的输入字节流 */ FileInputStream fin = new FileInputStream(src); /* 获取输入字节流的文件通道 */ FileChannel fcin = fin.getChannel(); /* 获取目标文件的输出字节流 */ FileOutputStream fout = new FileOutputStream(dist); /* 获取输出字节流的文件通道 */ FileChannel fcout = fout.getChannel(); /* 为缓冲区分配 1024 个字节 */ ByteBuffer buffer = ByteBuffer.allocateDirect(1024); while (true) { /* 从输入通道中读取数据到缓冲区中 */ int r = fcin.read(buffer); /* read() 返回 -1 表示 EOF */ if (r == -1) { break; } /* 切换读写 */ buffer.flip(); /* 把缓冲区的内容写入输出文件中 */ fcout.write(buffer); /* 清空缓冲区 */ buffer.clear(); } } 选择器 NIO 常常被叫做非阻塞 IO,主要是因为 NIO 在网络通信中的非阻塞特性被广泛使用。 NIO 实现了 IO 多路复用中的 Reactor 模型,一个线程 Thread 使用一个选择器 Selector 通过轮询的方式去监听多个通道 Channel 上的事件,从而让一个线程就可以处理多个事件。 通过配置监听的通道 Channel 为非阻塞,那么当 Channel 上的 IO 事件还未到达时,就不会进入阻塞状态一直等待,而是继续轮询其它 Channel,找到 IO 事件已经到达的 Channel 执行。 因为创建和切换线程的开销很大,因此使用一个线程来处理多个事件而不是一个线程处理一个事件,对于 IO 密集型的应用具有很好地性能。 应该注意的是,只有套接字 Channel 才能配置为非阻塞,而 FileChannel 不能,为 FileChannel 配置非阻塞也没有意义。 1. 创建选择器 Selector selector = Selector.open(); 2. 将通道注册到选择器上 ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false); ssChannel.register(selector, SelectionKey.OP_ACCEPT); 通道必须配置为非阻塞模式,否则使用选择器就没有任何意义了,因为如果通道在某个事件上被阻塞,那么服务器就不能响应其它事件,必须等待这个事件处理完毕才能去处理其它事件,显然这和选择器的作用背道而驰。 在将通道注册到选择器上时,还需要指定要注册的具体事件,主要有以下几类: SelectionKey.OP_CONNECT SelectionKey.OP_ACCEPT SelectionKey.OP_READ SelectionKey.OP_WRITE 它们在 SelectionKey 的定义如下: public static final int OP_READ = 1 << 0; public static final int OP_WRITE = 1 << 2; public static final int OP_CONNECT = 1 << 3; public static final int OP_ACCEPT = 1 << 4; 可以看出每个事件可以被当成一个位域,从而组成事件集整数。例如: int interestSet = SelectionKey.OP_READ | SelectionKey.OP_WRITE; 3. 监听事件 int num = selector.select(); 使用 select() 来监听到达的事件,它会一直阻塞直到有至少一个事件到达。 4. 获取到达的事件 Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } 5. 事件循环 因为一次 select() 调用不能处理完所有的事件,并且服务器端有可能需要一直监听事件,因此服务器端处理事件的代码一般会放在一个死循环内。 while (true) { int num = selector.select(); Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } } 套接字 NIO 实例 public class NIOServer { public static void main(String[] args) throws IOException { Selector selector = Selector.open(); ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false); ssChannel.register(selector, SelectionKey.OP_ACCEPT); ServerSocket serverSocket = ssChannel.socket(); InetSocketAddress address = new InetSocketAddress("127.0.0.1", 8888); serverSocket.bind(address); while (true) { selector.select(); Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { ServerSocketChannel ssChannel1 = (ServerSocketChannel) key.channel(); // 服务器会为每个新连接创建一个 SocketChannel SocketChannel sChannel = ssChannel1.accept(); sChannel.configureBlocking(false); // 这个新连接主要用于从客户端读取数据 sChannel.register(selector, SelectionKey.OP_READ); } else if (key.isReadable()) { SocketChannel sChannel = (SocketChannel) key.channel(); System.out.println(readDataFromSocketChannel(sChannel)); sChannel.close(); } keyIterator.remove(); } } } private static String readDataFromSocketChannel(SocketChannel sChannel) throws IOException { ByteBuffer buffer = ByteBuffer.allocate(1024); StringBuilder data = new StringBuilder(); while (true) { buffer.clear(); int n = sChannel.read(buffer); if (n == -1) { break; } buffer.flip(); int limit = buffer.limit(); char[] dst = new char[limit]; for (int i = 0; i < limit; i++) { dst[i] = (char) buffer.get(i); } data.append(dst); buffer.clear(); } return data.toString(); } } public class NIOClient { public static void main(String[] args) throws IOException { Socket socket = new Socket("127.0.0.1", 8888); OutputStream out = socket.getOutputStream(); String s = "hello world"; out.write(s.getBytes()); out.close(); } } 内存映射文件 内存映射文件 I/O 是一种读和写文件数据的方法,它可以比常规的基于流或者基于通道的 I/O 快得多。 向内存映射文件写入可能是危险的,只是改变数组的单个元素这样的简单操作,就可能会直接修改磁盘上的文件。修改数据与将数据保存到磁盘是没有分开的。 下面代码行将文件的前 1024 个字节映射到内存中,map() 方法返回一个 MappedByteBuffer,它是 ByteBuffer 的子类。因此,可以像使用其他任何 ByteBuffer 一样使用新映射的缓冲区,操作系统会在需要时负责执行映射。 MappedByteBuffer mbb = fc.map(FileChannel.MapMode.READ_WRITE, 0, 1024); 对比 NIO 与普通 I/O 的区别主要有以下两点: NIO 是非阻塞的; NIO 面向块,I/O 面向流。 八、参考资料 Eckel B, 埃克尔, 昊鹏, 等. Java 编程思想 [M]. 机械工业出版社, 2002. IBM: NIO 入门 Java NIO Tutorial Java NIO 浅析 IBM: 深入分析 Java I/O 的工作机制 IBM: 深入分析 Java 中的中文编码问题 IBM: Java 序列化的高级认识 NIO 与传统 IO 的区别 Decorator Design Pattern Socket Multicast 本文同步分享在 博客“码上代码”(CSDN)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

最近学到的前后端分离知识

前言 只有光头才能变强。 文本已收录至我的GitHub仓库,欢迎Star:https://github.com/ZhongFuCheng3y/3y 前后端分离这个词相信大家都听过,不知道大家是怎么理解的呢。前阵子看项目的时候,有一段实现硬是没看懂,下面来给大家说一下一段愚蠢的经历哈。 (我没正正式式写过前端,所以如果文章有错的地方希望可以在评论区友善交流~) 一、交代背景 我一直都知道我现在的这个系统是前后端分离的,我的接口只会返回JSON出去,但我不曾关心前端是怎么处理我的JSON数据的(以及他是怎么跑通和运行的) 在某一天,我在查接口的时候,习惯F12,想直接看一下这个请求返回的JSON数据是什么。但是一看,在network返回的是html格式: 于是,我就很好奇啊,就看一下这个接口是不是我想象中的那个。于是就去找我的接口,看一下是不是真的返回JSON(我还专门Debug了一下,看看是不是真请求到这个接口上了): 得出的结果是:我的接口的确是返回JSON数据,浏览器的reponse返回的的确是HTML格式。 于是,我就去找我前端的小伙伴,去问了一下这是怎么搞的。他回复我说:“在浏览器看到返回的是页面,那肯定是你们后端干的呀” 我说:“没有啊,我Java接口返回的是JSON数据啊,是不是中途你们用node做了些处理啊?”(我之前听过Node.js,但仅仅是听过) 他说:“Node.js也是你们后端的啊。” 我一听,啊?Node.js不是属于前端的吗? 二、初识Node.js 在遇到这个事情之前,其实我在知乎已经看了一个帖子,话题名是这个《毕设答辩,老师说node不可能写后台怎么办?》 有兴趣的小伙伴可以去了解一下,大多数内容还是挺通俗易懂的: https://www.zhihu.com/question/327657434/answer/704249816 我在下载Node.js的时候,发现其简介十分简洁: Node.js® is a JavaScript runtime built on Chrome's V8 JavaScript engine. Node.js® 是一个基于 Chrome V8 引擎 的 JavaScript 运行时。 然后点进去Chrome V8引擎,再看了一下介绍: V8 is Google’s open source high-performance JavaScript and WebAssembly engine, written in C++. It is used in Chrome and in Node.js, among others. V8是Google的开源高性能JavaScript和WebAssembly引擎,用C ++编写。它用于Chrome和Node.js等。 看了介绍,一脸懵逼,这是啥玩意啊。下面我来解释一下 2.1 V8引擎是什么? 众所周知,JavaScript是解析型语言,我们写好的JavaScript代码会由JavaScript引擎去解析,而V8是JavaScript引擎的一种。 在传统意义上,我们会认为解析器是逐条解析(一边执行一边解析),但为了提高JavaScript的解析速度(相当于提高用户体验),在解析的时候做了点“手脚”。 V8引擎:为了提高解析的性能,引入了一些“后端”的技术(不过他本来就由C++编写的)。它是先将JavaScript源代码转成抽象语法树,然后再将抽象语法树生成字节码。如果发现某个函数被多次调用或者是多次调用的循环体(热点代码),那就会将这部分的代码编译优化。说白了就是:对热点代码做编译,非热点代码直接解析。 总结:V8引擎是JavaScript引擎的一种,这个引擎由C++来编写的,性能很不错。 参考资料: https://zhuanlan.zhihu.com/p/27628685 https://zhuanlan.zhihu.com/p/73768338 2.2回到Node.js 浏览器为了安全,没有为JavaScript提供一套IO环境,而一门后端语言是肯定能进行网络通信、文件读写(IO)的。 后来,有牛逼的人把V8引擎搬到了服务端上,在V8引擎的基础上加了网络通信、IO、HTTP等服务端的函数。取了一个名字叫:Node.js 比如通过libuv库来进行文件读取,以及建立TCP/UDP连接。通过xxx库解析HTTP请求和响应....这些库都是由C/C++来编写的。 所以,Node.js是运行在服务端的,只不过在基础语言是JavaScript。 三、前后端分离入门 回顾一下自己学JavaWeb的历程: 刚学Servlet的时候,会在response对象上写一些HTML代码输出到浏览器看效果 后来,学习到JSP了,就纯粹用Servlet做控制,JSP做视图。 JSP本质上还是一个Servlet,只不过看起来像HTML文件,在编译的时候还是会变成一个HttpJspPage类(该类是HttpServlet的一个子类) 再后来,学到了AJAX技术,发现我们完全可以通过AJAX来进行交互。AJAX请求Servlet,Servlet返回JSON数据回去,AJAX拿到Servlet返回的数据进行解析和处理。这里压根就不需要JSP了(纯HTML+AJAX),这算是前后端分离的一种了 在开发上体验:如果完全使用HTML+AJAX的话,会发现其实需要写非常非常多的JavaScript代码,而且这些JavaScript代码都不好复用。 在部署上,还是跟Java一起部署(放在resource下),没有将前端单独部署。 再后来,学到了一些在常用的模板引擎(比如freemarker),其实用起来跟JSP没多大的区别,只不过性能要比JSP好不少。 ...流下不学无术的泪水 目前我了解到的前后端分离,首先部署是分离的(至少不会跟Java绑定在一起部署): Java接口只返回JSON数据: 关于前端这几大框架:angular/vue/react这几个我都是没有写过的,所以也就不多BB了。我一直想知道的是:前框框架和node是啥关系。问了一下前端的小伙伴,他回复是大致这样的: 前端现在是讲究工程化的,工程化用到了node而已(就是打包编译那些会用到,项目里面真正跑起来的话是没有这些东西的) -----------以下引用摘录: Webpack、Less、Sass、Gulp、Bower以及这些工具的插件都是Node上开发的---@知乎陈龙 举个例子:随着发展,前端的JavaScript需要依赖的包也非常复杂,类比于Java我们会有Maven,而前端现在有npm (包管理) 而npm是随同Node.js一起安装的。所以前端(vue/angular/react)在开发环境下都是离不开Node.js的(编译、打包等等) 参考资料(为什么要使用 npm): https://zhuanlan.zhihu.com/p/24357770 3.1 方式一(Nginx+Server) OK,现在假设我们用前端(vue/angular/react)开发完,开发环境下将JavaScript编译/打包完,那我们能得到纯静态的文件。我们可以直接将纯静态文件放到Nginx(CDN)等等地方【只要能够响应HTTP请求就行】。 如果请求是调用后端服务,则经过Nginx转发到后端服务器,完成响应后经Nginx返回到浏览器。 3.2 方式二(加入Node.js) 在前边的基础上加入Node.js,至于为啥要Node.js,一个重要的原因就是:加快首屏渲染速度,解决SEO问题 加入Node.js,此时的请求流程应该是这样的: 浏览器发起的请求经过前端机的Nginx进行分发. URL请求统一分发到Node Server,在Node Server中根据请求类型从后端服务器上通过RPC服务请求页面的模板数据,然后进行页面的组装和渲染; API请求则直接转发到后端服务器,完成响应。 最后 好的,现在问题来了:你是觉得Node.js归属在后端还是前端? 看得不过瘾?推荐一下我认为不错的文章和资料: https://segmentfault.com/a/1190000009329474 https://www.zhihu.com/question/267014376 https://cnodejs.org/topic/565ebb193cda7a91276ff887 https://github.com/yalishizhude/front-back-separation 乐于输出干货的Java技术公众号:Java3y。公众号内有200多篇原创技术文章、海量视频资源、精美脑图,关注即可获取! 觉得我的文章写得不错,点赞!

优秀的个人博客,低调大师

Redis专题(1):构建知识图谱

场景:Redis面试 (图片来源于网络) 面试官: 我看到你的简历上说你熟练使用Redis,那么你讲一下Redis是干嘛用的? 小明: (心中窃喜,Redis不就是缓存吗?)Redis主要用作缓存,通过内存高效地存储非持久化数据。 面试官: Redis可以用作持久化的存储吗? 小明 :嗯...应该可以吧... 面试官: 那Redis怎么进行持久化操作呢? 小明:嗯...不是太清楚。 面试官: Redis的内存淘汰机制有哪些? 小明:嗯...没了解过 面试官:我们还可以用Redis做哪些事情?分别利用了Redis的哪个指令? 小明:我只知道Redis还可以做分布式锁、消息队列... 面试官:好了,我们进入下一个话题... 思考:很明显,小明同学在面试过程中关于Redis的表现和回答肯定是比较失败的。Redis是我们工作中每天都会使用到的东西,为什么一到面试却

优秀的个人博客,低调大师

Python知识点:lambda, map, filter

通过示例介绍Python中的lambda,map,filter 函数的使用方法。 lambdalambda 操作符(或 lambda函数)通常用来创建小巧的,一次性的匿名函数对象。它的基本语法如下: lambda arguments : expression lambda操作符可以有任意数量的参数,但是它只能有一个表达式,且不能包含任何语句,返回一个可以赋值给任何变量的函数对象。 下面通过一个例子来理解一下。首先看看一个Python函数: def add(x, y): return x+y # call the function add(1, 2) # Output: 3 上述函数名为add, 它需要两个参数x和y,并返回它们的和。接下来,我们把上面的函数变成一个lambda函数: add = lambda x, y : x + y print(add(1,2)) # Output: 3 在lambda x, y : x + y中,x和y是函数的参数,x+y是表达式,它被执行并返回结果。 lambda x, y : x + y返回的是一个函数对象,它可以被赋值给任何变量。在本例中函数对象被赋值给了add变量。如果我们查看add的type,可以看到它是一个function type(add) # Output: function 绝大多数lambda函数作为一个参数传给一个需要函数对象为参数的函数,比如map,reduce,filter等函数。 **mapmap的基本语法如下:** map(function_object, iterable1, iterable2, ...) map函数需要一个函数对象和任意数量的iterables,如list,dictionary等。它为序列中的每个元素执行function_object,并返回由函数对象修改的元素组成的列表。示例如下: def add2(x): return x+2 map(add2, [1,2,3,4]) # Output: [3,4,5,6] 在上面的例子中,map对list中的每个元素1,2,3,4执行add2函数并返回[3,4,5,6]接着看看如何用map和lambda重写上面的代码: map(lambda x: x+2, [1,2,3,4]) #Output: [3,4,5,6] 仅仅一行即可搞定! 使用map和lambda迭代dictionary: dict_a = [{'name': 'python', 'points': 10}, {'name': 'java', 'points': 8}] map(lambda x : x['name'], dict_a) # Output: ['python', 'java'] map(lambda x : x['points']*10, dict_a) # Output: [100, 80] map(lambda x : x['name'] == "python", dict_a) # Output: [True, False] 以上代码中,dict_a中的每个dict作为参数传递给lambda函数。lambda函数表达式作用于每个dict的结果作为输出。 map函数作用于多个iterables list_a = [1, 2, 3] list_b = [10, 20, 30] map(lambda x, y: x + y, list_a, list_b) # Output: [11, 22, 33] 这里,list_a和list_b的第i个元素作为参数传递给lambda函数。 在Python3中,map函数返回一个惰性计算(lazily evaluated)的迭代器(iterator)或map对象。就像zip函数是惰性计算那样。我们不能通过index访问map对象的元素,也不能使用len()得到它的长度。但我们可以强制转换map对象为list: map_output = map(lambda x: x*2, [1, 2, 3, 4]) print(map_output) # Output: map object: list_map_output = list(map_output) print(list_map_output) # Output: [2, 4, 6, 8] filterfilter的基本语法如下: filter(function_object, iterable)filter函数需要两个参数,function_object返回一个布尔值(boolean),对iterable的每一个元素调用function_object,filter只返回满足function_object为True的元素。 和map函数一样,filter函数也返回一个list,但与map函数不同的是,filter函数只能有一个iterable作为输入。示例:返回偶数: a = [1, 2, 3, 4, 5, 6] filter(lambda x : x % 2 == 0, a) # Output: [2, 4, 6] 过滤dicts的list: dict_a = [{'name': 'python', 'points': 10}, {'name': 'java', 'points': 8}] filter(lambda x : x['name'] == 'python', dict_a) # Output: [{'name': 'python', 'points': 10}] 和map一样,filter函数在Python3中返回一个惰性计算的filter对象或迭代器。我们不能通过index访问filter对象的元素,也不能使用len()得到它的长度。 list_a = [1, 2, 3, 4, 5] filter_obj = filter(lambda x: x % 2 == 0, list_a) # filter object even_num = list(filter_obj) # Converts the filer obj to a list print(even_num) # Output: [2, 4] 有关Python技术文章优先发布在我的个人博客:猿人学公众号:猿人学Pyhton

优秀的个人博客,低调大师

Python高级知识点学习(九)

并发、并行,同步、异步,阻塞、非阻塞 并发、并行 并发是在一个时间段内,有几个程序在同一个cpu上运行,但是任意时刻只有一个程序在cpu上运行。 并行是任意时刻点上,有多个程序同时运行在多个cpu上。 同步、异步 同步是指代码调用IO操作时,必须等待IO操作完成才返回的调用方式。 异步是指代码调用IO操作时,不必等待IO操作完成就返回的调用方式。 阻塞、非阻塞 阻塞是指调用函数时候当前线程被挂起。 非阻塞是指调用函数时候当前线程不会被挂起,而是立即返回。 阻塞和非阻塞的概念和同步异步感觉很像,但是其实它们之间是有区别的。 区别: 同步和异步实际上是消息通信的一种机制,可以把IO操作看做一个消息,调用IO操作时,相当于发一个消息给另外一个线程(或者说另外一个协程),让它去执行某些操作,在提交数据之后立刻得到future,后边就可以通过future拿到结果,实际上是消息之间的通信机制。 阻塞和非阻塞是不同于同步异步的,它是函数调的一种机制。 IO 多路复用 (select、poll 和 epoll) unix中五种I/O模型 阻塞式I/O 非阻塞式I/O I/O复用 信号驱动式I/O (用的比较少) 异步I/O (POSIX的aio_系列函数) 以上五种是递进式的发展。 I/O多路复用: select方法也是阻塞的方法,select本身是阻塞式的,select可以监听多个文件句柄和socket,select在某一个文件句柄或者socket准备好的话就会返回,这时候立刻可以做业务逻辑处理。 I/O多路复用带来的好处是: 比如现在同时发起了100个非阻塞式的请求,这时候直接使用select去监听这100个socket,这样的话一旦有一个发生状态变化,我们就可以立马处理它。 I/O多路复用中,将数据从内核复制到用户空间这段时间消耗还是省不了。 异步IO: 这里的异步IO是真正意义上的异步IO(aio),我们现在接触到很多高并发框架实际上都没有使用异步IO,实际上在很大程度上使用的都是io多路复用技术,IO多路复用很成熟很稳定,异步IO对于IO多路复用性能提升并没有达到很明显的程度,但是编码难度有很大提升,所以当前情况下IO多路复用用的比较多。 异步IO节省掉了数据从内核拷贝到用户空间这一步骤。 select、poll、epoll: select、poll、epoll都是I/O多路复用的机制。 I/O多路复用就是通过一种机制,一个进程可以监视多个描述符,一旦某个描述符就绪(一般就是读就绪或写就绪),能够通知程序进行相应的读写操作。 但select、poll、epoll本质上都是同步I/O,因为它们都需要在读写事件就绪后自己负责进行读写(数据从内核拷贝到用户区),也就是说这个读写过程是阻塞的,而异步I/O则无需自己负责进行读写,异步I/O的实现会负责把数据从内核拷贝到用户空间。 select是什么? select 函数监视的文件描述符分三类,分别是writefds、readfds、exceptfds。调用select后会阻塞,直到有描述符就绪(有数据可读、可写、或者有except),或者超时(timeout指定等待时间,如果立即返回设为null即可),函数返回。当select函数返回后,可以通过遍历fdset来找到就绪的描述符。 select目前几乎在所有的平台上支持,其良好的跨平台也是它的一个优点。select的一个缺点在于单个进程监视的文件描述符的数量有最大限制,在linux上一般为1024,可以通过修改宏定义甚至重新编译内核的方式提升这一性质,但是这样也会造成效率的降低。 poll是什么? 不同于select使用三个位图来表示三个fdset的方式,poll使用一个pollfd的指针实现。pollfd结构包含了要监视的event和发生的event,不再使用select "参数-值" 传递的方式。同时,pollfd并没有最大数量限制(但是数量过大性能也会下降)。和select函数一样,poll返回后,需要轮询pollfd来获取就绪的描述符。 从上面看,select和poll都需要在返回后,通过遍历文件描述符来获取已经就绪的socket。事实上,同时连接的大量客户端在一时刻可能只有很少的处于就绪的状态,因此随着监视的描述符数量的增长,其效率也会线性下降。 epoll是什么? epoll是在2.6内核中提出的,epoll是之前的select和poll的增强版本。相对于select和poll来讲,epoll更加灵活,没有描述符限制。epoll使用一个文件描述符管理多个描述符,将用户关系的文件描述符的事件存放到内核的一个事件表中,这样在用户空间和内核空间的copy只需要一次。 epoll它的查询使用了数据结构中性能很高的一个:红黑树。 nginx就是使用了epoll。 epoll并不代表一定比select好: 在并发高的情况下,连接活跃度不是很高, epoll比select。 并发性不高,同时连接很活跃, select比epoll好。 非阻塞I/O实现http请求 上示例代码: import socket from urllib.parse import urlparse def get_url(url): # 通过socket请求html url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 这里会导致后边抛异常,但是连接请求已经发出去了 client.setblocking(False) # 捕获异常 try: client.connect((host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass # 不停的询问连接是否建立好, 需要while循环不停的去检查状态 # 做计算任务或者再次发起其他的连接请求 while True: try: client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) break except OSError as e: pass data = b"" while True: # 这里还会抛异常,读不到就继续读 try: d = client.recv(1024) except BlockingIOError as e: continue if d: data += d else: break data = data.decode("utf8") html_data = data.split("\r\n\r\n")[1] #打印返回的数据 print(html_data) client.close() if __name__ == "__main__": get_url("http://www.baidu.com") 非阻塞I/O整个过程依赖前后的监测,整个过程不停的做while循环检测状态,但是返回时间没有变,所以并没有提高并发。 select+回调+事件循环实现http请求 目前开源的高性能框架,一般都是使用这种方式实现并发。 使用select + 回调 + 事件循环实现下载网页,并发性高且是单线程。 select方法本尊是在import select这个包里边,但是有另外一个包把select基础上进行了封装,用起来更简单:from selectors import DefaultSelector,DefaultSelector一般使用DefaultSelector这个比较多。 看代码示例: import socket import time from urllib.parse import urlparse from selectors import DefaultSelector, EVENT_READ, EVENT_WRITE selector = DefaultSelector() urls = [] stop = False class Fetcher: def connected(self, key): selector.unregister(key.fd) self.client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(self.path, self.host).encode("utf8") selector.register(self.client.fileno(), EVENT_READ, self.readable) # 当socket可读时,读数据,全部都是cpu操作 def readable(self, key): d = self.client.recv(1024) if d: self.data += d else: # 数据读完为空 selector.unregister(key.fd) data = self.data.decode("utf8") html_data = data.split("\r\n\r\n")[1] print(html_data[:30]) self.client.close() urls.remove(self.spider_url) if not urls: global stop stop = True def get_url(self, url): self.spider_url = url url = urlparse(url) self.host = url.netloc self.path = url.path self.data = b"" if self.path == "": self.path = "/" # 建立 socket 连接 self.client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) self.client.setblocking(False) try: self.client.connect((self.host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass selector.register(self.client.fileno(), EVENT_WRITE, self.connected) # 驱动整个事件循环 def loop(): while not stop: ready = selector.select() for key, mask in ready: call_back = key.data call_back(key) if __name__ == "__main__": # 计时开始 start_time = time.time() for url in range(60): url = "http://www.baidu.com" urls.append(url) fetcher = Fetcher() fetcher.get_url(url) loop() print(time.time()-start_time) 上边代码中,Fetcher类包含三个方法,get_url简历socket连接,connected和readable是两个回调函数。 loop函数负责驱动整个事件循环。 回调的缺点 可读性差 共享状态异常处理 异常处理困难

优秀的个人博客,低调大师

Python高级知识点学习(八)

线程同步 - condition介绍 多线程中的另外一个重要点就是condition:条件变量。 condition是python多线程编程中用于复杂线程间通信的一个锁 叫做条件变量。 cond = threading.Condition() with self.cond: cond.notify() cond.wait() condition有两层锁, 一把底层锁会在线程调用了wait方法的时候释放, 上面的锁会在每次调用wait的时候分配一把并放入到cond的等待队列中,等到notify方法的唤醒。 有关condition的详情请查阅资料。(这里作者自己暂时还没理清楚原理,见谅) 线程同步 - Semaphore 介绍 信号量,Semaphore。 Semaphore 是用于控制进入数量的锁,控制进入某段代码的线程数。 文件, 读、写, 写一般只是用于一个线程写,读可以允许有多个。 ThreadPoolExecutor线程池 多线程和多进程对比 运算,耗cpu的操作,用多进程编程 对于io操作来说, 使用多线程编程 由于进程切换代价要高于线程,所以能使用线程就不用进程。 耗费cpu的操作: def fib(n): if n<=2: return 1 return fib(n-1)+fib(n-2) if __name__ == "__main__": with ThreadPoolExecutor(3) as executor: all_task = [executor.submit(fib, (num)) for num in range(1, 10)] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) 模拟IO操作: def random_sleep(n): time.sleep(n) return n if __name__ == "__main__": with ProcessPoolExecutor(3) as executor: all_task = [executor.submit(random_sleep, (num)) for num in [2]*30] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) multiprocessing 多进程 使用os.fork创建子进程,fork只能用于linux/unix中。 import os import time # fork新建子进程 fork只能用于linux/unix中 pid = os.fork() print("a") if pid == 0: print('子进程id:{} ,父进程id是: {}.' .format(os.getpid(), os.getppid())) else: print('我是父进程, 我fork出的子进程id是:{}.'.format(pid)) time.sleep(2) 运行结果: a 我是父进程, 我fork出的子进程id是:3093. a 子进程id:3093 ,父进程id是: 3092. 运行结果中,可以看到打印了两次a,因为在执行完pid = os.fork()这行代码后,就创建了一个子进程,且子进程把父进程中的数据原样拷贝了一份到自己的进程中,所以父进程中打印一次,子进程中又打印一次。 多进程编程: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": progress = multiprocessing.Process(target=get_html, args=(2,)) print(progress.pid) progress.start() print(progress.pid) progress.join() print("main progress end") 使用进程池: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) result = pool.apply_async(get_html, args=(3,)) # 等待所有任务完成 pool.close() pool.join() print(result.get()) 进程池另一种方法: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) for result in pool.imap_unordered(get_html, [1, 5, 3]): print("{} sleep success".format(result)) 进程间通信 Queue、Pipe,Manager 共享全局变量不能适用于多进程编程,可以适用于多线程。 进程间通信和线程间通信有相同也有不同,不同点是之前在多线程中用的线程间通信的类和线程间同步的锁在多进程中是不能用的。 使用multiprocessing中的Queue实现进程通信 import time from multiprocessing import Process, Queue, Pool, Manager, Pipe def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Queue(10) my_producer = Process(target=producer, args=(queue,)) my_consumer = Process(target=consumer, args=(queue,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() 一定要使用multiprocessing中的Queue,如果使用import queue这个queue是不行的。 pool中的进程间通信需要使用manager中的queue multiprocessing中的queue不能用于pool进程池。 pool中的进程间通信需要使用manager中的queue def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Manager().Queue(10) pool = Pool(2) pool.apply_async(producer, args=(queue,)) pool.apply_async(consumer, args=(queue,)) pool.close() pool.join() 使用Manager,多进程修改同一变量: def add_data(p_dict, key, value): p_dict[key] = value if __name__ == "__main__": progress_dict = Manager().dict() from queue import PriorityQueue first_progress = Process(target=add_data, args=(progress_dict, "a", 22)) second_progress = Process(target=add_data, args=(progress_dict, "b", 23)) first_progress.start() second_progress.start() first_progress.join() second_progress.join() print(progress_dict) 可以看到两个进程对一个dict变量做值得填充,最终主进程中打印出了最终的dict。 通过pipe实现进程间通信: pipe的性能高于queue。 pipe只能适用于两个进程。 def producer(pipe): pipe.send("a") def consumer(pipe): print(pipe.recv()) if __name__ == "__main__": recevie_pipe, send_pipe = Pipe() #pipe只能适用于两个进程 my_producer = Process(target=producer, args=(send_pipe, )) my_consumer = Process(target=consumer, args=(recevie_pipe,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() my_producer进程给my_consumer进程发送的a变量可以正常打印。

优秀的个人博客,低调大师

Python高级知识点学习(七)

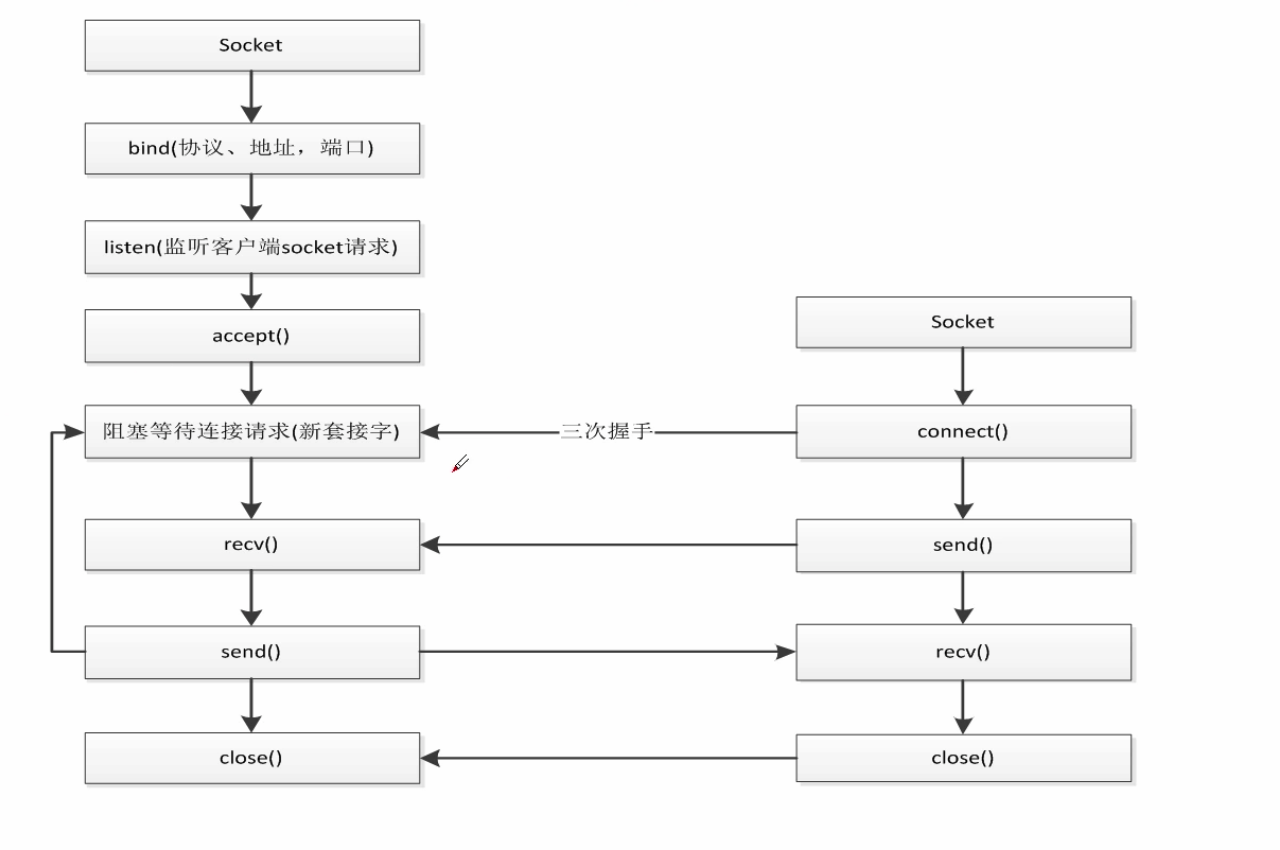
HTTP、Socket、TCP概念 socket属于常用的http协议之下的让我们可以使用tcp/ip协议的一个接口。 socket编程 image.png socket编程的模式其实是非常固定的。 上图: 左侧server端 右侧client端 server必须是随时处于一个监听的状态和服务的状态,因为不知道客户端什么时候会发送来请求。 绑定协议、地址、端口。 每一个应用程序只能占用一个端口,服务器a到服务器b发数据时,数据是不知道是由哪个应用程序接受的,这时候就需要端口机制,每一个应用程序提供一个端口。 socket连接后,只要不关闭连接,服务端可以一直给客户端发送请求,但是在http中,只完成一次发送数据就停止了。 编写测试代码: 新建文件sever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 绑定ip 端口 server.bind(('0.0.0.0', 8000)) # 监听 server.listen() sock, addr = server.accept() # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) # 给client发数据 sock.send("hello".encode("utf8")) # 关闭 server.close() sock.close() 新建文件client.py import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) # 给server端发数据 client.send("allen".encode("utf-8")) # 接受server端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) # 关闭 client.close() 首先运行server.py,再运行client.py,观察打印结果,可以看到,数据发送接收已经是实现。 socket实现简单聊天 要实现双向交流,肯定不能做close操作,改为一直while循环, 代码: 修改srever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(("0.0.0.0", 8000)) server.listen() sock, addr = server.accept() while True: # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) re_data = input() # 给client发数据 sock.send(re_data.encode("utf8")) 修改client.py: import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) while True: # 输入消息 re_data = input() client.send(re_data.encode("utf8")) # 接受client端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) 运行server.py ,再运行client.py,在client.py中输入要发送的文字,在server.py中观察接收到的文字,再在server.py中发送文字,在client.py中查看。 以上就是实现了最初级的基本聊天过程。 如果要在网页上做一个聊天模块,一般都是需要用web socket来实现。 socket多用户聊天 所谓多用户聊天,其实平时我们也经常遇到。 假如你是一位线上客服人员,你需要接待的人员可能同时有多位,当你和A用户聊天时,并不妨碍和B用户C用户给你发消息,而你回消息,回给A用户的消息只有A用户可以看到,B用户是看不到的,接着看如何实现这种功能。 首先client.py的代码不用改动,只需修改server.py: import socket import threading server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(('0.0.0.0', 8000)) server.listen() def handle_sock(sock, addr): while True: data = sock.recv(1024) print(data.decode("utf8")) re_data = input() sock.send(re_data.encode("utf8")) while True: sock, addr = server.accept() #用线程去处理新接收的连接(用户) client_thread = threading.Thread(target=handle_sock, args=(sock, addr)) client_thread.start() 上边代码把接受处理逻辑放到了线程中,每一个线程存放一个不同的socket,主线程来查看有哪些线程进入。 运行server.py,再运行多个client.py,client.py给server发消息,测试可发现可实现上边的客服功能。 注:真正客服系统要比这个复杂得多,以上代码仅供测试。 socket模拟http请求 我们平常所用到的requests包,是基于 urllib,urllib实际上是基于socket上来完成的。 requests - urlib - socket 如何通过socket去完成类似urllib中http请求呢? http请求无非就是在tcp协议之上加了一些协议,只要按照这个协议发,就会返回数据。 看代码: import socket from urllib.parse import urlparse def request_demo(url): # url拆分 url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect((host, 80)) client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) data = b"" # 每次读取1024大小,循环知道读取完毕 while True: d = client.recv(1024) if d: data += d else: break data = data.decode("utf8") print(data) client.close() if __name__ == "__main__": url = 'http://www.baidu.com' request_demo(url) 运行结果包含两部分: 第一部分request header 第二部分html源码 建立连接的过程是比较费时的,一般在使用socket编程都是为了解决长连接的问题,而不是说每发送一个请求数据返回就把它关掉。 很多时候我们需要一个交互的过程,这时候socket就派上用场了,有了socket后我们的代码灵活性高,它完全可以让我们将整个过程变得可以操控。

优秀的个人博客,低调大师

Python高级知识点学习(六)

围棋少年 Python中的迭代协议 迭代协议有两个概念: 可迭代类型(Iterable) 迭代器(Iterator) 迭代器:迭代器是访问集合内元素的一种方式, 一般用来遍历数据。 迭代器和以下标的访问方式不一样, 迭代器是不能返回的, 迭代器提供了一种惰性方式数据的方式。 可迭代对象(Iterable) 和 迭代器(Iterator) 是不同的。 可迭代对象: 实现__iter__这个魔法函数 迭代器: 实现__next__这个魔法函数 实现__iter__这个魔法函数 from collections.abc import Iterable, Iterator a = [1, 2] print(isinstance(a, Iterable)) print(isinstance(a, Iterator)) 打印结果: True False 上边代码,因为a是一个list,而list是一个可迭代对象并不是迭代器,因为list对象中没有__next__方法。 生成器 生成器函数:函数里只要有yield关键字,它就是生成器对象。 生成器对象在python编译字节码的时候就产生了。 生成器对象也是实现了迭代器协议的,所以可以使用for循环遍历到它的值。 def gen_func(): yield 1 gen = gen_func() for value in gen: print(value) 打印结果: 1 Python 中的GIL GIL:global interpreter lock (cpython) GIL:全局解释器锁。 python中一个线程对应于c语言中的一个线程。 GIL使得同一个时刻只有一个线程在一个cpu上执行字节码, 也就意味着无法将多个线程映射到多个cpu上执行。 GIL锁分配给某一线程后,并不是说这个线程执行完了之后它才会释放把它交给另外一个线程,它不是整个过程完全占有,它实际上是会在适当的时刻释放的,是结合了字节码执行的行数比如他执行了1000行字节码之后,它会释放,然后另外一个线程就可以得到运行。 GIL释放: 会根据执行的字节码行数以及时间片释放gil。 gil在遇到io的操作时候主动释放。 total = 0 def add(): global total for i in range(1000000): total += 1 def desc(): global total for i in range(1000000): total -= 1 thread1 = threading.Thread(target=add) thread2 = threading.Thread(target=desc) thread1.start() thread2.start() thread1.join() thread2.join() print(total) 上边代码两个线程分别执行两个函数,两个函数对同一变量做加减操作,本来应该先加到1000000再减1000000最终打印出0,但事实上是不会打印0的。 多线程编程 IO密集型时,适合多线程。 CPU密集型时,适合多进程。 多线程编程是我们几乎所有编程语言中都会遇到的问题。 操作系统能够切换和调度的最小单元是线程。 在最开始的时候,操作系统能够调度的最小单元是进程,但是由于进程对系统资源消耗非常大,所以后期就演变出了线程。 第一种方式:通过Thread类实例化 def get_detail_html(url): print("get detail html started") time.sleep(2) print("get detail html end") def get_detail_url(url): print("get detail url started") time.sleep(4) print("get detail url end") if __name__ == "__main__": thread1 = threading.Thread(target=get_detail_html, args=("",)) thread2 = threading.Thread(target=get_detail_url, args=("",)) # 设置为守护线程,随着主线程退出,子线程也退出 #thread1.setDaemon(True) #thread2.setDaemon(True) start_time = time.time() thread1.start() thread2.start() # 等待线程1,2执行完成 再执行完主线程; thread1.join() thread2.join() print(time.time() - start_time) 上边代码中,两个线程分别执行两个函数,主线程下有两个子线程。 thread1.setDaemon(True)这个操作是把thread1设置为守护线程,随着主线程退出,thread1也退出。thread1.join()这个操作是把主线程等待thread1执行完再执行完主线程。 第二种方式:通过重载Thread来实现多线程 def get_detail_html(url): print("get detail html started") time.sleep(2) print("get detail html end") def get_detail_url(url): print("get detail url started") time.sleep(4) print("get detail url end") class GetDetailHtml(threading.Thread): def __init__(self, name): super().__init__(name=name) def run(self): print("get detail html started") time.sleep(2) print("get detail html end") class GetDetailUrl(threading.Thread): def __init__(self, name): super().__init__(name=name) def run(self): print("get detail url started") time.sleep(4) print("get detail url end") if __name__ == "__main__": thread1 = GetDetailHtml("get_detail_html") thread2 = GetDetailUrl("get_detail_url") start_time = time.time() thread1.start() thread2.start() thread1.join() thread2.join() print("last time: {}".format(time.time()-start_time)) 上边代码继承threading.Thread必须重载run方法。 线程同步Lock、RLock 为什么要线程同步? 现有两个函数,分别是对全局变脸a进行加减操作,两个函数使用两个线程来运行,一个线程负责把a加一,另一个负责把a减一,上代码: a = 0 def add(a): a += 1 def desc(a): a-=1 首先使用内置方法dis()看一下两个函数字节码是什么样子的: import dis def add(a): a += 1 def desc(a): a-=1 print(dis.dis(add)) print(dis.dis(desc)) 打印结果: 63 0 LOAD_FAST 0 (a) 2 LOAD_CONST 1 (1) 4 INPLACE_ADD 6 STORE_FAST 0 (a) 8 LOAD_CONST 0 (None) 10 RETURN_VALUE None 66 0 LOAD_FAST 0 (a) 2 LOAD_CONST 1 (1) 4 INPLACE_SUBTRACT 6 STORE_FAST 0 (a) 8 LOAD_CONST 0 (None) 10 RETURN_VALUE None 上边代码打印结果: 看下add的里边字节码: LOAD_FAST:首先把 a LOAD 到内存中 LOAD_CONST :再把1 LOAD 到内存中 INPLACE_ADD:执行加的操作 STORE_FAST:将加完的值赋值给 a desc里边也是一样的,分四步,不同的是desc里执行的是减法。 如果同时执行add字节码和desc字节码时,之前笔记中提过,执行以上四个步骤时随时都可能释放gil锁,因为字节码的数量已经满了,以上四步任何一步骤都可能释放gil锁切换到另外一个线程,所以有可能造成一个结果,就是a要么等于1,要么等于-1,但是我们期望的是a 等于0,这时候就需要线程同步来解决问题。 我们希望在执行add函数的代码段时,另一个线程中的desc代码段是停止的,这就是线程同步机制。 python给我们提供了一个机制,叫做锁:from threading import Lock 在运行一个代码段时,加一把锁,等运行完了,再释放锁。 from threading import Lock total = 0 # 声明一把锁 lock = RLock() def add(): global lock global total for i in range(1000000): # 获得锁 lock.acquire() total += 1 # 释放锁 lock.release() def desc(): global total global lock for i in range(1000000): lock.acquire() total -= 1 lock.release() import threading thread1 = threading.Thread(target=add) thread2 = threading.Thread(target=desc) thread1.start() thread2.start() thread1.join() thread2.join() print(total) 打印结果: 0 上边代码不管累加多少次最终结果都是0。 如果没有释放锁,会导致死锁。 使用锁会影响性能。 RLock: 在同一个线程里面,可以连续调用多次acquire, 一定要注意acquire的次数要和release的次数相等。 在同一个线程中,可以使用RLock。

优秀的个人博客,低调大师

Python高级知识点学习(五)

dict的子类 首先,不建议自己编写代码继承dict和list这种原生使用c语言编写的,因为有时候,用c语言写的dict不会调用python写的覆盖的方法。 如果确实有继承dict来写代码的需求,可以使用UserDict,继承这个UserDict。 UserDict这个内部使用了python语言实现了c语言写的逻辑。 from collections import UserDict class Mydict(UserDict): def __setitem__(self, key, value): super().__setitem__(key, value*2) my_dict = Mydict(one=1) print (my_dict) 打印结果: {'one': 2} set和fronzenset set集合: 无序 不重复 set 接受一个可迭代对象 frozenset集合: 一旦设置好就无法修改。 frozenset为不可变类型。 相对于可变类型来说的好处,可以作为dict的key。 set的初始化方法: set([a, b, c]) a = {a, b, c} 两种都可以初始化 dict、set实现原理 当我们了解了背后的实现原理,就可以判断什么情况下使用dict以及为什么要使用dict。 dict查找的性能远远大于list。 在list中随着list数据的增大 查找时间会增大。 在dict中查找元素不会随着dict的增大而增大。 dict原理实际上就是利用hash算法。 数组和链表相比来说最大的优势,就是它可以做到任何一个位置直接存取而不需要从头到尾遍历,因为数组是一段连续的空间,数组取数据的时间复杂度是O(1)。 dict的key或者set的值,都必须是可以hash的。不可变对象都是可hash的, str, fronzenset, tuple。 自己实现的类重载__hash__这个魔法函数,让它可以变为可哈希对象。 dict的内存花销大,但是查询速度快, 自定义的对象或者python内部的对象都是用dict包装的。 dict的存储顺序和元素添加顺序有关,添加数据有可能改变已有数据的顺序。 Python中的变量是什么 python和java中的变量本质不一样,python的变量实质上是一个指针。我们可以理解变量就是一个便利贴, 例如:a = 1 先成对象,然后贴便利贴,把a贴在1上面。 a = [1, 2, 3] b = a print(id(a), id(b)) 打印结果: a和b的地址值一样。 is 和 == 的区别 is是判断对象的id是否相同,但是注意看下边例子: a = [1, 2, 3, 4] b = [1, 2, 3, 4] print (id(a), id(b)) print (a is b) 输出结果: 4446597320 4446597640 False 上边这种用法得到的结果很正常,再看下边代码: a = 1 b = 1 print (id(a), id(b)) print (a is b) 运行结果: 4325627840 4325627840 True 这种情况下,a和b指向的是同一个。这是由于Python内部机制决定的,将小正数建立一个全局唯一的对象,小段字符串也是一样的。 a = [1, 2, 3] b = [1, 2, 3] print(a==b) 返回True 因为: list里边实现了一个魔法函数 __eq__,当我们调用a==b这种模式的时候,会调用__eq__这个魔法函数,从而来判断值是否相等。 它们的值是相等的,只是不是同一个对象而已,所有a==b是True。 垃圾回收和del语句 cpython中垃圾回收的算法是采用 引用计数 a = 1 b = a 此时,1这个对象上就又有一个计数器,a = 1 时会在计数器上加1,b如果指向的还是1,1上边的计数器会再加1,当不使用时,执行del a,他就会将引用计数器减1,当引用计数器减到0时,python解释器会将对象回收。 对象只有在计数器减到0时,才会被回收,del只是减计数器的功能。 a = object() b = a del a print(b) print(a) 打印结果: <object object at 0x104a86100> NameError: name 'a' is not defined 可以看到,执行del后,只是把a销毁了,b还在。 __del__魔法函数: 可以在__del__魔法函数中实现自己的逻辑,当python解释器回收对象的时候,会调用对象的__del__魔法函数,它可以帮我们在回收对象时做一些事。 @property的用法 我们在读源码时,往往会看到这这种方法: @property def hello(self): pass @property 这个装饰器会把函数变为属性描述符,怎么说? 看代码: class Allen(object): def word(self): return 'word' @property def hello(self): return 'hello' a = Allen() print(a.hello) print(a.word()) 运行结果: hello word 可以发现,@property这个装饰器把取方法的模式变为取属性。 魔法函数__getattr__、__getattribute__介绍 魔法函数是python解释器内部需要用的方法,它是整个python动态特性的最根本原因。 __getattr__:就是在查找不到属性的时候调用。 例1: class User: def __init__(self, info): self.info = info def __getattr__(self, item): return '2' if __name__ == "__main__": user = User('allen') print(user.info) print(user.age) 运行结果: allen 2 例2: class User: def __init__(self, info={}): self.info = info def __getattr__(self, item): return self.info[item] if __name__ == "__main__": user = User(info={"name": "allen", "age": "3"}) print(user.name) 打印结果: allen __getattribute__ : 比__getattr__更高级,只要查找属性,就会首先进入__getattribute__这个魔法函数,强制进入,无条件的。 __getattribute__这个魔法函数尽量不要去重写,因为如果一旦写不好,整个类的属性访问就会崩溃掉,一般写框架时会用到这个魔法函数。 class User: def __init__(self,info={}): self.info = info def __getattr__(self, item): return self.info[item] def __getattribute__(self, item): return "10" if __name__ == "__main__": user = User(info={"name":"allen"}) print(user.name) print(user.test) 打印结果: 10 10 属性描述符和属性查找过程 一个类只需要实现__get__、__set__、__delete__这三个中的任意一个方法,它就算是属性描述符。 通过属性描述符,可以控制在赋值的时候它的行为,在属性设置的时候参数检查。 属性描述符有两种: 数据属性描述符:实现__get__ 和 __set__就是数据属性描述符。 非数据属性描述符:只实现一个__get__方法就是非数据属性描述符。 数据属性描述符 和 非数据属性描述符 它们的属性查找过程是不一样的。 前边提到的属性查找过程,先查找实例中的属性,然后查找类中的属性,实际上它有更加详细的查找过程。 魔法函数__new__ 和 __init__ 区别 __new__ 魔法函数在python新式类才会有 python2.2之前没有这个。 class User: def __new__(cls, *args, **kwargs): print(" in new ") return super().__new__(cls) def __init__(self): print(" in init") pass if __name__ == "__main__": user = User() 打印结果: in new in init __new__魔法函数允许在生成对象之前加逻辑,自定义对象生成过程,传递进来的是类。 __init__方法传递进去的是对象。 __new__ 在 __init__ 之前调用。 __new__中必须return super().__new__(cls)才会调用__init__方法。 def __new__(cls, *args, **kwargs):这个中的*args,和**kwargs,代表的是传入的参数。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册