首页 文章 精选 留言 我的

精选列表

搜索[团队协作工具],共10000篇文章
优秀的个人博客,低调大师

事务,不只ACID | 京东物流技术团队

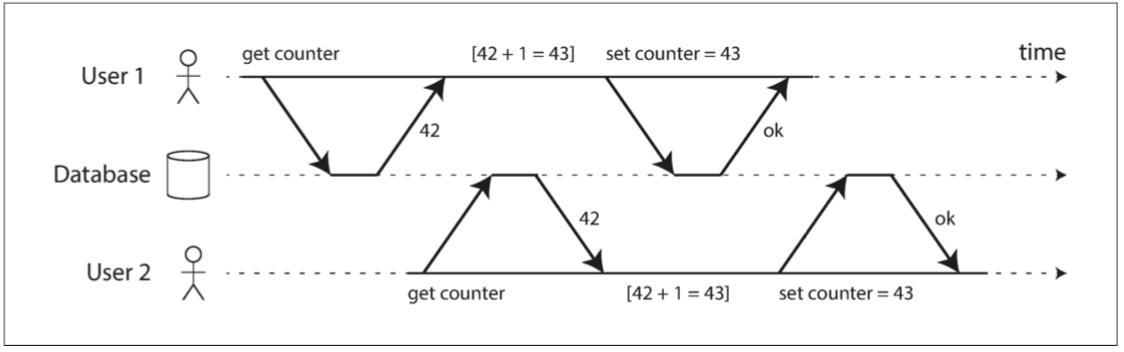
1. 什么是事务? 应用在运行时可能会发生数据库、硬件的故障,应用与数据库的网络连接断开或多个客户端端并发修改数据导致预期之外的数据覆盖问题,为了提高应用的可靠性和数据的一致性,事务应运而生。 从概念上讲,事务是应用程序将多个读写操作组合成一个逻辑单元的一种形式,这样其中所有的读写操作都被视为单个操作来执行,要么成功提交,要么失败回滚,不存在任何部分成功和部分失败的情况。现在,几乎所有的关系型数据库和一些非关系型数据库都支持事务。 1.1 ACID 事务通过ACID来保证安全的操作,它们分别是原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)和持久性(Durability)。ACID的提出旨在为数据库容错机制建立精确的术语,但是它在不同的数据库中实现并不相同,我们来对其逐一的进行解释。 原子性 原子性定义的特征是:一个事务必须被视为一个不可分割的工作单元,整个事务中的所有操作要么全部提交成功,要么全部失败回滚,不可能只执行其中的一部分操作。 一致性 一致性在ACID中是“多余的”存在,它不同于原子性、隔离性和持久性,一致性是应用程序的属性,而其他三者是数据库的属性。应用可能依赖原子性和隔离性来保证一致性,但有时候一致性的保证并不仅仅取决于数据库。 一致性的体现依赖应用程序对数据的约束,比如在会计系统中,所有账户的交易收支一定是平衡的。如果一个事务开始于一个平衡状态,那么在该事务执行完成提交后,那么依然会保持平衡。从概念上来说,一致性是对数据的一组特定约束必须始终成立,这一点由应用程序来保证,因为这些写入和修改的逻辑都是由应用程序决定的,数据库只负责对这些操作进行执行。 隔离性 在实际工作中,大多数数据库都同时被多个客户端访问,这就可能会发生客户端并发修改同一条数据的情况,引发并发问题。如下图中例子所示: User1和User2要同时在数据库中操作计数器增长,每个用户都是先读取值,执行加1,然后写入。理论上计数器的值最终应该为44,但是由于并发问题,使得终值为43。 通常来说,隔离性让一个事务所做的修改在最终提交以前,对其他事务不可见,它解决的是并发问题。如果一个事务进行多次写入,则另一个事务要么看到全部写入结果,要么什么都看不到。所以在上述例子中,User2在修改计数器时读取到的值应该是User1修改完之后的结果43,之后执行加1,使得最终结果为44。 持久性 持久性是一个承诺,即事务成功提交,即使发生硬件故障或者数据库崩溃,写入的任何数据都不会丢失,在单节点数据库中,它通常意味着数据已经被写入硬盘或SSD;在多节点数据库中,持久性可能意味着数据已经成功复制到一些节点。但是,如果硬盘和备份被销毁,那么显然没有任何数据库能再找回这些数据,所以完美的持久性并不存在。 2. 并发产生数据不一致的问题 往往由于事务之间的操作对象有竞争关系,并且又因为并发事务之间不确定的时序关系,会导致这些所操作的有竞争关系的对象会出现各种奇怪的结果,下面我们就来看看这些常见的问题。 2.1 脏写 两个事务尝试同时更新数据库中相同的对象,如果先前的写入是尚未提交事务的一部分,后面的写入将一个尚未提交的值覆盖掉了,这种情况被称为脏写。 2.2 脏读 如果A事务已经将一些数据写入数据库,但是A事务还没有提交或中止,现在开启另一个B事务查询,那么B事务能看到A事务中没有提交的数据,这就是脏读。 我们考虑一种情况,一旦A事务发生回滚,B事务很有可能将未提交过的数据提交给数据库,因此造成的问题会让人无从下手去排查。 2.3 不可重复读 我们拿一个例子来说,Alice 在银行有 1000 美元的储蓄,分为两个账户,每个 500 美元。现在有一个事务从她的一个账户转移了 100 美元到另一个账户。如果她在事务处理的过程中查看其账户余额,她可能在发出转账之后看到付款账户的余额为 400 美元,而收款账户的余额仍为 500 美元。对 Alice 来说,现在她的账户看起来总共只有 900 美元,转账的 100 美元似乎凭空消失了,而再对收款账户进行读取时,发现余额变成了 600 美元。 这种情况被称为不可重复读,又被称为读偏差,即对同一数据两次读取的结果不一致。 2.4 丢失更新 两个事务同时执行读取-修改-写入序列,其中一个写操作在没有合并另一个写操作变更的情况下,直接覆盖了另一个写操作的结果,导致了数据的丢失,这种情况被称为丢失更新。 比较直接的避免丢失更新的方法是不使用读取-修改-写入这一系列操作,而是进行原子更新,以计数器为例,SQL如下。它的原理通常是获取要读取对象的排他锁,使得事务在修改同一数据时依次执行。 update counters set value = value + 1 where key = 1; 如果不能避免读取-修改-写入这一系列操作,那么可以通过显式加锁(FOR UPDATE)的方式来避免丢失更新,使得任何其他想要读取同一对象的事务被阻塞,直到第一个获取到该锁的事务执行完毕。 BEGIN TRANSACTION; SELECT * FROM xxx FOR UPDATE; -- 执行业务逻辑 UPDATE xxx SET ...; COMMIT; 比较并设置(CAS)是一种比较常见的乐观的避免丢失更新的操作。当对数据更新时,会将数据表中的值和读取值进行对比,只有在没有发生改变的情况下才允许更新,否则需要重试这个事务。一般在工作中会采用在数据表中添加时间戳列的方式来实现CAS。 2.5 幻读和写入偏差问题 幻读用一句话来概括就是:一个事务的写入改变了另一个事务的搜索查询结果。 A事务的select查询出符合条件的数据,并检查是否符合业务要求,根据检查结果决定业务是否继续执行。如果此时B事务对数据进行修改,并符合A事务select的查询条件,那么A事务在执行完写入操作后,再次执行select查询会发现不同的结果,这很可能会导致写入偏差问题。 写入偏差问题是两个事务读取相同的对象,然后更新其中一些对象时发生了预期之外的异常情况。它区别于脏写和丢失更新,因为它是两个事务正在更新两个不同的对象。如下面这个例子所示,Alice 和 Bob 是两位值班医生,两人都感到不适,所以他们都决定请假。不幸的是,他们恰好在同一时间点击按钮下班: 这导致了没有医生值班,违反了至少有一名医生值班的业务要求。 解决写入偏差问题比较麻烦,因为它涉及多个对象,采用单对象原子操作的方法不能解决。通常情况下会采用更改隔离级别为可串行化或通过加锁的方式来解决。 但是,加锁的方式并不是在所有情况下都适用。比如,多人预定同一时段的会议室,因为该时段的会议室预定记录还没有生成,导致多人读取预定纪录时都没有读到对应的结果值,所以就无从加锁,那么此时将会造成多人预定同一时段会议室的结果。为了解决这种情况,可以再创建一张数据表管理会议室的时间段,当有人想预定某时段会议室时,会将该时段的数据进行加锁,那么这时再有其他用户来查询时,将会被阻塞,这种方法被称为物化冲突。 3. 隔离级别 数据库一直试图通过事务隔离解决并发问题。可串行化隔离级别能保证事务串行执行,这意味着不会发生并发问题。但是在实际生产中为了保证系统的性能,往往不会采用该隔离级别,而是会采用一些较弱的隔离级别,它们可能在某些情况下不能保证数据的一致性,但是能够让系统的性能更好。下面我们对这些隔离级别进行介绍: 3.1 读未提交 该隔离级别相对更弱,只能避免脏写。 3.2 读已提交(Read Committed) 这种隔离级别非常流行,它能够避免脏读和脏写。 最常见的情况是使用行锁来防止脏写:当事务想要修改同一个对象时,则必须等到第一个事务提交或回滚后才能获取该行的锁继续。 脏读也可以通过加读锁来避免,但是这种方式会导致在有长时间的写入事务持有要读数据的锁时,读请求被阻塞,所以这种方式在实践中的效果并不好。另一种避免方式是数据库将已经写入的旧值记住,即使发生新的写入事务且并没有执行完时,读请求读取到的都是这个旧值,只有当该写事务提交时才能读取到新值。 3.3 可重复读 可重复读能够避免脏写、脏读、不可重复读和只读查询中的幻读,快照隔离是实现可重复读的常见解决方案。每个事务都从数据库的一致性快照中进行读取,那么这也就意味着该事务能看到事务开始时在数据库中提交的所有数据。即使这些数据随后被新的事务更改,该事务还仍然读取的是在事务开始时的旧数据。这种办法对长时间运行的只读查询非常有用,因为如果在查询过程中数据不断的变化,那么没有办法对数据进行分析。 不提供快照隔离的读已提交不能实现可重复读,因为它只记住了数据的两个版本。 快照隔离也是通过写锁的方式来避免脏写,而避免脏读的方式无需加锁,而是通过读取数据库中维护的对应版本的数据对象,它的关键原则是读不阻塞写,写不阻塞读。这也就意味着数据库在处理一致性快照上的长时间查询时,能够同时处理写入,而不会发生锁的争用。 使用InnoDB引擎的MySQL对快照隔离的实现方法是MVCC多版本并发控制,它会同时维护单个对象的多个版本,以提供多个不同时间节点的数据状态,我们下面来简单地看一下它的实现原理。 对于InnoDB引擎的表来说,它的聚簇索引记录中都包含两个必要的隐藏列:trx_id和roll_pointer trx_id: 事务每次对某条聚簇索引记录进行改动时,都会把该事务的事务ID赋值给 trx_id roll_pointer: 每次对某条聚簇索引记录进行改动时,都会把旧的版本写入到 undo 日志中, 这个隐藏列相当于一个指针,可以通过它来找到该记录修改前的信息。我们举个例子来理解它,假设表 hero 中只包含一条记录: mysql> select * from hero; +-----+-----+ |id |name | +-----+-----+ |1 |刘备 | +-----+-----+ 指定插入该记录的事务ID为80,此时再开启两个事务对这条记录进行修改,每次修改都会生成一条 undo log,每条日志也都有 trx_id 属性和 roll_pointer 属性。通过 roll_pointer 属性可以将多条 undo log 连接成一条链表,如下图所示: 这个链表被称为版本链,版本链的头节点是当前最新的记录,利用这个记录的版本链可以来控制并发事务访问相同记录时的行为,这种方式被称为多版本并发控制。 事务在执行第一次查询的时候会生成一致性快照(Read View),通过它来判断版本链中的哪个版本对当前事务是可见的。Read View 中包含4个比较重要的内容如下: m_ids: 生成 Read View 时,当前系统中活跃的读写事务的 id 列表,它用来保证即使活跃的这些事务被提交,它们的写入也会被当前事务忽略 min_trx_id: 当前系统中活跃的读写事务的最小事务 id max_trx_id: 系统应该分配给下一个事务的事务 id creator_id: 生成该 Read View 的事务的事务 id 有了 Read View,只需要按照下面的步骤去判断记录中的某个版本是否可见: 如果被访问版本的 trx_id 属性值与 Read View 中的 creator 中的 creator_trx_id 值相同,则意味着当前事务在访问自己修改过的内容,该版本能够被当前事务访问 如果被访问的版本的 trx_id 属性值小于 Read View 中的 min_trx_id 值,表明生成该版本的事务在当前事务生成 Read View 前已经提交,这些版本能够被当前事务访问 如果被访问的版本的 trx_id 属性大于或等于 Read View 中的 max_trx_id 值,表明生成该版本的事务在当前事务生成 Read View 之后才开启,那么该版本不能被当前事务访问 如果被访问的版本的 trx_id 属性值在 Read View 的 min_trx_id 和 max_trx_id 之间,则需要判断 trx_id 是否在 m_ids 列表中。如果在,说明创建该 Read View 时生成该版本的事务还是活跃的,所以该版本不可见;如果不在,说明创建该 Read View 时生成该版本的事务已经被提交,该版本可以被访问 也就是说,想要满足记录对当前读事务可见,需要创建该记录的事务在当前读事务开启前已经提交。 3.4 可串行化 可串行化通常被认为是最强的隔离级别,能够避免我们上诉所有数据不一致问题。它能保证即使事务可以并行执行,但最终的结果也是一样的,就好像它们没有任何并发性,连续挨个执行一样。也就是说,数据库可以防止所有可能的竞争条件。 可串行化的实现技术大多采用如下3种方式之一:串行化执行事务,两阶段锁定或可串行化快照隔离。 串行化执行事务 使用这种技术实现必须要求每个事务小而快,如果其中有一个缓慢的事务,那么自然会将其他事务拖慢。除此之外,这种方式限于活跃数据集可以放入内存的情况,如果需要在事务中访问磁盘中的数据,那么系统也会变得非常慢。写入吞吐量必须低到在单个CPU核上处理,如若不然,事务需要能划分至单个分区,且不需要跨分区协调。当然跨分区事务可以实现,但是它的执行效率会非常低。所以,串行化执行事务的伸缩性较差。 两阶段锁定(2PL, two pahse locking) 两阶段提交的含义是:第一阶段事务执行时获取锁(共享锁/排他锁),第二阶段在事务执行完成时释放锁。它要求没有写入时多个事务都可以读取同一个对象,但是只要有写入就会独占访问,读阻塞写,写也会阻塞读,与快照隔离不同,因此两阶段锁定可以避免竞争条件而实现可串行化。 Mysql的InnoDB引擎实现可串行化隔离级别采用的就是2PL机制。 两阶段锁定的性能很差,不仅是因为它获取和释放锁的开销,而且还包括并发性的降低,因为如果两个事务修改同一个对象时,第二个事务必须要等待第一个事务执行完为止。除此之外,2PL实现的可串行化隔离出现死锁的情况也比较频繁。 可串行化快照隔离(SSI, serializable snapshot isolation) 可串行化快照隔离是一种乐观的并发控制技术,它在快照隔离的基础上,添加了一种算法来检测写入之间的串行化冲突,并确定要终止哪些事务。 乐观意味着如果存在潜在的危险也不阻止事务,而是继续执行事务,希望一切都会好起来。当一个事务想要提交时,数据库检查是否有什么不好的事情发生(即隔离是否被违反),如果是的话,事务将被中止,并且必须重试。在争用不是很高时,乐观的并发控制往往比悲观的并发控制性能要好。 事务从数据库中读取一些数据,并根据这些数据进行条件判断执行业务逻辑时,在快照隔离的条件下,往往先前的查询结果不是最新的,因为在数据查询之后,该数据可能会被修改,所以执行的业务逻辑可能会出现异常。因此在事务提交时判断先前读的数据是否发生改变就需要两方面的校验: 检查是否存在读之前未提交的写入 检查读之后的写入 只有通过这些校验后才能保证事务提交时使用的数据是新的。 可串行化快照隔离与串行执行相比,可串行化快照隔离并不局限于单个 CPU 核的吞吐量,所以它的伸缩性更好;可串行化快照隔离与两阶段锁定相比,它的最大优点是一个事务不需要阻塞等待另一个事务所持有的锁,就像在快照隔离下一样,读不阻塞写,写也不阻塞读,这对于读取较多的业务场景非常友好。 可串行化快照隔离的性能表现在中止率上,如果长时间的读写事务较多,很可能会经常发生冲突导致事务中止。因此在事务比较短小的情况下,可串行化快照隔离的表现更好。 4. 及时性与完整性 ACID事务通常能保证强一致性,也就是说,写入者会等到事务提交,而且在写入完成后,写入结果对所有读取者可见。在强一致性这个语义中,包含两个特别值得考虑的方面: 及时性:这意味着确保用户观察到系统的最新状态。如果不是强一致性而是最终一致性的情况,那么用户可能会读取到陈旧的数据,但这种不一致是暂时的,最终都会通过等待与简单地重试得到解决 完整性:完整性代表数据没有丢失、矛盾或错误,即没有损坏。尤其是某些衍生数据集(缓存、搜索索引等),它们一定要与底层数据库保持一致。在ACID事务中,原子性和持久性是保证完整性的重要原则 有意思的是:基于异步流处理系统实现的分布式事务,它能够将及时性与完整性分开,只保证完整性,而不保证及时性,除非我们显示地构建一个在事务提交返回结果之前明确等待特定消息到达的消费者。 下面我们来看一个基于流处理系统实现分布式事务的例子,来加深对及时性和完整性的理解。 4.1 使用基于日志的消息队列保证完整性 我们以转账为例,比如有三个分区:一个包含请求ID,一个包含收款人账户,另一个包含付款人账户。如果在数据库传统的方法中,执行此事务需要跨三个分区进行原子提交,这样就需要协调分布式事务,因此吞吐量很可能会受到影响。但事实上使用基于日志的消息队列实现的流处理系统,可以达到等价的数据完整性而不需要原子提交。例子执行过程如下: 从账户 A 向账户 B 转账的请求由客户端提供一个唯一的请求 ID,并按请求 ID 追加写入相应的消息队列,并对该消息进行持久化 消费者读取请求日志。对于每个请求消息,它向输出流发出两条消息:付款人的借记指令(A分区),收款人的贷记指令(B分区),发出的消息中会携带原始的请求ID 后续消费者消费借记和贷记指令,按照ID除重,并将变更应用到账户的余额 为了在多分区间保证数据完整性而且还要避免对分布式事务的协调(2PC等协议),我们首先需要将这个事务所要做的事情持久化为单条记录,然后从这条消息记录中衍生出贷记指令和借记指令。在几乎所有的数据系统中,单对象的写入都是原子性的:即请求要么出现在日志中,要么都不出现。 如果流处理在步骤2崩溃,则它会从上一个存档点恢复处理,这样它就不会跳过任何消息,但可能会生成多条重复的借记/贷记指令,不过由于它是确定性的,因此它生成的只是相同的指令,在步骤3中的处理器可以通过ID值轻松地去重。 在上述例子中,我们把一个操作拆分为跨越多个阶段的流处理器,消息记录的消费是异步的,发送者不会等其消息被消费处理完,而且这个消息与消息的处理结果被解耦,所以我们没有对及时性进行保证,只是保证了完整性。 一般地,我们在借助可靠的流处理系统时无需再协调分布式事务或采用其他原子提交协议就能保证完整性,其中所包含的机制如下: 将写入操作的内容表示为单条消息,这样就保证了写入的原子性 从这一消息中衍生出其他所需要的状态变更 将客户端生成的请求ID传递通过所有的处理层,从而能达到去重和保证幂等性的目的 保证消息不可变,并允许衍生数据能被随时重新处理,这使从错误中恢复更加容易 4.2 完整性的重要性 不论是ACID事务还是基于流处理系统的分布式事务,它们都保证数据的完整性。因为违反及时性可能会令人困惑,不过这只是暂时的,但是如果违反完整性,那么它的结果可能是灾难性的。违反一致性,最终一致性;违反完整性,永无一致性,是最好的概括。 巨人的肩膀 《数据密集型应用系统设计》:第七章 事务、第十二章 数据系统的未来 Replication(下):事务,一致性与共识 《MySQL是怎样运行的》第二十一章 《高性能MySQL 第四版》第一章 作者:京东物流王奕龙 来源:京东云开发者社区

优秀的个人博客,低调大师

ReentrantLock源码解析 | 京东云技术团队

并发指同一时间内进行了多个线程。并发问题是多个线程对同一资源进行操作时产生的问题。通过加锁可以解决并发问题,ReentrantLock是锁的一种。 1 ReentrantLock 1.1 定义 ReentrantLock是Lock接口的实现类,可以手动的对某一段进行加锁。ReentrantLock可重入锁,具有可重入性,并且支持可中断锁。其内部对锁的控制有两种实现,一种为公平锁,另一种为非公平锁. 1.2 实现原理 ReentrantLock的实现原理为volatile+CAS。想要说明volatile和CAS首先要说明JMM。 1.2.1 JMM JMM(java 内存模型 Java Memory Model 简称JMM) 本身是一个抽象的概念,并不在内存中真实存在的,它描述的是一组规范或者规则,通过这组规范定义了程序中各个变量的访问方式. 由于 JMM 运行程序的实体是线程.而每个线程创建时JMM都会为其创建一个自己的工作内存(栈空间),工作内存是每个线程的私有 数据区域.而java内存模型中规定所有的变量都存储在主内存中,主内存是共享内存区域,所有线程都可以访问,但线程的变量的操作(读取赋值等)必须在自己的工作内存中去进行,首先要 将变量从主存拷贝到自己的工作内存中,然后对变量进行操作,操作完成后再将变量操作完后的新值写回主内存,不能直接操作主内存的变量,各个线程的工作内存中存储着主内存的变量拷贝的副本,因不同的线程间无法访问对方的工作内存,线程间的通信必须在主内存来完成。 如图所示:线程A对变量A的操作,只能是从主内存中拷贝到线程中,再写回到主内存中。 1.2.2 volatile volatile 是JAVA的关键字用于修饰变量,是java虚拟机的轻量同步机制,volatile不能保证原子性。 作用: 线程可见性:一个变量在某个线程里修改了它的值,如果使用了volatile关键字,那么别的线程可以马上读到修改后的值。 指令重排序:没加之前,指令是并发执行的,第一个线程执行到一半另一个线程可能开始执行了。加了volatile关键字后,不同线程是按照顺序一步一步执行的。1.2.3 CASCAS是Compare and Swap,就是比较和交换,而比较和交换是一个原子操作。线程基于CAS修改数据的方式:先获取主内存数据,在修改之前,先比较数据是否一致,如果一致修改主内存数据,如果不一致,放弃这次修改。 作用:CAS会使用现代处理器上提供的高效机器级别原子指令,这些原子指令以原子方式对内存执行读-改-写操作。1.2.4 AQSAQS的全称是AbstractQueuedSynchronizer(抽象的队列式的同步器),AQS定义了一套多线程访问共享资源的同步器框架。 AQS主要包含两部分内容:共享资源和等待队列。AQS底层已经对这两部分内容提供了很多方法。 共享资源:共享资源是一个volatile的int类型变量。 等待队列:等待队列是一个线程安全的队列,当线程拿不到锁时,会被park并放入队列。 2 源码解析 ReentrantLock在包java.util.concurrent.locks下,实现Lock接口。 2.1 lock方法 lock分为公平锁和非公平锁。 公平锁: final void lock() { acquire(1); } 非公平锁:上来先尝试将state从0修改为1,如果成功,代表获取锁资源。如果没有成功,调用acquire。state是AQS中的一个由volatile修饰的int类型变量,多个线程会通过CAS的方式修改state,在并发情况下,只会有一个线程成功的修改state。 final void lock() { //通过原子方式修改值 if (compareAndSetState(0, 1)) setExclusiveOwnerThread(Thread.currentThread()); else acquire(1); } /** * 获取锁的线程. */ private transient Thread exclusiveOwnerThread; /** * 设置拥有锁的线程 */ protected final void setExclusiveOwnerThread(Thread thread) { exclusiveOwnerThread = thread; 2.2 acquire方法 acquire是一个业务方法,里面并没有实际的业务处理,都是在调用其他方法。 public final void acquire(int arg) { //调用tryAcquire方法:尝试获取锁资源(非公平、公平),拿到锁资源,返回true,直接结束方法 if (!tryAcquire(arg) && //当没有获取锁资源后,会先调用addWaiter:会将没有获取到锁资源的线程封装为Node对象, //并且插入到AQS的队列的末尾. //继续调用acquireQueued方法,查看当前排队的Node是否在队列的前面,如果在前面,尝试获取锁资源 //如果没在前面,尝试将线程挂起,阻塞起来! acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 2.3 tryAcquire方法 tryAcquire分为公平和非公平两种。 公平: protected final boolean tryAcquire(int acquires) { //拿到当前线程 final Thread current = Thread.currentThread(); //拿到AQS的state int c = getState(); // 如果state == 0,说明没有线程占用着当前的锁资源 if (c == 0) { //如果没有线程排队,直接直接CAS尝试获取锁资源 if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { //如果获取资源成功,将当前线程设置为持有锁资源的线程 setExclusiveOwnerThread(current); return true; } } //如果有线程持有锁资源,判断持有锁资源的线程是否是当前线程 else if (current == getExclusiveOwnerThread()) { //增加AQS的state的值 int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } } 非公平: protected final boolean tryAcquire(int acquires) { return nonfairTryAcquire(acquires); } final boolean nonfairTryAcquire(int acquires) { //拿到当前线程 final Thread current = Thread.currentThread(); //拿到AQS的state int c = getState(); // 如果state == 0,说明没有线程占用着当前的锁资源 if (c == 0) { //获取锁资源 if (compareAndSetState(0, acquires)) { //将当前占用这个互斥锁的线程属性设置为当前线程 setExclusiveOwnerThread(current); return true; } } //如果有线程持有锁资源,判断持有锁资源的线程是否是当前线程 else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 2.4 addWaiter方法 在获取锁资源失败后,需要将当前线程封装为Node对象,并且插入到AQS队列的末尾。 private Node addWaiter(Node mode) { // 将当前线程封装为Node对象,mode为null,代表互斥锁 Node node = new Node(Thread.currentThread(), mode); // pred是tail节点 Node pred = tail; // 如果pred不为null,有线程正在排队 if (pred != null) { // 将当前节点的prev,指定tail尾节点 node.prev = pred; // 以CAS的方式,将当前节点变为tail节点 if (compareAndSetTail(pred, node)) { // 之前的tail的next指向当前节点 pred.next = node; return node; } } // 添加的流程为, 自己prev指向、tail指向自己、前节点next指向我 // 如果上述方式,CAS操作失败,导致加入到AQS末尾失败,如果失败,就基于enq的方式添加到AQS队列 enq(node); return node; } // enq,无论怎样都添加进入 private Node enq(final Node node) { for (;;) { // 拿到tail Node t = tail; // 如果tail为null,说明当前没有Node在队列中 if (t == null) { // 创建一个新的Node作为head,并且将tail和head指向一个Node if (compareAndSetHead(new Node())) tail = head; } else { // 和上述代码一致! node.prev = t; if (compareAndSetTail(t, node)) { t.next = node; return t; } } } } 2.5 acquireQueued方法 // acquireQueued方法 // 查看当前排队的Node是否是head的next, // 如果是,尝试获取锁资源, // 如果不是或者获取锁资源失败那么就尝试将当前Node的线程挂起(unsafe.park()) final boolean acquireQueued(final Node node, int arg) { boolean failed = true; try { for (;;) { // 拿到上一个节点 final Node p = node.predecessor(); if (p == head && // 说明当前节点是head的next tryAcquire(arg)) { // 竞争锁资源,成功:true,失败:false // 进来说明拿到锁资源成功 // 将当前节点置位head,thread和prev属性置位null setHead(node); // 帮助快速GC p.next = null; // 设置获取锁资源成功 failed = false; // 不管线程中断。 return interrupted; } // 如果不是或者获取锁资源失败,尝试将线程挂起 // 第一个事情,当前节点的上一个节点的状态正常! // 第二个事情,挂起线程 if (shouldParkAfterFailedAcquire(p, node) && // 通过LockSupport将当前线程挂起 parkAndCheckInterrupt()) } } finally { if (failed) cancelAcquire(node); } } // 确保上一个节点状态是正确的 private static boolean shouldParkAfterFailedAcquire(Node pred, Node node) { // 拿到上一个节点的状态 int ws = pred.waitStatus; // 如果上一个节点为 -1 if (ws == Node.SIGNAL) // 返回true,挂起线程 return true; // 如果上一个节点是取消状态 if (ws > 0) { // 循环往前找,找到一个状态小于等于0的节点 do { node.prev = pred = pred.prev; } while (pred.waitStatus > 0); pred.next = node; } else { // 将小于等于0的节点状态该为-1 compareAndSetWaitStatus(pred, ws, Node.SIGNAL); } return false; } 2.6 unlock方法 释放锁资源,将state减1,如果state减为0了,唤醒在队列中排队的Node。 public final boolean release(int arg) { // 核心的释放锁资源方法 if (tryRelease(arg)) { // 释放锁资源释放干净了。 (state == 0) Node h = head; // 如果头节点不为null,并且头节点的状态不为0,唤醒排队的线程 if (h != null && h.waitStatus != 0) // 唤醒线程 unparkSuccessor(h); return true; } // 释放锁成功,但是state != 0 return false; } // 核心的释放锁资源方法 protected final boolean tryRelease(int releases) { // 获取state - 1 int c = getState() - releases; // 如果释放锁的线程不是占用锁的线程,抛异常 if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); // 是否成功的将锁资源释放利索 (state == 0) boolean free = false; if (c == 0) { // 锁资源释放干净。 free = true; // 将占用锁资源的属性设置为null setExclusiveOwnerThread(null); } // 将state赋值 setState(c); // 返回true,代表释放干净了 return free; } // 唤醒节点 private void unparkSuccessor(Node node) { // 拿到头节点状态 int ws = node.waitStatus; // 如果头节点状态小于0,换为0 if (ws < 0) compareAndSetWaitStatus(node, ws, 0); // 拿到当前节点的next Node s = node.next; // 如果s == null ,或者s的状态为1 if (s == null || s.waitStatus > 0) { // next节点不需要唤醒,需要唤醒next的next s = null; // 从尾部往前找,找到状态正常的节点。(小于等于0代表正常状态) for (Node t = tail; t != null && t != node; t = t.prev) if (t.waitStatus <= 0) s = t; } // 经过循环的获取,如果拿到状态正常的节点,并且不为null if (s != null) // 唤醒线程 LockSupport.unpark(s.thread); } 3 使用实例 3.1 公平锁 1.代码: public class ReentrantLockTest { public static void main(String[] args) { ReentrantLock lock = new ReentrantLock(true); new Thread(()->test(lock),"线程A").start(); new Thread(()->test(lock),"线程B").start(); new Thread(()->test(lock),"线程C").start(); } public static void test(ReentrantLock lock){ for (int i = 0; i < 3;i++){ try { lock.lock(); System.out.println(Thread.currentThread().getName()+"获取了锁!"); Thread.sleep(200); }catch (Exception e){ e.printStackTrace(); }finally { lock.unlock(); } } } } 2.执行结果: 3.小结: 公平锁可以保证每个线程获取锁的机会是相等的。 3.2 非公平锁 1.代码: public class ReentrantLockTest { public static void main(String[] args) { ReentrantLock lock = new ReentrantLock(); new Thread(()->test(lock),"线程A").start(); new Thread(()->test(lock),"线程B").start(); new Thread(()->test(lock),"线程C").start(); } public static void test(ReentrantLock lock){ for (int i = 0; i < 3;i++){ try { lock.lock(); System.out.println(Thread.currentThread().getName()+"获取了锁!"); Thread.sleep(200); }catch (Exception e){ e.printStackTrace(); }finally { lock.unlock(); } } } } 2.执行结果: 3.小结: 非公平锁每个线程获取锁的机会是随机的。 3.3 忽略重复操作 1.代码: public class ReentrantLockTest { private ReentrantLock lock = new ReentrantLock(); public void doSomething(){ if(lock.tryLock()){ try { System.out.println(Thread.currentThread().getName()+"获取了锁!"); Thread.sleep(5); }catch (Exception e){ e.printStackTrace(); }finally { lock.unlock(); } } } public static void main(String[] args) throws Exception { ReentrantLockTest test = new ReentrantLockTest(); for (int i = 0; i < 10;i++){ new Thread(()->{test.doSomething();},"线程"+i).start(); Thread.sleep(1); } } } 2.执行结果: 3.小结: 当线程持有锁时,不会重复执行,可以用来防止定时任务重复执行或者页面事件多次触发时不会重复触发。 3.4 超时不执行 1.代码: public class ReentrantLockTest { public static void main(String[] args) { ReentrantLock lock = new ReentrantLock(); new Thread(()->test(lock),"线程A").start(); new Thread(()->test(lock),"线程B").start(); } public static void test(ReentrantLock lock){ try { if(lock.tryLock(2, TimeUnit.SECONDS)){ try { System.out.println(Thread.currentThread().getName()+"获取了锁!"); Thread.sleep(3000); }finally { lock.unlock(); } } }catch (Exception e){ e.printStackTrace(); } } 2.执行结果: 3.小结: 超时不执行可以防止由于资源处理不当长时间占用资源产生的死锁问题。 4 总结 并发是现在软件系统不可避免的问题,ReentrantLock是可重入的独占锁,比起synchronized功能更加丰富,支持公平锁实现,支持中断响应以及限时等待等,是处理并发问题很好的解决方案。 作者:京东物流 陈昌浩 来源:京东云开发者社区

优秀的个人博客,低调大师

lnmp团队开发环境docker环境搭建

docker-compose-nginx-php-mysql docker-compose+nginx+php+mysql+redis+elasticsearch fox.风 github库 https://github.com/foxiswho/docker-compose-nginx-php-mysql 喜欢的同学可自行下载 版本 php:5.6.x mysql:5.6.x nginx:latest elasticsearch:latest 说明 目前只针对MAC系统的安装,其他系统请自定修改 Volumes 和 Users 目录 安装方式 1.选择要安装的系统和版本 例如:mac系统 php5.6.x版本,进入mac-php56目录 cd mac-php56 2.docker-compose.yml配置更改 选择你需要的功能,不需要的用#号注释掉 3.生成镜像 这个时候 一定不能更换目录。 注意 如果你以前已经配置过一样的容器那么会自动覆盖容器 docker-compose up 时间比较长, 更新源都在国外,最好早晨拉取 nginx 配置文件位置:/etc/nginx/nginx.conf 来源:官方源 php 来源:官方源 php-fpm 配置文件及目录位置 /usr/local/etc/php-fpm.conf /usr/local/etc/php-fpm.d/www.conf /usr/local/etc/php-fpm.d 目录 php.ini 默认加载目录位置 /usr/local/etc/php/conf.d/ 目录 redis 来源:官方源 elasticsearch 来源:官方源 使用教程-MAC系统 新建目录 /Volumes/work/lanmps/vhost/ work:分区名称 lanmps:自定义目录 vhost:nginx 站点配置文件 复制 nginx/default.conf 到 /Volumes/work/lanmps/vhost/ 目录下 1.mac硬盘设置 mac 系统默认硬盘 不区分大小写, 如果需要区分请 按 http://blog.csdn.net/fenglailea/article/details/53083785 此链接中教程 重新分区。 建议分区,我这里是分区的 2.nginx 配置 进入nginx容器 docker exec -it compose_nginx_1 bash compose_nginx_1 容器名字可能不一样 注意 自动生成的名字是根据当前项目目录名字来的。 例如项目目录为mac-php56目录,那么生成容器前缀名字是macphp56_xxxx 配置nginx.conf vim /etc/nginx/nginx.conf 找到如下配置 include /etc/nginx/conf.d/*.conf; 修改为:(根据你自己分区名称置修改) include /Volumes/work/lanmps/vhost/*.conf; 保存和退出容器 3.php 配置 略 跟nginx类似 5.测试 在 /Volumes/work/lanmps/ 目录下 新建 index.php <?php phpinfo(); X.问题 X.1 权限问题 设置 可读写执行权限 chmod -R 777 /Volumes/work/lanmps

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册