首页 文章 精选 留言 我的

精选列表

搜索[AI产设研一体],共10000篇文章
优秀的个人博客,低调大师

开源的Trafodion如何实现事务与分析一体化?

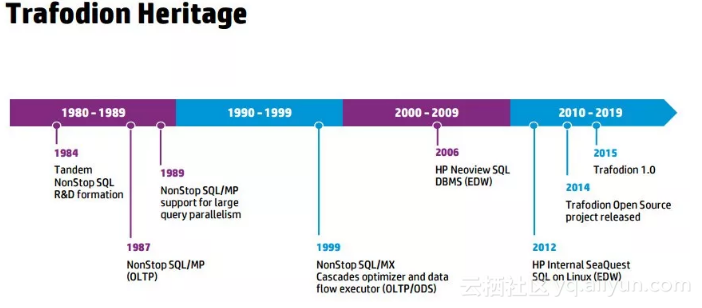
Trafodion是Apache基金会的一个开源项目,提供了一个成熟的企业级SQL-on-HBase解决方案。Trafodion的主要设计思想是处理operational类型的工作负载,或者是传统的OLTP应用。此外,对于需要保证数据一致性、需要标准SQL开发接口,或者需要实时数据读写分析的应用,Trafodion也是一个十分合适的解决方案。 Trafodion的前世今生 Trafodion的渊源可以追溯到数据库技术的“史前时代”。 Trafodion的鼻祖是天腾 (Tandem) 公司的NonStop SQL。之后在1989年,天腾推出了NonStop SQL/MP,它是第一个MPP分布式数据库,实现海量并发SQL执行。在当时的历史条件下,NonStop SQL/MP开创性地提供了线性横向扩展能力(我们如今耳熟能详的scale out)。 1999年,在Graefe Goetz的帮助下,NonStop SQL/MX诞生了,它实现了基于成本的CBO SQL优化器和基于数据流的MPP SQL执行器。2002年,惠普公司和康柏公司合并,已被康柏收购的天腾也成为了惠普的一部分。2006年,NonStop SQL的OLAP分支Neoview诞生,而Trafodion直接继承于Neoview和其后续产品SeaQuest。SeaQuest将Neoview从其专有的硬件,和专有的NonStop OS操作系统中移植到通用的x86服务器和通用的Linux操作系统上 2014年,乘着大数据的浪潮,SeaQuest将底层的数据存储和访问引擎移植到HBase/Hadoop上,并创新地开发出HBase分布式事务处理等新技术,从而推出了Trafodion,并将全部代码开源,贡献给社区。 因此Trafodion是秉承了超过20年的技术积累而诞生的。其成熟的SQL引擎和各种Utility并不是几个技术天才在Google论文的启发下一挥而就,而是经过多年的团队努力和不断创新才得以完成。 Trafodion是一个建立在Hadoop/HBase平台上的关系型数据库,它的Welsh原意是“事务”。Trafodion能够完整地支持ANSI SQL 99标准,并支持ACID事务。基于最新的HBase发行版,Trafodion能够利用HBase的扩展性管理海量数据,并能提供极低的访问延迟。这些特点使得Trafodion成为了一个创新的大数据解决方案。 传统的RDBMS在扩展性上存在瓶颈,无法处理PB级别的海量数据,因此催生了大量的NoSQL数据库。但是NoSQL方案不提供方便的SQL接口,并且放弃了ACID支持。对于需要严格数据一致性的应用,NoSQL一般都无法满足需求。 Hive等SQL on Hadoop项目提供了类似SQL的访问接口,又构建在极具横向扩展能力的Hadoop平台上,既解决了大数据的扩展能力,又提供了用户熟悉的SQL接口。但是它们也存在几方面的问题。 首先,Hive等项目的SQL支持并不完整;其次,Hive等方案在访问数据时,有比较大的延迟,不能支持OLTP或者operational类型的应用。而Impala、Stinger等实时SQL on Hadoop方案则关注于大数据分析,适用于数据只写入一次而多次读取的场景。这类方案一般都无法提供实时修改和写入数据的功能,比如Impala就不支持UPDATE和DELETE语句。 Trafodion结合了传统RDBMS和NoSQL HBase各自的优点,提供了一种全新的数据访问方式。它的主要特性如下: Trafodion是一个企业级的SQL DBMS,能提供所有传统商业RDBMS为用户提供的服务。和传统数据库的区别在于,Trafodion基于Hadoop/HBase构建,能够提供极佳的水平扩展能力。当用户数据量增加时,只需增加普通的计算机节点即可横向扩展存储和计算能力。 Trafodion提供完整的ANSI SQL语言支持,包括DDL、DML、事务控制语句,而不是类似HQL等提供的SQL语言的子集。Trafodion还提供常见的商业数据库才提供的utility,比如数据库备份和恢复。 Trafodion支持UDF和存储过程。 Trafodion提供Linux和Windows版本的ODBC/JDBC驱动。基于ODBC/JDBC的应用可以方便地移植到Trafodion平台上来。 Trafodion采用分布式事务处理算法提供严格的ACID事务一致性保护,采用日志技术保护用户数据在软硬件故障情况下依然可以得到恢复。 Trafodion拥有一个非常成熟的基于成本的SQL优化器 ,针对operational类型的工作负载进行了很多优化。 Trafodion拥有一个MPP并发执行引擎,采用数据流驱动构架,中间数据保存在内存中,不需要将中间数据保存在HDFS上;也不需要MapReduce等模型的启动开销;Trafodion利用LLVM的JIT方式生成运行时代码来解析表达式;利用这些执行器的先进技术,Trafodion保证了毫秒级别的查询响应时间。 Trafodion可以无缝地集成原生的HBase、Hive数据。比如用户可以直接在Trafodion中进行Hbase、Hive和Trafodion的多表join操作。或者利用Trafodion的SQL接口直接访问存放在Hive和HBase的原生数据,无需做数据移动和转换。 支持索引,约束等标准关系数据库特性。提供数据的快速随机访问,并在数据库级别保证数据的一致性。 除了拥有以上介绍的这些技术特性,Trafodion项目完全开源。用户可以直接从 http://trafodion.apache.org 下载使用,无需任何License费用。Trafodion和底层的Linux版本无关,也支持各种Hadoop发行版,因此使用Trafodion,用户可以避免采用商业软件带来的供应商锁定问题。 Trafodion主要应用场景 可以将Trafodion看作是一个构建在可扩展Hadoop平台上的传统数据库。基于此,Trafodion可以有多种适合的应用场景。 首先,Trafodion能够处理海量的数据,数据量超过了传统数据库可以处理的范围。而且Trafodion可以对数据进行随机的增删改查,完整地支持ACID事务。比较适用的应用场景就是物联网应用。 随着道路运输业的飞速发展,道路交通安全事故逐年增加,同时还存在道路运输运营效率低、能耗高、效益产出低等问题,与国外先进水平相比,我国平均油耗要高10%-25%。目前我国绝大多数客运及危化品运输企业车辆运营与监控调度管理水平偏低,设备和平台的合规率比较低,既无法适应政府管理部门相关管理要求,也无法满足企业自身对车辆精细管理的要求。 车联网企业利用大数据和物联网技术,对道路上运行车辆进行实时数据采集和分析,对客运车节能减排监控和驾驶行为进行监测分析。 他们采用Trafodion作为底层数据库,达到了良好的效果。车辆轨迹加载和查询,表大小为133亿。对该表数据的混合加载能力达到每秒8000条,在加载的同时,有300个并发连接查询, 80%的用户查询最近7天内的告警信息,20%用户查询15天内的告警数据,所有查询响应时间均小于1秒。 各类解决方案漫谈 对于NoSQL用户 首先,使用传统数据库的主要限制之一在于数据量增大到一定程度时,数据库在扩展性上遇到瓶颈。比如扩展的成本太大,添加计算和存储节点以及软件License的费用惊人。 因此为了应对快速增加的数据量,很多应用不得不采用前后端Cache缓存、读写分离、分库分表等技术,导致应用程序编写难度增加,维护成本提高。当公司业务蒸蒸日上,数据持续增长的情况下,这些技术手段已使用到了极限,然而应用的性能提升却无法跟上数据增长的速度。 这正是催生大量NoSQL数据库的主要原因。但多数NoSQL数据库为了扩展性而牺牲了SQL的易用性,用户需要使用各种不同的编程语言,学习各种NoSQL的编程方式,比如MongoDB,用户需要学习JavaScript、Ruby或者Python;Riak采用了十分不易书写的REST接口;Cassandra、Redis……不一而足。 即使编程语言对于很多程序员来说并不是问题,但多数NoSQL数据库仅仅提供非常底层的数据读写功能。比如MongoDB不支持Join、key-value数据库不支持聚集操作等等。因此,使用这些简单API的应用开发人员需要花很多精力来完成那些原本是数据库开发人员的任务。 比如做join,可以采用Hash Join、Nest Loop Join或者sort merge join等不同方法,实现这些方法并不是非常简单的事情,而应用程序开发人员需要投入很多精力来实现这些和应用无关的功能,无法专注于更有价值和创新意义的应用开发。况且每一个NoSQL的开发都不是随意学习一两天就可以开始使用的,需要一定的学习曲线。我觉得学习SQL语言比学习MongoDB的开发要简单一点儿。 另外值得一提的是,NoSQL放弃了对ACID事务的支持,而将这些任务都交给应用开发人员处理。而支持事务处理,尤其是分布式情况下的事务和数据一致性是很复杂的事情。 如果你也有类似的困扰,不妨考虑使用Trafodion来解决。 对于关系数据库用户 很多正在使用传统关系数据库的公司和组织,往往已经投入了很多人力物力,开发了大量基于SQL的应用程序。在面对数据量不断增长的情况下,如果迁移到NoSQL,则需要大量的投入,将原有代码抛弃重新开发。如此就势必会遇到前面描述的种种困难,并且过去的投资全都白白浪费了。 而Trafodion本身就是一个关系型数据库,因此从传统数据库应用迁移的成本极低。Trafodion关注于帮助用户解决迁移问题,比如启其开发团队特意为兼容用户原有的Oracle应用而对Trafodion现有的标准SQL做了很多扩展: Sequence Numbers NEXTVAL and CURRVAL oracle syntax PIVOT functionality ROWNUM() function to return sequential numbers for returned 因此当你的应用本身基于关系型数据库,又面临数据量不断增长的困境,不妨考虑采用Trafodion来重用过去的应用,保护过往投资,节约新的投入。 对于Hadoop用户 最后,让我们看看Hadoop生态圈。Hadoop在大数据领域已经成长为最受瞩目的明星,众多公司已经大量使用Hadoop,从各自所拥有的海量数据中挖掘出新的商业价值。 Hadoop的MapReduce非常强大,但其固有的缺点在于:MapReduce仅适于批处理任务,而且开发难度很大。因此HBase、Hive得到了长足的发展。 利用HBase,用户可以在HDFS上进行随机的数据访问。Trafodion正是基于HBase的这种能力构建起来的。然而HBase功能相对简单,基于其进行开发需要学习HBase的专业知识;HBase不支持跨行跨表的ACID事务、不支持二级索引、不支持Join操作、不支持聚集。凡此种种却都是数据应用中非常需要的功能,意味着必须由应用层来自己负责。 Trafodion将以上这些特性一一实现,开发人员可以使用描述性语言SQL,也无需考虑事务一致性,从而可以专心于自身的商业价值开发。因此使用HBase的很多应用场景都可以考虑使用Trafodion来解放开发人员,无需再去实现本应由数据库提供的服务。 再来看看Hive。利用Hive,用户可以使用熟悉的SQL语言来进行Hadoop上的大数据分析。然而传统的Hive仅仅是将SQL语言翻译为MapReduce,因此还是更加适合批处理任务。主要的问题在于MapReduce job的启动成本,Sort/Shuffle将中间计算结果存放在HDFS磁盘上等等,这些因素都限制了Hive查询的响应速度和延迟。 因此标准的Hive使用场景为:定期进行数据的批量加载,再进行批处理计算。这个数据加载周期短则一个小时,长的甚至每天才加载一次数据。更糟糕的是,分析计算本身往往也需要数分钟甚至数小时的时间。因此这种计算模式往往无法满足结果的时效性,而越来越多的应用希望能提供更加实时的计算。 在线广告投放、实时交通状况分析等场景下,1小时前的数据已经降低了分析的可用性,更多的期望是分钟级别甚至秒级的实时性。比如为驾驶员提供道路信息的系统,如果每隔1小时才可以进行分析,那么即使分析计算可以在1秒内完成,其分析的数据却是1小时前的,那么驾驶员已经堵车堵了一小时,这样的系统就失去了意义。 为了满足实时性,一些新的实时分析系统涌现出来。比如Hortonworks的Stinger,采用Tez DAG型计算模型,极大地提高了响应速度,Stinger开发团队声称已经有100倍的性能提高。与此同时,其他的实时解决方案,比如Impala应声而出。Impala不再采用Map Reduce计算模型,而是采用和Trafodion相同的MPP并发执行引擎直接读取HDFS,以此获得极低的数据响应延迟,进而支持实时数据分析。然而Stinger、Impala的底层数据存储,比如ORCFile,Parquet等都无法支持随机写入修改功能。因此即便Stinger和Impala可以提供秒级别的分析响应能力,实时的数据依旧无法立即加载到Stinger和Impala的数据集中,所以Stinger/Impala还是仅仅能够提供准实时的分析能力。 用户期望能够对在线数据进行实时加载、实时分析。而Stinger、Impala虽然可以提供实时分析能力,但无法提供实时加载能力。在这种情况下,Trafodion就是一个十分适合的解决方案。比如用Flume、Storm等对在线数据进行收集和流式处理,将处理后的数据实时加载到Trafodion数据库中,然后利用标准SQL对数据进行实时分析处理。近年来,一些技术能力强大的公司利用Storm+HBase来实现流式、实时计算,效果良好。在这类场景下也可以使用Trafodion替换HBase以便更加高效地使用SQL,而不是HBase Java API来进行开发。 总结 在大数据时代,历史悠久的Trafodion还只是一个新产品,还有很多功能需要逐步完善。本文中提及到的其他技术,各自都很优秀,没有任何一个产品可以替代其他。正如《七周七数据库》的作者所说,一个好的木匠不会只有一种工具。通过本文的简浅介绍,不妨把Trafodion放入你的工具箱,在需要时让它试试身手。 原文发布时间为:2018-06-6 本文作者:刘明 本文来自云栖社区合作伙伴“DBAplus社群”,了解相关信息可以关注“DBAplus社群”。

优秀的个人博客,低调大师

三位一体的工业大数据综述

工业大数据的目的是为了改变以往工业价值链从生产端向消费端、上游向下游推动的模式,实现以客户价值为核心的定制化产品和服务,以及与之相适应的全产业链协同优化。为此,工业大数据应满足用户需求定义、工业智能制造、活动协同优化三方面的应用。 在这些应用中,工业大数据的落地需要与之相适应的技术架构作为支撑。目前,李杰教授提出的“5C”架构体现了工业大数据“数据->知识->应用”的信息架构,而工业互联网参考架构(IIRA)和工业4.0参考架构(RAMI4.0)均是顶层系统架构,还有一些公司企业依据自身的业务提出了自定义的技术架构,如通用的Predix、三一的根云等。 我们知道技术架构应由应用场景的特征来决定,就现状而言,工业大数据还处在产业的初级阶段,对工业大数据应用场景的认知还不太深入,但大数据在互联网的应用已具备成熟的技术体系和应用框架,因此,本文主要通过比较工业应用场景和互联网应用场景的差异性,期望能够修正互联网大数据的相关应用技术框架,以满足工业大数据落地对技术框架的要求。 工业大数据和互联网大数据的技术架构都具备数据环境、知识环境和应用环境三个层,如下图所示。 数据环境 从数据环境来看,首先,互联网大数据和工业大数据具备不同特征。如下表所示: 由于上述对数据的差异性,互联网大数据更多的是关注数据的持久化,其技术架构侧重于实现异构数据的存储、访问的一致性,满足多负载的并行读能力。所以,互联网催生了大量的非关系型数据库、实时数据库、分布式文件存储的技术。 工业大数据同样关注数据持久化,但工业大数据部署应用的一个原则是将应用尽可能部署在离数据产生源越近的地方。这是因为,就近部署其可靠性、实时性越高。需要按照业务需要进行部署,因此,很多应用部署在设备、生产车间等。所以,与互联网大数据集中式存放的方式相比,工业大数据对数据存放更加离散化,在空间中形成跨网的分布式存储,且各数据节点对数据存放、访问的能力要求不一样。比如以在某一公司实施的智能风场项目为例,在风机上部署的采集终端,需要存储结构化且要求实时性高的技术方案;在相应业务端,如生产系统或调度系统,数据是半结构化且实时性要求一般;在公司数据中心,数据是非结构化且需要语义组织。因此,需要抽象和设计一个统一的数据持久化环境,为工业大数据的上层应用提供基于语义的数据发现和相适宜的访问能力。 另外,工业大数据的数据环境,更关注数据采集的能力。工业大数据的数据采集依赖于物联网(IOT)的实现,IOT关注的采集的可靠性,实现数据接入的总线化,但工业大数据对IOT提出了更多的需要。以在某一公司实施的智能风场项目为例,在设计数据采集时,考虑了如下一系列的需要。 一、IOT终端需要具备边缘计算能力,首先是风机高频运行状态数据没必要全部上传,只需要上传从风机运行状态数据提取的相应特征数据,在必要时,如发生故障需要原始数据进行深入分析或者为训练模型需要原始数据,才需要终端上传数据。因此IOT终端需要运行特征提取算法; 二、IOT终端需要具备对采集数据的辨伪能力,需要对数据质量进行预判和修复。在采集风机运行数据时,数据大多是通过传感器,传感器本身存在故障、标定、存在寿命等问题,产生错误数据的概率较大,而坏数据对基于物理关联和因果分析的模型影响相对于互联网应用基于统计分析的影响更高; 三、IOT需要提供更智能的接入能力,形成数据生态环境,因为工业数据不会自发形成,不像互联网一样本身在线,需要解决传感器、物联网、嵌入式智能等在边缘端需要解决的技术问题; 四、IOT需要提供基于语义的定义,是因为作为工业大数据应用的最基本数据产生源,它是物理世界实体的高度抽象,能够映射物理世界实体的特征、实体间的关系,能够发现和被发现,提供互操作性,从而形成物理世界在虚拟世界里的组织和协作能力。 知识环境 工业大数据和互联网大数据都需要对数据进行分析、处理,以获得相应的知识,用以支撑上层业务应用。它们的差异性首先体现在模型特性上面。如下表所示: 由模型的差异性,在工业大数据和互联网大数据应用中,对模型执行的环境要求有很大区别。 目前,在互联网环境中,一般都是基于云平台,使用hadoop生态环境进行搭建,通过流式或离线计算对数据进行处理,采用容器技术运行相应的计算模型,统一对外提供知识数据的访问,其根本是在于其服务或者算法的通用性和可复制性,当一个服务满足不了外部需求,可以通过容器方便的产生副本,扩展其提供外部访问的能力,而微服务、无服务等技术架构更多是基于对服务的结构、协作等的重新定义,来解决服务响应、资源使用、实施、并行等相关非功能特性。而在工业大数据中,绝大多数模型对外提供服务并不用在意访问的并发性,比如风场智能运维系统对某个风机的健康状态评估,使用其评估结果的外部访问仅限于几个终端,毕竟是只有与风机相关的干涉人才会需要。因此,工业大数据应用所需要的模型执行平台关注的是单例执行效率以及类型的扩展性。 另外,工业大数据应用的模型相关性较强。比如,在风场智能运维系统中,对风机的状态评估,依赖于对其组成的多个部件的健康评估,对风机发电效率预测需要结合环境、风机健康状态的结果。因此,工业大数据应用所需要的模型执行平台还需要提供较好的模型执行协作环境。 因此,工业大数据的知识环境的技术平台是CPS,云计算是CPS的一个组成部分。CPS关注的是物理实体映射的逻辑实体的管理,提供逻辑实体的关系、协作,以对称的方式来演进,体现与物理实体的相关性,实现知识的挖掘。 应用环境 互联网大数据的应用可以充分利用云平台相关的技术提供集中式的服务环境,对外以SaaS的方式提供应用功能,但工业大数据的应用多样,既有对物(设备、生产线)的嵌入式应用,也有与传统信息系统相似的应用,如风场的维护排程优化、设备状态监控,也有与互联网大数据应用相同的SaaS应用,如Predix。 因此,工业大数据的应用环境包括了嵌入式环境、单机环境、集群或云平台环境,需要考虑应用支撑环境的多样性统一;其次,工业大数据的应用部署可以在生产一线、控制中心、数据中心等地域分离的地方,其应用环境也需要提供应用跨域的协作能力和应用从故障中恢复的能力;工业大数据的应用环境不仅需要提供服务本身的弹性扩展(并发能力和瞬时负载能力),还需要提供服务的(类型、行为、资源要求)多样性扩展。 总之,由互联网推动的大数据、智能应用等已成熟的技术体系和应用框架,是构建工业大数据应用的最好参考,是工业大数据技术实施的基础。但建立有效的工业大数据应用,离不开工业应用技术的核心——CPS平台,并在相应的信息架构、资源架构等方面,做出合适的设计和实践。 原文发布时间为:2017-10-25 本文作者:朱武 本文来自云栖社区合作伙伴“51CTO”,了解相关信息可以关注。

优秀的个人博客,低调大师

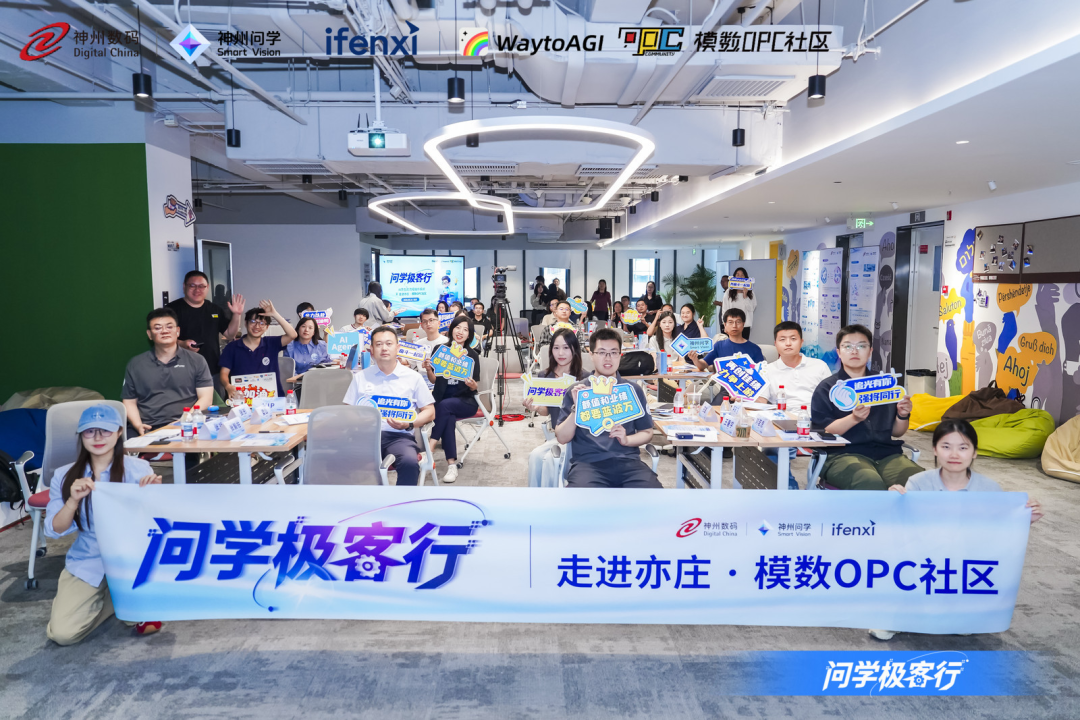
北京经开区信产局指导、爱分析联合主办,问学极客行走进亦庄

9 月 16 日,神州问学发起的城市巡回技术沙龙"问学极客行"走进北京亦庄·模数 OPC 社区。本次活动由北京经济技术开发区信息技术产业局指导,神州问学主办,爱分析、WaytoAGI 模数 OPC 社区联合主办,神州数码通明湖研究院提供智库支持。本次活动聚焦"Agent 如何接进企业系统、跑通真实任务"这一核心命题,以主题分享与圆桌对话两种形式展开。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册