首页 文章 精选 留言 我的

精选列表

搜索[基础模型],共10000篇文章
优秀的个人博客,低调大师

Go 语言读写 Excel 基础库

Excelize 是 Go 语言编写的一个用来操作 Office Excel 文档类库,基于 ECMA-376 Office OpenXML 标准。可以使用它来读取、写入 XLSX 文件。相比较其他的开源类库,Excelize 支持写入原本带有图片(表)的文档,还支持向 Excel 中插入图片,并且在保存后不会丢失图表样式。 安装 go get github.com/xuri/excelize/v2 创建 XLSX package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { f := excelize.NewFile() // Create a new sheet. index := f.NewSheet("Sheet2") // Set value of a cell. f.SetCellValue("Sheet2", "A2", "Hello world.") f.SetCellValue("Sheet1", "B2", 100) // Set active sheet of the workbook. f.SetActiveSheet(index) // Save xlsx file by the given path. err := f.SaveAs("./Book1.xlsx") if err != nil { fmt.Println(err) } } 读取已有文档 package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { f, err := excelize.OpenFile("./Book1.xlsx") if err != nil { fmt.Println(err) return } // Get value from cell by given worksheet name and axis. cell, err := f.GetCellValue("Sheet1", "B2") if err != nil { fmt.Println(err) return } fmt.Println(cell) // Get all the rows in the Sheet1. rows, err := f.GetRows("Sheet1") for _, row := range rows { for _, colCell := range row { fmt.Print(colCell, "\t") } fmt.Println() } } 向 Excel 中插入图表 package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { categories := map[string]string{"A2": "Small", "A3": "Normal", "A4": "Large", "B1": "Apple", "C1": "Orange", "D1": "Pear"} values := map[string]int{"B2": 2, "C2": 3, "D2": 3, "B3": 5, "C3": 2, "D3": 4, "B4": 6, "C4": 7, "D4": 8} f := excelize.NewFile() for k, v := range categories { f.SetCellValue("Sheet1", k, v) } for k, v := range values { f.SetCellValue("Sheet1", k, v) } err := f.AddChart("Sheet1", "E1", `{"type":"col3DClustered","series":[{"name":"Sheet1!$A$2","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$2:$D$2"},{"name":"Sheet1!$A$3","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$3:$D$3"},{"name":"Sheet1!$A$4","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$4:$D$4"}],"title":{"name":"Fruit 3D Clustered Column Chart"}}`) if err != nil { fmt.Println(err) return } // Save xlsx file by the given path. err = f.SaveAs("./Book1.xlsx") if err != nil { fmt.Println(err) } } 向 Excel 中插入图片 package main import ( "fmt" _ "image/gif" _ "image/jpeg" _ "image/png" "github.com/xuri/excelize/v2" ) func main() { f, err := excelize.OpenFile("./Book1.xlsx") if err != nil { fmt.Println(err) return } // Insert a picture. err = f.AddPicture("Sheet1", "A2", "./image1.png", "") if err != nil { fmt.Println(err) } // Insert a picture to worksheet with scaling. err = f.AddPicture("Sheet1", "D2", "./image2.jpg", `{"x_scale": 0.5, "y_scale": 0.5}`) if err != nil { fmt.Println(err) } // Insert a picture offset in the cell with printing support. err = f.AddPicture("Sheet1", "H2", "./image3.gif", `{"x_offset": 15, "y_offset": 10, "print_obj": true, "lock_aspect_ratio": false, "locked": false}`) if err != nil { fmt.Println(err) } // Save the xlsx file with the origin path. err = f.Save() if err != nil { fmt.Println(err) } } 还有其他一些功能,在这里就不一一列举了,详细使用文档以及获取后期的维护更新可以从项目的主页获取 github.com/xuri/excelize

优秀的个人博客,低调大师

GaussDB SQL基础语法-变量&常量

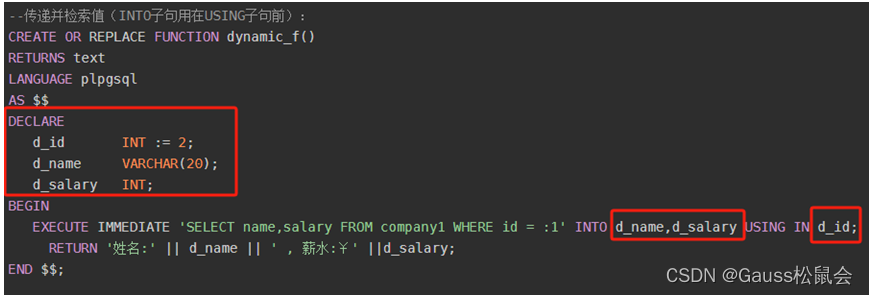
一、前言 SQL是用于访问和处理数据库的标准计算机语言。GaussDB支持SQL标准(默认支持SQL2、SQL3和SQL4的主要特性)。 本系列将以《云数据库GaussDB—SQL参考》在线文档为主线进行介绍。 二、GaussDB数据库中的常量和变量的基本概述及语法定义 数据库中的变量和常量是两种重要的数据使用类型。变量是可以变化和被修改的,而常量则是固定不变,不能被修改的。 1、变量定义 在GaussDB中,变量是用于存储可变值的数据类型。变量通常在程序中定义,并在执行期间可以更改其值。在GaussDB中,可以使用以下语法来定义变量: DECLARE variable_name data_type; 其中,variable_name 是变量的名称,data_type 是变量的数据类型。例如,要定义一个名为 my_variable 的整数变量,可以使用以下语句: DECLARE my_variable INT; 2、常量定义 在GaussDB中,常量用于存储固定值的数据类型。常量在程序中定义后,其值不能被修改。在GaussDB中,可以使用以下语法来定义常量: DECLARE constant_name data_type = constant_value; 其中,constant_name 是常量的名称,data_type 是常量的数据类型,constant_value 是常量的值。例如,要定义一个名为 my_constant 的整数常量,可以使用以下语句: DECLARE my_constant INT = 10; 这将定义一个名为 my_constant 的整数常量,其值为 10。 请注意,这只是GaussDB中定义变量和常量的基本语法。具体建议参考GaussDB的官方文档或相关资料以获取更详细信息。 3、其他(%TYPE、%ROWTYPE属性) 变量类型除了支持基本类型,还可使用%TYPE和%ROWTYPE去声明一些与其他表字段或表结构本身相关的变量。 %TYPE属性: %TYPE主要用于声明某个与其他变量类型(例如,表中某列的类型)相同的变量。假如我们想定义一个my_name变量,它的变量类型与employee的firstname类型相同,我们可以通过如下定义: `--使用某列的属性声明 DECLARE my_name employee.firstname%TYPE --使用其他变量的属性声明 DECLARE name VARCHAR(10) NOT NULL := 'ZhangSan'; surname name%TYPE := 'LiSi';` 这样定义可以带来两个好处,首先,我们不用预先知道employee 表的firstname类型具体是什么。其次,即使之后firstname类型有了变化,我们也不需要再次修改my_name的类型。 %ROWTYPE属性: %ROWTYPE属性主要用于对一组数据的类型声明,用于存储表中的一行数据,或从游标匹配的结果。假如,我们需要一组数据,该组数据的字段名称与字段类型都与employee表相同。我们可以通过如下定义: --根据表employee表结构定义变量类型 DECLARE my_employee employee%ROWTYPE 三、在GaussDB数据库中如何使用变量&常量(示例) 变量&常量一般在数据库中不能直接应用到简单的SQL语句中,而是常常用于自定义的函数、存储过程中。下文简单举一列子(可参考前面FUNCTION/PROCEDURE等相关文章): 示例一,定义常量&变量(创建动态语句) 常量作为WHERE 条件之一;变量存储查询的结果值。 示例二,定义变量(创建游标) 定义变量,存储游标结果值 示例三,定义变量(创建package属性重载函数) 定义TEXT类型变量、赋值SQL语句 四、小结 在GaussDB数据库中,变量和常量是两种不同的数据存储方式。变量是用于存储可变值的数据类型,可以在程序执行期间更改其值。而常量则是用于存储固定值的数据类型,其值在定义后不能被修改。 在GaussDB中,可以使用DECLARE语句来定义变量和常量,并通过使用“:=”运算符来为它们赋值。正确地定义和使用变量和常量可以提高程序的灵活性和可维护性,并确保数据的准确性和完整性。 ——结束

优秀的个人博客,低调大师

ElasticSearch必知必会-基础篇

京东物流 康睿 姚再毅 李振 刘斌 王北永 说明:以下全部均基于eslaticsearch 8.1 版本 一.索引的定义 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/indices.html 索引的全局认知 ElasticSearch Mysql Index Table Type废弃 Table废弃 Document Row Field Column Mapping Schema Everything is indexed Index Query DSL SQL GET http://... select * from POST http://... update table set ... Aggregations group by\sum\sum cardinality 去重 distinct reindex 数据迁移 索引的定义 定义: 相同文档结构(Mapping)文档的结合 由唯一索引名称标定 一个集群中有多个索引 不同的索引代表不同的业务类型数据 注意事项: 索引名称不支持大写 索引名称最大支持255个字符长度 字段的名称,支持大写,不过建议全部统一小写 索引的创建 ​ index-settings 参数解析 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/index-modules.html 注意: 静态参数索引创建后,不再可以修改,动态参数可以修改 思考: 一、为什么主分片创建后不可修改? A document is routed to a particular shard in an index using the following formula: <shard_num = hash(_routing) % num_primary_shards> the defalue value userd for _routing is the document`s _id es中写入数据,是根据上述的公式计算文档应该存储在哪个分片中,后续的文档读取也是根据这个公式,一旦分片数改变,数据也就找不到了 简单理解 根据ID做Hash 然后再 除以 主分片数 取余,被除数改变,结果就不一样了 二、如果业务层面根据数据情况,确实需要扩展主分片数,那怎么办? reindex 迁移数据到另外一个索引 https://www.elastic.co/guide/en/elasticsearch/reference/8.1/docs-reindex.html ​ 索引的基本操作 ​ 二.Mapping-Param之dynamic 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/dynamic.html 核心功能 自动检测字段类型后添加字段 也就是哪怕你没有在es的mapping中定义该字段,es也会动态的帮你检测字段类型 初识dynamic // 删除test01索引,保证这个索引现在是干净的 DELETE test01 // 不定义mapping,直接一条插入数据试试看, POST test01/_doc/1 { "name":"kangrui10" } // 然后我们查看test01该索引的mapping结构 看看name这个字段被定义成了什么类型 // 由此可以看出,name一级为text类型,二级定义为keyword,但其实这并不是我们想要的结果, // 我们业务查询中name字段并不会被分词查询,一般都是全匹配(and name = xxx) // 以下的这种结果,我们想要实现全匹配 就需要 name.keyword = xxx 反而麻烦 GET test01/_mapping { "test01" : { "mappings" : { "properties" : { "name" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } } } } } } dynamic的可选值 可选值 说明 解释 true New fields are added to the mapping (default). 创建mapping时,如果不指定dynamic的值,默认true,即如果你的字段没有收到指定类型,就会es帮你动态匹配字段类型 false New fields are ignored. These fields will not be indexed or searchable, but will still appear in the _source field of returned hits. These fields will not be added to the mapping, and new fields must be added explicitly. 若设置为false,如果你的字段没有在es的mapping中创建,那么新的字段,一样可以写入,但是不能被查询,mapping中也不会有这个字段,也就是被写入的字段,不会被创建索引 strict If new fields are detected, an exception is thrown and the document is rejected. New fields must be explicitly added to the mapping. 若设置为strict,如果新的字段,没有在mapping中创建字段,添加会直接报错,生产环境推荐,更加严谨。示例如下,如要新增字段,就必须手动的新增字段 动态映射的弊端 字段匹配相对准确,但不一定是用户期望的 比如现在有一个text字段,es只会给你设置为默认的standard分词器,但我们一般需要的是ik中文分词器 占用多余的存储空间 string类型匹配为text和keyword两种类型,意味着会占用更多的存储空间 mapping爆炸 如果不小心写错了查询语句,get用成了put误操作,就会错误创建很多字段 三.Mapping-Param之doc_values 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/doc-values.html 核心功能 DocValue其实是Lucene在构建倒排索引时,会额外建立一个有序的正排索引(基于document => field value的映射列表) DocValue本质上是一个序列化的 列式存储,这个结构非常适用于聚合(aggregations)、排序(Sorting)、脚本(scripts access to field)等操作。而且,这种存储方式也非常便于压缩,特别是数字类型。这样可以减少磁盘空间并且提高访问速度。 几乎所有字段类型都支持DocValue,除了text和annotated_text字段。 何为正排索引 正排索引其实就是类似于数据库表,通过id和数据进行关联,通过搜索文档id,来获取对应的数据 doc_values可选值 true:默认值,默认开启 false:需手动指定,设置为false后,sort、aggregate、access the field from script将会无法使用,但会节省磁盘空间 真题演练 // 创建一个索引,test03,字段满足以下条件 // 1. speaker: keyword // 2. line_id: keyword and not aggregateable // 3. speech_number: integer PUT test03 { "mappings": { "properties": { "speaker": { "type": "keyword" }, "line_id":{ "type": "keyword", "doc_values": false }, "speech_number":{ "type": "integer" } } } } 四.分词器analyzers ik中文分词器安装 https://github.com/medcl/elasticsearch-analysis-ik 何为倒排索引 ​ 数据索引化的过程 ​ 分词器的分类 官网地址: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-analyzers.html ​ 五.自定义分词 自定义分词器三段论 1.Character filters 字符过滤 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-charfilters.html 可配置0个或多个 HTML Strip Character Filter:用途:删除HTML元素,如 <b>,并解 码HTML实体,如&amp Mapping Character Filter:用途:替换指定字符 Pattern Replace Character Filter:用途:基于正则表达式替换指定字符 2.Tokenizer 文本切为分词 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-tokenizers.html#_word_oriented_tokenizers 只能配置一个 用分词器对文本进行分词 3.Token filters 分词后再过滤 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-tokenfilters.html 可配置0个或多个 分词后再加工,比如转小写、删除某些特殊的停用词、增加同义词等 真题演练 有一个文档,内容类似 dag & cat, 要求索引这个文档,并且使用match_parase_query, 查询dag & cat 或者 dag and cat,都能够查到 题目分析: 1.何为match_parase_query:match_phrase 会将检索关键词分词。match_phrase的分词结果必须在被检索字段的分词中都包含,而且顺序必须相同,而且默认必须都是连续的。 2.要实现 & 和 and 查询结果要等价,那么就需要自定义分词器来实现了,定制化的需求 3.如何自定义一个分词器:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-custom-analyzer.html 4.解法1核心使用功能点,Mapping Character Filter 5.解法2核心使用功能点,https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-synonym-tokenfilter.html 解法1 # 新建索引 PUT /test01 { "settings": { "analysis": { "analyzer": { "my_analyzer": { "char_filter": [ "my_mappings_char_filter" ], "tokenizer": "standard", } }, "char_filter": { "my_mappings_char_filter": { "type": "mapping", "mappings": [ "& => and" ] } } } }, "mappings": { "properties": { "content":{ "type": "text", "analyzer": "my_analyzer" } } } } // 说明 // 三段论之Character filters,使用char_filter进行文本替换 // 三段论之Token filters,使用默认分词器 // 三段论之Token filters,未设定 // 字段content 使用自定义分词器my_analyzer # 填充测试数据 PUT test01/_bulk {"index":{"_id":1}} {"content":"doc & cat"} {"index":{"_id":2}} {"content":"doc and cat"} # 执行测试,doc & cat || oc and cat 结果输出都为两条 POST test01/_search { "query": { "bool": { "must": [ { "match_phrase": { "content": "doc & cat" } } ] } } } 解法2 # 解题思路,将& 和 and 设定为同义词,使用Token filters # 创建索引 PUT /test02 { "settings": { "analysis": { "analyzer": { "my_synonym_analyzer": { "tokenizer": "whitespace", "filter": [ "my_synonym" ] } }, "filter": { "my_synonym": { "type": "synonym", "lenient": true, "synonyms": [ "& => and" ] } } } }, "mappings": { "properties": { "content": { "type": "text", "analyzer": "my_synonym_analyzer" } } } } // 说明 // 三段论之Character filters,未设定 // 三段论之Token filters,使用whitespace空格分词器,为什么不用默认分词器?因为默认分词器会把&分词后剔除了,就无法在去做分词后的过滤操作了 // 三段论之Token filters,使用synony分词后过滤器,对&和and做同义词 // 字段content 使用自定义分词器my_synonym_analyzer # 填充测试数据 PUT test02/_bulk {"index":{"_id":1}} {"content":"doc & cat"} {"index":{"_id":2}} {"content":"doc and cat"} # 执行测试 POST test02/_search { "query": { "bool": { "must": [ { "match_phrase": { "content": "doc & cat" } } ] } } } 六.multi-fields 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/multi-fields.html // 单字段多类型,比如一个字段我想设置两种分词器 PUT my-index-000001 { "mappings": { "properties": { "city": { "type": "text", "analyzer":"standard", "fields": { "fieldText": { "type": "text", "analyzer":"ik_smart", } } } } } } 七.runtime_field 运行时字段 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime.html 产生背景 假如业务中需要根据某两个数字类型字段的差值来排序,也就是我需要一个不存在的字段, 那么此时应该怎么办? 当然你可以刷数,新增一个差值结果字段来实现,假如此时不允许你刷数新增字段怎么办? 解决方案 ​ 应用场景 在不重新建立索引的情况下,向现有文档新增字段 在不了解数据结构的情况下处理数据 在查询时覆盖从原索引字段返回的值 为特定用途定义字段而不修改底层架构 功能特性 Lucene完全无感知,因没有被索引化,没有doc_values 不支持评分,因为没有倒排索引 打破传统先定义后使用的方式 能阻止mapping爆炸 增加了API的灵活性 注意,会使得搜索变慢 实际使用 运行时检索指定,即检索环节可使用(也就是哪怕mapping中没有这个字段,我也可以查询) 动态或静态mapping指定,即mapping环节可使用(也就是在mapping中添加一个运行时的字段) 真题演练1 # 假定有以下索引和数据 PUT test03 { "mappings": { "properties": { "emotion": { "type": "integer" } } } } POST test03/_bulk {"index":{"_id":1}} {"emotion":2} {"index":{"_id":2}} {"emotion":5} {"index":{"_id":3}} {"emotion":10} {"index":{"_id":4}} {"emotion":3} # 要求:emotion > 5, 返回emotion_falg = '1', # 要求:emotion < 5, 返回emotion_falg = '-1', # 要求:emotion = 5, 返回emotion_falg = '0', 解法1 检索时指定运行时字段: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime-search-request.html 该字段本质上是不存在的,所以需要检索时要加上 fields * GET test03/_search { "fields": [ "*" ], "runtime_mappings": { "emotion_falg": { "type": "keyword", "script": { "source": """ if(doc['emotion'].value>5)emit('1'); if(doc['emotion'].value<5)emit('-1'); if(doc['emotion'].value==5)emit('0'); """ } } } } 解法2 创建索引时指定运行时字段:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime-mapping-fields.html 该方式支持通过运行时字段做检索 # 创建索引并指定运行时字段 PUT test03_01 { "mappings": { "runtime": { "emotion_falg": { "type": "keyword", "script": { "source": """ if(doc['emotion'].value>5)emit('1'); if(doc['emotion'].value<5)emit('-1'); if(doc['emotion'].value==5)emit('0'); """ } } }, "properties": { "emotion": { "type": "integer" } } } } # 导入测试数据 POST test03_01/_bulk {"index":{"_id":1}} {"emotion":2} {"index":{"_id":2}} {"emotion":5} {"index":{"_id":3}} {"emotion":10} {"index":{"_id":4}} {"emotion":3} # 查询测试 GET test03_01/_search { "fields": [ "*" ] } 真题演练2 # 有以下索引和数据 PUT test04 { "mappings": { "properties": { "A":{ "type": "long" }, "B":{ "type": "long" } } } } PUT task04/_bulk {"index":{"_id":1}} {"A":100,"B":2} {"index":{"_id":2}} {"A":120,"B":2} {"index":{"_id":3}} {"A":120,"B":25} {"index":{"_id":4}} {"A":21,"B":25} # 需求:在task04索引里,创建一个runtime字段,其值是A-B,名称为A_B; 创建一个range聚合,分为三级:小于0,0-100,100以上;返回文档数 // 使用知识点: // 1.检索时指定运行时字段: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime-search-request.html // 2.范围聚合 https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-bucket-range-aggregation.html 解法 # 结果测试 GET task04/_search { "fields": [ "*" ], "size": 0, "runtime_mappings": { "A_B": { "type": "long", "script": { "source": """ emit(doc['A'].value - doc['B'].value); """ } } }, "aggs": { "price_ranges_A_B": { "range": { "field": "A_B", "ranges": [ { "to": 0 }, { "from": 0, "to": 100 }, { "from": 100 } ] } } } } 八.Search-highlighted highlighted语法初识 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/highlighting.html ​ 九.Search-Order Order语法初识 官网文档地址: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/sort-search-results.html // 注意:text类型默认是不能排或聚合的,如果非要排序或聚合,需要开启fielddata GET /kibana_sample_data_ecommerce/_search { "query": { "match": { "customer_last_name": "wood" } }, "highlight": { "number_of_fragments": 3, "fragment_size": 150, "fields": { "customer_last_name": { "pre_tags": [ "<em>" ], "post_tags": [ "</em>" ] } } }, "sort": [ { "currency": { "order": "desc" }, "_score": { "order": "asc" } } ] } 十.Search-Page page语法初识 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/paginate-search-results.html # 注意 from的起始值是 0 不是 1 GET kibana_sample_data_ecommerce/_search { "from": 5, "size": 20, "query": { "match": { "customer_last_name": "wood" } } } 真题演练1 # 题目 In the spoken lines of the play, highlight the word Hamlet (int the text_entry field) startint the highlihnt with "#aaa#" and ending it with "#bbb#" return all of speech_number field lines in reverse order; '20' speech lines per page,starting from line '40' # highlight 处理 text_entry 字段 ; 关键词 Hamlet 高亮 # page分页:from:40;size:20 # speech_number:倒序 POST test09/_search { "from": 40, "size": 20, "query": { "bool": { "must": [ { "match": { "text_entry": "Hamlet" } } ] } }, "highlight": { "fields": { "text_entry": { "pre_tags": [ "#aaa#" ], "post_tags": [ "#bbb#" ] } } }, "sort": [ { "speech_number.keyword": { "order": "desc" } } ] } 十一.Search-AsyncSearch 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/async-search.html 发行版本 7.7.0 适用场景 允许用户在异步搜索结果时可以检索,从而消除了仅在查询完成后才等待最终响应的情况 常用命令 执行异步检索 POST /sales*/_async_search?size=0 查看异步检索 GET /_async_search/id值 查看异步检索状态 GET /_async_search/id值 删除、终止异步检索 DELETE /_async_search/id值 异步查询结果说明 返回值 含义 id 异步检索返回的唯一标识符 is_partial 当查询不再运行时,指示再所有分片上搜索是成功还是失败。在执行查询时,is_partial=true is_running 搜索是否仍然再执行 total 将在多少分片上执行搜索 successful 有多少分片已经成功完成搜索 十二.Aliases索引别名 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/aliases.html Aliases的作用 在ES中,索引别名(index aliases)就像一个快捷方式或软连接,可以指向一个或多个索引。别名带给我们极大的灵活性,我们可以使用索引别名实现以下功能: 在一个运行中的ES集群中无缝的切换一个索引到另一个索引上(无需停机) 分组多个索引,比如按月创建的索引,我们可以通过别名构造出一个最近3个月的索引 查询一个索引里面的部分数据构成一个类似数据库的视图(views 假设没有别名,如何处理多索引的检索 方式1:POST index_01,index_02.index_03/_search 方式2:POST index*/search 创建别名的三种方式 创建索引的同时指定别名 # 指定test05的别名为 test05_aliases PUT test05 { "mappings": { "properties": { "name":{ "type": "keyword" } } }, "aliases": { "test05_aliases": {} } } 使用索引模板的方式指定别名 PUT _index_template/template_1 { "index_patterns": ["te*", "bar*"], "template": { "settings": { "number_of_shards": 1 }, "mappings": { "_source": { "enabled": true }, "properties": { "host_name": { "type": "keyword" }, "created_at": { "type": "date", "format": "EEE MMM dd HH:mm:ss Z yyyy" } } }, "aliases": { "mydata": { } } }, "priority": 500, "composed_of": ["component_template1", "runtime_component_template"], "version": 3, "_meta": { "description": "my custom" } } 对已有的索引创建别名 POST _aliases { "actions": [ { "add": { "index": "logs-nginx.access-prod", "alias": "logs" } } ] } 删除别名 POST _aliases { "actions": [ { "remove": { "index": "logs-nginx.access-prod", "alias": "logs" } } ] } 真题演练1 # Define an index alias for 'accounts-row' called 'accounts-male': Apply a filter to only show the male account owners # 为'accounts-row'定义一个索引别名,称为'accounts-male':应用一个过滤器,只显示男性账户所有者 POST _aliases { "actions": [ { "add": { "index": "accounts-row", "alias": "accounts-male", "filter": { "bool": { "filter": [ { "term": { "gender.keyword": "male" } } ] } } } } ] } 十三.Search-template 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-template.html 功能特点 模板接受在运行时指定参数。搜索模板存储在服务器端,可以在不更改客户端代码的情况下进行修改。 初识search-template # 创建检索模板 PUT _scripts/my-search-template { "script": { "lang": "mustache", "source": { "query": { "match": { "{{query_key}}": "{{query_value}}" } }, "from": "{{from}}", "size": "{{size}}" } } } # 使用检索模板查询 GET my-index/_search/template { "id": "my-search-template", "params": { "query_key": "your filed", "query_value": "your filed value", "from": 0, "size": 10 } } 索引模板的操作 创建索引模板 PUT _scripts/my-search-template { "script": { "lang": "mustache", "source": { "query": { "match": { "message": "{{query_string}}" } }, "from": "{{from}}", "size": "{{size}}" }, "params": { "query_string": "My query string" } } } 验证索引模板 POST _render/template { "id": "my-search-template", "params": { "query_string": "hello world", "from": 20, "size": 10 } } 执行检索模板 GET my-index/_search/template { "id": "my-search-template", "params": { "query_string": "hello world", "from": 0, "size": 10 } } 获取全部检索模板 GET _cluster/state/metadata?pretty&filter_path=metadata.stored_scripts 删除检索模板 DELETE _scripts/my-search-templateath=metadata.stored_scripts 十四.Search-dsl 简单检索 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl.html 检索选型 ​ 检索分类 ​ 自定义评分 如何自定义评分 ​ 1.index Boost索引层面修改相关性 // 一批数据里,有不同的标签,数据结构一致,不同的标签存储到不同的索引(A、B、C),最后要严格按照标签来分类展示的话,用什么查询比较好? // 要求:先展示A类,然后B类,然后C类 # 测试数据如下 put /index_a_123/_doc/1 { "title":"this is index_a..." } put /index_b_123/_doc/1 { "title":"this is index_b..." } put /index_c_123/_doc/1 { "title":"this is index_c..." } # 普通不指定的查询方式,该查询方式下,返回的三条结果数据评分是相同的 POST index_*_123/_search { "query": { "bool": { "must": [ { "match": { "title": "this" } } ] } } } 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-search.html indices_boost # 也就是索引层面提升权重 POST index_*_123/_search { "indices_boost": [ { "index_a_123": 10 }, { "index_b_123": 5 }, { "index_c_123": 1 } ], "query": { "bool": { "must": [ { "match": { "title": "this" } } ] } } } 2.boosting 修改文档相关性 某索引index_a有多个字段, 要求实现如下的查询: 1)针对字段title,满足'ssas'或者'sasa’。 2)针对字段tags(数组字段),如果tags字段包含'pingpang', 则提升评分。 要求:写出实现的DSL? # 测试数据如下 put index_a/_bulk {"index":{"_id":1}} {"title":"ssas","tags":"basketball"} {"index":{"_id":2}} {"title":"sasa","tags":"pingpang; football"} # 解法1 POST index_a/_search { "query": { "bool": { "must": [ { "bool": { "should": [ { "match": { "title": "ssas" } }, { "match": { "title": "sasa" } } ] } } ], "should": [ { "match": { "tags": { "query": "pingpang", "boost": 1 } } } ] } } } # 解法2 // https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-function-score-query.html POST index_a/_search { "query": { "bool": { "should": [ { "function_score": { "query": { "match": { "tags": { "query": "pingpang" } } }, "boost": 1 } } ], "must": [ { "bool": { "should": [ { "match": { "title": "ssas" } }, { "match": { "title": "sasa" } } ] } } ] } } } 3.negative_boost降低相关性 对于某些结果不满意,但又不想通过 must_not 排除掉,可以考虑可以考虑boosting query的negative_boost。 即:降低评分 negative_boost (Required, float) Floating point number between 0 and 1.0 used to decrease the relevance scores of documents matching the negative query. 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-boosting-query.html POST index_a/_search { "query": { "boosting": { "positive": { "term": { "tags": "football" } }, "negative": { "term": { "tags": "pingpang" } }, "negative_boost": 0.5 } } } 4.function_score 自定义评分 如何同时根据 销量和浏览人数进行相关度提升? 问题描述:针对商品,例如有想要有一个提升相关度的计算,同时针对销量和浏览人数? 例如oldScore*(销量+浏览人数) ************************** 商品 销量 浏览人数 A 10 10 B 20 20 C 30 30 ************************** # 示例数据如下 put goods_index/_bulk {"index":{"_id":1}} {"name":"A","sales_count":10,"view_count":10} {"index":{"_id":2}} {"name":"B","sales_count":20,"view_count":20} {"index":{"_id":3}} {"name":"C","sales_count":30,"view_count":30} 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-function-score-query.html 知识点:script_score POST goods_index/_search { "query": { "function_score": { "query": { "match_all": {} }, "script_score": { "script": { "source": "_score * (doc['sales_count'].value+doc['view_count'].value)" } } } } } 十五.Search-del Bool复杂检索 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-bool-query.html 基本语法 ​ 真题演练 写一个查询,要求某个关键字再文档的四个字段中至少包含两个以上 功能点:bool 查询,should / minimum_should_match 1.检索的bool查询 2.细节点 minimum_should_match 注意:minimum_should_match 当有其他子句的时候,默认值为0,当没有其他子句的时候默认值为1 POST test_index/_search { "query": { "bool": { "should": [ { "match": { "filed1": "kr" } }, { "match": { "filed2": "kr" } }, { "match": { "filed3": "kr" } }, { "match": { "filed4": "kr" } } ], "minimum_should_match": 2 } } } 十六.Search-Aggregations 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations.html 聚合分类 ​ ​ 分桶聚合(bucket) terms 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-bucket-terms-aggregation.html # 按照作者统计文档数 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "agg_user": { "terms": { "field": "user", "size": 1 } } } } date_histogram 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-bucket-datehistogram-aggregation.html # 按照up_time 按月进行统计 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "agg_up_time": { "date_histogram": { "field": "up_time", "calendar_interval": "month" } } } } 指标聚合 (metrics) Max 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-metrics-max-aggregation.html # 获取up_time最大的 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "agg_max_up_time": { "max": { "field": "up_time" } } } } Top_hits 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-metrics-top-hits-aggregation.html # 根据user聚合只取一个聚合结果,并且获取命中数据的详情前3条,并按照指定字段排序 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "terms_agg_user": { "terms": { "field": "user", "size": 1 }, "aggs": { "top_user_hits": { "top_hits": { "_source": { "includes": [ "video_time", "title", "see", "user", "up_time" ] }, "sort": [ { "see":{ "order": "desc" } } ], "size": 3 } } } } } } // 返回结果如下 { "took" : 91, "timed_out" : false, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : { "value" : 1000, "relation" : "eq" }, "max_score" : null, "hits" : [ ] }, "aggregations" : { "terms_agg_user" : { "doc_count_error_upper_bound" : 0, "sum_other_doc_count" : 975, "buckets" : [ { "key" : "Elastic搜索", "doc_count" : 25, "top_user_hits" : { "hits" : { "total" : { "value" : 25, "relation" : "eq" }, "max_score" : null, "hits" : [ { "_index" : "bilili_elasticsearch", "_id" : "5ccCVoQBUyqsIDX6wIcm", "_score" : null, "_source" : { "video_time" : "03:45", "see" : "92", "up_time" : "2021-03-19", "title" : "Elastic 社区大会2021: 用加 Gatling 进行Elasticsearch的负载测试,寓教于乐。", "user" : "Elastic搜索" }, "sort" : [ "92" ] }, { "_index" : "bilili_elasticsearch", "_id" : "8scCVoQBUyqsIDX6wIgn", "_score" : null, "_source" : { "video_time" : "10:18", "see" : "79", "up_time" : "2020-10-20", "title" : "为Elasticsearch启动htpps访问", "user" : "Elastic搜索" }, "sort" : [ "79" ] }, { "_index" : "bilili_elasticsearch", "_id" : "7scCVoQBUyqsIDX6wIcm", "_score" : null, "_source" : { "video_time" : "04:41", "see" : "71", "up_time" : "2021-03-19", "title" : "Elastic 社区大会2021: Elasticsearch作为一个地理空间的数据库", "user" : "Elastic搜索" }, "sort" : [ "71" ] } ] } } } ] } } } 子聚合 (Pipeline) Pipeline:基于聚合的聚合 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-pipeline.html bucket_selector 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-pipeline-bucket-selector-aggregation.html # 根据order_date按月分组,并且求销售总额大于1000 POST kibana_sample_data_ecommerce/_search { "size": 0, "aggs": { "date_his_aggs": { "date_histogram": { "field": "order_date", "calendar_interval": "month" }, "aggs": { "sum_aggs": { "sum": { "field": "total_unique_products" } }, "sales_bucket_filter": { "bucket_selector": { "buckets_path": { "totalSales": "sum_aggs" }, "script": "params.totalSales > 1000" } } } } } } 真题演练 earthquakes索引中包含了过去30个月的地震信息,请通过一句查询,获取以下信息 l 过去30个月,每个月的平均 mag l 过去30个月里,平均mag最高的一个月及其平均mag l 搜索不能返回任何文档 max_bucket 官网地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-pipeline-max-bucket-aggregation.html POST earthquakes/_search { "size": 0, "query": { "range": { "time": { "gte": "now-30M/d", "lte": "now" } } }, "aggs": { "agg_time_his": { "date_histogram": { "field": "time", "calendar_interval": "month" }, "aggs": { "avg_aggs": { "avg": { "field": "mag" } } } }, "max_mag_sales": { "max_bucket": { "buckets_path": "agg_time_his>avg_aggs" } } } }
优秀的个人博客,低调大师

自定义 WorkManager —— 基础概念

WorkManager是一个Android Jetpack扩展库,它可以让您轻松规划那些可延后、异步但又需要可靠运行的任务。对于绝大部分后台执行任务来说,使用 WorkManager 是目前 Android 平台上的最佳实践。 目前为止本系列已经讨论过: Android Jetpack WorkManager | Android 中文教学视频 WorkManager 在Kotlin 中的实践 WorkManager: 周期性任务 在本篇文章中,我们将会讨论自定义配置相关的内容,包括: 为什么可能会需要自定义配置 如何声明自定义配置 WorkerFactory 以及自定义 WorkerFactory 的原因 DelegatingWorkerFactory 详解 本系列的下一篇文章将对依赖注入和 Dagger 展开讨论,请持续关注我们。 使用 WorkManager 时,您需要自己定义Worker/CoroutineWorker或任何ListenableWorker的派生类。WorkManager 会在正确的时间点实例化您的 Worker,其时机独立于您应用的运行,不受其运行状态的影响。为了可以初始化您的 Worker,WorkManager 会使用一个WorkerFactory。 默认 WorkerFactory 所创建的 Worker 只包含两个参数: Application 的 Context WorkerParameters 如果您需要通过 Worker 的构造函数传入更多参数,则需要一个自定义的 WorkerFactory。 延伸阅读 : 我们讲过默认的 WorkerFactory 使用反射来实例化正确的 ListenableWorker 类,但当我们的 Worker 类的类名被 R8 (或 ProGuard) 最小化之后,这个操作就会失败。为了避免这种情况,WorkManager 包含了一个proguard-rules.pro文件来避免您的 Worker 类的类名被混淆。 自定义配置和 WorkerFactory WorkManager 类遵循 单例模式,而且它只能在实例化之前进行配置。这意味着,如果您想自定义它的配置,就必须先禁用默认配置。 如果您尝试通过 initialize() 方法再次初始化 WorkManager,该方法就会抛出一个异常 (于 1.0.0 版本中加入)。为了避免异常,您需要禁用默认的初始化。您可以稍后在您的 Application 的 onCreate 方法中配置和初始化您的 WorkManager。 2.1.0 版本 中加入了一个更好的初始化 WorkManager 的方式。您可以通过在您的 Application 类中实现 WorkManager 的Configuration.Provider接口的方式来使用按需初始化。接下来,您只需要使用getInstance(context)获得实例,WorkManager 就会通过您的配置初始化它自己。 可配置参数 如上所讲,您可以配置用来创建 Worker 的 WorkerFactory,但是您也可以自定义其他的参数。WorkManager 的Configuration.Builder参考指南中包含了参数的完整列表。这里我想强调两个附加参数: Logging 级别 JobId 范围 当我们有需要时,可以通过修改日志级别方便地理解 WorkManager 中正在发生什么。关于这个话题,我们有一个 专门的文档页。您也可以查看Advanced WorkManager codelab 实战教程,以了解此功能在真实示例中的实现,以及您可以通过此功能获取到什么样的信息。 如果以在我们的应用中使用 JobScheduler API 一样的方式使用 WorkManager,我们可能也会想要自定义 JobId 范围。因为在这种情况下,您会想要避免在同一个地方使用相同的 JobId 范围。版本 2.4.0 中也加入了一个新的Lint 规则 来覆盖这种情况。 WorkManager 的 WorkerFactory 我们已经知道,WorkManager 有一个默认的 WorkerFactory,它可以根据我们经由 WorkRequest 传入的 Worker 类的类名,通过反射来找到应该实例化的 Worker 类。 ⚠️ 如果您在创建了一个 WorkRequest 后重构了应用,并为您的 Worker 类起了另一个名字,WorkManager 就会因为无法找到正确的类而抛出一个 ClassNotFoundException。 您可能会想要为您的 Worker 的构造函数添加其他参数。假设您有一个 Worker 需要引用一个 Retrofit 服务来跟远程服务器进行通讯: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class UpvoteStoryWorker( appContext: Context, workerParams: WorkerParameters, private val service: UpvoteStoryHttpApi) : CoroutineWorker(appContext, workerParams) { override suspend fun doWork(): Result { return try { // 投票操作 Result.success() } catch (e: Exception) { if (runAttemptCount < MAX_NUMBER_OF_RETRY) { Result.retry() } else { Result.failure() } } } } 如果我们在一个应用上作出上面的修改,程序仍然可被正常编译。但是只要代码被执行、WorkManager 尝试去实例化这个 CoroutineWorker 时,应用就会因为抛出异常而被关闭。异常的描述为无法找到正确的方法来进行实例化: Caused by java.lang.NoSuchMethodException: <init> [class android.content.Context, class androidx.work.WorkerParameters] 这时我们就需要一个自定义的 WorkerFactory。 但是别着急,我们已经看到其中涉及的几个步骤。现在让我们回顾一下我们已经做了的事情,然后深入了解其中每一步的详细信息: 禁用默认初始化 实现一个自定义 WorkerFactory 创建自定义配置 初始化 WorkManager 禁用默认初始化 如WorkManager 的文档 中描述,禁用操作要在您的 AndroidManifest.xml 文件中完成。移除默认情况下从 WorkManager 库中自动合并的节点。 <!-- Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 --> <application … <provider android:name="androidx.work.impl.WorkManagerInitializer" android:authorities="${applicationId}.workmanager-init" tools:node="remove" /> </application> 实现一个自定义 WorkerFactory 为了创建包含正确参数的 Worker,现在需要实现我们自己的工厂 (factory): /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyWorkerFactory(private val service: UpvoteStoryHttpApi) : WorkerFactory() { override fun createWorker( appContext: Context, workerClassName: String, workerParameters: WorkerParameters ): ListenableWorker? { // 这里只能处理一个 Worker,请不要这样做! // 参考下文来更好地使用 DelegatingWorkerFactory return UpvoteStoryWorker(appContext, workerParameters, DesignerNewsService) } } 创建一个自定义 WorkerConfiguration** 接下来,我们必须将我们的工厂注册到我们的 WorkManager 的自定义配置中: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyApplication : Application(), Configuration.Provider { override fun getWorkManagerConfiguration(): Configuration = Configuration.Builder() .setMinimumLoggingLevel(android.util.Log.DEBUG) .setWorkerFactory(MyWorkerFactory(DesignerNewsService)) .build() ... } 初始化 WorkManager 当您的应用中只有一个 Worker 类时,以上便是您所需要做的所有事情。而如果您有多个或者预计未来会有多个 Worker 类,更好的解决方案是使用在 2.1 版中加入的DelegatingWorkerFactory。 使用 DelegatingWorkerFactory 我们可以通过使用 DelegatingWorkerFactory 来替代将 WorkManager 配置为直接使用某个工厂的操作。我们可以使用 DelegatingWorkerFactory 的addFactory()方法向其添加我们的工厂,这样一来,您就有了多个工厂,其中每个都可以管理一个或多个 Worker。在 DelegatingWorkerFactory 中注册您的工厂,这将有助于协调多个工厂的执行。 在这种情况下,您的工厂需要检查是否知道如何处理作为参数传入的 workerClassName。如果答案是否定的,就返回 null,而 DelegatingWorkerFactory 便会去寻找下一个注册的工厂。如果没有任何被注册的工厂知道如何处理某个类,那么它将回退到使用反射的默认工厂。 下面是我们的工厂类代码,修改为当它不知道如何处理某个 workerClassName 时,将返回 null: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyWorkerFactory(private val service: DesignerNewsService) : WorkerFactory() { override fun createWorker( appContext: Context, workerClassName: String, workerParameters: WorkerParameters ): ListenableWorker? { return when(workerClassName) { UpvoteStoryWorker::class.java.name -> ConferenceDataWorker(appContext, workerParameters, service) else -> // 返回 null,这样基类就可以代理到默认的 WorkerFactory null } } } 我们的 WorkManager 配置会变成: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyApplication : Application(), Configuration.Provider { override fun getWorkManagerConfiguration(): Configuration { val myWorkerFactory = DelegatingWorkingFactory() myWorkerFactory.addFactory(MyWorkerFactory(service)) // 在这里添加您应用中可能会使用的其他 WorkerFactory return Configuration.Builder() .setMinimumLoggingLevel(android.util.Log.INFO) .setWorkerFactory(myWorkerFactory) .build() } ... } 如果您有多个 Worker 需要不同的参数,您可以创建第二个 WorkerFactory,并通过再次调用 addFactory 来添加它。 总结 WorkManager 是一个功能十分强大的库,它的默认配置已经可以覆盖许多常见的使用场景。然而当您遇到某些情况时,诸如需要增加日志级别或需要传入额外参数到您的 Worker 时,则需要一个自定义的配置。 希望您能通过本文对此主题有一个良好的认识。如果您有任何疑问,可以在评论区中留言。 接下来的文章我们将会讨论如何在自定义 WorkManager 配置时使用 Dagger,感兴趣的读者请继续关注。

优秀的个人博客,低调大师

MySQL运行原理与基础架构!

下面是关于上述部件的介绍: connectors 与其他编程语言中的sql 语句进行交互,如php、java等。 Management Serveices & Utilities系统管理和控制工具 Connection Pool (连接池)管理缓冲用户连接,线程处理等需要缓存的需求 SQL Interface (SQL接口)接受用户的SQL命令,并且返回用户需要查询的结果。比如select from就是调用SQL Interface Parser (解析器)SQL命令传递到解析器的时候会被解析器验证和解析。 主要功能: a . 将SQL语句分解成数据结构,并将这个结构传递到后续步骤,后面SQL语句的传递和处理就是基于这个结构的 如果在分解构成中遇到错误,那么就说明这个sql语句是不合理的,语句将不会继续执行下去 Optimizer (查询优化器)SQL语句在查询之前会使用查询优化器对查询进行优化(产生多种执行计划,最终数据库会选择最优化的方案去执行,尽快返会结果) 他使用的是“选取-投影-联接”策略进行查询。 用一个例子就可以理解: select uid,name from user where gender = 1; 这个select 查询先根据where 语句进行选取,而不是先将表全部查询出来以后再进行gender过滤 这个select查询先根据uid和name进行属性投影,而不是将属性全部取出以后再进行过滤 将这两个查询条件联接起来生成最终查询结果. Cache和Buffer (查询缓存)如果查询缓存有命中的查询结果,查询语句就可以直接去查询缓存中取数据。 这个缓存机制是由一系列小缓存组成的。比如表缓存,记录缓存,key缓存,权限缓存等 8.Engine (存储引擎) 存储引擎是MySql中具体的与文件打交道的子系统。也是Mysql最具有特色的一个地方。 Mysql的存储引擎是插件式的。它根据MySql AB公司提供的文件访问层的一个抽象接口来定制一种文件访问机制(这种访问机制就叫存储引擎) SQL 语句执行过程 数据库通常不会被直接使用,而是由其他编程语言通过SQL语句调用mysql,由mysql处理并返回执行结果。那么Mysql接受到SQL语句后,又是如何处理的呢? 首先程序的请求会通过mysql的connectors与其进行交互,请求到处后,会暂时存放在连接池(connection pool)中并由处理器(Management Serveices & Utilities)管理。当该请求从等待队列进入到处理队列,管理器会将该请求丢给SQL接口(SQL Interface)。SQL接口接收到请求后,它会将请求进行hash处理并与缓存中的结果进行对比,如果完全匹配则通过缓存直接返回处理结果;否则,需要完整的走一趟流程: (1)由SQL接口丢给后面的解释器(Parser),上面已经说到,解释器会判断SQL语句正确与否,若正确则将其转化为数据结构。 (2)解释器处理完,便来到后面的优化器(Optimizer),它会产生多种执行计划,最终数据库会选择最优化的方案去执行,尽快返会结果。 (3)确定最优执行计划后,SQL语句此时便可以交由存储引擎(Engine)处理,存储引擎将会到后端的存储设备中取得相应的数据,并原路返回给程序。 这里有几点需要注意: (1)如何缓存查询数据? 存储引擎处理完数据,并将其返回给程序的同时,它还会将一份数据保留在缓存中,以便更快速的处理下一次相同的请求。具体情况是,mysql会将查询的语句、执行结果等进行hash,并保留在cache中,等待下次查询。 (2)buffer与cache的区别? 从上面的图可以看到,缓存那里实际上有buffer和cache两个,那它们之间是否有什么不同呢?简单的说就是,buffer是写缓存,cache是读缓存。 (3)如何判断缓存中是否已缓存需要的数据 这里可能有一个误区,觉得处理SQL语句的时候,为了判断是否已缓存查询结果,会将整个流程走一遍,取得执行结果后再与需要的进行对比,看看是否命中,并以此说,既然不管缓存中有没有缓存到查询内容,都要整个流程走一遍,那么缓存的优势又在哪里?? 实际上,并非如此,在第一次查询后,mysql便将查询语句以及查询结果进行hash处理并保留在缓存中,SQL查询到达之后,对其进行同样的hash处理后,将两个hash值进行对照,如果一样,则命中,从缓存中返回查询结果;否则,需要整个流程走一遍。 ​

优秀的个人博客,低调大师

Docker入门基础之镜像使用

当运行容器时,使用的镜像如果在本地中不存在,docker 就会自动从 docker 镜像仓库中下载,默认是从 Docker Hub 公共镜像源下载。 下面我们来学习: 1、管理和使用本地 Docker 主机镜像 2、创建镜像 列出镜像列表我们可以使用 docker images 来列出存在于宿主机上的镜像。 root@ubuntu:~# docker images REPOSITORY TAG IMAGE ID CREATED SIZE alpine latest 055936d39205 3 weeks ago 5.53MB mysql 5.7 7faa3c53e6d6 3 weeks ago 373MB ubuntu 15.04 d1b55fd07600 3 years ago 131MB ubuntu 16.04 2a697363a870 2 weeks ago 119MB 各个选项说明: REPOSITORY:表示镜像的仓库源 TAG:镜像的标签 IMAGE ID:镜像ID CREATED:镜像创建时间 SIZE:镜像大小 同一仓库源可以有多个 TAG,代表这个仓库源的不同个版本,如ubuntu仓库源里,有16.04、15.04等多个不同的版本,我们使用 REPOSITORY:TAG 来定义不同的镜像。 以相应的镜像启动容器我们如果要使用版本为16.04的ubuntu系统镜像来运行容器时,命令如下: root@ubuntu:~# docker run -it ubuntu:16.04 sh 如果要使用版本为15.04的ubuntu系统镜像,则命令如下: root@ubuntu:~# docker run -it ubuntu:15.04 sh 各个参数解析: docker: Docker 的二进制执行文件。 run: 与前面的 docker 组合来运行一个容器。 -it: 其实是两个参数组成, -i 和 -t,-i:允许你对容器内的标准输入 (STDIN) 进行交互。-t:在新容器内指定一个伪终端或终端。 ubuntu:15.04指定要运行的镜像,Docker首先从本地主机上查找镜像是否存在,如果不存在,Docker 就会从镜像仓库 Docker Hub 下载公共镜像。 sh: 执行命令。 获取一个新镜像当我们在宿主机上使用一个不存在的镜像时 Docker 就会自动下载这个镜像。如果我们想预先下载这个镜像,我们可以使用 docker pull 命令来下载它。 root@ubuntu:~# docker pull ubuntu:18.04 18.04: Pulling from library/ubuntu 6abc03819f3e: Pull complete 05731e63f211: Pull complete 0bd67c50d6be: Pull complete Digest: sha256:f08638ec7ddc90065187e7eabdfac3c96e5ff0f6b2f1762cf31a4f49b53000a5 Status: Downloaded newer image for ubuntu:18.04 下载完成后,我们可以直接使用这个镜像来运行容器。 查找镜像 我们可以从 Docker Hub 网站来搜索镜像,Docker Hub 网址为: https://hub.docker.com/我们也可以使用 docker search 命令来搜索镜像。比如我们需要一个httpd的镜像来作为我们的web服务。我们可以通过 docker search 命令搜索 httpd 来寻找适合我们的镜像。 NAME: 镜像仓库源的名称DESCRIPTION: 镜像的描述OFFICIAL: 是否docker官方发布 拉取httpd镜像我们决定使用上图中的httpd 官方版本的镜像,使用命令 docker pull 来下载镜像。 root@ubuntu:~# docker pull httpd Using default tag: latest latest: Pulling from library/httpd 743f2d6c1f65: Already exists c92eb69846a6: Pull complete 2211b052800a: Pull complete aed180197314: Pull complete 7c472a4980a7: Pull complete Digest: sha256:a35ad614c1ffc6fe931f12dc42b682edbdcc62cf78d8edc41499dd90ef0f8003 Status: Downloaded newer image for httpd:latest 下载完成后,我们就可以使用这个镜像了。 创建镜像当我们从docker镜像仓库中下载的镜像不能满足我们的需求时,我们可以通过以下两种方式对镜像进行更改。 1.从已经创建的容器中更新镜像,并且提交这个镜像 2.使用 Dockerfile 指令来创建一个新的镜像 更新镜像更新镜像之前,我们需要使用镜像来创建一个容器。 root@ubuntu:~# docker run -it ubuntu:16.04 sh 在运行的容器内使用 apt-get update 命令进行更新。 # apt-get update Get:1 http://archive.ubuntu.com/ubuntu xenial InRelease [247 kB] Get:2 http://security.ubuntu.com/ubuntu xenial-security InRelease [109 kB] Get:3 http://archive.ubuntu.com/ubuntu xenial-updates InRelease [109 kB] Get:4 http://archive.ubuntu.com/ubuntu xenial-backports InRelease [107 kB] Get:5 http://archive.ubuntu.com/ubuntu xenial/main amd64 Packages [1558 kB] Get:6 http://security.ubuntu.com/ubuntu xenial-security/main amd64 Packages [844 kB] Get:7 http://archive.ubuntu.com/ubuntu xenial/restricted amd64 Packages [14.1 kB] Get:8 http://archive.ubuntu.com/ubuntu xenial/universe amd64 Packages [9827 kB] Get:9 http://archive.ubuntu.com/ubuntu xenial/multiverse amd64 Packages [176 kB] Get:10 http://archive.ubuntu.com/ubuntu xenial-updates/main amd64 Packages [1237 kB] Get:11 http://security.ubuntu.com/ubuntu xenial-security/restricted amd64 Packages [12.7 kB] Get:12 http://security.ubuntu.com/ubuntu xenial-security/universe amd64 Packages [556 kB] Get:13 http://archive.ubuntu.com/ubuntu xenial-updates/restricted amd64 Packages [13.1 kB] Get:14 http://archive.ubuntu.com/ubuntu xenial-updates/universe amd64 Packages [967 kB] Get:15 http://archive.ubuntu.com/ubuntu xenial-updates/multiverse amd64 Packages [19.1 kB] Get:16 http://archive.ubuntu.com/ubuntu xenial-backports/main amd64 Packages [7942 B] Get:17 http://archive.ubuntu.com/ubuntu xenial-backports/universe amd64 Packages [8532 B] Get:18 http://security.ubuntu.com/ubuntu xenial-security/multiverse amd64 Packages [6113 B] Fetched 15.8 MB in 8s (1933 kB/s) Reading package lists... Done 在完成操作之后,输入 exit命令来退出这个容器。 通过 docker ps -a 查看所有容器: root@ubuntu:~# docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 12847d9f5071 ubuntu:16.04 "sh" 2 minutes ago Exited (0) 43 seconds ago peaceful_edison 3cec6f5e47c0 httpd "httpd-foreground" 5 minutes ago Exited (0) 5 minutes ago vigilant_heisenberg 此时ID为12847d9f5071的容器,是按我们的需求更改的容器。我们可以通过命令docker commit来提交容器副本。 root@ubuntu:~# docker commit -m="has update" -a="yeqing112" 12847d9f5071 yeqing112/ubuntu:v2 sha256:5cce1167ee4c083ff9b87e61a58081805e76d015a12a4811bd152263aa013860 各个参数说明: -m: 提交的描述信息。 -a: 指定镜像作者。 12847d9f5071: 容器ID。 yeqing112/ubuntu:v2: 指定要创建的目标镜像名。 我们可以使用 docker images 命令来查看我们的新镜像 yeqing112/ubuntu:v2: root@ubuntu:~# docker images REPOSITORY TAG IMAGE ID CREATED SIZE yeqing112/ubuntu v2 5cce1167ee4c 2 minutes ago 144MB ubuntu 16.04 2a697363a870 2 weeks ago 119MB 从上面的信息中可以看到我们更新过的镜像,文件体积明显比之前大了一些。 构建镜像除了上面更新镜像的方法,我们还可以使用命令 docker build , 从零开始来构建一个新的镜像。为此,我们需要创建一个 Dockerfile 文件,其中包含一组指令来告诉 Docker 如何构建我们的镜像。 root@ubuntu:~# cat Dockerfile FROM ubuntu:16.04 MAINTAINER Fisher "service@urlos.com" RUN apt-get update EXPOSE 22 EXPOSE 80 CMD /bin/bash 每一个指令都会在镜像上创建一个新的层,每一个指令的前缀都必须是大写的。 第一条FROM,指定使用哪个镜像源 RUN 指令告诉docker 在镜像内执行命令,安装了什么 这里我们还是一样,执行一个 apt-get update 更新命令 然后,我们使用 Dockerfile 文件,通过 docker build -t yeqing112/ubuntu:v3 . 命令来构建一个新镜像。 root@ubuntu:~# root@ubuntu:/home# docker build -t yeqing112/ubuntu:v3 . Sending build context to Docker daemon 422.4kB Step 1/6 : FROM ubuntu:16.04 ---> 2a697363a870 Step 2/6 : MAINTAINER Fisher "service@urlos.com" ---> Running in 92229e7a091a Removing intermediate container 92229e7a091a ---> 9a89f4debc7d Step 3/6 : RUN apt-get update ---> Running in d709ef335784 Get:1 http://archive.ubuntu.com/ubuntu xenial InRelease [247 kB] Get:2 http://security.ubuntu.com/ubuntu xenial-security InRelease [109 kB] Get:3 http://archive.ubuntu.com/ubuntu xenial-updates InRelease [109 kB] Get:4 http://archive.ubuntu.com/ubuntu xenial-backports InRelease [107 kB] Get:5 http://security.ubuntu.com/ubuntu xenial-security/main amd64 Packages [844 kB] Get:6 http://archive.ubuntu.com/ubuntu xenial/main amd64 Packages [1558 kB] Get:7 http://archive.ubuntu.com/ubuntu xenial/restricted amd64 Packages [14.1 kB] Get:8 http://archive.ubuntu.com/ubuntu xenial/universe amd64 Packages [9827 kB] Get:9 http://security.ubuntu.com/ubuntu xenial-security/restricted amd64 Packages [12.7 kB] Get:10 http://security.ubuntu.com/ubuntu xenial-security/universe amd64 Packages [556 kB] Get:11 http://archive.ubuntu.com/ubuntu xenial/multiverse amd64 Packages [176 kB] Get:12 http://archive.ubuntu.com/ubuntu xenial-updates/main amd64 Packages [1237 kB] Get:13 http://archive.ubuntu.com/ubuntu xenial-updates/restricted amd64 Packages [13.1 kB] Get:14 http://archive.ubuntu.com/ubuntu xenial-updates/universe amd64 Packages [967 kB] Get:15 http://archive.ubuntu.com/ubuntu xenial-updates/multiverse amd64 Packages [19.1 kB] Get:16 http://archive.ubuntu.com/ubuntu xenial-backports/main amd64 Packages [7942 B] Get:17 http://archive.ubuntu.com/ubuntu xenial-backports/universe amd64 Packages [8532 B] Get:18 http://security.ubuntu.com/ubuntu xenial-security/multiverse amd64 Packages [6113 B] Fetched 15.8 MB in 5s (3051 kB/s) Reading package lists... Removing intermediate container d709ef335784 ---> 540751496556 Step 4/6 : EXPOSE 22 ---> Running in 9ae528bc083f Removing intermediate container 9ae528bc083f ---> cfccc621a52d Step 5/6 : EXPOSE 80 ---> Running in efd88e9349c1 Removing intermediate container efd88e9349c1 ---> 428cb5221a06 Step 6/6 : CMD /bin/bash ---> Running in 2bc08b664f97 Removing intermediate container 2bc08b664f97 ---> 9c55ea9b9ee8 Successfully built 9c55ea9b9ee8 Successfully tagged yeqing112/ubuntu:v3 参数说明: -t:指定要创建的目标镜像名 .:Dockerfile 文件所在目录,可以指定Dockerfile 的绝对路径 构建成功后,使用 docker images 查看镜像: root@ubuntu:~# docker images REPOSITORY TAG IMAGE ID CREATED SIZE yeqing112/ubuntu v3 9c55ea9b9ee8 9 seconds ago 144MB yeqing112/ubuntu v2 5cce1167ee4c 16 minutes ago 144MB ubuntu 16.04 2a697363a870 2 weeks ago 119MB 由上面的信息看出,新的镜像v3与v2文件体积是一样的,两个镜像都只是执行了apt-get update 设置镜像标签我们可以使用 docker tag 命令,为镜像添加一个新的标签。 root@ubuntu:/home# docker tag 9c55ea9b9ee8 yeqing112/ubuntu:v3-1 docker tag 镜像ID,这里是 9c55ea9b9ee8,用户名称、镜像源名(repository name)和新的标签名(tag)。 使用 docker images 命令可以看到,ID为9c55ea9b9ee8的镜像多了一个v3-1的标签。 root@ubuntu:/home# docker images REPOSITORY TAG IMAGE ID CREATED SIZE yeqing112/ubuntu v3 9c55ea9b9ee8 21 minutes ago 144MB yeqing112/ubuntu v3-1 9c55ea9b9ee8 21 minutes ago 144MB yeqing112/ubuntu v2 5cce1167ee4c 38 minutes ago 144MB ubuntu 16.04 2a697363a870 2 weeks ago 119MB

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册