首页 文章 精选 留言 我的

精选列表

搜索[量化交易],共10000篇文章
优秀的个人博客,低调大师

基于Python装饰器的向量化计算速度对比

timer是一个装饰器,功能是给被装饰的函数计时。如果要进一步了解装饰器的使用,点击此链接Python闭包函数和装饰器 sumOfLoop函数是常规的使用for进行循环遍历求和的方法; sumOfComprehension函数使用推导式得出新的列表,然后用内置sum函数求出列表的和; sumOfVectorization函数使用np.dot方法求出两个数据类型的为numpy.ndarray的对象的点积,两个向量a = [a1, a2,…, an]和b = [b1, b2,…, bn]的点积定义为:a·b=a1b1+a2b2+……+anbn。 np.random.rand()方法需要传入一个参数,例如传入参数为5,则返回一个数据类型为numpy.ndarray、长度为5、其中元素的值范围为0-1的对象,如下图所示: np.random.rand()方法.png from time import time import numpy as np def timer(func): def inner(*args,**kwargs): start = time() result = func(*args,**kwargs) end = time() usedTime = 1000 * (end - start) print("%s function used %.2f ms,return %.4f" %(func.__name__,usedTime,result)) return result return inner @timer def sumOfLoop(np_array): result = 0 for i in np_array: result += i * i return result @timer def sumOfComprehension(np_array): return sum([i * i for i in np_array]) @timer def sumOfVectorization(np_array): return np.dot(np_array,np_array) if __name__ == "__main__": print("计算小数平方和三种方法对比:") n = np.random.rand(3000000) a = sumOfLoop(n) print(a) sumOfComprehension(n) sumOfVectorization(n) print("计算整数平方和三种方法对比:") n = np.array(range(3000000)).astype('int64') sumOfLoop(n) sumOfComprehension(n) sumOfVectorization(n) 本文作者在2018年7月13日晚11点的运行结果如下: 计算小数平方和三种方法对比: sumOfLoop function used 1036.76 ms,return 999213.4882 sumOfComprehension function used 1103.75 ms,return 999213.4882 sumOfVectorization function used 2.00 ms,return 999213.4882 计算整数平方和三种方法对比: sumOfLoop function used 545.89 ms,return 8999995500000499712.0000 sumOfComprehension function used 718.86 ms,return 8999995500000499712.0000 sumOfVectorization function used 5.00 ms,return 8999995500000499712.0000

优秀的个人博客,低调大师

每日一博 | 库存预占架构升级方案设计 - 交易库存中心

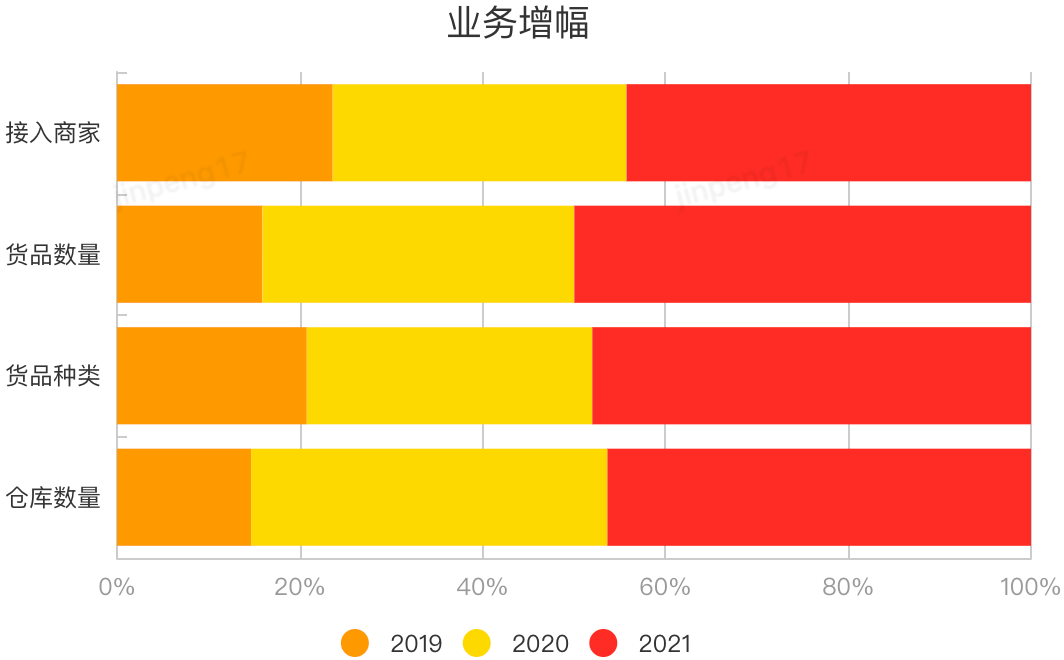
背景介绍 伴随物流行业的迅猛发展,一体化供应链模式的落地,对系统吞吐、系统稳定发出巨大挑战,库存作为供应链的重中之重表现更为明显。近三年数据可以看出: 接入商家同比增长37.64%、货品种类同比增长53.66% 货品数量同比增长46.43%、仓库数量同比增长18.87% 通过分析过往大促流量,分钟级流量增长率为75%,大促仓内反馈三方订单下传不及时,库存预占吞吐量和性能是导致订单积压因素之一。目前库存使用mysql数据库作为接单预占的扛量手段,随着一体化供应链建设以及重点KA商家不断接入,现有库存架构在业务支撑上存在风险和缺陷。 此外未来3到5年业务增长、流量增长预计增长5-10倍。为避免系统性能和技术架构缺陷导致业务损失,轻量级库存架构势在必行。 // 名词解释: 库存预占:是指消费者拍下商品订单后,库存先为该订单短暂预留,预留的库存即为预占库存。 架构原则 架构:是⾯向问题,解决问题的手段。 库存系统的问题: 非功能性:1.高并发 2.系统稳定性(容灾) 3.数据一致性 功能性: 1.业务复杂 2.数据一致性 系统设计 设计思路 当前库存系统瓶颈在哪里?:抗写流量,数据库成为瓶颈点。 如何解决系统瓶颈?:由高并发组件Redis替代数据库。 利用Redis需要解决哪些问题?:防超卖,异步写数据库保证最终一致性。 总体设计 扛量部分:库存性能瓶颈在预占,传统架构主要依靠数据库事务保持数据一致以及数据读写;新版架构设计将数据扛量部分移植到Redis,利用Redis高性能吞吐解决高并发场景下数据读写。 数据回写:Redis进行扛量削峰,后续数据仅用于记账,最终牺牲数据的短暂一致性达到削峰的目的。 差异部分:老版本库存预占设计仅依靠数据进行数据处理,新版设计依靠切量配置建数据切换到Redis,利用Redis高读写进行削峰操作。 详细设计 主流程: 库存初始化:竞态条件利用Redis watch命令来实现锁等待,解决并发场景数据不一致问题。 LUA执行器:将原子操作指令/复用指令封装到LUA脚本中以减少网络开销。 补偿机制:i> 执行流程中所有业务异常发生时会同步发起反向操作请求;ii> 反向操作执行异常后会提交异步反向操作任务;**iii>**异步任务执行异常后,依赖监q控系统扫描异常单据或异常库存并修改异常库存量 回溯回写:任务落库后发出mq组装参数调用数据回写服务,数据回写服务操作库存数量;同时回写redis数据,释放预占量库存数据;更新任务库数据状态 数据结构 库存记录索引:{deptNo|goodsNo|warehouseNo}|stockStatus|stockType|goodsLevel hashTag:{deptNo|goodsNo|warehouseNo}|stockStatus|stockType|goodsLevel 可售库存数量:usableKey:{库存记录索引} 扣减库存量:usableSubtractKey:{库存记录索引} ,记录Redis到DB执行期间减库存量 预占防重key:operateKey:{库存记录索引:单号} 防重key防并发重复请求 回滚防重:rollbackOperateKey:{库存记录索引} 缺量预占库存量:ullageOperateKey:{库存记录索引} 扣减库存单据记录:hSetrecord: {库存记录索引} key 预占 缺量预占 回滚 回写 可售库存数量 - - + 不变 扣减库存量 + + - - 预占防重key + + - 不变 回滚防重 不变 不变 + 不变 缺量预占库存量 不变 + 反向 不变 扣减库存单据记录 + + - - Redis&DB 首先进行redis&从库数据比对,若存在差异则对主库进行校验 比对过程中,DB中sku明细行进行锁定(for update),比对逻辑为DB可用库存量==(Redis可用库存量+Redis预占量) 有差异,报警且触发SDK可用量过期,同时矫正预占量 容灾方案 // 对系统容错/降级、监控机制(空间换稳定性,两份redis,故障3次丢数),流量分布材料,618流量大、峰值数据切量。数据不一致,多个商家,不能超过5分。 预占任务持久化:mysql需要将核心属性字段数据持久化:事业部,商品编码,仓编码,等级,库存类型,库存状态,预占库存量,任务状态;调度执行完成后需要更新stockTask状态为完成 初始化: (1) lock db (2) sum stockTask (3)使用DB可用库存初始化Redis可用库存,stockTask预占量初始化Redis预占量 (4)Redis库存回滚,如果预占量key不存在,该key不需要回滚 性能结果 23年618大促 切量细则 切量细则 冷热数据 OMS库存冷热装置 预占架构升级切量重点key监控 库存预占架构升级切量商家 架构升级切量商家明细2 已切量商家 反向切量 原有设计中存在以下名单 禁止切量商家:优先级较高,一旦在名单中,禁止切量 批次库存商家:批次库存管理商家,目前该部分能力尚未建设 动态质押商家:物流金融业务,目前该部分能力尚未建设 切量名单商家:该部分为切量商家 原有切量流程:!禁止切量->!批次库存->!动态质押->切量名单中,通过以上校验为切量商家。 原有流程在增量商家中需要手动将商家配置到切量名单中才可进行切量操作,对于新增商家场景操作不变,且原有流程中逻辑库存名单为痛点:逻辑库存的启用配置在事业部主数据中,不在库存侧。 新版切量流程中对切量名单进行优化,将原来切量名单商家拆分成非逻辑库存名单、逻辑库存两个名单,其中: 非逻辑库存名单:包含可切量商家 逻辑库存名单:逻辑库存商家,该部分不可切量 原流程新流程对切量商家名单进行优化,拆分成非逻辑库存名单、逻辑库存两个名单 构建模型(批次库存&内存模型待续) Redis存储数据结构 MD生成规则工具集 ◦逻辑库存MD5工具 StringBuffer md5Key = new StringBuffer(); md5Key.append(logicWarehouseStock.getGoodsNo()+"_"+logicWarehouseStock.getWarehouseNo()+"_"+logicWarehouseStock.getOwnerNo()+ "_"+logicWarehouseStock.getDeptNo()+"_"+logicWarehouseStock.getStockType()+"_"+logicWarehouseStock.getGoodsLevel()); if(StringUtils.isBlank(logicWarehouseStock.getFactor1())){ md5Key.append("_0"); }else { md5Key.append("_"+logicWarehouseStock.getFactor1()); } if(StringUtils.isBlank(logicWarehouseStock.getFactor2())){ md5Key.append("_0"); }else { md5Key.append("_"+logicWarehouseStock.getFactor2()); } if(StringUtils.isBlank(logicWarehouseStock.getFactor3())){ md5Key.append("_0"); }else { md5Key.append("_"+logicWarehouseStock.getFactor3()); } if(StringUtils.isBlank(logicWarehouseStock.getFactor4())){ md5Key.append("_0"); }else { md5Key.append("_"+logicWarehouseStock.getFactor4()); } if(logicWarehouseStock.getYn()== null){ md5Key.append("_1"); }else { md5Key.append("_"+logicWarehouseStock.getYn()); } md5Key.toString().hashCode() 批次库存MD5工具 public void fillMd5Value(){ StringBuffer md5Key = new StringBuffer(); md5Key.append(warehouseNo); md5Key.append("_"); md5Key.append(goodsNo); md5Key.append("_"); md5Key.append(goodsLevel); md5Key.append("_"); md5Key.append(stockType); //遍历类字段不遍历map是为了控制MD5的组成顺序 Class clazz = BatchAttrStock.class; Field[] fields = clazz.getDeclaredFields(); try { int batchFieldCount = 0 ; for (Field field : fields){ BatchAttrEnum attrEnum = BatchAttrEnum.batchFieldEnumMap.get(field.getName()); //不是批属性的字段不进入MD5的组成 if (attrEnum == null){ continue; } batchFieldCount ++; field.setAccessible(true); Object value = field.get(this); if (value == null ){ md5Key.append("0"); continue; } if(field.getType().toString().contains("String")){ md5Key.append(value); continue; } if(field.getType().toString().contains("Date")){ Date timeField = (Date) value; md5Key.append(timeField.getTime()); continue; } throw new RuntimeException(attrEnum.getField()+"填充MD5异常"); } //默认50个批属性长度,长度不够0补齐 int remainLength = 50 - batchFieldCount; String str = String.format("%0"+remainLength+"d", 0); md5Key.append(str); }catch (Exception e){ throw new RuntimeException("填充MD5异常."); } md5Key.append(yn); String md5Value = MD5Util.md5(md5Key.toString()); setMd5Value(md5Value); } MD&ID&属性保存工具 本文篇幅有限,余下二期进行分享。 作者:京东物流 金鹏 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

每日一博 | 百度交易中台之钱包系统架构浅析

导读:百度APP内含有现金、活动、虚拟等多类资产信息,分布于百度APP内各个业务线中,用户回访信息难度较高,且用户对百度资产认知度不高。我的钱包建立后,汇聚百度APP内所有用户资产信息,解决了用户回访难的问题,建立用户百度APP资产认知。本文主要介绍了钱包从0到1的搭建过程、遇到的各种问题以及相应的解决方案,旨在抛砖引玉,希望能给读者带来思考和帮助。 全文6082字,预计阅读时间16分钟 一、背景 百度APP坐拥日活2亿+、月活6亿+用户,在百度APP内每时每刻都产生了众多用户的资产信息。当前,百度APP内含有现金资产、活动资产、虚拟资产等多类资产信息,分布于百度APP内各个业务线中。每个业务线提供用户独立的资产信息,业务线间关联性较低,用户回访信息难度较高,不利于形成用户对百度APP资产信息的整体认知。亟需一个系统,能够汇聚百度APP内所有用户资产信息,支持用户资产信息统一汇总、展示,收拢用户回访入口,建立用户百度APP资产认知,提升百度APP用户体验,我的钱包应运而生。 二、业务介绍 百度APP个人中心里我的钱包,主要收拢了百度用户的资产信息,进行统一的管理、展示,同时收拢各个业务线资产查看、使用等能力的入口,便于用户快速回访、找到个人的资产信息。钱包在百度APP个人中心外露四个金刚位和钱包入口地址,四个金刚位支持配置,运营人员可根据不同时期的活动、营销等配置不同外露业务方,便于用户快捷回访。同时四个金刚位支持业务数据外露展示,使用户直观感知个人的资产信息。 在钱包入口点击后,可进入钱包首页。首页中主要外露用户的现金、提现活动、返现、卡券、虚拟币、快捷入口等信息,同时支持运营配置营销、活动。对于现金余额信息,我们需要用户授权,用户授权后查询用户在度小满、百度闪付的余额,进入明细页面后,可分别进行授权、查看明细。针对活动提现金额,钱包推动百度APP内所有涉及提现金额的业务接入钱包,统一进行管理,支持用户查看金额明细,其中金额明细中包含两个部分,一部分是明确返回用户余额信息的业务,支持用户点击跳转至具体业务方查看明细,另一部分是汇总百度提现中心全部业务,支持用户点击跳转,建立用户现金余额统一管理、访问的认知。对于虚拟币数据,可根据用户各个虚拟币余额数量进行动态展示,便于用户快速知晓自己的虚拟币信息,点击具体虚拟币时,支持跳转至业务方明细页面进行查看明细、充值等操作,也支持跳转至钱包统一虚拟币明细列表,查看用户明细、月度汇总等信息。对于业务方接入,钱包提供多种接入方式:API数据同步、实时查询、配置跳转,业务方可根据自己实际情况进行选择。 △图2-1 钱包展示 三、系统业务架构 △图3-1 钱包业务架构图 钱包的整体系统业务架构如上图3-1所示,钱包服务主要面向C端用户、业务接入方、运营人员。针对C端用户,钱包提供百度APP个人中心一级入口和钱包首页两个核心入口,前端使用talos框架实现。用户通过个人中心入口访问到达逻辑层后,首先判断用户是否命中用户缓存,该缓存用来标识用户是否有资产,如果命中缓存且有资产,则读取数据缓存返回数据。用户通过钱包首页进入钱包,根据访问的模块,路由适配器根据配置规则,选择不同数据规则进行数据加载、获取,数据获取后按规则进行聚合返回。为了防止服务异常时影响页面渲染,提供异常兜底方案,业务方接口异常时使用缓存数据兜底,内部异常时统一返回兜底文案。 针对不同的业务方,我们提供多种接入方式,对一个人中心一级入口外露业务,我们提供推送、拉取机制,即业务方在用户数据变更时同步钱包,钱包准时拉取用户最新数据;对于钱包首页、列表页业务,我们提供实时查询方式,对于利用钱包给业务内导流的业务,我们支持H5、scheme、talos、端内等多种跳转能力。配置主要包括基础配置、扩展配置、流控配置, 实现不同的适配器供上游调用。 运营人员可使用B端运营工具,配置、修改接入的业务方信息,也可以管理钱包首页展示、运营活动、营销等,同时亦可配置相关的流控、监控等信息。底层服务,我们使用了百度内通用的数据库、Redis、消息队列、CDN等基础服务,该基础服务由统一的部门运维,稳定性比较可靠。 四、技术细节 1、资产数据同步 钱包搭建,面临着一个棘手的问题:百度APP内资产信息分布在不同业务线,信息间互相隔离,系统异构。如果推动业务方直接暴露API查询数据,则需要业务方接口达到钱包要求的高QPS、底平响、高稳定性,同时业务线内可能存在一些特殊情况,再加上节假日、活动等特殊时期流量突增,会严重影响钱包数据展示,进而影响用户体验。存在部分业务方用户量级较小,但必须得提供符合钱包需要的性能,这就对业务方带来额外压力。如果要求所有业务方将全量数据同步至钱包,又面临业务线数据推送、钱包海量数据存储、数据准确性对账等问题。 针对如上一系列问题,我们确定了接入钱包的原则:①在个人中心破壳展示位外露的业务方,必须将资产数据同步至钱包,钱包服务内部确保接口可用性和降级方案;②钱包首页展示数据,支持业务方选择是否将数据同步至钱包,如果不同步数据,需要提供满足QPS、平响等要求的API供钱包调用;③钱包二级页面、三级页面数据,需业务方提供查询API或者落地页,实时查询业务方数据进行展示,确保明细数据准确无误。 1.1 数据同步 对于业务方同步的用户资产数据,我们只存储用户的最新数据,考虑数据量级问题,钱包不存储历史快照。钱包定义业务方数据推送的接口规范,业务方在数据更新时,需及时通知钱包拉取最新数据。为了防止业务方推送数据时流量突增对钱包sever的影响以及提高钱包server的吞吐,引入消息队列进行削锋,即接到业务方资产数据变更请求时,放入消息队列后返回业务方通知成功,钱包server内消费队列消息,根据配置信息向业务方拉取最新数据进行更新。对于用户资产明细数据,钱包定义接口规范,业务方实现后将调用地址提供给钱包,钱包进行配置,用户访问时实时调用。 于是,我们设计了如下的数据同步方案: △图4-1 业务方数据同步 ①用户资产变更时,业务方调用钱包接口通知信息变更; ②钱包接到通知后,放入消息队列; ③消费任务获取消息队列中消息进行消费处理; ④根据配置,拉取业务方最新信息,更新至钱包存储; 在消费消息时,钱包server进行批量处理,针对一定时间内同一业务方同一用户信息,只拉取一次数据,减少对业务方服务压力。遇到异常时,会进行3次重试拉取。钱包server控制是否拉取、流控,在下游业务方服务异常时,可及时停止拉取、降低拉取流量,减少或者去除下游系统对钱包的影响。 1.2 实时查询 针对部分业务方不推送数据,我们定义接口规范,业务方进行实现,实现后上报钱包配置调用方式。对于此类业务方,不允许配置到个人中心展示,防止业务方接口性能不达标拖累整体用户体验。实时查询接口主要分为余额、分页明细接口,钱包统一format后进行展示。余额接口查询返回后,异步写入Redis进行缓存,用于下次访问业务接口异常时进行兜底展示,如果后续访问业务接口正常,则使用最新数据更新Redis数据。 用户明细分页数据包含分页明细数据和月度汇总数据(月度总收入与总支出),钱包调用下游拆分成两个接口:分页明细接口和月度汇总接口,提供给前端展示页面封装成一个接口,降低前端交互复杂度。调用下游分页接口实时返回用户明细分页数据,月度汇总接口返回用户当前明细所属月份的汇总数据。钱包服务内部根据业务方明细分页接口数据进行汇总,为了减少请求业务方次数,钱包内部判断分页数据,如果返回数据都是同一月份,则只请求业务方一次月度汇总接口,后续分页不再请求,如果返回数据分散在两个月份,则请求业务方月度接口两次,如果返回数据分散在三个月份(含)以上,则只请求起止两个月份的月度数据,中间月份数据由钱包根据明细数据内部计算。 2、多级缓存 百度登录账号体系中,用户id已超过数十亿,存在资产的用户接近亿级,同时钱包会在百度APP个人中心破壳展示部分业务,即一级入口,预计会带来平均万级 QPS、峰值超过十万级 QPS流量,特殊时间点可能会更高。为了防止服务宕机对百度APP产生非预期影响,故需要对破壳展示的数据提供完整缓存方案和降级预案。为了提升系统的高吞吐,我们决定将一级入口数据全部缓存至Redis,访问流量只读Redis,如果遇到Redis异常时,则返回兜底数据,不查询DB(防止压垮DB)。DB数据用来Redis极端情况崩溃时恢复Redis数据时使用。 针对存在资产的用户量分析,进入个人中心的用户存在一个特点:大部分用户没有个人中心外露的资产数据,抽象成一个稀疏矩阵,这就使我们在设计的时候,可以考虑两层缓存:第一层判断用户是否拥有资产信息,第二层缓存存储用户资产数据。故我们设计了如下的两层缓存方案。 △图4-2钱包两层缓存方案时序图 大部分用户流量会被第一层缓存拦截,设计合理的第一层缓存数据结构,成为了系统的一个关键。我们调研了hyperLogLog、布隆过滤器、roaringBitmap等方案,分析和实验后发现,hyperLogLog中pfadd操作本身可以满足性能要求,key的大小在12k也满足,但是由于pfadd本身针对于一个uid,只能操作一次,所以不适合这个场景hyperLogLog;布隆过滤器在试验20亿的数据量下,内存占用来量大约占比3G,内存占用比较大,基于redis的布隆过滤器没有分布式的数据能力,本质上还是对redis的强依赖,存在风险。 roaringBitmap在存储空间上满足要求,我们根据钱包的实际场景,改进了分桶与计算规则,根据用户id进行sharding分桶,桶内使用uid的hash值对应的bitmap位点标记状态。实验数据验证,3000分片,8个计算单元,1000W实验数据,存储空间占用500M+,误判率2.14%,即存在2.14%的用户没有资产信息会打到第二层缓存,整体对第二层缓存增加压力可控。 3、读写分离 钱包服务承接较大的读流量和写流量,为了防止互相影响,我们将读写流量分别拆到不同的服务。用户访问读服务异常时,不影响业务方推送写入,业务方推送写入服务异常时,不影响C端用户访问。读服务主要承接C端用户通过个人中心和钱包首页、二级页面访问的流量,将用户访问的相关数据进行缓存,提升系统平响。写服务主要承接业拉取业务方数据和C端用户授权信息,同时承接消息队列消费处理和与下游业务方交互。读写服务之间,通过RPC接口调用进行交互。 △图4-3读写分离 4、数据一致 个人中心外露的业务数据,针对接入用户中心外露展示的业务方,我们需要业务方在用户资产发生变更时及时推送给钱包,以确保用户在钱包看到的数据与在业务方提供的入口查看的数据是相同的。但实际情况不一定如此,比如业务方推送服务异常、网络抖动,都有可能导致两方数据不一致。于是,我们提出了推拉结合的数据一致性解决方案。即业务方资产信息变更时,准时推送钱包,在用户进入个人中心时,触发拉取用户最新资产信息。当前,我们只对用户的资产信息已被推送至钱包的业务方,拉取用户最新资产信息,防止拉取全量业务方数据给用户量级小的业务方带来过多无效拉取流量导致服务压垮。针对系统内部,由于展示时只使用Redis中缓存数据,如果同步用户信息时因某些异常导致Redis与DB中数据不一致,我们采用定时任务,每天凌晨拉取DB中前一天(DB变更时间)有变更的用户信息,与Redis信息进行比对,数据不一致时,拉取业务方最新数据,更新Redis数据,做到T+1对账,解决系统内数据不一致问题。 对于钱包内展示的业务方,也会存在服务异常、网络抖动导致的无法获取用户最新信息的问题。我们采用的方案,对于正常请求业务方结果数据,将结果信息写入Redis,如果下次访问业务方接口异常时,使用Redis中数据作为兜底,优先确保数据正常展示。如果后续请求下游接口正常,则使用成功的数据更新Redis数据,确保Redis数据的准实时性。 △图4-4钱包数据一致方案时序图 5、配置化 钱包设计之初,就面临着如何支持业务方快速接入和支持运营人员快速配置用户展示界面、活动、营销等信息的问题。通用配置化能力,是解决此类问题的首选方案。 配置化主要分为两部分:接入配置化和展示配置化。通过分析发现,不同业务方的接入、展示需求不同,于是我们抽象共同的信息,生成通用基础信息,对于业务个性化信息,采用扩展模型记录业务特殊配置。汇总业务方基础配置+扩展配置后,放入Redis缓存中。对于钱包展示配置,底层设计展示通用配置,比如展示名称、文案、跳转链接、图片Url、背景图Url,对于特殊展示需求,可配置到扩展信息,比如外露Icon、展示金额,配置信息同样放入Redis缓存中。 项目上线初期,配置信息新增与更改的频次都很高,容易发生修改错误的风险,导致C端用户体验受损。于是我们设计版本号+白名单方案进行放量控制,新版本发布需与白名单用户相关联,配置生效后先使用白名单用户线上进行验证,验证通过后逐步全流量。修改配置时,保存历史更改全量数据,用于配置信息异常时回滚。 由于钱包对业务方配置信息依赖较强,如果Redis异常时会影响钱包的稳定性,所以我们将配置信息同步配置到百度云控平台GCP中,作为Redis异常时的兜底。缓存有效期可以设置永久有效,在变更配置时同步更新Redis,同时需要同步更新GCP配置,及时下发。 6、数据库设计 由于用户量较大,涉及用户资产信息到了数据库层面会同步放大,受限于MySQL数据库单机处理能力,故将数据进行拆分,不同的数据放置在不同的机器,便于机器扩容。在数据模型的设计上,数据库分表字段采用用户id作为分表字段(shardingKey),这样通过用户id定位到具体的库和表,因将整个资产信息库所有表按照统一规则进行切分,分表规则一致,保证按照同一用户都能在一个库,从而可以使用数据库事务。采用分库分表模式,后续遇到数据库存储瓶颈时,可以很方便的进行横向扩容。 五、总结 本文重点在介绍了百度APP个人钱包搭建的整个技术细节,在项目推动和落地的过程中,也遇到了诸多困难,主要的难点在系统高可用、高稳定、快速支持业务接入。梳理清楚难点与技术关键点,抓住关键问题,对系统合理做减法,降低系统复杂度,快速推进系统上线,后续不断迭代,打造极致用户体验。后续,在业务上会持续推进业务线快速接入,让用户在钱包内可以查看、管理百度系全量资产信息,在技术上继续推进稳定性、可靠性建设,为业务方带来更多用户流量,为用户提供更好的用户体验。 ——————END—————— 推荐阅读: 基于宽表的数据建模应用 百度评论中台的设计与探索 基于模板配置的数据可视化平台 如何正确的评测视频画质 小程序启动性能优化实践 我们是如何穿过低代码 “⽆⼈区”的:amis与爱速搭中的关键设计 移动端异构运算技术-GPU OpenCL 编程(基础篇) 云原生赋能开发测试

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册