首页 文章 精选 留言 我的

精选列表

搜索[meetup],共586篇文章
优秀的个人博客,低调大师

Apache Spark Meetup China 第1期 最全资料下载

活动时间:2018年12月16日13:30-17:00 活动地点:杭州市余杭区文一西路998号未来科技城海创园4幢801C 主办单位:阿里云、袋鼠云、云栖社区 主题介绍: 主题一、Spark优化实践-13:30 - 14:30阿里云E-MapReduce-王道远介绍阿里云EMR中Spark计算引擎所包含的一系列额外优化工作,包括SmartShuffle、file skip index等。 主题二、Spark使用对象存储的机遇和挑战-14:30 - 15:30阿里云E-MapReduce-余根茂介绍Spark对对象存储这种类似的访问的原理机制,以及优化的策略 主题三、基于SparkSQL的安防大数据检索分析优化外部-15:30-16:30杭州海康威视研究院大数据技术部 - 陈国栋 介绍基于SparkSQL构建安防大数据交互式查询分析方面做的工作,

优秀的个人博客,低调大师

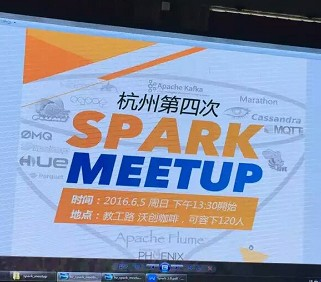
2016年杭州第四次spark meetup见闻

引言 spark发展非常快,2.0都快要发布了。在不同的城市都会有一些交流聚会,杭州有很多互联网企业,创业的氛围也非常好。大家每隔一段时间的交流还是必须的。不过最好还是时间上密集点,最好重点在于大家讨论,互相交流。这次是挖财网的时金魁同学主办的,感谢时金魁同学,演讲稿下载链接 期待2.0发布,最近E-MapReduce团队在做benchmark,找时间单独对比下1.6与2.0之间的性能差距。 过程 有4场次的分享,分别为: 《Spark 2.0介绍》来自七牛的陈超大致介绍了spark2.0的一些新的功能,包括Dataset、Structured Streaming、Tungsten Phase2。记得最清楚就是 陈超说: 目前Structured Streaming还不成熟,吹了很多牛,大家得等到2.x版本吧,不管怎么搞还是基于batch,

优秀的个人博客,低调大师

Meetup 02期回顾:Qualitis 数据质量 0.9.0版本介绍

主题:《Qualitis 数据质量 0.9.0版本介绍》 讲师:周玉壮 微众银行大数据平台工程师 GitHub:https://github.com/WeBankFinTech/Qualitis 以下内容为分享文字版本,点击阅读原文可查看完整视频 Qualitis介绍 Qualitis是一个支持多种异构数据源的质量校验、通知、管理服务的数据质量管理平台,用于解决业务系统运行、数据中心建设及数据治理过程中的各种数据质量问题。 Qualitis基于Spring Boot,依赖于Linkis进行数据计算,提供数据质量模型构建,数据质量模型执行,数据质量任务管理,异常数据发现保存以及数据质量报表生成等功能。并提供了金融级数据质量模型资源隔离,资源管控,权限隔离等企业特性,具备高并发,高性能,高可用的大数据质量管理能力。 批量计算场景数据校验 在进行检验规则的定义跟配置。我们接入数据源,根据规则模板去生成真实的好批的 SQL 去查询这些数据,看是否存在上述的这些问题。我们的批量的这个数据质量的校验是接入了 Linkis 主要使用的是 Spark 阶段引擎,由 Linux 帮我们执行,拿到质量检验结果。 我们在进行质量检验过的质量检验结果,后续的一些校验成功或者检验失败的,处理失败的话,我们有失败任务的熔断或者失败任务的告警。在最后的分析阶段,我们会导出数据质量报告以及可订阅质量报告,自动地推送用户以及数据质量问题的跟踪,跟异常数据的一些统计。 质量管理流程制度落地 同时我们在数据参与人员中也要建立更切实的流程制度。这里第一步,以及后续的分析报告,还有后续的落实出以及生成我们数据检验知识库、知识积累、知识应用、体系标准、专家经验等。我们的技术架构是既提供独立的界面,也可配合工作流 DataSphere Studio 使用。 首先是有我们一个前端入口,有一个我们独立的 UI 还有一个就是内嵌于 DSS 及 Appconn 开发的一个内嵌界面。我们的系统的功能是分模块开发管理,主要有就是规则管理、模板管理、指标管理以及后台的一些人员管理,还有以及项目管理、任务管理以及元数据管理。 功能技术架构 我们后台还应用的技术主要采用的是一些是 Jetty 容器,应用的是 jersey restful 接口管理,刚刚用到了 Zookeeper 来保证高可用多实例的主备服务一致性,还有 Druid 的语法解析,直接去执行解析自定义的 SQL 以及应用到 Easy Excel 帮助我们规则间的一些导入导出多环境复制。 我们底层的依赖主要是 Linkis ,这个必要的是分不开的。使用 Qualitis 这之前必须部署 Linkis 然后就是 DataShapis 我们有数据标准的接入,会拉取 DataShapis 的接口。不过这块不是必要的,以及我们后台的数据库是MySQL。 系统访问权限 我们的数据质量是存在大量的查询操作的,所以我们必须严格管控使用用户的权限。我们接下来介绍一下我们的权限体系。首先就是我们在系统访问控制是基于 URL filter 的后台管理员,普通用户做动态访问权限的控制。 我们的 Url 以 Quality 的前缀,以 GET PUT POST DELETE 这些方法都是对管理员开放的。所以在所有的接口包括集群配置、人员管理、部门管理、增加后回收代理用户等,只有后台管理员才可以访问。对于普通用户,我们把 URL 收缩到 qualitis/api/v1/projector 这一层,给用户开放一些其他的操作,这是我们的系统访问控制。 分级权限控制 然后我们设计了一个分级的权限的控制。我们是将登录用登录系统的用户分为超级、部门管理员、部门人员三个权限等级。我们的权限范围就是依次递减,主要是对于规则模板跟规则的指标这些很敏感型的物料进行权限控制的实现。我们的超级管理员可触达所有的操作。这个比较常规。 我们的部门管理员是具备上层内容查看权限,它的上层也就是超级管理员管理的内容,然后它可触达内部部门内部所有操作。然后部门之间是隔离的,比如多个不同的部门,它是有多个不同的部门角色部门管理员角色。然后我们的部门人员是具备上层他的上层包括超级管理员跟部门管理员管理的内容,他是仅具备查看权限,然后他个人所管理的一些规则模板跟指标是可以触达所有操作的。这个也是主要为了保证我们部门体现的一个敏感数据的保密性以及校验逻辑的协作性,还有业务校验的差异性。 项目授权机制和代理用户机制 接下来的一个权限就是项目授权机制,我们的项目创建者可以通过系路的授权对该项目的下面的批量规则进行协作处理。在我们的界面上项目详情界面项我们权限这样的一个按钮,点击之后会有项目权限管理的界面,这里会帮我们show出来当前拥有项目权限的一些用户,他们是有哪些权限的 接下来就是我们的代理用户机制,我们的登录用户往往是不具备所有要校验的数据权限,此时就需要我们通过代理到更高数据权限的用户进行数据质量校验。代理用户机制就等同于数据访问权限的升高,所以该操作需要系统管理员等合并实施。 左侧这张图就是在没有配置代理用户的时候,当前的登录用户查到了表只有一张表,如果是配置了代理用户,则会访问代理用户下的数据,作为检验数据。配置下代理用户,这里就会看到更多的一些库表。 工作流接入插件升级 接下来来给大家介绍的是我们本次版本更新带来的一些新的功能特性。 首先是工作流,我们的技术插件是由原来的 Appjoint 升级为 Appconn 我们在升级的过程当中是完善了免密规范、项目规范跟节点规范。然后我们是打通工作流项目跟系统的项目授权体系,这也跟我们项目的授权,还有工作流的一些编辑查看发布权限是打通的。然后我们是支持节点版本管理,我们的接口是 OK 的。在工作流我们可以把 query 的节点放在任何一个阶段,进行前置或者后置的一些数据校验。 Linkis任务资源提交配置 然后我们是 Linkis 任务资源提交配置的一些完善。 我们的引擎启动配置参数除了在规则内置可以编辑进去,也就是随着规则而保存,还可以在提交的时候动态修改。 我们看图片就是动态引擎配置这边有一个执行参数,它是可以实时地去替换你要跑任务的一个Yarn的队列名,还有Yarn的一些参数上线以及 Spark 的一些引擎跟 Driver 内存的一些设置。 我们同时支持在这个图片上也可以看到上面有一个切换集群,这个主要是应对集群变更迁移对一些常规的比较重量的自然的影响,我们可以随时地切到可用的集群上去。 还有一个就是任务错误码的解析,追加备注记录快速定位失败,运营任务在跑未通过校验或者跑失败的时候,我们能根据这样异常备注去确定我们任务出问题的原因,然后在系统做一些修改。 指标管理的引入 接下来是指标管理功能的引入,我们的规则需要关联指标。这个指标就是为了帮助我们的校验结果,明确校验业务 it 含义和影响。从这个图片上可以看出来,我们的指标是关联了一些子系统产品或者自定义的一些维度的信息,然后有一些指标的分类跟指标的频率以及开发部门、运维部门及相应的责任人。 这个我会帮助我们一个检验结果来分析它的影响的范围,以及需要跟进的开发或者运维。我们的指标同时是也支持历史值的波动统计,可以实时地查看检验结果。在我们指标末端有一个操作按钮,可以查看历史值这样的一个历史值,就是指它关联的这个规则在历史跑的记录产生的一个检验结果,可以在这里实时查看。通过这样的一个历史值,我们就可以分析校验结构的一个波动。 我们还支持多指标校验,提高校验统计的效率。这个说我们在一个自定义的 SQL 上,可以在一条 SQL select 这样的一个聚合去分别 as 不同的指标。这样一条 SQL 执行下来之后,我们得到的是多个指标的一个结果。 任务生命周期管理 接下来是我们的任务生命周期管理。我们首先是修复了单线程更新任务状态的滞后性,采用动态拆分任务,然后并发更新。接着是完善我们任务批量停止重拉以及对特定日期校验结果的覆盖更新。我们在执行变量配置,这里可以指定一个参数,系统参数叫 run_date 参数值可以指定一个日期。然后我们的任务不管跑了多次,始终更新的都是这一个日期的结果。 质量分析报告导出 最后是我们一个质量分析报告的导出,我们的执行记录是导出到 HDFS 由我们的运维去进行查看,去跟进。然后我们在他的入口在任务查询数据质量分析,点击一个弹窗。这上面有一些你要建面的数据源库表的一些选择以及起止时间,还有它的一个状态以及文件生成路径。这里的文件生成路径就是一个 HDFS 路径,导出的文件的格式是如图所示,它有基本的规则的名称,集群名称、库表名称以及我们校验的一些模板。你是用了什么样的校验?它的结构值是多少,它的状态是多少以及我们的结果。 Roadmap 未来我们的一个 roadmap 以后会继续往完善跟开源的一些功能,比如说像前端交互的升级,我们的看板的现在的信息是过于简单,所以我们的看板分析信息功能会进一步增强。然后我们的指标历史值容易涉及敏感信息,我们对于指标的一个权限机制将进一步优化收缩。 我们的数据库要实现读写分离,方便检验数据采集的同时不影响系统 IO 的效率。我们的任务会增加自动失败重试配置当前是一个手动的失败重拉。然后我们要接入轻量上的调度框架,实现一键调度。我们当前在开源的版本是必须发布到 schedulis 来完成调度。然后我们的多实例实现动态的横向扩容,加入服务治理,保证高可用,以及我们之前已经也提到过的正在做的实时流式校验的一些接入。 在未来社区会继续优化 Qualitis 在业务系统中的应用,也期待和大家交流经验。 备注说明: 1、 参与社区提问的开发者 ,请扫码添加小助手,可以获得社区定制的开源精美礼品一份; 2、公众号后台回复“四大组件”获取讲师分享材料 3、点击“阅读原文”可查看完整视频 扫码添加WeDataSphere小助手 参与社区贡献的方式 (1)新手任务:认领入门任务,详见https://github.com/apache/incubator-Linkis/issues/1161 (2)作品沉淀:发布WeDataSphere开源组建相关内容,包括但不限于安装部署教程、使用经验、案例实践等,形式不限,请投稿给小助手。如: (3)贡献代码:PR和Issue; (4)答疑:热心为开发者答疑,如社区群回答开发者问题、issue答疑等; (5)其他:沙箱体验、参与活动、成为社区志愿者等; 本文分享自微信公众号 - WeDataSphere(gh_273e85fce73b)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

MoonBit Meetup 深圳站 | AI时代下的基础软件的精彩回顾

10 月 25 日下午,「 AI 时代下的基础软件」MoonBit 技术沙龙在深圳圆满举办。来自 MoonBit 团队的多位核心工程师,与粤港澳大湾区的开发者们共同探讨了 AI 与基础软件的结合、 MoonBit 语言的最新进展 以及 AI 驱动下的未来编程方式。 01|MoonBit 的发展与展望 活动由 粤港澳大湾区数字经济研究院基础软件中心首席科学家、MoonBit 团队负责人 张宏波 率先开场,带来了题为《MoonBit 发展与展望》的主题分享。 他回顾了 MoonBit 在过去三年中的成长历程——从最初的语言设计、编译器架构,到生态系统的搭建,再到与 AI 的深度融合。 张宏波表示,MoonBit 团队正在持续推进 编译器自举、AI 编程工具链、异步系统 等关键组件的建设,为智能化软件开发打下坚实的基础。 02 | MoonBit 异步编程系统发布 刘请(MoonBit 核心开发工程师) 带来了关于 MoonBit 异步编程系统 的介绍。 随着 moonbitlang/async 模块的发布,MoonBit 现已拥有完整的异步编程支持,结合结构化并发的设计理念,让异步代码更易读、更安全。 分享中还展示了运行时的架构设计与未来规划,吸引了现场开发者的高度关注。 03|让 AI 写出更好的 MoonBit 代码 刘子悦(MoonBit 核心开发工程师) 带来了关于 AI 编程实践的干货分享。 他结合 MoonBit Pilot、Cursor 等 AI 工具的实际使用案例,讲解了如何通过: 1️⃣ 扁平化设计与模式匹配让 AI 更好“看懂”代码 2️⃣ pattern match 替代不安全索引与 unwrap 3️⃣ 高质量文档与测试提升 AI 代码生成精度 04|AI 与 MoonBit:提升开发生产力的新引擎 鲍志远结合自身开发经验,分享了 AI 在日常工作中的高频实用场景。同时揭秘了 MoonBit 工具链为适配大模型能力所做的优化,让开发者真切感受到技术融合带来的效率飞跃。 05 | 用 MoonBit 构建 Code Agent MoonBit 核心开发工程师 费浩祥 带来了关于「Maria:用 MoonBit 写个 Code Agent」的精彩分享。 Maria 是一个由 MoonBit 从零实现的 Code Agent 框架,能够作为底层 SDK,为开发者构建可定制、可扩展的 AI 助手提供基础。 他详细介绍了 Maria 的事件系统设计、工具接口规范,以及如何通过合理的 JSON schema 与工具抽象来提升 LLM 的可靠性与未来适配性。 06 | 自举 parser & formatter 的技术落地与应用 陈玉斌带来了 MoonBit 自举解析器与格式化器的最新进展。他演示了如何利用 moonbitlang/parser 模块实现词法解析、语法解析与错误恢复,以及 moonbitlang/formatter 的设计思路。更展示了基于这些模块开发的 moonlint 代码检查工具、自定义代码生成工具等实用应用,让大家看到了 MoonBit 生态的强大扩展性。 07|现场活动 除了精彩议题,现场还举行了 「MoonBit × AI 编程挑战」互动活动。 参与者带上电脑现场挑战,用 MoonBit 语言完成任务,就有机会赢取 GitHub Copilot 月度会员。 现场还准备了茶歇礼品,为到场的每一位开发者提供轻松交流的空间。大家在咖啡与点心间畅聊代码、分享想法,从语言实现聊到 AI 工具,从编译原理聊到未来的开发方式,现场氛围热烈又自在。

优秀的个人博客,低调大师

Meetup 回顾|Data Infra 研究社第十六期(含资料发布)

本文整理于上周六(10月21日)Data Infra 第 16 期的活动内容。本次活动由 Databend 研发工程师-王旭东为大家带来了一场主题为《Databend hash join spill 设计与实现》的分享,让我们一起回顾一下吧~ 以下是本次活动的相关视频、资料及文字: 通过本次分享,我们能更加了解Databend的hash join spill的设计与实现,以及学习如何使用spill功能。 本次活动回放也可在 B 站上找到: 🔗https://www.bilibili.com/video/BV1pC4y137sN?t=3.7 《Databend hash join spill 设计与实现》 此次活动的讲稿和相关资料都可以在 Data Infra 第 16期的 PDF 文件中找到:🔗https://github.com/databendcn/data-infra/tree/main/第16期-20231021 Hash join 在 pipeline 架构下的设计 左侧是一个典型的两表 join plan,通过 pipeline builder 会生成右侧的 pipeline,包括 main pipeline 和一条子 pipeline ( build pipeline )。 probe pipeline 和 build pipeline 之间通过 bridge 结构关联,hash table 以及 build 和 probe 共用的一些 states 都会存在 bridge 里面,等 hash join build 侧生成 hash table 后会通过 bridge 把 hash table 给 probe 侧用。 Hash join 是多线程的,假设 build side 有 N 个 threads,probe side 有 M 个 threads。Probe 需要等待 build 完成后才能开始。因为两条 pipeline 是同时开始的,我们没法确定 build 先到达还是 probe 先到达,所以 probe 可能先于 build 发生,又因为是多线程执行,可能所有 probe 的线程都先与build 线程到达,也可能发生交错,这时提前到达的 probe 线程需要异步等待状态。 最直观的想法是用 notify 来控制 build 和 probe 之间的等待,因为是多线程的,所以考虑 notify waiters(),但是 notify 不知道预知有多少 waiters,它只会唤醒 register 过的 waiters,在 build 和 probe 这种模式下找到合适的地方进行注册不太可能的,所以不考虑 notify 而是用 tokio 的 watch channel 来解决 Hash join 的多线程模型。 channel 中的初始值是 0,当 build 侧完成后,最后一个 build 线程把 1 发送到 channel 中来唤醒所有的 probe 线程。probe 在开始等待 build 的时候会订阅 watcher channel,得到一个 receiver,如果此时已经是 1,可以直接进行 probe, 否则就要等待 channel 中发生 change,及 build 的最后一个线程把 1 写到 channel 里。 pub async fn wait_first_round_build_done(&self) -> Result<()> { let mut rx = self.build_done_watcher.subscribe(); if *rx.borrow() == 1_u8 { return Ok(()); } rx.changed() .await .map_err(|_| ErrorCode::TokioError("build_done_watcher's sender is dropped"))?; debug_assert!(*rx.borrow() == 1_u8); Ok(()) } 梳理完 build 和 probe 之间的交互后,看一下 build 的状态。不考虑 spill 的时候,它的状态比较简单,只有三个 steps,不同的 step 对应不同的 event,触发不同的行为,有异步的有同步的,一些比较重的 IO 会进行异步,还有线程之间的等待也会异步,比如在 finalize 之前需要等所有的 threads 都完成 running step (即搜集完所有的 data )。 enum HashJoinBuildStep { // The running step of the build phase. Running, // The finalize step is waiting all build threads to finish and build the hash table. Finalize, // The fast return step indicates there is no data in build side, // so we can directly finish the following steps for hash join and return empty result. FastReturn, // Wait to spill WaitSpill, // Start the first spill FirstSpill, // Following spill after the first spill FollowSpill, // Wait probe WaitProbe, // The whole build phase is finished. Finished, } 首先所有的线程都开始运行,进入第一个 step—running,这一步主要收集 input data,到 chunk 里面,一个线程完成当前任务后需要等待其他完成,这里我们可以用 Barrier 这个 sync 结构。最后一个线程负责切分 finalize tasks 和初始化 hash table,之后所有的线程进入 finalize 阶段,并行的写 hash table。 FastReturn 是一个 fast path,如果 build side 数据为空,那么对于一些特定的 join 类型,probe 可以直接返回,不需要 probe 一个 空的 hash table。 接下来看下 probe 的状态 enum HashJoinProbeStep { // The step is to wait build phase finished. WaitBuild, // The running step of the probe phase. Running, // The final scan step is used to fill missing rows for non-inner join. FinalScan, // The fast return step indicates we can directly finish the probe phase. FastReturn, // Spill step is used to spill the probe side data. Spill, // Async running will read the spilled data, then go to probe AsyncRunning, } 第一个 step 就是我们之前提到的:等待 build 的阶段。这个阶段完成后,进入 probe 阶段。等所有的线程都完成了 probe,对于 non-inner join 要进行 Final Scan,来进行 补 NULL。 Spiller 模块的设计 Spiller 是一个比较独立的模块,也就是说不局限在某一个 operator 上,所有有 spill 需求的 operator 都可以利用 Spiller 模块完成 spill 操作。 具体来说,spiller 负责以下工作: 收集需要 spill 的数据 partition 需要 spill 的数据 序列化和反序列化数据 与存储进行读写交互 每一个 partition 都有一个 file lists,通过 opendal 把对应的 files 写到存储上。 Hash join spill 设计与实现 首先看一下 build 侧,80% 的工作量都在 build 侧,probe 只需要根据 build 的 spill 信息进行 spill 就可以。 enum HashJoinBuildStep { // The running step of the build phase. Running, // The finalize step is waiting all build threads to finish and build the hash table. Finalize, // The fast return step indicates there is no data in build side, // so we can directly finish the following steps for hash join and return empty result. FastReturn, // Wait to spill WaitSpill, // Start the first spill FirstSpill, // Following spill after the first spill FollowSpill, // Wait probe WaitProbe, // The whole build phase is finished. Finished, } 引入 spill 后,build step 多了四个主要的 step,WaitSpill、FirstSpill 以及 FollowSpill 和 WaitProbe。 每个线程都有自己的 Spiller,否则这个线程的 spill 工作,不同线程的 spill 通过 BuildSpillCoordinator 来协调。 如果一个线程对当前内存数据大小进行判断,发现需要 spill 后,会进入 WaitSpill 状态,BuildSpillCoordinator 会记录当前等待 spill 的线程数量,最后一个线程不会进入等待状态,而是直接作为 coordinator,来协调第一次 spill,它会把 buffer 中所有等待 spill 的数据收集起来,进行 partition,均匀的生成 tasks,分发给每个线程,每个线程的 partition set 都是一样的。完成第一次 spill 后,之后的 spill 不需要再 buffer 数据,如果数据有对应的 partition 可以直接进行 spill,否则 buffer 起来,看后续是否还需要 spill,如果内存够用,可以直接生成 hash table。 等所有的 spill 工作完成后对内存中的数据,进行正常的 hash join build 过程,生成 hash table,通过 bridge 发给 probe 后进入 wait probe 状态。 接下来先看下 hash join probe 侧 spill 的工作,然后再回到 build。 probe 和 build 一样,每个线程都有一个 Spiller。 enum HashJoinProbeStep { // The step is to wait build phase finished. WaitBuild, // The running step of the probe phase. Running, // The final scan step is used to fill missing rows for non-inner join. FinalScan, // The fast return step indicates we can directly finish the probe phase. FastReturn, // Spill step is used to spill the probe side data. Spill, // Async running will read the spilled data, then go to probe AsyncRunning, } 有了 spill 后,当 WaitBuild 阶段结束后,就要进入 Spill 阶段了。 build 会通过 bridge 把它的 partition set 发过来,比如 {0, 1, 2 3},probe 也会利用 Spiller 对数据计算 partition,如果 partition id 在 build 的 partition set 中,会下刷,对于不在的数据,如果是第一轮,会跟 build 发送过来的 hash table 进行 probe。 spill 完成后,会选出一个 partition id,发送给 build,build 拿到 id 后,会把相关 partition 的数据读上来,进行正常的 hash join build 流程,生成 hash table 给 probe,probe 也会读取对应 id 的数据进行 probe,这就是正常的 hash join 过程。每完成一轮,就取一个 partition id,直到没有需要读取的 partition。 未来规划 支持递归 spill 应用具体的场景 进一步优化 Connect With Us Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 Databend Website GitHub Discussions Twitter Slack Channel

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册