首页 文章 精选 留言 我的

精选列表

搜索[思维链],共10003篇文章
优秀的个人博客,低调大师

单链表解题思维

一、概念 链表由一组零散的结点通过指针连接而成,每个结点都包含当前结点内容和后继指针。相对于数组,它不受固于存储空间的限制,可更快捷地进行插入和删除操作,主要有以下几种类型: 1、单链表 指针指向下一个节点,终点指向null 2、双链表 指针指向前一个节点和后一个节点 3、循环链表 最后一个节点指向第一个节点 在解决链表相关问题时,先执行三步骤,再敲下代码会更清晰 确定解题的链表类型 画图理清思路 确定边界条件 不同于数组,JS官方还没有提供一个直接的链表API,可通过对象的方式模拟出链表,其结构为 const head = { data: 1, next: { data: 2, next: null, }, }; 二、leetcode 最常见相关题型 1、合并两个有序链表 将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的 示例: 输入: l1 = [1,2,4], l2 = [1,3,4] 输出: [1,1,2,3,4,4] 步骤: 解题的链表类型是单链表 思路: l1 与 l2 是有序递增的,因此 l1.val 与 l2.val 的较小值就是合并后链表的最小值 依次递归 大小节点的比较,直到 l1 l2 均为 null 边界条件:递归到任意链表为 null 即可停止,并将 next 指向另外的链表 var mergeTwoLists = function(l1, l2) { if (l1 === null) { return l2 } else if (l2 === null) { return l1 } else if (l1.val < l2.val) { l1.next = mergeTwoLists(l1.next, l2) return l1 } else { l2.next = mergeTwoLists(l2.next, l1) return l2 } }; 2、环形链表 给定一个链表,判断链表中是否有环。如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。如果链表中存在环,返回 true 否则返回 false 。要求用 O(1) 内存解决此问题 pos 表示链表尾连接到链表中的位置,若 pos 是 -1 则该链表中没有环 示例: 输入:head = [3,2,0,-4], pos = 1 输出:true // 链表中有一个环,其尾部连接到第二个节点 步骤: 解题的链表类型是单链表 思路: 龟兔赛跑算法:利用快慢双指针,快指针走两步,慢指针走一步 如果链表存在环,则两个速度不同的指针必定会相遇。并且从相遇点和链表头结点同时往下走,会在环起点相遇 边界条件: 快指针指向 null 停止,无环 快慢指针指向同一个节点,有环 var hasCycle = function(head) { if(!head || !head.next) return false; let slow = head.next; let fast = head.next.next; while(slow !== fast ) { if(!fast || !fast.next) return false; slow = slow.next; fast = fast.next.next; } return true } 3、反转链表 给你单链表的头节点 head ,请你使用迭代或递归地反转链表,并返回反转后的链表 示例: 输入: head = [1,2,3,4,5] 输出: [5,4,3,2,1] 步骤: 解题的链表类型是单链表 迭代思路: 将单链表的每个节点的后继指针指向它的前驱节点 边界条件: 当链表 null 停止 链表仅有一个节点 var reverseList = function(head) { if(!head || !head.next) return head; let prev = null; let cur = head; while(cur) { const curNext = cur.next; // 反转后赋值给prev指针 cur.next = prev; prev = cur; // 链接到下一个节点 cur = curNext; } return prev }; 4、链表的中间结点 给定一个头结点为 head 的非空单链表,返回链表的中间结点,如果有两个中间结点,则返回第二个中间结点(给定链表的结点数介于 1 和 100 之间) 示例: 输入: [1,2,3,4,5] 输出: 3 输入: [1,2,3,4,5,6] 输出: 4 步骤: 解题的链表类型是单链表 思路: 快指针p2的位移是慢指针p1的2倍,所以当p2走到链表尾部时,p1刚好走了一半,指向链表的中点。 下题同理 边界条件: 快指针指向 null 时,慢指针刚好处于中间位置 var middleNode = function(head) { if(!head || !head.next) return head; let slow = head; let fast = head; while(fast && fast.next) { slow = slow.next; fast = fast.next.next; } return slow }; 5、删除链表倒数第 n 个结点 给你一个链表,删除链表的倒数第 n 个结点,并且返回链表的头结点 示例: 输入:head = [1,2,3,4,5], n = 2 输出:[1,2,3,5] 步骤: 解题的链表类型是单链表 思路: 快指针一次性走完n个节点,接着两个指针一起往后走,直到快指针指向null,此时慢指针就是倒数第n个节点 添加哨兵处理第n个节点 边界条件: 快指针指向 null 时,慢指针所在位置就是倒数第n个节点 const removeNthFromEnd = function (head, n) { // 哨兵 let preHead = new ListNode(0) preHead.next = head let slow = preHead; let fast = preHead; // 先走n步 while (n--) { fast = fast.next } // 一起走 while (fast && fast.next) { fast = fast.next slow = slow.next } slow.next = slow.next.next return preHead.next; }; 6、回文链表 给你一个单链表的头节点 head ,请你判断该链表是否为回文链表。如果是,返回 true ;否则,返回 false 示例: 输入: head = [1,2,2,1] 输出: true 步骤: 解题的链表类型是单链表 思路: 借助数组,将链表丢进数组 设置前后指针,前后指针理应相同,若不同则不是回文 循环结束若没有返回false则是回文 边界条件: 前后指针不一致 循环结束 var isPalindrome = function (head) { const res = [] while (head) { res.push(head.val); head = head.next } let pre = 0; let last = res.length - 1; while (pre < last) { if (res[pre] !== res[last]) return false; pre++; last--; } return true } 8、相交链表 给你两个单链表的头节点 headA 和 headB ,请你找出并返回两个单链表相交的起始节点。题目数据保证整个链式结构中不存在环。 注意: 函数返回结果后,链表必须 保持其原始结构(需复制新的链表) 如果两个链表没有交点,返回 null 程序尽量满⾜ O(n) 时间复杂度,且仅⽤ O(1) 内存 示例: 输入:intersectVal = 4, listA = [1,2,3,4,5], listB = [6,7,4,5], skipA = 3, skipB = 2 // 在 A 中,相交节点前有 3 个节点;在 B 中,相交节点前有 2 个节点 输出:Intersected at '4' // 相交节点的值为 4 (注意,如果两个链表相交则不能为 0) 步骤: 解题的链表类型是单链表 思路: 同上,寻找AB链表的高度差并消除,已知相交点之后的长度必须相等 AB双指针同时前进,当短链表B的指针遍历完成时,双指针的长度差刚好是双链表的长度差,将B指针指向A链表的头节点,跟着A指针再一次遍历,直到A指针遍历完成 同样将A指针指向B链表的头节点,B指针向前一步,则消除了链表的高度差 边界条件: 指针指向null时,切换指向链表 AB链表值相等 var getIntersectionNode = function (headA, headB) { if (!headA || !headB) return null; let pA = headA; let pB = headB; while (pA !== pB) { pA = pA !== null ? pA.next : headB; pB = pB !== null ? pB.next : headA; } return pA; } 9、链表求和 给定两个用链表表示的整数,每个节点包含一个数位,这些数位是反向存放的,也就是个位排在链表首部。编写函数对这两个整数求和,并用链表形式返回结果 示例: 输⼊:(7 -> 1 -> 6) + (5 -> 9 -> 2),即617 + 295 输出:2 -> 1 -> 9,即912 步骤: 解题的链表类型是单链表 思路: 输出的是新链表,因此需要创建一个链表 由于是反向存储,则链表从个位数开始计算,大于十则进位 进位,首先考虑⽤carry存储每次的进位,余数存储进创建的节点 边界条件: 双链表指向null时,遍历完成 遍历完成,carry不为0,则还需前进一位 const addTwoNumbers = function (l1, l2) { // 哨兵 let preHead = new ListNode(0) let carry = 0; let pre = preHead; while (l1 || l2) { let sum = 0; if (l1) { sum += l1.val l1 = l1.next } if (l2) { sum += l2.val l2 = l2.next } sum += carry carry = Math.floor(sum / 10) pre.next = new ListNode(sum % 10) pre = pre.next } if (carry > 0) { pre.next = new ListNode(carry) pre = pre.next } return preHead.next } 进阶:思考⼀下,假设这些数位是正向存放的,⼜该如何解决呢? 输⼊:(6 -> 1 -> 7) + (2 -> 9 -> 5),即617 + 295 输出:9 -> 1 -> 2,即912

优秀的个人博客,低调大师

mysql优化思维引导一

一般数据库优化分sql语句优化和数据库服务器参数优化,数据库服务器参数优化是DBA可以独立完成的,但是sql语句优化就必须和开发人员协同完成。 现在我们先不谈优化的实施,我们先研究下如何优化,优化哪里,我们要找准数据库性能的瓶颈,有的放矢,这样才能让优化立竿见影。 如何找到mysql数据库得瓶颈呢?如何提前发现mysql数据库可能出现的瓶颈呢?这里又分两大方面。 一方面是架构的设计和业务的类型,另一方面是通过观察mysql数据库的状态,好似中医的望闻问切。 关于第一个大的方面,需要注意的是。在业务前期,一定要确定业务的类型,是OLAP系统还是OLTP系统,数据量到底有多大,并发量到底有多大,查询居多,还是修改插入居多,需不需要支持事务和外键约束等信息。 因为这些信息可以帮助我们在设计数据库架构,选取数据库引擎的时候有很大帮助。还有就是硬件层面的需求,到底多大业务,需要多少的硬件资源,硬件支援才压力承受范围内,可以得到很好的性能,如果超过了压力承受范围,那么性能会下降的很厉害,并且硬件的各个组成部分要匹配,不要出现某个部分太差,原因大家都应该知道的。 下面举两个简单的案例 案例一、一个公司的数据库出现这样一个问题,一个myisam引擎的表,只有几百行的数据,但是table.myd文件却占了数十个G的空间,每次操作这个表的时候,速度就奇慢。 通过explain查看,又是正常的,这个问题在很多数据库上都存在,用oracle的话来说,就是高水位和块回收的问题。如果找到原因 optimize table tablename,优化一下表就可以了。 由于那个表操作很频繁,需要经常优化,这样就增加了DBA或者运维的工作量,这种问题其实在当初设计的时候,选用memcache引擎就比较合适,但是web应用的话还是比较适合memcached。 案例二、一个考试系统,当考试完成的时候,大家一交卷,服务器垮掉了,这是为什么呢? 因为大家都想要同时往一个表里写数据,但是等待表锁很严重,最后服务器挂掉了,所有数据未保存,这种情况在业务设计之初,就应该考虑到,使用innodb引擎,就可以解决这个问题。 应为innodb引擎室行锁对这种大并发的写入操作承受力很强。现在的考试系统已经比较完善,大部分是边做题,边提交数据库,就算这样,innodb引擎在这种应用还是很有优势的。 这些情况都还好,能够修复,不会对业务造成的影响一般,如果一个架构前期没有设计好,等到开发完成,投入使用了,发现有问题,再返回修改,修改量和测试的工作量是相当庞大的,结果就是浪费资金,浪费时间。 本文转自 fenghao.cn 51CTO博客,原文链接:http://blog.51cto.com/linuxguest/455251,如需转载请自行联系原作者

优秀的个人博客,低调大师

朴素系统优化思维的实践

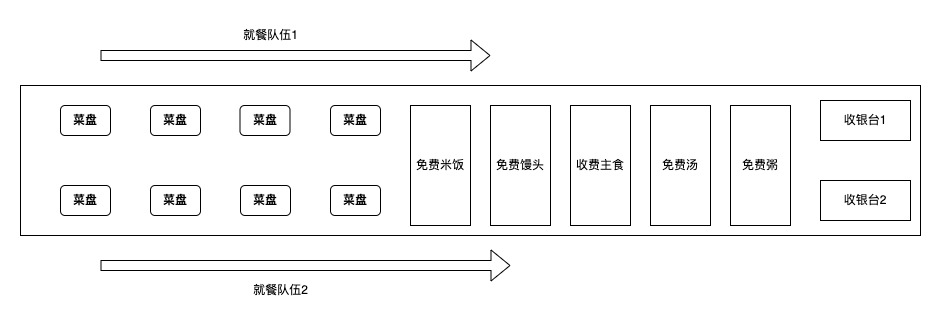
作者:京东物流 严孝男 一、问题 去年年中时候,我有个好朋友(可以叫他华哥)顶着当时还很严重的疫情形式激情创业,斥巨资承包了他原公司食堂的几个摊位,摇身一变成了老板。当了老板的华哥没有丝毫懈怠,不但做了充足的市场调研,还结合他自己以前就餐时的痛点做了创新,比如以前食堂除了最常规的面,饺子,米线一类的之外就是一份份的卖炒菜,差不多一份荤菜十几块,一份素菜近十块的样子,这就导致一个问题,一般男生花了几十块钱也就只能吃到2-3个菜,不但营养不够丰富,万一踩坑遇到了原本抱有很高期待但发现实际菜并不好吃的情况,体验就更差了。 所以华哥借鉴了市面上麻辣烫自选称重模式的特点推出了自助选菜称重的模式,餐台上会摆放很多种做好的菜(荤素凉都有),大家根据自己的喜好自己打菜,主食的米饭和馒头免费,粥和汤也免费,然后还提供一些收费的主食比如红薯,玉米一类的,打菜的流程就是大家从台子两边按顺序开始自选打菜,然后选择主食,然后选择汤粥,然后结账刷卡,如下图所示: 华哥不愧是前互联网大厂的金牌产品经理,其敏锐的抓住了用户的痛点,并很好的给出了相应的解决方案,自助称重模式自从推出后就受到了同事们的热烈欢迎,每次都排了长长的队伍,甚至中午11点半开餐,不到11点20就有很多同事在排队等着,写到这里我想举个排长队的例子给大家一个直观的印象,我最开始想到的例子是五道口那个枣糕店门口排的长队,后来一想现在京东2号楼B座4楼餐厅里排瓦罐的队伍好像更贴切。 华哥开始的时候非常开心,但一个月后做了营收盘点发现有点不对,虽然看上去队伍排得很长很火爆的样子,但实际上营收并不如预期。华哥分析了一下排除了客单价低的因素,自选模式下好多菜大家看到后都想来一点,一来二去就会打好大一盘,基本都是20元起步的客单价;然后就剩下单量低这个可能性了,实际分析一下就可以发现,因为菜的可选品种很多,所以选菜环节每个人需要花很长的时间选菜,再加上需要打汤和打饭,一个人实际完成整个取餐的过程耗时是很长的,虽然后面的同事可以跟在前面同事后面串行打菜,但因为每个人的喜好不一样,所以每个人在不同菜前的停留时间不一样,这就导致当前面的同事在某个菜盘前耗时稍长的时候,后面的同事是处于等待状态的。 而且有的时候还会遇到一些极端的情况,比如有些同事会在某些他爱吃的菜前停留很久挑挑拣拣,还有些同事会在打免费汤时拿着大勺顺逆时针交替着疯狂搅动,以此企图捞起汤里那些零散的沉底的菜叶和鸡蛋白,华哥就亲眼目睹了他以前汇报的经理在辣子鸡丁菜盆里翻来覆去的寻找隐匿在辣椒深处的那一点点鸡肉,每发现一块鸡肉时经理的脸上还会露出那种心满意足充满成就感的笑容,话说回来其实在经理挑鸡肉时整个队伍实际是处于完全停滞状态的,所以综合来看整个队伍的执行就餐过程是非常缓慢的,也就导致实际打完餐付费的人数并不如想象中多。 二、方案 后来在一次好友聚会时,华哥和我聊起了这个事情,他问我:你们搞技术的不都各种吹嘘什么系统优化,降本增效一类的吗,你帮我想想办法。听完华哥这略带挑衅意味的要求,我突然觉得自己身上有了很重的责任感,觉得自己要守住技术人的尊严。于是自己好好想了想,然后觉得这个商业问题实际上也可以看成一个技术问题,这个餐台可以看成一个系统,打餐的流程可以认为是系统的一次交互流程,每个打菜的同事可以看成是一次调用,因为每次调用执行起来的性能太差,导致系统整体的吞吐量太低,影响了整体系统的效能,因此整个系统的效能很低,虽然当时已经是酒过三巡,脑子不太清醒了,但是自己还是尽力给华哥想了好几个办法。 2.1 系统扩容 第一个想到的办法就是扩容,在工程技术领域当遇到系统性能不达标时,第一个想到的解决方案也一般都是扩容,工程领域里的扩容一般可以分垂直扩容和水平扩容两种方式:垂直扩容是通过提升单体实例的硬件能力来提升单体处理能力,水平扩容则是通过增加实例节点的方式来增加整个系统的处理能力。 套用这两个理论,看看怎么提升餐台的吞吐,好像垂直扩容这块能做的不多,总不能把打饭的勺子升级一下变成德国原装进口高温武火蹴练镀金勺吧;不过虽然垂直扩容没什么好办法, 但是水平扩容好像能做的事情很多了,只要多增加几套打菜餐台,这样并行执行的2条打饭队伍就可以变成4条,甚至8条,直接实现了多线程并发,这样系统整体的吞吐能力可以立马获得翻倍式提升,效果不但见效块,效果也可谓是立竿见影,于是我给画了一个水平扩容示意图,如下图所示: 不过水平扩容的方案很快就被华哥否了,虽然在工程技术领域,随着云原生技术的成熟,应用级别的扩容缩容都是很成熟的提升系统处理能力的解决方案了,但是在华哥这里,想再搭一个餐台是不可能的,且不说华哥承包的摊位没有这么大的地方去搞第二个餐台,就算有,从新施工装修,水电改造一系列的成本也几乎是不可能实现的。 虽然这个世界上能用钱解决的问题都不叫问题,但现在的问题是华哥没钱了。 2.2 单次执行优化 提升系统并发能力的路走不通后,那么提升系统的吞吐量的办法就是缩短单条请求的处理执行时间,这样单位时间内系统处理的请求条数就会有提升,从而提升系统吞吐量,那回到餐台这里,就变成了需要缩短单人打餐的时间,尤其是遇到华哥前经理那种在单个菜盘前会耗费大量时间的情况该如何优化呢? 我们拆分一下每次调用,把在每个菜盘前打菜的过程可以模拟理解为执行一段逻辑,这样全部的打菜过程可以被拆解成一个个小的代码块,总的调用时间是由这些代码块的执行时间之和决定的,从工程技术视角的话就是保证每段逻辑都在一个可预期的时间内完成,所以每段逻辑都可以通过一个超时判断逻辑来控制每段代码的执行时间,这里举一个百度搜索的例子,百度为了增强返回结果的多样性,推出了阿拉丁架构,每个query经过星图模型解析后会分发给不同的垂类,每个垂类会加工生产属于自己业务领域的卡片,然后阿拉丁的root应用聚合垂类返回的各个结果并返回给用户,那某些垂类场景执行会比较慢,比如当遇到用户搜一款药的场景时,健康垂类的应用会根据搜索人的经纬度筛选附近的o2o的药店,并计算该药品在该门店的促销折扣价,这种计算往往会耗时很久,所以root应用会增加一个380ms的超时判断,对所有的垂类应用都是一样,当你返回的内容超过这个时间后结果会被丢弃,举这个例子让大家可以明白通过增加对每个环节的超时设置,这样可以保证整体的流程在一个可控的时间范围内得到执行,从而保证用户体验的一致性。 程序里的超时好加,因为程序没有喜怒哀乐,但打餐的场景不一样,总不能在每个菜后面安排一个服务员在背后数123计时,超过5s往前推他一把,总不能这样吧,究其原因就是打菜是主观能动的,他想在一个菜前停多久就停多久,想到这个问题后,我有了主意,把用户自主停留的权利给剥夺,创造统一的停留时间,所以我给华哥设计了一套超时装置,那就是在餐台的两边各增加一套自动传送装置,类似于飞机场里安检后赶去航站楼的传送带一样,这样人们在两边打菜时不需要自己走动了,而且每个人在每个菜盘前停留时间是一样的,就不会出现一个人在某个菜前停留时间过久的问题,也避免了餐台因前面某个人的长时间停留而出现整体停滞的问题,提升了餐台的吞吐量,而且传送带的增加还有个好处就是人不多时可以开得很慢甚至停掉,在高峰期时可以适当增加传送带的速度,从而控制每一个人打菜的时间,保障整个餐台的吞吐率。 华哥听到我这个有点天才的想法后愣了很久,盘算了一下可能性后他觉得这个办法还真的可行,只是需要等到十一或者五一长假期间动工在两边增加传送带,终于听到一个可行方案的华哥有点兴奋,两腮也泛出了点点的红晕。 2.3 非核心流程剔除 看到华哥接纳了我的这个方案,我顿时感受到了很大的鼓励,于是又继续思考这块流程还能怎么优化,在工程技术领域,一个流程在承受很大流量时还可以做的一个事情就是流程简化,只保留核心的流程环节,也就是大家常说的黄金流程,而将非核心的业务节点从主流程中剔除,这样精简后的主流程可以一定程度上缩短执行时间,而且主流程执行的逻辑少了,出错的概率也同时就降低了,举一个京东零售的下单计算流程为例,零售侧结算时需要做以下的事情: 实际上结算这块还有很多的非主要节点要处理,比如删除购物车中相关已结算商品,预占自提柜等等,但是这些属于非核心的流程,可以从主流程中剔掉。 回到餐台这里,什么流程是黄金流程,没错,就是那些和营收直接相关的流程,而那些不产生收益的项目,比如米饭馒头,汤粥的环节就可以认为是非主要流程,可以从主流程中剔掉,这样不断简化了大家取餐的主流程,而且还节省了餐厅的空间,剩余的空间可以用来做几件事,一个是可以多放一些收费的主食或者增加一些菜品,以此可以增加收入,第二个可以增加一些自助收银设备,之前2个收银台在之前打餐比较慢时可以满足需求,但现在整个流程简化了,整体每个人的打餐速度提升了,这样2个收银台就会变成新的瓶颈,尤其是遇到有扫码直付的同学就会瓶颈的更明显,这样通过增加收银台的数量,从而提升了收银环节的并发处理能力,保证了整个取餐流程的流畅,避免新的性能瓶颈的出现,完美! 华哥听完这个建议很满意,他正嫌餐台太小摆放的菜系不够多呢,这样空间被更合理的利用到能带来收益的食品上了,正合华哥之意,华哥很开心的敬了我一个。 2.4 分布式缓存 除此之外,互联网增加系统吞吐能力,缩短单次执行时间的一个很主要的法宝利器就是利用分布式缓存技术,分布式缓存技术可以让很多存在系统瓶颈的调用通过缩短数据获取时间从而极大缩短处理时间,在这里分布式缓存技术是不是也可以利用到餐台这里呢。 我想了一下,前面从主流程中拿掉的免费主食部分和汤粥部分可以利用缓存的原理,尤其是CDN缓存的原理,把主食和汤粥分布式的放在离同事们就餐的餐桌附近,这样可以让就餐的同事们最近范围就可以盛到主食和汤粥,表面上看对营收没提升,但实际上一是大家打饭近了,就餐体验好了,二是大家打饭加饭方便了,就餐的时间就会降低,从而提升餐桌的利用率。保证下一个打到饭的同事能快速找到座位,体验同样也会提升。这里我就不画图了,相信大家都能明白。 三、后记 华哥整体听完我的优化方案后低头陷入了沉思,许久之后他抬起头看着我,眼神有些许迷离,我顿时有点紧张,以为他要系统点评一下我的方案,没想到华哥开口问我的是,现在几点了,我才意识到华哥刚才是喝多了低头睡着了。

优秀的个人博客,低调大师

每日一博 | 单链表解题思维

一、概念 链表由一组零散的结点通过指针连接而成,每个结点都包含当前结点内容和后继指针。相对于数组,它不受固于存储空间的限制,可更快捷地进行插入和删除操作,主要有以下几种类型: 1、单链表 指针指向下一个节点,终点指向null 2、双链表 指针指向前一个节点和后一个节点 3、循环链表 最后一个节点指向第一个节点 在解决链表相关问题时,先执行三步骤,再敲下代码会更清晰 确定解题的链表类型 画图理清思路 确定边界条件 不同于数组,JS官方还没有提供一个直接的链表API,可通过对象的方式模拟出链表,其结构为 const head = { data: 1, next: { data: 2, next: null, }, }; 二、leetcode 最常见相关题型 1、合并两个有序链表 将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的 示例: 输入: l1 = [1,2,4], l2 = [1,3,4] 输出: [1,1,2,3,4,4] 步骤: 解题的链表类型是单链表 思路: l1 与 l2 是有序递增的,因此 l1.val 与 l2.val 的较小值就是合并后链表的最小值 依次递归 大小节点的比较,直到 l1 l2 均为 null 边界条件:递归到任意链表为 null 即可停止,并将 next 指向另外的链表 var mergeTwoLists = function(l1, l2) { if (l1 === null) { return l2 } else if (l2 === null) { return l1 } else if (l1.val < l2.val) { l1.next = mergeTwoLists(l1.next, l2) return l1 } else { l2.next = mergeTwoLists(l2.next, l1) return l2 } }; 2、环形链表 给定一个链表,判断链表中是否有环。如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。如果链表中存在环,返回 true 否则返回 false 。要求用 O(1) 内存解决此问题 pos 表示链表尾连接到链表中的位置,若 pos 是 -1 则该链表中没有环 示例: 输入:head = [3,2,0,-4], pos = 1 输出:true // 链表中有一个环,其尾部连接到第二个节点 步骤: 解题的链表类型是单链表 思路: 龟兔赛跑算法:利用快慢双指针,快指针走两步,慢指针走一步 如果链表存在环,则两个速度不同的指针必定会相遇。并且从相遇点和链表头结点同时往下走,会在环起点相遇 边界条件: 快指针指向 null 停止,无环 快慢指针指向同一个节点,有环 var hasCycle = function(head) { if(!head || !head.next) return false; let slow = head.next; let fast = head.next.next; while(slow !== fast ) { if(!fast || !fast.next) return false; slow = slow.next; fast = fast.next.next; } return true } 3、反转链表 给你单链表的头节点 head ,请你使用迭代或递归地反转链表,并返回反转后的链表 示例: 输入: head = [1,2,3,4,5] 输出: [5,4,3,2,1] 步骤: 解题的链表类型是单链表 迭代思路: 将单链表的每个节点的后继指针指向它的前驱节点 边界条件: 当链表 null 停止 链表仅有一个节点 var reverseList = function(head) { if(!head || !head.next) return head; let prev = null; let cur = head; while(cur) { const curNext = cur.next; // 反转后赋值给prev指针 cur.next = prev; prev = cur; // 链接到下一个节点 cur = curNext; } return prev }; 4、链表的中间结点 给定一个头结点为 head 的非空单链表,返回链表的中间结点,如果有两个中间结点,则返回第二个中间结点(给定链表的结点数介于 1 和 100 之间) 示例: 输入: [1,2,3,4,5] 输出: 3 输入: [1,2,3,4,5,6] 输出: 4 步骤: 解题的链表类型是单链表 思路: 快指针p2的位移是慢指针p1的2倍,所以当p2走到链表尾部时,p1刚好走了一半,指向链表的中点。 下题同理 边界条件: 快指针指向 null 时,慢指针刚好处于中间位置 var middleNode = function(head) { if(!head || !head.next) return head; let slow = head; let fast = head; while(fast && fast.next) { slow = slow.next; fast = fast.next.next; } return slow }; 5、删除链表倒数第 n 个结点 给你一个链表,删除链表的倒数第 n 个结点,并且返回链表的头结点 示例: 输入:head = [1,2,3,4,5], n = 2 输出:[1,2,3,5] 步骤: 解题的链表类型是单链表 思路: 快指针一次性走完n个节点,接着两个指针一起往后走,直到快指针指向null,此时慢指针就是倒数第n个节点 添加哨兵处理第n个节点 边界条件: 快指针指向 null 时,慢指针所在位置就是倒数第n个节点 const removeNthFromEnd = function (head, n) { // 哨兵 let preHead = new ListNode(0) preHead.next = head let slow = preHead; let fast = preHead; // 先走n步 while (n--) { fast = fast.next } // 一起走 while (fast && fast.next) { fast = fast.next slow = slow.next } slow.next = slow.next.next return preHead.next; }; 6、回文链表 给你一个单链表的头节点 head ,请你判断该链表是否为回文链表。如果是,返回 true ;否则,返回 false 示例: 输入: head = [1,2,2,1] 输出: true 步骤: 解题的链表类型是单链表 思路: 借助数组,将链表丢进数组 设置前后指针,前后指针理应相同,若不同则不是回文 循环结束若没有返回false则是回文 边界条件: 前后指针不一致 循环结束 var isPalindrome = function (head) { const res = [] while (head) { res.push(head.val); head = head.next } let pre = 0; let last = res.length - 1; while (pre < last) { if (res[pre] !== res[last]) return false; pre++; last--; } return true } 8、相交链表 给你两个单链表的头节点 headA 和 headB ,请你找出并返回两个单链表相交的起始节点。题目数据保证整个链式结构中不存在环。 注意: 函数返回结果后,链表必须 保持其原始结构(需复制新的链表) 如果两个链表没有交点,返回 null 程序尽量满⾜ O(n) 时间复杂度,且仅⽤ O(1) 内存 示例: 输入:intersectVal = 4, listA = [1,2,3,4,5], listB = [6,7,4,5], skipA = 3, skipB = 2 // 在 A 中,相交节点前有 3 个节点;在 B 中,相交节点前有 2 个节点 输出:Intersected at '4' // 相交节点的值为 4 (注意,如果两个链表相交则不能为 0) 步骤: 解题的链表类型是单链表 思路: 同上,寻找AB链表的高度差并消除,已知相交点之后的长度必须相等 AB双指针同时前进,当短链表B的指针遍历完成时,双指针的长度差刚好是双链表的长度差,将B指针指向A链表的头节点,跟着A指针再一次遍历,直到A指针遍历完成 同样将A指针指向B链表的头节点,B指针向前一步,则消除了链表的高度差 边界条件: 指针指向null时,切换指向链表 AB链表值相等 var getIntersectionNode = function (headA, headB) { if (!headA || !headB) return null; let pA = headA; let pB = headB; while (pA !== pB) { pA = pA !== null ? pA.next : headB; pB = pB !== null ? pB.next : headA; } return pA; } 9、链表求和 给定两个用链表表示的整数,每个节点包含一个数位,这些数位是反向存放的,也就是个位排在链表首部。编写函数对这两个整数求和,并用链表形式返回结果 示例: 输⼊:(7 -> 1 -> 6) + (5 -> 9 -> 2),即617 + 295 输出:2 -> 1 -> 9,即912 步骤: 解题的链表类型是单链表 思路: 输出的是新链表,因此需要创建一个链表 由于是反向存储,则链表从个位数开始计算,大于十则进位 进位,首先考虑⽤carry存储每次的进位,余数存储进创建的节点 边界条件: 双链表指向null时,遍历完成 遍历完成,carry不为0,则还需前进一位 const addTwoNumbers = function (l1, l2) { // 哨兵 let preHead = new ListNode(0) let carry = 0; let pre = preHead; while (l1 || l2) { let sum = 0; if (l1) { sum += l1.val l1 = l1.next } if (l2) { sum += l2.val l2 = l2.next } sum += carry carry = Math.floor(sum / 10) pre.next = new ListNode(sum % 10) pre = pre.next } if (carry > 0) { pre.next = new ListNode(carry) pre = pre.next } return preHead.next } 进阶:思考⼀下,假设这些数位是正向存放的,⼜该如何解决呢? 输⼊:(6 -> 1 -> 7) + (2 -> 9 -> 5),即617 + 295 输出:9 -> 1 -> 2,即912

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册