首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

Python标准库(待续)

相识一场,记得顶我 集合操作 并集 >>> a = set([1,2,3]) >>> b = set([2,3,4]) >>> a.union(b) {1, 2, 3, 4} >>> a|b {1, 2, 3, 4} 交集 >>> a = set([1,2,3]) >>> b = set([2,3,4]) >>> a.intersection(b) {2, 3} >>> a&b {2, 3} 子集归属 >>> c = a&b >>> c.issubset(a) True >>> c<=b True >>> c<=a True >>> c>=a False 因为集合是可变的,但是集合本身包含的是不可变对象,所以以下代码会报错。 >>> a = set([1,2,3]) >>> b = set([2,3,4]) >>> a.add(b) Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: unhashable type: 'set' 这时候我们需要使用frozenset类型,用于代表不可变的集合,它会创建一个副本对象加入到集合中。 >>> a.add(frozenset(b)) >>> a {1, 2, 3, frozenset({2, 3, 4})} 堆操作 堆是一种数据结构,它是优先队列的一种,它在查找方面比列表的效率要高得多。 heappush(heap,x) 入堆 heappop(heap) 出堆 heapify(heap) 把可迭代对象转换为堆 heapreplace(heap,x) 将堆中最小元素弹出,同时将x入堆 nlargest(n,iter) 找出可迭代对象中第n大元素 nsmallest(n,iter) 找出可迭代对象中第n小元素 >>> from heapq import * >>> from random import shuffle >>> data = range(10) >>> shuffle(data) >>> heap = [] >>> for n in data: heappush(heap,n) >>> heap [0, 2, 1, 3, 5, 7, 4, 6, 9, 8] >>> heappop(heap) 0 >>> heappop(heap) 1 >>> heappop(heap) 2 >>> heappop(heap) 3 >>> heap [4, 5, 7, 6, 9, 8] ----------------------------------------- >>> heap = [9,7,2,4,5,6,2,3,1] >>> heapify(heap) >>> heap [1, 3, 2, 4, 5, 6, 2, 7, 9] ----------------------------------------- >>> heapreplace(heap,0.5) 1 >>> heap [0.5, 3, 2, 4, 5, 6, 2, 7, 9] 从上述代码运行的结果可以看出,这是一个小根堆的排序算法---位于i位置上的元素总比i/2位置处的元素大,反过来也就是i位置处的元素总比2i和2i+1位置处的元素小。 双端队列 >>> from collections import deque >>> q = deque(range(5)) >>> q.append(5) >>> q.appendleft(6) >>> q deque([6, 0, 1, 2, 3, 4, 5]) >>> q.pop() 5 >>> q.popleft() 6 >>> q deque([0, 1, 2, 3, 4]) >>> q.rotate(2) >>> q deque([3, 4, 0, 1, 2]) >>> q.extend([3,4]) >>> q deque([3, 4, 0, 1, 2, 3, 4]) >>> q.extendleft([2,1]) >>> q deque([1, 2, 3, 4, 0, 1, 2, 3, 4]) 从上述代码可以看出双端队列的好处在于它可以在列表的两端进行操作和旋转列表。 time 可以使用实数表示,也可以使用包含9个整数的元组表示。如果使用元组表示,那这些整数的意义如下: (2018,1,21,10,28,30,2,21,0) 表示2018年1月21日,10时28分30秒,星期3,当天为当年的第21天,(无夏令时) asctime([tuple]) 将时间元组转换为字符串 localtime([secs])将秒数转换为日期元组,以本地时间为准 mktime(tuple)将时间元组转换为本地元组 sleep(secs)休眠 strptime(string[,format])将字符串解析为时间元组 time()当前时间 'Wed Jul 11 10:02:04 2018' random random() 返回0<n<=1之间的随机实数n getrandbits(n) 以长整型形式返回n个随机位 (加密有用) uniform(a,b) 返回随机实数n,其中a<=n<b,(a,b)之间的均匀分布 randrange([start],stop,[step]) 返回range(start,stop,step)中的实数 choice(seq)从序列seq中返回随意元素 shuffle(seq[,random])原地指定序列 seqsample(seq,n) 从序列seq中选择n个随机且独立的元素 re re模块是一个正则表达式的模块 compile(pattern[,flags]) 根据包含正则表达式的字符串创建模式对象 search(pattern, string[,flags])在字符串中寻找模式 match(pattern,string[,flags]) 在字符串的开始处匹配模式 split(pattern,string[,maxsplit=0])根据模式的匹配来分割字符串 findall(pattern,string) 列出字符串中模式的所有匹配项 sub(pat,repl,string[,count=0])将字符串中所有pat的匹配项用repl替换 escape(string) 将字符串中所有特殊正则表达式字符转义 用任意长度的逗号和空格序列来分割字符串 some_text = 'alpha,beta,,,,gamma delta' re.split('[, ]+',some_text) ['alpha', 'beta', 'gamma', 'delta']

优秀的个人博客,低调大师

python的条件结构

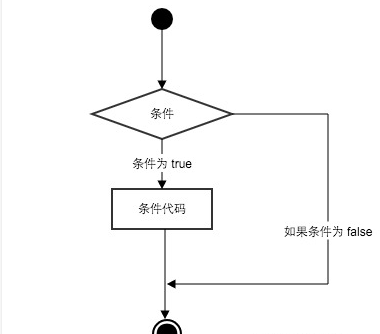
一.条件结构的语法结构 完整形态 if 条件判断1: 代码块1 elif 条件判断2: 代码块2 elif 条件判断3: 代码块3 else: 代码块4 #举例 age = 20 if age >= 60: print('老年人') elif age >= 30: print('中年人') elif age >= 20: print('青年人') elif age >= 10: print('少年') else: print('儿童') 简化形态1 if 条件判断1: 代码块1 else: 代码块4 #举例 age = 20 if age >= 18: print('成年人') else: print('未成年人') 简化形态2 if 条件判断1: 代码块1 elif 条件判断3: 代码块3 #举例 age = 20 if age >= 60: print('老年人') elif age >= 30: print('中年人') 简化形态3 if 条件判断1: 代码块1 #举例 age = 20 if age >= 60: print('老年人') 二.条件结构的执行原则 原则1:从上到下,顺序执行。 原则2:条件判断的结果,如果为True,则进入执行代码块;如果为False,则继续向下进行条件判断;如果所有条件判断都为False,则执行else语句。 原则3:在同一个条件结构里,如果一个条件满足,进入执行代码块, 那么其他条件都会无效,不再进行条件判断。 三.条件结构的嵌套 嵌套:就是一层嵌套一层,如同俄罗斯套娃。 #举例:条件执行的嵌套 num=int(input("输入一个数字:")) if num%2==0: if num%3==0: print ("你输入的数字可以整除 2 和 3") else: print ("你输入的数字可以整除 2,但不能整除 3") else: if num%3==0: print ("你输入的数字可以整除 3,但不能整除 2") else: print ("你输入的数字不能整除 2 和 3") 我们可以在一个条件结构的代码块里,继续放入条件结构。 四.pass语句 pass:不做任何事情。一般用作占位符,保证程序结构的完整性,以免报错。 if 条件判断1: pass elif 条件判断2: pass elif 条件判断3: pass else: pass

优秀的个人博客,低调大师

python的循环结构

一.循环结构的语法结构一 while循环:重复到一定条件才结束的循环。(也叫条件循环) while 条件判断: 代码块 #举例 count =0 while count<3: print(“进入循环执行!”) print(count**2) count=count+1 二.循环结构的语法结构二 for循环:遍历序列,重复到一定次数的循环。(也叫计数循环) for 变量名 in 序列: 代码块 #举例 list=["关羽","张飞","赵云","黄忠","马超"] for i in list: print("此乃五虎上将:"+i) 三.循环结构的执行原则 原则1:从上到下,顺序执行 原则2:循环结构执行完毕后,才会接着执行后面的代码。 四.for循环+range()函数 range():数列生成函数。 (跟for循环简直绝配哦!) 用法1:range(num1,num2) 生成数列,从num1开始,直到num2结束。 #举例1 for i in range(1,9): print(i) 用法2:range(num2) 生成数列,从0开始,直到num2结束。 #举例2 for i in range(9): print(i) 用法3:range(num1,num2,num3) 生成数列,从num1开始,按num3增长,直到num2结束。 #举例3 for i in range(1,9,2): print(i) 五.传说中的死循环 死循环:无限次循环执行,永远不会结束! (也叫无限循环) #举例1 while True: print(11111) #举例2 while 1<2: print (111111) 注1:一般来说,我们需要避免死循环的发生!因为进入死循环,循坏外面的代码就都不会执行了。 注2:但有时候,我们会需要无限循环的效果。这个时候,就会故意写成死循环。 六.循环结构的嵌套 嵌套:就是一层嵌套一层,如同俄罗斯套娃。 #举例:打印一个九九乘法表,使用for循环 for i in range(1,10): for j in range(1,i+1): print(str(i)+" * "+str(j)+" = "+str(i*j),end=" ") print() #举例:打印一个九九乘法表,使用while循环 i =1 while i<=9: j = 1 while j <= i: print(str(i) + " * " + str(j) + " = " + str(i * j),end=" ") j=j+1 i=i+1 print() 我们可以在一个循环结构的代码块里,继续放入循环结构。 七.break语句 break:立即终止循环。 #break语句举例,while循环 var = 10 while var > 0: var = var -1 if var == 5: break print ('当期变量值为 :', var) #break语句举例,for循环 for letter in 'google': if letter == 'o': break print ('当前字母为 :', letter) 注:如果循环嵌套,break只能终止本层的循环,不会终止上层的循环。 八.continue语句 continue:跳过这一轮循环,进行下一轮循环。 #continue语句举例,while循环 var = 10 while var > 0: var = var -1 if var == 5: continue print ('当前变量值 :', var) #continue语句举例,for循环 for letter in 'google': if letter == 'o': continue print ('当前字母 :', letter) 九.pass语句 pass:不做任何事情。一般用作占位符,保证程序结构的完整性,以免报错。 #while循环 while 条件判断: pass #for循环 for 变量名 in 序列: pass

优秀的个人博客,低调大师

Python爬虫-小测验

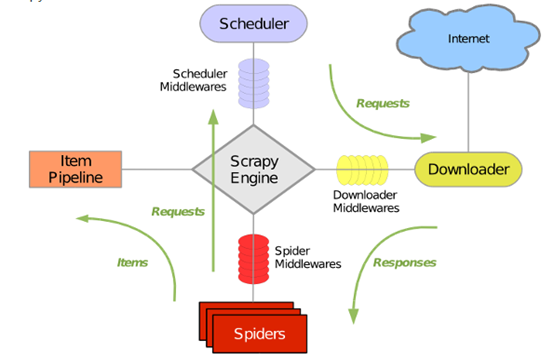
一、 使用scrapy.Selector或BeautifulSoup,实现以下需求(30分) (1)读取给定的dangdang.html页面内容,注:编码为gbk(5分) (2)获取页面中所有图书的名称,价格,作者,出版社及图书图片的url地址(20分) (3)将获取的信息保存至文件(excel、csv、json、txt格式均可)(5分) 网页文件dangdang.html文件下载链接: https://pan.baidu.com/s/1awbG5zqOMdnWzXee7TZm6A 密码: 3urs 1.1使用BeautifulSoup解决 from bs4 import BeautifulSoup as bs import pandas as pd def cssFind(book,cssSelector,nth=1): if len(book.select(cssSelector)) >= nth: return book.select(cssSelector)[nth-1].text.strip() else: return '' if __name__ == "__main__": with open("dangdang.html",encoding='gbk') as file: html = file.read() soup = bs(html,'lxml') book_list = soup.select("div ul.bigimg li") result_list = [] for book in book_list: item = {} item['name'] = book.select("a.pic")[0]['title'] item['now_price'] = cssFind(book,"span.search_now_price") item['pre_price'] = cssFind(book,"span.search_pre_price") item['author'] = book.select("p.search_book_author a")[0]['title'] item['publisher'] = book.select("p.search_book_author span a")[-1].text item['detailUrl'] = book.select("p.name a")[0]['href'] item['imageUrl'] = book.select("a.pic img")[0]['src'] if item['imageUrl'] == "images/model/guan/url_none.png": item['imageUrl'] = book.select("a.pic img")[0]['data-original'] result_list.append(item) df = pd.DataFrame(result_list,columns=result_list[0].keys()) df.to_excel("当当图书信息.xlsx") 1.2使用scrapy.selector解决 from scrapy.selector import Selector import pandas as pd if __name__ == "__main__": with open("dangdang.html",encoding='gbk') as file: response = Selector(text=file.read()) book_list = response.xpath("//ul[@class='bigimg']/li") result_list = [] for book in book_list: item = {} item['name'] = book.xpath("a[@class='pic']/@title").extract_first() item['now_price'] = book.xpath(".//span[@class='search_now_price']/text()").extract_first() item['pre_price'] = book.xpath(".//span[@class='search_pre_price']/text()").extract_first() item['author'] = book.xpath("p[@class='search_book_author']//a/@title").extract_first() item['publisher'] = book.xpath("p[@class='search_book_author']//a/@title").extract()[-1] item['detailUrl'] = book.xpath(".//p[@class='name']/a/@href").extract_first() item['imageUrl'] = book.xpath("a[@class='pic']/img/@src").extract_first() if item['imageUrl'] == "images/model/guan/url_none.png": item['imageUrl'] = book.xpath("a[@class='pic']/img/@data-original").extract_first() result_list.append(item) df = pd.DataFrame(result_list,columns=result_list[0].keys()) df.to_excel("当当图书信息.xlsx") 二、 需求:抓取天猫三只松鼠旗舰店超级满减商品信息(55分) 网站地址如下https://sanzhisongshu.tmall.com/p/rd523844.htm?spm=a1z10.1-b-s.w5001-14855767631.8.19ad32fdW6UhfO&scene=taobao_shop 评分标准如下: 1、创建函数获取页面所有内容,代码无误(5分) 2、得到页面内容后解析信息,获取页面中图片链接,并将图片下载至本地photo文件夹。(10分) 3、获取页面中每个商品信息的商品名称、价格以及商品图片url信息(20分) 4、创建数据库product,及表格productinfo,包含(商品名称、价格及图片地址三个字段)(5分) 5、将第(3)步获取的结果写入数据库(10分) 6、代码规范,有注释(5分) import requests from bs4 import BeautifulSoup as bs import urllib import os import pymysql #获取实例化BeautifulSoup对象 def getSoup(url, encoding="gbk", **params): reponse = requests.get(url, **params) reponse.encoding = encoding soup = bs(reponse.text, 'lxml') return soup #下载单个图片函数 def downloadImage(imgUrl, imgName): imgDir = "photo" if not os.path.isdir(imgDir): os.mkdir(imgDir) imgPath = "%s/%s" %(imgDir,imgName) urllib.request.urlretrieve(imgUrl,imgPath) #下载所有图片函数 def downloadAllImages(soup): image_list = soup.select("img") count = 0 for image in image_list: try: srcStr = image['data-ks-lazyload'] imgFormat = srcStr[-3:] if imgFormat == 'gif': continue count += 1 imgName = "%d.%s" % (count, imgFormat) imgUrl = "http:" + srcStr downloadImage(imgUrl, imgName) except Exception as e: print(str(e)) #通过css选择器语法选择出标签 def cssFind(movie,cssSelector,nth=1): if len(movie.select(cssSelector)) >= nth: return movie.select(cssSelector)[nth-1].text.strip() else: return '' #获取数据库连接函数 def getConn(database ="product"): args = dict( host = 'localhost', user = 'root', passwd = '.... your password', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": soup = getSoup("https://sanzhisongshu.tmall.com/p/rd523844.htm" \ "?spm=a1z10.1-b-s.w5001-14855767631.8.19ad32fdW6UhfO&scene=taobao_shop") #下载所有图片 downloadAllImages(soup) #获取数据库连接 conn = getConn() cursor = conn.cursor() #新建数据库中的表productinfo sql_list = [] sql_list.append("drop table if exists productinfo") sql_list.append("create table productinfo(name varchar(200)," \ "price varchar(20),imageUrl varchar(500))") for sql in sql_list: cursor.execute(sql) conn.commit() #获取商品信息并插入数据库 item_list = soup.select("div.item4line1 dl.item") for item in item_list: name = cssFind(item,"dd.detail a") price = cssFind(item,"dd.detail span.c-price") imageUrl = item.select("dt img")[0]['data-ks-lazyload'] insert_sql = 'insert into productinfo values("%s","%s","%s")' %(name,price,imageUrl) cursor.execute(insert_sql) conn.commit() 三、请以你的理解尽可能准确的描述出scrapy运行的原理图(15分) scrapy框架原理图.png 在实际编写代码的过程一种,一般按照下列顺序编写代码文件: 1.编写item.py文件;2.编写爬虫文件;3.编写pipelines.py文件;4.编写settings.py文件 在Scrapy框架理解上: 1.爬虫Spiders发送请求Requests给调度器Scheduler 2.调度器Scheduler发送下载网页的请求Requests给下载器Downloader 3.下载器Downloader获取网页相应response交给爬虫Spiders 4.爬虫Spiders对response进行解析形成Item 5.Item传送给管道,管道对数据进行相应处理,数据持久化。 6.Middelwares分为三种:调度中间件Scheduler middlewares、爬虫中间件spider Middlewares、下载中间件Download Middlewares。在编写scrapy-redis分布式爬虫时,redis就相当于调度中间件Scheduler middlewares;对爬虫进行伪装,设置用户代理User-agent和代理Ip,是在爬虫中间件spider Middlewares中进行设置,下载中间件Download Middlewares可以对下载进行相应设置。

优秀的个人博客,低调大师

利用Python发送email

引入smtplib和email.mime.text.MIMEText两个库可以完成发送邮件的功能 代码逻辑顺序:初始化邮箱服务——>使用用户名和密码登录邮箱——>定义发送的信息的内容、主题、来源——>邮箱发送邮件——>邮箱退出 import smtplib # 将你写的字符串转化为邮件的文本形式 from email.mime.text import MIMEText # smtp服务器地址 smtp_server = 'smtp.163.com' # 发送者是谁 sender = 'stevenlei2013@163.com' # 客户端授权码 password = '你自己设置的授权码' # 发给谁 多个用户中间使用 逗号 隔开 to = '474933858@qq.com' # 发送的消息 message = "好好学习,天天向上" # 转化为邮件文本 message = MIMEText(message) # 定制邮件标题 message['Subject'] = '顺利毕业!' # 定制发送者 message['From'] = sender # 绑定服务器和端口号 mail_server = smtplib.SMTP(smtp_server, 25) # 登录 mail_server.login(sender, password) # 发送邮件 mail_server.sendmail(sender, to, message.as_string()) # 退出 mail_server.quit()

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册