首页 文章 精选 留言 我的

精选列表

搜索[向量存储],共10000篇文章
优秀的个人博客,低调大师

Android数据存储之SQLite

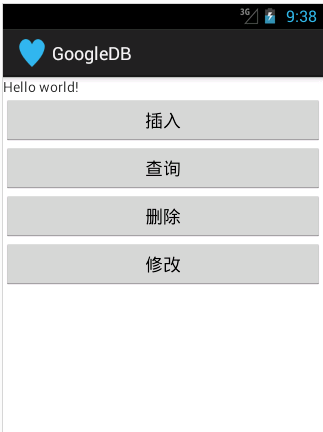
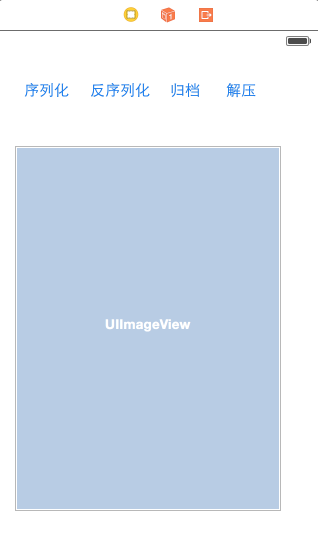
SQLite,是一款轻型的数据库,是遵守ACID的关系型数据库管理系统,它的设计目标是嵌入式的,而且目前已经在很多嵌入式产品中使用了它,占用资源非常少,只有几百KB内存。支持Windows/Linux/Unix等等主流的操作系统,同时能够跟其他程序语言相结合,比如 Tcl、C#、PHP、Java等,还有ODBC接口,同样比起Mysql、PostgreSQL这两款开源的世界著名数据库管理系统来讲,它的处理速度比他们都快。SQLite是当前使用最广泛的数据库,基于以上优点,Android系统采用SQLite数据库。 SQLiteOpenHelper介绍 Android应用程序为了对数据库进行管理,提供了一个抽象类SQLiteOpenHelper,SQLiteOpenHelper类提供了两个重要的方法,分别是onCreate()和onUpgrade(),onCreate用于初次使用软件时生成数据库表,onUpgrade用于升级软件时更新数据库表结构。 当调用SQLiteOpenHelper的getWritableDatabase()或者getReadableDatabase()方法获取用于操作数据库的SQLiteDatabase实例的时候,如果数据库不存在,Android系统会自动生成一个数据库,接着调用onCreate()方法。onCreate()方法在初次生成数据库时才会被调用,在onCreate()方法里可以生成数据库表结构及添加一些应用使用到的初始化数据。 onUpgrade()方法在数据库的版本发生变化时会被调用,一般在软件升级时才需改变版本号,而数据库的版本是由程序员控制的。 假设现在的版本是1,升级软件时希望更新用户手机里的数据库表结构,为了实现这一目的,可以把原来的数据库版本设置为2,并且在onUpgrade()方法里面实现表结构的更新。当软件的版本升级次数比较多,这时在onUpgrade()方法里面可以根据原版号和目标版本号进行判断,然后做出相应的表结构及数据更新。 Demo的实现 先来看一个页面: 布局就不用写了,就是四个按钮,实现的目的就是在生成Person数据库,同时生成一个表,然后操作Person中的数据: 首先需要重写一下抽象类SQLiteOpenHelper中的方法 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 public class MySQLDBHelper extends SQLiteOpenHelper { private static final String DBname= "Person.db" ; private static final int version= 1 ; private String tag= "MySQLDBHelper" ; public MySQLDBHelper(Context context) { super (context, DBname, null , version); Log.i(tag, "测试" ); } @Override public void onCreate(SQLiteDatabase db) { // TODO Auto-generated method stub Log.i(tag, "Person数据库中Person创建前" ); String sqlString= "create table Person (id integer primary key autoincrement,Name nvarchar(200),Address nvarchar(200))" ; db.execSQL(sqlString); Log.i(tag, "Person数据库中Person创建成功" ); } @Override public void onUpgrade(SQLiteDatabase db, int oldVersion, int newVersion) { // TODO Auto-generated method stub Log.i(tag, "更新数据库,暂时不需要使用" ); } } 构造函数中的数据库名称和版本号都是自己可以固定一下,测试就没有传那么多参数,,多说一下这个@Override: @Override是伪代码,表示重写(当然不写也可以),不过写上有两点好处: 1、可以当注释用,方便阅读; 2、编译器可以给你验证@Override下面的方法名是否是你父类中所有的,如果没有则报错。例如,你如果没写@Override,而你下面的方法名写错了,这时你的编译器是可以编译通过的,因为编译器以为这个方法是你的子类中自己增加的方法。 插入数据调用,这里获取SQLiteDatabase,让后把拼接好的sql直接传入执行就OK了: 1 2 3 4 5 6 public void insert(View view) { SQLiteDatabase database = dbhelper.getWritableDatabase(); String sql = "insert into Person values(NULL,?,?)" ; database.execSQL(sql, new Object[] { "FlyElephant" , "北京" }); Log.i(tag, "插入成功" ); } 更新数据,这里注意一下ContentValues的使用,键值对的顺序: 1 2 3 4 5 6 7 8 public void update(View view) { SQLiteDatabase database = dbhelper.getWritableDatabase(); ContentValues contentValues = new ContentValues(); contentValues.put( "Address" , "深圳" ); database.update( "Person" , contentValues, "Name=?" , new String[] { "FlyElephant" }); Log.i(tag, "更新成功" ); } 查询数据,这里用到了游标,类似于C#中SqlDataReader的使用,moveToNext可以满足基本需求: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 public void query(View view) { SQLiteDatabase database = dbhelper.getReadableDatabase(); Cursor cursor = database.rawQuery( "select * from Person" , null ); if (cursor.getCount()> 0 ) { while (cursor.moveToNext()) { String nameString = cursor.getString(cursor.getColumnIndex( "Name" )); String addreString = cursor.getString(cursor .getColumnIndex( "Address" )); Log.i(tag, "Name:" + nameString + "--Address:" + addreString); } } else { Log.i(tag, "没有数据" ); } cursor.close(); } 如果你觉得moveToNext()不能满足需求,我就从网上找了一下别人贴的代码,如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 c.move( int offset); //以当前位置为参考,移动到指定行 c.moveToFirst(); //移动到第一行 c.moveToLast(); //移动到最后一行 c.moveToPosition( int position); //移动到指定行 c.moveToPrevious(); //移动到前一行 c.moveToNext(); //移动到下一行 c.isFirst(); //是否指向第一条 c.isLast(); //是否指向最后一条 c.isBeforeFirst(); //是否指向第一条之前 c.isAfterLast(); //是否指向最后一条之后 c.isNull( int columnIndex); //指定列是否为空(列基数为0) c.isClosed(); //游标是否已关闭 c.getCount(); //总数据项数 c.getPosition(); //返回当前游标所指向的行数 c.getColumnIndex(String columnName); //返回某列名对应的列索引值 c.getString( int columnIndex); //返回当前行指定列的值 删除数据: 1 2 3 4 5 public void delete(View v) { SQLiteDatabase database = dbhelper.getReadableDatabase(); database.delete( "Person" , "Name=?" , new String[] { "FlyElephant" }); Log.i(tag, "删除成功" ); } 可以看下结果: 本文转自Fly_Elephant博客园博客,原文链接:http://www.cnblogs.com/xiaofeixiang/p/4052488.html,如需转载请自行联系原作者
优秀的个人博客,低调大师

Ceph作为OpenStack后端存储

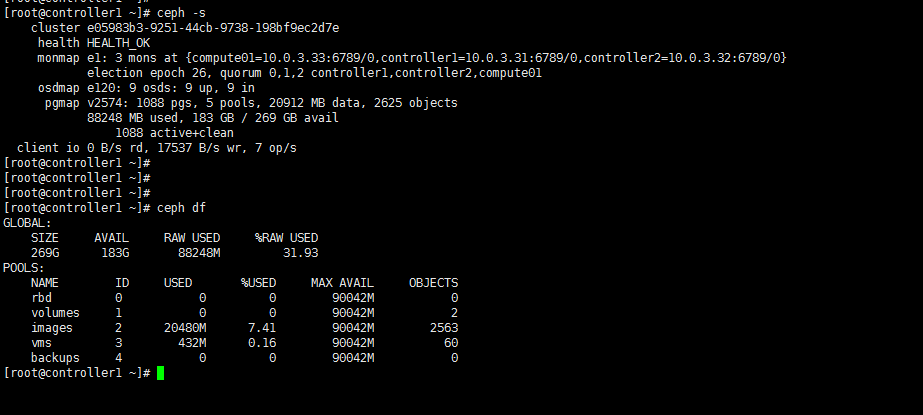
Total PGs = (Total_number_of_OSD * 100) /max_replication_count) 1、Create pool for OpenStack 1 2 3 4 5 pg=256 cephosdpoolcreatevolumes$pg #disk_pool cephosdpoolcreateimages$pg #image_pool cephosdpoolcreatevms$pg #host_pool cephosdpoolcreatebackups$pg #backup_pool 2、setup ceph client authentication 1 2 3 cephauthget-or-createclient.cindermon 'allowr' osd 'allowclass-readobject_prefixrbd_children,allowrwxpool=volumes,allowrwxpool=vms,allowrxpool=images' cephauthget-or-createclient.glancemon 'allowr' osd 'allowclass-readobject_prefixrbd_children,allowrwxpool=images' cephauthget-or-createclient.cinder-backupmon 'allowr' osd 'allowclass-readobject_prefixrbd_children,allowrwxpool=backups' 3、Add the keyringsfor client.cinder, client.glance, and client.cinder-backup to the appropriatenodes and change their ownership 1 2 3 4 cephauthget-or-createclient.glance| ssh {your-glance-api-server} sudo tee /etc/ceph/ceph .client.glance.keyring ssh {your-glance-api-server} sudo chownglance:glance /etc/ceph/ceph .client.glance.keyring cephauthget-or-createclient.cinder| ssh {your-volume-server} sudo tee /etc/ceph/ceph .client.cinder.keyring ssh {your-cinder-volume-server} sudo chowncinder:cinder /etc/ceph/ceph .client.cinder.keyring 4、Nodes running nova-compute need the keyring file for thenova-compute process 1 cephauthget-or-createclient.cinder| ssh {your-nova-compute-server} sudo tee /etc/ceph/ceph .client.cinder.keyring 5、Create a temporary copy of the secret key on the nodes runningnova-compute: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 cephauthget-keyclient.cinder>client.cinder.key cephauthget-keyclient.cinder| ssh {your-compute-node} tee client.cinder.key uuidgen 4f859b95-406e-49f6-9ff8-d6e04f7ba1ef cat >secret.xml<<EOF <secretephemeral= 'no' private= 'no' > <uuid>4f859b95-406e-49f6-9ff8-d6e04f7ba1ef< /uuid > <usage type = 'ceph' > <name>client.cindersecret< /name > < /usage > < /secret > EOF sudo virshsecret-define-- file secret.xml sudo virshsecret- set -value--secrete05983be-9251-44cb-9738-198bf9ec2d7e--base64$( cat client.cinder.key)&& rm client.cinder.keysecret.xml 6、Configuring Glance 1 2 3 4 5 6 7 8 vi /etc/glance/glance-api .conf [DEFAULT] ... default_store=rbd rbd_store_user=glance rbd_store_pool=images show_image_direct_url=True ... 7、Configuring Cinder 1 2 3 4 5 6 7 8 9 10 11 vi /etc/cinder/cinder .conf [DEFAULT] ... volume_driver=cinder.volume.drivers.rbd.RBDDriver rbd_pool=volumes rbd_ceph_conf= /etc/ceph/ceph .conf rbd_flatten_volume_from_snapshot= false rbd_max_clone_depth=5 glance_api_version=2 rbd_user=cinder rbd_secret_uuid=e05983be-9251-44cb-9738-198bf9ec2d7e 8、Configuring Cinder Backup 1 2 3 4 5 6 7 8 9 10 11 vi /etc/cinder/cinder .conf [DEFAULT] ... backup_driver=cinder.backup.drivers.ceph backup_ceph_conf= /etc/ceph/ceph .conf backup_ceph_user=cinder-backup backup_ceph_chunk_size=134217728 backup_ceph_pool=backups backup_ceph_stripe_unit=0 backup_ceph_stripe_count=0 restore_discard_excess_bytes= true 9、Configuring Nova 1 2 3 4 5 6 7 8 9 10 11 12 vi /etc/nova/nova .conf [DEFAULT] ... libvirt_images_type=rbd libvirt_images_rbd_pool=vms libvirt_images_rbd_ceph_conf= /etc/ceph/ceph .conf rbd_user=cinder rbd_secret_uuid=e05983be-9251-44cb-9738-198bf9ec2d7e libvirt_inject_password= false libvirt_inject_key= false libvirt_inject_partition=-2 libvirt_live_migration_flag= "VIR_MIGRATE_UNDEFINE_SOURCE,VIR_MIGRATE_PEER2PEER,VIR_MIGRATE_LIVE,VIR_MIGRATE_PERSIST_DEST" 10、Restart OpenStack 1 2 3 serviceopenstack-glance-apirestart serviceopenstack-nova-computerestart serviceopenstack-cinder-volumerestart 10、Test 本文转自Jacken_yang 51CTO博客,原文链接:http://blog.51cto.com/linuxnote/1789924,如需转载请自行联系原作者

优秀的个人博客,低调大师

GlusterFS作为OpenStack后端存储

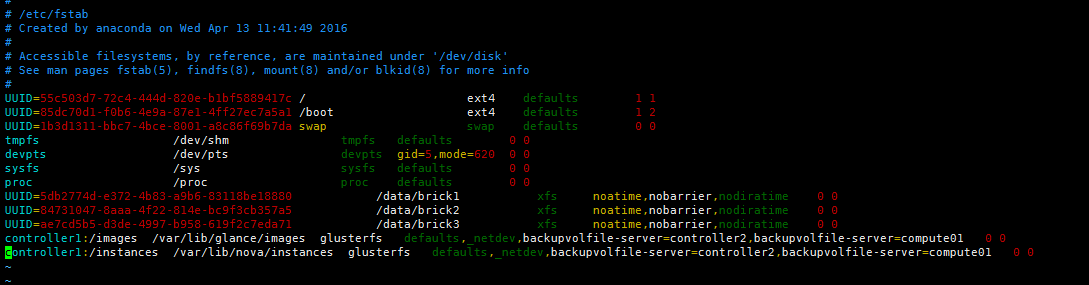
创建3个卷images、volumes、instances分别对接openstack的glance、cinder、nova组件 images卷用于存放OpenStack镜像 volumes卷用于存放OpenStack硬盘 instances卷用于存放OpenStack云主机 1、创建卷 1 2 3 4 5 6 7 8 9 10 11 12 13 14 glustervolumecreateimagesreplica3\ controller1: /data/brick1/image controller2: /data/brick1/image compute01: /data/brick1/image \ controller1: /data/brick2/image controller2: /data/brick2/image compute01: /data/brick2/image \ controller1: /data/brick3/image controller2: /data/brick3/image compute01: /data/brick3/image glustervolumecreatevolumesreplica3\ controller1: /data/brick1/volume controller2: /data/brick1/volume compute01: /data/brick1/volume \ controller1: /data/brick2/volume controller2: /data/brick2/volume compute01: /data/brick2/volume \ controller1: /data/brick3/volume controller2: /data/brick3/volume compute01: /data/brick3/volume glustervolumecreateinstancesreplica3\ controller1: /data/brick1/instance controller2: /data/brick1/instance compute01: /data/brick1/instance \ controller1: /data/brick2/instance controller2: /data/brick2/instance compute01: /data/brick2/instance \ controller1: /data/brick3/instance controller2: /data/brick3/instance compute01: /data/brick3/instance 2、启动卷 1 2 3 glustervolumestartimages glustervolumestartvolumes glustervolumestartinstances 3、添加images、instances到fstab自动挂载 1 2 controller1: /images /var/lib/glance/images glusterfsdefaults,_netdev,backupvolfile-server=controller2,backupvolfile-server=compute0100 controller1: /instances /var/lib/nova/instances glusterfsdefaults,_netdev,backupvolfile-server=controller2,backupvolfile-server=compute0100 mount -a挂载 上述挂载方式使用backupvolfile起到了高可用性,避免单点故障 nova、glance节点要挂载到instances、images的相关目录,根据实际服务部署情况调整,cinder不太一样,下边会说到。 4、设置相关权限 1 2 3 4 5 6 7 8 9 10 11 chown -Rnova.nova /var/lib/nova/instances chown -Rglance.glance /var/lib/glance/images chown -Rnova:nova /data/brick1/instance chown -Rnova:nova /data/brick2/instance chown -Rnova:nova /data/brick3/instance chown -Rglance:glance /data/brick1/image chown -Rglance:glance /data/brick2/image chown -Rglance:glance /data/brick3/image chown -Rcinder:cinder /data/brick1/volume chown -Rcinder:cinder /data/brick2/volume chown -Rcinder:cinder /data/brick3/volume nova要有instance、cinder要有volume、glance要有image的读写权限,根据节点上的服务,给相应的权限。 5、配置cinder 1 2 3 4 cp /etc/cinder/cinder .conf{,.bak} openstack-config-- set /etc/cinder/cinder .confDEFAULTvolume_drivercinder.volume.drivers.glusterfs.GlusterfsDriver openstack-config-- set /etc/cinder/cinder .confDEFAULTglusterfs_shares_config /etc/cinder/shares .conf openstack-config-- set /etc/cinder/cinder .confDEFAULTglusterfs_mount_point_base /var/lib/cinder/volumes 1 2 3 4 5 touch /etc/cinder/shares .conf vim /etc/cinder/shares .conf #添加以下内容 controller1: /volumes controller2: /volumes compute01: /volumes #设置相关权限 1 2 chown -Rcinder.cinder /etc/cinder/shares .conf chown -Rcinder:cinder /var/lib/cinder/ * 6、重启openstack相关服务 1 2 3 openstack-servicerestartnova openstack-servicerestartcinder openstack-servicerestartglance 7、验证cinder 本文转自Jacken_yang 51CTO博客,原文链接:http://blog.51cto.com/linuxnote/1826501,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册