首页 文章 精选 留言 我的

精选列表

搜索[AI],共10000篇文章
优秀的个人博客,低调大师

按配对顺序将刷卡进出记录转为单行记录-AI解法

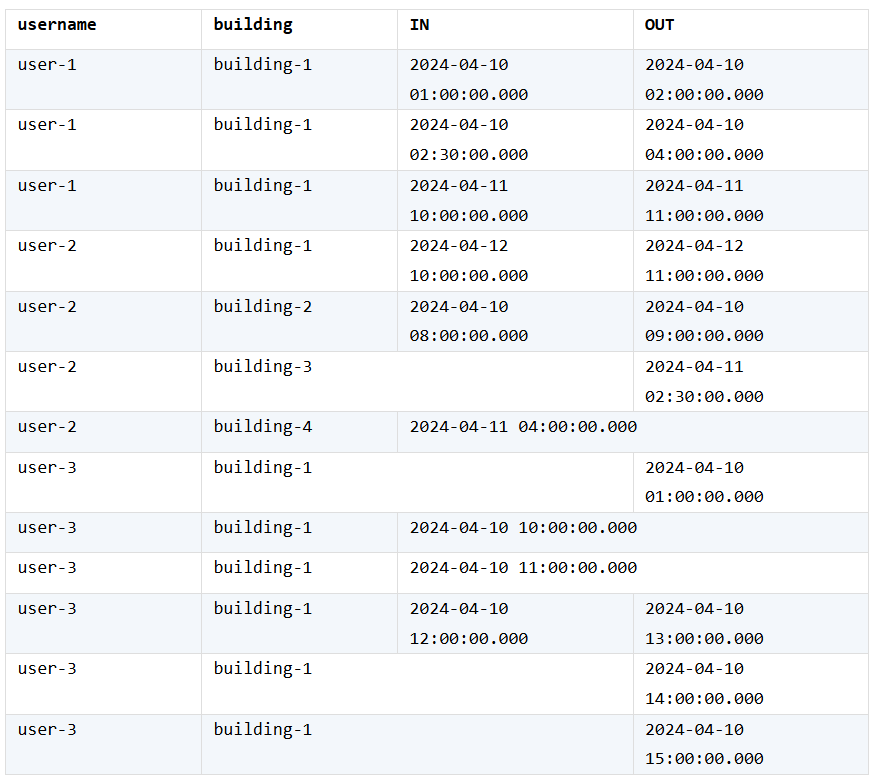
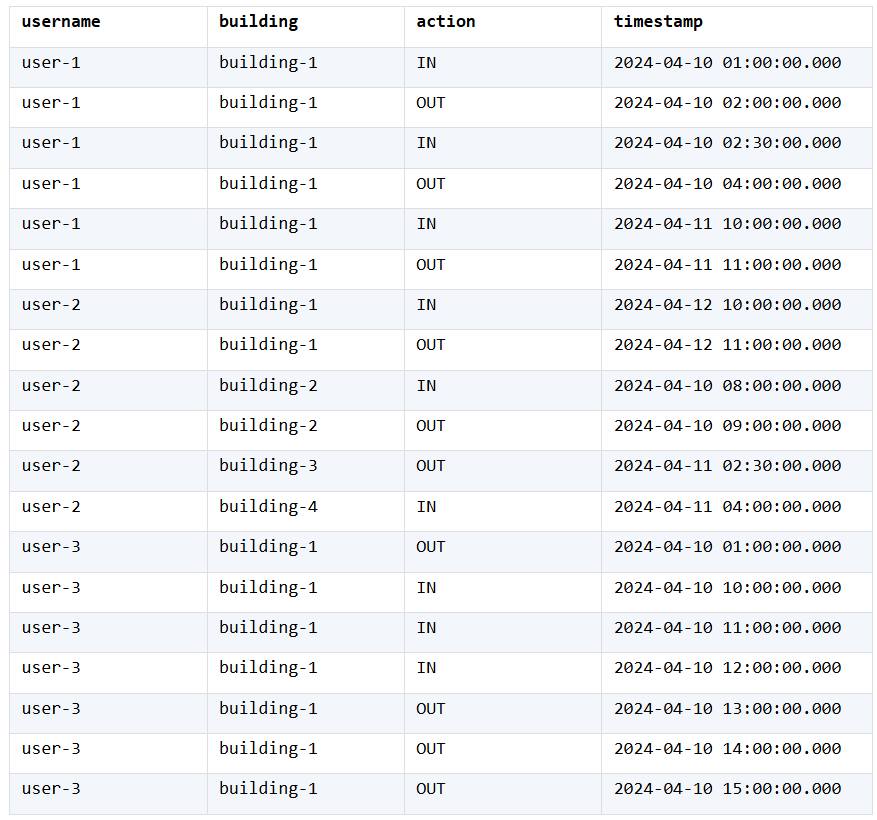
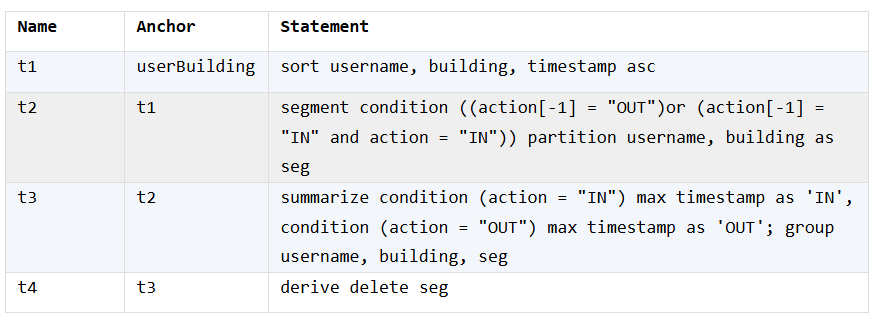
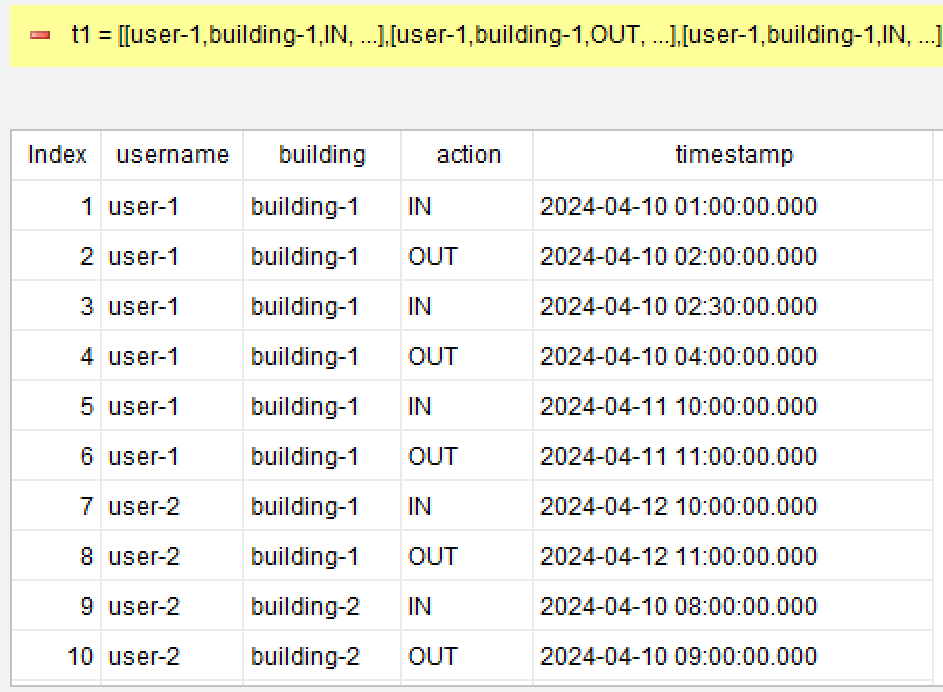
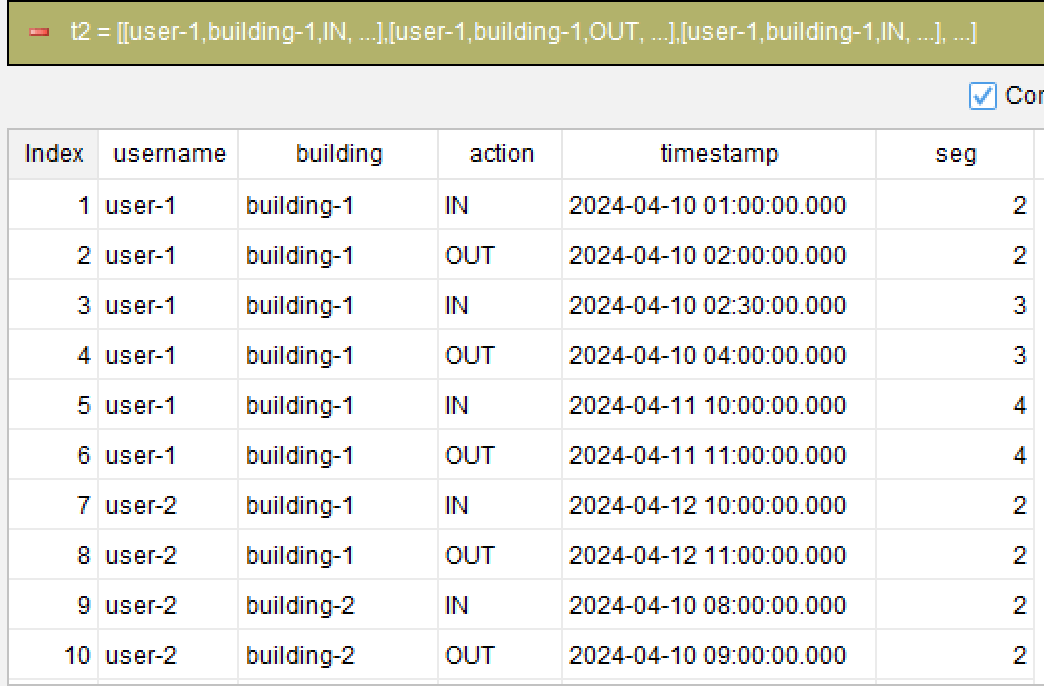
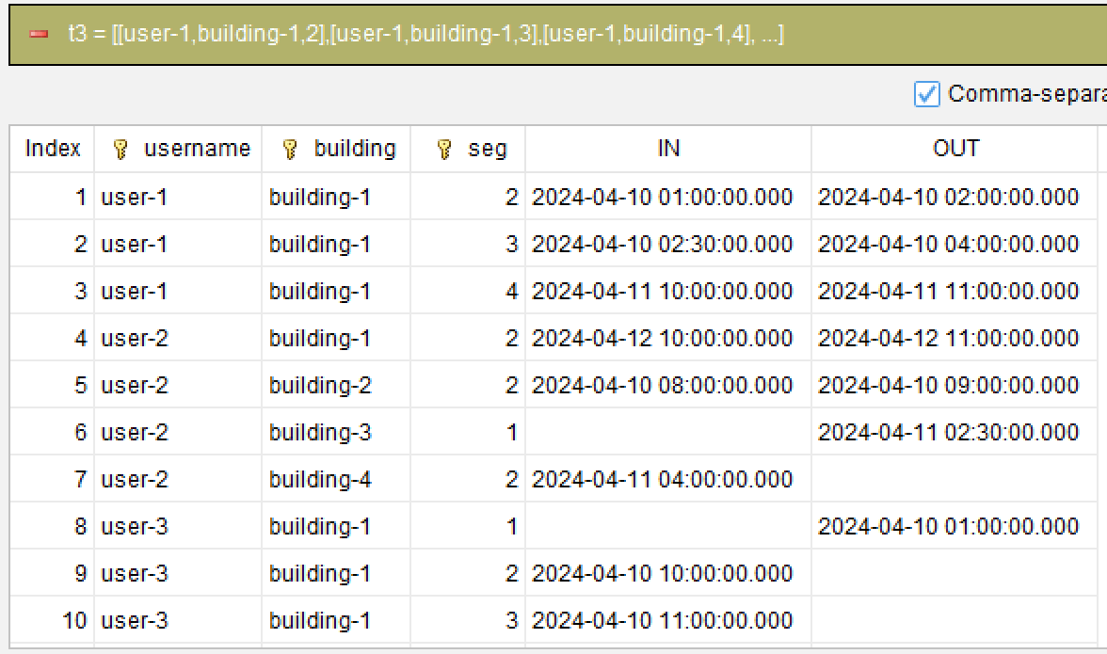
## 问题描述 某库记录了人员刷卡进出建筑的流水, 每个时间点有一条记录, 字段为 username、building、action(IN/OUT)、timestamp。正常情况下同一人同一建筑的记录成对出现, 先 IN 后 OUT; 但实际数据会出现不成对、连续同向动作等脏数据。现在要把每个人每栋建筑的每对记录由行转列变成一条记录, 不成对的记录单独转为一条记录, 空缺部分填 NULL,即按配对顺序把纵向流水转为横向会话。 ### **源数据** ![](https://developer.qcloudimg.com/http-save/yehe-9292056/37402c4a28c2ec5dfc231d143a50d631.png) ### **期望结果** ![](https://developer.qcloudimg.com/http-save/yehe-9292056/d292e065e3d805e74feeb81f0b75f087.png) 以 user-3/building-1 为例,原始序列为 OUT, IN, IN, IN, OUT, OUT, OUT,按配对规则切为 6 段:首条 OUT 落单,随后两条 IN 各落单,第四条 IN 与首条 OUT 配对成一行,最后两条 OUT 各落单。连续同向动作不会被强行配对,保证会话边界正确,13 行结果中该用户占 6 行正是此逻辑的体现。 ## SQLazy 分步实现 核心思路:先按 username、building、timestamp 排序,把同一人同一建筑的流水排成时间顺序;再用条件分段识别会话边界,上一条是 OUT 或当前是 IN 就新开一组,这样每组恰好包含至多一个 IN 和至多一个 OUT;最后按 username、building、seg 分组,用带条件的 max 聚合把组内 IN 时间与 OUT 时间分别收敛到同一行,落单则为 NULL。 ![](https://developer.qcloudimg.com/http-save/yehe-9292056/32a5058e063b5d8b3feb7dc61527ee29.png) *下面逐一解释这些步骤。* **第 1 步: 按人、建筑、时间排序** *sort username, building, timestamp asc* 将同一人同一建筑的记录按 timestamp 升序排列, 确保后续按时间顺序判断配对边界; 用户名与建筑作为排序前置键, 保证分区内顺序与分区键一致, 排序是后续分段与汇总的前提。 ![](https://developer.qcloudimg.com/http-save/yehe-9292056/d1d720d2a47ef9729bac18e5b1a635bc.png) **第 2 步: 按配对语义条件分段, 生成 seg** *segment condition ((action[-1] = "OUT")or (action[-1] = "IN" and action = "IN")) partition username, building as seg* 最关键的一步是用条件分段表达会话边界:上一条是 OUT,或上一条是 IN 且当前也是 IN 就新开一组。上一条 OUT 表示上一会话已闭合,应新开;连续 IN 表示多刷进入,每多一次 IN 就切一组,避免把多条 IN 塞进同一会话。partition username, building 保证不同人、不同建筑互不干扰,各自独立编号 seg。条件中 action[-1] 是 SQLazy 的相对位置写法,等价于 LAG(action,1),无需手写窗口函数。 ![](https://developer.qcloudimg.com/http-save/yehe-9292056/308a2cf017c071eb146b4907950dbe85.png) **第 3 步: 按人、建筑、段号分组, 条件汇总行转列** *summarize condition (action = "IN") max timestamp as 'IN', condition (action = "OUT") max timestamp as 'OUT'; group username, building, seg* 按 username、building、seg 分组, 每组至多包含一进一出。汇总时用条件聚合:action="IN" 时取 timestamp 的 max 作为 IN 列,action="OUT" 时取 timestamp 的 max 作为 OUT 列。max 与 first 在此等价, 因为组内同类动作至多一条; 使用带条件的 max 可使落单组的另一侧自然为 NULL。注意新版语法中求值聚合算法 (max) 在被聚合式 (timestamp) 之前, 分组键通过 "group username, building, seg" 指定。 ![](https://developer.qcloudimg.com/http-save/yehe-9292056/ad0f25386afea25d03bda149f0583299.png) **第 4 步: 清理掉辅助列** *derive delete seg* 删除分段产生的辅助列 seg, 仅保留 username、building、IN、OUT 四列, 得到最终结果, 表格更干净。 ### **编译生成 SQL** 确认上述 4 步逻辑后,SQLazy 编译器自动生成原生 SQL(这里是 Oracle 语法): ``` SELECT MAX(CASE WHEN (action = 'OUT') THEN timestamp ELSE NULL END) AS "OUT" , MAX(CASE WHEN (action = 'IN') THEN timestamp ELSE NULL END) AS "IN" , building, username FROM ( SELECT username, building, action, timestamp , 1 + SUM(CASE WHEN (col__2 = 'OUT' OR action = 'IN') THEN 1 ELSE 0 END) OVER (PARTITION BY username, building ORDER BY username ASC, building ASC, timestamp ASC ROWS UNBOUNDED PRECEDING) AS seg FROM ( SELECT t1.*, LAG(action) OVER (PARTITION BY username, building ORDER BY username ASC, building ASC, timestamp ASC) AS col__2 FROM t1 ) sub__3 ) t_4 GROUP BY username, building, seg ORDER BY username, building, seg; ``` **SQLazy让你用业务语言描述逻辑,而不是用 SQL 语法写嵌套查询**。上面的 NLC 代码,用一句条件分段就能把业务规则说清:segment condition ((action[-1] = "OUT")or (action[-1] = "IN" and action = "IN"))partition username, building,也就是“上一段已结束或连续刷入就新开会话”。手写 SQL 时,你得自己写 LAG 取上一行、SUM OVER 累计段号,再套两层子查询封装窗口列,最后用条件聚合 MAX(CASE...) 做行转列,还要处理分区与排序的一致性。SQLazy 把这些压缩成排序、分段、条件汇总、清理四步,每步都能单独验证,相对位置和分区会编译成窗口函数,条件汇总自动处理 NULL。

优秀的个人博客,低调大师

NVIDIA Attribution:分布式 AI 训练故障的自动归因系统

![文章封面](https://developer.qcloudimg.com/http-save/10106350/fb7e66ccbb8a9a5adb7d6b30d84dce6e.jpg) ## 背景 分布式训练失败时,一个底层硬件故障会在多个节点上引发级联报错。例如一块 GPU 的 NVLink 信号完整性问题触发 XID 149,随后其他节点上的 NCCL 集合通信失败,调度器记录作业异常退出,日志里留下数千条相关消息。开发者看到的往往是最后一个报错点——某个 rank 的 NCCL 超时或 OOM,而不是真正引发故障的硬件事件。 ![](https://developer.qcloudimg.com/http-save/10106350/40e8fba50382757b4c7ff24612844801.jpg) 人工排查需要串联分散在 Kubernetes 事件、Slurm 日志、Loki 查询结果和 Prometheus 指标里的证据,判断哪些是症状、哪些是诱因。团队可能把调试精力花在正常节点上,而真正的坏卡继续影响后续作业。NVIDIA Attribution 把这个过程自动化了:它接收一次作业执行的全部证据,返回一个结构化诊断,包含终止状态、根因域、受影响节点、支持症状和证据链。确定性规则保证同样的输入产生相同的诊断,方便与现有健康检查、修复流程集成。 ![](https://developer.qcloudimg.com/http-save/10106350/6cc7a076b16537615e181ccce2cf0c2b.jpg) ## 核心原理 Attribution 由 Service 和 Blueprint 两部分组成。Service 通过 REST API 暴露归因引擎,Blueprint 是 Python 参考编排器,负责对接调度器和遥测数据源。Blueprint 内置了 Slurm、Kueue、静态输入三种执行上下文连接器,以及 Loki、本地文件、Kubernetes pod 日志和 PromQL 指标的收集器。 归因流程分四个阶段。第一步是划定作业范围,Blueprint 从调度器标识符或显式时间窗口和节点分配中确定一次执行尝试。第二步收集观测数据,日志和指标连接器从应用日志、syslog、GPU 驱动和 Fabric Manager 消息、调度器历史、节点与网络指标中产生作业范围内的观测记录。第三步提取和关联事件,Service 调用归因引擎识别 GPU XID、NCCL 失败、调度器状态转换、指标条件等显著事件,规则根据时间序列和事件交互分离下游症状与导致失败的事件,找出根因。第四步返回结构化结果,Blueprint 组合裁决、作业终止状态、归因域、症状、受影响节点、收集器覆盖情况和错误记录。 归因引擎的规则流水线包含提取、过滤、症状精炼三个阶段。提取阶段把原始日志转换成类型化事件并保留来源信息。过滤规则处理事件流,例如 EARLY 阶段的 HandleXidBurstEvents 规则读取 XID burst 证据,解码错误字段,对于 XID 149 和特定错误码的组合,它会发出"信号完整性问题"归因事件,同时保留原始 NCCL 错误不变。精炼阶段将事件物化为每节点症状,执行逐节点清洗后聚合成作业级症状集。FINAL 精炼规则 Xid149AndNvlinkFiltering 保留信号完整性症状并降级其他节点症状,Gb200PriorityRootCause 减少活跃症状集,结果映射产生硬件故障归因。降级的症状被标记为"有意思",仍可供检查,避免丢失有用证据。 ## 局限与注意 诊断质量取决于遥测数据的完整性和质量。如果证据不完整或多个原因都符合现有证据,sub_domain 会标记为 ambiguous,系统正确反映不确定性而非强行给出结论。规则引擎是确定性的,相同输入产生相同输出,但规则本身需要根据集群特征定制。例如在 RDMA 集群中关联端口错误和连接重置的规则,在 InfiniBand 和 RoCE 环境下可能需要调整。 目前 Blueprint 只连接了 Slurm、Kueue 和静态输入三种调度器,其他调度器需要自己实现连接器。日志和指标收集器也需要根据实际使用的可观测性栈调整,比如把 Loki 换成 Elasticsearch 或 Splunk 需要写新的连接器。系统一次只分析一个作业尝试,对于跨作业的故障模式(例如某个交换机端口持续影响多个作业)需要在外部聚合多次归因结果。 Service 和 Blueprint 分离的架构意味着团队要部署两个组件。Service 暴露 HTTP API,Blueprint 作为编排器调用 Service 并写入输出接收器,包括只读仪表板。这种设计让核心归因逻辑可以复用,但增加了部署复杂度。 ## 对开发者的意义 Attribution 已在 NVIDIA 内部生产环境运行多年,每周分析数十万 GPU 上的数百万次作业。在一个大型 RDMA 集群中,它关联端口错误、连接重置和调度器事件,识别出特定主机和交换机端口的故障模式,帮助团队定向修复网络和调优拥塞控制。 开源后,开发者可以把它部署到自己的集群。快速开始流程是克隆仓库,运行示例工作流并在本地仪表板里查看诊断。Blueprint 配置文档解释了如何对接自己的调度器和遥测后端。对于自定义规则,需要理解提取、过滤、精炼三个阶段的事件流处理逻辑。 它的价值在于把手工排查自动化,并把结果标准化。健康检查系统告诉你集群当前状态,Attribution 告诉你作业为什么失败。修复系统可以根据归因结果决定是重启作业、隔离节点还是触发硬件更换。对于运行大规模训练的团队,这套系统能减少从故障发生到定位根因的时间,降低重复故障的成本。

优秀的个人博客,低调大师

用户最想甩给AI的,其实是那些繁琐小事

很多人以为普通人打开大模型对话框,主要是在写代码、做深度翻译或生成专业报告。但大模型实验室最近在整理真实用户求助场景时,发现排在最前面的高频需求格外接地气:怎么给孩子挑合适的托育机构、怎么办理某项地方政务手续、怎么理清一堆乱七八糟的账单与报销。这些事情技术难度看起来不高,却是每天消耗普通人最多精力和情绪的地方。 这类需求有一个共同特征:规则极其琐碎、强依赖本地现实、信息极度分散。用户向通用大模型提问时,得到的回答往往逻辑通顺,但只要拿去实际办事,就会发现材料清单漏了两项,或者办事窗口上个月已经改了流程。通用大模型擅长给出一个标准答案,但现实生活中的具体事务全是由特例和长尾细节构成的。 大厂建立评估基准,是为了测试模型在生活常识上的通用理解,但它们很难为某个具体城市的具体人群把事情从头到尾办结。这种大平台覆盖不到的高摩擦地带,恰恰为一人公司做什么提供了清晰的参照物。创业者不一定要去卷通用助理,而是可以看一看大模型在哪些现实问题上总是给出模糊回答,那些回答模糊却又必须解决的缝隙,就是产品切口。 一个值得验证的思路,是把通用问答收缩为极度具体的单点流程交付。比如针对自由职业者、自雇个体的本地社保公积金断缴与续接,或者特定行业跨区域执业的合规手续办理。面对这些事情,用户不是为了找一个聊天对象,而是害怕跑错窗口、补交材料、漏看政策。他们愿意付费购买的,是一个被验证过的、确定的执行路径。 要验证这类需求,启动成本其实很低,甚至早期不需要写复杂的代码或训练模型。最轻量的做法是挑选一个自己最熟悉的本地规则场景,把官方文件、办事指南和实际踩坑经验梳理成高密度的结构化文档,外接一个提示词约束极强的轻量对话工具。先放到同城社群、小红书特定话题或垂直圈子里,看有没有人愿意为了省下半天排队时间支付几十块钱的单次咨询或指引费用。 这个方向的局限性同样明显。生活事务和政务流程往往是低频的,一个人办完一次居住证或报销,可能一年内都不会再用第二次,很难依靠单一工具做高留存的订阅制。此外,政策变动带来的信息校对成本并不低,完全依赖自动化很容易产生新的误导,必须有人工维护机制作为底线。 评估一个生活类工具值不值得做,关键不在于功能有多智能,而在于它能否替用户承担搜索和核对的痛苦。大厂把这些日常琐事列为攻坚目标,说明需求真实存在且规模巨大;但在算法真正打通所有现实接口之前,靠精细化整理和本地认知做小规模变现的空间,已经摆在眼前了。 ![](https://developer.qcloudimg.com/http-save/yehe-12733872/8709ab698b224713bfbab3fbd096cc84.jpg)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册
修改密码
忘记密码